BOSS 直聘南北阁开源 Nanbeige4.3-33B:33B 稠密、512K 上下文,对三家同级模型 20 项赢 18 项
BOSS 直聘的南北阁团队开源 Nanbeige4.3-33B:33B 稠密、512K 上下文、Apache-2.0,官方 20 项评测对三家同级模型赢 18 项,权重 66.2 GB,第三方还没有建档。

10 月 25 日北京时间 20:11,Nanbeige 在 X 上宣布开源 Nanbeige4.3-33B。1 官方给的定位是 Nanbeige4.3 系列的「老师」:先把大模型的能力做上去,之后蒸馏进小模型,第一个是 Nanbeige4.3-3B。2
权重比这条帖早一天半。Hugging Face 仓库在 10 月 24 日 10:49(北京)建好,14 个权重分片当晚 19:57 传完。3
模型卡和评测图到 10 月 25 日 18:19 至 19:11 才补齐,官方帖再过一小时发出。3 这套成绩,今天才第一次能逐一核对。
南北阁(Nanbeige)是 BOSS 直聘的模型团队,模型卡留的联系邮箱后缀是 kanzhun.com。4
上一代 4.2-3B 走的是循环层路线:同一批层重复算两遍,用算力换容量。这次换个做法,参数直接堆到 33B。
先说结论
- 形态:33B 稠密模型,33,118,977,024 个参数,标准 Llama 结构、52 层,文本进文本出,中英双语。56
- 体积:BF16 权重合计约 66.2 GB,官方示例用的是 4 卡张量并行。25
- 上下文:524,288 tokens,RoPE 基数 1.2 亿,没有配缩放参数。6
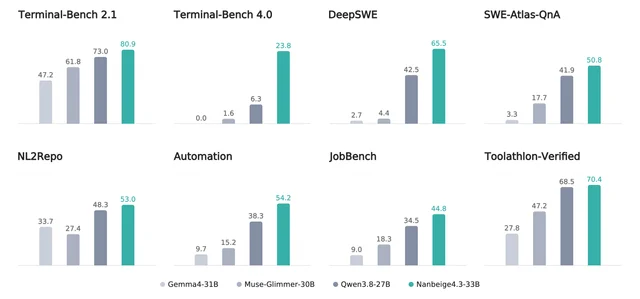
- 最强项:Terminal-Bench 2.1 拿到 80.9,同规模的 Qwen3.8-27B 是 73.0、Muse-Glimmer-30B 是 61.8、Gemma4-31B 是 47.2。2
- 落后项:SWE-Bench Pro 60.3 输给 Qwen3.8-27B 的 61.7,GDPval 84.8 输给 86.4。2
- 获取:许可 Apache-2.0,权重在 Hugging Face 直接下,没有托管 API,也没有第三方评测分数。2
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与时间 | Nanbeige4.3-33B;仓库 10 月 24 日 10:49 建好、当晚 19:57 传完权重,模型卡 10 月 25 日 18:19 补齐,官方帖 20:11 | HF 提交记录 · 官方帖 |
| 厂商 | 南北阁(Nanbeige),BOSS 直聘的模型团队 | 组织页 |
| 现在能做什么 | 权重已可下载,社区量化当天就出了;托管 API 没有,官方 FP8 在路上 | 模型卡 · FP8 讨论 |
| 参数规模 | 33,118,977,024(33.12B),稠密 | HF 元数据 |
| 架构 | LlamaForCausalLM,52 层,隐层 7168,56 个注意力头对 8 组 KV,FFN 22016,词表 166,912 | config.json |
| 上下文 | 524,288 tokens,RoPE 基数 120,000,000,无 rope_scaling | config.json |
| 输入输出 | 文本进、文本出;中英双语;不支持图像 | 模型卡 |
| 权重体积 | BF16 共 66.2 GB,14 个分片;另有 Base 版同规格 | HF 元数据 |
| 部署门槛 | 官方示例给的是 4 卡张量并行;支持 Transformers、SGLang、vLLM | 模型卡 |
| 采样参数 | agent 与工具调用 1.0/0.95,推理与对话 0.6/0.95 | 模型卡 |
| 聊天模板 | enable_thinking 默认开,preserve_thinking 多轮工具调用建议开,工具格式建议 xml | 模型卡 |
| 许可 | Apache-2.0,写在模型卡元数据里,仓库没有单独的 LICENSE 文件 | HF 元数据 |
| 获取方式 | Hugging Face 主仓与 Base 仓,另有集合页 | 集合页 |
| 托管服务 | 没有官方 API,Hugging Face 上也没有推理提供方接入 | 模型卡 |
| 第三方评测 | Artificial Analysis、OpenRouter、Vals 都没有建档 | AA 落点 · OpenRouter 目录 |
| 技术报告 | 模型卡没挂链接,仓库里没有 PDF | 模型卡 |
| 评测口径 | 20 项,全部最高 thinking 档,同一 harness 与超参数;对照仅 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B | 模型卡 |
33B 稠密,一块实心的
模型的骨架写在 config 里,比模型卡说得细。52 层,隐层 7168,56 个注意力头乘 128 维正好等于隐层宽度。KV 只有 8 组,也就是 7 个查询头共用一组键值,这是长上下文时省显存的安排。FFN 宽度是隐层的三倍。6
按这套配置算,每层约 5.9 亿参数,乘 52 层,再加输入嵌入与输出头各一份词表,正好落在 33.12B。6 权重 66.2 GB 也印证了这一点:BF16 下每个参数两个字节,没有稀疏专家。
4.2-3B 的循环层是它花算力省参数的招。7 4.3-33B 的 config 里没有
num_loops 这类字段,架构写的是标准的 LlamaForCausalLM,仓库 27 个文件里也没有额外模块。社区讨论区问的第一件事正是这个,有人直接问「是不是像 4.2 那样的循环 Transformer」。8 config 与文件清单里都找不到循环的痕迹。
Base 版同时放出,对着 Gemma4-31B-Base 在 MMLU-Pro、GPQA、SuperGPQA、GSM8K、Math、MBPP、MMLU、CMMLU 八项通用基准上全部领先。9
领先幅度不小的一格是 CMMLU,86.8 对 76.9。想自己做后训练的,起点是这一版。
官方的 SOTA,是对着三个模型算的
模型卡里那句「30B 级开源模型里 agent 能力最强」,对照只有三个:Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B。2
评测口径写得比多数厂商细:四家全部取最高 thinking 档,每项基准用同一套推理超参数和同一个 harness。2
一处不对称是,Nanbeige 自己那列开了
preserve_thinking=true,另外三家的设置没有写。220 项分成三组:agentic coding 8 项、agentic cowork 9 项、推理 3 项。Nanbeige 赢 18 项,输 2 项。2
差距最大的是几项新基准。Terminal-Bench 4.0 上 23.8 对 Qwen 的 6.3,DeepSWE 65.5 对 42.5,DeepPlanning 63.3 对 49.2,Automation Bench 54.2 对 38.3。2
险胜的几项要单独看:EnterpriseOps-Gym 41.0 对 40.2,Tau3-Bench 48.8 对 48.5,GPQA Diamond 89.5 对 89.2。差 0.3 到 0.8 分,换一次采样就可能翻过来。
一个容易误读的数字是 Terminal-Bench 的两个版本。同一份模型,2.1 是 80.9,4.0 只有 23.8。2
两个版本用的 harness 不同:2.1 走 Terminus 2,4.0 走 mini-swe-agent v2.4.6,分数不能跨版本比较。2
模型卡自己在同一张表里还标了十来个 harness。SWE-Atlas-QnA 用 mini-swe-agent 加 GPT-6 Sol 做裁判,NL2Repo 用 Claude Code,JobBench 用带搜索工具的 Claude Code,YC-bench 只保留最近十轮对话。2
换 harness 会改变分数,这也是它的成绩值得自己复跑一遍的原因。
35 个职业里,赢了 27 个
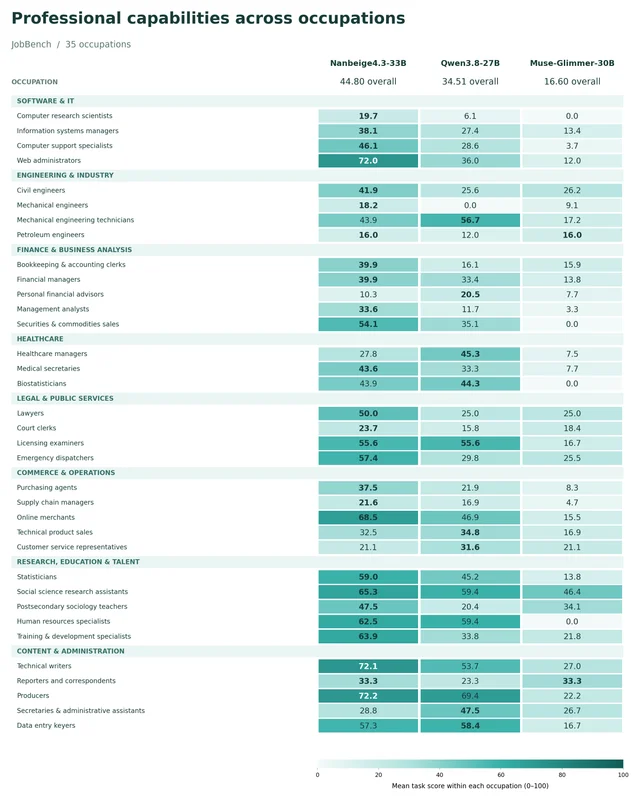
「专业协作」是这次宣传的重点,可核对的落点是 JobBench 那张职业表:35 个职业、每家一个 0 到 100 的平均任务分。2
27 个职业领先,2 个打平,6 个落后。2
落后的六项是:机械工程技术员 43.9 对 Qwen 的 56.7,医疗管理者 27.8 对 45.3,个人理财顾问 10.3 对 20.5,技术产品销售 32.5 对 34.8,客服代表 21.1 对 31.6,数据录入 57.3 对 58.4。2
医疗管理者这一项差 17.5 分,是六项落后里差得最大的一项。个人理财顾问只有 10.3 分,是唯一掉到 10 分附近的一格。2
领先最多的集中在写作与行政:技术写作 72.1 对 53.7,制片人 72.2 对 69.4,网站管理员 72.0 对 36.0,网上商户 68.5 对 46.9。2
512K 上下文要多少显存
模型卡写支持 524,288 tokens,config 里的位置编码上限也是这个数,而且没有配缩放参数。从这两处看,长度是在预训练阶段就拉上去的。6
按 config 推算,每个 token 的 KV 缓存约 0.21 MB:52 层乘 8 组 KV、每组 128 维,K 与 V 各存一份,BF16 两字节。6
换算成机器门槛:32K 上下文约 7 GB,128K 约 28 GB,跑满 512K 要 112 GB。6
权重本身是 66.2 GB。长上下文场景里,KV 缓存很容易超过权重,成为真正吃显存的那一块。
官方没有给吞吐、延迟或单卡显存实测,示例只有一行
--tensor-parallel-size 4。2社区已经把门槛往下拉了一截。官方帖发出后的三个多小时里,Hugging Face 上冒出 18 个第三方仓库,几乎都是量化版本:bartowski 的 GGUF、primitive-ai 的 FP8 与 NVFP4、Duckets 的 MLX 4bit、moeshawky 的 INT8。10
官方自己的 FP8 在讨论区回了一句「很快」。11
该不该试
- 卡够多、想本地跑 agent 的:权重 66.2 GB,两张 80GB 的卡装得下,官方示例给的是 4 卡张量并行;许可与权重都干净,直接下。2
- 只有单张消费卡的:等官方 FP8 或直接用社区的 GGUF、MLX 量化;BF16 原版 66.2 GB,放不进 24GB 与 48GB 这一档。10
- 已经在用 Qwen3.8-27B 的:官方对照里差距最大的是 Terminal-Bench 4.0、DeepSWE、DeepPlanning 这类新基准,你手上如果跑的是老基准,优势会小很多。2
- 做医疗、理财、客服一类的:JobBench 上这三块它都输给 Qwen3.8-27B,先拿自己的任务试。2
- 要长上下文的:512K 是真的,但 KV 缓存按配置算要 112 GB,先算机器再选长度。6
- 要托管接口或第三方分数的:两样都还没有,AA、OpenRouter、Vals 都没建档,现在只能自己复跑。121314
还没有的数字
- 技术报告:模型卡没挂链接,仓库里没有 PDF,训练数据、训练阶段、上下文怎么拉到 512K 都没写。2
- 第三方复跑:20 项都是厂商自跑,harness 与超参数由厂商定,公开渠道里还没有独立重跑。2
- 第三方建档:Artificial Analysis 上只有更早的 4.1-3B 有页面(智能指数 8、上下文 256K),4.3-33B 的页面还是空的。1215
- 官方 FP8:讨论区答复是「很快」,仓库里还没有。11
- 速度与成本:没有 tokens/s、首 token 延迟,也没有每任务成本。2
- 知识截止与训练语料:中英双语是卡片里唯一的数据线索。2
- 安全与偏差评估:模型卡没有这一节,要接生产环境的得自己补。2
- 托管价格:没有托管服务,也谈不上定价。2
References
- 1官方发布帖
x.com
- 2Nanbeige4.3-33B 模型卡
huggingface.co
- 3HF 提交记录
huggingface.co
- 4Nanbeige 组织页
huggingface.co
- 5HF 仓库元数据
huggingface.co
- 6config.json
huggingface.co
- 7Nanbeige4.2-3B 模型卡
huggingface.co
- 8HF 讨论区
huggingface.co
- 9Nanbeige4.3-33B-Base 模型卡
huggingface.co
- 10HF 全站搜索
huggingface.co
- 11FP8 讨论帖
huggingface.co
- 12AA 落点
artificialanalysis.ai
- 13OpenRouter 目录
openrouter.ai
- 14Vals Index
vals.ai
- 15AA 上的 Nanbeige4.1-3B
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.