OpenAI 的文本水印 textGrain:200 token 检出率约八成,改写四分之一词后剩约一成七
解读 OpenAI 2026 年 10 月 5 日的欧盟文本溯源方案:自研水印 textGrain 用最优传输把词表分块再耦合到密钥随机列,1% 假阳性下 200 token 检出率约八成;本文拆开它的机制、被量化的证据边界,以及为什么上线是分阶段、检测器只给审核过的研究者。

10 月 5 日,OpenAI 发布了《Our approach to EU text provenance rules》,回应欧盟《人工智能法案》对生成文本的标识要求,并第一次公开自研文本水印 textGrain 的做法1。配套的技术报告同一批上传,20 页,署名九人,作者来自 OpenAI 与宾夕法尼亚大学、耶鲁大学2。
先说两组数字。在 1% 的目标假阳性率下,心理学类问答里 200 个 token 的段落约 80% 能被检出,400 个 token 约 95%;而把 400 个 token 段落里 10% 的词换成同义词,检出率从约 92% 掉到 66%,换掉 25% 只剩 17%1。一头是长度带来的确定性,另一头是改写带来的崩塌,这份材料的形状就落在这两头之间。
法规要的是什么
《人工智能法案》第 50 条第 2 款自 2026 年 8 月 2 日起适用,要求生成合成音频、图像、视频或文本的 AI 系统提供者,确保输出「以机器可读的格式被标记,并可作为人工生成或被操纵的内容被检出」3。同一款接着写:提供者的技术方案应在「技术可行的范围内」有效、可互操作、稳健、可靠,并要「考虑到各类内容的特性与局限」3。
后半句是理解整件事的钥匙。法规自己写下了文本标识存在做不到的地方,所以厂商实际要交的答案,落在「在哪些条件下做得到、剩下哪些做不到」这件事上。
配套的《AI 生成内容透明度行为准则》由独立专家在多利益相关方流程中起草。签署这份准则出于自愿,但第 50 条的义务本身是法律义务;欧盟委员会与 AI 委员会都已确认,这份准则是证明合规的充分工具4。准则分两节,第一节管提供者的标记与检测,第二节管部署者对深度伪造与 AI 生成文本的标注4。
OpenAI 这一步落在三个动作上1:
- API 客户即日起可对部分模型开通文本水印,全球可用,但默认关闭;
- 未来数周在欧盟为符合条件的 ChatGPT 与 Codex 文本输出加上不可见水印,只覆盖欧盟,不做全球默认;
- 文本水印检测器即日起接受申请,初期只向能够帮助评估与改进技术的审核研究者与专家组织开放,个案审批。
textGrain 怎么加水印
技术报告把 textGrain 写到了可以照着复现的程度。生成一个 token 时,模型先有一个下一词分布(已经过温度与 top-p 截断)。textGrain 保留这个分布里各词概率的相对大小,按密钥和一个上下文窗口把词表切成 B 个块,把每块内部所有词的概率加起来,得到块分布2。
接下来是这套方法真正特别的一步:它把块分布与一个「m 个等概率列」的分布做最优传输耦合。每一对「块、列」都会拿到一个由密钥决定的标准化 Gumbel 值,它的相反数就是这对配对的代价,代价越小,耦合分给它的概率越大。耦合带约束——每一块的概率之和、每一列的概率都必须守住——所以对密钥取平均之后,各块的原始概率原样恢复2。
为了让信号消耗的采样随机性有个上限,目标函数里加了一项 KL 正则,惩罚耦合偏离「块与列相互独立」的程度。报告证明了一个等式,把这项正则的含义定死了:这个 KL 散度正好等于条件熵的减少量,也就是加水印平均拿掉的采样随机性2。于是熵预算成了一个可以直接设的量——它限制平均最多牺牲掉下一词熵的多大比例来换取信号。
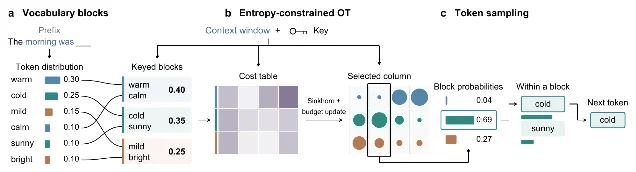
采样时,密钥在 m 列里选中一列,该列归一化后的各项决定各块的抽样概率;块一旦定下,块内的词仍按原始相对概率抽2。也就是说,被改动的只是「选哪一块」这一层,块内部的词序分布不动。报告里的定理 A.4 给出结论:对密钥取平均后,生成序列的分布与不加水印时一致。这条序列级的结论有一个附加条件——每个位置上的列索引要条件均匀,而重复出现的上下文会复用同一批伪随机值,破坏这个条件。报告自己把这条边界写了出来2。
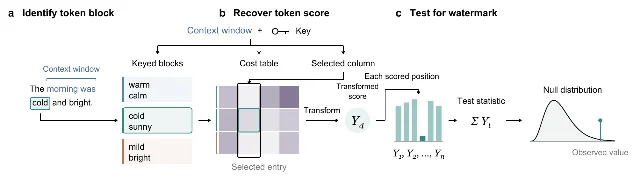
检测方向反过来走。检测器只需要文本和密钥,用同一套分词器、块数、列数与上下文规则,重建每个位置上的代价表与选中列,再看观察到的 token 落在低代价配对上的程度2。每个位置的代价被变换成一个得分;在「文本未加水印、且与密钥独立」的零假设下,这个得分服从单位指数分布,n 个位置的得分之和服从形状参数为 n 的 Gamma 分布。这个和超过该分布的 1−α 分位数,就判定这段文本带水印2。检测不需要知道生成时的熵预算,也不需要模型本身。
为什么要保住采样随机性
值得停一下的是,报告专门解释了 Gumbel-max 这条更常见的水印路线有什么毛病,以及它自己换到另一条路之后换到了什么2。Gumbel-max 的做法是给每个候选词的对数概率加上一个由密钥生成的 Gumbel 噪声,再取最大的那个。它有一个副作用:在固定上下文和固定密钥下,它每次都挑同一个词,于是同一个提示词反复生成会得到一模一样的答复2。对需要多个不同答案或解法的应用来说,这是硬伤。
textGrain 要的是另一件事:对密钥取平均后分布不变,同时在固定密钥下仍留有采样随机性。这也是它把牺牲量做成一个可调预算的理由2。
放进这几年的方法谱系里看,文本水印分成了几支。green-list 类通过偏向密钥选出的词子集提高可检测性,代价是改变了生成分布;此外还有 inverse transform、最优化耦合,以及锦标赛采样(tournament sampling,Google 的 SynthID-Text 属于这一支)5。textGrain 同样把词分组,但条件块概率由一个带边缘约束和熵预算的最优传输问题决定2。这个定位是它敢说「对输出质量没有可测的影响」的原因——生成分布被保住了。
边界落在哪两个方向上
发布页给了两张图来说明边界的位置,数字如下。
第一是长度与内容类型。在 1% 目标假阳性率下,心理学类内容的 200 token 段落检出率约 80%,400 token 约 95%;数学类内容因为用词几乎没有回旋余地,检出率「显著更低」1。发布页没有给出数学类的具体数字。评测用的是 ELI5 数据集里的心理与数学问答6。
第二是编辑。同一批 400 token 段落,把 10% 的词替换成同义词,检出率从约 92% 降到 66%;替换 25%,降到 17%1。
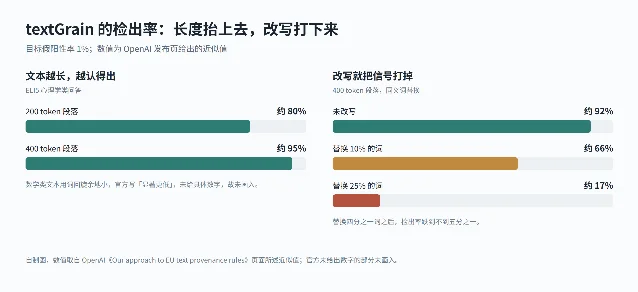
根据 OpenAI 发布页给出的近似值自制。左侧是心理学类内容在 200 与 400 token 上的检出率,右侧是 400 token 段落经同义替换后的检出率。数学类内容官方只写「显著更低」、未给数字,因此没有画入。
这几条边界直接决定了上线方式。检测器会犯两类错误:把没有水印的文本判成有水印(假阳性),或者漏掉真水印(假阴性);文本越短、用词越受限、被改写越多,这两类错误都越容易发生。这就是检测器初期只给审核研究者、API 默认关闭的原因1。
还有一处对照要标出来。发布页说 textGrain 在自家评测里达到或超过了包括「SynthID for text」在内的其他方案,但没有附数字,技术报告的相关工作一节也没有给出同条件对照12。要判断这个说法,得等报告后续更新或开源之后再动手测。
质量这边几乎看不出代价
水印对输出质量的影响,官方用 Astra 的八个基准做了有水印与无水印的对照1:
| 基准 | 无水印 | 有水印 |
|---|---|---|
| Artificial Analysis 智能指数1 | 49.57 | 49.76 |
| AutomationBench1 | 34.09% | 34.86% |
| DeepSWE v1.11 | 72.80% | 71.68% |
| Terminal-Bench 4.01 | 53.90% | 56.06% |
| Terminal-Bench Science 0.11 | 56.90% | 60.00% |
| BrowseComp1 | 87.92% | 87.35% |
| HealthBench Professional1 | 64.27% | 64.60% |
| GPQA Diamond1 | 94.44% | 93.94% |
官方从这张表里得到的结论是「没有看到有意义的性能差异」1。差异有正有负,例如 Terminal-Bench Science 0.1 高了 3.1 分、DeepSWE v1.1 低了 1.12 分,更接近基准自身的波动。这张平表也说明熵预算这个设计的重量:如果为了更强的水印去牺牲更多采样熵,它就不会这么平。
水印不告诉你什么
发布页专门留了一节,讲清水印能证明到哪一步。它只说明 OpenAI 的系统生成或处理过一段文本的一部分,此外的事情它不回答1:
- 它不衡量人类贡献,无法说明一段文字里有多少来自人的判断、编辑或创作1;
- 它不确立所有权或责任,不判定文本归谁、使用是否合法、是否需要披露、由谁负责1;
- 它不识别用户,不会把文本关联到某个人、组织、账号、提示词或对话1;
- 它不验证准确性,不告诉你一段话是真是假、是否有害、语境是否恰当1;
- 它不把「检测不到」当作人类所写的证据,因为文本可能太短、被编辑或翻译、来自不支持水印的模型、早于水印功能上线,也可能出自别家公司的工具1。
最后一条把否定结果也划出了可解释的范围:一段文本判不出 OpenAI 水印,可能只是因为它太短。
现在能下的判断
把这件事收成一句:法规要求文本标识稳健、可靠,而一套统计水印的稳健性上限,由厂商愿意牺牲多少采样随机性决定。textGrain 的选择是少牺牲,这既是它在 Astra 八项上几乎没有代价的原因,也是它在短文本、低熵文本和任何改写面前信号脆弱的原因。同一件事的两面。
对读者来说,可操作的部分有几条。如果你在用模型产出面向欧盟用户的公开文本,未来数周后 ChatGPT 与 Codex 的输出会默认带水印,而 API 侧的默认是关闭,需要自己开通。如果你想检测一段文本是否由 OpenAI 模型生成,现阶段拿不到公开工具,只能通过申请进入研究者名单。如果你想要的是一台判定「这段文字是不是 AI 写的」的通用检测器,OpenAI 这份发布页划出了它回答的范围:它只回答「这段文本里有没有 OpenAI 系统留下的密钥随机性」,其余问题它明确说不回答1。
References
- 1Our approach to EU text provenance rules
openai.com
- 2
- 3Article 50: Transparency obligations for providers and deployers of certain AI systems
ai-act-service-desk.ec.europa.eu
- 4Code of Practice on Transparency of AI-generated Content
digital-strategy.ec.europa.eu
- 5
- 6ELI5: Long Form Question Answering(数据集)
huggingface.co
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.