5 张卡降频 58% 只掉 4% 速度、12GB 显存是把桌面降到 1080p 换来的、笔记本长压 90°C 却没降频
七组来自 Reddit、X、小红书与公众号的实测,每组都在同一个速度旁边写着它从哪一格预算里挪出来的:电、显存、桌面分辨率、电池、首字时间与人力。

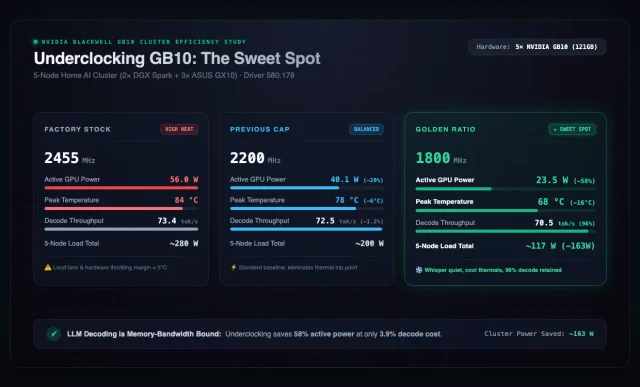
今天上午十点多,一个自己在家里搭了 5 台 Blackwell 小机器的人,把 GPU 频率从 2455MHz 锁到 1800MHz:单卡功耗从 56.0W 掉到 23.5W,解码从 73.4 掉到 70.5 tok/s 1。
今天早上六点多,另一台 12GB 显存、16GB 内存的机器上,同一个 27B 在 110K 上下文下从 14 tok/s 提到 25。作者说这轮提速的动作,是把桌面分辨率从 4K 降到 1080p,再关掉串流 2。
10 月 16 日,The Register 测一台 RTX Spark 笔记本:持续推理一小时以上,GPU 越过 90°C,出现过死机与一次花屏 3。
三组人量的都是同一件事:自己那台机器还剩多少余量,以及这点余量是从哪一格挪出来的。
| 材料 | 挪走的是什么 | 换回来的是什么 |
|---|---|---|
| 5 台 GB10 降到 1800MHz 1 | 58% 的 GPU 功耗、16°C 温度 | 96% 的解码速度 |
| 12GB 显存那台机器 2 | 桌面分辨率与几 GB 系统内存 | 90K 上下文 35 tok/s |
| Bolt 加一个草稿头 4 | 2.3GiB 显存 | 2.07 倍解码,24GB 卡装不下 |
| RTX Spark 笔记本 5 | 电池与散热余量 | 14.3 tok/s 撑一小时,还是 90°C 花屏 |
| 7900 XTX 上的 Strata 6 | 调优表版本对不对得上 | 预填 900,还是 1,459 到 2,500 |
| 一台 DGX Spark 拉到 512K 7 | 5 分钟的首字等待 | 三份 50 万 token 的提示都跑通 |
| 一个 agent 花 3.5 小时 8 | 人力与 3.5 小时 | 216 tok/s 的自制引擎 |
5 张 GB10 按到 1800MHz:省 58% 的电,掉 4% 的速度
作者手上有 5 台 GB10 机器:2 台 DGX Spark 加 3 台 ASUS GX10,每台 128GB 统一内存,驱动 580.178,跑的是 125B 以上的模型 1。
他把三档频率各跑一遍,每次只改频率这一个数:
| 频率 | 单卡功耗 | 峰值温度 | 解码 | 5 台合计负载 |
|---|---|---|---|---|
| 2455MHz(出厂)1 | 56.0W | 84°C | 73.4 tok/s | 约 280W |
| 2200MHz 1 | 40.1W | 78°C | 72.5 tok/s | 约 200W |
| 1800MHz 1 | 23.5W | 68°C | 70.5 tok/s | 约 117W |
第二笔账在他十六分钟后的回复里。5 台合计省 163W,按 17 美分一度电、24 小时不停跑折算,一年约 243 美元、每月 20 美元 9。
按他给的数复核:163W × 8,760 小时约 1,428 度,乘以 0.17 约 243 美元,对得上。
他给的理由是解码吃内存带宽、不吃算力。频率砍掉 26%,吞吐只掉了 3.9% 1。
限制在他自己手里:这是他一个人的 5 节点集群、一种量法;他只报了解码吞吐,没报同一批提示的回答有没有变;「风扇听不见」是主观描述,不是分贝数。
12GB 显存那台机器,先把桌面降到 1080p
机器是 12GB 显存加 16GB 内存,跑 Qwen3.8-27B 的 IQ3_XXS 量化,KV 缓存压到 q4_0,flash attention 打开,14 线程 2。
他给出六档上下文,每档配一个不同的
-ngl:| 上下文 | -ngl | 解码(现在) | 解码(之前) |
|---|---|---|---|
| 60K 2 | 99 | 36 tok/s | 32 tok/s |
| 90K 2 | 67 | 35 tok/s | 23 tok/s |
| 110K 2 | 62 | 25 tok/s | 14 tok/s |
| 120K 2 | 59 | 17 tok/s | 11 tok/s |
| 150K 2 | 54 | 11 tok/s | 未给出 |
| 180K 2 | 50 | 8 tok/s | 6 tok/s |
他把这轮提速归给两件事:桌面分辨率从 4K 换成 1080p,关掉 Moonlight 串流。几百 MB 显存回到卡上,预填充落到 750 到 1,200 tok/s 之间,他说是之前的两到三倍 2。
他自己下的判断很具体:90K 那格 35 tok/s 是现在的默认;60K 的 36 tok/s 已经没有意义,同样的速度直接用 90K 2。
腾出来的显存他拿去换了上下文,速度是顺带多出来的。
限制也写全了:一个人一台机器;这个量化他自己说接近 Unsloth 的 Q4 档,没有给对比数据;180K 那格 KV 是 q4_0;MTP 因为显存不够没开;高推理档没试。
评论区两条反驳都落在这套配置的边角。有人看到 K 和 V 都压到 q4_0 就笑了,另一个人回说这个模型对 q4 的容忍度确实高于其他模型;还有人问 120K 到底够不够用,毕竟前沿产品的入口现在给到 1M。有人问机器是哪张卡,作者回的是 4070 Ti 2。
Loading content card…
一个 1GB 的草稿头,把 24GB 的卡挡在门外
条件是 RTX 5090 32GB、llama.cpp b11750、NVIDIA 自己的 Bolt 24GB GGUF:22.0GB 权重、1.7GB 视觉投影、1.0GB 的 LiLiCorr 草稿模型,窗口 32K,KV 用 q8_0,温度 0 4。
| 窗口 | 草稿头 | 显存 | 解码 | 接受率 |
|---|---|---|---|---|
| 32K 4 | 开 | 25.0GiB | 343 tok/s | 55% |
| 32K 4 | 关 | 22.7GiB | 166 tok/s | — |
| 64K 4 | 开 | 25.2GiB | 342 tok/s | 55% |
| 32K,不带视觉投影 4 | 开 | 23.4GiB | 342 tok/s | 55% |
| 32K,不带视觉投影 4 | 关 | 21.0GiB | 166 tok/s | — |
三个数一起看,账就清楚了。草稿头把解码从 166 拉到 343,2.07 倍,代价 2.3GiB;上下文从 32K 拉到 64K,只多 0.2GiB 4。
于是那张 24GB 卡的账是算出来的:关掉草稿头和投影 21.0GiB,装得下;只带草稿头 23.4GiB,还能挤;两个都带 25.0GiB,装不下。他的结论是草稿头实际要一张 32GB 的卡 4。
接受率按题不同:短事实题 49%,Kubernetes 与 Go 那两题 59%。预填充 pp512 是 5,166 tok/s,20K 上下文约 4 秒填满 4。
他还顺手把 Bolt 塞进那套 33 道运维题:79%,九个模型里排第七;54% 的工具调用是语料里没录过的形状,回放时按未命中扣分 4。
限制他自己列了:每行只跑一次,同一个模型换个时段能差四道题;NVIDIA 建议温度 1.0,他为了可重复跑 0;专家是 2bit 量化加蒸馏;今天 Metal 上 llama.cpp 跑这个模型会崩,修复的 PR 还开着 4。
他是 taraengine 与 taracode 的作者,这件事写在帖子末尾。
笔记本上,插电和拔电是两个档
RTX Spark 是 NVIDIA 10 月 16 日开卖的 Windows 本,超芯叫 N1X。统一内存最高 128GB,笔记本 TDP 标称 45 到 80W 5。
国内评测者卡兹克用 128GB 那台(华硕 ProArt 创 16,京东 37,999 元)跑了一周:主力 Qwen3.8-27B 开 MTP 约 30 tok/s,预设本地模型约 80 tok/s 5。
爱范儿 APPSO 测的 64GB 那台给的数更细:Qwen3.8-27B 生成 14.3 tok/s、预填充 615.7 tok/s、首字 2.83 秒;换成 Qwen3 32B 的 NVFP4 档,生成 55 到 60 tok/s 5。
第二笔账落在电源上。拔电时 GPU 常驻 P4 的 30W 档,插电才到 P0;持续推理时放电功率 86 到 88W,10 分钟电量从 100% 掉到 85%,按 99.9Wh 电池粗算能撑 1 小时 15 分 5。
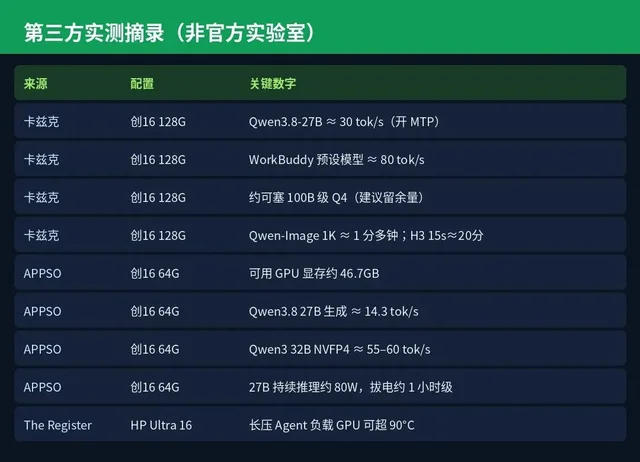
温度那关是 The Register 测出来的。HP OmniBook Ultra 16 跑持续 agent 负载一小时以上,GPU 越过 90°C,出现偶发死机,有一次花屏,原文判断可能与内存过热有关 3。
原文对散热限制的描述是「热降频问题,或者更确切地说,看起来根本没有降频」。温度上去之后,这台机器给出的是死机与花屏,风扇没有替它把功耗压下来 3。
同一篇里还有一个反直觉的读数。agentic 任务里,Qwen3.5-122B 的吞吐只有 35B 的一半,但因为用的 token 少,中位解题时间反而快约 40 秒 3。
限制先摆清楚:三家的条件各不相同,模型、量化、框架分别是 WorkBuddy 预设、LM Studio 和 llama.cpp v0.6.0;公众号这篇是转述,原文三家各自可查。机器也不是便宜货,全球起售约 2,599 美元,顶配到 6,000 美元以上 3。
7900 XTX 上,同一个引擎报出三个数
小红书作者 ChipAI 整理了一份 7900 XTX 跑 Strata 的对照:24GB 显存、gfx1100,官方支持的卡型 6。
官方 Measured 的单卡读数是读 1,459 tok/s、生成 75.5 tok/s。社区数字分成三档 6:
- Win11 加 IQ3_XXS:短聊 decode 约 91,32K 提示读 2,000 以上 6
- Linux 默认:长提示预填约 900;换上 resident 与版本匹配的调优表,到 2,000 至 2,500 6
- 短聊常见区间 60 到 98;另一位用 0.1.27 加 DDR3 64GB 的人,预填峰值 1,602、短上下文 decode 约 84 6
两边是同一张卡、同一个模型;把 1,459 和 900 分开的,是调优表版本与热身状态。
三个坑他写得很直:调优表版本与 hipBLASLt 对不上,预填充腰斩;只堆显存而系统内存不够,专家就回盘上读;不同版本、不同量化、冷热状态下的截图不能横着比 6。
他自己也写了「配置不同差很大,仅供对照」。这是一份整理,每条数字后面的机器与命令没有一起给出来。
一台 DGX Spark 拉到 512K:代价是 5 分钟首字
条件是一台 DGX Spark,跑社区的 vLLM 分支 eugr/spark-vllm-b12x,开 MTP-4 投机解码。权重是 NVIDIA 官方 checkpoint,512 token 进、512 token 出 7。
并发三档:单路 44.8 tok/s,两路合计 60.7,四路合计 86.6 7。
长上下文那组是原生 262K,用 YaRN 拉到 512K(factor 2.0)。三份约 50 万 token 的冷提示,0 次报错,预填充约 1,650 tok/s,首字约 5 分钟 7。
50 万 token 确实进去了,代价是第一句话要等 5 分钟。按 1,650 tok/s 算,50 万 token 要 303 秒,与 5 分钟的首字对得上。同一段长文档反复追问,这笔首字钱只付一次;一次性问答,它就是全部。
限制在这三条数据里:三份提示、一台机器、一个社区 fork;聚合吞吐不等于单请求速度;他只报了「0 errors」,没在同一批提示上验准确率。
3.5 小时,一个 agent 把推理引擎写出来
crit 是给 coding agent 用的工具包。作者说他们研究了 30 个专用推理引擎,把通用的那部分抽了出来:请求处理、内存管理、采样、模型加载,再加一个按硬件物理上限打分的评测 8。
他们给 Claude Opus 5.5 的指令是一句话:「用 crit 给 Qwen3.8-27B 造一个推理引擎」。3.5 小时后,几乎没有人插手,引擎跑起来了:RTX 5090 上解码 216 tok/s、预填充 8,917 tok/s、262K 上下文、困惑度比参考实现高 0.3% 8。
这组数里没有一道题的准确率。作者拿「比参考实现高 0.3% 的困惑度」当质量凭据;困惑度量的是输出分布的接近程度,判不了答题对错 8。
他们的评价思路写得很清楚:先量出这张卡的带宽与算力上限,再看引擎离上限差多少 10。
限制也得说:crit 与 crit-hub 都是他们自己的产品;一个模型、一张卡、一次实验;hub 现在只有他们自己的 4 个 RTX 5090 引擎 8。
Loading content card…
顺带几条
VALS AI 今天说,DeepSeek V4.1 Flash 1017 在他们的多步进攻性网络安全任务上赢了 GPT 6 Sol;Sol 是通过 Daybreak 可信访问计划测的。完整评测要几周后才公开,现在没有分数可对 11。
DeepSeek 把生产里用的推理框架 DeepInfer 开源了,Apache 2.0,只支持 V4.1-Flash,硬件是 SM100 与昇腾 950;benchmark 用 4 张 SM100 做预填充、64 张做解码。开源版没带 KV 缓存系统,也没带预填充与解码的分离部署 12。
Strata 0.1.45 的解码提升 42%、4K 提示处理提升 80%;同一天 Reddit 有人发帖「别升级」,139 赞、74 条评论,说 Windows 与 Linux 都碰上了破坏性变更 1314。发布说明自己也写了 Windows 实机未测、RTX 5070 不在测试集、老卡的改动挪到 0.1.46 13。
看完先查四件事
- 这个数是在哪一档频率、插电还是拔电下量的。 同一张 GB10,2455MHz 是 56W 与 84°C,1800MHz 是 23.5W 与 68°C,速度只差 4% 1。笔记本上同一台机器拔电,GPU 落回 30W 的 P4 档 5。
- 换来的显存是从哪腾出来的。 桌面分辨率、视觉投影、KV 量化,三样都可以,代价各不相同 2。
- 新加的东西有多贵。 本期草稿头要 2.3GiB,上下文翻倍只要 0.2GiB,差了十倍多 4。
- 首字等多久还算能用。 50 万 token 那组的答案是 5 分钟,你得先想清楚自己是哪种用法 7。
一个当场能做的动作:把常用那条命令固定下来——温度 0、
--parallel 1、5 条固定提示各跑三次取中位;然后只改一个变量,桌面分辨率、频率或草稿头,再跑同一组。两次之间只差一个数,第二次的读数才站得住。References
- 1
- 2
- 3The Register:RTX Spark 笔记本实测
theregister.com
- 4
- 5公众号 数字生命歪果仁:RTX Spark 轻薄本开售实测
mp.weixin.qq.com
- 6小红书 ChipAI:7900XTX 跑 Strata 起步清单与社区速度表
xiaohongshu.com
- 7
- 8Reddit r/LocalLLM:用 agent 造专用推理引擎\
reddit.com
- 9X @kkiran:电费折算
x.com
- 10GitHub crit-labs/crit
github.com
- 11
- 12GitHub deepseek-ai/DeepInfer
github.com
- 13公众号:Strata 0.1.45 的改动与限制
mp.weixin.qq.com
- 14Reddit r/LocalLLaMA:别升级 Strata
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.