「线程池满了」和「把线程数调大」,中间隔着一道乘法
线程池是服务能同时干活的那几个位置;满了之后,请求不是排队就是被拒。三句话问清这次该加人、该限流,还是该去查慢在哪。

上一篇的结尾是:加缓存省掉的那些回头问源头,最后还是会在同一秒一起回来。那一秒落到机器上,就是几千个请求同时等着被处理。这一篇讲机器拿什么接住它们,以及接不住的时候会发生什么。
周二上午,群里一句:「订单服务的线程池满了,日志里全是 rejected(被拒掉的请求)。」半分钟后跟一句:「我把线程数从 200 调到 800,先顶一下。」
这话听着像把水龙头开大一点。可这台机器也许一共只有 8 个核(真正同时算数的单元),多出来的 792 个线程不会让活干得更快,反而会互相拖慢。1
先把这个词拆开。「线程池」是提前雇好的一批位置,用完不遣散,下一个请求接着用。所以「线程池满了」说的是一件很朴素的事:这个服务能同时干活的位置全都占着,后来的请求没地方站。
占满之后会怎样、这一下该往哪儿使劲,问三句就够。
一、这段时间每个请求变慢了吗?
二、线程是在算,还是在等?
三、排不下的那批人,看到了什么?
三句问完,处置落在三种里:加人(加机器,或者把池子调大)、限流(明确拒掉一部分,保住绝大多数)、去查慢在哪。
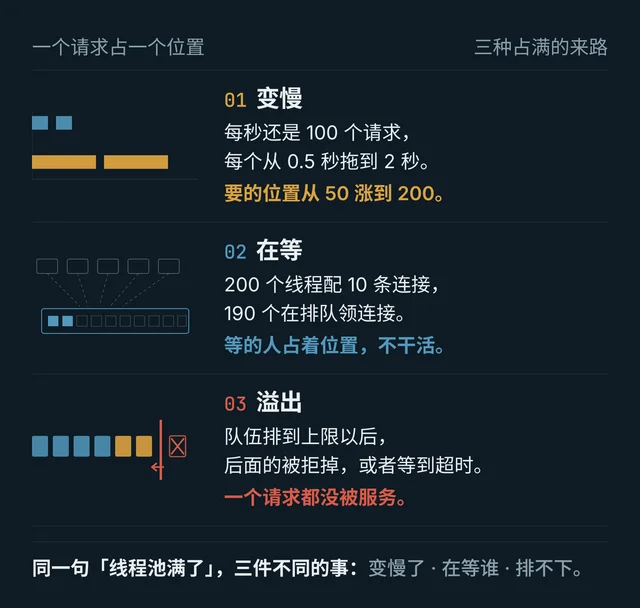
示意图由本文绘制。三行对应上面三问:条形长度=每个请求占位多久,虚线=线程在等谁,红线=排到这里的人被拒掉或等到超时,一个都没被服务。
01 雇人
要理解「位置」,得先认识占位置的人。
一台机器上跑着很多进程,进程就是一个正在运行的程序。前面几篇讲过,工程师嘴里的「服务」通常就是一个被系统管着的进程。
进程里面还有更小的单位,叫线程。Linux 的手册写得很直白:一个进程可以包含多个线程,它们跑的是同一个程序,共用同一块内存,但每个线程有自己独立的栈。2
用一家店打比方。进程是这家店,线程是店里的店员。
店员共用同一个店面、同一份库存——内存里的数据谁都能伸手拿到。每个人手边还有自己的小本子(栈),记着自己算到哪一步。
所以「多开几个线程」,等于在同一个店里多雇几个人:店面和库存不用重开,成本很低。
「多开几个进程」,等于多开一家店:各自有各自的库存,彼此看不见对方手里的东西。
你会听到:「这个服务是单线程的。」「起了四个 worker(干活的单元)。」
问什么:一个进程里有几个线程?它们共用哪些东西?
02 排队
请求进来,谁接?
在大多数 Web 框架里,一个请求从进来到把回答发出去,全程占着一个线程。Tomcat 的文档把这句话写得很硬:每一个进来的非异步请求,在那次请求期间都需要一个线程。3
按默认配置,这个池子的上限是 200 个线程。也就是说,这台机器同一瞬间最多答 200 个请求。3
第 201 个请求不会凭空消失。它先进服务器内部的队伍,等有人空出手;这层还能再挂一大批连接,默认上限 8192 条。再往外是操作系统那一层队,默认排 100 个。3
队也满了,后面的请求就连不上:可能被直接拒掉,也可能一直等到超时。3
「线程池满了」这句话真正含糊的地方就在这里。「满」至少有两种下场:一种是在排队,用户干等,最后多半超时;一种是被拒,用户当场看到报错。
这两种下场,用户感受完全不同,处置也完全不同。
写代码的那一侧还有第三种选择。Java 的线程池文档列了四种拒绝方式:抛异常、交给提交任务的那个线程自己去干、直接丢掉、丢掉队首最老的那个。4
你会听到:「日志里全是 rejected。」「接口开始大面积报错。」
问什么:被拒的占多少?用户看到的是转圈还是报错?
03 算数
流量没涨,池子却满了,这句话不矛盾。
因为要几个位置,不只看每秒进来多少个请求,还要看每个请求占多久。两件事乘起来,才是同一瞬间占着位置的人数。
这条关系在排队论里叫利特尔法则:系统里的平均人数,等于到达率乘以平均停留时间。5
换成本行的话:需要的线程数,约等于每秒请求数乘以每个请求的耗时。
走一遍。每秒 100 个请求,每个耗时 0.5 秒,同一瞬间有 50 个在做,50 个位置够用。
还是每秒 100 个请求,某个环节变慢,每个请求耗时涨到 2 秒,同一瞬间就有 200 个在做,正好占满。再慢一点,就开始排队。
所以「QPS(每秒请求数)没涨,怎么满了」是一个可以回答的问题:来的人没变多,是每个人待的时间变长了。
这道乘法有三个口子:每秒多少请求、每个请求多久、池子多大。任意一个变了,另外两个的平衡就破了。
你会听到:「QPS 跟上周一模一样啊。」
问什么:这段时间每个请求的耗时是多少?跟上周差多少?
04 变慢
耗时为什么会变长?最常见的来源是等。
一个请求要查数据库,得先拿到一条数据库连接——通往数据库的一条线路,用之前先领,用完还回去。
连接不是无限的。HikariCP 这个常用的连接池,默认上限只有 10 条。6
举个常见配置:200 个线程配 10 条连接。同一瞬间最多 10 个线程真的在查库,另外 190 个想查库的只能在池子外等着。
等的线程和算的线程,占的位置一样多。监控上看到的都是「200 个线程都在忙」。
这时加线程的后果很具体:位置多出来了,等连接的人更多了,数据库那边一点没变快。
再往上还有一层天花板,是核数。这台机器 8 个核,同一瞬间真的只有 8 个线程在算,其余都在等着被轮到,换手本身要花时间。
HikariCP 的文档把这条讲得很不客气:线程数一旦超过核数,加线程是变慢,不是变快;只有在「等」的时候——等磁盘、等网络——多几个人才有意义。1
同一份文档里记了一次实测:只把连接池调小,别的都不动,响应时间从大约 100 毫秒降到大约 2 毫秒。1
你会听到:「机器负载不高,但接口就是慢。」「CPU 才 20%。」
问什么:慢在哪一段?那一段是在算,还是在等?
05 处置
三种处置,各有硬条件。
加人。 只在「流量真的涨了、每个请求也没变慢、机器也没跑满」的时候管用。加机器是把同样的池子复制几份;调大池子是在一份里多开座位,核数用满之后反而帮倒忙。
限流。 明说「我们同一秒只接这么多」,多出来的当场拒掉,或者排一小会儿就失败。它换来一部分人快速失败,剩下的人还能被服务。
去查慢在哪。 耗时翻倍、机器没满、CPU 不高,这三条同时成立,答案通常在某条查询或某个下游服务上。这一步最花钱,但它治的是根。
你会听到:「先加机器吧。」「加个限流顶一下。」
问什么:这次是流量涨了,还是每个请求变慢了?
存下来当一张表
| 你听到的 | 多半指什么 | 你接着问 |
|---|---|---|
| 线程池满了 | 能同时干活的位置全占着,后来的在排队或被拒 | 每个请求的耗时变了吗? |
| 日志里全是 rejected | 队伍也排到上限,任务被拒 | 拒掉的占多少?用户看到什么? |
| 把线程数调到 800 | 多开座位,超过核数后互相拖慢 | 这台机器几个核?CPU 跑满了吗? |
| QPS 没涨,怎么满了 | 每个请求待的时间变长了 | 耗时是哪一段涨的? |
| CPU 才 20%,接口很慢 | 线程在等,不在算 | 在等连接,还是在等下游? |
| 加个限流顶一下 | 明确拒掉一部分,保住其余 | 拒的是哪些人?他们看到什么? |
怎么用
先看耗时,再看池子。
耗时没变、流量真涨了,加人是对的答案。耗时翻了倍,加人只是把同一个堵点复制成几份。
这两句话当场说得清,就比「先调大试试」省下几个小时的排查。
线程等不到东西的时候会超时。工程师说「这个接口超时了」,那个几秒是谁定的、为什么是这个数,下一层从这句话讲起。
References
- 1HikariCP:连接池该配多大
github.com
- 2Linux 手册:pthreads(7)
man7.org
- 3Apache Tomcat:HTTP 连接器配置
tomcat.apache.org
- 4Java 21:ThreadPoolExecutor
docs.oracle.com
- 5维基百科:利特尔法则
en.wikipedia.org
- 6HikariCP:maximumPoolSize 默认值
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.