「猫和车」其实是一个 V:可解释性最著名的两个反例,被当年立起它们的人自己拆了
一位前 OpenAI 研究员、也是「猫和车」那一批早期工作的作者,发表了一篇 65 分钟的长文,主张可解释性领域最著名的两个反例当年被读错了;本篇核完他的四步主张、那串百分比分别属于哪个模型,以及为什么反对意见集中在「叠加」这个词的定义上。

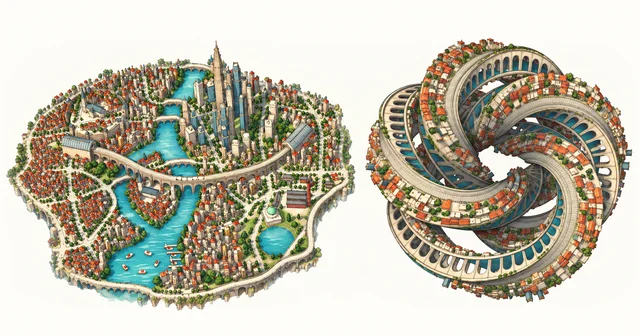
标题是《神经网络本来就是干净的》。页面在标题下自己标着一句「这是一个暂定的假设」,并把阅读时长写在旁边:65 分钟。1
四分钟后,他所在公司的官方账号转出这篇文章,配了一句话。3
那句话是:「多年来神经网络看上去难以看透,像需要解开的死结。我们不再这么认为了。」3
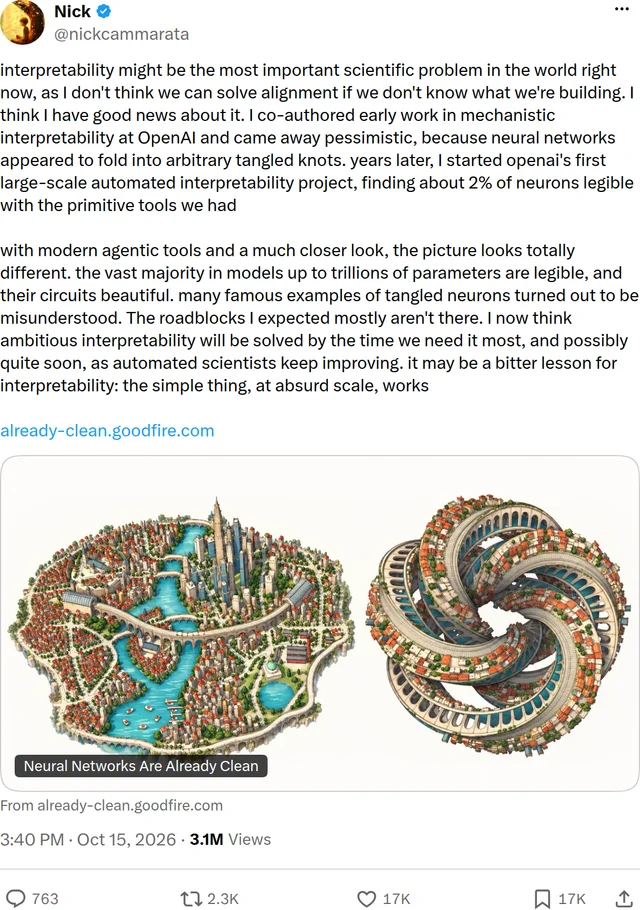
作者不是外人,这是这条结论分量最重的地方。
2019 年,他找到了那条后来被反复引用的电路:一辆汽车的信号,流进了一批本来在做别的事的神经元。1
第二年,那条电路和领域里最著名的那个多义神经元一起,被写进可解释性最有名的 Distill 文章《Zoom In》,用来论证「神经元这个单位恐怕不适合做研究」。他是那篇文章的共同作者。4
现在他说,这两个例子当年都读错了。1
用一句话概括他的结论:这个领域的默认假设选错了。
01 他主张的到底是什么
他没有说可解释性已经解决。全文最后有一节专门讲标题起得不好。1
他说这个标题「两个方向都过头」:既夸大了证据,因为整个网络并没有全审完;也低估了他们的判断,因为在他们的版本里,网络学到的东西比「每个神经元对上一个人给的标签」更好。1
他说的「干净」,也不只是「一个神经元只有一个意思」。1
按他的用法,它指的是一件更基本的事:网络的零件是按「能被下游读懂、并且被下游接着用来搭东西」的方式长出来的。1
他给了自己的置信度:「我们大概是 85% 确定」。1
这个 85% 需要一句解释,因为它的分母不是神经元的个数。他用了一个类比:这次更新「有点像从神创论走到自然选择」——不是越来越多的物种被发现有演化痕迹,而是你意识到自己搞错了产生它们的那个过程。1
所以那个 85% 指的是「几乎所有机制都来自生长出来的那一种过程」,不是「85% 的机制如此」。1
他真正主张的是一套四步推理,四步的强度并不一样,这一点他自己标了出来。1
第一步:网络只有一个学习原则,不是两个。所以要研究它,前面没有拦路的东西。1
第二步:用今天的模型和工具去做,这件事比多数人预期的顺利得多。1
第三步:理解是复利的,地图填得越满就越容易填。所以网络自身的机制至少应当放进工具箱。1
第四步,他明说是高度猜测:这可能就是我们需要的绝大部分;可解释性也许比所有人以为的都容易,而且可能很快。1
关键就在第一步。它要推翻的不是某个实验结果,而是这个领域近十年来放在地基上的那块石头。
02 那个「猫和车」神经元,其实是一个 V
要理解这篇文为什么会被争论,得先看清它推的是哪两块东西。
第一块是 InceptionV1 的 4e:55 号神经元。它从 2017 年的《Feature Visualization》起就被反复引用,因为特征可视化画出来的图里,它同时对着猫脸和车头亮起来。15
顺便交代一个后面一直要用到的词:叠加(superposition),这个领域给「网络把几个不相干的东西塞进同一个神经元」起的名字。4
《Zoom In》当年对 4e:55 写过一句很硬的话:这个神经元「不是在回应猫脸和车头有什么共同之处」。4
它找的是猫的眼睛和胡须、毛茸茸的腿,还有车头反光的金属面——「不是某种微妙的共同特征」。4
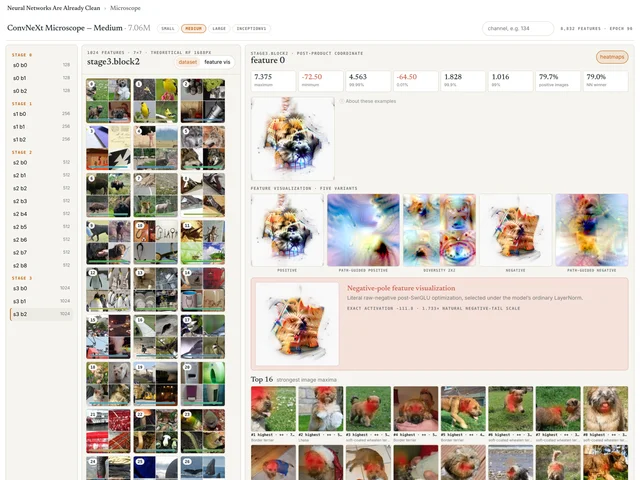
共同之处是有的。Cammarata 说,是一个 V 形。1
他把这个神经元的两端都翻出来看:正极上是 V 形的火焰、消防船喷出的 V 形水柱、V 形的狐狸脸。1
负极上是一个 O——对着 V 的尖端,圆而平的那一类。1
它的职责不是在给输入命名,而是沿一条下游神经元能用的分界线做切分:尖的进来,圆的出去。他为此写了一句全文最好用的话:神经元的职责「与其说像名词,不如说更像动词」。1
需要说清楚的是,当年读错的并不是「看不懂这个神经元」。《Zoom In》把它当成一个可读的电路讲得很清楚。4
它当时的判断是更宏观的一句:多义神经元是电路研究议程的一大障碍,严重限制了人们推理网络的能力。4
作者现在推翻的,正是这句判断的前提。
第二块材料更直接,当年被命名为「叠加中的汽车」。4
原话是:模型「没有在下一层再做一个纯粹的车检测器,而是把车特征摊到一批主要在做别的事的神经元上,特别是狗检测器」。4
它给的理由也写得很清楚——车和狗不同时出现,所以后层可以照常把狗特征取回来。4
按他现在的读法,车和狗被放在一起是因为共享的姿态。InceptionV1 里有一百多个这类广义姿态神经元,每一个都干净利落,只是检测对象横跨车和狗。1
这里有他全篇最重的一句断言:那个「折起来藏好、等下游来取」的读法,实测下来找不到对应的读出结构。
「没有任何东西读那个组合。」1
那为什么会看错?他给了三个原因。
一是缺知识——当年不知道有广义姿态神经元这种东西。1
二是工具本身在骗人。特征可视化靠梯度下降去找「最能让这个神经元兴奋的图」,而梯度下降会走最省事的那条路。1
InceptionV1 的训练数据里狗很多、狗神经元也很多,优化一旦掉进去就再没出来。1
三是架构。InceptionV1 后半段本身就学坏了,后期层「溢出」,看上去像一堆任意的混合物。1
有一点值得单独指出:这不是他第一次说工具在骗人。6
2021 年的《多模态神经元》里,同一批作者写过一个后来被遗忘的说法——有些概念「在一个切面上浅浅地重叠,然后向多个方向泛化出去」。他这次把那个说法翻出来,改了名字,当成主要解释。6
03 那串百分比,分别属于哪个模型
同一个 InceptionV1 的最后一层,他给了一串递进的数字。1
在他回忆中,那一层当年约 5% 的神经元可解释;换成更好的工具、模型不动,约 50%;把同一个架构用更合理的现代正则化重训,约 70%;同规模、但换成现代架构的 ConvNeXt,约 99%。1
文章副题里那句「99–100%」,指的是最后那个模型。1
同一段里他自己写明,2014 年那个原版模型的检查点和训练细节已经丢失,所以 5% 和 50% 这两个数只能算回忆。1
换句话说,标题级的那句「几乎全部可解释」,靠的是换架构,不是换工具。
语言模型那侧量级接近。他在文里说明,这一部分是和同事 Curt Tigges 一起做的,所以这一节他改用「我们」。1
在一批 Qwen3-32B 神经元的初步审计里,他们估计约 90% 的神经元极点只有一个主职责,约 7% 有两个相关的职责,只有 2–4% 尚未理解。1
(一个神经元有正负两个极,他这里是把两极分开数的。)1
这个比例他自己在脚注里拆得很细。1
弱激活的阈值怎么设、看第几层、子电路密度多大、以及「算不算一件事」,都会让它变;只看强激活时接近 97%;样本不大。1
他还专门说,把所有东西压成一个「干净度」分数,只该当成「网络处在哪个区间」的粗略指针,不该拿去直接优化。1
作为对照,这块地过去的两把尺子长这样。注意它们是两把不同的尺子,不能互换。1
第一把是人工盲评。Anthropic 2023 年的《Towards Monosemanticity》研究一个小规模单层模型,那个模型的 MLP 层有 512 个神经元;论文让人按满分 14 分的评分表给「特征激活区间」打分。7
结论分两半:中位数神经元 0 分——评分人连一个假设都形成不了;而中位数特征区间是 12 分。7
这个对比本身就是论文想说的话:换成「特征」这个单位,同一批激活就变得能读了。整套一共打了 412 个区间,覆盖 162 个特征与神经元,样本小是论文自己承认的。7
第二把是自动打分。他自己 2023 年在 OpenAI 启动的那个项目,测了 GPT-2 XL 全部 307,200 个 MLP 神经元。8
做法是让模型先写解释,再按解释去「模拟」该神经元在没见过的文本上的激活,最后算模拟值与真实值的相关系数,门槛取 0.7。8
过线的比例是 1.7%;只算随机样本的口径下掉到 0.2%;过 0.9 的只有 189 个,占 0.06%。论文当时写下的结论是:「这提示我们该换一个解释对象了。」8
他们把 GPT-2 XL 重做了一遍。同一批模型上,约 70% 的神经元「像是一件事」,而真正干净的仍只有约 5%。1
04 他给的替代机制:递归泛化
否定掉叠加之后,他得给一个替代品。他叫它「递归泛化」。1
定义很简单:一个神经元在长大的过程中,沿着不止一个方向泛化出去,像树枝长出子枝。1
他给的例子好懂。一个负责「iy」这个字母组合的神经元,先管到「Miyazaki」(宫崎骏),接着管到「diy」,再接着管到「do it yourself」——而到这个短语里,「iy」已经不存在了。1
顺着这条线,他把语言模型里那些「看起来最乱」的神经元一个个翻了过去。1
有个被自动标注工具判成「多义逗号神经元」的,实际跟踪下来是在追踪科罗拉多州:区号 303、丹佛的地名、当地的俚语。逗号只是注意力存放当前语境摘要的位置,它等到科罗拉多出现才开始亮。1
这个替换为什么重要?因为两条路线给的下一步动作是相反的。
递归泛化说的是一根枝上的东西在语义空间里彼此相邻,顺着长势能理出来;叠加说的是它们之间没有线索可学。两者对「要不要继续挖这个神经元」给出完全不同的答案。1
他还翻转了一个沿用了很久的视角:过去把负极点理解成一个神经元的「反面」,他建议把它当成电路里的门——正极让一类东西过去,负极把另一类挡在外面。1
这个视角在他给的例子里很直观。在 Qwen3-32B 里解一道「谁吃了饼干」的题,答案指向圣诞老人。1
真正起作用的那几个神经元是强烈为负的,它们的负极点上才是圣诞老人那套语境。1
把带圣诞老人负极点的八个神经元拿掉,模型答案从接近确定掉到 6%,转去怪家里的宠物。1
顺着同一个视角,他们还找到一处架构层面的毛病:SwiGLU 神经元有一小块「双负」区间,会让激活值跑进正极点,看起来却像负极点。1
对大约 4% 的神经元来说,这块「回声」占据了激活列表的最顶端。他在文里直接向架构设计者喊话,请他们把这个问题修掉。1
05 反对与保留
第一种反对是不给理由的否定。
我到现在还没见过任何一个不在 OpenAI 或 Goodfire 工作的人认为这是件大事。我个人认为它 a) 明显是错的,b) 提供的证据不值得回应。
第二种反对则把理由讲了出来。
Liv Gorton 在文章上线约两小时四十六分钟后发出一串逐条反驳,开头第一句先给分寸。11
我非常尊重 Nick,而且如果神经网络比我们想的容易理解得多,我会非常高兴。但我认为这里的论证误述了叠加所预测的东西。
她的核心质疑是定义问题:叠加说的本来就是「模型持有的概念比它拥有的神经元更多」,而不是「神经元会随便乱装东西」。12
按这个读法,作者看到的树枝状泛化并不构成对叠加的反驳。12
这个质疑正好打在要害上。文章花了整整一节讨论「叠加」这个词在过去几年被用成了好几个意思,并明确说自己只取其中一个版本——「神经元因为互不干扰而把无关的东西学到一起」。所以作者与 Gorton 争的不是数据,而是「叠加」到底指什么。1
Google DeepMind 机械可解释性团队负责人 Neel Nanda 质疑的方向和 Gorton 接近,措辞更客气,也更冷。13
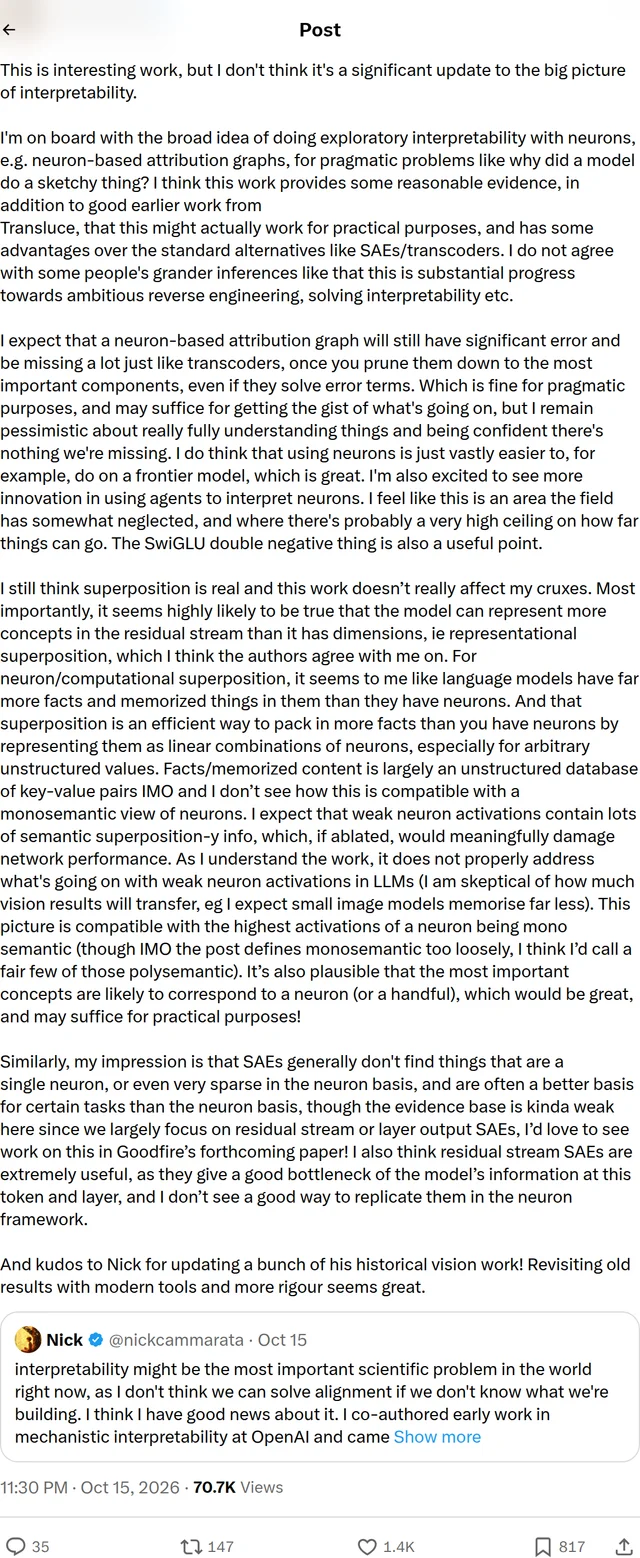
这是有意思的工作,但我不认为它显著改变可解释性的整体图景。
他补了几条具体的。他仍然认为叠加是真的,尤其是「模型能在残差流里表示比它维度更多的概念」这一点。13
他说这篇文没有真正处理弱激活,而他预期弱激活里装着大量语义上的叠加信息。13
他还认为文章把「单一含义」定义得太松——按他的标准,那批被算作干净的神经元里有一批该叫多义。13
还有两位的落点又不一样。OpenAI 战略前瞻负责人 Dean Ball 在 10 月 16 日写了一篇长文叫《生长出来的东西的美》,标题就接着作者那个「神创论到自然选择」的类比。14
他给了一句留有余地的判断:「Cammarata 完全可能是错的;也可能他对自己那个突破的判断是对的,只是对它的意义判断错了。」14
斯坦福应用物理博士生 Mason Kamb 挑的是另一处:他认为这个领域一直缺的能力,是回答「这些东西为什么会在这里」,而不只是描述「这里有什么」。15
按他的说法,这篇文章把训练动态带了进来,「方向上是对的」——前提是结果经得起检验。15
06 叫好的一方,和一篇还没出来的论文
读懂这篇文的人,站的位置并不中立。
作者在 Goodfire 任职,这家公司卖的就是理解与监控模型内部的产品。16
它 2025 年 4 月的 5000 万美元 A 轮由 Menlo Ventures 领投,Anthropic 参与出资。16
Dario Amodei 还在这份公告里留了一段话,说这笔投资反映的是他们相信机械可解释性是「把黑箱网络变成可理解、可操控系统的最好赌注之一」。16
作者自己的处理方式有两条。文章末尾写着「任何错误,以及这里的观点,都是我的」。1
10 月 17 日凌晨,他又补了一条长帖,说「兴奋太多也会带来问题」,并解释乐观情绪为什么会在这个领域被格外放大。17
最后一件必须写清楚的事:技术姊妹论文还没出来。
那一串百分比里最需要被检验的部分——语言模型的实验细节——都留在那篇还没发布的论文里。1
07 他挑战的共识,这个领域自己已经在松手
那个默认假设确实是写明了、可查的。
2024 年 7 月,Anthropic 在讲自家方法时写:找出可解释特征这一步,「历史上被叠加严重阻塞」。19
2025 年 3 月,Anthropic 又把这件事写成了更标准的说法:真实语言模型里「神经元通常是多义的」,而这个现象「被认为部分源于一种叫叠加的机制」——模型表示的概念比它拥有的神经元更多。20
但真正的变化发生得更早:这个领域最主流的可解释性路线,在 2025 年自己调过一次头。
2025 年 3 月,Google DeepMind 的可解释性团队发布了一批负面结果,随后做出一个很少见的表态。21
他们的原话是:「我们暂时降低基础稀疏自编码器(sparse autoencoder,SAE)研究的优先级,转向别的方向」,并推测「这个领域在这上面投入过度」。21
所以 Cammarata 推的这块石头,主要玩家已经不再全力压在上面了。21
但这不等于叠加被取消了。2025 年,Anthropic 说他们在真实语言模型里「找到了显著的注意力叠加证据」;另有一批工作把叠加解释成语言模型缩放规律的来源。24
更准确的说法是:叠加的适用边界被压缩了,而不是被删掉了。
他自己把话说得很窄——他断言的是「没有人发表过第二个同形的电路」。这条断言与本轮的检索结果一致,但也只是「没找到」,不是「不存在」。1
至于两条研究路线的分歧,他给它们起了名字。1
一条叫枚举式:先假设有一大堆特征,然后想办法把它们都抽出来,为此不断设计更精巧的重建目标。1
另一条叫探索式:从问题出发,在神经元、注意力头、归因图之间自由缩放,边走边发现问题。1
他说这个领域是从第一条路开始的,后来退到第二条——退的理由是网络看着像一团解不开的结。而他现在的判断是,那个结不存在。1
值得一提的是他借的方法是谁的。20
文章里语言模型实验的起点,是 Anthropic 那篇归因图研究里的医疗诊断图。他保留了方法,换掉了拆解的对象:Anthropic 那边用的是 transcoder 抽出来的特征,他换成了 Qwen3-32B 里原始的 MLP 神经元。20
他还顺手引了同一批作者自己的方法论文:他们最大的那个 transcoder,「只有一半的时候」能预测出和原模型相同的下一个词。25
这一句的杀伤力在于:如果抽特征是为了让模型变得可读,而抽出来的东西只有一半时候能对上原模型的下一个词,那这套中介物到底是在帮忙还是在挡路,就该重新问一遍。
同一周还有另一条路径,处理的是同一个问题——怎么让外面的人核对 AI 到底在想什么。26
10 月 17 日凌晨,Sam Altman 发帖展示一件纪念衫的背面,说印在上面的是解出纳维–斯托克斯那道题时,模型思维链的最后一行。26
10 月 15 日,OpenAI 又在那篇发布数学结果的文章上挂了一段更新:出 500 万美元,支持西蒙斯基金会一项帮助数学家审查与理解 AI 所产结果的新计划。27
Cammarata 的答案是让外面的人自己去读模型内部;OpenAI 这条线的答案是让模型把想法说出来,再想办法让数学界能审它。两者关心的是同一个词,落在完全不同的位置。
Cammarata 那篇文的开头,恰好是把这两条路并排放在一起的一句:「我认为,如果我们不知道自己在造什么,我们就解决不了对齐。」1
08 现在能核对的,和还不能核对的
能核对的东西,这篇文几乎全部放在了外面。1
它配了一个可以直接点开的显微镜,覆盖四个不同规模的网络,逐个神经元给出特征可视化、真实图片里的最强响应和负极点。1
另有一个把上千个神经元按高层归因流铺成地图的界面。1
它还放了一份纯文本版全文,专门写给阅读工具和 AI 代理用。1
如果只看一条外部线索,可以看它自己列在「Prior work」第一条的那篇论文。28
那篇论文的标题是《语言模型电路在神经元基下是稀疏的》——它本身就是这篇文章主张的前身。28
也就是说,早在这篇长文之前,已经有人认为神经元这个单位值得重新认真对待,只是那个声音没有传开。28
至于这篇长文到底对不对,现在还没有人能下这个判断。
真正会决定它是「一次更新」还是「一次过度更新」的,是那篇还没发出来的技术论文。1
References
- 1Neural Networks Are Already Clean(Goodfire,2026-10)
already-clean.goodfire.com
- 2
- 3
- 4
- 5Feature Visualization(Distill,2017-11-07)
distill.pub
- 6
- 7Towards Monosemanticity: Decomposing Language Models With Dictionary Learning(2023-10-04)
transformer-circuits.pub
- 8Language models can explain neurons in language models(OpenAI,2023-05-09)
openaipublic.blob.core.windows.net
- 9
- 10
- 11
- 12
- 13
- 14Hyperdimensional:The Beauty of Something Grown(2026-10-16)
hyperdimensional.co
- 15
- 16
- 17
- 18Goodfire Research 索引
goodfire.com
- 19Circuits Updates – July 2024(Transformer Circuits)
transformer-circuits.pub
- 20On the Biology of a Large Language Model(Transformer Circuits,2025-03-27)
transformer-circuits.pub
- 21Negative Results for Sparse Autoencoders On Downstream Tasks and Deprioritising SAE Research(Google DeepMind,2025-03-26)
deepmindsafetyresearch.medium.com
- 22
- 23
- 24Progress on Attention(Transformer Circuits,2025)
transformer-circuits.pub
- 25Circuit Tracing: Revealing Computational Graphs in Language Models(Transformer Circuits,2025)
transformer-circuits.pub
- 26
- 27
- 28
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.