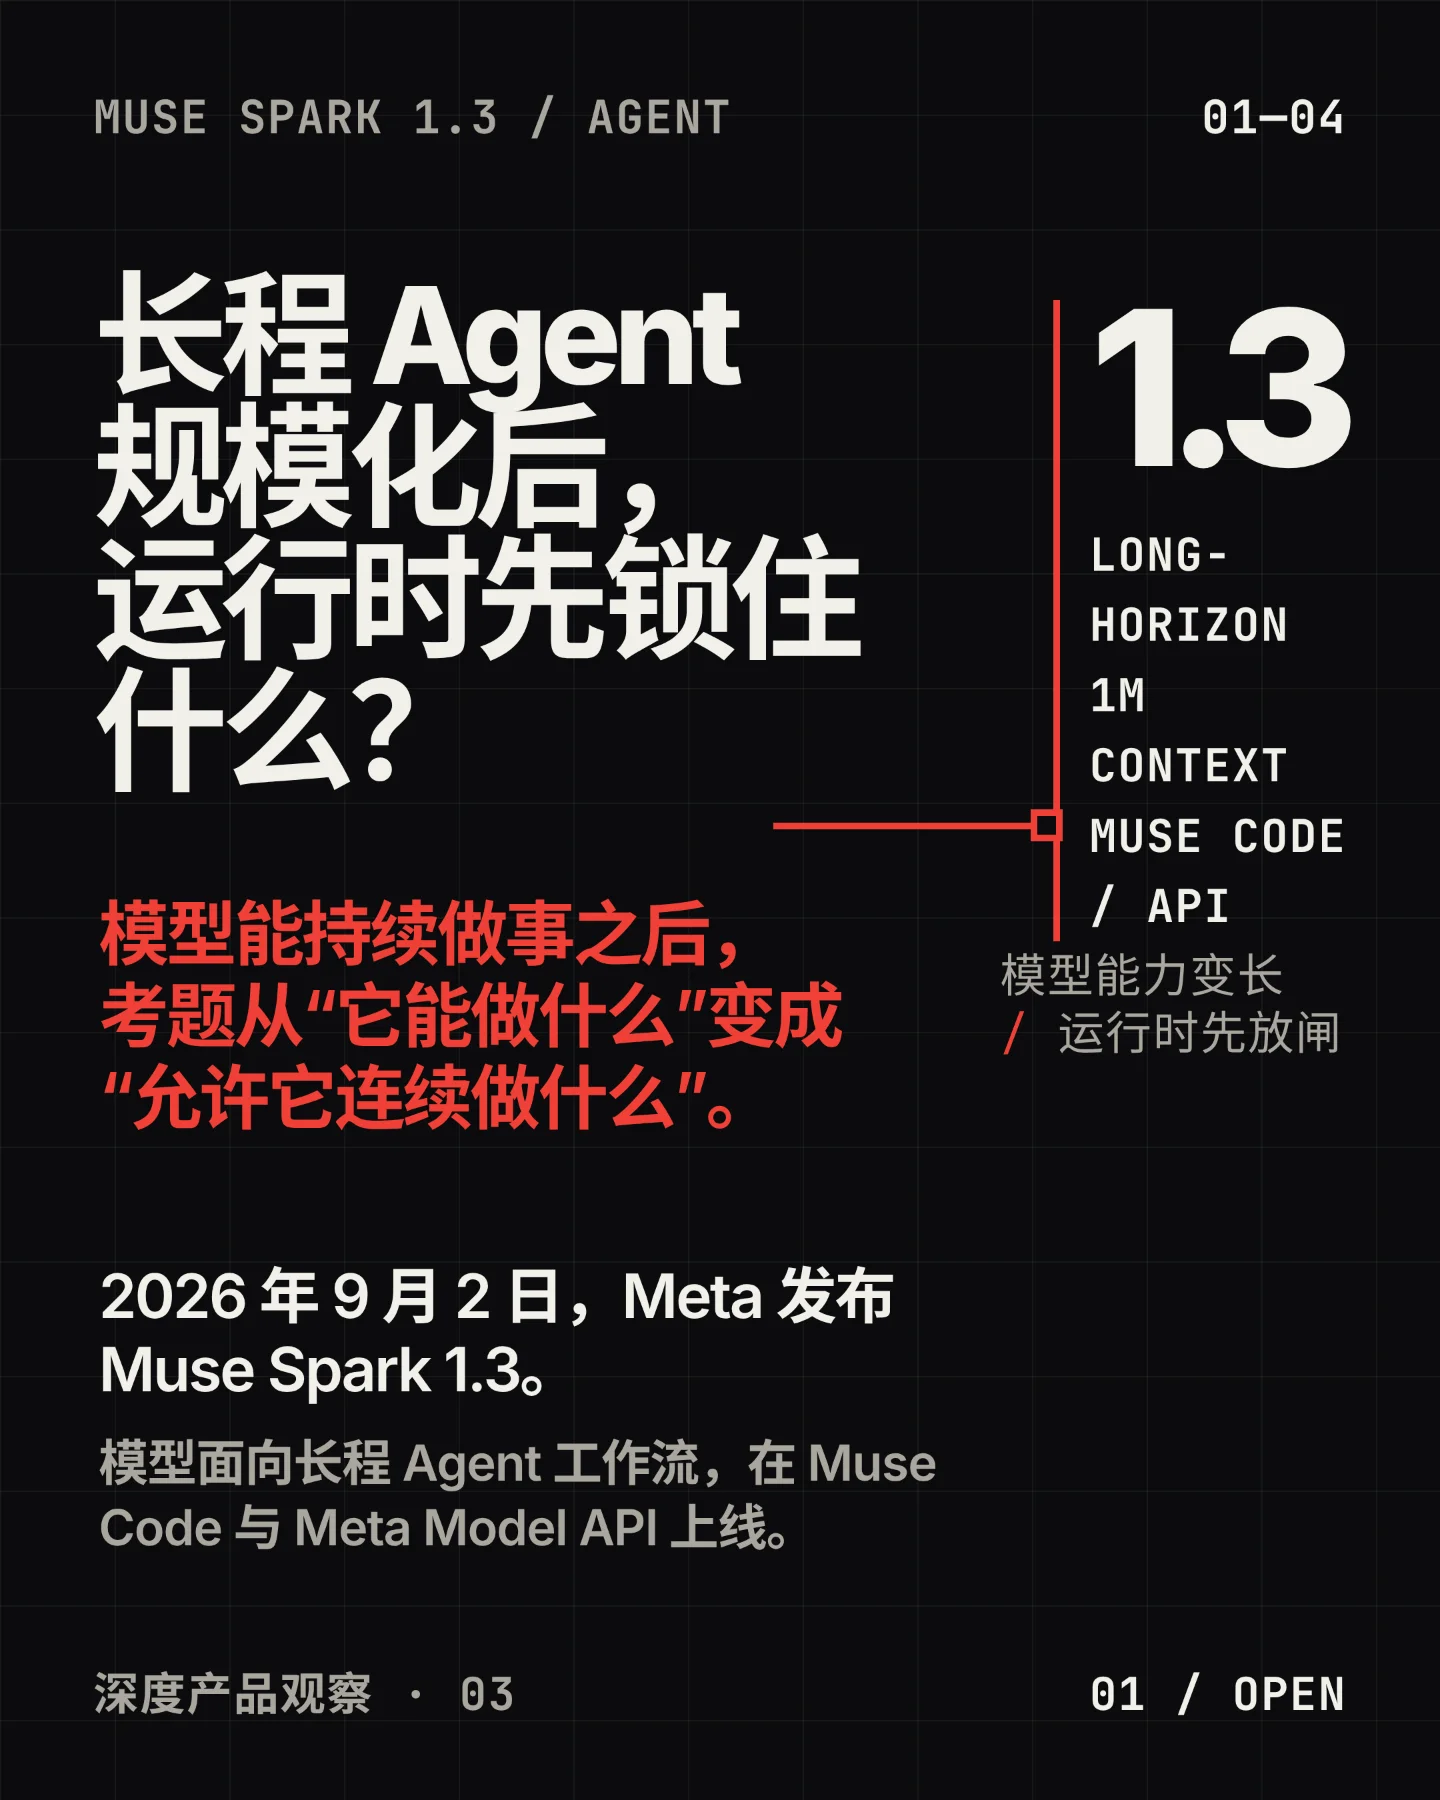
2026 年 9 月 2 日,Meta AI Research 发布 Muse Spark 1.3。官方公告称,1.3 当天在 Muse Code 与 Meta Model API 推出,模型面向长程 Agent 工作流和竞赛级编码;官方模型页把上下文窗口标为 1M。12
同一 24 小时窗口内,Google 也发布了 Gemini 3.8 Flash 与 Gemini 3.8 Flash Cyber。Google 把 Flash 定位为工作模型,把 Cyber 通过 Fairwind Program 提供给可信防御者。两家公司的公告各自选择了不同的对照模型和评测口径,因此同日发布足以构成竞争信号;跨厂商排名仍需独立横评。3
这次更新值得产品团队判断的问题是:当模型可以连续做事,企业应该先锁住什么?
我的判断是,长程 Agent 的产品门槛正在从“模型会不会完成某个动作”移到“哪些动作必须在运行时停下来确认”。Muse Spark 1.3 把长线程、多工作流、工具调用和代码工作放到一个产品叙事里;企业要补上的,是身份、范围、确认、审计和回退之间的连接。
1. 发生了什么:一次回答开始变成一段持续工作
Meta 对 Muse Spark 1.3 的官方定位包括长程 Agent 工作流、编码和原生多模态感知。公告把长程行为说得很具体:模型可以在单一长线程里与用户协作、同时管理多个工作流;模型会为开放目标生成上下文、修正计划缺口、追踪已经获得的信息;提示词含糊时,模型会先提问,遇到困难时会求助,重大动作前会请求确认。1
官方模型页和 Muse Code 产品页还把 multi-agent orchestration、agent fan-out、computer use、GitHub agent 等用法列为开发入口,并把 Muse Code 描述为“Multi-agent by default”和“Fully auditable”。这些页面证明了官方支持的使用路径,公告正文对 1.3 新增能力的重点仍然是长程 agentic 工作和编码改进。24
Meta 工程师还称,1.3 相比 1.2 约少 20% 工具调用、约少 25% token。这个比例属于 Meta 自己的比较;本期把它保留为效率假设,产品团队可以用自己的任务、工具和失败样本验证。1
1M 上下文窗口会让 Agent 更容易保留长任务中的代码、文档、工具结果和历史决策。OpenRouter 的独立模型页也把窗口写成 1,048,576 tokens。上下文变长解决了模型记住更多信息的问题,运行时仍然要决定哪些信息可以被读取、哪些工具可以被调用、哪些结果可以改变下一步。25
2. 为什么长程能力会改变产品风险
一次性回答的主要交付物是一段文字、一个代码片段或一个结构化结果。长程 Agent 的交付物是一条行动链:模型读取材料,调用工具,看到反馈,重写计划,再次调用工具,最后写入某个系统。
行动链每延长一步,任务状态就会多保存一层,重试就会多出一条路径,写入动作就会多留下一个副作用。开头的授权很快会遇到后续状态里的新对象;一个“允许处理代码”的授权,还需要单独规定推送分支、发布版本和删除数据的权限。
Meta 把“重大动作前请求确认”写进了模型行为描述。企业需要把这句话变成运行时条件:系统要识别正在行动的身份、代表的用户、目标工具、具体参数、影响范围、有效时间和审批人。模型负责提出下一步,策略服务负责判断下一步是否放行,执行器负责把放行结果落实到具体工具。
模型自己判断“这个动作重大”,与企业定义“这个动作不可逆”,也可能出现偏差。企业的不可逆动作可以包括发版、发消息、修改权限、转账和删除数据;企业还要把故障预算、合规期限和业务优先级显式接入运行时策略,提示词负责传递模型实际获得的上下文。运行时确认点应由模型外部的策略和执行层承载。
3. 同日发布说明了什么:能力正在和访问门槛一起交付
Google 在同日发布 Gemini 3.8 Flash 与 Cyber 版。Google 对 Cyber 版采用 Fairwind Program,只向可信防御者开放;这套安排把组织、身份、岗位和用途放到模型访问之前。客户获得模型访问权以后,仍然要决定模型能进入哪些代码库、调用哪些工具、使用哪些凭证以及写入哪些分支。3
Meta 的 1.3 也把使用方式分成不同档位。官方模型页把
muse-spark-1.3 标为数据“不用于改进产品”,把 muse-spark-1.3-contributor 标为数据“用于改进产品”。这项差异会影响企业选择接口档位、处理敏感代码的方式和采购评估,产品负责人需要把数据用途和工具权限放在同一张上线清单里。2两次发布提供的是产品路线信号,跨厂商适用性仍要回到企业自己的任务和控制条件。两次发布共同把产品问题推到了同一个位置:模型提供商负责提升连续工作能力,也开始用组织、身份和用途收紧高风险能力;客户负责把自己的凭证、工具和写入边界接到每一次动作上。
4. Scorecard 衡量能力,运行时决定许可
Meta 的官方 Scorecard 把 Muse Spark 1.3、Muse Spark 1.2、GPT 5.6 Sol(max)和 Opus 5(max)放在 Agent、Long Context、Coding 等维度中比较。1.3 在表中显示:MRCR 512K–1M 为 98.1,Terminal-Bench 2.1 为 88.8,OSWorld 2.0 为 66.9。同一张表里,Opus 5(max)在 OSWorld 2.0 为 68.3,在 Terminal-Bench 2.1 为 86.7。这些数字支持“模型在特定评测里表现强弱”的判断。1
官方评测方法同时写明,1.3 和 1.2 使用 xhigh 推理强度,对照模型使用 max;编码环境关闭外网,工具和 harness(测试工具链)受到限制,未评分和拒答结果按 0 分计入分母,第三方模型采用尽力而为的运行方式。6
发布公告还说,1.3 的 max reasoning 要等额外安全测试完成后推出。于是,评测表里的推理档位、评测时的运行配置和发布当天客户可以使用的档位,需要分别核对。一个分数可以帮助团队估算能力上限;生产权限仍由企业的运行时规则发放。1
5. 企业可以怎样安排第一轮上线
第一步,列出不可逆动作。 团队先把改代码、发消息、修改权限、转账和删数据分开列出,再给每类动作写回退条件。这个清单把“重大动作”从模型的模糊判断变成企业自己的边界。
第二步,把确认点放在动作之前。 Agent 需要先说明意图、参数、目标对象和预期影响。人工审批或策略服务确认之后,执行器才发放本次动作需要的凭证。确认点越靠近实际写入,审批越能看到真实参数。
第三步,把权限绑定到动作。 工具、身份、凭证、仓库、分支、时间和预算都应按最小范围配置。长上下文可以让模型看到更多内容;模型能够写入的范围仍由企业权限配置决定。
第四步,把停止和回退接回运行时。 团队需要保存每次读取、调用、审批、写入和重试的记录,并在隔离环境里运行测试。小范围变更先进入人工审核和金丝雀环境,自动回滚与人工停止经过验证以后,再考虑扩大权限。
这套顺序把模型的连续工作能力放进一个可以观察、暂停、复核和重建的行动链。产品负责人获得的是一组可验证的上线条件,安全团队获得的是每次放行的审计入口,开发者获得的是可以逐步扩大的工具范围。
结论:先验证“哪一步必须问”,再验证模型能走多远
Muse Spark 1.3 的发布把长程 Agent 的可用性又向前推了一步:更长的上下文、更连续的工作方式、更明确的工具和代码入口,都在减少人类逐步接管任务的频率。Meta 同时把“含糊时提问、卡住时求助、重大动作前确认”写进模型的官方行为描述。
产品团队接下来最值得验证的变量,是确认点的位置和执行层的边界。只读任务可以先让团队观察模型怎样规划、调用工具和处理失败;写入任务需要隔离环境、逐步审批、短期凭证、完整审计和回退路径;只有当这些条件经得起真实任务验证,企业才有依据扩大长程权限。
模型判断的“不可逆”是否等于企业定义的“不可逆”,仍然是一个需要在具体系统里测试的问题。这个问题的答案,决定了长程 Agent 能走多远。
References
- 1Introducing Muse Spark 1.3
research.meta.ai
- 2Muse Spark 1.3 | Meta
developer.meta.com
- 3
- 4Muse Code
developer.meta.com
- 5Muse Spark 1.3
openrouter.ai
- 6Muse Spark 1.3 Evaluation Methodology
research.meta.ai
Comments