8月21日 AI 早报:Google 用认股权证锁定定制芯片,巴西押注主权算力
过去24小时的五条全球 AI 进展显示,定制芯片、内存研究、主权算力、治理议题与 AI 生成内容正在共同决定 AI 如何落地。
覆盖时间:2026 年 8 月 20 日 07:45 至 8 月 21 日 07:45(上海时间)。本期按产业影响力、落地程度,以及对 AI 运行条件的牵引力排序。
过去一天,最值得看的变化集中在模型之外:云厂商开始用定制芯片协议锁定供应商,内存研究被当成 AI 基础设施的长期战略,国家算力计划同时处理技术与主权,OpenAI 把治理问题写进新团队的任务书,互联网文本也出现了更明显的 AI 生成痕迹。
| 排名 | 发生了什么 | 读者该记住什么 |
|---|---|---|
| 1 | Marvell 披露与 Google 扩大定制芯片合作,并向 Google 发行最多 5,897.1 万股的认股权证,执行价为每股 206.58 美元。1 | 云厂商正在用长期采购承诺换取定制 AI 芯片能力;约 121.8 亿美元是按执行价计算的名义规模,不是 Google 当天支付的金额。 |
| 2 | Micron 宣布在美国建立专门的内存研究实验室,计划未来十年投入 100 亿美元,预计 2027 年动工。2 | 高带宽内存已经从配套部件变成 AI 计算扩张中的战略瓶颈,内存技术会和 GPU、计算系统一起决定扩张速度。 |
| 3 | 巴西政府宣布约 23 亿雷亚尔(约 4.442 亿美元)的 AI 生态投资,其中 13 亿雷亚尔用于与华为、科大讯飞合作的里约热内卢超算基础设施,另有约 10 亿雷亚尔用于招标建设另一台超算。3 | 国家 AI 计划正在同时回答「算力从哪里来」和「不要依赖单一国家或公司」两个问题;这些是分阶段投资与建设计划,不是已经上线的算力。 |
| 4 | OpenAI 启动 Strategic Futures 团队和 AI Futures 博客,首篇文章把变革性 AI 对个人权利、代理能力和权力集中的影响列为长期议题。4 | 前沿公司的竞争已经延伸到治理叙事:OpenAI 正公开讨论如何约束权力集中,但这篇文章明确代表作者观点,不等同于 OpenAI 全组织立场。 |
| 5 | Pew Research Center 用近 49 万个英文网页研究 AI 署名迹象;2026 年 7 月抽取的 1 万页中,约 10% 显示出明显的 AI 写作或编辑迹象。5 | AI 对互联网的影响已经可以从大样本文本统计中观察到,但检测结果是概率信号,不是逐页确认作者身份。 |
1. Google 用认股权证锁定 Marvell 的定制芯片能力
发生了什么。 Marvell 在 8 月 19 日提交的 8-K 中披露,公司与 Google 于 7 月 29 日签署了扩大合作的商业协议,范围覆盖连接 Google TPU 生态的多类定制半导体,包括 AI 推理加速器、存储控制器、网络接口控制器、内存接口控制器和近内存计算。8 月 18 日,Marvell 又向 Google 发行了最多 58,970,907 股的认股权证,执行价为每股 206.58 美元。1
按执行价计算,这份认股权证对应约 121.8 亿美元的名义规模。Google 需要满足归属条件才能获得相应股份:其中 1,360,867 股按时间分期归属,其余股份分成 240 个等额批次,每当 Google 或关联方购买的定制产品收入达到 5 亿美元,就对应一个批次。权证有效期到 2033 年 8 月 18 日。1
背景。 定制芯片指为特定公司的计算架构或工作负载设计的芯片。Google 既有 TPU,也需要存储、网络和内存之间的协同;Marvell 的披露显示,双方合作已经越过单一加速器,覆盖到整套数据中心数据流。
为何重要。 这份协议把采购量、芯片设计和股权激励绑在了一起。Google 得到更强的定制化供应保障,Marvell 则把未来收入预期写进了权证归属条件。对其他云厂商和芯片公司的启示是,AI 芯片竞争正在从「谁有最快的通用 GPU」变成「谁能把计算、内存、网络和软件一起做成自己的系统」。
2. Micron 用 100 亿美元押注 AI 内存研究
发生了什么。 Micron 8 月 20 日宣布成立 Micron Research Labs,并计划在未来十年投入 100 亿美元,研究内存技术、计算系统和未来芯片制造。Reuters 报道,实验室设在爱达荷州博伊西,预计 2027 年动工,计划容纳数百名研究人员,并连接 Micron 在美国、欧洲、日本、印度、新加坡和中国台湾的研发网络。2
背景。 高带宽内存(HBM)负责把数据快速送到 AI 加速器。模型规模和并发推理一起增长时,计算芯片能做多少运算只是一个限制,内存能否持续供数也是限制。Micron 的新实验室还计划把客户、高校、政府和半导体产业链放进同一个研究网络。2
为何重要。 这笔投入的信号比实验室本身更大:AI 基础设施的瓶颈正在从「买更多加速器」扩展到「怎样让数据更快、更省电地流过整个系统」。Micron 把内存研发与计算系统、制造能力放在同一个十年计划里,说明内存供应商希望参与定义下一代 AI 机器,而不是只在模型公司需要时提供标准部件。项目仍处于宣布和筹建阶段,实际产出要等动工与后续研发结果。
3. 巴西把 AI 超算分成中美两条供应链
发生了什么。 巴西政府 8 月 20 日宣布约 23 亿雷亚尔(约 4.442 亿美元)的 AI 生态投资。Reuters 报道,其中略超过一半、即 13 亿雷亚尔将用于里约热内卢的超算基础设施项目,合作方包括华为和科大讯飞;政府希望这套基础设施主要用于开发通用和行业大模型。另有约 10 亿雷亚尔将通过招标投入另一台超算,地点在北里奥格兰德州,政府预计它进入全球 AI 处理能力最强的十台机器之列。3
这两项建设都还没有变成现成算力。巴西政府预计另一台超算在 2027 年年底前开始运行,与中国公司的合作协议计划于 2027 年 7 月启动。资金来自巴西国家科学技术发展基金(FNDCT),政府同时宣布了基于开放 RISC-V 架构的芯片合作、公共—私人云服务计划,以及未来建设可信 AI 和算法透明度中心的安排。3
背景。 巴西总统卢拉政府把这组投资放在「数据主权」和战略自主的语境中。项目一边使用中国企业的基础设施经验,另一边通过招标与美国芯片供应商竞争,并没有把国家算力押在单一供应商上。
为何重要。 这不是一项单纯的采购新闻。对没有美国或中国同等资本规模的国家来说,AI 产业政策必须同时处理算力、能源、数据和供应链外交。巴西的方案把超算、开放硬件和公共云放在同一张图上;它能否形成可持续的本土模型与公共服务能力,要看项目能否按期上线,以及后续是否有稳定的数据、人才和使用场景。
4. OpenAI 把「谁拥有 AI 带来的权力」写进新团队任务
发生了什么。 OpenAI 8 月 20 日推出 Strategic Futures 团队和 AI Futures 博客。首篇文章由 Dean Ball 撰写,提出团队要回答一个问题:在变革性 AI 出现的同时,自由社会应如何保留个人权利和行动能力。文章把权力集中列为长期 AI 安全与政策讨论中最严重、也最难处理的风险之一。4
文章的观点包括:个人应保有使用 AI 的自主权;技术滥用应由个人承担责任;需要集体行动的风险应尽量限定范围;法律应尽可能帮助个人和小组织,而不是把权力继续集中;高风险行动应能追溯到负责的人或受人控制的组织,同时把隐私放在制度设计的核心。文章还明确说明,这些内容代表作者观点,不一定代表其他 OpenAI 员工或 OpenAI 组织本身的立场。4
背景。 过去的 AI 治理讨论更常围绕模型是否安全、公司是否应暂停训练,或政府如何制定规则。Strategic Futures 这篇文章把问题往前推了一步:如果 AI 能替代部分劳动、行政和安全执行,社会还怎样让权力依赖普通人的同意与参与?
为何重要。 这是治理方向的公开立场文章,不是新模型、监管规则或已经执行的制度。它仍然值得关注,因为 OpenAI 把「权力集中」单独设为团队长期议题,意味着公司开始为模型能力之外的政治经济后果建立持续的研究入口。后续真正有分量的内容,要看这个团队是否提出可执行的制度方案,以及这些方案怎样处理安全、增长、隐私和个人控制之间的冲突。
5. Pew:2026 年约一成网页出现明显 AI 署名迹象
发生了什么。 Pew Research Center 使用 Common Crawl 网页档案,收集了 2021 年 1 月至 2026 年 7 月期间近 49 万个英文网页文本,再用 Pangram 的 Open Pangram AI 检测模型分析文本中是否出现更常见于 AI 写作或编辑的语言模式。研究团队在 2026 年 7 月随机抽取的 1 万个网页中发现,约 10% 显示出明显的 AI 署名迹象;如果只看 ChatGPT 发布后上线的网页,这个比例超过三分之一。5
Pew 按顶级域名拆分后,2026 年的六个月平均值约为:
.com 网页 9.4%,.org 网页 4.6%,.edu 网页 1%,.gov 网页 0.8% 显示出明显的 AI 编辑或署名迹象。.com 的比例大约是 .org 的两倍,是 .edu 和 .gov 的近十倍。5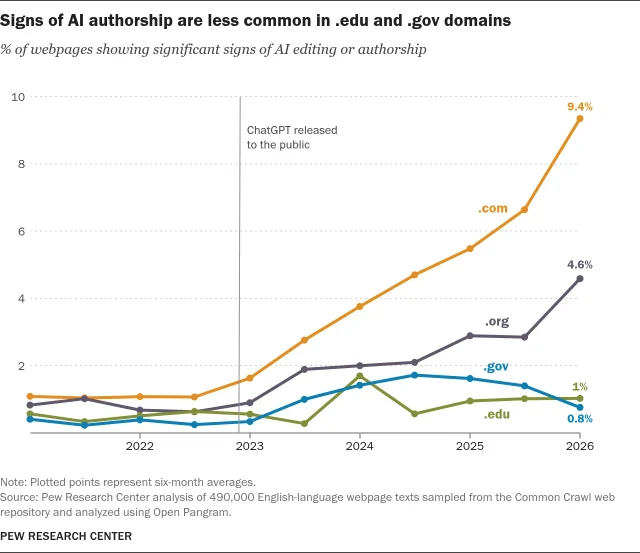
背景。 这项研究检测的是文本统计特征,例如词语选择、标点和句式模式。检测模型会把人类写作误判为 AI 写作,也会漏掉 AI 生成文本;单个网页的检测结果因此只能表示一种可能性,不能单独证明作者身份。5
为何重要。 这组结果把「网上 AI 内容变多了」从体感变成了可重复检查的大样本问题。不同域名的差异也提醒读者,AI 文本进入互联网的速度与内容类型、发布主体和编辑流程有关。对搜索、媒体、研究和知识库来说,接下来的难题不只是识别一段文字是否由 AI 参与生成,还包括怎样保留来源、编辑责任和可核验的事实链。
今天的共同线索
这五条消息把同一个变化拆成了五个具体部分:Marvell 和 Google 在重写定制芯片的供应关系,Micron 把内存研发提升到十年战略,巴西把算力建设与国家自主放在一起,OpenAI 开始公开讨论 AI 如何重新分配权力,Pew 则测到了 AI 语言特征在网页上的扩散。12345
因此,今天判断一家 AI 公司或一个国家的进展,不能只看模型榜单。还要继续看四个可验证的条件:定制芯片能否交付,内存和能源能否跟上,国家算力能否按计划上线,AI 生成内容能否留下清楚的来源与责任链。
References
- 1August 19, 2026 - 8-K: Current report
investor.marvell.com
- 2
- 3
- 4Introducing AI Futures
openai.com
- 5How Much of the Internet Is Written With AI?
pewresearch.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.
Related content
More from this channel
- 8月26日 AI 早报:Jalapeño 首批实测,Apple 推 M6 与 M5 Ultra
- 8月25日 AI 早报:Wan3.0 上线,GPT-5.6 进入 Kiro,英乌启动 AI 防务合作
- 8月24日 AI 早报:阿里巴巴定价 800 亿港元配股,Ox Alpha 开发者仍是谜
- 8月23日 AI 早报:NVIDIA 服务器或涨价超15%,OpenAI 转向支持加强 SB 53
- 8月20日 AI 早报:Stripe 正式确认收购 OpenRouter,OpenAI 预览跨交互安全处理
- 8月19日 AI 早报:OpenAI 暂停前沿训练,FDA 开始讨论生成式医疗器械规则
- 8月18日 AI 早报:NVIDIA 为俄亥俄算力项目提供 1050 亿美元担保,Google 关停 Imagen
- 8月17日 AI 早报:Stripe 传出 70 亿美元收购 OpenRouter,AI 同时面对价格与信任账单