企业 AI agent 的正确答案,取决于它在 19:05 看到了什么
微软作者提出的时间点回放方法显示,企业 agent 的答案必须绑定提问时刻与角色权限;静态终态快照会把泄露未来误判成能力,并把真正的人工复核位置藏起来。

支付服务出了故障。18:42 触发告警,18:47 值班工程师确认,19:05 还在排查,20:10 才打开修复请求,20:55 才解决。
如果工程师在 19:05 问 agent「现在是什么状态」,正确答案是「已确认,时间线有三条记录,还没有根因,也没有修复」。但如果评测系统只给 agent 一份事故结束后的静态快照,里面显示的会是「已解决」、完整时间线和根因。于是,忠实回答当时状态的 agent 被判错,复述未来结果的 agent 反而得分。
这是微软作者 Tezan Sahu 和 Himani Arora 在 8 月 2 日提交的预印本 What Could the Agent See at 19:05? 给出的核心例子。论文提出的不是一个更大的模型,而是一种把企业世界恢复到指定时刻、指定角色可见范围的 agent 评测方法。1
静态快照会把故事压扁
企业 agent 读的不是一张静态表,而是邮件、聊天、工单、代码库和业务系统里持续变化的记录。一个事故在两个小时内会经历确认、定位、修复和复盘;每个时刻都对应不同的问题,也对应不同的正确答案。
静态快照至少会造成三种失真。它只能测故事的终点,测不到变化刚发生后 agent 是否反应;它会把后来的评论、状态和文本留在记录内部,即使这些字段在提问时还没有出现;它还无法可靠评估「看到某个变化就应该行动」的 always-on agent。论文把这些问题归结为同一个错误:把一段会展开的工作过程,当成了已经结束的状态来评分。1
这会改变我们对「答对」的理解。对企业 agent 来说,正确性不是一句话脱离上下文后的属性,而是一个关系:它是否回答了当时存在的事实,以及回答中包含的内容是否属于这个人可以看到的范围。
时间和权限必须一起进入评测
论文的事故案例里,19:05 的工程师能看到告警、团队聊天和代码库;另一位只接收邮件的产品经理,在同一时刻甚至还看不到事故,因为第一封通知要到 21:00 才发出。两个角色面对同一个「现在发生了什么」的问题,合法答案并不相同。1
这不是把权限检查换个名字。权限决定 agent 能否看到某条信息,时间决定这条信息在当时是否已经存在;缺掉任何一个维度,评分都会把越权或泄露未来误认成能力。
把模型移出评分路径
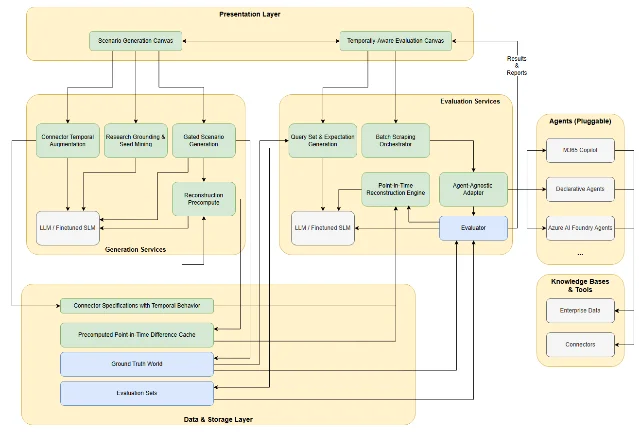
这套方法的工程关键,不是让语言模型在每次评分时重新猜一遍过去,而是把需要猜的部分提前处理掉。流程可以压缩成三个动作:
- 先生成会变化的世界。 系统从真实研究材料中提取场景种子,依次生成角色、因果线、时间线和跨应用记录;每条记录同时带有出现时间与允许查看它的人。
- 再重建指定时刻。 对时间戳、列表和状态字段,系统用规则删除未来内容、清空尚未生效的字段;只有自由文本改写、生命周期状态这类无法直接从时间戳读出的部分,才调用语言模型。
- 最后用缓存评分。 时间点重建提前计算成差异缓存。真正评分时,只做记录合并和权限过滤,不再调用模型,因此同一世界的两次评测可以得到字节级一致的输入。1
这个设计把「模型会不会稳定地产生同一个答案」换成了一个更容易审计的问题:评分路径里的数据操作是否确定,评分路径之外生成的过去是否经过检查。论文报告,早期企业 agent 使用中,一个已编写的场景可以产生几十个按时间点和角色拆开的评测,接入新应用从几天缩短到几分钟,批量运行也能完全复现。这里的收益来自论文作者自己的早期使用报告,不是独立评测结果。1
可复现不等于已还原真实过去
这也是论文最值得保留的缺口。时间戳可以告诉系统一条评论尚未出现,却不一定能告诉系统一段自由文本在 19:05 应该写成什么;一个事故的状态也可能要根据多条记录推断。论文明确把「自由文本应改写到什么程度」和「重建出的过去是否忠实」列为仍需校准的问题。1
所以,时间点回放解决的是评测对象错位,不是自动制造真相。它把隐藏在静态快照里的错误暴露出来,却仍需要人工抽查重建内容,尤其是语义状态、跨应用因果和不同角色的可见边界。否则,系统只是把一份不可靠的终态快照,换成了一份看起来更精细的合成过去。
对准备验收企业 agent 的团队,这篇论文留下了三个比「最终回答准确率」更具体的问题:
- 回答对应哪个明确时刻?
- 当时提问的人能看到哪些记录,哪些信息应该被排除?
- 如果 agent 是被事件触发的,它是否在变化刚发生后获得了正确的世界,而不是等到事情结束才回答?
这三个问题把人的复核位置也说清楚了。人不必逐字重做 agent 的全部工作,但必须检查它所处的时间、权限和状态是否成立;这一步如果缺失,所谓 human oversight 可能只是在终态答案上盖章。
三条相邻信号
把微软论文和最近的两类材料放在一起,可以得到一个更窄、也更可靠的判断:AI 的表现属于模型、上下文和交互策略的组合,而不是模型单体的固定属性。微软把时间和角色权限放进被评估的世界;OpenAI 发现保留 reasoning 与 context compaction 会改变同一模型在 ARC-AGI-3 上的表现;哈佛团队则让系统根据人的能力、认知需要和 AI 信心,决定给完整建议、部分解释,还是暂不回答。三者不是一项共同实验,也不支持同一个效果量,但都说明把上下文从评测中藏起来,会把能力和监督效果一起测歪。123
1. 哈佛:最好的帮助有时是暂时不替人回答
哈佛 SEAS 8 月 3 日介绍的一项研究,让强化学习系统根据人的技能、思考需求和 AI 置信度选择交互方式:完整推荐、部分解释,或暂不提供答案。两项在线实验分别有 316 人和 964 人;在以准确率为目标的设置里,参与者的人机组合在许多情况下超过了单独的人和单独的 AI。研究团队也测试了以长期学习为目标的策略,但新闻稿没有给出所有条件下的完整效果量。3
这条信号补上了微软论文中的「人」这一侧:监督不是固定地把一个人放在 agent 后面,而是要判断人在当前状态下该获得多少帮助。该研究仍是在线健康处方选择任务,不能直接证明高风险现实决策已经安全。
2. OpenAI:评测分数也在测 harness
OpenAI 7 月 29 日复盘 ARC-AGI-3 时发现,官方 harness 会在每次行动后丢弃模型的 private reasoning,并用滚动截断丢掉更早的行动记录。改用 Responses API 保留 reasoning、再启用 compaction 后,GPT-5.6 Sol 在公开任务集上的分数从 13.3% 升到 38.3%,输出 token 减少约 6 倍。2
这是 OpenAI 对自家模型和自家设置的工程实验,不是独立复核。但它把微软论文的时间问题推进了一步:评测不只要规定「世界在什么时候」,还要记录 agent 在连续任务中保留了什么上下文、使用了什么运行设置。
3. Amazon 作者:模拟用户能抓方向,仍会夸大效果
Stefan Hut 和 Lorenzo Masoero 8 月 3 日提交的 Can AI Agents Simulate A/B Test Outcomes? 用 67 个历史营销 A/B 测试验证 agent 模拟用户行为。未校准的基础设置捕捉到 0.70 的效果方向一致率,却系统性高估效果幅度;论文称,两阶段的前置校准可把去除不可约测量噪声后的平方预测误差降低约 77 倍,within-subject 设计可把标准误降约 2.4 倍。4
作者仍把 persona 完整性列为根本瓶颈:模拟器只能看到被写进 persona 的信息,用户当下意图、情绪和外部环境若没有进入描述,模型再会生成语言也无法补回它们。这个限制和时间点回放是同一类提醒:缺失的上下文不会因为 agent 说得流畅而自动消失。
References
- 1What Could the Agent See at 19:05?
arxiv.org
- 2OpenAI 对 ARC-AGI-3 harness 的复盘
openai.com
- 3Harvard 对自适应决策支持的介绍
seas.harvard.edu
- 4
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.