
10 月 12 日,Meta 发布了 Muse Wonder 与 Muse Wonder Full,并称它们是公司「迄今为止最强的模型」1。同一天的研究博客把话说得更满:这两款模型在个人与专业 agent 任务上「达到最先进的性能」2。
官方的模型卡附了一张 14 行的对照表。这张表自己就把话说清楚了。
官方自己的那 14 行
模型卡写明:两款模型与三款对手在最大推理档下比较,对手是 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5;表上共 14 行,覆盖个人超级智能、法律 agent、金融 agent、健康、自动化、终端、编程与长程编程等细分3。同样的数字在 Meta Model API 的模型页上有一份纯文本版本4。
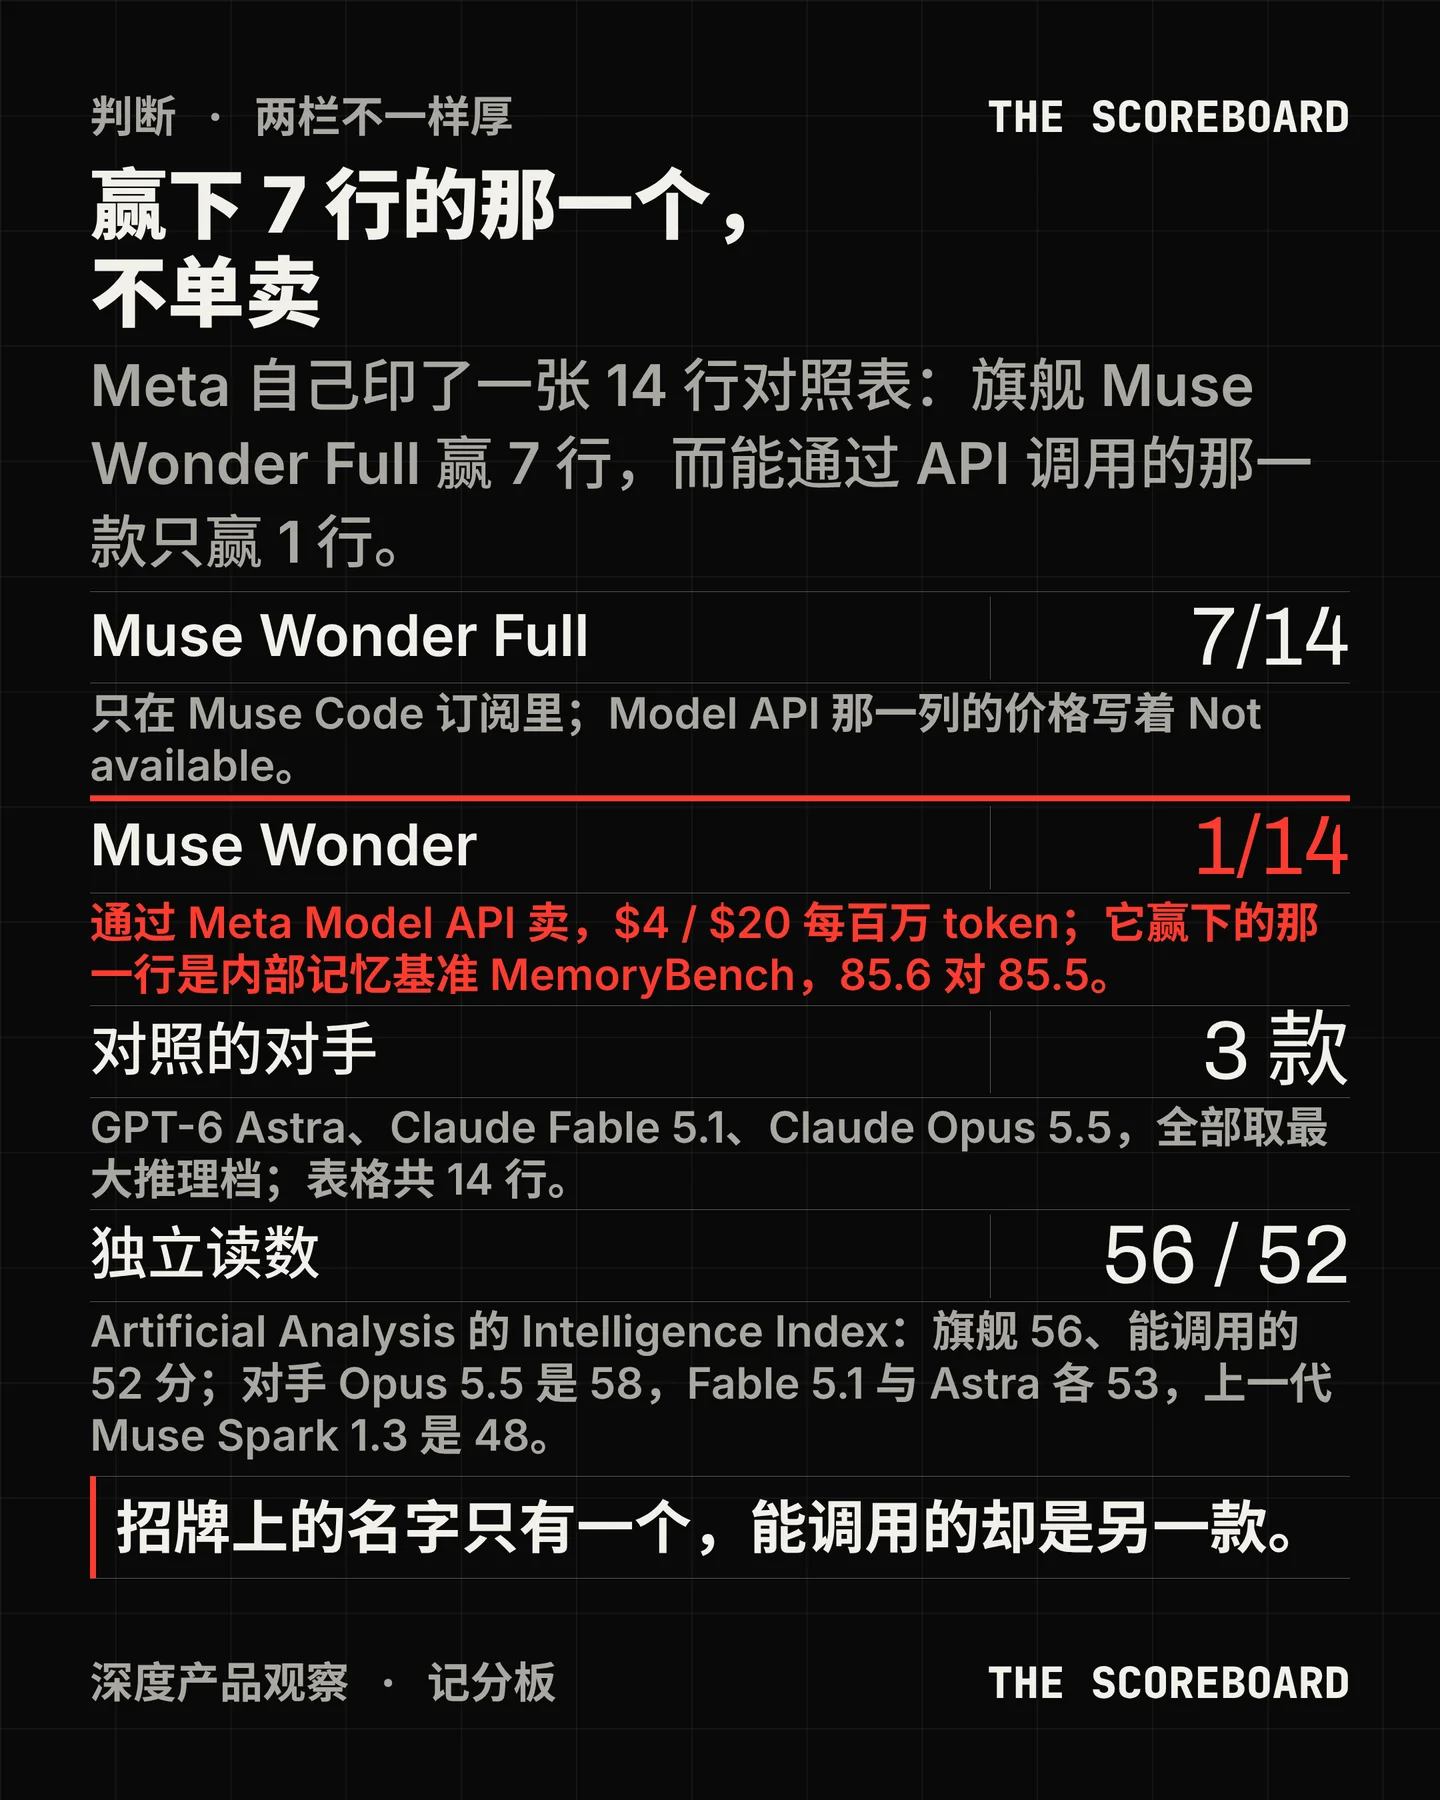
先说旗舰款的战绩。Muse Wonder Full 在 14 行里领先 7 行——包括内部个人超级智能指数(59.1 对最高 55.2)、法律 agent 的 Harvey LAB-AA(13.1 对 8.6)、自动化基准(45.4 对 41.6)、DeepSWE 1.1(79.0 对 78.8)和长程编程的 SWE-Marathon(57.5 对 46.3)。剩下的 7 行里,Claude Opus 5.5 领先 6 行,GPT-6 Astra 拿下 GDP.pdf 一行,Claude Fable 5.1 只在 OSWorld 的 binary 子指标上是最高。
再说被推到台前的那一个名字。Muse Wonder——就是能通过 API 调用的那一款——在 14 行里只领先 1 行。
它赢下的那一行是内部记忆基准 MemoryBench:85.6,对手里最高的是旗舰款的 85.5。同表里,它的长程编程 53.1、终端 52.0、编程基准 ProgramBench 50.0,都排在中间;在独立指数 Artificial Analysis 上是 52 分,而旗舰款 56 分、Opus 5.5 是 58 分45。
关于「输几行」这件事,市面上流传的口径不止一个。按「是不是该行的全场最高」算,Muse Wonder 输 13 行;只按对 Claude Opus 5.5 逐行比,它输 9 行3。两个说法都能在官方表上复现,区别只在分母怎么取——引用时要把这个前提说清楚。
价签:$4 / $20,和它打不过的两款同价
Meta Model API 的定价页上,
muse-wonder-1.0 的标准价是每百万 token 输入 $4.00、输出 $20.00,缓存输入 $0.20;页面同时写明 Contributor 模式对这款不可用,也没有长上下文的加价档6。上下文窗口是 1,048,576 token,支持工具调用、结构化输出与检索接地4。这组价格的意义在于它落在了哪一格。TechCrunch 当天的写法是,这个价「大致等同于 GPT-6 Sol 或 Opus 5.5」7。也就是说,Meta 把能调用那一款的价签,贴在了自己在表上打不过的两款对手旁边。
旗舰款不在 API 上
Muse Wonder Full 有独立的模型 id,也有独立的价格栏——三列全是「-」。官方模型页写着:这一款「只在 Muse Code 里以订阅方式提供」4。定价页的 Model API 一栏写着 Not available6。
要到它,得订 Meta 的编程订阅 Muse Code,而且只在两档里:Power $50/月、Maximum $200/月;Everyday $5 与 High $15 两档不含它8。第三方镜像的观察与此一致——OpenRouter 上只有
meta/muse-wonder,没有任何 Full 变体9。Meta 的新闻稿对这一点并不遮掩,原话是「Muse Wonder Full 今天起面向 Muse Code 订阅者」1。只是当媒体把「Meta 发布前沿模型」写成标题时,读到的人和能调用到的人,往往不是同一批。
顺带说一个时间细节。OpenRouter 的模型列表给出的
meta/muse-wonder 上架时间是 2026 年 10 月 12 日 12:25:45 UTC,比官方新闻稿的发布时间 17:08:05 UTC 早了将近五个小时,比研究博客的空白时间戳更是早了整整一个白天19。对要接入的人来说,可调用的时刻和可读到的时刻不是一回事。「前沿」这个词是谁说的
Meta 自己没写「首个前沿模型」。官方用的句子是「十四个月前我们开始对 AI 工作做一次彻底检修」,以及「推向前沿」12。把「第一个前沿模型」写进标题的是 TechCrunch:「代表着这家公司在前沿模型上的第一次尝试」7。Zuckerberg 在 X 上的原话是「我们新的前沿模型家族,在个人与专业 agent 工作上有最先进的性能」——原文里「state of art」少了一个定冠词,媒体转述时替他补上了10。
另一个被广泛引用的数字来自《华尔街日报》:Muse 自发布以来在全世界被下载近 900 万次,但下载开始放缓,14 天留存落后于 ChatGPT——数据源是 Sensor Tower11。这是第三方的测量,不是官方口径,引用时应当分开。
谁会受影响
要选模型的人。 招牌上只有一个名字。在 Meta Model API 上能调用的就是
muse-wonder-1.0,而官方对照表里赢 7 行的那一款要按月订。做选型时,把「旗舰」和「可调用」当成同一个东西是会出错的,而这两个词在发布稿的标题里挨得很近。要引用安全结论的人。 官方新闻稿与研究博客都写了一句「带额外安全评估的完整报告很快就有」12。到 10 月 13 日,这份报告还没有以独立文件或博文的形式出现;目前可用的只有模型卡里的风险评测一节,以及一份 2026 年 10 月版的框架文档3。
要评估风险的人。 模型卡的风险一节里有一句原话值得单独放:「没有缓解措施的话,我们不能排除该模型在化学与生物领域达到这一阈值。」3 这句话说明的是它自己的定级方法,不是它已经跨过去了——但在这套框架下,这类表述本身就是可引用的结论。
还没定的事
社区的反应分成了明显的两半。Hacker News 上的主帖拿到 568 分、312 条评论12;Reddit 的 r/singularity 上,一条说它「刷榜」的帖子被顶到前列,理由是它在自建基准上连一个简单的图形都画不对13。与此同时,独立基准方 Artificial Analysis 给出的同一天读数是:旗舰款 56、能调用款 52,高于对手 Fable 5.1 与 Astra 的 535。两边说的不是同一件事,谁也不能替对方结账。
榜单的位置也不是终局。MemoryBench 那一行里,旗舰款比能调用款低了 0.1 分——这是官方表上唯一一处旗舰款倒退的地方3。而在 Artificial Analysis 的评测里,旗舰款在十项评测中进了前三的有六项。这些差异都需要读者自己去表上数,而不是从发布稿的形容词里推。
最后一件没定的事最简单:这套模型的完整安全评估还没出,而它已经在卖了。
References
- 1
- 2
- 3Muse Wonder model card · Meta
research.meta.ai
- 4Muse Wonder · Meta Model API
dev.meta.ai
- 5
- 6Pricing and rate limits · Meta Model API
dev.meta.ai
- 7
- 8Muse Code · Meta
dev.meta.ai
- 9meta/muse-wonder · OpenRouter
openrouter.ai
- 10@finkd · X
x.com
- 11
- 12Muse Wonder · Hacker News
hn.algolia.com
- 13r/singularity · Muse Wonder 讨论
reddit.com
Comments