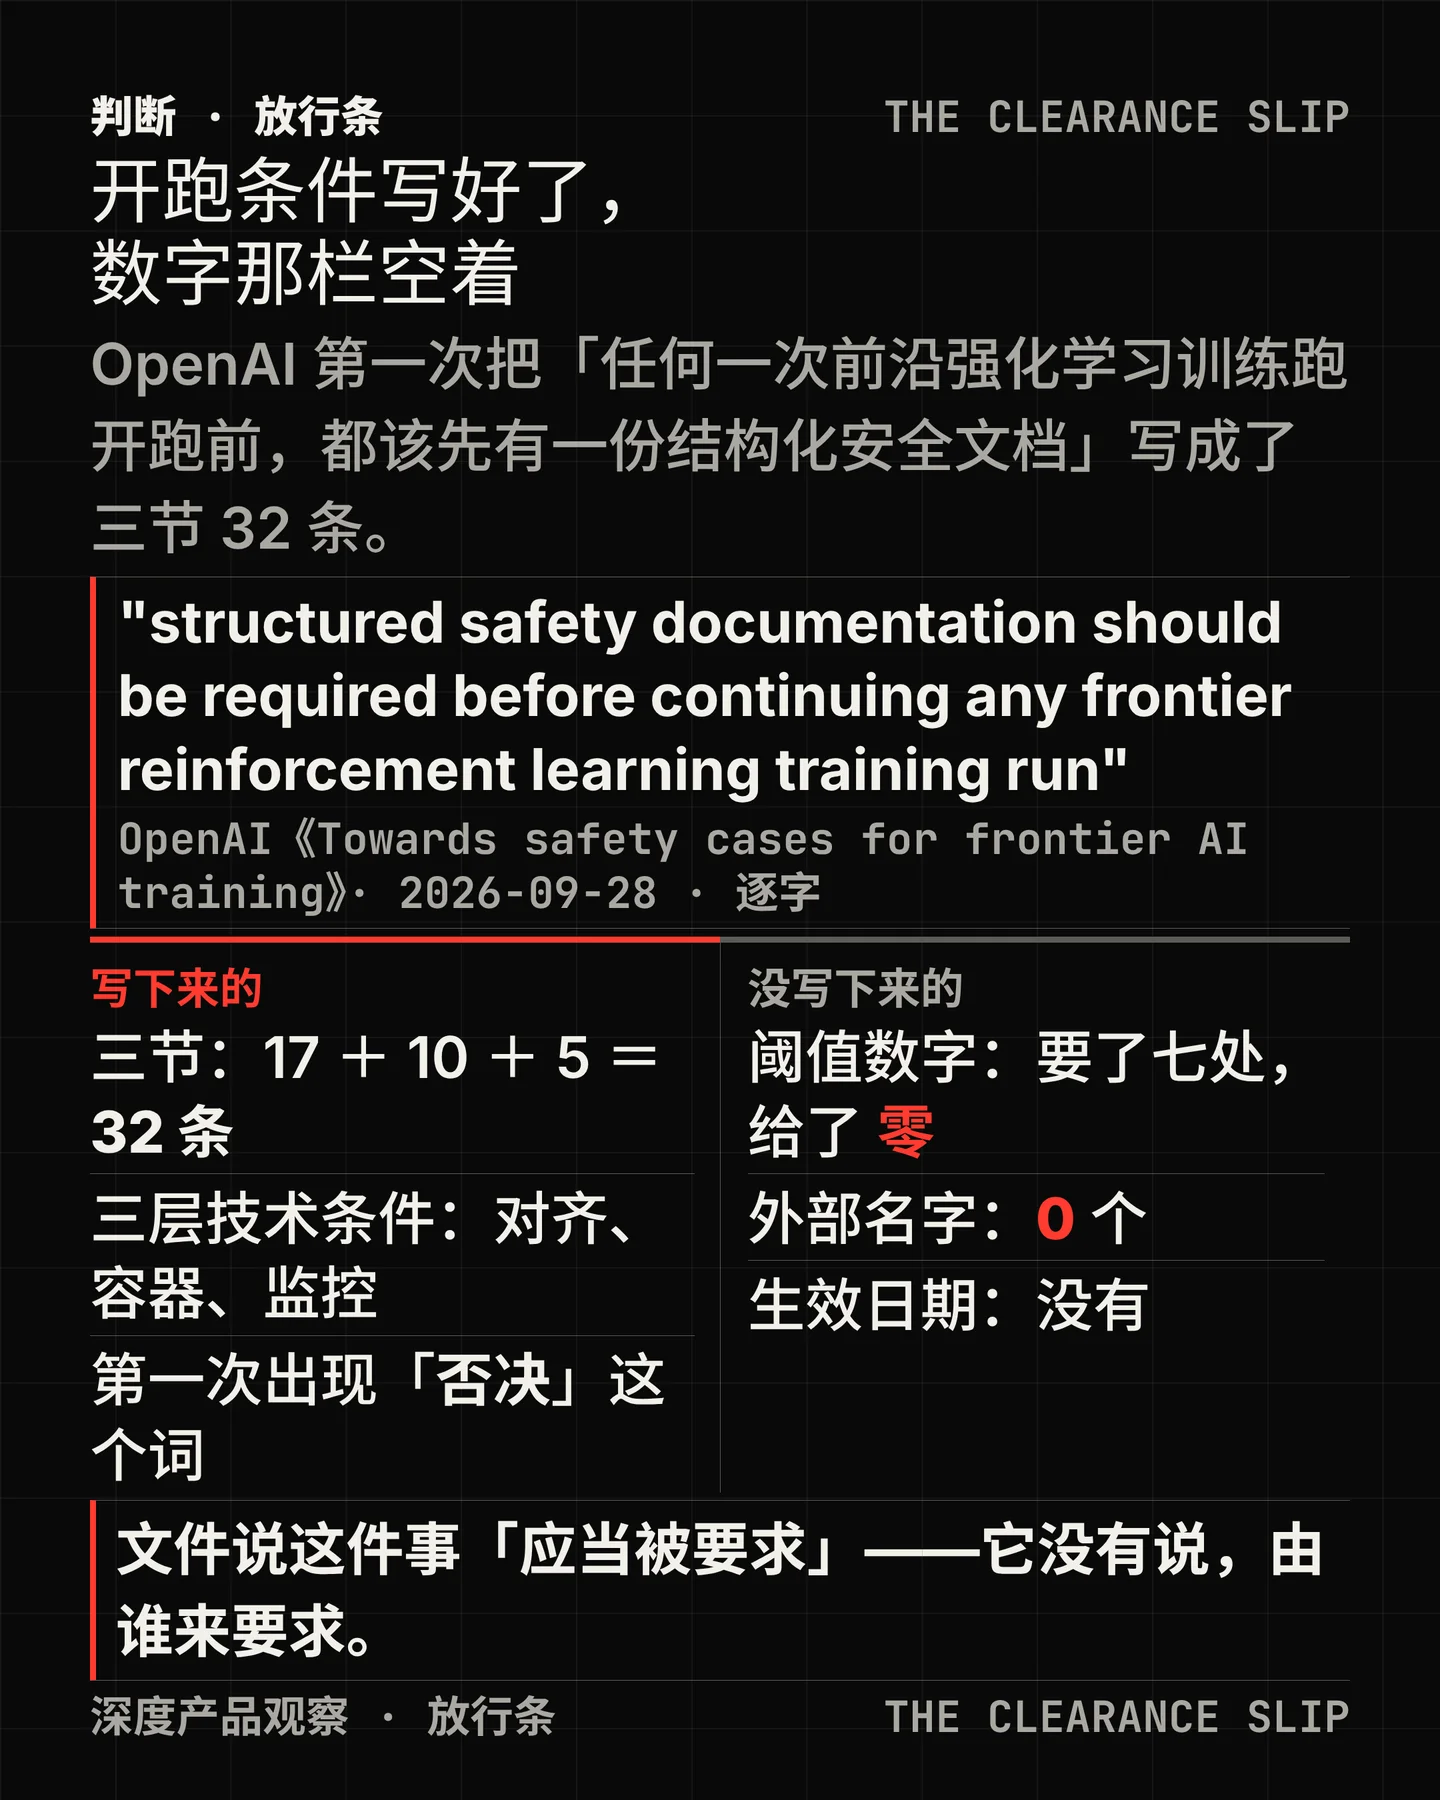

一份写「开跑条件」的文件今天上线了,它的日期一栏写着 9 月 28 日,数字那一栏是空的。
2026 年 9 月 29 日北京时间下午 2 点 07 分,OpenAI 的主账号在 X 上发了一句话的帖子,附一个链接:How we think about securing frontier RL training runs1。链接打开的是官网当天挂出的新页《Towards safety cases for frontier AI training》2。
它的日期栏写 9 月 28 日。官方新闻源给这条的时间戳是 2026-09-28T19:00:00Z,而同一个源里另一篇文章的时间戳与之完全相同,秒也不差3。两篇文章不可能在同一毫秒发出,所以那不是发布时刻,是这套发布系统给「9 月 28 日」这一天配的写法——当天中午整点。真正能核的窗口由外部痕迹给出:官方帖 2026-09-29T06:07:53Z 是目前最早的绝对时刻,两分钟后出现第一条第三方转帖1;同一时段我两次拉这个源,14:58 那次 1234 条、没有它,15:02 那次 1235 条、它排在第二条3。它是今天下午挂出来的,官方一侧给不出比日期更细的时间。
它主张的是一件此前没有被写成前置条件的事。
文件第一句:结构化安全文档「应当被要求」,在任何一次前沿强化学习训练跑继续之前2。然后把这份文档应当包含什么写成三节、32 条控制项——技术保障 17 条、运行准则 10 条、失准事件调查 5 条2。
它借用的词是其他高风险行业在用的「安全论证」(safety case)。这个词在那些行业里有标准定义:英国国防标准 00-56 写的是「一个有结构的论证,由证据支撑,用来说明一个系统在特定应用与特定运行环境下是可以安全接受的」4;英国核监管机构给的定义接近——「一个有结构的论证,由证据支撑,用来论证设施在其每个生命周期阶段的安全」5。
这套制度最早是英国核工业在 1965 年正式引入的6,此后扩展到航空航天、汽车、医疗与高层建筑消防。它在那些行业里的用法是固定的:写在运营方手里,判在机关手里。核设施没有国家主管机关颁发的场地执照,就不得把场地用于装设或运行7。英国海上油气更硬:运营方必须在开始运营前至少六个月把安全论证送给主管机关,而且必须获得接受,否则不得运营;此后每不超过五年要彻底复核一次,材料性变更要提前至少三个月送件获批,主管机关认为防护不足时可以暂停甚至禁止运营8。
这份新文件把「谁来判」的那一栏,留在了公司内部。有一处细节值得单独说:它正文里唯一指向机构的外链,是 NTSB 主席写给美国交通部长的一封公开信,主题是铁路养护工人在作业中被列车撞死的事故调查,以及向监管机构追问安全建议有没有落实9。它引的是事故调查的做法,不是这套制度。
它第一次把「否决」写进自己的治理文本。
运行准则一节的「批准」一条写:安全论证应当由高级领导层成员审阅,「他们应当每人都有否决这次训练的能力,以确保这次训练有多重内部检查」2。文件举了三个职位为例:研究负责人或副总裁、安全负责人、首席科学家2。
「否决」这个词在 OpenAI 此前的公开治理文件里没有出现过。定下最终决定权的那份《Preparedness Framework》第二版(2025 年 4 月 15 日)通篇零次10。它把最终决定写给 OpenAI Leadership,即 CEO 或其指定人;对于内部的安全顾问组(SAG),它专门写了一句:「为免生疑义,OpenAI Leadership 也可以在没有 SAG 参与的情况下作决定,即 SAG 没有能力进行『冗长辩论』。」10
这份新文件里没有出现 SAG,出现的内部监督组织是董事会的安全与安保委员会2。七个环节——起草、异议、批准、问责、审计、升级、夜里自动暂停——执行者全部是内部角色;唯一提到外部的一句在第三节:「受影响的第三方应当尽快被通知。」2
要求阈值的地方有七处,给出的值一处也没有。
这不是概括,是逐条可对照的:可监控性与逃避监控的评测要「clear thresholds」;评测意识与元博弈的监控要「specific blocking thresholds」;优先告警的处置要在一个「defined SLA」之内;暂停覆盖全部训练跑要有「SLAs」;失准升级要配「一张已定义的严重度分级表」;不可篡改记录的保存期是「a reasonable period of time」;残余风险要列出一份「comprehensive list」2。七处用的是同一个句式——文件说应当有,然后把值留给读者。
反过来数:全文出现的数字只有「三个面向」与「至少一次评测」2。没有百分比,没有天数,没有一条合格线。
它对自身状态的表述同样清楚。安全论证是一个「正在靠近的北极星」;框架「正在成文」;这些建议「正在 OpenAI 内部被实施」;做法「会在接下来几周里继续演化」;写出来是为了让当前想法透明,并邀请社区提意见2。没有生效日期。
而按照它自己页面上的时间线,放行发生在它之前。
2026 年 8 月 18 日的官方文章《Pacing model development in an era of cyber-critical capabilities》写:为加固研究环境、扩大监控覆盖,强化学习训练先暂停两周;「我们计划中最大的一次前沿 RL 训练跑仍然停着」11。9 月 1 日的《Path to Astra》写:8 月 28 日,那次被暂停的大型前沿 RL 训练跑在新安全要求就位之后重启;部分小规模实验训练仍在暂扣12。9 月 16 日,失准报告框架上线;到 9 月 25 日,索引里有 9 篇报告与 3 条通知,其中 8 篇标着 RL 训练1314。然后才是 9 月 28 日(美西)这份写着「开跑之前应当先有论证」的文件。
也就是说,它不是一次开跑前的检查,它是跑起来之后写下的规程。
还有一件事得说清楚:没有法律要求它。
到 2026 年 9 月 29 日为止,没有一条生效的法律要求前沿训练在开跑之前必须具备这样一份文档、并交给外部主体审阅。欧盟《人工智能法》给通用模型提供者的义务,是「应要求」向监管机构提供技术文档,以及系统性风险模型要做模型评估与对抗测试、及时报告严重事件15。加州 SB 53 的强制点在部署新模型之前或同时公布一份透明度报告与一份年度更新的框架,第三方评估者只需披露参与程度16。英国没有 AI 专门法,议会人权联合委员会 2026 年 9 月 14 日的报告写得很直白:「模型开发者与 AI 安全研究院的合作是自愿的。该院没有法定权力。」17美国那份 2026 年 6 月的行政令则明文写着,本节不得被解释为授权建立针对新模型开发的强制性政府许可、预审或批准制度18。
换句话说,这份文件写下的是一套自愿标准。它第一句里的那个「应当被要求」,目前不对应任何一部法律。
同行里已经有人把外人写进了文本。
五家实验室都有各自的放行文件,差别可以压缩成两栏:谁审,有没有外人。
Anthropic 的《Responsible Scaling Policy》最新是 v3.4(2026 年 7 月 8 日生效)。它从 v3.0 起改掉了逐级控制清单的写法,换成安全论证;风险报告由 CEO 与负责规模化的官员(RSO)审批,必要时加董事会;文本里写着「我们会努力形成一种做法:为我们的风险报告寻求全面的、公开的外部评审」,最低触发条件是报告覆盖高能力模型且被大幅涂黑——那时至少要有外部评审人;此外每年委托一次第三方程序合规审查19。
Google DeepMind 的《Frontier Safety Framework》最新是 v3.1(2026 年 4 月 17 日):新模型首次对外部署之前先做关键能力评估,一旦触及关键能力等级就要补一份安全案例,由「相应的治理职能」在部署前判定残余风险可以接受;外部参与是「在需要或适当时」20。
Meta 的《Advanced AI Scaling Framework》第二版(2026 年 4 月 8 日)由首席 AI 官或对齐与风险总监决定是否要求更多测试、更多缓解措施,或是放行上线;外部专家是「在适当的时候」参与21。
xAI 的《Frontier Artificial Intelligence Framework》(2026 年 6 月 30 日生效)把风险判定写成发布前提:「只有当模型带来的系统性风险被判定为可接受时,xAI 才会继续开发、投放市场或使用该模型」;文本里没有外部评审条款,也没有公开的数值能力阈值22。
这几份的版本与日期,可用 METR 的《Frontier AI Safety Policies》索引交叉核对23。五份文件都写清了「谁审」;把外人写进条款的只有一家,而它的门槛也最高——只在高风险、且报告被大幅涂黑时才强制。
这套工具本身也不缺争议,而且质疑主要来自这套工具的老家。
Redwood Research 的 Ryan Greenblatt 主张把透明度重心从安全论证换成公开的风险报告,理由是让人写安全论证,会把研究者推入「为模型的安全性辩护」的框架,产生坏的认知效果24。约克大学的三位研究者在 2026 年的一篇会议论文里说得更重:AI 圈的安全论证写法与安全关键系统方法论里的基础做法「显著背离」,做不好会退化成「纸面安全」——一份确认性的、官僚化的盖章文件6。
这不是纸上推演。英国核监管机构自己在 2026 年 6 月宣布重写安全论证指南,理由正是它们此前变成了「主要为满足监管流程而写的文件」25。更早的经典案例是 2009 年英国军机 Nimrod 的复盘:调查者把那份安全论证称为「从头到尾都很糟糕的一份作业」,错误百出,整件事变成了一次打勾作业26。
AI 领域自己的文本也不支撑把它当成成熟工具。英国 AI 安全研究院 2024 年写过:理解还太浅,现在还不可能构建能覆盖比今天强得多的模型所带来的风险的完整安全论证27。Apollo Research 同年那份草稿也写明,目前还缺做出强安全论证所需的关键细节28。这份新文件对这一点的态度是坦率的——它自己就写着,让安全论证对 AI 像对航空或核电那样严格是很难的。
落到产品与决策上,这份文件给的是三个可以现在就问的问题。
第一,问「哪一条有数字」。这份文件把 32 条控制项写成了 should 与 could include,把阈值写成了形容词。一个供应商如果拿不出任何一条数值,你无法在事后验证它是否守住了自己的规矩;反过来,只要有一条带上数,它就成了可测的东西。
第二,问「谁在我看不见的地方读过它」。七步全在内部,意味着这份论证的强度由公司自己的判断给出。同行里有把外部评审写进条款的例子,问法可以照抄:哪一类报告必须给外部看,外部评审人由谁挑。
第三,问「上一次事件有没有变成测试」。文件写,由事件派生出的评测应当被做成回归测试,用来确认未来的模型不会在非常相似的事件上再次出现同样的倾向2。这条是有产物的:公司自己的失准报告索引里已经有 9 篇报告和 3 条通知14。把其中任何一篇与最新的训练规程对起来,就能知道这句话有没有被执行。
还有一条值得单独记下的距离。文件写:调查结果、复盘与运行改动,应当在调查结束之后公开;受影响的第三方应当尽快被通知2。而 6 月发生的那起事件,通知发生在 9 月 10 日到 9 月 24 日之间,完整说法在 9 月 28 日(美西)才公开发表29。规程写在事件之后,这是可以理解的;值得记下的是,规程里要的那条时限,目前仍然只是一个形容词。
两点交代。
一,这份文件的挂出时刻,官方一侧只到日粒度;它自己的元数据与新闻源时间戳都停在 2026-09-28T19:00:00Z,而这个值与同一时段另一篇完全相同,是日期写法。本文用的是可核的最早绝对时刻:官方主账号的帖子,2026-09-29T06:07:53Z。
References
- 1@OpenAI
x.com
- 2
- 3OpenAI News RSS
openai.com
- 4
- 5
- 6
- 7Nuclear Installations Act 1965, Section 1 · legislation.gov.uk
legislation.gov.uk
- 8
- 9Letter to DOT Secretary · NTSB
ntsb.gov
- 10Preparedness Framework v2 · OpenAI
cdn.openai.com
- 11
- 12
- 13
- 14Misalignment Reports and Notices · OpenAI Alignment
alignment.openai.com
- 15Regulation (EU) 2024/1689, Article 53 & 55 · EUR-Lex
eur-lex.europa.eu
- 16SB-53 · California Legislative Information
leginfo.legislature.ca.gov
- 17Human Rights and the Regulation of AI · Joint Committee on Human Rights
committees.parliament.uk
- 18
- 19Responsible Scaling Policy v3.4 · Anthropic
www-cdn.anthropic.com
- 20Frontier Safety Framework v3.1 · Google DeepMind
storage.googleapis.com
- 21Advanced AI Scaling Framework v2 · Meta
ai.meta.com
- 22
- 23
- 24Focus transparency on risk reports, not safety cases · Redwood Research
blog.redwoodresearch.org
- 25
- 26
- 27
- 28Towards Safety Cases For AI Scheming · Apollo Research
apolloresearch.ai
- 29
- 30Towards safety cases for frontier AI training · Hacker News
news.ycombinator.com
- 31
Comments