官方表 38% 独立测出 26%、一份文档把 81% 顶到 97%、平均分只差 0.5 分成本差 8 倍
过去二十四小时里八组材料的名次都只在它自己那一栏成立:同一款模型官方表上是 38.0%、独立实测测出 26%,同一批编码题加一份文档把五个模型从 81% 顶到 97%,同一台机器只改一处设置预填速度就从 704 涨到 1,234 tok/s。

过去二十四小时里,八组材料的每一个名次都只在它自己那一栏成立,换一栏看,赢家就换一个。
同一款模型,厂商官方表上 Terminal-Bench 4.0 是 38.0%,独立评测方测出 26%;换到「每条编码任务花多少钱」那一栏,它又是全场最便宜的两三个之一,比榜首便宜六倍多,成功率只低三个点。同一批编码题,加进一份 AGENTS.md 之后,有五个模型从 81% 到 90% 一起升到 97%;同一张表上,同样加了这份文档的另外四个只到 90% 到 94%。同一批三千道判断题,421M 的本地模型在新闻分类上高 6.5 个百分点,云端决策模型在阅读理解上高 19.5 个百分点。同一台机器上,只把一项默认设置改掉,预填速度从 704 涨到 1,234 tok/s。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和发帖人自己承认的限制放在一起,供正在选模型、自己部署和报账的读者核对。覆盖 2026 年 9 月 21 日至 9 月 22 日,来源为 X、Reddit、小红书与公众号,另含厂商发布页、Next.js 官方评测榜、Artificial Analysis 与一篇公开复现。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 一款新旗舰模型的真实水平 | Grok 4.7,9 月 21 日发布,$2/$6 每百万 token,500k 上下文,厂商自报成绩与独立评测并列 12 | 官方表 Terminal-Bench 4.0 为 38.0%;独立评测测出 26%,智能指数 46,比上一代高 2 分 | 官方表由厂商自报;独立评测的 harness 与档位不同,两个数字不能直接相减 |
| 一批真实的 Next.js 编码任务 | Next.js 官方评测榜 11 个在榜条目,9 月 21 日重跑,pass@4 计分,成本按公开价折算 3 | 同一批模型加一份 AGENTS.md 后,五个从 81%~90% 升到 97%;另外四个只到 90%~94% | 官方标注这一列是「拿到内置文档后额外通过的评测」;成本是估算不是账单 |
| 六个前端与办公类交付任务 | 阶跃星辰 Step 5 Preview 对 Claude Opus 5、GLM 5.3,同一批材料与提示词,满分 100 4 | 六例平均分 88.0 / 87.5 / 84.7,差 0.5 分;作者自报花费约 1:3:8 | 评分表与权重由作者自设;每例只跑一轮,费用不计入评分 |
| 四类岗位的真实办公活 | 豆包工作、腾讯 WorkBuddy、千问办公各跑一轮 5 | 内容运营 WorkBuddy 11 分钟交卷;原型题 6 / 15 / 20 分钟;抓公众号那轮三家都拿不到可核验的阅读数据 | 定性比较,没有评分表;每类岗位只跑一轮 |
| 三千道英文文本判断题 | 同一批 3,000 道新题(五类各 600 道),同一文本与选项,Jev 1.13 走 OpenRouter,Laya 用本地社区 ONNX 转换 6 | 新闻分类 Laya 91.3% 对 84.8%;影评 Jev 95.8% 对 90.5%;阅读理解 Jev 90.0% 对 70.5%;3,000 次调用 0.052 美元 | 公开题库抽样,无法排除训练数据重合;结果只对应这批版本与设置 |
| 一套记忆系统的公开基准 | MemoryAgentBench 多分类任务,纯 TF-IDF + kNN,无 LLM、无 embedding,约 200 行 7 | 基线 68.0%,排在八套已发表记忆系统之前;同表无记忆层的 GPT-4o-mini 是 82.4 | 只测四项能力中的一项;没有重跑那些系统,是拿已发表数字对比 |
| 一台双卡机器上的本地推理 | Ryzen 7 9800X3D、128GB DDR5、RTX 5090 加 RTX 3090,自编译 llama.cpp,Qwen3.8-27B 与 Qwen3.8-Flash-Next 8 | 同一份 20.6k 文档,只改 lazy-mode 就从 704 到 1,234 tok/s;batch 设成等于 ubatch,双卡从 2,669 掉到 2,040 | 作者自陈帖子的结构用了 AI 助手;除一处 A/B 外都是单次运行 |
| 一张改装显卡上的投机解码 | RTX 3080 20GB、98k 上下文、IQ4_XS 4.25 bpw,MTP 投机头在 GGUF 内 9 | 关掉投机解码 36.6 tok/s,打开后空上下文 72.7,填到 91k 掉回 41.3;草稿接受 404/580 | 单人单卡、发布账号很新、没有第三方复跑;未审查权重不能与官方权重比质量 |
官方表上是 38.0%,独立评测测出 26%
SpaceXAI 在 9 月 21 日发布 Grok 4.7,官方介绍页的标题句写着「两倍快、价格是同类模型的一半」,定价 $2 每百万输入、$6 每百万输出,缓存命中降到 $0.50,上下文 500k,推理档位从 low 到 xhigh 1。同一页附了一张与 Grok 4.6、GPT-5.6 Sol、Claude Fable 5.1 并排的表:CursorBench 4.0 上 46.3%(Grok 4.6 是 40.4%,Fable 5.1 是 51.8%),DeepSWE v1.1 上 71.0%(高 effort),EEBench 上 64.0%(Grok 4.6 是 53.0%),AA Briefcase 上 1,657(Grok 4.6 是 1,546),Terminal-Bench 4.0 上 38.0%(Grok 4.6 是 20.3%,GPT-5.6 Sol 是 37.3%,Fable 5.1 是 57.9%),Harvey Legal Agent Benchmark 上 19.6%,HealthBench Professional 上 56.7%。
独立评测方 Artificial Analysis 在同一天给出另一栏。它把这款模型放在 xhigh 档上测,智能指数 46,比 Grok 4.6 高 2 分,编码智能体指数 56,比上一代高 9 分,在各自原生 harness 里排第 4,前面是 Claude Fable 5.1、GPT-6 Astra 与 Claude Opus 5 10。它列出的增幅分布与官方表并不一致:长程知识工作基准 AA-Briefcase 上提升 111 Elo 到 1,657,Terminal-Bench 4.0 上只提高 4.5 个百分点,而 AA-LCR 降低 3.7 个百分点、AutomationBench-AA 降低 1.1 个百分点。它还记了一条官方页没提的成本项:xhigh 档每完成一道智能指数题,大约消耗 81k 输出 token,是 Grok 4.6(high)36k 的约 2.25 倍,也是 GPT-6 Astra(max)27k 的约 3 倍。
Loading content card…
两个 Terminal-Bench 4.0 的数字被摆到了一起:官方自报 38.0%,独立实测 26% 11。
第三个口径来自另一条榜。Next.js 官方评测榜 9 月 21 日重跑的那一版里,Grok 4.7 配 OpenCode 平均 337.19 秒完成一道题、每例 $0.109、成功率 94%;同一张表上 Claude Fable 5.1 每例 $0.722、97%,Claude Opus 5 每例 $1.96、94% 3。按每条任务的成本结算,Grok 4.7 大约是 Fable 5.1 的七分之一,成功率差 3 个百分点。
这三栏各自成立,混起来就不成立了。官方表由厂商自报,推理档位标 xHigh;独立那组用的是自己的十项加权评测与 harness,档位写 xhigh;Next.js 那条榜量的是另一批任务、另一个 harness,成本按公开价折算。三个数字回答的是三个问题,谁也不能拿去减谁。
加一份文档那一栏:81% 到 97%
Next.js 官方评测榜最后一轮运行在 9 月 21 日,评测的是编码 agent 做真实 Next.js 任务的表现。它有两个口径要写清楚:成功率是 pass@4,同一道题四次里有一次通过就算通过;成本是从服务方报的 token 数算出的平均每例花费,按结果导出时的公开价折算,官方自己写着这只是一个相对参考,不是账单 3。
| 模型与 harness | 平均用时 | 每例成本 | 成功率 | 有 AGENTS.md |
|---|---|---|---|---|
| Claude Fable 5.1(high)· Claude Code | 247.59 秒 | $0.722 | 97% | 97% |
| Claude Opus 5 · Claude Code | 368.39 秒 | $1.96 | 94% | 97% |
| Grok 4.7 · OpenCode | 337.19 秒 | $0.109 | 94% | 94% |
| Gemini 3.8 Flash · OpenCode | 434.82 秒 | $0.605 | 90% | 97% |
| GPT 6 Astra(high)· Codex | 251.89 秒 | $0.891 | 90% | 97% |
| Kimi K3 · OpenCode | 352.34 秒 | $0.281 | 84% | 97% |
| GLM 5.2 · OpenCode | 395.50 秒 | $0.152 | 81% | 97% |
| Claude Sonnet 5 · Claude Code | 263.04 秒 | $0.386 | 81% | 97% |
| Cursor Composer 2.5 · Cursor | 273.56 秒 | $0.062 | 81% | 94% |
| MiniMax M3 · OpenCode | 260.09 秒 | $0.053 | 81% | 90% |
| Kimi K2.7 Code · OpenCode | 318.42 秒 | $0.139 | 74% | 90% |
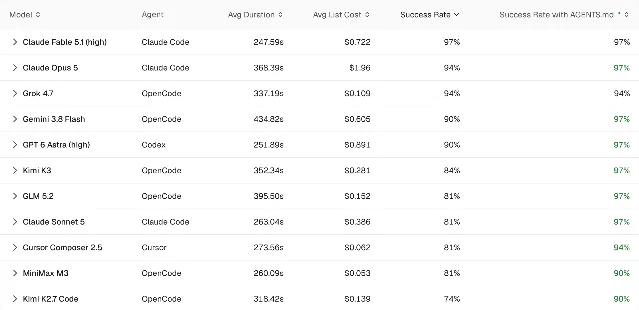
升幅集中在 80% 出头那一档。GLM 5.2 从 81% 到 97%、Kimi K3 从 84% 到 97%、Gemini 3.8 Flash 与 GPT-6 Astra 从 90% 到 97%,Claude Sonnet 5 从 81% 到 97%。加进这份文档之后,每例 $0.152 的 GLM 5.2 与每例 $1.96 的 Claude Opus 5 落在同一个数上。
同批里也有一动不动的。Grok 4.7 停在 94%,Cursor Composer 2.5 只从 81% 到 94%,MiniMax M3 与 Kimi K2.7 Code 只到 90%,Fable 5.1 本来就在 97%。这一列衡量的是「这批模型有没有利用项目内文档」,不是一次普遍提分。
小红书一位用户 9 月 22 日下午把这张表转述成一句话:「加入 AGENTS.md 后,这几个模型全都到了 97%」12。它列出的五个模型与官方表逐格相符,但「全都」把一个子集说成了整批:同批在榜的 Cursor Composer 2.5、Grok 4.7 到 94%,MiniMax M3 与 Kimi K2.7 Code 到 90%,Fable 5.1 一开始就是 97%。他笔记里另一句倒是官方的口径没错——模型没换,变的是 agent 终于知道这个项目该怎么干。
这篇材料的边界在口径上。pass@4 会奖励运气,四次里蒙对一次就算通过;成本按公开价折算,与你的实际账单不同;同一张表里各条目的 harness 也不同,Codex、Claude Code、OpenCode 与 Cursor 各跑各的。评测仓库公开在 GitHub 上,可以自己看题目组成 13。
平均分差 0.5 分,成本差 8 倍
公众号「K 姐研究社」9 月 21 日把阶跃星辰的 Step 5 Preview 与 Claude Opus 5、GLM 5.3 放在同一批材料与提示词上,跑了六个案例:修一个图片压缩器、做一个商品海报生成器、做陶艺工作室预约页、做太阳系科普页、做一页经营看板、排一场 24 人工作坊的日程。Step 5 Preview 的规格是总参数 600B、每个 token 激活 27B、1M 上下文、文本与图像输入。评分满分 100,拆成正确性 40 分、需求完成度 30 分、展示与操作体验 20 分、细节与异常处理 10 分 4。
| 案例 | GLM 5.3 | Step 5 Preview | Claude Opus 5 |
|---|---|---|---|
| 图片压缩器修复 | 89 | 93 | 84 |
| 商品海报生成器 | 82 | 86 | 94 |
| 陶艺预约页 | 87 | 91 | 88 |
| 太阳系科普页 | 82 | 88 | 93 |
| 经营看板 | 81 | 83 | 84 |
| 活动排期执行图 | 87 | 87 | 82 |
| 总分(满分 600) | 508 | 528 | 525 |
| 平均分 | 84.7 | 88.0 | 87.5 |
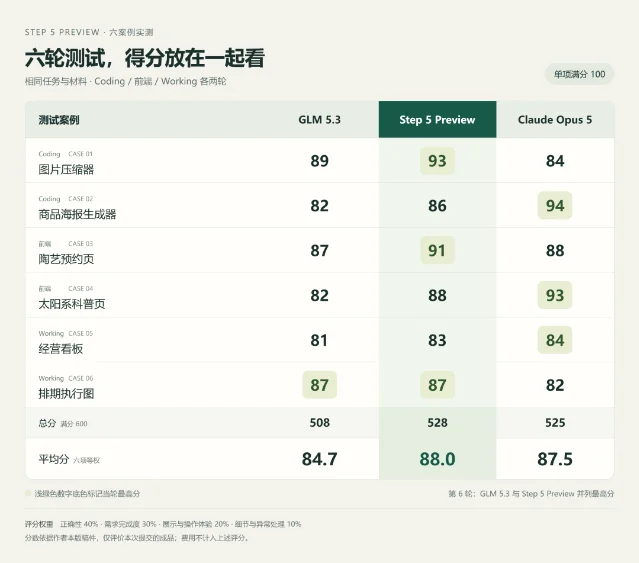
按平均分排,三个模型的差距是 0.5 分。按作者自己这次的实际花费排,Step 5 Preview 大约是 GLM 5.3 的三分之一、Claude Opus 5 的八分之一。同一天里,这两栏给出的推荐并不一样。
单个案例里的胜负换得很快,六个案例产生了三个不同的单例第一:Step 5 Preview 拿下三个,Opus 5 拿下两个之外的一个并列,GLM 5.3 在活动排期那一例与 Step 5 Preview 并列 87 分。翻车的地方都记得很具体:GLM 5.3 在经营看板里把 O08 那笔订单的可恢复商品成本写成 450 元,在太阳系科普页里把详情面板排到了首屏之外(题面明确要求 1200×900 窗口下不滚动),这两处都会直接改变结论;Claude Opus 5 在陶艺预约页里写进了资料里没有的烧制费用、作品三周后可取与开课前提醒,在经营看板的折叠说明里把收入最低的渠道写成 A 的 3,000 元,实际最低的是 C 的 2,300 元;最后那个排期案例,三份交付都漏掉了乙组第一节课前的转场,「三组学员先上基础课再上进阶课」这条约束谁都没排对。
这份材料的边界由作者自己写在图上:评分表、维度与权重都是他一个人定的,只评交付的成品、费用不进评分,每个案例只跑一轮、没有重测。他本人的结论也留了余地——三款模型的整体表现很接近,他愿意继续用 Step 5 Preview,主要理由是效果与花费的组合。
三类办公活,三家的强弱换了一遍
公众号「科沿社」9 月 22 日凌晨那篇选了市场营销、内容运营、产品经理、前端开发四类岗位,各出一道真实任务,分别交给字节的豆包工作、腾讯的 WorkBuddy 与阿里的千问办公,调用三家最新旗舰模型各跑一轮 5。
时间这一栏三家都给了。内容运营考追热点和选题,WorkBuddy 11 分钟交卷,热点按模型、资本、政策分类;产品经理那道奶茶点单小程序,WorkBuddy 6 分钟交卷,千问花了 15 分钟,豆包 20 分钟。第二轮要抓机器之心、量子位等账号过去一周传播度最高的文章,WorkBuddy 说自己检索了 118 篇、筛出 15 篇,并且显示三家都拿不到完整的公众号阅读、点赞和在看数据,于是用跟进同一话题的头部媒体数量、站外扩散广度和事件延续天数合成一个传播指数;豆包说从 135 篇里筛出 18 篇,并把已查证数据与估算内容分开标注;千问选了 10 篇。
强弱在四类活上对调。物料那轮给了贝果新品 brief,要主视觉海报、小红书封面和 15 秒预热视频,豆包自己调了视频生成与文生图模型,视频串起了制作过程、配了背景音乐与旁白,完成度最高,主视觉只有一处文字挤在一起;千问两张图偏生硬,视频更像一张会动的海报。前端那道「骑自行车的鹈鹕」经典题上,豆包建模最自然,没有明显穿模,速度还分悠闲、正常、飞驰三档;千问这一轮翻车,鹈鹕没有握住车把,两只脚像踩在同一侧踏板上。产品经理的数据看板加归因那一轮,WorkBuddy 最细,把直接原因与根本原因分开讲,建议按优先级排序,还主动交代了结论缺哪些数据验证、指标口径是什么。
这份材料的边界在它没有评分。四类岗位各一轮,好坏的判断由作者肉眼给出,没有量化的评分表;公众号的阅读、点赞、在看数据三家都取不到可核验值,这一栏只能看替代指标。
三千道题:本地模型赢一类,云端模型赢两类
小红书用户「hX1_hd」9 月 22 日下午把同一个问题换成了可以计数的方式:把云端的决策模型换成本地模型,准确率会损失多少,有没有哪类任务本地反而更好。做法是从公开测试集或验证集里抽 3,000 道新题,五类英文文本判断任务各 600 道,并且排除了上一轮用过的样本;两个模型用相同的文本、相同的提示和相同的选项,各回答一次,合计 6,000 次判断。Jev 走 OpenRouter 调 1.13,Laya 用本地英文基础版的社区 ONNX 转换;作者没有针对这批答案调过提示词、也没有微调模型,异常返回一律计入失败 6。
| 任务 | Laya | Jev 1.13 |
|---|---|---|
| 新闻分类 | 91.3% | 84.8% |
| 影评正负面判断 | 90.5% | 95.8% |
| 阅读理解 | 70.5% | 90.0% |
| 情绪识别 | 差距较小 | 差距较小 |
| 文本推断 | 差距较小 | 差距较小 |
结果不是一边倒,而是按任务分家:新闻分类上本地模型高 6.5 个百分点,影评正负面判断上云端模型高 5.3 个百分点,阅读理解上云端模型高 19.5 个百分点。情绪识别与文本推断两类的差距较小,作者对照同题配对的统计区间后写道,这两类还不够判胜。成本这一栏:本轮 Jev 的 3,000 次调用合计 0.05204 美元,Laya 没有 API 账单,但要自己承担本地硬件与运行成本。
作者在笔记里划了两条边界。一条关于样本:这是公开题库的抽样评测,不是全量复现,无法排除训练数据重合,结果只对应本次模型版本、样本与设置。另一条关于证据来源:配图把「这次同题实测」与「Laya 作者公布的 benchmark」分开列,后者图里的 Jev 数字来自第三方,而且涉及不同版本与路由策略,不能与这次的基础版测试合并比较。他自己给的结论是,Laya 在部分分类任务上展现了本地替代的潜力,这一轮还不足以证明它能通用替代 Jev,真正部署前要用自己的业务样本验证。
1960 年代的算法,排在八个记忆系统前面
X 用户 Kadir Emre Parlak 9 月 22 日在 Medium 上公开了一份复现:在 MemoryAgentBench(Hu、Wang 与 McAuley,ICLR 2026)的多分类任务上,他跑了一个纯 TF-IDF 加 kNN 的基线,没有 LLM、没有 embedding、没有训练,约 200 行 Python,得分 68.0% 7。
这个分数排在八套已发表记忆系统的前面:Self-RAG 11.6、Mem0 32.4、Cognee 35.4、MIRIX 38.4、GraphRAG 39.4、RAPTOR 59.4、HippoRAG-v2 61.4、Zep 62.8。同一张表上,不带任何记忆层的 GPT-4o-mini 是 82.4。他引了这项基准的作者自己写的一句话:两个基于 RAG 的 agent(Mem0 与 Cognee)在上下文并不长的时候,表现也明显低于它们的底座 GPT-4o-mini 14。
同一份基准上还有一个事实冲突任务 FactConsolidation:事实带着递增的序号到达,后到的覆盖先到的。他写了一个正则解析器,覆盖语料里的 40 个事实模板,策略就是「取序号最大的那条」,在没有 LLM 的情况下做出单跳 89.0%、多跳 12.0%,两栏都高于已发表的最好成绩(54% 与 7%)。接着他做了一次稳健性测试,把一部分事实改写成解析器不认识的同义表述后,准确率随改写比例下滑:改写到约 40% 时已经掉到 54% 以下,改到 100% 时归零。他把这个结果当作对基准本身的批评——这项任务的难点主要是表层措辞的难点。
他把自己的三条边界写得比结论更清楚:这份基线并不好,它输给每一个长上下文模型,也输给纯 BM25,它是地板而不是方法;他没有重跑那些系统,是拿这份基准已发表的数字做对比,实现差异没有追踪;榜单会被刷,Zep 自己报过 LoCoMo 84%,独立方用十轮与四个已校验类别修正之后是 58.44%,所以同样的怀疑也要用在他自己的数字上 15。他还引了两项他人的研究:一项说记忆效用随合并推进先升后降、可以低于无记忆基线;另一项把证据抽取与策略执行分开,把多跳从 7% 提到 27% 到 41%,并且指出把最后的执行器从 LLM 换成确定性代码只多 2.0 分 1617。代码与数据集都公开,几十秒能跑完 1819。
同一台机器,一项默认设置让 prefill 差近一倍
Reddit 的 r/LocalLLaMA 上,用户 /u/Blindax 用一晚时间把自己 llama.cpp 的路由预设逐个量了一遍。机器是 Ryzen 7 9800X3D、128GB DDR5-6000、RTX 5090(PCIe 5.0 x8,同时带桌面)加 RTX 3090(PCIe 4.0 x8),系统 Kubuntu,llama.cpp 自己编译(CUDA 13.4,build 11028),跑的是 Qwen3.8-27B 的 UD-Q6_K 与 Q8_0,以及 Qwen3.8-Flash-Next 的 UD-Q4_K_XL 8。
最干净的一组是同一份 20.6k token 文档、ubatch 4096、其余条件不变,只动 lazy-mode 与加载方式:
| 设置 | 预填速度 |
|---|---|
| lazy-mode 开 + load-mode mmap | 704 tok/s |
| lazy-mode 关 + load-mode mmap | 1,104 tok/s |
| lazy-mode 关 + load-mode none | 1,220–1,234 tok/s |
在默认的 ubatch(512)上叠加「lazy-mode 开 + mmap」,他量到的是约 300 tok/s。机制他也量了出来:跑 Flash 预填时,nvtop 显示 5090 的接收速率大约 28 GiB/s,这已是 Gen5 x8 链路的饱和值,瓶颈在专家权重每处理一个小批次就要过一次 PCIe。顺着同一个瓶颈往下,他的第二组结论是:卸载 MoE 的时候,ubatch 比 n-cpu-moe 重要得多——ubatch 从 2048 提到 4096,预填从 941 涨到 1,234 tok/s(+31%),而多搬两层专家回 GPU 只有 +3%。
第三组把方向反过来。27B 的 Q8 权重完全放进两张卡、瓶颈不再是 PCIe 时,batch 与 ubatch 设成相等会把流水线杀掉:2048 / 512 是 2,669 tok/s,2048 / 2048 掉到 2,040,4096 / 1024 是 2,702。他的建议是把 batch 保持在 ubatch 的 3 到 4 倍。第四组的结论与常见直觉相反:27B 上,5090 单卡跑 Q6 是 2,766 tok/s 预填、约 100 tok/s 解码,双卡切分的 Q8 是 2,687 tok/s 与 69.5 tok/s,那张 3090 拖住了整条链路;他现在的默认是单卡 Q6 开 128k 上下文,只有超过 128k 才用双卡。
投机解码这一组也有具体的最优值。draft 数从 2 加到 3 让解码提升 12%(61.9 到 69.5 tok/s),加到 4 只有不到 1%,而且接受率掉到约 58%。他给了一张按任务分的接受率:数值推理 75%、代码 68%、Pillar Two 指令摘要 73%、GDPR 摘要 75%。长文档那张表里,同一台机器同一份预设的差别全在上下文长度上:61k token 的文档,27B Q6 单卡 2,364 tok/s 预填、23.7 秒首字、97.9 tok/s 解码、全程 47 秒;97k 的文档是 1,929 tok/s、50.5 秒、86.0 tok/s、1 分 48。同一台机器换成 Flash Q4 双卡,61k 是 862 tok/s、65.1 秒、30.5 tok/s、2 分 44;97k 是 807 tok/s、2 分 01、26.7 tok/s、4 分 43。从 61k 到 97k,27B 的预填掉 18%,Flash 只掉 6%,因为它卡在 PCIe 上,与上下文长度无关。
Loading content card…
作者把自己的边界写在开头与结尾:帖子的结构与措辞用了 AI 助手,所有数字来自他自己的运行与日志;方法是 Open WebUI 接 llama.cpp 路由、整份文档直接进上下文而不走 RAG、每次开新会话、每次加载预设后先跑一次热身;除了 lazy-mode 那组 A/B 之外都是单次运行。到取回时这条帖子 8 个赞、11 条评论,标签是「Tutorial | Guide」。
一个开关把 36.6 提到 72.7,填满上下文又掉回 41.3
X 用户 @Jyo_Hug 9 月 22 日贴出的这台机器是一张改装到 20GB 显存的 RTX 3080,98k 上下文,MTP 投机头直接放在 GGUF 里,权重是 bartowski 的 IQ4_XS 未审查版,4.25 bit per weight 9。
关掉投机解码的起点是解码 36.6 tok/s,llama-bench 的原生成绩是 38.0 tok/s(tg128)、1,288 tok/s(pp512)。打开 MTP 之后,空上下文是 72.7 tok/s,填到 16k 掉到 53.5,33k 是 48.7,67k 是 47.5,91k 是 41.3;这一轮草稿接受 404/580。预填速度 769 到 1,062 tok/s,看深度。他算的两个比例值得单独记:原生解码已经跑在 1,368 GB/s 这类带宽上限的 78%,投机解码跑到原始上限的 149%。他还提到这张卡花的钱不到一张 3090 的三分之一。
Loading content card…
同一个人把整轮过程放进了公开仓库。rtx-3080-20gb 有 31 次提交,README 记的当前最好成绩是 72.68 tok/s:llama-server 加 IQ4_XS 权重、
--spec-type draft-mtp、-ub 256、-c 98304,生成 600 token、温度 0、三次取中位;同一张表上还有 base 权重的 66.15、上游 llama.cpp 的 67.9、三元权重 Bonsai 双实例共驻的 64.1,以及一份从 h0 到 h38 的逐次尝试记录 decision.tsv 20。需要留意的是,推文上那条 72.7 与 README 里的 72.68 不是同一次运行:前者是空上下文的单次测量,后者是固定协议的取中位结果。这份材料的边界有几条:单人单卡,发布账号很新(12 条帖子),没有第三方复跑;「未审查」权重与官方权重的输出质量无法直接比较,所以这组数字能用来看「同一套权重开不开投机解码的差别」,不能用来给这张卡的模型质量下结论。
看一个数字之前,先问它算的是哪一栏
今天这八组材料给不出一个统一的名次,能带走的是一套看数字的动作。三句话够用。
第一句,这一栏是谁算的。Grok 4.7 在 Terminal-Bench 4.0 上,厂商自己贴出来的数字是 38.0%,独立评测方测出 26%;同一个模型在 Next.js 那条榜上是每例 $0.109、94%,比榜首便宜六倍多。这三个数都真,分别属于三张不同的表。
第二句,旁边那几格跟着动了没有。同一批编码题加上一份 AGENTS.md,五个模型从 81% 到 90% 一起升到 97%,同一张表上另外四个只到 90% 到 94%;阶跃那份六案例横评里,平均分差距是 0.5 分,而作者自报的花费差到八倍。看到一栏数字变化,先看它旁边那一栏有没有跟着变。
第三句,你拿到的是哪一段。同一张改装显卡上,开不开投机解码是 36.6 与 72.7 tok/s 的差别,而打开之后从空上下文填到 91k,速度又从 72.7 掉到 41.3;Reddit 那台双卡机器上,61k 文档的预填是 2,364 tok/s,97k 时就掉到 1,929。
最后留一个能自己动手的核对项:挑一条自己常用的提示词,在同一台机器上只改一处设置跑两次——先关掉投机解码再打开,或者先把预填的 ubatch 从 512 改到 4096——把预填速度、解码速度和草稿接受率记下来。今天这两组本地实测里,同一套权重在 36.6 与 72.7 之间,隔的就是这几行配置。
References
- 1
- 2Artificial Analysis:Grok 4.7 发布评测\
artificialanalysis.ai
- 3Next.js Agent Evals\
nextjs.org
- 4公众号 阶跃 Step 5 Preview 到底啥水平\
mp.weixin.qq.com
- 5公众号 科沿社:AI 办公三强实测\
mp.weixin.qq.com
- 6小红书 Jev本地平替?我测试了Laya\
xiaohongshu.com
- 7
- 8
- 9
- 10
- 11DataCamp:Grok 4.7 与 GPT-6 Astra 对比
datacamp.com
- 12小红书:别急着换更贵模型,写好你的 AGENTS.md
xiaohongshu.com
- 13vercel/next-evals-oss
github.com
- 14MemoryAgentBench 论文
arxiv.org
- 15
- 16
- 17
- 18
- 19Hugging Face MemoryAgentBench 数据集
huggingface.co
- 20GitHub JamieJ5926/rtx-3080-20gb
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.