Qwen3.8-Omni 技术报告:三路编码器与四个预训练阶段,参数量仍未公布
解读阿里 Qwen 2026 年 9 月 22 日挂出的技术报告:它补上了官方博客没给的架构与训练配方——三路感知编码器、稀疏 MoE 骨干、四个预训练阶段,也第一次给出语音克隆与定制音色的对照读数;参数量与权重仍然没有。

2026 年 9 月 22 日,Qwen 团队在 arXiv 挂出技术报告《Qwen3.8-Omni: Towards Native Omni-Modal Agents》,署名是「Qwen Team」,末尾把作者分成两档列出:核心贡献者 41 人按字母序排列,通讯作者标在 Dayiheng Liu 与 Jin Xu 名下,另有 Contributors 一栏的一百二十多人12。报告按 CC BY 4.0 发布,主分类 cs.CL,另标 cs.CV 与 cs.MM1。它写的是四天前已经上线的那一代模型:Qwen3.8-Omni-Flash 与实时版 Qwen3.8-Omni-Flash-Realtime23。
9 月 18 日那篇官方博客把架构细节留在外面,页面标题后还带着
[draft] 标记3。这份报告补的正是那一层:混合稀疏 MoE 骨干、三路感知编码器、四个预训练阶段、2.5 万亿 token 的模态配比,以及多教师蒸馏加统一强化学习的两段后训练。参数量依然缺席,报告里没有这个模型自己的参数与算力数字;能查到的规模属于它的骨干家族,那份架构报告写的是 125B 总参数、每 token 激活 6B,另有 51B 的 n-gram 嵌入表放在加速器之外24。两份材料并排读,数字都对得上——多说话人分离的 3.4|17.2、实时接口的首次音频包 978 毫秒、每小时音视频输入 0.20 美元,报告与博客给的是同一批读数23。出入在陈述层:博客里「材料没有给架构」这句话被作废;博客把实时版本称作「首个能靠声音定位目标的全模态模型」,到了报告的正式文本里,这项能力换成了可比的读数,OmniEchoBench 上从 23.3 提到 43.923。
骨干是三路编码器加共享的稀疏 MoE
模型沿用家族里的 Thinker–Talker 结构:Thinker 负责文本,做推理、对话与工具调用;Talker 负责把回复说成语音2。Thinker 的骨干是 Qwen3.8-Next 那套混合稀疏 MoE——专家稀疏激活,token 混合交替使用 Gated DeltaNet(把前文压进固定大小的递归状态)与全注意力层;注意力层在预热与稀疏训练两个阶段过渡到 Qwen Sparse Attention(QSA),由一个轻量 indexer 给压缩后的 micro-block 表示打分、挑出相关的上下文块,核心注意力再在这些块内的原始 token 上做2。这套骨干的消融与取舍写在 8 月 31 日那份架构报告里,包括混合层每四层放一个全注意力层4。
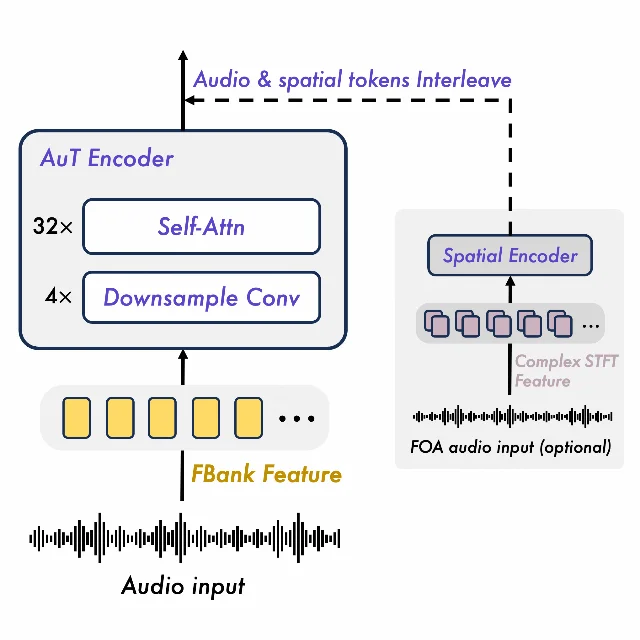
接进骨干的感知通道有三条。视觉编码器取自 Qwen3.8-Next,吃图像与按需抽样的视频帧。通用音频编码器 AuT 用四个 Conv2D 把声学特征下采样 16 倍,接时序自注意力,输出的是 6.25 Hz 的 token,约合每 160 毫秒一个;它在二十多种语言的语料上预训练,中英等语言的配比是 3.5:3.5:3,监督信号来自 Qwen ASR 模型生成的转写2。
第三条通道是这一代新加的空间音频。多通道输入先转成一阶 Ambisonics(FOA),Spatial AuT 再对 FOA 通道的复数短时傅里叶变换做处理,保留实部与虚部,从而保住通道之间的幅度与相位关系——声源的方向、距离和运动就藏在这些关系里2。位置编号的安排值得一提:同一时间片上的空间音频嵌入共享时间索引,但各自保留空间位置索引,与同一帧里不同位置的图像块一样处理,这样既能和音频流对齐,又能让模型区分同一时刻的多个空间表征2。
四个预训练阶段与 2.5 万亿 token 的配比
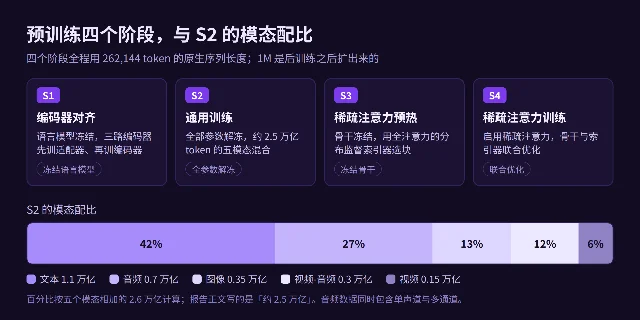
四个阶段都跑在 262,144 token 的原生长度上,1M 是后训练之后再扩出来的2。顺序值得记住,因为每一段冻的是不同的东西。S1 冻结语言模型,让三路编码器各自先训适配器、再训编码器本身;S2 解冻全部参数,用约 2.5 万亿 token 的多模态数据做通用训练;S3 转过头冻结骨干,拿全注意力的分布当监督去训 QSA 的 indexer,此时注意力仍是稠密的;S4 才启用 QSA,让骨干与 indexer 联合优化2。
S2 的数据配比是文本 1.1 万亿、音频 0.7 万亿、图像 0.35 万亿、视频 0.15 万亿、视频–音频 0.3 万亿,音频里同时有单声道与多通道数据2。这五个数相加是 2.6 万亿,比正文那句「约 2.5 万亿」多出 0.1,属于报告里数值衔接上的一处松动。
语言覆盖面报告列了一张表:文本 201 种,语音输入 113 种(74 种语言加 39 种中文方言),语音输出 36 种(29 种语言加 7 种中文方言)2。这张表的标题写的是「Qwen3.8-Omni-Flash-Plus」,而摘要与全文其他位置都只有 Qwen3.8-Omni-Flash 这个名字,
Plus 是排版时留下的痕迹2。文本能力保住了多少
后训练分两段。第一段是多教师蒸馏:教师模型都从预训练的 Qwen3.8 基座出发,各自做监督微调与强化学习,分别专精通用指令跟随、基础推理、编码、智能体、视觉理解和音频理解,再由它们生成各自的领域轨迹,混成一份多模态训练混合,蒸馏进一个学生模型2。第二段是跨文本、视觉、音频与混合模态的统一强化学习,奖励同时评估任务级正确性与交互质量;对长程智能体任务,奖励由任务结果与执行结果决定,而不是由模型自己报告完成2。这条口径对做智能体评测的人直接有用:自报完成在这里拿不到奖励。
「吃进音视频之后文本能力还剩多少」,报告的表 2 给了读数,也给了需要收窄的地方。对同尺寸的纯文本型号 Qwen3.8-Flash,这一代在 SWE-bench Pro 上 63.3 对 62.5、CoWorkBench 上 75.3 对 73.9、NL2Repo-Bench 上 48.9 对 48.1;在 DeepSWE 1.1 上 57.8 对 58.7、SWE-bench Multilingual 上 80.5 对 81.02。通用项里 IFBench 81.5 与 LiveCodeBench v6 的 92.6 是列表里的最高分,GPQA Diamond 91.0;同一张表上 HLE 是 36.5,低于 Claude-Opus-4.6 (Max) 的 40.02。互有胜负、差距都在一两个点内,这个说法才站得住;「与纯文本型号相当」在表 2 上成立的范围到此为止。
视觉这一侧,表 3 里最高的是 LVBench 76.9,AndroidWorld 87.1 高于 Qwen3.8-Flash 的 84.5,MathVision 91.8、加上 CI 设置 96.2,CharXiv 83.5、加 CI 91.42。同表里 ClawEval-MM 提供了一个读表方法的样本:平均分 61.9 高于 Qwen3.8-Flash 的 60.4,Pass@3 却以 60.4 低于对方的 64.4——三次里至少过一次的比例与三次平均分是两件事,报告把这个区别写了出来2。
长视频:从全塞进去改成按需找证据
几小时的视频里,真正有用的画面常常只有几分钟。报告的做法是让模型从问题出发规划分析路径,用工具调用由粗到细地取音视频片段,必要时把音频与视觉分析并行分给多个子智能体,把计算压到相关片段上2。三种长视频推理基准上,直接理解与跑 Qwen Code 的智能体模式分别是 OmniVideoBench 63.4 到 67.8、Video-MME-v2 65.0 到 71.3、LVOmniBench 63.3 到 73.6;每次查询的 token 从 145,736 降到 79,117,约少用 45.7%2。
这张表要在两点上读。报告自己写明,智能体模式跨轮保留上下文,两种设置的条件因此并不完全对等;它同时说明,这组读数说明的是准确率与 token 之间的折中,端到端延迟与金钱开销并没有对应的下降读数2。另外,同一个运行时也在给对照模型加分:Gemini 3.8 Flash 跑 Qwen Code 时,OmniVideoBench 从 65.2 升到 70.1、Video-MME-v2 从 71.0 升到 72.7,LVOmniBench 停在 70.72。智能体模式的涨幅是模型与运行时的合计,整段记到模型头上会高估。
成本为什么能压下来,报告给了博客里没有的那一层:它把视频输入摆在三个困难的第一个——存储与传输开销大、token 预算高,长内容在智能体流程里很贵2。对应的四个模块是 Omni-Caption 把视频转成详细字幕、Omni-Video2Note 转成结构化文字摘要、Omni-Memory 对音视频内容做智能体式懒加载、Omni-Skill-Creator 把教程或标准流程视频转成可被运行时调用的技能2。这四个名字 9 月 18 日的博客里出现过,它们要解决的问题这次才写清楚。至于每小时音频输入降 98% 以上、音视频输入降 93% 以上这两个降幅,报告只给了结论,估算口径仍要看博客那张价格面板:两分钟素材乘 30、音视频按 720p 每秒 1 帧采样3。
语音克隆与定制音色:这一版才放出来的两张表
博客里语音只有一张延迟表,质量对照这次才出现。表 11 看零样本克隆,表 12 看定制音色的可控性,对照对象是 SeedAudio、MiniMax-Speech-2.8、Gemini 3.1 TTS Flash、SeedTTS 2.0 与 ElevenLabs V32。
克隆这一侧,报告用内容稳定性(词错率或字错率,越低越好)与音色一致性(说话人相似度,越高越好)两组指标。在 SEED 基准的中文、英文与困难子集上,这一代的内容错误率是 0.74、0.89、5.29,上一代是 0.99、1.26、6.37,SeedAudio 是 1.76、1.02、7.70,MiniMax-Speech-2.8 是 0.82、0.99、9.082。长语音生成上的差别更大:上一代在中文与英文上的字错率是 19.25 与 4.52,这一代收到 1.74 与 1.59,音色相似度也从 0.597、0.470 提到 0.820、0.7682。整体克隆分(SpeechSuperClue,自建)这一代多语 3.749、跨语 3.306,高于 SeedAudio 的 3.448、2.756 与 MiniMax 的 3.589、3.0212。
定制音色这张表的两个方向更值得记。音素准确率这一代是 93.3%,上一代 61.3%,Gemini 3.1 TTS Flash 86.6%,ElevenLabs V3 78.0%,SeedTTS 2.0 67.2%,MiniMax 2.8 HD 62.7%2。自然度这一项反了过来:ABX 胜率这一代 72.7%,略低于 Gemini 3.1 TTS Flash 的 74.2%,高于 SeedTTS 2.0 的 66.2%、MiniMax 的 48.0% 与 ElevenLabs V3 的 23.1%;风格可控率 95.0%,也低于 Gemini 的 97.5%2。要拿它替换手上的配音,音素准确率与长语音稳定性这一侧已经可以换,自然度与风格可控这一侧还得和自己的素材一起听。
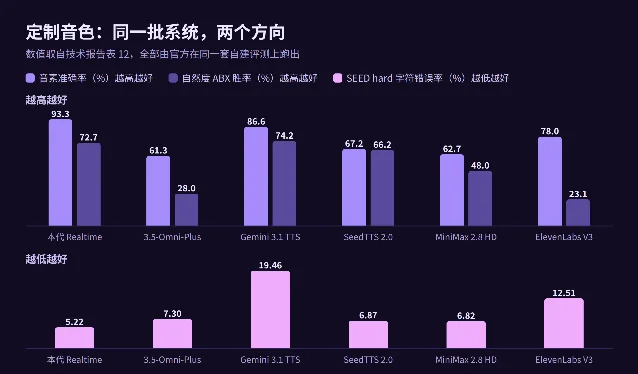
这两张表的评测范围要跟着数字一起读。SpeechSuperClue、LongSpeechGeneration 与方言口音克隆在报告里都标了星号,属于自建评测;音频这一块另有一套自家的 OmniLingua-Bench,覆盖长音频识别、多说话人转写与语音指令跟随25。外部基准这一侧,多说话人分离的 AliMeeting、AISHELL-4 与 MagicData-RAMC 都是中文或中英会议域,结论往外推的时候要收着。
实时这一章:Talker 的五段训练与 Live Harness 的三件事
实时版本补的是博客没写的机制。Talker 工作在残差矢量量化(RVQ)的 token 上,用一个多 token 预测模块建模残差码本,控制声学细节;系统提示词专门用来指定目标音色;流式生成靠 ARIA 对齐并交错文字与语音 token,让模型能从半截文本继续发声;因果 Code2Wav 解码器加了一条上采样路径,波形重建从 24 kHz 提到 48 kHz2。
训练是五段接力的。先建一套平衡的数据流水线做预训练,再用持续预训练引入复杂的对话上下文语料;接着训练各语言专家,并用多教师同策略蒸馏把它们合起来,这一步针对的是单语语料带来的外国口音残留;然后是轻量的说话人微调;最后在强化学习阶段先微调 Thinker 去对齐人类偏好,再用它给出的奖励信号以 GSPO 优化 Talker2。延迟表的测量条件这次写全了:音频按 16 kHz 单声道 PCM 传输,音视频还带 1280×720、每秒 1 帧的画面,每档取 10 次有效响应,关闭语音活动检测,时延含网络传输但不含连接建立与输入上传2。
Qwen-Live-Harness 这件外壳由三块能力组成。异步工具与子智能体:前台智能体通过统一适配器把任务交给 Qwen Code、Codex 或 Claude Code,提交后立刻回执,对话继续,进度与结果异步进入上下文,用户打断语音不会取消已委派的任务,通话结束后后端任务仍可继续26。主动交互:用户可以按音频、画面与时间定义条件,监视任务跑在独立的实时会话里并产出文本事件报告,前台智能体在对话允许时把它转成语音通知,冷却时间与连续正检抑制用来压掉重复提醒2。持久记忆:录下的对话、显式工作记忆与跨会话保留的用户事实放在一起,可复用的信息整合成画像,用词法检索加可选的嵌入匹配取回;开启视觉记忆时,保存的是从抓帧里得到的文字观察2。这三块都写在这份报告里,也都在那个 Apache-2.0 的运行时仓库里有对应实现7。
报告没有回答的问题
参数量与训练算力仍然没有。报告完整交代了骨干形状、编码器结构、数据配比与训练顺序,却没有这个模型自己的规模数字;能借用的是骨干家族的 125B 总参数、6B 激活与 51B 旁挂的 n-gram 表24。权重与训练代码也没有放开,两个开源仓库放的是插件与运行时——前者 7 月 29 日建仓,后者 9 月 10 日建仓,都是 Apache-2.0——模型本身仍然只有 API 一条路789。
对照条件也没有给全。闭源模型跑在哪套运行时只写明了一部分——WildClawBench-MM 与 AgenticVBench 用 Claude Code,UniClawBench 用 OpenClaw,OmniGAIA 不带外部运行时;Gemini 一侧的配置与推理档位没有交代2。
还有两处需要读者自己留意的内部不一致。表 1 的标题写着「Qwen3.8-Omni-Flash-Plus」,这个型号在报告其他地方都不存在;表 5 里 OmniEchoBench 一栏记 43.9,同一节的正文写的是「从 23.3 提升到 41.7」2。标题与模型名之间也有一层:论文标题是 Qwen3.8-Omni,摘要和正文里用的模型名是 Qwen3.8-Omni-Flash1。
最后,这是一份未经同行评审的预印本,v1 于 9 月 22 日提交,全部读数出自官方自己的运行时与评测流水线1。它相对上一代的位置倒是清楚的:Qwen3.5-Omni 的技术报告当时写的是 256K 上下文与十小时以上的音频理解,这一代把原生序列长度定在 262,144,再在后训练之后扩到 1M,并把空间音频作为新的输入模态接进统一序列210。
可以带走的三件事
第一件是编码器分路加共享骨干的排法,以及那两次「先冻后放」:S1 只让编码器与适配器学习,S3 只训 QSA 的 indexer,两次都把主干按住,等新部件的分布对上再一起放。这套顺序不依赖它的规模,搬到自己的多模态微调与稀疏注意力改造上都能用2。
第二件是长内容的账要连条件一起读。按需取证据把每次查询的 token 压掉 45.7%,代价是条件变了——智能体模式跨轮保留上下文,报告自己也标了这一点;判断这条路值不值得接,要拿自己素材上的 token 与延迟一起量,别人的 45.7% 只是一次条件下的读数2。
第三件是语音线分轴验收。音素准确率、长语音稳定性与多语克隆这些轴上读数已经够用,自然度与风格可控这两轴仍落后 Gemini 3.1 TTS Flash 一点,另外这几张表多半来自自建评测2。
References
- 1
- 2Qwen3.8-Omni 技术报告全文
arxiv.org
- 3
- 4
- 5QwenLM/Omnilingua-Bench
github.com
- 6QwenLM/Qwen Code
github.com
- 7QwenLM/Qwen-Live-Harness
github.com
- 8QwenLM/Qwen-MM-Plugins
github.com
- 9qwen3.8-omni-flash 模型信息(阿里云百炼)
help.aliyun.com
- 10Qwen3.5-Omni Technical Report
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.