10月15日论文雷达:最弱模型配上全流水线反超最强模型零样本、同一道题只换答案抽取协议就从 20.8% 跳到 93.9%、静音输入仍保住 +11.2 点的音频后训练增益:长程智能体与生成式音频的 147 篇分层雷达
本期把该账号 10 月 15 日发布的一个批次逐条筛完:151 篇里收录 147 篇。围绕模型的那层确定性工程能把最弱模型抬到最强模型零样本之上;同一道题只把答案抽取从正则换成显式标记,准确率就从 20.8% 跳到 93.9%;把音频换成等长静音,音频大模型的后训练增益仍保住 +11.2 点,去掉选项后只剩 +2.3 点。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。本期筛选该账号在 2026 年 10 月 15 日 13:56(GMT+8)发布的一个批次。这一批里落在候选池的只有两栏:自然语言处理学术速递[10.15],131 篇;语音与音频学术速递[10.15],20 篇。该账号在这批图文的公告里写明 cs.AI、cs.CV、cs.LG 当天 0 更新,所以这一批没有发布「人工智能学术速递」;同批次的机器人(idx=4)与统计学(idx=6)两栏不在候选池内。10 月 13 日与 14 日该账号只发过单篇论文导读,没有发布任何「学术速递」栏目,本期的覆盖窗口因此是 10 月 15 日这一个批次。
公众号正文自 10 月 6 日起只展开每栏前 8–9 篇(本期 NLP 栏前 9 篇、语音栏前 8 篇),完整列表留给它自己的站点。本期候选池按该站点同日同名两栏的完整条目重建:两个分类列表下当天共 332 条列表条目(其中含交叉投稿与版本更新),去重后 326 篇论文;其中被站点标注为「新提交」(当天首次提交)的按两栏分别为 131 篇与 20 篇,两栏之间没有重复,合计 151 篇构成本期候选池。站点条目带英文原题、中文题、机构与 AI 总结,与公众号条目同源;它与 arXiv 原文不一致的地方,在条目里逐条标出。每篇在全景表里都给出公众号栏目、站点条目与 arXiv 全文三处入口。本频道的候选池固定为该账号这三个栏目;arXiv 摘要页、arXiv 原文,以及论文原文明确链接的作者官方代码仓库、项目页与数据页,本期只用于核验与复现情况。
151 篇逐条读完后收录 147 篇,排除 4 篇——2610.19028(科幻与通俗小说里的性别指称建模)、2610.19294(字符级多语言 BabyLM 预训练)、2610.20279(低资源语言 Saraiki 词性标注)、2610.19532(教育平台的学生能力与题目难度联合建模);这四篇与四条线之间只有泛泛的相关性,搬不出具体设计。收录的 147 篇按与四条研究线的关系分层:直接命中 52 篇、邻近跟踪(不在研究线上,但对某条线有明确可迁移价值)95 篇。再按建议的阅读投入分档:精读 33 篇、值得扫读 37 篇、其余 77 篇为最轻一档。这一档与上面按研究线分层得到的「邻近跟踪」层同名而口径不同:前者说的是这篇值不值得读,后者说的是论文与哪条研究线相关。四条线按每篇的主要归属计:大模型长程任务的训练与评估(A 线)106 篇、轨迹学习与自进化(B 线)16 篇、TTS 生成与评估(C 线)25 篇、播客生成与节目级评估(D 线)0 篇;归并口径是条目所在的节——第一、二、三、四、七、九、十、十一、十二节计入 A 线,第五、六节计入 B 线,第八、十三节计入 C 线,D 线本期为 0 篇、没有对应节,只在本期末节说明该线的覆盖情况。正文按主题分 13 节,全景表第一列是建议的阅读投入(1 精读、2 值得扫读、3 只按连接点取用,取用档与第二列的「邻近跟踪」层同名而口径不同),第二列是条目与四条研究线的关系(直接命中 / 邻近跟踪)。收录的这 147 篇与本频道此前 46 期已收录的论文逐条比对,没有重复:本期候选池的 arXiv 编号全部不小于 2610.18881,而上一期收录的最大编号是 2610.13948,两个编号区间本身也不重叠。另有 5 篇的原文没有提供 HTML 全文(2610.19644、2610.19735、2610.19789、2610.19890、2610.20399),它们的条目只到摘要层,全景表里的入口相应给到 arXiv 摘要页。
本期有十条判断值得先记住,理由与限定写在各自条目里。
围绕模型的确定性工程能填平模型差距:153 份法律文件的九格对照里,最弱模型配上全流水线拿到 Overall 0.948,最强模型零样本是 0.806;在两侧都计分的 133 份文档上做配对 bootstrap,全流水线相对零样本的差为 +0.117(p<0.001)。 1
测量工具本身就是结果:同一道题、同一个模型,只把答案抽取从正则表达式改成显式的
\boxed{},准确率从 20.8% 变成 93.9%。 2长程智能体交回来的最后一句话本身要单独测:480 条回复里有 258 条判为不可用(0.54),在 256 个回复点上加一条要求消息把该子集的失败率从 0.52 压到 0.43,再让第二个模型改写能到 0.36。 3
把长程任务编成类型化完成图、只收可校验轨迹做监督微调:Qwen3.6-27B 在 AutomationBench 上通过率升 4.00 个百分点,JobBench 的 Main/Easy 两档分别升 4.35 与 6.64 个百分点。 4
自蒸馏的现实检验:10 种方法在 ALFWorld、ScienceWorld、Search-QA、WebShop 四个基准与三种模型规模上对 GRPO 做统一对比,132 次训练合计 12,124.4 H800 GPU 时的开销下,没有一种方法稳定胜出。 5
音频大模型后训练的涨点里有多少来自「听」:MMAU 上的音频增益是 +14.8,把音频换成等长静音仍有 +11.2;再去掉选项改成开放作答,增益只剩 +2.3。 6
长音频合成可以在推理期补:只收紧注意力窗口、并给声学提示的 logits 加一个常数偏置,同一模型的整体词错率从 8.63% 降到 3.58%,说话人相似度从 0.659 升到 0.759,训练一步没做。 7
把检索从固定流程改成轨迹里的一个动作:学出来的策略在 IdiomKB 汉译英上把 I5 从 0.652 抬到 0.731、MQM 从 −3.94 抬到 −2.74,而检索率只有 30.6%。 8
排行榜的成对投票里,越相似的模型越「敢决断」:Chatbot Arena 中版本对、尺寸对与同实验室对的决断乘子分别是 ×1.37、×1.26、×1.12(95% 区间都排除 1),似然比检验 177.6(3 自由度)。 9
多说话人对话的评测第一次给出工作点:12 个系统在话轮结束召回 82.5–92.6% 时假正率只有 4.3–11.8%,但合格工作点上的成功打断召回最高只有 56.2%;5 个全双工智能体的让位平衡准确率落在 46.9–54.7%。 10
全景表
| 优先级 | 层级 | 论文(英文原题 · arXiv ID) | 改动位置(维度) | 核心可比结果(含比较对象与口径) | 阅读风险与证据局限 | 入口 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | Following the Flow the Law Requires: Training Voice Agents to Transfer to Unseen Regulated Procedures in Debt Collection · arXiv:2610.18881 | 把规范 FlowSpec 放进训练评测环,门控工具与话语目录,按谱系留出测迁移 | 9B 策略在 2,506 段对话上微调后,文本化检查 67–71%升至 93–100%、接地检查训练前已 97–100%;场景通过 15/43 升至 40/43,未训练 27B 为 37/43 | 单次运行、四部署、一条留出谱系;重复运行出现 8/21 与 9/21 波动;规范与监督同源,得分不等于法律合规;未做组件消融 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | HERO: Harnessing Evidence for Test-time Refinement and Prompt Optimization in Program Generation · arXiv:2610.19184 | 把 harness 拆成共享提示层与实例级测试时修正层 | 四类程序生成基准 pass@1 相对初始提示平均 +7.6(分基准 4.16、11.5、4.66、10.1),测试时修正平均再 +2.0;BIRD-SQL 63.55 对 GEPA 62.59 | 预算按 GEPA 设定固定,未覆盖反思与候选生成成本;表 3 的 DSCodeBench VES 正文写 57.8、表内为 59.8 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | REWIND: Uncertainty-Guided Trajectory Repair for Test-Time Reasoning · arXiv:2610.19561 | 把随机切点重生成改为熵梯度回溯选点、边界对齐与 MH 式接受的运行期修复控制器 | 3 模型族 5 基准共 15 个组合准确率均最高,比随机切点 MCMC 高 0.51–10.00 个百分点;Qwen2.5-Math-7B 的 MATH500 由 72.60%升至 77.60%(3 种子均值) | 无显著性检验;成本只报生成 token 数未归一 FLOPs;AIME2025 仅 30 题;7.6%样例无熵峰、14.8%检出未救回 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing · arXiv:2610.19705 | 路由策略里的执行范式门控与模式内模型选择 | 五域未加权平均准确率 61.4%,最强基线 Router-R1 55.3%(相对 +11.03%);去掉渐进探索降到 55.6% 且模式使用塌为纯单轮 1.00/0.00/0.00 | 未见种子数与置信区间,消融只有单点数值;α 为任务与效率两路优势的混合权重,α=0 只用任务信号、成本按 token 用量事后重建;域分数为未加权均值,跨基准比较需留口径说明 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Delta Tokenizer: Reference-Identical Tokenization of Session Deltas and Segment-Parallelism for Long Prompts on Multicore CPUs · arXiv:2610.19801 | 服务前端:会话内增量分词、长请求分块并行、尾感知调度接入 SGLang | 单轮会话分词约快 40 倍(HF 参考);16 核 400 万字符快 8.2 倍;100K 上下文 TTFT 中位数降 59% | 全部自建基准;LoPT 为作者重实现且对比系统本身有错 ID;多数吞吐为单次测量,未报种子数 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | A Strong Harness Narrows the Model Gap: A Comparative Evaluation for Legislative Document-to-XML Conversion · arXiv:2610.19999 | 模型外围的 harness 层级(工具、编排与持久状态) | 153 份法案 9 格:最弱模型全流水线 Overall 0.948 胜过最强模型零样本 0.806;配对 bootstrap Δ=+0.117(p<0.001,配对文档 n=133,非两格均值之差);低分文档率 31%→4% | 单一模型家族与两个辖区;每格只跑一次无种子;T2→T3 把分解、状态、上下文三件事捆在一起;DTD 与 gold 保密、未报成本 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Why Generate a Click? Plug-in Decision Heads for Web Agents · arXiv:2610.20107 | 在冻结生成器的 prefill 隐状态上挂决策头,用置信阈值级联决定该步是否免解码 | WebArena 的 174 个任务上 4B 从 12.5% 升到 13.8%、8B 从 13.6% 升到 14.6%,每步生成词元从 7.4 降到 3.1 与从 7.5 降到 3.3;τ=0.9 时七个离线集与生成器差距在低 0.3 点到高 1.4 点之间 | 增益集中在训练模板覆盖的 47 个任务,127 个新模板任务全部低于 7%;决策头绑定单一生成器与编号框动作语法;原文未给出代码或数据入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Taking the PULSE of Medical Reasoning: Step-Level Retrieval Timing for Knowledge-Grounded Inference · arXiv:2610.20292 | 运行期门控:按步用跨层隐状态几何探针决定是否触发检索并重生成该步 | MedMCQA 上 AUROC 0.7385 对 ReProbe 0.7350;MMLU-Pro(Biology) 上 Llama 0.7933 对 0.7406;检索调用较每步检索减少 72% | 需中间隐状态,不能用于黑盒 API;假设步骤边界显式;探针与层区间绑定骨干;仅 JAMA 给了校正后检验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | HACHIMI-II: From Role-Play to Learner Behavior Modeling for Faithful Student Simulation · arXiv:2610.19654 | 生成约束层(学习者状态推断 → 行为 harness 编译) | 项目反应一致率 75%/61%/63%,对照最强基线至多 53%/52%/48%;去掉状态推断后 ENEM 模拟均值 0.384 升到 0.802(真实 0.394) | 对话指标由单一判官标注;数据集仅数学与自然科学;每轮由真实前文预测,多轮自演未评;原文未报告区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Joint Subspace Sparse Attention for Efficient Long-Context Decoding · arXiv:2610.19026 | 解码期 KV 选择与执行内核(token 级稀疏注意力) | 128K 上下文单张 B200 上吞吐达全 KV 的 6.43 倍(GLM-4.7-Flash)与 1.51/1.88 倍(两个 GQA 模型);LongBench 与全 KV 最大差 0.67 分 | 精度结果无种子与区间;6.43 倍只属 MLA 的 GLM-4.7-Flash,勿当通用倍数;免收集增益只在特定 batch 条件给出 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | JetSpec++: Foresight Parallel Drafting with Self Refinements · arXiv:2610.19792 | 解码服务栈(草稿模型训练 + 草稿与验证流水线) | GB200 batch 1 下 Qwen3-8B MATH-500 达 1361.1 tok/s、相对自回归 7.45 倍(DSpark 4.94 倍),草稿每轮只暴露 0.66 ms(DSpark 3.80 ms) | 草稿模型占第二张 GPU 而对照多为单卡,非纯算法对比;batch 1 单请求;无种子与区间;作者自陈系统优化未做完 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | What Is a Clarification? Estimating Model-Dependent Input Ambiguity · arXiv:2610.20052 | 运行时交互门控:用模型可用答案集决定作答、澄清还是弃答 | AmbigQA-HQ 上集合 F1 / 精确集合匹配:Qwen3-4B 60.02 / 52.00、GPT-5.4-mini 74.09 / 54.00,均高于 ICE、Sampling-50 与 1-Enumeration | 仅 4 个模型与 2 个任务域;集合 F1 标准差极大(46.26);下游 AUROC 与平衡准确率只有图示无正文数值;原文未给代码数据入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Evaluating Compressed Memory: Dependence, Utility, and Content Benefit · arXiv:2610.19373 | 记忆评估的对照设计(依赖/效用/内容收益) | 9 系统三种子对照:4 个系统归零掉分却劣于各自训练替代(U 为 −1.414 到 −0.219 nats);QASPER 979 题文档输入 F1 19.98 对常量输入 12.54(表 1、表 3) | 收益均为相对指定对照模型与流程;合成任务上模型本身预测不可靠(512 目标准确率 14.78%);未控总成本与收敛。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | EGCForest: Structured Agent Memory Organization for Enterprise Group Chats · arXiv:2610.19836 | 智能体记忆的组织方式:不可变消息日志之上的三视图森林与四阶段检索 | 三基准平均答对率均为最高,比最强基线分别高 4.77、8.59、12.61 点;Company 上对 MemOS 高 20.85 点;检索 65 ms/查询 | Company 为企业内部数据不可复现;金标由大模型判定,未报判官一致性与区间、种子数;P@20 上界约 18% | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | MemDuet: Learning Dual-Process Memory for Long-Context Reasoning · arXiv:2610.19928 | 长上下文递归记忆的门控:小模型并行提案、大模型按序验证并改写记忆文本 | RULER-HQA 3.5M token 处准确率 75.78% 对 RL-MemAgent 71.88%(高 3.90 点),同时加速 49.61×、输出 token 少 99.14%;但 7K 处加速仅 0.983× | 测试集是 RULER-HQA 128 题开发集,主表未报种子与置信区间;作者称短输入更差、System 1 漏掉的证据无法找回 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Titan-Llama: Retrofitting Pre-trained LLMs with External Neural Memory Modules · arXiv:2610.19210 | 把 Llama-3.2-1B 前 4 层注意力换成块状分段注意力,历史 KV 压进测试时更新的外部神经记忆模块(NMM)以残差注入 | 相对分段注意力基线:QuALITY 23.87%→40.51%、LongHealth 14.50%→40.75%;RULER S-NIAH-1 在 8K/16K/32K 均 100.0 与全注意力持平;平均相对解码耗时 0.689(全注意力 1.00,Mamba-2 2.70),只训占总参数 1% 的外部权重 | 单一模型(Llama-3.2-1B-Instruct)与单次训练,种子数、重复次数、置信区间原文未报告;训练长度 16K,32K 以上 RULER 掉点;Multi-value 检索 32K 时 53.0 低于全注意力 70.0 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Beyond State Capacity: Why Retrieval Breaks in Mamba · arXiv:2610.19709 | 用只差一个相关性标记的反事实提示加门控与表示插补,定位 SSM 检索失败的深度时序 | 查询优先检索中,只把目标信息 10 个数字词元的选择门换成另一变体的值,未标记提示的准确率就接近标记版、反向替换则掉回低值;相关性在标记版 1–2 层内可解码,未标记版要近 10 层 | 结论只基于合成电话簿任务与两个 Mamba-2 检查点;准确率与 AUC 具体数值只在图中,引用前须回看图;原文未报告多种子重复 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Which Knowledge Should LLMs Trust? Uncovering a Generalizable Steering Direction Across Knowledge Conflicts · arXiv:2610.20067 | 推理期激活:在残余流上加一条知识选择方向,调参数知识与语境知识的取舍 | NQ-Swap 参数侧源匹配率 33.7→56.8(Llama-3.1-8B-Instruct);RAG 的 RGB 62.0±1.2→82.0±0.5,同表 ContextFocus 69.0、CK-PLUG 71.0 | 推理期干预且系数由验证集选定;表 7 只报 ±,未说明重复次数;无冲突时语境方向仍降准确率(ParaConflict 100.0→85.5) | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Cortex: Consolidating Context into Parametric Memory · arXiv:2610.20399 | 用前瞻性查询把上下文条件输出蒸馏成可合并的低秩或结构化前馈网络更新,目标是在移除上下文后仍保住增益 | 仅摘要层:4B–120B 稠密与 MoE 骨干、纯文本与多模态模型上多数设置位于「巩固–保留」帕累托前沿;14B 模型 50 次顺序事实编辑后 Cortex-Structural 恢复 88.9% 的上下文增益并保留 99.8% 非目标性能 | arXiv 未提供 HTML 全文(实测 /html/2610.20399v1/ 返回 404,只有 v1),数字仅来自摘要;无逐任务表、无基线细节、无种子与区间;原文未给出代码或数据入口 | 自然语言处理栏目 · 官网条目 · 摘要 |
| 2 | 直接命中 | Latent Compaction with Test-Time Training · arXiv:2610.20582 | 长上下文 KV 缓存:逐文档测试时训练,改初始化与两阶段蒸馏 | RULER 32× 压缩 96.7% 对 KVZip+ 40.0%;Phonebook 16× 均值 80.67%,把 diversifiers 换成随机文档 KV 只剩 20.50% | 主实验 Qwen3-1.7B、每文档 1 个 paired seed,未报多种子或区间;只算逻辑 KV 对数预算,非实测显存或速度;逐文档训练成本高 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Evidence-Anchored Overdose Death Prediction from Death Investigation Reports · arXiv:2610.19556 | 解释接口:抽取式理由对模板陈述,流水线对自解释 | 最佳「报告+抽取式理由」流水线 macro-F1 0.831,高于规则系统 SPOT 的 0.721;仅理由更差;二值特征逻辑回归 0.621 | 单一辖区、单次划分;银标三位教师一致性仅 κ=0.361;无代码与数据入口;未报种子与区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Share the Symbol, Not the Vector: Training-Free Fact Communication Across Language Models · arXiv:2610.19696 | 跨模型通信接口:只传符号索引,由接收方用自己拟合的词方向写入隐状态 | 25 对发送方–接收方在新场景四答成功率 72.0–98.3%,比中层写入高 65.0–96.2 点;无任务探针 45/45 预测命中 | 合成事实交换任务;27B 及以下接收方内部写入仍落后纯文本最多 14.1 点;两个 MoE 接收方无结果;原文未报告作者与机构 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Cascaded Retrieval with Cross-Modal Query Refinement for Efficient Visual Document Search · arXiv:2610.20367 | 昂贵多向量重排只作用在 top-K 候选内,并用语义分数在表示层精化视觉查询 | 四基准单查询 387–553 毫秒,比 SOTA(ColEmbed-3B-v2)的 4.5–32.8 秒快 8.4–80.7 倍;ViDoRe 3 的 NDCG@5 由 56.65 升至 58.85 | 索引与摘要成本不计入查询延迟;精度未报方差与显著性;摘要依赖闭源 VLM;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Can LLM Agents Efficiently Identify Appliance Faults? Insights From Diagnosing a Simulated Appliance · arXiv:2610.19291 | 智能体评测任务与环境设计(传感器+动作+多轮假设的 MCP 环境) | 12 个模型中仅 Gemini 2.5 Pro 一轮 pass^1 超 60%(61.1%),对照 Nemotron 12B/30B/120B 为 12.6/13.7/14.7%;RMST 1.74 轮(95% CI 1.52-1.95)对理性猜测者期望 5 轮 | 仅一台模拟家电与固定故障集,不能外推产线;判官单一;每模型 episode 量与采样次数正文未汇总;无代码数据入口,复现成本高 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | J-tau: A Fully Localized Japanese Benchmark for Tool-Agent-User Interaction · arXiv:2610.19638 | 交互式工具智能体基准的本地化、修题与评分聚合审计 | 表 2、表 1:airline 6 道修复题 GPT-5.6 Sol 77.8 对 tau* 27.8;Qwen3.5-4B 大量空回复仍被判 93.3、85.3、98.7,J-tau 上为 24.0、6.7、33.6 | 每题三次试验并报标准差;仅日语、缺 banking_knowledge 域;可解性核验只用一个模型;分数强依赖用户模拟器 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Interlock: From Local Correctness to Task Completion in Long-Horizon Agents · arXiv:2610.19686 | 任务合成与轨迹准入:把长程任务编成类型化完成图并筛可校验轨迹 | 用自身被接受轨迹做 SFT:Qwen3.6-27B 较原检查点 AutomationBench 通过率 +4.00 个百分点、JobBench Main/Easy +4.35/+6.64、Harvey LAB +3.89 | 每格只训练一次,原文未报种子数与显著性;JobBench 与 Harvey LAB 由 GPT-5.5 判分;未见独立局限小节;原文未给代码数据入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | BANGLAPLAN: A Benchmark for Constraint-Based Planning and Decision-Making in Bangla · arXiv:2610.19704 | 基准与任务设计:约束规划任务集,把可行计划与不可行识别分栏上报并给常数基线 | 1,000 题(744 可行、256 不可行),11 个配置中 7 个低于永远回答不可行的 25.6% 常数基线;GPT-6.1 Sol 98.7%,Qwen3.5-27B 开思考 80.3% | 零样本单提示、精确匹配不给近似分;难度按约束计数未与人工耗时核对;微调结论只用 1 个 2B 模型 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Can LLMs Access their World Knowledge for Event Prediction? · arXiv:2610.19021 | 事件预测的输入接口与标签命名(每事件补描述、语义名换 type_i 符号名) | 七数据集平均:描述加符号标签最好,Qwen3.5-27B 平均 F1 0.290、Gemini-2.5 0.289,高于最强非 LLM 基线 KNN 的 0.231;语义标签无描述时 Gemini-2.5 为 0.261(图 1、附录 B.2) | 单轮 next-event 离线评测;F1 为跨标签宏平均且绝对值很低,不能作为世界知识能力的证据;未报种子与置信区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Recognizing Dialogue Ambiguity via Candidate Set Visual Grounding · arXiv:2610.19723 | 多目标集合评测:匈牙利匹配 P/R/F1,按对话轮次切样本 | CVG 准确率随规模升至 27B 的 0.819,CSVG 的 F1 从 2B 的 0.271 到最高 0.649;喂金标候选集后 F1 普遍提高 | 数据源自单目标 CVG 集、候选集变化模式单一;仅静态图与包围框;开源上限 38B;零样本且无重复统计 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | From Copying to Composition: How Language Models Develop In-Context Learning · arXiv:2610.19113 | 评测口径:把 ICL 评测从单一准确率拆成控制源、答案偏好、无候选构造与迁移四问 | 17 个模型中 6 个复制偏好 ≥.70、8 个 ≤.30;OLMo-2-7B 控制权在 336B–630B token 间易主,四选准确率约 1.5T token 才越过 .25 随机线,精确生成约 3.6T | 单一受控任务;训练实验只到 8B 且合成文档与诊断同格式,迁移为格式绑定;.70/.30 分档为作者自定,无显著性检验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | How to Evaluate When You Don't Know How to Evaluate? Choosing Reliable Setups for Base Language Model Benchmarking · arXiv:2610.19185 | 评估设置:示例数、提示、归一化、度量四类口径 | 2B 模型上答案概率赢 93% 两两比较、准确率仅 6%;5-shot 胜率 70%;264 组设置中分层配方排第 6(0.93 对最优 0.95) | 元度量只是可用信号的代理;仅四种欧洲语言、两档模型;跨规模差异作者称提示性;未报种子与区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Whose Data, Whose Benchmark? A User-Centric Framework for Auditing Evaluation Resources · arXiv:2610.19268 | 基准内容惯例、评分归一化与文档字段(来源用户与目标用户分离) | DROP 官方 EM 在等义变体下从 100.0% 降到 33.3%(95% CI[−92.3,−36.4]);TruthfulQA ROUGE-1 相似度 100.0 降到 88.9 而正确性仍 97.0%;16 个资源无一操作化目标用户 | 配对样本小(DROP 12 对、TruthfulQA 33 对);地理与经济为描述性关联非因果;33.3% 是评分器敏感性而非模型水平 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | PersEvalBench: Can LLM Evaluators Judge Contextually Appropriate Use of Persona Information? · arXiv:2610.19314 | 判官效度:多轮历史下用户信息该不该用的三分类判定与子类型 | 403 场景 806 响应;人评子集个性化不足人类 94.4% 对最强已报告判官 63.9%;恒判 Over 基线 ERR(错误识别率)67.7%、FAR(误报率)100% | Claude Opus 4.6 结果因发布限制未公开;场景合成且仅英语,作者称不能用于认证部署可靠性 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Measuring and Reducing Unusable Replies of LLM Agents · arXiv:2610.19659 | 把回复可用性做成请求者视角的评测口径,并在回复点加运行期指令 | 480 条回复中 258 条失败(0.54,单模型 0.30–0.82);另在 256 个回复点上(默认失败率 0.52,与 0.54 非同总体)加要求消息降到 0.43,二次模型改写降到 0.36 | 读者模型对 5 位标注者 κ=0.60,只验证过一种请求者画像;协作脚本化、判官模型单一;0.54 与 0.52 分属不同总体,不可混用 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | OpenTWBench (Open Taiwan Benchmark): Taiwan-Domain Knowledge Evaluation for Large Language Models, and How the Measurement Apparatus Shapes the Score · arXiv:2610.19848 | 测量工具即变量:抽取协议、提示占位符、思考预算、评委面板逐项做同题同模型对照 | 同题同模型把答案抽取由正则改为显式 \boxed{} 后准确率 20.8% 变 93.9%;难度带约六周后失效,108 个模型中 22 个超上限、最高 91.6% | 难度池仅七个模型且已过期;草稿来自单一生成器;继承约千分之一答案键噪声;两套件都是四选一选择题 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Similar Models, Broken Odds: Where Luce's Axiom Fails in Chatbot Arena · arXiv:2610.19095 | 排行榜评测口径:为成对投票加关系决定的决断乘子并分账平局 | 相对无关配对,版本对、尺寸对与同实验室对的决断乘子为 ×1.37(95% 区间 1.20–1.76)、×1.26(1.14–1.34)、×1.12(1.01–1.19),似然比 177.6(3 自由度);榜单排名相关 0.9999 | 公开观察性投票,无法分离逐票相似度与选民异质性;效应仅基于 17 个版本对与 49 个尺寸对;迁移检验回溯且区间含 0;复现代码仅承诺将发布 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision · arXiv:2610.19118 | 评测口径:给决策模型的扰动与提示注入攻击加标签一致性核验,并做跨模型候选筛选 | 常见图像扰动 ASR 核验前 47.2–70.4%、核验后 25.4–47.0%(五模型、320 样本);筛选外 GLiNER2.5-Decide-340M 扰动 ASR 11.4%,注入目标 ASR 55.3% | 核验模型为 GPT-5 mini、DeepSeek-V4-Flash、Claude Sonnet 5,换一批数值会变;原文未报检验与区间,且只评单个决策 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Not All Criteria Matter: Importance-Aware Criteria Weighting for Rubric-Based LLM Evaluation · arXiv:2610.19915 | 改的是 rubric 聚合环节:把整体权重分配改成 LLM 成对重要性比较 + 一致性修正 + 主特征向量 | 六个成对偏好基准上偏好准确率相对均匀加权提升 3.11%/5.08%/2.76%/3.84%/1.64%/5.79%,逐项高于最强基线 RRD-WU | 原文未做显著性检验;查询量随准则数二次增长;专业领域加权模型可能缺知识;仅 6 个基准、1 个默认加权模型配置 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Same Claim, Different Interpretations: How LLM Agents Resolve Ambiguity in Scientific Claims · arXiv:2610.20457 | 评测口径(判定与解读绑定,用单字段编辑做效度审计) | 量词改为全称后 56 个主张平均降 0.62 分(区间 -0.91 至 -0.35);带卡与不带卡符号准确率 0.68 对 0.71(差 -0.03,区间 -0.07 至 +0.01) | 主张仅 60+24 个、每张编辑卡只跑一次;编辑一律指向更难满足,无法分离普遍保守;单主干;未做多重比较校正 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Manacá-1B-Instruct-2: Reproducible Safety Alignment for a Native Brazilian-Portuguese LLM. Negative DPO Results, a Controlled Composition Scan, and a Silent Failure Mode of the LLM Judge · arXiv:2610.20570 | 改的是安全评测口径与判官审计:报 Wilson 区间与配对 McNemar 校正,并单独计数判官自身拒评 | 留出安全 97.2%(N=218)的区间下界 94.1% 高于四个基线区间上界;过拒 9.2% 仅对 Tucano-2b4 显著;DPO margin 到 1.0 而自由生成仍 0/16 | 过拒维多数无显著差异;组成扫描每点单种子且探针 N=16/34;模板与不确定实验仅 4–6 题单种子;真实有害顺从率 0.46% | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | NEPSEE: A Double-Annotated Benchmark for Nepali Sentiment Analysis · arXiv:2610.19190 | 双盲标注一致性子集加强度两可标签,并把 tokenizer 归一化纳入基准审计 | 3,189 句三分类 macro-F1:NepBERTa 0.877、IndicBERTv2 0.867、最佳 TF-IDF 0.766;五分制 Claude Opus 5.5 0.838 比 NepBERTa 0.721 高 0.116 | 只留极性一致句使基准偏易、未测 Neu–Pos 边界;仅 2 名标注者;每个 LLM 只用单一提示与温度 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Learning What to Keep: Transfer-Aware Personal Skill Learning from User Feedback · arXiv:2610.19380 | 把用户反馈拆成原子规则并逐条预测可迁移性 | 三个基座五项写作任务平均分 81.96、84.02、87.29,各超最强基线 1.61、1.13、1.32 分;去原子化降到 78.93、82.22、85.23 | 用户画像由大模型合成,只覆盖 1.7B–4B 与写作任务;无统计检验;代码入口 curl 实测 403,抓取被 Cloudflare 拦截 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Evolve Together, Fall into Place: How Social Scaffolding Shapes Self-Evolving Multi-Agent Systems · arXiv:2610.19799 | 自进化 MAS 的社会层——团队构成与相互依赖结构 | 27 个 MAS 配置中 24 个因合适结构优于只靠进化;最佳组合超过单独进化的强智能体最多 25.0 分(GAIA 用 SkillOpt:74.2 对 49.2) | 每条件只跑一次进化,SD 只反映评测噪声;结果与基准共线;α=0.3 门控与 6 会话并发可能影响结论 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | AtomSearch: Evidence-Grounded Tree Search for Agent Skill Optimization · arXiv:2610.19951 | 把技能修订拆成对比式原子编辑,用技能状态树搜索与结果记忆决定探索哪条修订路径 | deepseek-v4-flash 下四任务取三胜 SkillOpt,LiveMathematicianBench 52.42% 对 42.74%(+9.68 个百分点);技能长度为其 1/2.3–1/19.7 | 全为点估计、无显著性检验;组件消融仅在 SpreadsheetBench 单一设定;NDR 为自建单任务 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | MMLA-RSI: Recursive Self-Improvement through RTT and RTMA · arXiv:2610.20294 | 自进化的可变域划分:策略状态与权威记忆分两路并表示成可替换的后继 | 四候选程序选择的组件实验中,保留反馈更新使期望误差下降 24.65 与 36.65 个百分点;CI 回放上绑定有益而保留有害,SParC 配对增益 −1.75 点、CoSQL −0.979 点 | 无新实验,四项均为组件级证据且作者自陈未评估递归链;程序选择最终审计未开启;两项 SQL 配对增益为负 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | MolLean: A Process-Verifiable Language for Chemical Reasoning · arXiv:2610.20459 | 以可验证状态内核与有状态 MCP 接口否决单步动作并即时反馈 | 8,800 条样例、12 项任务上 Refine 相对直接 CoT 全部胜出,提升 12.0–48.2 个百分点;反应任务 MCP 最好(正反应 66.4%、逆合成 27.4%) | 只用一个主模型,无其它化学验证基线对照;未单列局限;12.0–48.2 是跨任务区间;成功判定由各任务自定 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | AdaRSI: On-Demand Recursive Self-Improvement for Embodied Agents · arXiv:2610.20474 | 自我改进的层级选择:先改 harness,再只微调不可靠子步骤 | RoboCasa365 未见复合任务成功率 4.6%→13.8%,套件级 48.8% 对 VLA 单独 42.4%;全量微调耗 3.5 倍 GPU 时间且成功率略低(12.6% 对 13.8%) | 纯仿真且依赖特权状态,真机待验证;无种子数与区间;Composite-Unseen 起点在 §5.2 与 §5.3 写作 4.6% 与 5.9% 不一致;部分任务权重轮反降分 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | PRISMATIC: Prescription Risk Inspection System for Multi-Agent Treatment Interaction in Clinical Decision-Making · arXiv:2610.19762 | 六智能体处方系统:内环 DFPC 局部归因修订,外环 DSWA 按维度误差重配评估权重 | MIMIC-IV 上 GPT-4o 基座 ZIR 98.20%、EM 13.58%;消融去 SC 使 ZIR 降至 78.98%,去 DFPC 使 EM 降至 7.42%,去 DSWA 降至 8.56%(表 3) | 仅一个基座做消融;表为点值无种子与置信区间;DSWA 权重演化为观察性描述;EM 绝对值低且为临床处方域 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Beyond Corrected Actions: Training LLM Agents on Textual Critiques · arXiv:2610.19367 | 把专家监督目标从「修正动作」换成「批评+修正动作」,并保留学生错误步在上下文中 | 4 个学生模型 × 2 个代理域共 8 个设定上,CAFT 平均高于仅动作蒸馏 8.4%,WebShop 的 Nemotron 3 Nano 4B 为 58.9 对 31.6;只训批评的变体平均高于只训修正的变体 5.0% | 原文未给出代码或数据入口;专家固定为单一 Gemma 4 31B;未报告种子数、置信区间与显著性,8.4% 只是八个设定上的平均 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | ForkGRPO: Efficient Exploration and Fine-Grained Credit Assignment for Diffusion Language Models · arXiv:2610.19408 | 在参考轨迹的高熵文本边界处对中间状态分叉采样,把组内相对优势与蒙特卡洛状态值差(段级信用)两种信号叠加训练 | 生成长度 256、表 1:GSM8K/MATH-500/HumanEval/MBPP 为 90.4/46.6/51.8/49.0,对照 JustGRPO 89.6/46.0/50.6/48.6;表 5 归一化 token 预算 0.7217–0.8125(少生成 18.75%–27.83%);表 2 五种子消融 ForkGRPO 90.31±0.06 对 JustGRPO 88.81±0.53 | 主结果每方法每任务仅一次训练,跨种子波动未测;消融只是同一 checkpoint 上 10 步短续训;基座仅 LLaDA-8B-Instruct、生成长度固定 256;表 1 部分对照数字取自各原文且带改架构或更多私有数据标注 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Retrieve What Helps, Only When It Helps: Agentic Reinforcement Learning for Selective Retrieval-Augmented Machine Translation · arXiv:2610.19528 | 训练信号与信用分配:把检索当轨迹动作,并对比轨迹级与文档级两种检索器监督 | IdiomKB Zh→En 的 I5(1–5 分习语翻译评委分,越高越好)Direct 0.652→0.731、MQM(错误分越低越好)−3.94→−2.74,检索率 30.6%;对永远检索对照的 MQM 提升 20.6% | BLEU 低于有监督基线;原文称“显著”但无检验与区间;MQM 由 Claude Sonnet 4.6 评委给出;人工评测仅 20 人 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds · arXiv:2610.20195 | 用配对世界把终局奖励重新分配到具体轮次,并以规则可验证的成功替代对话评分 | Qwen3-8B 可验证成功率 20.42%→28.33%,高于 PPO 的 25.00% 与 GRPO 的 26.25%;13 个模型上 35.99% 的 Goal≥8 对话未过验证 | 主实验为固定伙伴;Integrity 依赖 LLM 判官(跨判官一致 90.0%、κ0.78);部分族增益为零 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | PA1-OPD: One-Step Prefix-Augmented On-Policy Distillation for Language Model Pretraining · arXiv:2610.19601 | 在语料前缀上让学生多采一个 token,再在该后继状态加教师前向 KL,并按学生惊奇度挑选监督根节点 | 表 1:Stage2 取学生惊奇度最高的 10% 根节点,Macro 交叉熵 2.531635 对 KD 2.532039,超出 KD 相对 NTP 收益的比例为 48.85%;Stage1 同配置反为 −5.22%;表 2 按惊奇度选根 36.18% 优于按教师优势 29.07%(同 50% 覆盖度) | 每条件仅一次训练、单一师生族(OLMo2-7B→1B)、三个似然语料,作者自陈绝对提升在 10⁻⁴ 量级需独立种子复现;未分离权重分配与监督位置;按 token 而非算力对齐;原文未给出代码或数据入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | FACES: Fine-grained Gated Semantic Alignment for Multimodal Emotional Support Conversation · arXiv:2610.20051 | 信用分配:非补偿门控多维奖励加按推理与响应段对齐的 token 优势 | cap-15 下 MLLM 均分 3.61 到 4.04、盲对胜率 80.22%、人评 75.3%;同骨干 DPO 3.62、SimPO 3.77、RLOO 3.83 | 训练判官与后验判官同为 Qwen 系;人评与判官一致率仅 74.7%/71.7%(κ 0.316/0.441);视觉仅关键帧 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | VASPO: Self-Distillation with Privileged Value Estimation · arXiv:2610.20516 | 把同一份特权信息同时用于 critic 估值与自教师 token 调制 | 六项数学基准均值 Qwen3-4B 53.17 对 PPO 50.58、OLMo3-7B 33.42 对 31.61;Knights and Knaves 均值 60.81 最高 | 去掉特权 critic 后数学均值 35.59、KK 均值 23.30(等同 OPSD);原文未报种子数与置信区间,差值仅 1–3 个点 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis · arXiv:2610.20538 | 训练与数据信号:同一 rubric 兼做过滤与 RL 奖励,按方差选样本 | 同规模基线上 rubric 过滤子集在每项基准胜整体打分过滤(Vega-Lite 最多 24 分);35B 在 ChartMimic 低层/高层 83.42/80.69 | 多基准判官与流水线同族,仅附录做跨判官复核;人类研究仅 100 例且区间在附录;跨列指标不可比 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Structure-Preserving Document-Level Data Augmentation via Discourse Parsing · arXiv:2610.19497 | 合成训练数据:保留语篇结构的文档增广加原句索引标签迁移 | 中文摘要 Inp+Con+Aug BLEU 0.276 对 LLM 重标 0.165、UniRST 0.174;SQuAD EM 0.731 对 QA 重标 0.370 | 增广器与下游同属 Qwen2.5 系列;每种语言仅 100 对句对核验;无种子数、重复次数与显著性检验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | What Does LALM Post-training Learn? Rethinking Audio Understanding and Reasoning Capabilities · arXiv:2610.19476 | 后训练增益的归因控制(静音评测、静音训练、去选项评测) | Qwen2-Audio-7B 上 GRPO 的 MMAU 准确率增益 ΔAcc^a +14.8 点、静音增益 ΔAcc^s +11.2 点;去掉选项后音频增益降到 +2.3 点、静音降到 +0.8 点(表 1、表 6) | 静音保留音频 token 长度仍可能提供线索;结论限 MMAU 与 MMAR、2 个基座、200 步 LoRA 配方;未测其他架构与规模 | 语音与音频栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | INTACT: Inducing Latent Reasoning on a Frozen Backbone · arXiv:2610.19568 | 改的是后训练的作用位置:主干全程冻结,只训一个 107M 接口编码器并加 on-policy 保持损失 | GSM8K 上 75.8%→79.3%(Llama-3.2-3B)、77.6%→79.7%(Qwen2.5-3B);每题时延 4,180→3,386 ms(−19%);8B 生成 token 754→182 | 精度取 3 个编码器种子但 token 数只测单种子、消融单种子;1B 上低于 Aug-SFT;潜块不可解释;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning · arXiv:2610.19789 | 智能体 RL 自蒸馏方法的统一对比(方法、基准、规模、稳定性与成本) | 10 种方法对 GRPO 在 ALFWorld、ScienceWorld、Search-QA、WebShop 四个基准与三种模型规模上比较:132 次训练、12,124.4 H800 GPU 时、8 个 rollout 种子重评,无方法稳定优于 GRPO | 仅摘要层,无逐方法分数、稳定性定义与成本口径;8 个种子是评测重复而非训练重复 | 自然语言处理栏目 · 官网条目 · 摘要 |
| 2 | 直接命中 | Rationale Distribution Distillation via Flow Matching for Distributional Continuous Latent Reasoning · arXiv:2610.19871 | 把多条正确文本理由蒸馏成隐式理由的条件分布,用查询内 mixup 扩充蒸馏目标 | S=6 隐位置预算下,RDD 在六个基准的 pass@512 上全部超过同预算点值基线,MATH500 为 43.4 对 CODI 30.7、MUX 38.0;但 pass@1 常落后 MUX(1.5 对 2.2) | 主结果只在 GPT-2-0.1B 骨干上,1.7B 试验与文本 CoT 的差距更大;无自有代码仓库;pass@512 是覆盖率口径,不能当单次推理能力引用 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | DAGFormer: Global Topology Prediction for Transformer Cross-Layer Connections · arXiv:2610.19625 | 用共享拓扑预测器一次规划全层跨层连接,并在域微调期间测结构化剪枝后的能力保持 | 75M–1B 匹配 OLMo-2 上 WikiText-2 NLL 比 vanilla 低 0.18–0.29;1B 模型 5B token 胜过 10B token 的 vanilla 基线 | 除 300M 外为单种子(第二种子 NLL 变动至多 0.08);路由使每 token FLOPs 达 1.18–2.13 倍;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation · arXiv:2610.19758 | 四阶段流水线:领域对齐 CPT+SFT、在线 M2PO 偏好优化、学生轨迹上的 reverse-KL 在线策略蒸馏、结构感知推理与选择性修复 | 表 2(23 个方向、1–5 分判官口径):总均分 4.60、通过率 87.7%,对照 GPT-5.5 与 Qwen3.7-Max-Think 均 4.63;表 4 累积消融中 OPD 把指令遵循从 4.13 提到 4.38,在线 M2PO 把翻译质量从 4.23 提到 4.55 | 全部由单一 LLM 判官(DeepSeek-V4-Pro)打分,提交时无官方人工评测;未报告置信区间、重复次数与逐方向样本量;基线分数与自测分数同源,4.60 与 4.63 的差距不足以支撑排序 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | AFCS: Atomic-Fact-Conditioned Synthesis for Factual Knowledge Pretraining · arXiv:2610.20086 | 合成数据的条件单元:由段落改为抽取出的原子事实,并加源事实覆盖度诊断 | 源事实显式覆盖 85.1%,对照 WRAP 73.0%、Nemotron-CC 77.0%;7B 的 PopQA 由 Base 23.06% 升到 29.80%,32B 为 37.22% | 抽取质量只在 500 篇核对子集报告且无区间;只测英文维基与 7B、32B;对照同源同配方,增益不可外推 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Language Exposure Matters: Distribution and Order in Multilingual BabyLM Pre-training · arXiv:2610.20102 | 多语预训练数据的语言配比与曝光顺序 | 多语平均 46.67(荷兰语主导 60/20/20)高于均衡 33/33/33 的 46.23;混合训练在全部 15 个配对语言主导配置上高于课程训练,80/10/10 上差 3.29 分 | 每配置只跑一次、固定种子,作者自称只能描述性解读;三语言单领域、单一架构、固定 100M token,各配置分词器不同 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Gap Detection: Mitigating Homogenization through Demand and Defensibility · arXiv:2610.20162 | 生成目标:不再重采样,而是搜索未被占据的语义方向 | 五主题碰撞率平均相对降 12.8%、90 查询降 10.8%(0.7766→0.6915);增广中 0.324→0.298、Vendi 27.16→29.20 | 两项指标共用同一编码器、无人工答案质量评估;全为点估计无区间;GEO 为模拟;增广准确率只差一个测试样本 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Scaling Multilingual Mixture-of-Experts: How Language Coverage Changes Capacity and Compute Allocation · arXiv:2610.20247 | 容量分配与能力保持口径(扩语言时「保持」的定义) | 专家从 1 增到 32 把 12→200 语言的损失惩罚压低 83%;扩到 200 语言后均值恢复只让 36% 的原 50 语言不掉分,全保住需 2.32 倍计算量 | 主网格单种子;限 Top-1 MoE、E≤32、分词器与语料固定;分配用逻辑计算量;匿名仓库被反爬拦截,仅 GitHub 镜像可取 | 自然语言处理栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech · arXiv:2610.19499 | TTS 量化与解码:HBQ 替代 FSQ 加可丢弃重预测的细化日程 | 同码本 2^16 下 HBQ [2^2]^8 全指标优于 FSQ [4]^8(LibriSpeech-PC 的 SIM 0.427 对 0.290);Seed-zh WER 1.19%,说话人相似度 0.645 低于真值 0.755 | 每格单次训练与解码,原文未报种子、区间与显著性;主观集仅 10、10、20 条样本;说话人相似度短板明显;原文未给代码数据入口 | 语音与音频栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech · arXiv:2610.19553 | 推理期缩小注意力窗口 W 并给声学提示 logits 加常数偏置 b | 相对 VoXtream2,整体 WER 8.63% 降到 3.58%、SPK-SIM 0.659 升到 0.759;消融里 W=375 取 4.82、b=1.5 取 3.58 | 无训练即有收益但上限受原模型限制,WER 仍高于 Qwen3-TTS 1.59% 与 MOSS-TTS 1.77%;主表未报种子数,图仅 8 条语句 | 语音与音频栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | MultiPartyTurnBench: Benchmarking Floor Control in Multi-Party Spoken Dialogue · arXiv:2610.20172 | 给出话轮结束与成功打断的事件条件化评测协议与硬负例、假正率预算口径 | 12 系统上话轮结束召回 82.5–92.6%时假正率仅 4.3–11.8%,合格工作点成功打断召回最高 56.2%;5 个全双工智能体让位平衡准确率仅 46.9–54.7% | 语料为合成语音,真实会议验证仅 15 段且阈值切片内调;未报显著性;项目页实测 HTTP 404 | 语音与音频栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | Noise-Aware Lombard Speech Synthesis via Flow-GRPO for Intelligibility Optimization · arXiv:2610.20181 | 给流匹配 TTS 的 DiT 深层加 FiLM 噪声波形与 SNR 条件通路,SFT 之后用 Flow-GRPO 以 ASR 词错率和说话人相似度为奖励在线优化可懂度 | Seed-TTS test-zh、四噪声平均、−6 dB:WER 由基线 0.378(95% CI 0.372–0.383)→SFT-only 0.289→NIL-TTS 0.224;同条件 ESTOI 0.246→0.279→0.298;主观 P.807(12 名听者)识别率 −6 dB 由 0.367 升到 0.598 | 两段训练均未报告种子与重复次数;客观 WER 由 ASR 给出,与训练奖励同源(仅用附录 A 验证奖励有效性);ESTOI 绝对值仅 0.2–0.3;主观测试仅 12 人、只覆盖 Babble 噪声与普通话;6 dB 下 SFT-only 反低于基线 | 语音与音频栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | ELARSpeech: A 30K-Hour Dataset Across 675 Underrepresented Languages for Long-Tail Multilingual Speech Technologies · arXiv:2610.19388 | 用档案田野录音的策展流水线为长尾语言补 ASR 与 TTS 数据,并测伪标注扩展 | 30,202 小时、675 语言;单语 OmniVoice 在 14 个≥5 小时语言上宏平均 CER 16.98 低于真值录音 21.07,MOS 3.42 低于真值 3.88(36 名非母语听者) | MOS 无置信区间、未报种子与显著性;非母语听者只评自然度;CC BY-NC-SA 限非商用 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Long-Prompt Zero-Shot TTS: Benchmarking Prosody Reproduction Beyond Voice Cloning · arXiv:2610.19774 | 把提示拉长到分钟级并给出韵律多维评测协议 | 表 1:中文 CER 为 Qwen3TTS-Base 0.73、逐说话人微调 1.78、LPTTS 1.03;八项韵律指标中六项优于微调;P-MOS 中文 3.529 对 3.471 | 表 1 无重复次数与置信区间;P-MOS 仅 100 条、三名听者;基准与代码录用后才发布,暂不可复现 | 语音与音频栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Lost in Translation: Why Lower Bias Scores Don't Mean Fairer Models · arXiv:2610.20479 | 给跨语言偏见分数加噪声地板与题级延续性两项审计口径 | 10 个模型 8 种语言、70 个模型–语言对的平均刻板印象分数全部低于英语,但英语分数预测译后分数的相关只有 0.23(改写英语为 0.48);70 对中仅 28 对通过置换检验 | 条目全来自英语基准、经单一机器翻译且无母语者复核;约 360 题/语言时 0.03 以下的差距检测不可靠,作者自陈通过检验的降幅可能被高估 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | GraphRAG-LTM: A Layered Threat Modeling Framework for Attacks on Graph Retrieval-Augmented Generation · arXiv:2610.19549 | 证据管线扰动设计(查询改写加桥接三元组删除) | HotpotQA-Distractor 配 Contriever 与 LLaMA3-8B:答案 F1 从 52.3 降到 BB 37.6、WB 26.2、图感知 23.7;BB 单独不动检索 F1(0.379),叠加删图降到 0.313 | 未报告随机种子、置信区间与显著性检验;结论限于 3 数据集、3 检索器、2 生成设置的固定超参。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Moral Combat: Exploiting Moral Foundations Theory to Jailbreak LLMs · arXiv:2610.19587 | 安全护栏可被道德框架改写绕过,并顺带审计安全基准的道德基础分布 | AdvBench 子集单次越狱率 Llama-4 90%、GPT-4.1 66%(PAP 同表为 Llama-2 46%、GPT-3.5 66%);重复 n=3 升到 98% 与 86% | 子集仅 50 条且无置信区间;对照组评测的模型不同;判定部分依赖 LLM 判官(Phi-4 与人工 ρ=−0.082,不显著) | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | MakSafe: A Spatiotemporal Semantic Framework for Formal Specification and Compliance Checking of Road Vehicle Safety Rules · arXiv:2610.19735 | 以语义区域与轨迹树推理替代均匀时间离散化的运行时安全规则检查 | 摘要层:同一初始场景可导出分支特定的安全与不安全判定,控制更新后可重评;单次规则检查在交通密度 N、跨度 H、分支因子 B 扫描下均远低于 1 毫秒 | 该文无 HTML 全文,条目仅到摘要层;机构、样本量、硬件与置信区间均无法核验;无代码或数据入口 | 自然语言处理栏目 · 官网条目 · 摘要 |
| 3 | 邻近跟踪 | Model vs. User: Whose Values Prevail? Inference-Time Value Alignment in Multi-Turn Conversations · arXiv:2610.19817 | 多轮对齐评测:用户与助手双向施压对照,报平均效应与首末漂移 | 对抗条件下 48 个情形中 39 个由模型基线偏向一方胜出;自主↔安全权衡 AaUb 下 SP 的平均 TE 为正,但净漂移对 Qwen3-14B 为 −1.96、Llama-3.1-70B 为 −0.73 | 仅两个英文价值权衡、单一用户模型、上限 10 轮;线性探针未与人类判断校准;未见显著性检验;原文未给代码数据入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Scaling Multilingual Safety and Reasoning Evaluation through Reasoning-Guided Translation · arXiv:2610.20221 | 扩语种流水线:配置选择与生成分离,配源感知校验与独立筛查 | 表 3:WildChat 与 WildJailbreak 共 6,820 个条目-语言对,接受 6,816 对(99.94%);结构通过但仍在英文的 274 对(1.2%) | 99.94% 只是结构覆盖率;下游仅两个 7–8B 模型、固定生成长度、判官英语一致率 88.7%;无人工双语评估 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | From Triage to Impact: A Multi-Hop Reasoning Benchmark for Explainable Persian Hate Speech · arXiv:2610.20370 | 改的是审核评测的任务分解与环境:把判定拆成七跳逐跳可核验子任务并逐跳报指标 | 1,200 条、8 个模型:第 1 跳宏 F1 最高 82.8(Grok 4.6)对最低 48.0;第 7 跳严重度宏 F1 最高 50.8;多跳中间结果使 5/8 模型宏 F1 提高、全部模型加权 κ 提高 | 观察性关联非因果;参考标注由 LLM 生成、开放式跳人类一致性低;四类人为均衡不代表真实分布;基准规模小 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Fantastic Metrics and How to Find Them: Meta-Evaluating Metrics for Multi-lingual Style-Personalized Generation · arXiv:2610.19166 | 指标元评估口径(校准加双锚点归一化) | 10 语言 4 维度 32 指标:原始相关最高 ρ=0.56;校准后风格集成 Ψ=0.78 对最好单指标 0.43(表 2、图 2) | Ψ 依赖归一化定义,绝对值不可跨任务搬;风格维度上标注一致性 α 与 Ψ 负相关(ρ=−0.71),易误读。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | The Sum of All Summaries: PropAlign for Graded Proposition Salience Evaluation · arXiv:2610.19387 | 显著性评测口径:由直接提问改为多摘要分级 0–5 分 | 摘要式把模型间 F1 从 0.464 提到 0.716/0.767;细粒度下 Claude F1 0.709 近人类 0.703,集成 0.622 仍低于人类 | 仅英文、无代码与数据链接;集成依赖 GUM 人工标注、不能用于未见数据;一处 MAE 结论与表内数值不一致 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Typed Decision Models on Tabular Data · arXiv:2610.19536 | 用 21 类保信息改写审计固定选项判定的稳定性,并用重发率做噪声下限 | 行分类、TabFact、异常检测三项任务上,改名或换序只改决策模型 2–8% 的判定,却改开源 LLM 14–30%;表格组织改写则让约三分之一的行判定翻转,而重发同请求只改 2–9% | 每个模型只测一个版本,含仍在公开测试的闭源接口;无自有代码仓库;改写不覆盖改列名或换算单位,结论不能外推 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | RCCM: Diagnosing Gains and Harms in Reasoning-Prompt Transfer · arXiv:2610.19872 | 提示迁移的收益损害配对归因与端点划分 | 同一提示反向:CoD 使 Phi 多答对 15 题、使 Qwen 少 32 题;Phi 简洁提示匹配 +13.3 个百分点,换端点后为 +20.0 与 +6.7(后者不显著) | 答案承诺标注仅单人复核且只覆盖最初 Phi 对照;重复采集复用同一 60 题;仅英文数学。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Equal CER, Unequal Damage: Severity-Weighted Character Error Rate for OCR · arXiv:2610.20461 | 字符级评测口径:用 LLM 判官的五级分布给每个字素编辑计严重度 | 6,100 万编辑上;整篇总分归一化 CER 与读者 ρ 0.93 不输;排序相左的对子上 semCER 英 0.71、中 0.78 对 0.58、0.60 | 人评只覆盖英越中三语,其余 13 语只有判官;判官 checkpoint 中途被更换,严重度只同版本可比 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Evaluating Large Language Models for Multilingual Abstractive Summarization: A Comprehensive Study of English and Bengali · arXiv:2610.19003 | 跨语言摘要评测口径:词面、事实性、判官三路拼装 | 表 2、表 4(0–100 尺度):孟加拉 ROUGE-1 头名 LLaMA 3.3 70B 16.23,英语头名 GPT-5.6 Luna 24.12;判官忠实度仅 1.10–1.34,流畅度 4.78–5.00 | 判官仅每语言 100 条且无置信区间;事实性由 BERTScore 聚合而非人工标注;模型清单须以原文表 1 为准 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Pre-Trained Language Models as Zero-Shot Tools for Social Science Research · arXiv:2610.19048 | 零标注监督与核验:无标签记录链接、姓名族裔推断、agent 抽样核验 | 佛州选民全名加地理 83.8% 对补名 BISG 78.0%;无地理仍 82.8%;默认检索平均 F1 85.2% | 单一作者、四个州的名册;agent 核验无准确率对照也无抽检条数;族裔推断涉敏感数据 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | DualView: Leveraging Broad and Output-Specific Evidence for LLM-based Multi-Output Text Regression · arXiv:2610.19206 | 多输出文本回归:冻结 LLM 表示加极小预测头,替代微调或用大模型当判官 | 5 数据集 8 骨干 21 目标上 Pearson 0.432 对最强基线 GAT-AES 0.365(+18.4%)、NRMSE 0.873 对 0.898,参数 5.1K–57.4K 对 1.84M–20.98M | 需模型内部表示,黑盒不可用;提示模板只测一套;参数少不等于延迟低;跨基线总体提升未报置信区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Vision-Language Models Integrate Conflicting Evidence Like Biased Bayesian Observers · arXiv:2610.19407 | 冲突证据的整合规则:把偏好拆成两模态证据强度与整合偏差 | 边界 11 格拟合、25 内部格测试:两参数模型 R² 0.852 至 0.860(Qwen2.5、GLM-4.6V)与 0.692(Gemma3) | 只测 3B–4B 级 4 个开源 VLM,参数逐模型与数据集重拟合不可跨数据集比较;R² 是偏好 log-odds 不是准确率 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | How Do LLMs Understand Legal Philosophy? Diagnosing Legal-Philosophical Reasoning in LLMs · arXiv:2610.19427 | 法哲学基准 LePhilBench:JP 画像与 JAJP 预测,隐藏身份并设无画像对照 | 220 份意见、9,240 条标注;给画像后法院意见准确率−7.94 点、异议+31.42 点、总体+11.74 点;人—人 Fleiss κ=0.474 | 仅美国法与 110 案标注子集;每实验 3 种子;无法排除预训练记忆贡献;数据集称接收后公开 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | AgriJev: Efficient Agricultural Candidate Scoring with Multi-Scale Adapted Models · arXiv:2610.19478 | 判定接口(生成式作答 → 一次前向的候选打分) | 17 个外部视图均值 75.44%,对照原生生成 69.54% 与 SFT 生成 71.65%;9B 中位延迟 93.80 ms 对生成 181.24 ms(SFT 189.16 ms) | 作者声明为描述性点估计、无显著性检验;17 个视图非独立数据集;概率未校准;无代码入口,公共托管未完成 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Are We Really Measuring Forgetting? Pitfalls in Evaluating Machine Unlearning for Multimodal LLMs · arXiv:2610.19613 | 多模态遗忘基准 GEMMU:分离训练与测试、用真实概念、逐方法超参搜索、模态差分析 | 139 个真实概念、重评 9 法;共享学习率 10⁻⁵时 RMU 胜、5×10⁻⁵时 KL Min 反超;RMU 在 Qwen3-VL-8B 把 VQA 分类压到 2.48 而 QA 仍 83.91 | 两个 7–8B 基座、LoRA 设定、点值无方差;排名翻转为配置依赖观测而非方法定论 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Beyond Reachability: A Relation-Semantic Reasoning Framework for Biomedical Multi-hop QA · arXiv:2610.19754 | 多跳 KG 问答:把答案可达与证据有效拆开建模与评测 | BioHopR 五种子 H@1 0.772±0.006 对 Fixed-Candidate 0.719±0.008,Joint@1 0.602;PrimeKGQA F1 0.761 对 hard schema 0.661 | 作者称聚合均值不能确立配对显著性;路径效度依赖人工标注队列;模板扰动下 H@1 与 Joint@1 降到 0.741 与 0.563 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Likelihood Is Not Authorship: Can We Reliably Measure Human Contribution in AI-Assisted Writing? · arXiv:2610.19767 | 用上下文互换审计检验基于似然的人类贡献分数,做法可迁移到任何上下文条件化度量 | 同一段文本在 Matched 与 Hidden 上下文间摆动 32–51 分(新闻 2,100 对)、43–47 分(摘要 600 对),每个模型每份文档均为正 | 仅英文新闻与摘要、模型自评自打;无人工复核;后缀显眼,不主张不可检测 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Beyond Benchmark Accuracy: A Diagnostic Test for LLM Chemical Prediction · arXiv:2610.19906 | 改用源实体加编辑操作定义目标,做身份盲化与源标签反事实替换 | 仅替换源标签即让 Claude-Opus-4.8 的 91.2%(BACE)、94.6%(HIV)二分类预测翻向假标签;标签一致组占优的组合由 C1 的 10/24 增至 C2 的 22/24 | 题目由作者按相似度规则构造,逆合成 42、手性 56 样本极小;CR 多处因分母为 0 而无穷;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Does Machine Translation Retain Media Bias? · arXiv:2610.19945 | 四引擎 MT 的媒体偏见保留评测:配对样本、分类器判偏、多系统配对统计 | 446 句译成保加利亚语后保留 64%–78%偏见;原文与各译文类型组合显著不同(配对全局置换检验 p_MC<.001),四译文两两无显著差异(p_Holm=1.00) | 两语言对、四引擎、单一偏见分类器与单一母语评审人;无源标注者间一致率;作者自陈不能作强断言 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | SoK: Grading Open-Text Legal Answers, from Law School Exams to Trustworthy Rubric Judges · arXiv:2610.19992 | LLM 判官的验证程序与保障(8 条要求、8 种范式、7 条保障) | 判官给被委员会判不及格的判决书 85 到 90 分(满分 100),委员会给 8 到 37 分;嵌入指令攻击对基于评分规则的判官平均成功 56.9%;模型更新移动严厉度最多 133(1000 分制);某微积分考试约 70% 题目须交回人类 | SoK 且评级出自单一作者;材料含 2026 预印本与复用数据,作者自陈论文数高估独立验证数;一致性口径混用不可横向比较 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | CSWBench: Evaluating Context-Sensitive Code-Switching in Creative Writing · arXiv:2610.20272 | 基准与两级评测:事件级构造质量加全文级质量,并做交换扰动检验 | 12 个 LLM 中 GPT-5.5 领跑 Focused Narrative(Σ=15.537)、GPT-5.6-Sol 领跑 Extended Narrative(Σ=17.767);事件级质量与全文分相关仅 r=.254 与 .255 | 只覆盖中英、约 700 与 4,000 字符文本;GPT-5.6-Sol 既参与流水线又是被评模型;约 82%(661/807)提示来自合成来源;相关为观察性 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | From Unreliable to Usable: Decomposing Failure Modes and Confidence Signals in LLM Entity Extraction - Evidence from Cyber Threat Intelligence · arXiv:2610.20417 | 用预注册门槛、三级标注与关系级反事实审计抽取置信信号能否验证真伪 | CTI 语料 354 个事件活动上微观精度 0.03–0.34、召回 0.81–0.99;假阳性中背景提及 65.6%、口径缺口 19.9%,无文本支撑仅 1.2% | 单一领域与单一口径;无 logprob;三级标注为 LLM 双标;旗舰模型未跑反事实批次 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | ChronoCulture: Evaluating Cultural Awareness Across Time in Large Language Models · arXiv:2610.20472 | 评测口径:文化基准由众数打分改为分布级距离,并先做知识过滤再测时间条件化 | 10,360 个题对中 68.2% 已变化题对众数未变;六模型两期都答准比例随变化增大下降,点名年份只帮 20–44% 条目 | 不含 2022 年后数据;仅取选项有序题;国家级分布掩盖群内差异;原文未报检验或区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | PerSo: Investigating Facets of LLMs' Social Intelligence in Real-World Persuasion Scenarios · arXiv:2610.20548 | 用真实说服对话的同一批数据同时构造认知题与行为题,并加最佳人类对照 | 200 个 CMV 帖子;行为任务 Qwen-3.5-397B 76%对最佳人类 75%;认知三轴 Sonnet-4.6 为 83.0%、59.0%、80.5%,最佳人类 85.0%、65.0%、85.0% | 人类参照仅 3 人且各抽 10%题;未报重复运行方差与显著性;认知题由 Gemini 2.5 Pro 生成,自偏好检查为弱证据 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Selective Reasoning for Typed Decision Models: When to Start, Read, and Stop · arXiv:2610.19644 | 推理启动、读取与停止的门控,以及推理开销的三项分账 | 768 题准确率 70.96% 升到 84.38%;对 1,024 token 末端推理流水线时间 −46.30%、准确率 −1.17 点;对 512 token 准确率 +7.29 点、输出工作量 +2.25%(摘要层) | arXiv 无 HTML 全文,仅摘要层;无种子、区间与显著性报告;合并口径未拆到三个数据集 | 自然语言处理栏目 · 官网条目 · 摘要 |
| 2 | 邻近跟踪 | Gray-Box Hallucination Detection in LLMs with Token Identities · arXiv:2610.19996 | 运行期门控(token 概率 + 身份编码的灰盒幻觉检测器) | 3 个开源模型 × 3 个基准九格平均 ROC-AUC 72.09%→79.09%(对概率基线 LOS-Net 平均 +7.00);跨模型 18 次迁移中 17 次胜过迁移过去的 LOS-Net | 标签为自动字符串匹配,可能奖励含正确子串的错答;需接口暴露候选字符串与概率;通道分析仅单一训练配置;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Weighted Ensemble Sampling for Rare-Event Estimation in Language Models · arXiv:2610.19202 | 改的是低概率指标的抽样预算分配:生成中途按前缀反应坐标分箱并重分配 walker | 毒性故事任务(40 seeds、14,336 样本)上相对误差 1.0%、样本效率增益 2.02 倍,同表 Twisted SMC 相对误差 10.5%、LMTailRisk 34.7% | hybrid 反应坐标需白盒隐状态;40/5 seeds 无显著性检验;原文未给自有代码;绝对概率依赖外部评测器 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Do Syntax Heads Influence Model Behavior? · arXiv:2610.19231 | GPT-2 主谓头因果作用:注意力掩码干预,并与同规模随机非句法头对照 | 原模型平均σ=0.94,强行指向干扰词后仅降到 0.72、4.7%模拟σ<0.5;非句法头在δ_p 口径 12.32%模拟中反超,δ_f 口径为 3.46% | 仅 GPT-2 small、英语、主谓依存;48 句刺激剔 2 句;无中间检查点;作者自陈两种度量结论冲突 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Target-Token Asymmetry Can Masquerade As Depth Specialization · arXiv:2610.19344 | 评测口径:跨语料层消融的合并对比按目标 token 类型拆分,并在共享混合下重估 | GSM8K/Wikitext 合并 CAI +0.0253 在剔除空白目标后变 −0.0247(Qwen2.5-7B),空白单元 +0.5181;高与中风险对 14 行全部变号 | 主结论限 H=3 mean-blend 与 α=0.2;H=1 mean-blend 内容单元未拆;以区间含零为判据,未做显著性检验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Tail Competition Explains Scaling in Best-of-N Sampling for Verifiable Problems · arXiv:2610.19362 | BoN 采样预算的停止控制,以及判官打分的尾部分布口径 | Monkey Business 2,878 个题目-模型对上,reward hacking 子集标准 BoN 从 19.02% 降到 5.68%,尾部张力早停为 11.61%;不完整选择器收敛由指数改判为多项式 | 早停增益只出现在已发生劫持的子集;只覆盖可验证任务;两成分高斯可分假设未在非双峰分布验证;EVT 在 n=32 偏差约 3-4% | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | One Block Ahead: Promoting Sampler State in Diffusion Language Models · arXiv:2610.19510 | 运行期解码调度:当前块与预热块同一次前向并行,跨提交边界提升采样器状态 | 十个基准平均 TPF 15.64→22.25、吞吐 2375→2761 tokens/s(+16.3%),准确率降 1.37 点;对照把块加宽到 512 吞吐 −41.4% | 只测 batch=1、单卡 GB300、单模型;α 为回归拟合估计量;准确率只报平均降幅,无逐基准区间 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Does the Linguistic Register of Thinking Matter? Wenyan as a Compact Reasoning Register for Chinese LLMs · arXiv:2610.19741 | 改的是可见推理的表达语域与监督数据:只把推理字段改写为文言,并用同源同配方紧凑对照剥离压缩效应 | MMLU-ProX-Lite-ZH 在 1024 token 预算下准确率 11.4%→52.9%、缺答率 87.5%→7.5%、输出 1008.1→394.2 token;文言略高于紧凑现代汉语对照 | 主基准仅 588 条、单次运行无种子方差;监督由教师生成且只做 LLM 判官审计;两基准上文言与紧凑对照差距方向不一致;无代码入口 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Frustratingly Easy Majority Voting Using Length Conditioning · arXiv:2610.19890 | 把思维链长度作为正确率先验,无标签自适应后给投票加权 | 摘要称在多个模型与推理基准上稳定优于标准多数投票与既有长度、置信度聚合策略,但摘要内无任何可用数值 | 该文 arXiv 未提供 HTML 全文,只到摘要层;实验规模、模型与基准清单、显著性均未核验;代码入口 GitHub 实测 200 | 自然语言处理栏目 · 官网条目 · 摘要 |
| 3 | 邻近跟踪 | To Reason but Not to Stop: Understanding and Recovering Pruned Large Reasoning Models · arXiv:2610.19934 | 用同一前缀下终止与循环续写的隐状态差构造终止方向,推理时按激活范数缩放到残差流上(免训练、不改权重) | 60% 稀疏度下不终止轨迹中 41.4%(7B)/39.2%(14B)已含正确答案;表 1 中 50%→60% 稀疏度不终止率 3.8%→16.8%(7B);TGAS 在每个模型-稀疏度组合提升平均准确率 1.3–3.7 点,18 个检查点-基准对中 16 个终止率上升且无一下降 | 主表 k=4 采样;显著性检验只覆盖 2 个模型 × 2 个基准(附录 F.10 中 DS-Qwen-7B 在 AIME-25 的 +1.5、p=0.171 不显著);模型均 ≤14B 且只覆盖数学与代码;需先从剪枝检查点采样构造方向;高稀疏度只能部分恢复 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Choosing the Number of Attention Heads from Intrinsic Dimension: A Small-Scale Study · arXiv:2610.19966 | 用无标注内在维度先验定头数,并示范等效性检验 | 表 2:SST-2 上 10 头 82.13%±0.42 对 32 头 81.95%±0.33,TOST 在 ±1 分内等效(p=0.0005);注意力参数少 69% | 有 10 个配对种子与 TOST;但只 4 层 128 维模型、只比 10 与 32 头、单一估计器,k* 只是单点吻合 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Sparse Autoencoders for Mechanistic Interpretability in NLP: A Critical Survey of Recoverability, Interpretability, and Utility · arXiv:2610.20139 | 把 138 篇研究按字典设计、特征操作、NLP 功能三面共同标记 | 以 138 篇为语料给出任务锚定分类学与按主张分级的证据框架;转述合成实验中 TopK 恢复率随 K 由 20 到 50 从 98.4% 掉到 23.4% | 综述不是受控实验,作者自陈不做普适排名;研究注册表入口抓取被 Cloudflare 拦截,内容未核验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | TreeSpark: Learning to Draft the Trees You Verify for Speculative Decoding · arXiv:2610.20175 | 改的是推理期候选生成与训练信号:树形保留多候选,训练复放部署选择并按路径质量加权 | 相对 DSpark 平均接受长度 +23.4%–31.6%、单请求吞吐 +15.1%–25.0%;固定容量与推理策略下监督仍带来约 6.4% 接受长度增益 | 未做显著性检验;仅贪心解码、Qwen3-4B/8B 与昇腾 910B 单机;原文无局限章节;跨硬件与采样策略未验证 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Cross-Model In-Context Neurofeedback Reveals (Limited) Activation Control in LLMs · arXiv:2610.20179 | 激活监控(探针判官)能否被模型在上下文里主动操纵 | 固定句子下 10 个 9B–32B 模型仅 3 个有控制效应(Qwen3.5-27B 1.8、Qwen3.6-27B 1.1、Gemma-4-31B 0.4 分,100 分制);原文称其显著(口径为 95% bootstrap 区间) | 控制组用均匀随机反馈,统计性质未必同真实反馈;只测 10 个 9B–32B 开放权重模型;监控器分数自身漂移数十点;原文未给 p 值与检验名 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | FOLD: Position-Free Far Memory with Local Order for Long-Context Speculative Decoding · arXiv:2610.20392 | 长上下文投机解码:drafter 读上下文的定位方式,局部保精确位置、远端折叠 | 6 组 target–drafter 最长 256K 上最佳加速 2.08× 到 4.22×(Llama-3.1-8B 的 LCA 122K),平均 2.11× 到 3.40× | 窗口与集中因子两个推理期超参需按 pair 选;drafter 本就不退化时略慢;测量为单卡 H100、batch size 1 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | ReaDy: Recurrent States as Dynamic Context for Speculative Drafting in Hybrid Linear Attention Large Language Models · arXiv:2610.20503 | 推测解码的草稿上下文来源与度量 | Qwen3.8-27B 单卡:平均吞吐 302.78 对自回归 95.86、DSpark 280.42(3.16 倍、+7.97%);无状态微调对照 286.50,ReaDy 再高 5.68% | 单卡并发 1、贪心、草稿块 7,未报种子与区间;相对 DSpark 的增益包含继续适配部分。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | From Qualitative Text to Integrated Evidence: The Parallel-Then-Integrated (PTI) Procedure · arXiv:2610.19164 | 把两套语料表示的对齐与整合流程显式化,并加折内特征选择防泄漏 | 29 位母亲 1,203 段访谈上,合并 PV+NMF 的 LOOCV AUC 0.756,高于单路 PV 0.706 与 NMF 0.680;贡献合并增量的 T0、T2 主题却被排除在联表之外 | n=29、仅 9 例抑郁;NMF 在全语料拟合后才做 LOOCV,属传导性估计;本体未在译成尼泊尔语的叙事上验证;AUC 差值作者也只称探索性 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Copy-Paste Language Models · arXiv:2610.19247 | 在 LM 头外并联复制头,为上下文复制开第二条梯度通路 | 表 1–3:1.7B 零样本平均分 Full 62.45→63.06;SFT 后平均高 1.2–5.1 分;单针检索全网格均值 SW 由 14.3 升到 99.4 | 只到 1.7B 且单次预训练、未报方差;字节级模型无增益;复制更忠实,可能复现输入中的敏感或受版权内容 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | TopicMerge: A Divide and Conquer Approach to Topic Modeling · arXiv:2610.19323 | 语料主题地图流程:把 LLM 决策限制在簇级合并以压缩调用量 | Wiki 上 ARI 0.71、NMI 最高 0.74;LLM 提示仅 562 次(Bills 645 次),较 PromptTopic、TopicGPT、LiSA 的 15,242+ 与 8,024+ 减少 92% 以上 | 两个数据集、单一闭源主干;未报种子与显著性;作者自陈闭源 LLM 带来污染与复现风险;原文代码仓库实测 HTTP 404 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | LLM-jp-4 Technical Report · arXiv:2610.19331 | 训练与研发流程:预训练—中训练—后训练的公开配方,含 4K→16K→64K 上下文扩展 | 日文 llm-jp-eval v2.1.3 均分 0.307→0.605(32B-A3B),同表 Qwen3-8B 0.608、gpt-oss-20b 0.604;英文 0.354→0.650(Qwen3-8B 0.714) | 技术报告非受控实验,代际对比中数据与配方同变;判官只报三次平均无区间;语料未全部公开,复现指流程 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | KoAGE: Do Large Language Models Know, Learn, and Coin Korean Neologisms? · arXiv:2610.19399 | 改的是基准的截断口径与任务族:按各模型训练截断分列结果,并把造词放进多智能体社区环境 | 21 个模型只看词面定义截断前新造词 34.7%、截断后 11.1%(开源 11.1%/1.1%),截断当年词仅 13–30%;社区造词仅 48% 沿用人类机制、缩略占 32% | 多为单次运行与厂商默认温度;G2 仅 25 卡、单主干单种子;仅 4 模型温度 0 复跑;代码仓库实测 404 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | More Than Seeing: Vision as Scalable Anchors in Native Multimodal Pre-Training · arXiv:2610.19443 | 用无内容 pad 占位替换图像嵌入,隔离视觉内容对训练前沿与下游能力的贡献 | 纯文本配对锚点间隙均值 −0.006%;多模态锚点间隙沿 img 包络由 3.35% 升至 8.09%(幂律指数 0.256、R²0.955) | 拟合复用同一批相关运行、未报告种子复现;幂律只覆盖已测算力区间;固定混合比 r=0.3 未做扫描 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | When Occupation-derived Skills Don’t Help: On the Limits of Skill-Augmented Career Path Prediction · arXiv:2610.20186 | 职业路径预测中技能表示是否冗余:评分融合与技能增强 MLP,金标与预测技能两条件 | DECORTE 文本基线 MRR 0.266、技能增强最好 0.270;文本与技能排序分 Spearman 均值 0.79,技能最多只纠正 2.9%样本 | 单轮无显著性检验与方差;仅一个文本基线架构;结论限于本设定,非技能表示普遍无用 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Do AI Agents Gossip? Evaluative Talk in Human and AI-Agent Online Communities · arXiv:2610.20360 | 用 LLM 判官加人工标注校准的编码协议做跨平台观测 | 同口径下含至少一条质疑的主题占比人类 65.1% 对智能体 21.3%;首个附和回复后共识未被挑战 44.7% 对 83.6% | 智能体侧样本小(37 条随机八卦帖、85 个锚帖);判官与作者可能同族;PTT 跨 2004–2024 对 Moltbook 七周,评论覆盖 71.9% | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Lexical Persistence Without Semantic Entrenchment in AI Agent Communities · arXiv:2610.20365 | 社区语义轨迹诊断:漂移 B1、邻域稳定 B2 与 lag-1 自相关 | MoltBook 自相关 0.167(p=0.41,n=199),对比 Reddit 0.313、PTT 0.622(均 p<.001);B1 约人类 2 倍、B2 低 20%–30% | MoltBook 的 8 周即其全部历史,年龄混淆只部分缓解;以单一 AI 平台为主;B1/B2 未做正式检验 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Analyzing performance of Retrieval Augmented Generation models for Question Answering Tasks · arXiv:2610.20419 | 把检索到的上下文与直接给定上下文拆成两档对照 | 表 5、图 8:RAG 平均准确率仅在 Bangla、Urdu、Tamil 高于直接给上下文,Hindi、Nepali 上直接给上下文更强 | 无重复次数与显著性;框架结论只来自 100 条试点;数据集与代码无入口;流行度只是观测关联 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | The COUNT: Counting N-grams Unlocks Scaling on Host Memory and Training-Free Adaptation · arXiv:2610.20456 | 计数表从显存搬到主机内存,作为免参输入嵌入并支持推理期换表 | 固定算力下 1B 主干验证损失等效多 46–89% 算力、任务损失等效 6–56%;797 GB 计数表服务 370M 到 1B 主干;λ=0.25 插值领域表使数学、生物医学、法律三领域域内损失均下降;吞吐保留 93.1–97.8% | 等效算力为缩放律拟合值而非实测;结论限 1B 及以下主干与 D/N 10、20、40;吞吐依赖主机查表优化 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Soloist: A Generative Model for Blind Voice Separation in the Wild · arXiv:2610.19716 | 语音生成式分离的训练信号与评测口径 | 盲计数 WildTV 语料级 PI-WER 0.150、计数准确率 1.000(SR-CorrNet 为 1.940 与 0.217);加噪 LibriMix PI-WER 0.192;裁判与 PI-WER 顺序一致率 88.9% | 除裁判一致性外多为点估计,未报随机种子;裁判信号检查为启发式;歌声数字只是与教师伪人声的一致度。 | 语音与音频栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Repairing Speech Access After Text Updates with Frozen Affine Fields · arXiv:2610.20253 | 冻结检查点之外的可拆卸语音隐状态算子(访问路径) | 真人录音 SLUE-SQA-5 的 256 条提问上 Affirm-Direct 比 No Repair 高 0.0941 ROUGE-L,LoReFT +0.0774,匹配范数的 SALSA −0.0707;合成语音上无优势 | 合成语音单一音色;SLUE 上任务、提示、说话人、声学同时变化且带段落;正结果只针对完整算子,单状态约束限制容量 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Anuvani-LID: Robust and Calibrated Spoken Language Identification for Indian Languages · arXiv:2610.20263 | 语音侧数据与评测:23 类印度语种 LID 的多轴留出条件与校准 | 37 个核心条件平均宏 F1 0.914,比 Gemini 3.5 Flash 高 5.2 分;1 秒输入高 24 分;23 类面板 0.897 对 0.713 | Stage I–V 每臂仅一次运行、Stage VI 只训一次;商用 API 仅给硬标签故未比校准;模型页实测 404 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | MuseBench: A Benchmark for AI-Generated Music Detection and Artifact Analysis · arXiv:2610.20310 | 给检测器建立含人机共创、压缩、后处理与对抗扰动的鲁棒性评测矩阵 | 11 个检测器在 361,166 首曲目上,默认设置下 ResNet18+Spec 与 AST 的平衡准确率均为 100.0、手写特征的 Deezer 为 97.6;但 PGD 扰动把 M5 漏报率推到 92.4%、变速变调把 Deezer 推到 93.6% | 商业 API 只跑了 1,990 首人类加 4,500 首 AI 的子集,与开源检测器全量口径不同;数据集托管在匿名仓库;无重复实验与显著性检验 | 语音与音频栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Anuvani-Diarization: Zero Shot Speaker Diarization and Annotation Conventions Across 22 Languages · arXiv:2610.20327 | 多语言 diarization 的评测约定敏感性 | 1,164 段录音时长加权 DER 16.78%,对 DiariZen md-v2 低 1.21 个百分点;桥接短间隙使 DER 降 1.90 到 4.14 个百分点,在字对齐集上反升 0.68 到 6.01 | 系统不建模基准分段约定;仍高于 Sarvam AI 自报的 16.0%;论文给出的模型入口实测 404。 | 自然语言处理栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | Quantizer Redundancy and Exact Index Recoding in a Frozen Neural Audio Codec · arXiv:2610.20471 | 编解码器索引存储:在冻结模型之外做预测式精确索引重编码,不动解码器输入 | 512 文件队列 129.591 kbps,比原索引 XZ 对照 174.988 kbps 低 25.943%;同 zlib 设置下预测式表示降 36.012% | 两个队列为方便样本且做过集合平衡,无法证明与训练内容不相交;精确性只在记录的 CPU float32 下成立;无代码入口 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | An Initial Study of Physiological Markers for Deepfake Speech Detection · arXiv:2610.18934 | 用 36 个手工生理标记加线性分类器替代高维学习表征做深度伪造语音检测 | 池化英语语料 EDS-14(12,198 真/70,085 伪)上域内 EER:RBF SVM 21.40%、LR 27.60%;只用于跨域评测的 MLAAD/M-AILABS 上 LR 32.77% | 无显著性检验与种子报告;池化划分非说话人隔离,OOD 亦非未见说话人;部分子集只有单一类别 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | CAFE: Confining Feature Distillation to Language-Routed Adapters for Compact Multilingual Automatic Speech Recognition · arXiv:2610.19134 | 多语 ASR 特征蒸馏的梯度作用位置:从损失层挪到语言路由适配器 | Open ASR 榜 EN-7+ML-9 检查点平均 WER:CAFE 8.02%,基线 8.55%,只加适配器的 Capacity 8.51%,直接加 CKA 9.04%;8 语言复现 EN-7 10.11%→8.71% | 每配置只训一次,显著性只用最后 7 个检查点;学生由教师剪枝初始化,结论不外推;主结果用测试集语言标签路由 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | From Detection to Anticipation: Continuous Onset Forecasting for Stuttered Speech · arXiv:2610.19235 | 把口吃预测改写为每 100 ms 的因果时间-事件预测,并给出事件级评测口径 | FBT 36 位说话人上因果 Conformer AUROC 0.63、AP 0.0769(为 4.93% 阳性率的 1.56 倍);25% 报警占空比下覆盖 58.6% 事件 | 单一数据集、2,872 个事件;稀有类型说话人内 AUROC 区间跨 0.5;原文未给出代码或数据入口 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Point-and-Play: Instrument Timbre Cloning from Music Mixtures · arXiv:2610.19445 | 以提示门控统计池化,从混音直接取音色,替代先分离再克隆 | 表 1:27 个留出 NSynth 乐器上目标乐器音频提示 CLAP 0.696、FAD 1.92,接近干净独奏 oracle 的 0.762 与 1.85;优于 Demucs 4.13 | 无重复次数、方差与显著性,未做听感测试;各系统用各自条件空间的解码器,绝对值只能同表比较 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Towards Efficient Simultaneous Inverse Text Normalization with Pretrained Text-to-Text Language Model and Read-Tag-Write Policy · arXiv:2610.19492 | 端到端 ITN 的流式化——分块因果编码加读-标注-写解码 | 越南语含 PnC 设定下流式 S2 的 WER 4.18% 对离线 B2 的 3.63%;噪声转写上 S4 相对混合基线 H2 降 21.43%;块大小 5 时延迟 206 ms→60 ms | 只做越南语与单一骨干;流式准确率仍低于离线;数据集只描述生成管线未给入口;混合基线实现沿用前人工作 | 自然语言处理栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | TVPara: Paralinguistic Captioning of Expressive TV-Series Speech in Complex Acoustic Environments · arXiv:2610.19678 | 语音数据与评测:剧集副语言字幕(单句与多句)与属性级 LLM 判官打分 | 492h 单句加 213h 多句;SFT 相对零样本逐格平均相对提升 31.26%;音量预测与实测能量 ρ 仅 0.03 | 判官只在文本层比对属性、不接触音频,且无判官与人评一致性;仅微调 2 个模型、未报种子数 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | ONCship: A Large-Scale Underwater Acoustic Corpus for Ship Recognition · arXiv:2610.19722 | 两万小时原始水声筛成 4521 小时语料,并设同站与异站增训对照 | EAT 联合预训练线性探针 DeepShip 准确率 62.45%,超 ResNet18(LARS) 的 57.78% 共 4.67 个点;BEATs 同站增训 68.11 升到 69.41 | 原文未给出数据集下载入口,仅写来源 ONC;MMSI 子集只有 50 个身份、100 小时,Top-1 最高 0.5320;全文无专门局限节 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | SEA-HELM Audio: Evaluating Multilingual ASR-LLM Pipeline Performance Across SEA-HELM Subsets · arXiv:2610.19869 | 语音侧评测口径:文本上限分与语音端到端分双路径对照 | 同一验证器下的 Δ=文本−语音:多选 9.00–18.50 分(中文 9.00–10.75、英语 15.50–18.50),指令跟随 20.00–42.86 分(泰米尔语两管线均为 40.00) | 只报点估计,每次运行 400 与 105 题且无重复次数;两任务 TTS 引擎不同;NLU QA 与 Safeguard 未评测;无代码或数据入口 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Few-Shot Adaptation for Anomalous Sound Detection at Low False-Positive Rate · arXiv:2610.19893 | 音频检测口径与适配:低误报工作点指标、冻结正常分布 | AUPR 23.0→64.0;pAUROC(FPR≤1%)39.6±0.9→72.8±0.4;TPR@FPR 0.1% 9.4±0.8→60.6±0.1(10 种子) | 单厂实测、故障为人工复现;两个边距手工选定且无故障验证集;无代码与数据入口;折间波动大 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | ACR-Net: Mitigating Semantic Dominance via Contrastive Acoustic-Semantic Decoupling · arXiv:2610.20114 | 音频文本冲突基准与解耦程度指标 | 极性冲突上 ACR-Net ACC 68.4 对 FAS 42.5、MCR 35.2;表示策略消融从朴素拼接 41.2 升到 76.5(表 2、表 4) | 冲突数据为合成、规模仅 1,200 条;未报多种子与置信区间;SOP 与 LDD 绝对值依赖模型与表示定义。 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Evaluating perceptual transparency of lossy music audio compression with Opus codec · arXiv:2610.20246 | 听测设计与统计口径(ITU-R BS.1116-3、LMM、TOST) | 第二阶段用最苛刻 10 名听众与 8 段最难样本:128 kbps 被判有损(p=0.030),160 kbps 通过 TOST 等价检验(p=0.024);第一阶段 128 kbps 未过硬等价(p=0.064) | 第二阶段为极端子集不可外推;Δ=±0.25 边界与设备、−23 LUFS 归一化绑定;未作多重比较校正 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | HRTF Upsampling and Personalization via Neural Operators · arXiv:2610.20400 | HRTF 上采样写成算子学习:球面隐模态加 Transformer 加方向解码与 TTO | SONICOM 在测点数 3、5、19、100 全档 LSD 最低,100 测点 2.3 dB 对 IOA3D 2.8 dB(低 18%)、ILD 误差低 43%;重建较 RANF 快 15–373 倍 | SONICOM 部分基线取自 RANF 原文;HUTUBS 为模拟 HRTF;未报种子波动;指标只在未观测方向计算 | 语音与音频栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | vst-bench-ml: Auditable Dataset Generation for Audio Plugins · arXiv:2610.20465 | 音频数据可行性:密封清单加输出哈希的可离线核验发布层 | 固定 macOS arm64 与 Python 3.12.13 栈上,两次全新进程复现同一计划哈希与全部 8 个预期输出哈希;12 个负例通过;0.1.1 版包测试 31 项、配套测试 36 项通过 | 只用自写 fixture、4 组参数与 2 个 MIDI 信号;未报跨平台重复次数;未测性能与感知质量;软件类投稿仍在评审中 | 语音与音频栏目 · 官网条目 · 全文 |
一、harness、门控与运行期执行控制
1. 用一纸规范驱动训练与评测的催收语音智能体:文本化检查 67%→93%、场景 15/43→40/43
Following the Flow the Law Requires: Training Voice Agents to Transfer to Unseen Regulated Procedures in Debt Collection · arXiv:2610.18881 · 精读
研究问题与核心方法:论文问一个小型自托管对话策略能否只训练一次、就遵循从未见过的「受监管流程」(由法规固定的对话顺序与话术)。作者把每个部署的规则写成一份机器可读的规范 FlowSpec(含状态、工具、约束三类字段的 JSON 文档),用同一份文档同时派生四样东西:策略指令、被门控的工具环境、监督目标与评测检查;智能体不自生成话术,只在「话语目录」(catalogue,一份已批准话术目录的编号枚举)里选条目,说话等于调用 reply 工具并传目录编号。训练侧用 Qwen3.5-9B 加 rank-32 LoRA(低秩适配)在 297 个随机化流程生成的 2,506 段对话上做监督微调,并把整条「谱系」(lineage,同一基础流程变异出的全部版本)整体留出,以检验向未见流程的迁移。 11
关键结果:
- 评测把检查按「期望值由谁决定」拆成两类:documented(文本化,期望值由流程规定,如必须调用的工具、收尾处置)与 grounded(接地的,期望值由本次对话决定,如工具参数是否与来电者所说一致)。训练前 9B 策略在 grounded 上已过 97–100%,documented 只有 67–71%;训练后 documented 升到 93–100%(含完全留出的谱系),grounded 到 100%(表 III)。 11
- 整条留出谱系的场景通过数从 8/21 升到 18/21,三个相关谱系部署合计从 7/22 升到 22/22;四个部署 43 个场景合计 15/43 → 40/43(表 IV、表 V)。 11
- 场景级配对检验:相关谱系 15/22 改善且 0 退步(exact McNemar 配对检验,即对配对二元结果差异的精确检验,p=6.1×10⁻⁵),整条留出谱系 10/21 改善(p=2.0×10⁻³),全部 43 个场景 25 改善(p=6.0×10⁻⁸)。 11
- 规模参照:未训练的 27B 检查点在同一评测口径下过 37/43,高于未训练 9B 的 15/43,但 40GB 硬件在 16 位精度下装不下 27B(表 VI)。 11
- 对共享规范的审计发现 11 处缺陷,其中 3 处连派生指标也暴露不出来(表 VIII 第 9–11 条:静默被判定为成功收尾、数据字段被当作暂存区、生成器内部字段写进对外的字段);缺陷 7 在约 1% 的生成片段里把账户余额透露给尚未验证身份的来电者(表 VIII)。 11
证据与局限:结果来自单次评测运行、四个部署、一条完整留出谱系;场景分母小(21/8/8/6),同一 prompt 与权重重复运行曾得到 8/21 与 9/21,作者因此把数字称为「观测结果」而非稳定估计。训练为单张 H100、3 个 epoch、468 步,未做组件消融(流程条件化、生成轨迹、随机化、数据量、额外微调均无对照),也未评测对「流程改版」的适应。评测用文本转写加模拟来电者,不含语音识别错误;规范、监督与评分三者同源,得分只说明「与形式化规范一致」,不等于合法合规。 11
与目标研究线的连接点:同线多数工作把策略或 SOP(标准作业流程)在推理时喂给智能体,本文把流程放进训练与评测闭环。可搬走的一件东西是它把「遵守流程」拆成 documented 与 grounded 两类检查,用同一份机器可读规范同时生成门控、监督与测试,并按谱系而非单例留出来测迁移;其「规范同源会掩盖缺陷、必须单独审计规范」的思路也可直接用于自建评测。 11
结论建议:若要做受约束的工具型智能体,读第 III 节(FlowSpec 的四类消费者与工具门控)、表 III–V 与附录 D(规范审计),重点搬「检查二分 + 谱系留出 + 规范审计」三段设计。引用时必须限定:单个 9B、单次运行、四个部署、文本转写与模拟来电者,「规范一致」不等于法律合规,数字不可外推为通用流程遵循能力。 11
2. HERO:执行证据驱动的 harness 离线优化加测试时修正,四基准 pass@1 平均 +7.6、再 +2.0
HERO: Harnessing Evidence for Test-time Refinement and Prompt Optimization in Program Generation · arXiv:2610.19184 · 精读
研究问题与核心方法:文本转 SQL、文本转 Cypher、文本转 Python 这类程序生成任务里,围着冻结大模型的 harness(提示词、工具、记忆构成的那套外壳)可以离线优化,但让 LLM 反思器直接改提示,往往一边修掉旧错误一边破坏原本正确的行为;而把测试时经验写回共享上下文,又会让一个实例的错答污染后续任务。HERO 把 harness 拆成跨实例复用的共享提示 h_shared 与实例级状态 h_inst 两层:离线阶段(HERO-O)用成功与失败程序的执行轨迹、报错和输出不匹配作为有据可依的诊断材料,提出可复用规则型的候选提示,再经带配对比较与不确定度分配的门控先验后采纳,最后在独立选择集上挑出最终提示;测试时阶段(HERO-T)冻结共享提示,只用当前实例的执行证据与检索到的已验证训练样例修正该程序,且修正必须通过程序化检查、并由同一模型判定“有证据支撑”才被接受。12
关键结果:
- 四类基准(BIRD-SQL 文本转 SQL、CypherBench 文本转 Cypher、BigCodeBench-Instruct 与 DSCodeBench 文本转 Python 函数)上,HERO-O 相对初始提示的 pass@1 提升分别为 4.16、11.5、4.66、10.1 个点,四类基准平均提升即摘要所称的 7.6 个点(表 1)。
- 测试时修正再带来 1.26、4.43、1.20、1.20 个点,四基准平均再加 2.0 个点;合并后 HERO 在四分之三基准上取得最高 pass@1 均值,只有 DSCodeBench 上 ReAct 略高(56.22 对 56.04)。
- 离线最优性:BIRD-SQL 63.55 对 GEPA 62.59,BigCodeBench 52.59 对 ACE 51.96,DSCodeBench 54.84 对 GEPA 52.14,CypherBench 85.50 对 SkillOpt 84.10;端到端做 harness 优化的 Meta-Harness 反而低于初始提示(BIRD-SQL 58.24 对 59.39,BigCodeBench 45.26 对 47.93)。
- 回归控制:累积 fix-to-break 比值(累计修复数除以累计回退数,大于 1 表示净修复)在 BIRD-SQL 上 HERO-O 约 3.0,MIPROv2 与 SkillOpt 约 2.0、GEPA 约 1.5、ACE 约 1.2;只拿失败案例做反馈时该比值从 2.23 降到 1.91。
- 成本与效率:最终提示平均 1,949 token,短于 GEPA 的 2,003、MIPROv2 的 2,704、ACE 的 35,881;每次优化调用平均 2.79K token,ACE 为 31.89K。执行效率用 VES(Valid Efficiency Score,按执行时间给正确程序加权的有效效率分)衡量:HERO-O 在 BIRD-SQL 取 91.9、BigCodeBench 取 75.0 居首,但 CypherBench 上 pass@1 从 85.5 升到 89.93 时 VES 反从 109.8 降到 101.7。12
证据与局限:主要结果按三个种子报告均值与标准差(表 1、表 3);优化预算按 GEPA 的 auto=heavy 设定固定,并对所有方法对齐 rollout 数。作者自陈固定预算会限制部分方法,且用 rollout 数对齐预算的做法无法覆盖「反思、候选生成与选择」三处成本差异,ACE 与 Meta-Harness 在 BigCodeBench 上分别耗约 12 与 24 小时机时,主实验依赖专有 GPT-5 与 GPT-5.4。引用时注意两点:表 3 里 DSCodeBench 的 HERO-O VES 在正文写作 57.8、在表内为 59.8,同一数字两处不一致,引用须注明取表值;“pass@1 平均提升 7.6 点”是四类基准的平均值,不能当作单基准增益。12
与目标研究线的连接点:同节其它离线提示/外壳优化工作只讲“反思后改提示”,HERO 的差别落在两个具体设计上——把执行结果(而非 LLM 反思)当作文本梯度的依据;以及在验收阶段用配对比对加不确定度分配,把“修复”与“回退”分开计分。可搬走的一件东西就是那条验收口径:候选提示只有在配对平均提升超过最小阈值 τ、且预算分配通过 UCB 式上界比较之后才替换当前提示,这一条直接抑制提示漂移。12
结论建议:要搬运行期执行控制的读者,重点读第 4.1.2 节的 ScreenAndAccept 门控与第 6.1 节的 fix-to-break 分析;要把测试时修正落到自己 pipeline 的读者读第 4.2 节(证据门;每实例检索后用同一模型挑不超过 3 个已验证样例;默认修正预算 B=3)。对 A 线可迁移的是“共享层与实例层分离”这一结构;引用数字时必须限定在四类程序生成基准与 GPT-5 骨干上。12
3. 熵信号回退重写:MATH500 上 77.60% 对随机切点 MCMC 的 72.60%
REWIND: Uncertainty-Guided Trajectory Repair for Test-Time Reasoning · arXiv:2610.19561 · 精读
研究问题与核心方法:一次早期的推理错误会约束其后全部推理,而 MCMC(马尔可夫链蒙特卡洛,这里指 Metropolis–Hastings 式的后缀提议采样)类重生成方法随机挑切点,无法对准真正出错的位置。作者提出 REWIND(Reasoning Error Windback via INtrinsic Detection),一个免训练的控制器:先取当前序列熵最高的生成位置作为锚点,再在其前 w=5 个 token 的窗口内找熵增量最大的位置(熵梯度回溯),把切点对齐到窗口内最近的分隔符(边界对齐),重生成后缀后用 MH 式(Metropolis–Hastings 式)分数决定是否接受。全部信号都由模型自身 logits 算出,不需要额外训练或外部验证器。 13
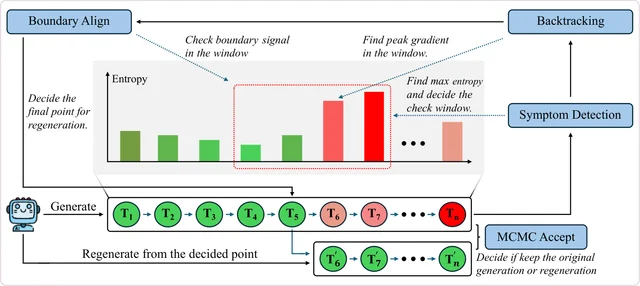
REWIND 的提议策略四步:熵峰锚定、梯度回溯选点、边界对齐、重生成后按分数接受(arXiv:2610.19561)
关键结果:
- 熵与错误的关联:在 MATH500 上对 Qwen2.5-Math-7B 每题采样 20 条回答,错误回答的平均 token 熵比正确回答高约 112%(逐题相对增幅的均值,中位数 83.61%),在 463 道同时含对错回答的题里,88.12% 的题上错误回答熵更高。
- 回答级诊断:平均 token 熵区分对错的 AUROC(受试者工作特征曲线下面积)为 0.746(95% CI [0.731, 0.760]),高于最大熵增量 0.724 与峰值熵 0.677。
- 主结果:在 3 个模型族 × 5 个基准共 15 个组合上 REWIND 全部取得最高准确率,比随机切点的 MCMC 高 0.51–10.00 个百分点;Qwen2.5-Math-7B 的 MATH500 从 MCMC 的 72.60% 升到 77.60%、GSM8K 从 79.45% 升到 84.31%,DeepSeek-R1-Distill-Qwen-1.5B 的 AIME2025 从 16.67% 升到 26.67%。
- 提议消融(Qwen2.5-Math-7B/MATH500,每块 K=10 次随机 MCMC 提议;原文表 3 分「切点选择 / 边界对齐」两列):主结果的对照基线 MCMC 是「全局随机切点 + 不做边界对齐」72.60%,与下列各档不是同一行;其余依次为随机分隔符(全局随机切点 + 完整边界对齐)73.20%、峰值处修订(在峰值 + 完整边界对齐)74.20%、窗口内随机切点(窗口内随机 + 完整边界对齐)75.20%、不做事先边界对齐(窗口内熵梯度 + 不做边界对齐)75.00%、受限边界(窗口内熵梯度 + 只用句号和换行)76.80%、完整 REWIND(窗口内熵梯度 + 完整边界对齐)77.60%。其中 73.20% 与 72.60% 同取全局随机切点,差别只在是否加完整边界对齐。 13
证据与局限:主表是三次独立随机种子运行的均值,标准差放在附录 K,但作者未报告显著性检验;熵–错误关系来自 500 题各 20 次生成、剔除 49 条空回答后的 9,951 条回答,属观察性关联,作者也明说自己没有 token 级首错标注,因此证据是「干预有用」而非「定位准确」。作者自陈的局限还包括:成本研究只报生成 token 数(MCMC 为单次温度采样的 8.84 倍、REWIND 为 9.26 倍,REWIND 比 MCMC 多约 4.8%),未做 FLOPs 或墙钟时间归一;AIME2025 只有 30 题;7.6% 的受检样例「自信但无熵峰」,14.8% 检出却未救回;作者也说明该接受过滤器略去了前后向的位点选择概率,不构成精确的 MH 稳态。 13
与目标研究线的连接点:同线的其它工作要么在回答级给不确定度打分再据此过滤或终止,要么在强化学习训练里用高熵 token 定位分叉点;REWIND 的差别是把它落成一条免训练的「运行期修复」策略,同一份 logits 既用来定位改动位置又用来决定接受与否。可搬走的是「先定位、再重写」的两级解耦设计:切点选择与接受判据分开做消融,因而可以在不换接受规则的前提下独立替换触发器(熵、偏度、峰度、时域 KL)。另外它在同等预算下与 MCMC、BoN@10 对照的做法(生成 token 比 9.26 倍对 8.84 倍、BoN@10 名义约 10 倍)也值得照搬。 13
结论建议:读第 3.2 节的熵–错误关联、5.2 节的主表(表 2)与 5.3 节的提议消融(表 3、表 4),再看 5.4 节的预算对照。对长程任务的运行期控制线,可直接搬这套免训练控制器骨架:熵梯度回溯选点 + 边界对齐 + MH 式接受。引用时须限定:增益为单一提示设置下三次种子运行的均值、无显著性检验,AIME2025 仅 30 题,且作者自陈该过滤器不是精确 MH。代码入口为匿名仓库(实测 HTTP 403,Cloudflare 反爬拦截,无法确认内容)。 13
4. RouteWeaver:把模式选择并入路由策略,五域平均准确率 61.4%,较最强基线 Router-R1 高 11.03%
RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing · arXiv:2610.19705 · 精读
研究问题与核心方法:现有 LLM(large language model,大语言模型)路由都先固定一种执行范式(单轮、多轮、agentic),因此只能选模型、不能决定「调用怎么组织」。RouteWeaver 用一个统一的动作文法把三种范式写成同一个策略的两级决策:模式选择(mode,用哪个范式)与模式内模型选择(inner,在该范式里调哪个 Worker)。训练上用 COMET-GRPO(COordinated Mode–Execution Training,把轨迹级优势拆成模式级与模式内两个信号的分组相对策略优化变体)做针对性信用分配,再用渐进探索(progressive exploration)先外部指定模式、逐步放开到自主选择,让策略先学会每种模式怎么执行、再学何时用。14
关键结果:
- 九个基准五个域(Math、Code、Knowledge、Reason、Recall)上平均准确率 61.4%,最强基线 Router-R1 为 55.3%,相对提升 11.03%,且五个域全部优于所有基线,相对增益从 Recall 的 5.20% 到 Math 的 12.52%(表 1)。14
- 消融(表 2,同预算同初始化):换成普通 GRPO 平均掉到 58.8%,模式使用从 .35/.41/.24 偏到 .13/.82/.05(几乎全走多轮);去掉渐进探索掉到 55.6%,策略完全塌到单轮(1.00/.00/.00)。两个消融版仍高于 55.3% 的最强固定范式基线。14
- 模式使用按任务强烈分化:Math 19%/50%/31%(单轮/多轮/agentic),Code 84% 走多轮,Knowledge 72% 走单轮,Reason 99% 走 agentic,Recall 96% 走单轮。14
- 代价曲线(α 为任务奖励优势与效率(成本)奖励优势的混合权重,α=0 表示只用任务信号、只优化任务性能,α∈{0,0.1,0.3,0.5}):α=0.1 省 23% 成本、掉 1.0 个点;α=0.3 省 61%、掉 3.1 个点;α=0.5 省 86%、掉 11.2 个点。未见基准(AIME、GPQA-D、BBH)平均 53.7%,Router-R1 为 45.4%(相对 +18.28%)。14
证据与局限:路由器是 Qwen3-4B-Instruct-2507 全参微调,Worker 池是 6 个冻结模型(Qwen3-8B、Qwen3-30B-A3B-Instruct-2507、Llama-3.1-8B-Instruct、Llama-3.3-70B-Instruct、Gemma-3-27B-IT、Gemini-2.5-Flash-Lite),路由器只看到匿名 ID 与能力描述、看不到模型名与价格;训练 3,200 条 query(每 batch 32 条,按域配额),评测 1,060 题(8 个数据集各 120 题 + TACO 100 题),与训练题不重叠。原文未报告训练种子数或置信区间,消融只有单点数值,α=0 的成本是事后按 token 用量重建的;域分数是未加权的域内均值,跨基准横向比较时要留意该口径。14
与目标研究线的连接点:直接落在 A 线的运行期执行控制这一环——它把「执行范式本身」变成一个可学习的门控决策,是 harness(包在执行器外面的一层调用外壳:工具、技能与过程编排)设计里少见的把「选模型」与「选调用结构」合进同一策略的写法。与同线其它路由工作相比,可搬走的有两件:COMET-GRPO 把优势拆成模式级与模式内分别加到模式 token 与后续 token 上;以及「强制指定→逐步放开」的渐进探索课程——消融显示它是防止策略塌成单轮的关键。14
结论建议:读 §4.1–4.3(统一轨迹表示、COMET-GRPO、渐进探索)、§5.2 表 1、§5.4 表 2、§5.5;代码在 https://github.com/LaughKing/RouteWeaver(实测 HTTP 200)。引用时必须限定为「单路由器全参微调 + 6 个冻结 Worker」的设置,并把 61.4% 说成该协议下的未加权域均值,不能当成通用路由上限。14
5. Delta Tokenizer:会话增量分词约快 40 倍,SGLang 中 100K 上下文首 token 时间中位数降 59%
Delta Tokenizer: Reference-Identical Tokenization of Session Deltas and Segment-Parallelism for Long Prompts on Multicore CPUs · arXiv:2610.19801 · 精读
研究问题与核心方法:LLM 推理栈里 KV cache 已经避免重算共享前缀,但 CPU 侧的分词前端每一轮仍把整个会话从第一个字符重新切一遍,于是首 token 时间(TTFT,从请求到达至第一个输出 token)随会话变长而变长。Delta Tokenizer 把每个请求当作对同会话上一轮的增量:保留上一轮的 token 序列,只重编码追加文本与可能受影响的短尾,并且只在分词器自身切分规则无法移动的边界处拼接,以此保证与参考分词逐 ID 相同;对无状态的长请求,则在实用分词器本来就保持相邻片段独立的切点处切块、多核并行编码后拼接。15
关键结果:
- 增量路径把单个会话轮次的分词时间相对 Hugging Face 参考分词器缩短约 40 倍,且该结论与上下文长度无关:固定追加 1.3K 字符时,全文从约 3.7K token 长到 662K token,拼接后被替换的部分始终在 300 token 附近。15
- 16 核上,400 万字符请求的分块并行编码比串行编码快 8.2 倍,比作者重实现的 LoPT 快 1.6–2.1 倍。15
- 接入 SGLang 后,100K token 聊天上下文的 TTFT 中位数下降 59%;agent 会话的 P99 TTFT 在负载下降 9.5 倍,在长请求占住前端、根本没进模型时降 23 倍;这些请求被接纳并由前缀缓存服务时仍约低 7 倍,在单核或更小模型上约低 20 倍。15
- 精确性检查(表 3):快速编码器整体编码的 41.8B 篇文档与参考逐 ID 一致、0 处不同;agent 阴影重编码 2,195 次、含长文档时 2,268 次比较全部 0 处不同;作者刻意保留一行「去掉归一化检查」的对照,10 万次比较中有 2,115 次不同,说明检查本身有检出能力。15
- 会话状态开销很小:100K token 时文本 391 KB、token ID 526 KB、前缀块 562 KB,合计约 1,089 KB,而同一批 token 的 KV cache 为 14.75 GB。15
证据与局限:实验分三段(增量、分块并行、调度)+ 端到端接入,多数吞吐与延迟数字为单次配置测量,原文未报告重复次数或种子数,只有部分图给出 95% bootstrap 区间;作者自陈跨机器结论方向一致但倍数依赖平台(GH200 节点上同一对比是 13 倍,而非 Zen/EPYC 机器上的 23 倍)。对比系统本身存在正确性问题:LoPT 在 CLongEval 上 21,789 次比较有 30 次 ID 不同,fastokens 279 次有 78 次不同,Gigatoken 在 41.8B 中 558 次不同——这些是作者查出的对手缺陷,但也意味着「比 LoPT 快 1.6–2.1 倍」是在作者自己的重实现上测的。15
与目标研究线的连接点:同节其它工作多在模型侧(调度、缓存、批处理)做控制,这一篇改的是被默认为「零成本」的服务前端,是 A 线里少见的「把前端也纳入首 token 延迟账本」的做法。可搬走的具体一件:会话内 tokenizer 级增量复用要在「切分规则无法移动的边界」处拼接才能保证逐 ID 一致,以及配套的精确性回归清单(整篇编码、逐轮重放、对抗串、阴影重编码、SGLang 报出的 prompt token 数五类对照)。15
结论建议:读 §3 的增量拼接与切点论证、§4.1 与 §4.4–§4.6 的 SGLang 端到端测量、§4.8 精确性表。对 A 线可迁移的是「会话状态复用 + 精确性回归」这套工程口径。引用时必须限定为 Qwen3-8B / gpt-oss-120b 在特定机器配置下的 TTFT,不能把 40 倍、59% 当作通用倍数。代码入口为 https://github.com/asu-idi/toktier (实测 HTTP 200;abs 页注释说明增量路径与快速编码器已开源,分块并行路径、CPU 池调度器与 SGLang 适配器「将在补充材料中发布」)。15
6. 强 harness 压平模型差距:153 份法案上最弱模型配全流水线 0.948 胜过最强模型零样本 0.806
A Strong Harness Narrows the Model Gap: A Comparative Evaluation for Legislative Document-to-XML Conversion · arXiv:2610.19999 · 精读
研究问题与核心方法:任务是把美国州立法议案 PDF 精确复现成受 DTD(Document Type Definition,文档类型定义)约束的出版 XML,要求章节层级、逐字文本、法条引用与修正案的增删标记都对得上。作者把「围绕模型的确定性工程」(类型化工具、schema 校验、按辖区配置、固定每一步产出的结构边界)统称 harness,并做成三级消融:T1 零样本一次直出(不给任何工具或中间步骤);T2 单智能体持有全部 47 个工具、按 9 步 playbook 自己排序;T3 分解为 7 个子智能体、由可编辑的自然语言 playbook 经 21 步编排,对外暴露 17 个组合工具,底层仍是同一批 47 个工具。T2 与 T3 工具集完全相同,因此 T2→T3 的差距被归因于编排(分解、可持久化的检查点状态、每个智能体各自的小上下文)。作者来自汤姆森路透科技(Thomson Reuters Technology)。 1
关键结果:
- 主结果(153 份专家产出的 gold(人工产出的标准答案)议案 × 3 个 Claude 模型 × 3 级 harness = 9 格,每格 153 次运行):153 指 gold 法案总数,两个 Overall 分别是各格在各自计分文档上的宏平均,n=133 则是配对检验里两臂都计分的文档子集。最弱模型 Haiku 4.5 在全流水线的 Overall 为 0.948,胜过最强模型 Opus 4.6 零样本的 0.806;同一段的配对 bootstrap 为 Δ=+0.117、p<0.001、n=133——两个 Overall 均值与 Δ 来自不同的文档集合,均值之差不能当作这个 Δ。Sonnet 4.6 全流水线 0.954(对 Opus·T1 Δ=+0.120,p<0.001,n=124)(Table 2)。1
- 模型零样本时 Overall 分布在 0.677–0.807,进入全流水线后收敛到 0.946–0.954:从 Haiku 零样本到 Haiku 全流水线抬升 0.677→0.948,而在零样本下从 Haiku 换到 Opus 只从 0.677 到 0.806(§6.1、Fig. 2)。1
- 引用规范化是 harness 属性:把引用解析到权威标识符这一维,Haiku 从零样本 0.024 只升到 T2 的 0.103,到 T3 才到 0.801;Sonnet 与 Opus 一拿到查找工具(T2)就到 0.881 与 0.593(§6.3、Fig. 3)。1
- 可靠性(低分文档比例,Overall<0.70):从 T1 的 31% 降到 T2 的 8%、T3 的 4%;方差反而非单调——T2 的合并标准差(pooled std)0.188 高于 T1 的 0.167,T3 才收到 0.099(Table 3)。1
- 更难的辖区上 harness 优势更大而非更小:Sonnet 全流水线减 Opus 零样本在爱达荷为 +0.117、在新泽西为 +0.174;新泽西在两套 harness、每个模型下都更难(§6.5、Table 4)。1
- 输出完整性:T1 有 7/459 次尝试、T2 有 21/459 次出现截断或过量生成(重跑可复现,作者记为稳定属性),集中在最大的几份新泽西预算案;T3 共享同样工具访问却没有这两类失败(§6.4)。1
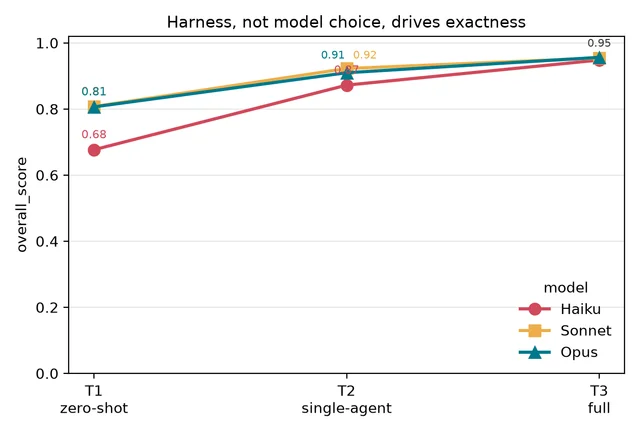
三个模型(Haiku、Sonnet、Opus)在三级 harness 下的总体得分:T1 零样本时分散在 0.68–0.81,T2 单智能体收拢,T3 全流水线都落在 0.95 附近(arXiv:2610.19999)
证据与局限:每个「模型×harness×文档」格只跑一次(未设温度与种子,用供应商默认),因此报的是文档样本上的 bootstrap 95% 区间而非运行间方差;作者依赖的对比 p 值均 ≤0.004,并说明确认性对比约 6 个、按 Bonferroni α/6≈0.008 仍成立;T2 上 Sonnet 对 Opus 的差异 p=0.39,作者明确拒绝解读。原文自陈局限:全部结果来自单一模型家族(Claude Haiku 4.5/Sonnet 4.6/Opus 4.6);只测两个辖区、一种文档类型与一套 schema;T2→T3 把分解、持久状态与按智能体上下文三者捆在一起,无法拆开;不报 token、延迟与成本;gold 来自另一套遗留系统且只有一位领域专家校对(未报标注者间一致性,也未报人类性能上限);DTD 与 gold 保密;最大的两份文档因 TEDS 的节点上限被排除在 Overall 之外。引用风险:Overall 是逐字归一化编辑距离(normalized edit distance, NED)、结构树编辑相似度(tree-edit similarity, TEDS)与修正案 F1 三项的未加权平均,引用定位/规范化两列被排除在 Overall 之外,引数字前必须说清是哪个维度。1
与目标研究线的连接点:这是 A 线少见的工业级 harness 定量消融,与同节其它工作的差异在于它把工具访问固定住、专门隔离「编排」这一环,并说明确定性外部查表能补上一个更大模型也补不上的能力(引用的规范标识符必须从外部权威检索,不是从权重里生成)。能搬走两件东西:一是评测口径——把正确性拆成互不混合的维度分别报告(逐字归一化编辑距离、结构树编辑相似度、修正案集合精确匹配、引用定位与引用规范化分开),并用低分率与方差而不只用均值表达「错得有多离谱」;二是确定性/模型的分工原则——凡需要外部真值或模板的步骤交给确定性函数,模型只做解释。1
结论建议:先读 §4(三级 harness 与 Table 1 的输入清单,注意 T2/T3 的工具是同一批)与 §5(四个维度的定义、TEDS 节点上限与配对 bootstrap 的用法),再看 §6.1–6.3 和 Table 3。对 A 线的直接用处是资源配置判断:把预算放在编排与确定性工具上,比换更大模型更能压掉长尾错误,但残余错误(引用规范化、大文档)仍然只能靠专家复核。引用时必须限定单一模型家族、两个辖区、单一 DTD,且 T3 的增益是「编排」这个打包变量的增益,不是分解单项的增益。原文未给出代码入口;输入数据入口为公开的州议会页面(爱达荷州议会 sessioninfo、新泽西州议会 bill-search,均实测 HTTP 200)。1
7. 决策头插件:冻结生成器上 τ=0.5 时 WebArena 从 12.5 升到 13.8%,每步生成词元砍到 3.1
Why Generate a Click? Plug-in Decision Heads for Web Agents · arXiv:2610.20107 · 精读
研究问题与核心方法:基于视觉语言模型的网页智能体靠「写文本」行动,例如把一个从 11 种动作类型里选一类、再从几十个编号框中选一个的决定,展开成 click(6) 这样逐词元解码的字符串,代价是一次顺序解码,且只对写出的那一个字符串打分。作者在冻结的生成器上挂三个插件式决策头(类型头、目标头、参数头),直接读生成器 prefill(预填充,即解码前那一次前向)中五层的隐状态,预测动作三元组;参数头还会指向提示里列出的文本选项或一个「WRITE」槽(表示新文本交回生成器书写)。推理时用置信级联(confidence cascade)控制:三个头概率乘积 c 达到阈值 τ(τ 是置信阈值)就立即执行,否则回退到同一次前向的 KV(key–value)缓存里让生成器解码。作者为 Chengguang Gan、Yunhao Liang、Hanjun Wei、Qinghao Zhang、Zhixi Cai、Shiwen Ni,机构为 Independent Researcher、University of Chinese Academy of Sciences、Pusan National University、Monash University 与 Shenzhen University of Advanced Technology。16
关键结果:
- 线上任务成功率:WebArena 的 174 个测试任务上,级联把 4B 从 12.5% 提到 13.8%、8B 从 13.6% 提到 14.6%,同时每步生成词元从 7.4 降到 3.1(4B)与从 7.5 降到 3.3(8B),任务步数从 15.7 降到 14.0、16.8 降到 16.2(Table 2、§5.2)。16
- 严格阈值 τ=0.9 时,级联在七个离线测试集上与各自生成器基本持平(低 0.3 点到高 1.4 点之内),而决策头仍在 12% 到 64% 的步上作出决定(Table 1、§5.1)。16
- 放宽到 τ=0.5 后两个基准方向相反:Mind2Web 未见网站上步成功率提升 3.1 点(4B)与 1.8 点(8B),GUIAct 四个测试集掉 1.0 到 1.9 点;MiniWoB++ 上分别让出 0.8 与 1.9 点,但决策头独立行动的步占比升到 67% 与 69%(§5.1、§5.2)。16
- 增益来源可定位:按意图模板切开 WebArena 测试任务,47 个在回放训练任务中出现过的模板上 4B 级联为 41.8%、生成器为 34.8%,8B 为 36.9% 对 33.3%;127 个新模板任务上所有系统都低于 7%(Table 3、§5.2)。16
- 联合训练有代价:把决策头与生成器训进同一个适配器,会让生成器自身在七个离线集上掉 0.5 到 4.9 点;换来的头更强,但只值 0.3 到 1.9 点,多数基准上级联不如「冻结生成器 + 单独训头」(Table 5、§6.1)。16
- 速度:MiniWoB++ 上 4B 每步模型耗时从 0.234 秒降到 0.207 秒(τ=0.9,1.13 倍)与 0.168 秒(τ=0.5,1.39 倍);生成器先写一段思考再行动时节省最大,联合级联把每步从 1.56 秒降到 0.70 秒并把成功率从 51.0% 提到 51.5%(Table 4、Table 9、§6.4)。16
证据与局限:训练数据 213k 网页步(去重后 212,761 训练 / 10,430 验证),决策头 6.0M(4B)与 9.2M(8B)参数、约占骨干 0.1%;所有成功率都是三个训练种子的均值,附录 D 给出逐种子结果,但没有置信区间或显著性检验。作者自陈的局限:头的目标空间是编号框,直接输出屏幕坐标的智能体需要另设计目标头;头与特定生成器绑定,换微调后的生成器要重训;全部实验只用 Qwen3-VL 骨干与一套动作语法,且 τ 按实验固定。原文未给出代码或数据入口(正文与附录均无仓库或数据页链接)。16
与目标研究线的连接点:与同节运行期控制类条目互补——它把「这一步要不要花解码预算」变成一个可阈值化的显式分数,而不是靠提示词或启发式。可搬走的两件东西:其一,把决策读成分布而不是字符串,从而获得可记录、可搜索、可阈值的动作概率;其二,级联与生成器共用一次前向的 KV 缓存,使回退几乎不额外付费。16
结论建议:读 §3(三头结构与级联定义)、§5.1–5.2(离线与线上结果)、§6.1(联合训练代价)与 Table 3(按模板拆分的增益来源)。对 A 线可迁移的是「读完再决定是否生成」的级联骨架,以及「增益只落在训练分布覆盖的意图模板上」这一验收口径;引用时必须限定为 Qwen3-VL 骨干、编号框动作空间,且 WebArena 的成功率绝对值(13.8%/14.6%)来自 174 个任务与三个种子,不要与其它论文的任务集混用。16
8. 用层间几何波动触发检索:AUROC 0.7385 对 ReProbe 0.7350,检索调用少 72%
Taking the PULSE of Medical Reasoning: Step-Level Retrieval Timing for Knowledge-Grounded Inference · arXiv:2610.20292 · 精读
研究问题与核心方法:多步医学推理里的知识缺口常只出现在个别步骤:问题级检索太粗,每步都检索又带来噪声与延迟。论文提出的 PUlSE(Probing Ungrounded reasoning via Layer-wise State Evolution,用逐层状态演化探测无据推理;原文正文写作 PUlSE,arXiv 标题写作 PULSE)把中间层隐状态轨迹当作内在信号:对每个推理步,把各层隐状态按 token 均值池化成一条跨层轨迹,再取出两条归一化序列——相邻层的方向变化(角度)与相邻层的位移(幅度),拼成特征向量送入两层隐藏层的小 MLP 探针,判断该步是否有事实错误;超过阈值就取该步关键 token 去检索外部语料,并把检索到的段落重新注入以重生成该步。 17
关键结果:
- 检测效果(骨干 Qwen2.5-7B-Instruct 与 Llama3.1-8B-Instruct;探针在 1,000 道 MedMCQA 加 173 道 AfriMedQA 上按 70/30 划分训练):同分布 MedMCQA 上 PUlSE 的 AUROC(受试者工作特征曲线下面积,与阈值无关的排序质量指标)为 0.7385(Qwen)与 0.7528(Llama),同骨干下 ReProbe 为 0.7350 与 0.7431,PUlSE 的 F1 也最高(Table 1)。 17
- 分布外 MMLU-Pro(Biology)上优势更大:Llama 的 AUROC 0.7933,比 ReProbe 的 0.7406 高 5.3 个百分点,且未做任何再训练;输出层信号(困惑度、最大 softmax 概率、熵)在分布漂移下明显退化,说明输出层置信度难以反映事实依据状态(Table 1、§3.3)。 17
- 检索效率摘要口径:在四个医学基准上,PUlSE 定时检索与「每步都检索」准确率相当而检索调用减少 72%;正文按占 IRCoT(每步检索的对照方法)调用数的比例表述为 28–54%(§6、Table 2)。 17
- 具体数字:Qwen 上 IRCoT 在 MedMCQA 用 5.06 次调用达 85.33%,PUlSE_front 用 2.75 次得 81.67%;JAMA 上 PUlSE_front 58.83%(3.00 次)超过 IRCoT 的 53.87%(4.38 次);MMLU-Pro(Biology)上 PUlSE_front 76.43%(2.62 次)超过 IRCoT 的 72.80%(5.51 次)(Table 2)。 17
- 同一注入协议下比 ReProbe 更准且更省:Qwen 上 JAMA 高 2.38 个百分点且调用少 13%,Health 高 2.57 个百分点且少 13%,Biology 高 2.24 个百分点且少 18%;Llama 上 JAMA 高 2.18 个百分点且少 20%(§4.2)。 17
- 两类几何量互补:只用幅度时 AUROC 0.6565 且只触发 2.51 次(漏检多),只用角度时 0.6866 但触发 2.94 次(过度检索),两者合并最好为 0.7273,端到端准确率 76.43%(Table 3)。 17
- 层区间选择有讲究:只用后层 [18,27] 最差(AUROC 0.7295),前层 [0,9] 为 0.7457,中层 [9,18] 为 0.7491,最终采用的 [7,25] 为 0.7588,甚至超过使用全部层的 0.7559;Llama 对应采用 [6,31](§5.1、Figure 4)。 17
- 跨域零迁移:只用医学数据训练的探针直接用在 MMLU-Pro(Law)1,101 条上,取得 42.23% 准确率与 2.36 次调用,高于 CoT 的 28.52% 与 IRCoT 的 39.96%(4.48 次)(Table 4)。 17
证据与局限:探针训练集共 1,173 题,检索评测的题目全部未见于训练;JAMA 上两个注入变体对 IRCoT 与 ReProbe 的配对检验经 Holm 校正后 p<0.05,其余基准原文只给点估计与自举区间口径(问答级自举、20,000 次配对重采样),未逐项给区间。作者自陈两项局限:方法需要访问中间隐状态,因此不能直接用于黑盒 API;它假设模型输出带明确步骤边界,自由文本生成还需做语义切分。迁移风险:探针与层区间是在这两个骨干上选定的,换模型需重选,跨域结论只建立在一个法律子集上。 17
与目标研究线的连接点:与同节「运行期执行控制」的其他工作相比,PUlSE 的触发信号来自内部表示而不是输出置信度,正好补上输出层信号在分布漂移下失效的短板。可搬走的一件东西是整套轻量管线:按步提取跨层几何特征、训练小探针、用阈值门控外部调用,并把触发信号做成可验证的量——被标记的步补上证据后准确率应当上升,这比只报检测 AUROC 更能说明门控有效。与 SRAT 的对照很清楚:SRAT 用强化学习学「何时检索」改的是策略,PUlSE 只加一个门控,因此更易插进已有 agent 外壳。 17
结论建议:先看 §3.2(特征构造)与 §4.1(触发流程与两种注入位置),再看 Table 1、Table 2 与 §5.1 的层区间选择。引用时必须写明骨干与层区间,并说明「减少 72% 调用」是相对每步都检索的摘要口径,逐基准的比例与准确率代价不同。 17
9. HACHIMI-II:把学生模拟改成对下一个动作的预测,ENEM 模拟准确率 0.384 对真实 0.394
HACHIMI-II: From Role-Play to Learner Behavior Modeling for Faithful Student Simulation · arXiv:2610.19654 · 邻近跟踪
研究问题与核心方法:让学生模拟器可信,前提是它能复现某个具体学习者何时对、何时错;而让大模型「扮演学生」只是给了角色,模型会用自己的能力去填空,于是每个模拟学生水平雷同,也几乎不犯真实学习者的错——作者把这种现象叫 competence leakage(能力泄漏)。作者(East China Normal University、HKUST(广州)、上海创新研究院,Yilin Jiang 等)把学生模拟重述为「对学习者下一个动作的第三人称预测」:先从学习者历史建学生模型(含 persona 先验),再对当前题目或导师话轮推断学习者状态,最后把状态编译成行为 harness(行为 harness:一份把推断状态落成对下一步动作硬约束的执行层),由它约束生成。主干为 Qwen3.5-397B,temperature 0.2,不做训练。 18
关键结果:
- 项目反应模拟(表 4):HACHIMI-II 在 XES3G5M、Eedi、ENEM 上与真实标签一致的配对比例为 75%、61%、63%,基线最高只有 53%、52%、48%;其 W1(模拟与真实学生准确率分布的一阶 Wasserstein 距离)为 0.039、0.046、0.169,比各数据集最强基线小 2.4–8.4 倍;学生排序 Spearman ρ 为 0.691、0.703、0.668。
- 能力泄漏的量化(表 6):ENEM 上真实最弱三分之一学生只答对 22%,基线却把它们模拟在 78–83%;HACHIMI-II 把三档模拟为 15%、39%、68%,真实值为 22%、39%、61%。
- 对话模拟(表 7):Eedi QATD2k 上 F1_err 0.561,是最强基线的 2.3 倍;完整复现真实错误(三结构标签全同)的比例 31.5%,为最强基线的 1.8 倍;Khan/CoMTA 上 Rec_struct 56.5%、F1_struct 0.346;基线在 82–93% 的真实错误轮上完全不犯错,HACHIMI-II 则在 52%(QATD2k)与 76%(CoMTA)的错误轮上出错。
- 消融(表 8):去掉状态推断后 ENEM 模拟均值从 0.384 升回 0.802(真实 0.394),W1 在三个项目反应数据集上放大 1.9–2.5 倍;去掉 harness 使 XES3G5M 的 W1 从 0.039 升到 0.056、ENEM 从 0.169 升到 0.257,Eedi QATD2k 的 F1_struct 从 0.339 降到 0.290;去掉 persona 先验把 XES3G5M 的 ρ 从 0.691 降到 0.603。 18
证据与局限:对话侧指标由单一判官 GPT-5.4 标注,判官是从五个候选模型里按与三名人工标注者的一致性选出的,各维度与人工多数标签的 Cohen κ 与人工间 Fleiss κ 相差不超过 0.06(表 5,功能标签 0.84 对 0.83,误差机制 0.66 对 0.60);数据集只有数学与自然科学,且每个对话轮都由真实前文预测,模拟学生自己的话不进入历史,多轮自演未评估;跨维度指标原文未报告种子数或置信区间。作者自陈学习者下一步还取决于记录之外的因素(如瞬时注意力)。 18
与目标研究线的连接点:与 A 线的 harness 一脉相承,可搬的是「别用角色提示去逼出行为,先把状态显式推出来、再编译成对下一步动作的约束」这条设计,以及它的消融口径:把状态推断与 harness 分开消融,就能分别量出「知识泄漏」与「约束缺失」各占多少。原文只给出所用数据集链接(https://github.com/Khan/tutoring-accuracy-dataset 实测 HTTP 200),未给出本方法代码入口。 18
结论建议:读 3.3–3.5(状态推断与 harness 编译)、表 4 与表 6、5.3 的消融;引用 F1_struct 这类结构保真度指标时要说明是单判官标注、无区间;若要复现,先确认自己场景里「被模拟对象的记录」是否足以推出状态,否则本方法没有抓手。 18
10. 免训练稀疏注意力 JSSA:128K 解码吞吐达全 KV 的 6.43 倍,LongBench 只差 0.67 分
Joint Subspace Sparse Attention for Efficient Long-Context Decoding · arXiv:2610.19026 · 邻近跟踪
研究问题与核心方法:长上下文解码的瓶颈是 KV 缓存(key-value cache,键值缓存)访存随序列长度线性增长;token 级稀疏注意力(每个解码步只选一部分上下文位置)本可比块级更细,却有两个具体障碍:低维打分丢掉排序所需的 query–key 结构,把散落选中的 token 聚成连续缓冲区又会吃掉省下的延迟。作者(Seoul National University,Jiwon Song 等)的 JSSA 对两处分别处理:选择侧把双线性分数误差写成可用边际上界逼近的目标,取闭式谱解学一个查询与键共享的低维子空间;执行侧实现免收集的索引注意力内核,在标准 GQA(grouped-query attention,分组查询注意力)KV 缓存布局下允许每个 KV 头保留各自的选择集。方法免训练,只做后置校准。 19
关键结果:
- LongBench 平均分(KV 预算 256 token,表 1):LLaMA-3.1-8B-Instruct 上 JSSA 49.16,全 KV 48.35,Loki 45.65;三个被测模型上与全 KV 的最大差距为 0.67 分,而单个基线没有跨架构的稳定最优。
- PG-19 困惑度(32K–128K 同密度预算,表 2):与全 KV 的最大差距 1.11;128K 时 LLaMA 上 JSSA 11.49、全 KV 10.38,对照 FASA 56.59、Loki 56.29。
- 推理(KV 预算 1,024 token,表 3):Qwen3-8B 的 AIME 2025 pass@1 为 68.33、生成长度为全 KV 的 1.07 倍,对照全 KV 69.58、FASA 60.42;Gemma4-26B-A4B-It 的 AIME 2025 为 86.67,FASA 73.75。
- 吞吐(单张 NVIDIA B200,128K 上下文):JSSA 最高达全 KV 的 1.51 倍(Qwen3-8B)、1.88 倍(Gemma4-26B-A4B-It)、6.43 倍(GLM-4.7-Flash)。
- 700B 规模(表 4):AIME 2025 上 JSSA 87.50 与模型原生 DSA(DeepSeek Sparse Attention,稀疏注意力)持平;GLM-5.2 的 GPQA-Diamond 上两者同为 90.91;解码吞吐达原生 DSA 的 96.1–99.2%。
- 消融(4.7 节):免收集执行相对「先收集再注意力」在 128K、batch 16 时把注意力阶段加速比从 25.35 倍提到 65.26 倍;用 32K 序列校准的打分基在 128K 评估时困惑度升到 16.05–18.31,而用 128K 校准的基为 11.31–11.48。 19
证据与局限:三种注意力架构(标准 GQA、混合局部/全局、MLA)都有覆盖,700B 规模用 DeepSeek-V3.1-Terminus / GLM-5.2 做后置校准对照;但精度类结果原文未报告种子数与置信区间,700B 上的差异作者自己定性为「可比」而非优势导向。引用风险:6.43 倍只出现在 GLM-4.7-Flash(MLA)的 128K 批量扫描里,两个 GQA 模型只有 1.51 倍与 1.88 倍,不能当成通用倍数;代码入口 https://github.com/jiwonsong-dev/JSSA 实测 HTTP 200,论文 HTML 全文入口 https://arxiv.org/html/2610.19026v1/ 实测 HTTP 200。 19
与目标研究线的连接点:它不在四条线上(研究问题是解码效率,不是长程任务的训练或评估),能搬走的是一件校准口径与一件执行选择:打分子空间的校准语料几乎不影响结果,校准长度却必须覆盖接近最大部署上下文(32K 校准在 128K 明显退化);以及「是否把选中项聚成连续缓冲区」会决定稀疏化后还剩多少加速。同节其它条目多在改生成或判定链路,这篇改的是承载长上下文的那一层,长程智能体跑长上下文时可以按这两个结论设默认值。 19
结论建议:读 4.2–4.6 与附录 A.4、A.5(校准构造与协议),只读吞吐数字的话看 4.5 节与图 4。引用时必须带模型、上下文长度、KV 预算与硬件条件;迁移到自己的服务栈前先确认自己的注意力实现属于 GQA 还是 MLA,因为两类收益差一个量级。 19
11. JetSpec++:草稿与验证流水线化,Qwen3-8B 上解码吞吐最高 7.45 倍、草稿侧每轮只暴露 0.66 ms
JetSpec++: Foresight Parallel Drafting with Self Refinements · arXiv:2610.19792 · 邻近跟踪
研究问题与核心方法:推测解码(speculative decoding:用小模型先并行草拟多个 token,再由目标模型一次验证)的收益由两个量决定——草稿被接受的比例,以及产出草稿的代价。作者(UC San Diego、UIUC、南京大学等,Zhaoxiang Feng 等)做算法与系统协同:块内自精修(训练草稿模型在同一个块内迭代纠正自己的并行预测)、块间前瞻草稿(当前块还在验证时就开始下一块)、以及草稿与验证流水线化(把草稿模型放到第二张 GPU,让它的时间藏在验证窗口里)。草稿块大小为 16(1 个锚点 + 15 个草稿位),另配一个适配器预测目标模型在草稿位上的状态。 20
关键结果:
- 服务吞吐(表 3,NVIDIA GB200、CUDA graph、temperature 0、验证预算 16、batch 1):Qwen3-8B 在 MATH-500 上 1361.1 tok/s,也就是相对自回归解码 7.45 倍,对照 DSpark 4.94 倍;GSM8K 上 6.30 倍对 DSpark 4.08 倍。草稿每轮真正暴露的时间为 0.61/0.66 ms,而 DSpark 为 3.76/3.80 ms;被预先备好结果的轮次占 92.9%/91.7%。
- 更大目标模型(Qwen3.8-27B,表 3):5.68 倍与 6.20 倍(对 DSpark 的 4.14 倍与 4.72 倍),即比 DSpark 快 1.37 倍与 1.31 倍。
- 接受长度 τ(每个验证轮次平均提交的 token 数,表 1,temperature 0、预算 16):J3-R3 配置在 GSM8K/MATH-500/AIME25/HumanEval/MBPP/LCB/MT-Bench 上为 9.78/11.04/10.49/8.79/8.24/8.95/5.29,对照全文认定的最强基线 DSpark 为 7.31/9.01/8.35/6.57/6.17/6.92/3.89。
- 消融(表 4、表 5):自精修本身把 τ 从 J0 到 J3 提高 0.42–1.27;每次上下文刷新加上锚点替换在 J1-R1 再补 0.92–1.55、J3-R3 补 1.72–2.97,而只刷新不加锚点替换最多加 0.84,即增益主要来自锚点替换;用全程加噪的块训练草稿模型时,J0 到 J3 的 τ 停在 4.36 完全不涨(本文训练法为 4.34→5.05)。 20
证据与局限:两个目标模型、七个基准,除 SSD 外的对照草稿模型都用在同一目标模型上重新生成的 80 万条序列训练;作者自陈局限只在系统优化侧(融合算子与通信还能再压草稿开销)。需要留意的口径问题:JetSpec++ 与 SSD 把草稿模型放到第二张 GPU,而 DSpark、DFlash 是单卡,因此 7.45 倍这类数字不是纯算法对比;表 3 的 tok/s 是 batch 1 单请求测量,原文未报告种子数或置信区间。代码与模型在 https://github.com/hao-ai-lab/JetSpec(实测 HTTP 200)。 20
与目标研究线的连接点:研究问题是解码加速,不在四条线上,可搬的是两条工程结论:其一,草稿模型要用「干净前缀 + 加噪后缀」的块来训练,否则它学不到自精修(全程加噪时 τ 完全不随迭代上升);其二,验证窗口是白给的时间,应该用来自精修与刷新目标状态,而不是让草稿侧干等。对要长时间跑解码的长程智能体,这两条直接决定吞吐。 20
结论建议:读 5.3–5.5 与附录 B.1(预草稿结果的评分与缓存规则)。引用 7.45 倍时必须带目标模型、基准、GPU 型号、batch 1 以及「草稿模型占用第二张卡」这一条件,不要写成通用加速比。 20
12. CircleClar:黑盒估计模型可用答案集,AmbigQA-HQ 上集合 F1 最高 74.09
What Is a Clarification? Estimating Model-Dependent Input Ambiguity · arXiv:2610.20052 · 邻近跟踪
研究问题与核心方法:论文把「歧义」拆成两层:世界歧义(world ambiguity,输入本身允许的所有解释)与模型歧义(model ambiguity,某个模型真正能作答的那些解释)。它用唯一性(uniqueness)、忠实性(faithfulness)、答案等价(answer equivalence)三条 desiderata 形式化自然语言澄清,并给出如下命题:这三条要求使「有效答案 ↔ 澄清等价类」一一对应,于是任何解释都可用答案、或用唯一表达它的澄清来代表。据此提出黑盒方法 CircleClar:沿「答案—澄清—答案」闭环做一致性检查来估计模型的可用答案集。作者 Jingqin Tang、Tim Tomov、Sebastian Schmidt、Dominik Fuchsgruber、Stephan Günnemann,单位为慕尼黑工业大学计算、信息与技术学院、慕尼黑数据科学研究所与慕尼黑机器学习中心;该文获 NeurIPS 2026 LP4FM(Linguistic Principles for Foundation Models)工作坊杰出论文与口头报告。21
关键结果:
- 可用答案集恢复:在 AmbigQA-HQ(100 题人工精修歧义集)上,CircleClar 的集合 F1 / 精确集合匹配(EM)为 Qwen3-4B 60.02±46.26 / 52.00、Qwen3-30B-A3B 64.88±40.76 / 49.00、GPT-5.4-mini 74.09±34.78 / 54.00、GPT-5.5 68.85±31.59 / 35.00,四个模型上都优于 ICE、Sampling-50(采样 50 次)与 1-Enumeration(一次枚举)三个基线(Table 1)。
- 同一方法在 1,000 题原版 AmbigQA 与 96 条 AMBROSIA 可执行 Text-to-SQL 歧义请求上整体领先;增益在小模型与精修集上最大,作者归因于原版 AmbigQA 标注噪声。
- 一致性检查主要提精度:从枚举得到的候选集到最终估计,几乎所有设置上宏精度上升、召回下降,但权衡幅度小于精度收益;模型越大精度增益越小(Figure 3)。
- 下游两用:用估计支持的基数(|M̂|≥2 视为该模型眼中的歧义)做歧义检测(AUROC),以及按支持(空=弃答、单答案=作答、多答案=澄清)选择回应动作(平衡准确率),CircleClar 在多数模型与数据集上最好;直接提示模型「要不要澄清」的两个基线相比通用提示几乎无稳定增益(Figure 4a、Figure 4b)。
- 论文未在正文给出 AUROC 与平衡准确率的具体数值(只出现在图中),可引用的具体数字集中在 Table 1 的集合 F1/EM。21
证据与局限:被评模型 4 个(Qwen3-4B、Qwen3-30B-A3B、GPT-5.4-mini、GPT-5.5),两个任务域(开放域 QA、可执行 Text-to-SQL);Table 1 报标准差,下游指标用 95% bootstrap 置信区间,原文未报告重复次数之外的种子数、也未做显著性检验。作者自陈局限:CircleClar 是精度导向估计器,召回受初始候选集限制;它只给出「支持的答案集合」而不给各解释的相对可能性;闭环一致只证明模型「可实现」该答案,不保证正确(模型可以稳定复现一个错误);评测还受歧义标注质量与覆盖度限制。引用风险:集合 F1 的标准差极大(如 46.26),单点数值不可当作稳定性能。该文原文未给出代码或数据入口(正文无仓库链接)。21
与目标研究线的连接点:归入第一节「harness、门控与运行期执行控制」,因为它的落点是运行时在「作答 / 澄清 / 弃答」之间切换的门控依据。与同节其它控制类工作的差异是:它不靠提示词直接问模型「歧义吗」,而是先重建模型可用答案集再把基数当门控信号。能搬走的一件东西是那条闭环:先生成候选答案,再让模型为每个候选生成唯一澄清,最后检查澄清能否把模型带回原答案,只有通过一致性的候选才进入可用集合——这条检查可直接插进自建 agent 的交互门控。21
结论建议:读 §4.1–§4.2(澄清的形式化与 CircleClar 回路)与 §5.2(下游用途),表看 Table 1;对第一节可迁移的是「用模型可用支持而非输入本身歧义」来定义门控阈值。引用时必须限定为四个被评模型与 QA / Text-to-SQL 两个域,并说明下游 AUROC、平衡准确率只有图示、无正文数值。21
二、记忆、上下文与证据构建
1. 零化记忆掉分不等于记忆有用:9 系统对照与 QASPER 的 19.98 对 12.54
Evaluating Compressed Memory: Dependence, Utility, and Content Benefit · arXiv:2610.19373 · 精读
研究问题与核心方法:本文作者来自济州国立大学与崇实大学。压缩记忆(compressed memory,把长文本编码成向量供大语言模型在生成时使用)的评估常用两个论据——去掉记忆后掉分、或比没有文档时分数更高,本文说明这两个论据都不足以证明「记忆里的文档内容有用」。作者把证据拆成三类比较:依赖(对已训练模型把记忆向量归零,Dependence,记 D)、效用(与另一套不接触记忆、单独训练的模型对比,Utility,记 U,用负对数似然之差表示)、内容收益(同一个记忆模块改成对所有文档输入同一个常量,Content benefit,记 C);NLL 是下一词负对数似然,单位 nats,越低越好。22
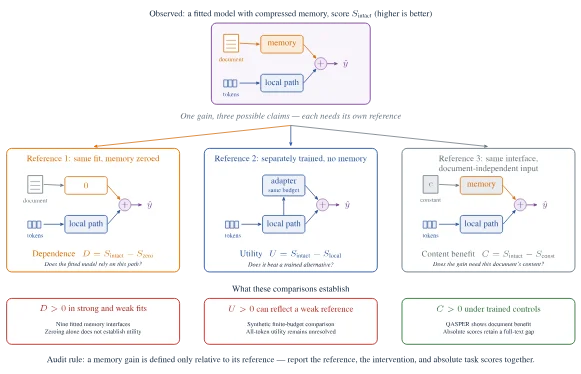
记忆收益的三种比较:归零测依赖、单独重训测效用、常量输入测内容收益(arXiv:2610.19373)
关键结果:
- 九个系统、每个三随机种子的对照(表 1):CCM、ICAE、Beacon、MemoryLLM、M+ 在合成故事任务上同时 D>0、U>0,U 落在 +1.804 到 +2.185 nats;StreamingLLM、H2O、xRAG、LoCoCo 则被归零伤害(D 为 +6.367 到 +7.690)却仍劣于各自的训练替代(U 为 −1.414 到 −0.219)。22
- QASPER 979 道题(表 3):文档输入的记忆投影器得 19.98 F1,同一架构输入常量得 12.54 F1;两者归零后同为 6.82,即归零造成的 13.16 分损失里有 5.73 分可由不含当前文档事实的学习型输入拿到;文档相对常量的优势为 +7.43 分(区间 [6.15,8.75])。22
- TriviaQA 11,313 道题(表 4、表 5):F1 在无文档时 19.38、换成他人问题的检索段(donor)24.78、本题检索段 29.88;donor 超过无文档 +5.40 F1,本题段再超过 donor +5.10;但 donor 的 Match 差为 −0.57([−1.50,0.37])不确定,EM 增益 +3.80([3.22,4.42])为正。22
- 词级探针(第 6 节,3,044 个 PG-19 重复词目标):文档输入 4.5088 NLL,对常量输入 4.8145、后缀输入 4.8254,内容收益 C=+0.3057([0.2530,0.3585])。22
- 合成边界任务(第 4.1 节):Llama-3.2-3B 上 D=0.4643、U=−0.1417 nats,但 512 个目标的准确率仅 14.78%,按训练频率猜为 18.55%,说明被比较的模型本身预测不可靠。22
证据与局限:多数比较给出三随机种子、配对自助法的 2.5–97.5 百分位区间,并对部分家族做多重比较校正;作者自陈每个收益都是相对指定对照模型与流程,不证明架构最优或收敛,也未匹配总预训练与推理成本,且 PG-19 可能已出现在 Pythia 的预训练数据里。入口实测:
https://arxiv.org/html/2610.19373v1/ 可取全文;原文未给出代码或数据入口。22与目标研究线的连接点:与同线「新记忆架构」类工作相反,它做的是评估审计,能直接搬走的两件东西是「常量输入对照」(把学习型输入本身的收益从文档内容收益里剥出来)与「配对报告绝对分数 + 对照模型名 + 生成与评分规则」的写法。22
结论建议:读第 3 节(三类比较的定义)、第 4 节表 1、第 5 节表 3–5;对记忆与上下文线可迁移「依赖/效用/内容收益」三段式与常量输入对照;引用时必须同时给出对照模型、绝对分数与评分口径,不能只说「去掉记忆掉 X 分」。22
2. 企业群聊记忆 EGCForest:三个基准平均分比最强基线高 4.77、8.59、12.61 点,检索 65 ms/查询
EGCForest: Structured Agent Memory Organization for Enterprise Group Chats · arXiv:2610.19836 · 精读
研究问题与核心方法:企业群聊(Slack、Teams 这类持久多人群组)里散落着任务进展、归属与决策依据,但要把聊天记录变成智能体能查询、且每条都指得回原始消息的外部记忆并不容易:检索增强生成(RAG)把消息当独立片段,记忆系统把对话压成事实或摘要,两者都丢掉多级会话结构(话题交错、回复链、跨频道跨时段的证据链)与说话人语境。EGCForest 用三棵互补森林组织同一份不可变消息日志——Channel 森林按频道做时间层次树,Actor 森林以参与者为中心并分「本人发言」与「被提及」两支,Artifact 森林围绕交付物组织其跨频道生命周期;Placement Map 让同一条消息在各视图里的位置指向同一条日志条目(不复制内容),稀疏 Bridges 用原生回复链与共享标识符连接不同消息。在线检索分四阶段:视图感知叶子召回(S1)、摘要补充(S2)、结构补全(S3)、预算内组装(S4)。23
关键结果:
- 三个基准的平均答对率都是最高:EverMemBench 54.72(最强基线 Dense 49.95,高 4.77 点)、GroupMemBench 55.70(最强基线 BM25 47.11,高 8.59 点)、Company 53.31(最强基线 BM25+Dense 40.70,高 12.61 点)。23
- 对记忆系统 MemOS:GroupMemBench 平均 55.70 对 35.70,Company 平均 53.31 对 32.46,后者相差 20.85 点,即摘要里「最高提升 20.85 个百分点」的来源。
- 检索消融(3,000 token 预算):P@20 从 S1 的 7.0 到完整方案 8.2、R@20 从 40.3 到 45.8、答对率从 45.4 到 53.3;其中 S3 把 P@20(前 20 条检索结果的精确率)从 7.1 抬到 8.0,S4 把答对率从 47.9 抬到 53.3。
- 视图消融:相对只用 Channel 视图(V1),加 Actor 视图(V2)在 Company 上把细分召回(Fine-grained Recall)一类题目提高 8.08 点、记忆感知(Memory Awareness)一类提高 5.32 点;全量 V4 比 V2 在 GroupMemBench 高 0.93 点、在 Company 高 3.37 点。
- 效率(GroupMemBench):构建 1842 s、存储 206 MB、检索 65 ms/查询;GraphRAG 为 38200 s、641 MB、2107 ms,Mem0 检索 15339 ms。
- 配置:答案模型按各基准官方约定用 GPT-5(GroupMemBench)与 GPT-4.1-mini(EverMemBench、Company),冻结的 Qwen3-Embedding-0.6B 编码器,分支因子 k=16。
证据与局限:Company 是企业内部数据,外部无法复现;两个公开集的重做需按各自官方协议。表 1 的金标答案由大模型判定,判官一致性与人评校验未报告,点估计也未给置信区间或种子数。检索精度本身受金标稀疏限制(每问平均 3.6 条金标消息,P@20 上界约 18%),引用 P/R 值时必须带这个前提;构建时间是全量重建,更大或更新更频繁的工作区只给了展望。机构为浙江大学区块链与数据安全全国重点实验室、杭州高新区(滨江)区块链与数据安全研究院与小红书;
https://arxiv.org/html/2610.19836v1/ 实测 HTTP 200,论文给出的代码入口 https://anonymous.4open.science/r/EGCForest-MAD12/ 用命令行实测返回 403、改用页面抓取仍被站点的人机校验(Cloudflare 挑战页)拦下,未能确认可访问。23与目标研究线的连接点:同节 SYNC 改的是「把事实写进模型隐状态」,这篇改的是「从原始对话里怎么取证、怎么编排进上下文」,两者在第 2 节「证据构建」这一环上可以叠用。最可搬的一件具体东西是把说话人维度做成独立视图(本人发言/被提及两支),而不是当元数据过滤条件——在任何多方对话记忆里都能直接复刻;其次是它的四阶段检索可以逐段替换进现有 pipeline 做消融。23
结论建议:读 §3.1(三视图与 Placement Map)、§4.2(表 1 主结果)、§4.4.2(表 2 阶段消融);要抄结构就抄 Actor 视图的两支划分。引用时必须限定:提升是在企业群聊问答这一代理指标上测的,Company 为企业内部数据,公开集上的增益只有 4.77–8.59 点,且全程没有显著性检验。23
3. MemDuet:3.5M token 上下文下提速 49.61×、输出 token 少 99.14%
MemDuet: Learning Dual-Process Memory for Long-Context Reasoning · arXiv:2610.19928 · 精读
研究问题与核心方法:长文档推理里,「递归记忆 agent」(把文档切块流式喂给模型、每块重写一份有界文本记忆)已经能处理超长输入,但控制决策要么困在串行循环里,要么作用在已经被压过的表示上,于是推理性能与推理成本始终绑在一起。MemDuet 借卡尼曼的双进程说法做分工:小模型 System 1 并行扫描原始 chunk(文本块),逐块判 Skip 还是 Update;大模型 System 2 按文档顺序验证候选块是否真值得更新,并生成新的记忆文本。训练分三段——System 1 监督热身、System 2 用 GRPO(Group Relative Policy Optimization,组相对策略优化)学验证与记忆改写、两者在任务奖励下联合优化;两套骨干权重冻结,只训练 LoRA(low-rank adaptation,低秩适配)适配器。24
关键结果:
- RULER-HQA(7K–3.5M token)上,MemDuet(7B)在 3.5M 处准确率 75.78%,比 RL-MemAgent 的 71.88% 高 3.90 个百分点,同时推理时间加速 49.61×、生成 token 减少 99.14%(Table 1)。
- 三个数据集按评估设置平均:相对 RL-MemAgent 端到端加速 9.74×、输出 token 减少 73.91%(摘要)。
- 短上下文上优势消失:7K 处 MemDuet 的相对加速只有 0.983×,作者归因于 System 1 扫描与跨系统协调的固定开销(Table 1、§4.2)。
- LongBench v2 上 Long 组选项准确率 30.00%、Ultra 组 29.29%,均为最高,加速 3.00× 与 8.03×;Short/Medium 组则低于 MemAgent(31.03 对 33.62;31.38 对 31.91)(Table 2)。
- 2WikiMultihopQA 的 sub-EM(normalized substring exact match,归一化子串精确匹配)在 14K、56K 落后 MemAgent,在 224K(61.72% 对 57.81%)与 896K(59.38% 对 57.03%)反超(Table 2)。
- 消融:去掉 draft–verify 或 state reevaluation 最多掉 3.90 个点,去掉 draft–verify 还把加速压到 9.89×;去掉 Stage II 最伤,112K 处准确率跌到 38.28%,448K 处 25.78%(Table 3)。
- 免训练迁移到专有 API(小模型当 System 1、强模型当 System 2 做接受/拒绝):延迟降 70.7–71.8%、成本降 58.2–59.9%,选项准确率变化不超过 0.60 个点(Table 6)。24
证据与局限:主结果把 RULER-HQA 的 128 题开发集留作测试集,样本量小;Table 1、Table 2 未给置信区间或显著性检验,种子数原文未报告,消融表只给 112K/448K/896K 三点上的准确率。作者自陈的局限包括:只在三个长上下文基准与 Qwen 系骨干上验证,短输入上选择性处理会丢掉有用证据,且 System 1 漏掉的证据 System 2 无法挽回;文档顺序更新也限制了并行执行的实际收益。24
与目标研究线的连接点:与同节的 Latent Compaction 都做长上下文记忆,但 MemDuet 压的是「记忆文本流」,Latent Compaction 压的是 KV 表示,两者正好回答「该在小模型侧过滤还是在 cache 侧压缩」。可以搬走的是两件具体东西:一是「小模型并行提案 + 大模型按序验证」的推测式门控(接受概率用 min(1,π_ver/π_sel) 再做独立抽样测试),二是三段式课程——先教「何时更新」、再教「如何更新」、最后联合对齐两个策略。24
结论建议:优先读 §3.3 三阶段训练与 Table 1、Table 3,再看 §4.3 的 System 1 骨干对比(0.8B 与 2B 的选择差异)。搬用要接受两个前提:目标上下文足够长(约 100K 以上加速才明显),且愿意为每对 backbone 跑完三段训练。引用时必须写明「RULER-HQA 128 题开发集、Qwen2.5-7B 作 System 2、无置信区间」,49.61× 与 99.14% 都是 MemDuet 相对 RL-MemAgent 的单点比值。24
4. 冻结主干只训 1% 外部权重:QuALITY 23.87%→40.51%、LongHealth 14.50%→40.75%
Titan-Llama: Retrofitting Pre-trained LLMs with External Neural Memory Modules · arXiv:2610.19210 · 值得扫读
研究问题与核心方法:Transformer 训练时靠注意力并行、推理时却要背负越来越大的 KV cache(键值缓存),本文给预训练好的注意力模型「后装」一套分层记忆:把 Llama-3.2-1B-Instruct 的前 4 层注意力换成块状分段注意力(blockwise attention,按固定 512 或 1024 个 token 切成一段),段内保留全保真注意力,更早的历史则压进定长的神经记忆模块(NMM,neural memory module,用测试时梯度更新参数的 MLP)。训练时主干冻结、只训外部模块,占总参数 1%;测试时用自监督的键值重建损失按 chunk 更新 NMM 的快权重。25
关键结果:
- 相对「分段注意力窗口」基线,在 Llama-3.2-1B-Instruct 上 QuALITY 准确率从 23.87% 升到 40.51%,LongHealth 从 14.50% 升到 40.75%(摘要与图 3 口径),训练只动占总参数 1% 的外部权重。25
- RULER 表 1:S-NIAH-1(pass-key 检索)在 8K/16K/32K 上均为 100.0,与全注意力持平,而 Mamba-2、Gated DeltaNet 在 32K 都掉到 26.0。25
- RULER 表 1 的「平均相对解码耗时」(8K、16K、32K 下一 token 延迟除以全注意力延迟)为 0.689,全注意力为 1.00,对照 Mamba-2 为 2.70、Gated DeltaNet 为 2.59。25
- 效率侧:在长 prompt 下 prefill 比全注意力快 20% 以上(改造 5 层时),中等上下文长度下解码快 37%,稳态解码显存低 24%;但部分改造的混合模型在 prefill 阶段的峰值显存高于全注意力(4.3 节与图 4)。25
- 最弱项是 RULER 表 2 的 Multi-value 检索:32K 时 53.0,对照全注意力 70.0;FWE/CWE(词频/常用词抽取)在 8K 时 44.9,反而高于全注意力的 39.2。25
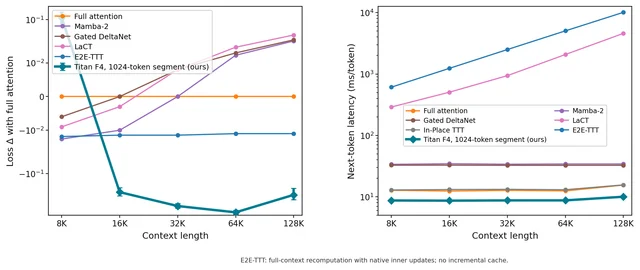
左:相对全注意力的每 token 负对数似然差,16K 以上为负;右:A100 单 token 解码延迟(arXiv:2610.19210)
证据与局限:实验只覆盖 Llama-3.2-1B-Instruct 一个模型、一种改造比例(前 4 层)与 16K 以内的训练长度,32K 以上的成绩下降作者归因于长度外推不足;种子数、重复次数与置信区间原文未报告,改造层数、chunk size 的对照放在附录 C,正文只给趋势。原文没有独立的 Limitations 章节,作者在讨论里把「无法解释记忆检索机制」「未做 NMM 规模扩展」列为开放问题。引用建议:数字可用于「KV 压缩能换到多少长文本能力」的定量参照,但它是单模型、单次训练的实测值,不要当作通用结论。25
与目标研究线的连接点:与同节 Cortex(arXiv:2610.20399)形成一组对照——Cortex 把上下文「写进参数」以摆脱上下文长度,Titan-Llama 则把历史 KV「写进外部定长状态」以摆脱缓存增长,两者都在回答「丢弃原始上下文后还剩多少能力」。可搬走的一件东西是它的评估切片方式:把「分段注意力基线」当作消去历史信息后的下界,再报告相对全注意力的每 token 负对数似然差(图 2 左),这样长上下文收益与推理成本能被同一条曲线读出,而不是只报一个准确率。25
结论建议:读 4.2 节(RULER 表 1、表 2)看 NMM 到底补回了哪类召回,读 4.3 节与附录 B 看推理实现与显存代价;对 A 线(记忆与上下文)可迁移的是「历史压缩 + 测试时更新」的接口设计,即冻结主干、只训外部模块的比例与注入方式。引用时必须限定:单模型、单次训练、训练长度 16K,效率数字来自单张 80GB A100 的特定配置。25
5. Mamba 检索瓶颈不在状态容量:只改 10 个目标词元的选择门,准确率可在近满与近零之间翻转
Beyond State Capacity: Why Retrieval Breaks in Mamba · arXiv:2610.19709 · 值得扫读
研究问题与核心方法:Mamba 类状态空间模型(SSM,state space model)在上下文内检索上落后 Transformer,通行解释是固定容量的循环状态会饱和丢信息。作者构造「查询优先」的检索设定(查询出现在上下文之前,此时状态容量不应是约束),用合成电话簿任务比较两个几乎相同的变体:未标记版与只在目标条目前置一个词「target」的标记版,并逐层追踪三条链路——循环状态里目标信息是否可解码、选择门 Δ(决定状态写入与衰减的、依赖词元的时间尺度)能否区分目标与干扰词元、以及门控值与性能的因果关系。作者为 Nir Yarden、Amit Ben-Artzy、Roy Schwartz,机构为 The Hebrew University of Jerusalem。26
关键结果:
- 只加一个局部相关性标记,就把 Nvidia-Mamba 在长电话簿上的准确率提高到两倍以上;两个变体仅差一个词(编码后 0–2 个词元),说明检索问题本身没变(§4.1、Appendix A.1)。26
- 因果干预:把未标记提示中目标信息那 10 个数字词元的选择门替换为标记版捕获的门值,准确率几乎追平标记版基线;反向替换则把标记版压低到未标记版水平;用真值下标对同一批 10 个词元的门做放大,可达近满准确率,缩小则性能急降(§5、Figure 3)。26
- 相关性信号是逐层浮现的:标记版里相关性在 1–2 次残差流更新内即可线性解码,未标记版要到近 10 层才趋于平台;而门向量还要再晚若干层才反映同一信号,两层解码起始点相差约 10 层(§6.1–6.2、Figure 4)。26
- 门控插补的收益集中在网络早中期;在同一段层里,表示已经能解码相关性,但门还没跟上,而真正决定检索的状态更新就发生在这段(§6.3、Figure 4c)。26
证据与局限:结论只基于两个 Mamba-2 检查点(Nvidia-Mamba 8B、56 层;Codestral-Mamba 7.3B、64 层),作者自陈开源 Mamba-3 只有小规模检查点、装不下该长上下文检索任务,故未验证;任务为合成电话簿,不是自然语言。评测口径清晰:每个长度–变体组合 500 个样本,Nvidia-Mamba 测长度 20–200、Codestral 测 20–500,默认分别为 150 与 400 条目,随机种子固定为 42,代码与数据生成脚本已开源。风险提示:正文的文字只给趋势与「翻倍以上」这类表述,准确率与 AUC 的具体数值只出现在图中,引用具体数字前必须回看 Figure 2–4;原文未报告多种子重复或区间。代码入口 https://github.com/schwartz-lab-NLP/beyond_state_capacity 实测 HTTP 200,实验数据在运行时按固定种子自动生成。26
与目标研究线的连接点:与同节记忆与上下文类条目互补——那里问「该不该检索」,这里问「检索失败卡在哪一层」。可搬走的一件东西是诊断方法:用一对只差一个相关性标记的反事实提示,把「信息是否到位」与「机制是否会用」分开,再用门控插补做必要性与充分性检验;这套做法可直接套到长程任务中检索关键层的定位上。26
结论建议:读 §3(诊断框架与数据集构造)、§5 与 §6(因果干预与时序结论)、Appendix A.3(探针与插补的完整口径)。对 A 线可迁移的是反事实提示 + 门控/表示插补这套定位手法,以及对混合架构里 SSM 部件价值的再评估;引用时必须限定为合成键值检索任务与两个 Mamba-2 检查点,且不要把「相关」当「因果」,因果结论只来自插补实验。26
6. 知识冲突下的单一引导方向:Llama-3.1-8B 的 RAG 答对率 62.0→82.0,四个模型族双向可控
Which Knowledge Should LLMs Trust? Uncovering a Generalizable Steering Direction Across Knowledge Conflicts · arXiv:2610.20067 · 值得扫读
研究问题与核心方法:检索证据、多轮记忆与明文规则提供的「语境知识」常与模型参数里的「参数知识」冲突,既有做法要么只在输入层写提示或结构化模板,要么做逐任务的注意力、稀疏自编码器特征或解码分布干预。作者问:知识选择能不能用一条低维方向来控制。做法是给每个问题配一对提示——clean 提示只有问题,conflict 提示是冲突段落加同一问题;按逐层残余流(residual stream,残差流)激活的角差最大处定位干预层,用两组激活的差均值取方向 v,然后在冲突提示的最后一个 token 上做 h′=h+αv(α>0 偏参数知识,α<0 偏语境知识)。27
关键结果:
- 域内源匹配率(四个指令微调模型,系数由验证集选定):NQ-Swap 上参数侧 Llama-3.1-8B-Instruct 33.7→56.8(+23.1 点)、Qwen3-8B 46.5→54.6、Gemma-2-9B-IT 32.8→80.9、Mistral-7B-Instruct-v0.3 42.2→59.0;语境侧同四个模型为 49.4→55.5、36.7→56.0、52.6→65.4、45.8→60.2。
- 跨数据集迁移(方向与系数只在 NQ-Swap 上选):ParaConflict 参数侧 15.8→83.9、语境侧 81.4→90.8;MemoTrap 为 66.7→75.4 与 30.0→53.3。
- 复杂任务(Llama-3.1-8B-Instruct):RAG 的 RGB 62.0±1.2→82.0±0.5、CRAG 23.7±0.8→25.8±1.0;记忆侧 LoCoMo 8.5±0.4→13.2±0.9、LoCoMo-Plus 32.7±1.1→36.7±1.3、LongMemEval 43.2±0.9→45.4±1.1;规则侧 IFEval 14.5±0.6→14.9±0.7。同表对照方法在 RGB 上为 ContextFocus 69.0、JUICE 62.0、CK-PLUG 71.0。
- 与「只是对上下文更敏感」的区分:冲突上下文对比强于对齐上下文与无关上下文(ParaConflict 参数侧 86.5 对 72.6 与 74.0),且三类上下文的对比方向余弦相似度只有 0.875–0.899,相近但不相同。
- 无冲突时的代价:同一组固定方向与系数下,原始答案准确率大多保持,但语境方向在 ParaConflict 上从 100.0 降到 85.5、MacNoise 降到 86.7。27
证据与局限:表 1 中随机方向对照是 10 个种子的均值±标准差,其余主表数字为点估计;表 7 的复杂任务给了 ±,但未说明重复次数与区间定义,也没有显著性检验,因此不宜自行对比两个方法的小差距。系数由验证集选定,附录 E 只验证邻近取值的稳定性。风险:这是推理期激活干预,不能写成「模型训练后自己就会更信任上下文」;复杂任务上记忆与规则类的提升只有 1–5 点量级。机构为北京大学(多媒体信息处理全国重点实验室、计算机学院、人工智能研究院)、南方科技大学与 YiXin-AI Lab(YIXIN,北京);
https://arxiv.org/html/2610.20067v1/ 实测 HTTP 200,代码入口 https://github.com/AheadOFpotato/knowledge_selection_steering 实测 HTTP 200。27与目标研究线的连接点:EGCForest 改的是证据怎么组织、SYNC 改的是事实怎么写入,这篇改的是模型在已有证据上的取舍旋钮,因此可以叠在前两者之上(先把证据写好,再用一条方向调它信谁)。最值得搬的不是方向本身而是它的对照设计:用「无上下文 vs 冲突上下文」的配对激活差取方向,再用「答案一致的对齐上下文」与「无关上下文」作匹配对照,把真正的知识冲突选择与通用的上下文敏感性分开。27
结论建议:读 §3.3(方向抽取与层选择)、§4.4(匹配对照表 4)、§5.2 与表 7(复杂任务迁移);要复现先看附录 B(干预位置与表示验证)与附录 E(强度敏感性)。引用时必须限定:增益来自推理期激活引导、系数由验证集选出,且它在 RAG 上的提升远大于记忆与规则任务。27
7. 50 次顺序事实编辑后恢复 88.9% 的上下文增益,同时保留 99.8% 非目标能力
Cortex: Consolidating Context into Parametric Memory · arXiv:2610.20399 · 值得扫读
研究问题与核心方法:上下文能提升大模型表现,但把上下文拿掉后这些增益往往消失;作者把「记忆巩固」(Memory Consolidation, MC)形式化为一个共同目标——把上下文带来的增益内化进参数,同时不破坏非目标能力。方法叫 Cortex:先生成前瞻性查询(prospective queries,预测这段上下文未来会被怎么用),再把上下文条件下的输出蒸馏成可合并的低秩或结构化前馈网络(FFN)更新。作者还搭了一个含五个任务族的测试台,分别在单次、批量与顺序更新下测量「巩固」与「保留」。28
关键结果:
- 摘要层:在 4B–120B 的稠密与混合专家(MoE)骨干、纯文本与多模态模型上,Cortex 在多数评测设置中位于「巩固–保留」的经验帕累托前沿(consolidation–retention Pareto frontier)。28
- 摘要层:在 14B 模型上做 50 次顺序事实编辑后,Cortex-Structural 找回 88.9% 的上下文带来增益,同时保留 99.8% 的原始非目标性能。28
- 摘要层:测试台覆盖五个任务族,并在单次、批量、顺序三类更新下分别测量巩固与保留。28
证据与局限:该文 arXiv 未提供 HTML 全文(实测 https://arxiv.org/html/2610.20399v1/ 返回 404,且只有 v1),以下只到摘要层:没有逐任务表格、没有基线与对照的设置细节、没有种子数或置信区间,「多数设置位于帕累托前沿」这一措辞无法逐条核验。三个数字(4B–120B、50 次编辑、88.9%/99.8%)只来自摘要,任何引用都应标注这一点。28
与目标研究线的连接点:与同节 Titan-Llama 是互补的两条路线:Titan-Llama 用外部定长状态留住历史 KV,Cortex 直接把上下文写进可合并的 FFN 增量,对应的是「上下文移除后的能力保留」这一评测问题。若拿到全文,最值得搬的是它的测试台设计——把「巩固」与「保留」拆成两个必须同时报告的轴,而不是只报上下文中或移除后的单点成绩。28
结论建议:在只到摘要层的前提下,这篇适合作为选题线索而非数字来源;先向作者索取全文或等 HTML 版上线,重点看它如何在 50 次顺序编辑下同时测巩固与保留、以及「可合并的低秩/结构化 FFN 更新」的具体合并与回滚机制。引用时必须写「仅摘要层」。28
8. Latent Compaction:32× 压缩下 RULER 96.7%,KVZip+ 只有 40.0%
Latent Compaction with Test-Time Training · arXiv:2610.20582 · 值得扫读
研究问题与核心方法:长上下文会把 KV cache(键值缓存,解码时缓存的历史注意力键值)撑大,压缩它必须在「下游问题还没来」时就保住文档信息。Latent Compaction 把某个文档的 KV cache 当成一份可训练参数(模型权重全程冻结),先用三条互补规则初始化:按 KVZip+ 重建分数全局选出的 preservers(保真条目)、由高教师注意力选出的 anchors(含第一个文档位置作为注意力汇)、用最远优先遍历在 key 空间撒开的 diversifiers。Stage 1 冻结 preservers,用教师查询拟合被压 cache 的注意力输出与 log-normalizer(对数归一化因子);Stage 2 冻结模型、用一份通用文档提示上的教师 rollout 做端到端蒸馏(分组 KL + 语言建模损失)。监督信号全部来自与下游问答无关的通用提示。29
关键结果:
- RULER 上 32× 压缩:Latent Compaction 准确率 96.7%,预算对齐的 KVZip+ 为 40.0%(摘要与 §4.3 Figure 1)。
- Phonebook Lookup(姓名→电话号检索)16× 压缩、Qwen3-1.7B:4K/8K/16K 上下文分别为 87.75%/83.75%/70.50%,均值 80.67%(Table 1)。
- 初始化消融:把 diversifiers 换成随机文档 KV,同样条件下均值只剩 20.50%;换成高斯随机向量 19.75%;换成文档开头 KV 43.50%;anchors 直接换成 KVZip+ 选择则均值 57.17%(Table 1)。
- 训练消融:去掉 Stage 2 均值从 80.67% 降到 70.67%,在 4K/8K/16K 上分别贡献 6.75/15.50/7.75 个点;去掉 Stage 1 更严重,均值跌到 13.92%(Table 2、Table 3)。
- 架构消融:去掉注意力偏置 b_cmp 只降 0.75/3.00/0.25 个点,但把归一化加权的混合写成两支等权平均会崩到 0.25% 以下,说明对数归一化因子是必需的(§4.8)。
- LongBench 上 0.6B/1.7B/4B 三个尺度在 16×、32× 强于 KVZip+,4× 时与 KVZip+ 接近;对文本摘要全程领先,但仍低于未压缩模型(§4.3)。
- 同流程在 Qwen3 的 0.6B/1.7B/4B/8B 与两个 MiniCPM5 模型上都能提升 Phonebook 检索(§4.4)。29
证据与局限:主实验用 Qwen3-1.7B、每文档只有 1 个 paired seed,原文未报告多种子重复或置信区间;消融集中在 Phonebook Lookup(每文档 20 个问题),跨基准泛化要自己补。作者明确写了两个关键限制:结果针对「逻辑 KV 对数预算」,不是实测显存节省或推理加速;逐文档拟合成本高,且 64× 以上压缩时各方法准确率都趋近 0,最强压缩比下文本摘要反而能赢过它。29
与目标研究线的连接点:与同节 MemDuet 是同一问题的两种切法(文本记忆 vs KV 记忆),可以互补使用。最值得搬走的是它的泄漏控制口径:整个准备阶段只用 480 条通用文档提示(24 类文档请求 × 20 种作答指令)做教师 rollout,不使用任何下游问题或答案,同时在 §3.1 里把「该给压缩 cache 多少注意力质量」显式参数化成偏置,这样后续换问题不用重训。29
结论建议:读 §3.2 初始化与预算分配、§4.5–4.8 消融、Figure 1;如果要复现,先看 §4.1 的训练配置(1000 + 1000 次更新、两个学习率)与 §4.7 关于训练时长的结论(继续加 Stage 2 会过拟合)。引用时必须限定 Qwen3-1.7B、16×/32× 与 logical KV-pair budget,不能写成实测的速度或显存收益。29
9. 9,263 份报告 macro-F1 0.831 对规则系统 0.721:抽取式证据锚定胜过模板化解释
Evidence-Anchored Overdose Death Prediction from Death Investigation Reports · arXiv:2610.19556 · 邻近跟踪
研究问题与核心方法:美国过量用药死亡的最终认定常滞后数月,作者改用案发数日内即可取得的死亡调查报告(现场调查员写的叙述报告)做「疑似过量」二分类,同时要求模型给出专家可复核的解释。他们比较两类解释:特征模板化陈述(feature verbalization,把专家定义的特征写成固定句子)与特征引导理由(feature-guided rationale,从报告里逐字抽出的证据句)。架构上也比较「先解释、再预测」的两段流水线(pipeline)与「一次生成解释和预测」的自解释模型(self-rationalizing);特征引导理由用 Clinical-ModernBERT 做句级多标签抽取,属于编码器模型,因此只能走流水线。
关键结果:
- 最佳配置是 Qwen3 加「报告 + 特征引导理由」输入的流水线(记作 I,RG→O):总体准确率 0.849、macro-F1 0.831;同一测试集上现行规则系统 SPOT 为准确率 0.736、macro-F1 0.721,论文表述为领先 15%。
- 特征引导理由在每一个数据划分上都优于特征模板化陈述,最好的特征引导模型比最好的模板化模型高 2.3% macro-F1。
- 只给理由不够:仅用理由预测(RG→O)明显差于直接从报告预测(I→O)与「报告 + 理由」(I,RG→O);只用二值特征训练逻辑回归只有 0.621 macro-F1,比对应最佳 Qwen3 低 33.8%,说明可用信号在证据文本里而不在特征取值里。
- 模板化解释下两段流水线优于自解释模型:Llama-3.1 为 0.812 对 0.779 macro-F1,Qwen3 为 0.776 对 0.768;作者指出这与 Wiegreffe 等人报告的相反趋势并不冲突,因为他们的流水线把理由单独喂给分类器,而本文同时给了报告。
- 专家反馈把句级特征抽取的总体 F1 从 0.602 提到 0.684(+13.6%),对稀缺特征增益最大(冰毒类 +105.3%、苯二氮类 +97.0%、处方药由 0.0000 升到 0.3243),对物理可观察的现场证据反而略有下降(注射器具 −3.8%、吸烟器具 −2.3%)。30
证据与局限:数据共 9,263 份报告,分特征标注分区(训练 4,483、验证 552、测试 545)与弱标注分区(2,927/374/382),64.7% 的报告被标为过量、39.8% 缺专家特征标注。特征引导理由没有人工金标,靠 MedGemma-27B、Llama-70B、Qwen3-30B 三名教师多数投票造银标,三位教师的总体一致性只有 κ=0.361(MedGemma–Llama 最高 0.500,Qwen3–Llama 最低 0.284),作者把低一致性当作「需要针对性修正」的信号。作者自陈局限:单一司法辖区、跨机构迁移性未知;银标噪声会系统性影响低一致性特征;专家反馈回路是事后评测而非在线部署。原文未报告重复次数、种子数与置信区间,也未给出代码或数据入口(报告属受保护的法医文书)。标题里的 0.831 与 0.721 取自同一测试集的同一次划分,「领先 15%」是论文的相对表述,不是百分点差。30
与目标研究线的连接点:它给的是一种「证据先于判断」的可搬走结构——把不可核验的自由生成解释换成能回溯到输入的原文片段,让下游同时看到原文与解释,专家在预测前修正解释。这跟本线常讨论的「中间产物是否可信、失败能否归因」直接互补;差别在于它的任务是一次性文书分类而不是长程任务,所以能迁移的是接口与对照设计(抽取式 vs 生成式解释、流水线 vs 联合生成),不是任务本身。30
结论建议:看 §3.2.2(教师–学生造标与抽取式理由)、表 2(五类配置的完整交叉对照)与表 3(专家反馈的逐特征增益),误差分析见 §5 的案例表 4,它把「聚合错误」与「抽取错误」分开,值得照抄这个分类。迁移时把「理由」限定为可回溯的原文片段,并让下游同时看到原文与理由。引用 0.831/0.721 时须说明这是单一辖区、单次数据划分的点估计,且该结论不适用于要求解释与预测联合生成的场景。30
10. 共享符号而非向量:跨五个模型族的新场景四答成功率 72.0–98.3%,比中层写入高 65.0–96.2 点
Share the Symbol, Not the Vector: Training-Free Fact Communication Across Language Models · arXiv:2610.19696 · 邻近跟踪
研究问题与核心方法:多智能体系统里让不同架构的模型交换内部状态,通常要在两者之间训一个翻译器,或假定它们结构兼容。SYNC(Symbol-Indexed Neural Communication,符号索引神经通信)改传符号:发送方从只有它能看到的私密描述里选词,只把 221 个共享词表符号的索引与对象归属发出去,从不看问题;接收方用自己拟合的词方向把这些符号写进隐状态。每个符号方向用一次前向即可得到——在同一位置把中性填充词 unknown 换成该词,在 12 个不含私密场景与问题的通用上下文上取接收方隐状态差的平均;写入落在预留的 unknown 槽位上(h′=h⁰+γ·(q_w/q_max)·d),写完的前缀缓存存下来,每个问题复制一份再回答。31
关键结果:
- 新场景四答成功率(572 条确认场景;四答成功=两个世界各两个问题全对,排除发送方与接收方为同一模型的格子):三个新发送方与九个来自五个模型族的新接收方组成的 25 对里,内部写成 72.0–98.3%。31
- 相对中层写入(相对深度 0.4/0.5/0.6):在 27B 以下的七个接收方上,早期写入(相对深度 0.2、γ=1)高出 65.0–96.2 点。
- 符号到方向的重指派对照(把符号指到别的符号的方向,字节数与编辑范数不变)在每个单元格最多留下 4.4%。
- 深度可预测性:无任务探针(只写两个符号问哪个对象带哪个符号)对九个新接收方的 45 个「接收方×深度」预测全部命中,与成功率的秩相关 0.89 [0.81, 0.96];只用深度拟合的规则平衡准确率低 0.13 [0.08, 0.19]。
- 冻结设置迁到新排版:六个接收方在 144 条场景上保持 89.6–100%,18 个非劣性检验 14 个通过、4 个不确定。
- 多 token 符号的地标任务(Countries):四个较大接收方 23.9–64.0%,无消息按构造为 0%,重指派后平均最多 5.0%,纯文本为 87.1–97.2%。
证据与局限:用成对 bootstrap(按场景族或 12 个父模板重采样)并做 Holm 校正,报的是两种聚类都覆盖的区间,主文表只给点估计。两个专家混合接收方(Qwen3.6-35B-A3B、Qwen3.5-122B-A10B)未通过预注册的缓存-完整检查,没有结果。作者自陈:新场景复用了问题形式与部分属性组合,开放词表、关系型事实与原文引用的 TipSheets 任务未测,发送方从自己隐状态读符号的版本表现很差,输入嵌入做法在单 token 符号上与拟合方向持平但多 token 符号未比。「免训练」指的是不更新模型参数,方向拟合仍要用接收方的前向。作者在讨论里还给出与纯文本的对照:等权重事实下内部写入没有稳定优势,纯文本在小接收方上最多领先 14.1 点,两个最大的接收方持平,而在 Countries 上纯文本领先 31.7–63.2 点(表 55)。风险:四答成功率是构造出来的复合指标,不能与常规准确率直接比;这篇 HTML 未给出作者与机构(原文未报告)。
https://arxiv.org/html/2610.19696v1/ 实测 HTTP 200,代码入口 https://github.com/LiXin97/SYNC 实测 HTTP 200。31与目标研究线的连接点:与同节 20067 的方向相反:20067 用一条方向调「信参数知识还是信上下文」,SYNC 提供的是「把外部事实写进模型状态」的通道;两者都作用在激活层,可以先写事实再调取舍。最可搬的一件是它的检验协议——交换一个属性、要求两个世界的两个属性都对(四答),再加上「无消息」条件使下界构造性地为 0——这可以搬到任何「注入的证据到底有没有被选择性使用」的问题上;配套结论是写得太深会让接收方用不了这些事实。31
结论建议:读 §2(方向拟合与事实写入)、§3(四答协议与全部对照)、§4.2 与 §4.3(深度扫描与探针);表 55 是主结果,表 56 是逐深度预测,表 57 是排版迁移与地标任务。引用时必须限定:收益在合成事实交换任务上,内部写入只有到 27B 以上才与纯文本持平,绝不能把 72.0–98.3% 当作我们下游任务的预期准确率。31
11. 级联双轨检索:延迟最高降 80.7 倍,ViDoRe 3 的 NDCG@5 以 58.85 超 SOTA 56.65
Cascaded Retrieval with Cross-Modal Query Refinement for Efficient Visual Document Search · arXiv:2610.20367 · 邻近跟踪
研究问题与核心方法:从版式复杂的文档页(表格、图、幻灯片、密集排版)里取证据时,多向量视觉检索效果好,但查询成本随语料规模增长,无法规模化。SCOUT 把成本拆到离线与在线两侧:离线用视觉语言模型为每个文档和每一页各生成一层摘要,把「文档级 + 页级」摘要拼接后编码成单向量;在线跑两条轨——Track A 先用轻量单向量视觉检索取 top-K,再只在 top-K 内做昂贵的多向量 MaxSim 重排,Track B 用摘要向量取 top-T,两轨并集进入跨模态查询精化(CMQR),用语义分数作软目标去精化视觉查询表示后再重排。 32
关键结果:
- 效率:SOTA 基线(ColEmbed-3B-v2)的单查询延迟为 4.5–32.8 秒,SCOUT 在四个基准上是 387–553 毫秒/查询,加速从 ViDoRe-HR 的 8.4 倍到 SlideVQA 的 80.7 倍,平均 28.8 倍。
- 质量:ViDoRe 3 上 NDCG@5 从 56.65 升到 58.85、NDCG@10 从 58.99 升到 61.31(平均提升 3.9%);ViDoSeek 上 NDCG@5 从 85.48 升到 87.41(+2.3%);REAL-MM-RAG 的四个子集里三个最好,增益最高 7.8%。
- 组件归因:把重排限制在 top-K 的子重排器相对只用父检索器提升 20.9%,CMQR 相对纯视觉级联最多再加 7.78 NDCG@10。 32
证据与局限:四个基准都只统计离线索引完成后的在线延迟(检索、重排、融合与精化),索引与摘要成本被排除在查询延迟之外;精度用 NDCG@5 与 NDCG@10 报告,但原文未报告方差、种子数或显著性检验。作者自陈局限:SCOUT 只能重排进入候选池的页面,两轨都排低的页面无法找回;语义轨依赖闭源视觉模型(Gemini 2.5 Flash)生成的摘要,可能漏写或错写页面内容;离线索引是一次性成本,需要为频繁更新的语料重建。原文未给出本方法的代码或数据入口,只列出被比较模型的公开仓库与权重页。 32
与目标研究线的连接点:对上下文与证据构建这条线,可迁移的是成本结构而非模型本身——把「昂贵算子只作用在固定大小的候选集上」与「在表示层用便宜轨的分数去改贵轨的查询,而不是在排序结果上做倒数排名融合」这两条合起来,查询成本就与语料规模解耦。做智能体的文档检索工具时,这直接决定「先粗取多少、再精排多少」这一档预算怎么设,也决定检索结果能否作为可回溯的证据页返回。 32
结论建议:读第 3.1 节的三段式架构与第 5.1 节的表 2、图 3(延迟分解)。若要做视觉文档检索或给智能体挂检索工具,可直接搬它的两段预算口径:父检索取 top-K 后只在这一集合内跑 MaxSim,并用另一条便宜轨的分数去改查询向量而不是改排名。引用时须限定加速倍数是在离线摘要与索引成本不计入查询延迟的口径下测得,且原文未报告统计显著性。 32
三、基准、环境与任务设计
1. CoffeeBench:12 个模型里只有 Gemini 2.5 Pro 一轮诊断准确率过 60%,状态追踪提示把超时压到 8% 以下
Can LLM Agents Efficiently Identify Appliance Faults? Insights From Diagnosing a Simulated Appliance · arXiv:2610.19291 · 精读
研究问题与核心方法:工业资产故障诊断不是一次问答:智能体要读传感器、做动作、在不确定中多轮迭代才能收敛,而既有工业基准多为考试式问答,只测准确率不测效率。作者(LMI Consulting、The George Washington University,Lucas H. McCabe 等)搭了 CoffeeBench——一台模拟的类咖啡机家电,八个传感器与若干动作经 MCP(Model Context Protocol,模型上下文协议)服务器暴露,智能体每轮提交一个故障假设、选一个动作、读一个传感器,命中或超时结束。指标除准确率(一轮 pass^1)外,用 pass^k 表示集体通过率,用 RMST(restricted mean survival time,受限平均生存时间,在 Kaplan–Meier 生存函数上积分)表示诊断效率,用 IDU(initial diagnostic uncertainty,初始诊断不确定性,即首轮故障假设分布的熵)表示起点不确定性。 33
关键结果:
- 12 个模型(9 个商用模型 + 3 个开放权重 Nemotron 12B/30B/120B)中,只有 Gemini 2.5 Pro 的一轮 pass^1 超过 60%(61.1%);Gemini 3.5 Flash 与 Claude 4.5 Sonnet 均为 56.8%;三个 Nemotron 模型分别为 12.6%、13.7%、14.7%(3.1 节图 2)。
- 诊断效率 RMST:Claude 4.5 Sonnet 1.74(95% CI 1.52–1.95)、Gemini 3.5 Flash 1.78(1.53–2.03)、Gemini 2.5 Pro 1.81(1.54–2.08),对照「理性猜测者」(随机猜并排除已错选项)的期望 5 轮;Nemotron 12B 为 5.21(4.54–5.89)、30B 为 6.78(6.06–7.51),比理性猜测还慢。
- 给 Nemotron 系列补上显式跟踪 episode 状态(已试与剩余诊断选项)的续写提示后,超时降到不足 8% 的 episode,诊断效率提升具统计显著性;此时 Nemotron 120B 与 Claude 4.5 Haiku 的效率差异已不可分辨(3.2 节图 3)。
- IDU 的预测力:高 IDU 的 episode 平均 4.85 轮(4.47–5.22)收敛,低 IDU 为 2.46 轮(2.31–2.60);超时占比 20.71%(16.12–25.94)对 3.26%(2.17–4.67);以 IDU 预测超时的 AUROC 为 0.821(0.785–0.857)。
- 解释健全度(独立判官按 0–100 打分):成功轮平均 87.15(86.16–88.14),比失败轮高 24% 以上;以健全度预测诊断是否正确 AUROC 为 0.820(0.803–0.837);把健全度做成提交前审议门槛后,Nemotron 120B 的首次提交准确率从 31.58% 升到 65.26%。 33
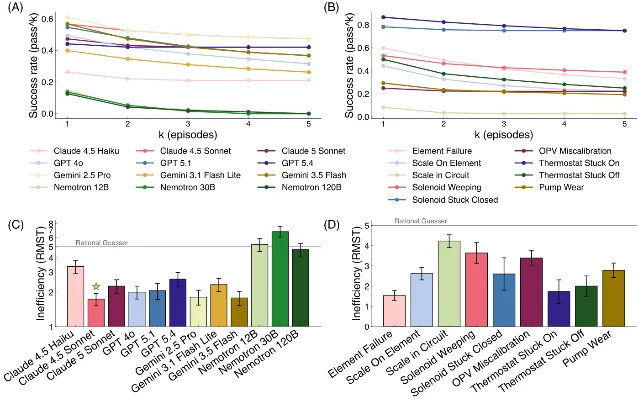
12 个模型的一轮 pass^1 成功率:只有 Gemini 2.5 Pro 越过 60%,三个 Nemotron 规模明显垫底(arXiv:2610.19291)
证据与局限:几乎所有对比都给了 95% 置信区间与显著性结论(超时占比用 Clopper-Pearson 精确区间、RMST 用 Wald 区间、多重比较用 Holm–Bonferroni 校正),是我这批八篇里统计口径最完整的一篇。局限是装置只有一台模拟家电、故障集固定,不能外推到真实产线;效率指标受超时右删失影响,作者用 RMST 处理并在 3.2 节明说;判官用 GPT-4.1(与被评模型不同族,但仍是单一判官)。每模型的 episode 总量与采样重复次数正文未汇总(协议细节见附录 A);原文未给出代码或数据入口(正文只列依赖软件的 Zenodo 记录),复现成本高。 33
与目标研究线的连接点:这是这批里最贴 A 线的一篇:多轮工具调用 + 环境交互 + 任务设计 + 评测口径合成在一个基准里。最值得搬走的是两件:其一,用 RMST 加置信区间而不是「平均轮数」来报告效率,超时会把朴素均值带偏;其二,「状态追踪提示」这个对照实验——先把 harness 该做而没做的事(已试与剩余选项写进上下文)补上,再看差距还剩多少,从而区分失败来自模型能力还是外壳缺失。后一手法可以直接搬到任何长程智能体评测,用来做失败归因。 33
结论建议:读 2.1–2.2(任务与指标定义)、3.1–3.3(三组结果),复现前查附录 A.3 的检验口径与 D.4、D.6 的判官与审议提示。引用时限定为「一台模拟家电、12 个模型、给定故障集」,不要把 61.1% 读成「LLM 能诊断设备故障」;soundness 审议带来的准确率提升需要额外判官调用(每 episode 最多 10 次尝试),引用时要一并给出这个成本。 33
2. J-tau:50/114/114 题三域日语工具智能体基准,修复 tau-bench 无效任务与最多虚高 64.6 分的聚合缺陷
J-tau: A Fully Localized Japanese Benchmark for Tool-Agent-User Interaction · arXiv:2610.19638 · 精读
研究问题与核心方法:SB Intuitions 公司与名古屋大学的 Chihiro Yano、Jun Hirako、Hiroaki Yamagiwa、Ryota Hirobuchi 把 tau-bench(让工具使用智能体与模拟用户对话完成客服任务的基准)本地化为日语 J-tau。流程五步:用 Gemini 3.1 Pro 翻译策略、工具定义、数据库与用户指令(提示里带领域术语表)→ 替换本地化实体(人名、地址、电话用 Faker 生成,金额按 1 USD = 150 JPY 折算、时区由 EST(北美东部时间)改 JST(日本时间))→ 每域三名专家人工复核 → 修题 → 修评分聚合。修题针对两类问题:本地化后变得不可解的题,以及原 tau-bench 里就存在的无效题(不可解,或参考答案不唯一);修评分则把空回复与工具调用 JSON 损坏这类「智能体自身错误」记为该模型的失败,而原基准会把这类试验重试至多三次、并把持续报错的试验从聚合中剔除,等于给易错模型加分。默认用户模拟器选 GLM-5.2-FP8,理由是它使评估结果失真最小 34
关键结果:
- 规模与题量:J-tau 覆盖 airline 50 题、retail 114 题、telecom 114 题;airline 由未改动 41、仅修无效题 4、兼有本地化与修题 2、仅本地化改动 3 构成,retail 为 80/12/0/22(附录 D 表 12,四类相加等于该域总数) 34
- 两处缺陷的规模:原文称原 tau-bench 的无效题在 airline 与 retail 约占 10%,评分聚合缺陷最多可为单个模型虚高 64.6 分(引言、5.1 节) 34
- 修题效果(表 2,三次试验均值):在高分模型被修复的题组上 J-tau 明显高于只修了评分的 tau*(tau* 指只施加同一评分修复、其余仍为原 tau-bench 的对照版本),例如 airline 的 6 道修复题上 GPT-5.6 Sol 为 77.8 对 27.8;在未改动题组上 J-tau 反而低于 tau*,同一模型为 85.4 对 95.1,作者解释为同一批题在日语下的表现低于英语 34
- 修评分效果:Qwen3.5-4B 在 airline、retail、telecom 分别有 75/150、56/342、38/342 次试验以空回复结束,原基准仍给它 93.3、85.3、98.7,而 J-tau 上为 24.0±2.0、6.7±2.2、33.6±9.9(脚注 8、表 1) 34
- 与纯机翻流水线对比(表 4,失败试验按 agent/user/eval 归因):retail 域 GLM-5.2-FP8 因评估框架导致的失败为 54 例,而 J-tau 上只有 4 例;另在 telecom 域 Kimi-K3 因 JSON 输出指令被去掉后从表 1 的水平升到 84.8±2.7(Δ+17.8,表 30) 34
- 主结果(三次试验均值±标准差,表 1):闭源最高是 Claude Fable 5,airline 90.7±1.2、retail 84.5±4.1、telecom 99.4±0.5;开源权重最高是 GLM-5.2-FP8,89.3±4.6、81.6±1.8、98.2±1.5 34
证据与局限:每题跑三次并报告标准差,这一点比多数交互式智能体基准扎实;但用户模拟器的选择本身会大幅改变分数(附录 I 表 31 显示不同候选模拟器的用户错误率与致命错误率差异很大,例如 GLM-5.2-FP8 对 Qwen3.5-9B 时为 53.7% 与 18.3%,换成 Qwen3.5-397B-A17B-FP8 则是 65.6% 与 34.3%)。作者自陈局限包括:只有日语、不含 tau-bench 最新版的 banking_knowledge 域、Faker 生成的地址并不真实、可解性核验只依赖 GLM-5.2-FP8 因此可能残留未发现的无效题、retail 域由用户模拟器导致的失败多于对照基准、以及原基准要求 JSON 输出的指令在日语下被某些模型过度执行从而可能低估其分数。引用风险:J-tau 与 tau-bench 的分数不可跨基准直接对比,表 2 的修复题组在某些模型上出现负差值,说明「修复」并不保证分数一律上升。入口实测:原文 HTML(v1)、基准仓库 https://github.com/sbintuitions/j-tau-bench 与实体生成工具 https://github.com/joke2k/faker 均返回 HTTP 200 34
与目标研究线的连接点:与同节其他基准与环境类论文相比,它的可搬之物有两件:一是把「评分聚合缺陷」与「无效题」当作基准缺陷来审计并公开修复的做法,二是按失败归因(agent/user/eval)分解试验轨迹,用来判断一个低分是模型能力问题还是环境问题。对做长程工具智能体评测的团队,这套归因分解和「错误该记给谁」的口径可以直接搬进自己的 harness;它同时补上了 tau 系列基准在非英语语言上的空白,与同节讨论语言迁移的基准工作互补 34
结论建议:先看表 1(三域主结果)与表 12(题量与改动类型),再看表 2、表 3、表 4 依次对应修题、修评分与机翻对比三种效果;附录 F、G 的对话案例值得扫一眼,能看出「用户模拟器失真」与「模型能力不足」失败在文本上长什么样。引用具体数字时必须同时带上「三次试验」与「GLM-5.2-FP8 作模拟器」这两个条件 34
3. Interlock:类型化完成图合成任务,AutomationBench 通过率 +4.00–4.50 个百分点
Interlock: From Local Correctness to Task Completion in Long-Horizon Agents · arXiv:2610.19686 · 精读
研究问题与核心方法:长程智能体的典型失败不是单步做错,而是「局部正确、整体不完整」:证据、决策与必须落地的下游效果之间的关系没被维持。Interlock 把任务表示成类型化完成图(typed completion graph):grounding(接地)边把公开证据连到它支持的决策,coupling(耦合)超边施加跨组件的联合约束,realization(落地)边把决策连到所有必须反映它的记录、产物或状态;再把同一张图编译成可重置工作区、公开请求与私有评分细则(rubric),经 source-coverage(要求是否在生成中存活)与 public-input(细则是否被解题者可见材料支持)两道复核,运行时由 agent-as-judge(能查看产物并写、跑校验脚本的判官)筛出满足全部强制要求的轨迹。作者 Linji Hao、Yanji He、Zihan Wang、Hansi Yang、Jiayuan Zhang、Hongyan Hao、Qi Gu、Yan Feng、Han Wu,单位为北京大学、香港科技大学(广州)、清华大学与美团。4
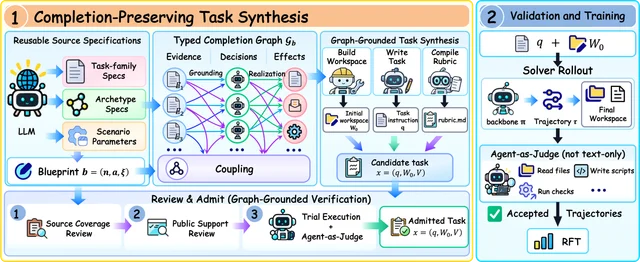
Interlock 总览:同一张完成图如何编译成工作区、公开请求与私有评分细则(arXiv:2610.19686)
关键结果:
- 三个外部基准(AutomationBench 600 题、JobBench Main 与 Easy 各 65 题、Harvey LAB 1,251 题)上,各主干用自己通过判官筛选的轨迹做 SFT 后:Qwen3.6-27B 相对原检查点 AutomationBench 任务通过率 +4.00 个百分点、JobBench Main/Easy 加权分 +4.35/+6.64、Harvey LAB 判据通过率 +3.89 个百分点;Qwen3.6-35B-A3B 对应为 +4.50、+3.20/+4.31、+4.16(Table 1,同表 ClawGym-SFT 反而低于原检查点)。
- 判官形态是独立的增益来源:同一批 rollout、同一判官主干与同一监督预算下,文本级 LLM-as-judge 过滤得到 13.17/15.14/56.53/75.28(AutomationBench、JobBench Main、JobBench Easy、Harvey LAB),可执行校验的 agent-as-judge 过滤得到 18.33/18.46/61.10/77.85,判官输出从约 11.03k 升到 12.28k tokens/rollout(+11.3%)(Table 2)。
- 合成任务确实拉长执行链:32,370 条正常终止轨迹平均 84,293 tokens、27.63 个助手轮次、42.10 次工具调用,对照 ClawGym 已发布轨迹的 24,497 条为 14,940 tokens、11.92 轮、14.76 次(倍数 5.64×、2.32×、2.85×),中位数同样分离(轮次 25 对 9,工具调用 40 对 12)(§4.5)。
- 语料与训练规模:保留 3,278 个任务,覆盖 128 个领域、484 个任务族;每任务每主干 5 次尝试,共 32,780 次尝试(其中 32,370 次正常终止),每个主干取自己 8,957 条被接受轨迹、约 154M 监督 tokens。
- 领域覆盖消融:固定 8,957 条轨迹,训练领域数从 16、32、64 增到 128 时,四个指标逐档上升,128 域为最高(Figure 3)。4
证据与局限:样本量清楚(3,278 任务 × 5 尝试 × 2 主干),但每格只训练一次,原文未报告种子数、置信区间或显著性检验,也未见独立的局限小节;评测实例被排除在合成与 RFT 之外(这点做得好),但 JobBench 与 Harvey LAB 由 GPT-5.5 判分,判官与被评对象同族。引用风险:把「+4.00 个百分点」当通用提升会过头,它是两代 Qwen3.6 主干、单次 SFT、特定判官口径下的结果。入口实测:全文页 https://arxiv.org/html/2610.19686v1/ 实测 HTTP 200,原文未给出代码或数据入口(正文只出现被引基准 Harvey LAB 的仓库链接)。4
与目标研究线的连接点:直接命中 A 线与 B 线的交叉处:合成环境/任务属于基准与环境设计,而「用自己通过判官筛选的轨迹做 SFT」是轨迹训练数据配方(B 线自采样—过滤套路)。与既有任务合成工作的差异是组织单位不同:它不以工具依赖、技能图或任务复杂度组织生成,而以「完成关系」(证据→决策→下游效果)为合成约束,并把判官必须能执行校验脚本写成硬条件。能搬走的一件东西:把「同一张图编译出工作区 + 公开请求 + 私有细则」的三件套接口,以及 agent-as-judge 与文本判官的对照设计(Table 2)直接搬进自建任务流水线。4
结论建议:先读 §3(类型化完成图与两道复核)与 §4.4(判官形态对照),表看 Table 1、Table 2;对 A 线可迁移的是任务合成约束的表示方式,对 B 线可迁移的是「自采样 + 可执行校验过滤」的准入规则。引用时必须限定为 Qwen3.6-27B / 35B-A3B 两主干、GPT-5.5 判分、单次训练的结果,并说明无种子与显著性报告。4
4. 孟加拉语约束规划基准:1,000 题含 256 道不可行,11 个配置中 7 个低于 25.6% 基线
BANGLAPLAN: A Benchmark for Constraint-Based Planning and Decision-Making in Bangla · arXiv:2610.19704 · 值得扫读
研究问题与核心方法:孟加拉语缺少在显式约束下评测规划与决策的基准。BanglaPLAN 含 1,000 道用孟加拉语原生撰写、取材于孟加拉国日常与机构场景的题,覆盖 10 个任务族(资格判定、办事流程、预约、出行、排班、排序、资源分配、采购、物流、应急),每族 10 类、每类 10 题。每题由硬约束、按字典序优化的目标与打破平局的规则确定唯一标准答案,作答必须是单元素 JSON 数组:可行时给出结构化计划,不可行时回 is_feasible:false;评分是规范化后的精确匹配(EM,exact match),不用 LLM 评委,因此不引入评委效度问题。 35
关键结果:
- 数据构成:744 道可行、256 道不可行;按结构难度(绑定约束与支撑事实总数 k,k≤10 为易、10<k≤20 为中、k>20 为难)分为 300 易、300 中、400 难;提示覆盖日常、正式、口语、孟加拉语-英语混合四种语域,答案有分配、分类、匹配、有序步骤、排序、路线、日程、选择八种结构(Table 1、§3.1)。 35
- 11 个模型配置零样本差距极大:GPT-6.1 Sol 精确匹配 98.7%、GPT-6 Luna 85.1%、Qwen3.5-27B(开启思考)80.3% 使用测试时推理;直接作答的配置最高只有 30.9%,且 11 个里有 7 个低于「永远回答不可行」这条 25.6% 的常数基线(Table 2)。 35
- 同权重加思考比扩规模更划算:Qwen3.5 从 2B 到 27B 精确匹配 3.3%→30.9%;在 27B 权重上开启思考再涨 49.4 个百分点到 80.3%,计划准确率从 19.5% 升到 76.9%,错误弃答从 41.0% 降到 2.0%(§5.1)。 35
- 难度主要打击「造计划」而非「识别不可行」:GPT-6 Luna 的计划准确率从易到难由 96.0% 降到 69.0%,Qwen3.5-27B(思考)从 91.6% 降到 59.6%;而 GPT-6.1 Sol 的不可行判定只从 100.0% 降到 99.0%,Qwen3.5-27B(思考)从 96.0% 降到 90.3%(Figure 4、§5.2)。 35
- 需要构造的答案最难、格式错误是主要漏分项:Qwen3.5-27B(思考)在分类题上 99.0%,在日程题上只有 68.6%;Gemma 3 12B 有 70.3% 的输出不合格式,即使只看格式合规的输出准确率也只有 28.6%(Table 2、§5.2)。 35
- 换英文提示与金答案微调都没真正提升规划:GPT-6.1 Sol 孟加拉语 98.7% 对英文 97.4%;Qwen3.5-2B/4B/9B 换英文只涨 2.5、8.3、4.7 个精确匹配点,且 Qwen3.5-4B 的不可行召回从 30.9% 升到 62.5% 的代价是错误弃答从 16.5% 升到 48.3%;用金答案微调 Qwen3.5-2B(834 训练/166 留出,其中 42 题不可行)后精确匹配 2.4%→27.1%、格式错误 18.7%→0、不可行召回 0→95.2%,但计划准确率只从 3.2% 到 4.0%,模型对 90.9% 的题回答不可行(Tables 3、4)。 35
证据与局限:构造过程为五名孟加拉语母语者(三人起草、两人独立验证)加 100 题试点,最后由 Claude Opus 5.5 在看不到金答案的情况下重解全部题,只当作复核信号,人工裁定最终题面与答案。原文未报告显著性检验或置信区间,模型比较均为点估计。作者自陈局限:只扎根孟加拉国,机构与惯例未必迁移到其他孟加拉语地区;每题被目标与平局规则钉成唯一答案,牺牲开放性,且精确匹配对近似正确的计划不给分;难度标签按约束计数得出,未与人的解题耗时核对;Claude 参与了场景起草与一致性检查,题目可能带其风格倾向;所有模型只做零样本单提示评测;微调只用了一个 2B 模型与一套配方,负结果只是提示性的。 35
与目标研究线的连接点:与同节其他基准相比,BanglaPLAN 的价值在评测口径而非任务新颖:它把「可行计划质量」与「不可行识别」拆开上报,并给出「永远回答不可行」的常数基线,因此高分不能被标签分布解释;这一点与 OpenTWBench 的「分数里有多少来自仪器」是同一类警觉。可搬走的一件东西是近边界不可行题的制作方式:只改一个绑定量、时间窗、容量或政策规则,直到无可行解,并要求放开该指定约束后恢复可行(minimally infeasible),这条设计能直接用在自家 agent 任务集的失配样本上。 35
结论建议:先看 §3.1(任务定义与 JSON 契约)与 §3.2–3.3(六阶段构造、难度定义),再看 Table 2 与 Figure 4。迁移到自家任务集时建议照抄三件事:不可行判定与计划准确率分栏、常数基线、格式错误单列一列;引用时写清是孟加拉语零样本单提示结果。 35
5. 给事件加描述并改用符号标签:LLM 平均 F1 最高 0.290,强于最强非 LLM 基线的 0.231
Can LLMs Access their World Knowledge for Event Prediction? · arXiv:2610.19021 · 邻近跟踪
研究问题与核心方法:时序事件预测(temporal point process,TPP:把事件编码成「类型+时间戳」的序列,预测下一个事件的类型与时间)上,LLM 常打不过专用小模型;本文主张这不是预训练知识取不出来,而是接口没设计好。作者做了两个接口改动:给每个事件补一段自然语言描述,把事件从 (type, time) 扩成 (type, time, description);并把预测目标的标签从有语义的事件名(push、merge)换成无语义的符号名(type_0、type_1),以消除「语义偏置」——模型仅凭标签名之间的预训练共现关系就猜下一个事件。作者来自 RBC Borealis 与阿尔伯塔大学。36
关键结果:
- 自建基准 DescribeEvent 含 148,185 个事件、1,940 条序列、7 个数据集、6 个领域,时间粒度从分钟到周;描述的信息量用可恢复性 RR(recoverability:只给描述、让验证器 LLM 猜事件类型的准确率)衡量,7 个数据集为 0.602(Wikipedia)到 0.992(NBA),对应随机猜测基线 0.111 到 0.167。36
- 七数据集平均口径下,描述+符号标签最好:Qwen3.5-27B 平均 F1 0.290(MAE 5.248),Gemini-2.5 为 0.289;语义标签且不给描述时 Gemini-2.5 为 0.261;六个非 LLM 基线的每数据集最优者在平均口径上是 KNN 的 0.231。36
- 符号标签的收益集中在稀有事件:在 46 个事件类型上,符号标签相对语义标签的精度增益与类型频率负相关(Pearson r=−0.51,p≈0.0003),而召回几乎不随频率变化(r=−0.01)。36
- 描述是否有益与推理能力挂钩而非模型大小:受益组在 GPQA Diamond 上均 ≥77%、在 HLE 上 ≥7%;GPT-4o Mini 与 Llama-3.1-8B 只有 42.6%/25.9%(GPQA Diamond)与 4.0%/5%(HLE),加描述后平均 F1 反而下降。36
- 描述对非 LLM 基线的作用不一致:给 NHP、RMTPP、MLP 加 Sentence-BERT 描述嵌入时常改善 MAE,却不稳定改善 F1(原文第 5.5 节)。36
证据与局限:LLM 逐步预测、全部四种设置共用同一提示协议(含一次简短推理),baseline 用每条序列前 80%–90% 事件训练、其余自回归评测;评测模型为闭源 GPT-5 Mini、Grok-4.1 Fast、Gemini-2.5 Flash 与开源 Qwen3.5-4B/9B/27B、Llama-3-8B、GPT-4o-mini。原文未报告随机种子、重复次数或置信区间,推理能力与描述收益之间只给相关系数。作者自陈:DescribeEvent 只作评测、未用于微调;能力相关只是相关、因果机制待查;LLM 单次预测是秒级而专用模型是数十毫秒级。36
与目标研究线的连接点:与本单元 2610.19476 是同一类控制思想的两种实现:那篇用「静音/去选项」查加成来自哪里,这篇用「随机标签置换」查模型是否真在读输入。可搬走的一件是它的描述粒度主张——既有数据集至多每序列一条描述,而本文给每个事件一条,并配两个诊断(可恢复性 RR 与描述—标签余弦相似度)表明描述确实带信息而不是复述标签名。36
结论建议:要搬接口做法读第 3 节(两个接口选择)与第 5.4 节(稀有事件精度增益);要搬评测口径读第 4.3 节(RR 与相似度两个诊断)与附录 B.1(推理能力对照表)。引用时必须限定:这是单轮 next-event 预测的离线评测,增益来自接口与标签命名,不能读成「LLM 已具备事件预测的世界知识」;F1 是跨标签宏平均且绝对值很低(0.29 量级),不可与别的 F1 横向比较。36
6. 1,249 段对话、4,833 个样本:18 个 VLM 的候选集 F1 最高 0.649,召回是短板
Recognizing Dialogue Ambiguity via Candidate Set Visual Grounding · arXiv:2610.19723 · 邻近跟踪
研究问题与核心方法:真实交互里一句含糊的话在给定上下文下往往无法唯一确定指代物,而已有的交互式视觉定位(visual grounding,把语言表达式对应到图中物体)研究都假设上下文足够锁定唯一目标。作者提出候选集视觉定位(CSVG)任务与 CandVG 基准:在第 i 轮对话上下文下,要求模型给出初始含糊话语仍可能指代的所有物体包围框(BBox);当上下文缩到唯一目标时即退化为常规的上下文感知视觉定位(CVG)。评测用匈牙利算法按 IoU≥0.5 做一对一匹配后算精确率、召回率与 F1,CVG 用 Acc@0.5,且同一段对话的每个累积上下文都算一个独立评测样本。
关键结果:
- CandVG 由 1,249 段对话、4,833 个评测样本构成,其中 CVG 单目标样本 2,549 个、CSVG 多目标样本 2,284 个;标注质量高(两对标注者的 CVG Acc 为 0.962/0.971,CSVG F1 为 0.943/0.935)。
- 在 18 个视觉语言模型(VLM)、六个系列上,CVG 准确率随规模单调上升(Qwen3.5 27B 最高 0.819),但 CSVG 的 F1 不随规模稳定提升:Qwen3 VL 2B 只有 0.271,最高是 GPT-5.6 Terra 与 GPT-5.6 Luna 的 0.649。
- 视觉定位能力强并不等于 CSVG 强:这些模型在 RefCOCOg 上准确率很高(Qwen3.5 27B 为 0.917),在 CandVG 上普遍更低;CSVG 在两个基准上都存在精确率—召回率缺口,且 CandVG 上缺口更大,随规模上升的是精确率而召回率不升。
- 把金标候选集直接喂给模型能普遍提高 CSVG 的 F1(InternVL3.5 系列增益最大),说明候选生成是一个瓶颈;加面向 CSVG 的任务指令(TAI)只对 27B 以上模型有效(Qwen3 VL 召回 +0.097、Qwen3.5 +0.087),对 4B 模型效果不一致,且不能稳定改善精确率。
- 追踪同一批 1,234 段对话的前三轮,失败模式分两种:Qwen3.5 27B 第一轮就过早收敛到很小的集合(召回低),Qwen3 VL 4B 则选出接近金标规模的集合却不随上下文收缩(第 2 到第 3 轮反而增加),GPT-5.6 Luna 整体最贴近金标更新,但前两轮偏少、第三轮偏多。37
证据与局限:18 个模型与六个系列可按正文核对——InternVL3.5、Qwen3 VL、Qwen3.5 各 4 个,GPT-5.6 两个,加上基于 Qwen3 VL 后训练的具身推理系列 RynnBrain 与 CosmosReason2 各 2 个。作者自陈局限:数据构建自既有单目标 CVG 数据集,图像域、对话风格与歧义模式都受限,且多数对话的候选集是单调收缩、突然改指代物的情形很少;只考虑静态图与包围框,覆盖不了视角依赖与非语言线索;开源模型只到 38B,未评 Gemini 等系列;改进手段只试了推理期指令,未试 self-reflection 等。评测全部为零样本,原文未报告多次采样的方差或种子。37
与目标研究线的连接点:与本单元其它评测类工作的差别是它评「集合值答案」,并把同一段对话的不同轮次切成不同样本,看的是候选集随上下文累积的更新轨迹——这正是把长程交互拆成逐轮可测口径的一种做法。能搬走的是两件事:用匈牙利匹配后算 P/R/F1 来评多目标集合输出;以及「提供金标候选集」这个对照条件,把生成失败与选择失败分离开。失败模式的命名(过早收敛/不收缩)也可以直接用于检查自己系统在多轮澄清中的行为。37
结论建议:看 §3.2(集合匹配指标定义)、§5.2–5.4 与 §6.1(三轮追踪)。若要做长程交互或多轮澄清的评测,可照搬「金标候选集条件」作为诊断对照,并把提前收敛与不收缩当成两个分别检查的失败模式。引用 0.649 与 0.271 时须写明这是零样本、只输出包围框、输出上限 15 个框的设置;代码与数据入口为 https://github.com/OU-sigma-dis/candvg 与 https://huggingface.co/datasets/SInadumi/CandVG(两者实测均 HTTP 200)。37
四、评测口径、判官效度与基准审计
1. 17 个模型上的诊断:提示控制权在 336B–630B token 间易主,四选准确率约 1.5T token 才越随机线,精确生成最晚到约 3.6T
From Copying to Composition: How Language Models Develop In-Context Learning · arXiv:2610.19113 · 精读
研究问题与核心方法:上下文学习(in-context learning,ICL,模型不改参数、只靠提示里的指令与示例临时改变行为)的既有评测只看答对没有,但同一个正确答案可能来自「照抄最近的示例」,也可能来自「把散在提示里的定义组合起来」,准确率分不出这两种。作者造了一个受控诊断任务:每个提示为两个二元特征域各分配 4 个假词词尾,示范 4 种组合中的 3 种,再问未示出的组合,于是「按定义组合」(rule-consistent)与「照抄最近示例」给出不同答案;用 P(copy)(复制答案在复制候选与正确候选两者上的归一化概率)与四选准确率分别度量,其中 margin 记为 m=log p_r−log p_c(p_r、p_c 分别是正确与复制候选的概率)。用阻断提示中某一段的注意力(blocking,挡住答案位置对该片段的注意力但不删词)与激活替换(activation patching,把一个词位置的内部表示换成另一个提示的表示后继续前向)定位控制权来自哪段提示,并把阻断最近示例词尾与阻断请求值两者对 m 影响的大小之差记为 D——D 为正表示答案仍由最近示例词尾主导。38
关键结果:
- 17 个模型按 P(copy) 分成三档:6 个把两候选概率中至少 .70 给复制答案,8 个至多 .30,3 个落在两个阈值之间;复制偏好与「能不能在没有候选时写出正确形式」同序,高复制组正确形式四选排名第一的比例低、精确生成也低。38
- 在 OLMo-2-7B 的预训练 checkpoint(训练中途存档)序列上,请求值(提示里被问到的那个特征值)对答案的控制在 336B 到 630B token 之间超过最近示例的词尾;四选准确率约在 1.5T token 才越过 .25 的随机水平,重测条目为 1.79T;精确生成未示出组合最晚到约 3.6T。
- 16 个已发布训练序列里,Marin-8B、Comma-v0.1-1T、SmolLM3-3B、OLMo-3-7B 结束时的四选准确率在阈值之上,Apertus 只达到部分,11 个仍在阈值之下。
- 继续预训练实验:把 SmolLM2-1.7B 续训流里的 3% 换成「先定义词尾、再查询」的合成文档后,P(copy) 在前 50M token 内从 .82 降到接近 0、精确生成升到 .56,同规模普通续训仍以复制为主;留出文本损失变化小于 .001,而控制失衡量 D 变化超过 20 nats(自然对数单位)。
- 定义练习微调:SmolLM2-1.7B 在 5700 万 token 的改写练习上微调后,把标签名换成自造符号的准确率在 TREC 上升 17.6 点、DBpedia 上升 17.2 点、Yahoo 上升 3.7 点,而同一诊断任务上的 P(copy) 基本不变。
证据与局限:核心证据是一个受控任务(另有短代码与南克丘亚语两种编码版本),作者自陈这是单一诊断,ICL 的其它行为是否同样顺序未测;表 2 的最终分数基于两套条目、共 320 条,多数跨模型比较只给点估计,未报告种子数、区间与显著性检验。训练实验最大到 8B,合成文档与诊断同格式,因此作者自己把迁移称为「格式绑定」的迁移。风险:P(copy) 的 .70/.30 分档是作者自定阈值,引用时不要把分档当作效应量。机构为 Scale AI 与亚利桑那大学;
https://arxiv.org/html/2610.19113v1/ 实测 HTTP 200,原文未给出代码或数据入口(附录 O 称代码、逐条结果与分析计划随补充 PDF 发布,正文未给 URL)。38与目标研究线的连接点:它落到 A 线的「上下文」这一环,但改的是评测方式而不是上下文本身:把「答对没有」拆成四个可分别测的环节——谁在控制答案、偏好哪个候选、无候选时能不能构造、训练出的改变能不能迁移。与同节其它工作互补:EGCForest 与 SYNC 关心证据怎么被组织与写进去,这篇关心写进去之后模型到底用没用、用的是哪一段。最可搬的一件是给控制权归因的做法:阻断提示中单个片段(最近示例词尾 vs 请求值),比较 margin 变化的大小与方向。38
结论建议:先读 §3(任务构造与 D、P(copy) 的定义)、§4(17 模型分档与阻断结果)、§6.2(合成文档与「全部示出」对照);表 2 给全部模型分数,表 1 给阈值穿越的拟合值与区间,表 3 给每个模型的逐片段阻断效果。引用时必须限定:这些发展顺序是在单一受控诊断上得到的,不能写成「所有 ICL 都按此顺序发展」;合成文档的效果是格式绑定的,且训练实验只到 8B。38
2. 8 个评估维度、26 个 2B 模型与 264 组设置:答案概率指标在 2B 模型上胜率 93%
How to Evaluate When You Don't Know How to Evaluate? Choosing Reliable Setups for Base Language Model Benchmarking · arXiv:2610.19185 · 精读
研究问题与核心方法:基础语言模型(base LM,未经指令微调的预训练模型)的基准测试长期缺少「评估设置该怎么选」的依据,作者把这项选择当成可量化的元问题处理。他们把评估设置拆成 8 个方面——示例数(shots)、提示模板(prompts)、分数重标定(score rescaling)、跨任务聚合(cross-task aggregation),以及分类任务专用的任务表述(formulation,完形填空 CF/多选 MCF/混合)、对数概率归一化(char/PMI/无)、度量(准确率 Acc/条件答案概率 CondProb/答案概率 AnsProb),生成任务专用的解码方式(贪心/随机采样)。三个元度量(meta-measure:单调性、非随机性、排名一致性)分别衡量「得分是否随训练进度上升」「是否明显远离随机基线」「相对排名是否在相邻检查点间稳定」,三者按百分位排名取等权平均,得到每种设置的总体分。
关键结果:
- 在 26 个单语 2B 参数模型、四种语言(挪威语、芬兰语、法语、西班牙语)共 80 个任务上,答案概率(AnsProb,把正确选项的归一化分数取指数、不与其它选项比较)在 2B 模型上赢下 93% 的两两比较,是最有信息量的度量;准确率(Acc)最差,因为离散分数只增加方差而不给足够信号。
- 5 次示例(5-shot)优于 0 次示例,胜率 70%,在单调性维度最明显(84%);任务表述上完形填空(CF)被三种方法一致选中,胜率 76%,而多选表述(MCF)信息量最低。
- 用各维度胜率最高的选项独立拼装出的分层配方,在四种语言共用的 264 组设置里排第 6,总体分 0.93,而最优完整设置是 0.95,两者只差是否使用 min-max 重标定;前五名完整设置在高影响维度上完全一致。
- 换成三个更大模型(≥7B)后结论分化:答案概率胜率从 93% 降到 63%,准确率从 6% 升到 37%(其单调性从 9% 升到 53%),CF 胜率从 76% 降到 61%、MCF 从 20% 升到 38%;字符归一化与 5 次示例仍被一致选中。39
六个挪威语 2B 模型在两种评估设置下的平均分随训练推进的曲线,末端排名几乎相反(arXiv:2610.19185)
证据与局限:作者自陈三个元度量只是「有用信号」的代理而非模型质量的效度证明,一个设置可以在三项上都高却只测到很窄的能力;三者等权平均是人为选择,换权重可能改变结论。覆盖面上,四种欧洲语言各用一套基准、可用选项不同,任务表述变体只有芬兰语和挪威语有,条件答案概率与生成任务的比较只在挪威语上做;更大模型只有三个(OLMo 3 7B、Apertus 8B、Prelude 9B),排名一致性依赖很少的比较,作者称跨规模差异「提示性而非结论性」。原文未报告随机种子数与置信区间,也未给出代码仓库,可直接复查的链接只有 Prelude 9B 的模型页 https://huggingface.co/openeurollm/prelude(实测 HTTP 200)。39
与目标研究线的连接点:同线上的榜单审计类工作通常质疑基准本身是否有效,这篇不问基准、只问设置,并把「从检查点轨迹里能否读出信号」变成三个可计算的量。可搬走的就是这套元度量口径:单调性用检查点训练进度与得分的 Spearman 秩相关再跨模型平均,非随机性用最优模型末态与随机基线的差除以末段 5 个检查点的标准差(所以与重标定尺度无关),排名一致性用窗口内相邻排名的 Kendall τ 平均。39
结论建议:优先读 §3.2(三个元度量的定义)与 §4.1 的高影响/低影响/情境依赖三档配方,表 2 直接给出三种选择方法在几种语言上的一致程度。对做预训练数据选择或检查点筛选的人,可先固定「多次提示 + 5 次示例 + 答案概率 + 字符归一化」,把任务表述与度量留待模型规模上升后重评。引用时必须限定:结论建立在 2B 与 7B–9B 两档、四种欧洲语言及各自基准之上,是对评估设置的信息量排序,不是对评估设置正确性的排序。39
3. 基准审计:把答案换成等义变体,DROP 精确匹配从 100.0% 掉到 33.3%;16 个资源无一记录目标用户
Whose Data, Whose Benchmark? A User-Centric Framework for Auditing Evaluation Resources · arXiv:2610.19268 · 精读
研究问题与核心方法:基准分数掩盖了「谁的惯例在定义成功」。本文提出以用户为中心的审计框架,区分来源用户(source users:贡献基准内容与判断的人)与目标用户(target users:分数本应服务的人),并把 7 个维度(语言与地区惯例、地理可见度、社会经济结构、来源用户语境、目标用户假设、标注者可见度、评分归一化)落到可核查的证据上。作者来自阿尔伯塔大学,审计对象是 11 个文本基准与 5 个图像文本资源,共 16 个资源。40
关键结果:
- 美国中心惯例占匹配信号的 62.4%(MedQA)到 94.4%(TruthfulQA);惯例覆盖率(含被审惯例的题目占比)差异极大:WinoGrande 5.97%、TruthfulQA 7.59%,而 MedQA 65.85%、DROP 78.08%;排除拼写类匹配后仍有 8 个基准呈美国中心多数(TruthfulQA 90.5%、GSM8K 83.3%、SVAMP 80.0%、DROP 72.3%)。40
- 配对评分实验(等义变体对原始答案,均用官方评分器):DROP 官方精确匹配(EM)从 100.0% 降到 33.3%,配对变化 −66.7 个百分点(95% CI [−92.3, −36.4],12 对);token 级 F1 从 100.0% 到 77.2%(−22.8,95% CI [−41.6, −5.2]);其中 6 组拼写对平均损失 45.7 F1 分(95% CI [−72.2, −23.0])。40
- TruthfulQA 对同类变体更宽容:BLEU 与 ROUGE-1 的正确性判定维持 97.0%、ROUGE-Lsum 维持 100.0%,ROUGE-2 从 100.0% 到 93.9%(−6.1,95% CI [−16.1, 0.0],区间含 0);但连续相似度下降明显——最高正确参考 BLEU 相似度 97.0 到 69.2(−27.7,95% CI [−34.0, −21.9]),ROUGE-1 相似度 100.0 到 88.9(−11.1,95% CI [−13.5, −9.0])。40
- 地理可见度集中:美国在 DataComp1B 13.55%、WIT English 14.59%、RedCaps 21.18%、COYO-700M 16.30% 居首,CC12M 例外(冰岛 10.24%、美国 9.99%);前三国家合计 26.8%–37.6%,欧洲、北美与大洋洲合计 60.9%–76.5%;国家可见度与世行 GDP 份额强关联(平均 Pearson r=0.780、Spearman ρ=0.778,平均 R²=0.614)。40
- 文档审计:16 个资源全部操作化了来源用户语境,但无一操作化目标用户语境;标注者信息 56.2% 提及、0% 操作化;地区假设 25.0% 提及、6.2% 操作化;评分归一化 75.0% 提及、68.8% 操作化;来源/地理元数据 37.5% 提及、31.2% 操作化。40
证据与局限:配对差异用 10,000 次按问题聚类的 bootstrap 重采样(seed 2026)给出 95% 百分位区间,DROP 与 TruthfulQA 分别使用官方 EM/F1 与 BLEU/ROUGE 参考排序流程;作者明写地理与经济的关联是描述性的、不是因果。局限:地理可见度只统计文本中的显式国家指称(不含图像地理定位);配对样本很小(DROP 12 对、TruthfulQA 33 对),单项变体即可移动区间;审计范围是 11 个文本基准与 5 个图像文本资源。引用时不要把 33.3% 当成 DROP 的真实模型水平,它是构造配对上的评分器敏感性。40
与目标研究线的连接点:与本单元 2610.19476 互补:后者用静音/去选项控制表明涨点有相当一部分不依赖音频、而来自文本捷径,本文用等义变体控制表明分数还取决于评分器是否承认合法变体,两篇合起来是「分数不可直接搬用」的两类证据。可搬走的一件:把「来源用户 vs 目标用户」当两个独立字段写进数据卡,并按第 7 节的六个文档字段与附录 D 模板自查。40
结论建议:要改自家评测口径读第 4.2 节(配对评分实验)与附录 A.6/A.7(构造与完整结果);要写数据卡读第 6 节与附录 D。引用时必须限定:这是资源层面的审计、不含模型行为;DROP 与 TruthfulQA 的下降是构造配对上的评分器敏感性,不是模型端准确率。40
4. PersEvalBench:403 个多轮场景、9 类受控个性化错误,个性化不足人类识别 94.4%、最强判官仅 63.9%
PersEvalBench: Can LLM Evaluators Judge Contextually Appropriate Use of Persona Information? · arXiv:2610.19314 · 精读
研究问题与核心方法:个性化助手越来越多地用 LLM 判官来评估,但判官能否判断「用户历史信息在这轮响应里用得恰不恰当」很少被检验。作者提出 PersEvalBench:403 个多轮(multi-episode)场景,每个场景配一条 Right 响应与一条受控错误响应(合计 806 条),错误覆盖三个家族、九个子类型——个性化不足(under-personalization,该用的偏好没用)、个性化过度(over-personalization,用了不该用的信息)、状态误用(misapplied-state,用了已过期或越界的状态)。对话历史决定先前信息应当延续、跨域迁移还是失效,对应再入(re-entry,174 条)、跨域迁移(166 条)、越界(out-of-scope,63 条)三类关系;判官须给出 Right/Under/Over 三分类判定,并在适用时给出子类型。41
关键结果:
- 主设定(Full 上下文 + 端到端)下,错误识别率(ERR,Error Recognition Rate,在错误响应上统计、被判成对应错误类即算识别)为 Kimi K2.5 66.5%、GLM-5 64.3%、DeepSeek-V3.2 62.5%、Qwen3-32B 32.0%;误报率(FAR,False Alarm Rate,把 Right 响应误判成 Under 或 Over 的比例)对应为 24.6%、12.2%、10.9%、2.5%。41
- 恒判「Over」的常数基线整体 ERR 67.7%、FAR 100%,已不低于任何真实判官——只用 ERR 会奖励乱报错误,必须与 FAR 一起看。41
- 个性化不足的识别最差:在 100 个共享人评场景上(其中 under 型 36 条),人类均值 94.4%,最强的已报告判官 Kimi K2.5 只有 63.9%;整体三者平均是人类 76.0% 对 Kimi 68.0%。41
- 判官常常方向判反:26.6% 的个性化不足响应被标成 Over,即把「没遵守适用的偏好」读成「用了不适用的偏好」。41
- 把证据指出来帮助很小:Kimi 从 Full 的 66.5% 升到「全历史+高亮相关轮次」的 70.5%,GLM 64.3%→65.8%,DeepSeek 62.5%→65.0%;给最近六轮的 ERR 反而高于给全历史(Kimi 70.7% 对 66.5%),说明难点不在「找得到」,而在「判断这条信息该起什么作用」。41
- 相关的历史被抽掉时判官崩得最厉害:五判官均值在「全历史减去相关历史」下 ERR 60.8%、FAR 67.6%(几乎见错就报);抽掉无关上下文则 ERR 62.8%、FAR 14.4%,成对准确率 60.8%(50 个场景)。41
证据与局限:基准由 Claude Sonnet 4.6 生成、经人类质量核验(456 个规格中 403 个保留),错误类型经过确认;统计以点估计为主,原文未见 Fisher 检验或区间。被评测的判官共五个(Claude Opus 4.6、Kimi K2.5、GLM-5、DeepSeek-V3.2、Qwen3-32B),但 Claude Opus 4.6 的结果因发布限制未公开,读者看到的是四个。作者在伦理声明中明确:场景是合成的、仅英语、任务型,结果不能用来认证部署中的判官可靠性,也不能推广到真实用户、其他语言或文化相关的个性化规范。人评子集只有 100 个场景,under 型 36 条,样本量小。41
与目标研究线的连接点:本篇把「长程记忆/上下文」的评测从助手侧搬到判官侧,正好补 A 线里「我们自己用 LLM 判官评长程行为」的效度缺口,与同节侧重基准审计的条目互补。可搬走的具体一件:ERR 必须配 FAR,并且要加一个「恒判某一类错误」的常数基线——PersEvalBench 上该基线的整体 ERR(67.7%)高于除 Kimi 外的所有真实判官,这个对照方式可以直接搬到任何三分类判官评测里。41
结论建议:读 §3.2 的九个子类型定义(决定你能不能复用它的错误分类)、§5.1 与表 3/表 4、§5.2 的「加高亮/减上下文」对照。对 A 线可迁移的是判官协议与基线设计;引用时必须说明被判官是四个已公开模型、任务为合成多轮场景,且 under-personalization 方向反转(26.6%)是主要失效模式。原文未给出公开代码或数据入口。41
5. 回复可用性评测:480 条智能体回复 54% 不可用,256 个回复点上加要求消息从 0.52 降到 0.43
Measuring and Reducing Unusable Replies of LLM Agents · arXiv:2610.19659 · 精读
研究问题与核心方法:长程智能体跑完几十次工具调用后,只把最后一条消息交给提需求的人(requester),现有评测只看任务是否完成、报告是否忠实,不看这条「回复」(reply)能不能被读懂。作者把这一属性定义为回复可用性,用三条判据判定失败:回复只能靠请求者见过的内容(请求者上下文,记作 R)解释、回复使用请求者的语言、回复确实回答了请求;解释回复中某个表达需要 R 里没有的信息,就记为一个「信息缺口」(information gap)。度量用「读者模型」(reader model):它站在请求者位置,先就回复生成请求者会问的问题,再依次在回复上下文、整条回复、R 中找答案并必须引用原文,找不到即为缺口。作者单位包括华东师范大学、香港科技大学(广州)与上海人工智能实验室。 3
关键结果:
- 在 4 个项目(2 个研究、2 个商业)× 8 个模型(7 个家族,含 Claude Opus 5、GPT-5.6 Sol、DeepSeek V4 系等)共 32 组多会话协作、480 条回复上,258 条失败,失败率 0.54(即 54%);单模型失败率从 0.30(GPT-5.6 Sol)到 0.82(Claude Opus 5),8 个模型里 7 个至少 48%(Fig. 3a)。3
- 失败构成:258 条失败回复中 222 条至少含一个信息缺口、73 条没有回答请求、17 条语言不对(一条回复可同时满足多条);全库 46% 的回复至少有一个缺口,114 条含两个以上缺口,带缺口的回复平均 2.1 个、最多十个(§5.1)。3
- 缺口类型(占 258 条失败回复的比例,Table 3):指向未见材料 46.1%、智能体自造的标签 42.2%、未解释的领域术语 23.6%、缺背景 1.6%;自造标签里 53.0% 最早出现在智能体自己写的文件、工具调用参数或跨会话加载的项目记忆中(Fig. 3c)。3
- 失败集中在汇报工作最多的回复:回复前有 3 轮以上工具调用的失败率 0.70,没有工具调用的 0.48,1–2 轮的 0.40(Fig. 3b)。3
- 干预一(在回复点追加一条列明「回复必须包含什么」的要求消息):干预实验换了一套总体——从同一批协作里另取 256 个回复点,每个点把回复按各条件重写一遍,其默认条件失败率为 0.52,与全部 480 条回复上的 0.54 不是同一个总体;在此基准上把失败率从 0.52 降到 0.43,降幅 0.098[0.030, 0.168];只提醒「读者没看过你的工作」的 notice 条件为 0.50,降幅 0.027[−0.052, 0.112],与默认条件不可区分(Table 4)。3
- 干预二(用 DeepSeek V4 Pro 在回复后重写一遍,仍在这 256 个回复点上):失败率从 0.52 降到 0.36,降幅 0.168[0.101, 0.242];5 位标注者在 83 个回复点上盲评同一回复与其改写,失败比例从 0.52 降到 0.32,差 0.201[0.095, 0.321](Fig. 4a/4b)。3
- 忠实度同步改善:检查器(checker,对照工作记录列出错误与遗漏)给出的「错误+遗漏」每条默认 1.41,加要求后 1.07,改写后 1.13(§6.2、§6.3)。3
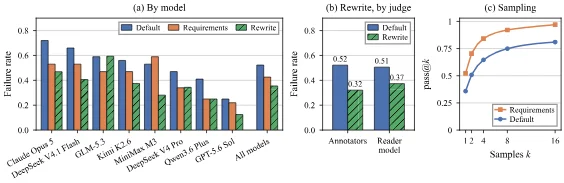
默认条件、加一句要求消息、二次模型改写三种条件下按模型比较的回复失败率(arXiv:2610.19659)
证据与局限:读者模型用 Gemini 3 Flash(preview);在 300 条回复的 gold set(人工标注的标准集)上,它相对 5 位标注者多数标签的 Cohen's κ(一致性系数)=0.60、准确率 82%,落在单个标注者之间的一致性区间内(标注者彼此 Fleiss κ=0.63),缺口分类器与两位标注者在 100 个缺口上平均 κ=0.68。写作条件与改写的比较都在同一回复点内配对,并给按协作重采样的 95% bootstrap 区间。原文自陈局限:协作是脚本化的(因此所有模型面对同样请求);读者模型只对「懂该领域但没看过智能体工作」这一种请求者画像做过验证;采样分析只覆盖一个开放权重模型(Qwen3.6-35B-A3B)。引用风险:失败率与缺口全部由 LLM 判官判定,虽与人类标注者比过一致性,但换判官模型是否稳定未测;0.54 是 480 条回复的合并率,0.52/0.43/0.36 是 256 个回复点上重写实验的比率,两者不能混用。3
与目标研究线的连接点:A 线一直缺一个「交回给人看的报告能不能用」的口径,这篇把评测对象从环境终态与轨迹忠实度挪到请求者视角,做法与同节的判官效度问题一致:先与人类标注者对齐一致性,再给区间。能搬走的具体东西有两件:一是那条要求消息的清单(先回答最新问题、做了什么、结果、下一步、证据在哪里可查、用户没见过的名字都要定义);二是「按回复前工具轮次分桶看失败率」的切分方式,可直接用来判断自家长程任务里哪一类回复最容易翻车。3
结论建议:先读 §3.2(读者模型的两步问答协议)与 §6.1–6.3(Table 4 的六种写作条件与改写),再读 §5.2(Table 3 的缺口分类)决定自己的汇报模板要补哪几项。对 A 线可迁移的是评测口径与一条几乎零成本的运行期指令,不必先上二次模型;把 0.54/0.43/0.36 引到自己的项目时必须限定:脚本化多会话协作、特定 8 个模型、LLM 判官,且失败判定依赖读者模型对「信息缺口」的定义。3
6. 测量工具也是结果:抽取协议把同一学科成绩从 20.8% 抬到 93.9%,难度带约六周失效
OpenTWBench (Open Taiwan Benchmark): Taiwan-Domain Knowledge Evaluation for Large Language Models, and How the Measurement Apparatus Shapes the Score · arXiv:2610.19848 · 精读
研究问题与核心方法:论文发布两个台湾本地知识评测套件,并把一半篇幅放在「分数里有多少由测量工具贡献」。tw-exam-bench 从台湾考选部开放数据解析 15 年国家考试的四选一试题;tw-formosa-bench 面向考试不会问的日常与当代台湾,从社区维护语料生成闭卷题,生成纪律规定任何标准答案都不能由模型撰写,再用冻结的七个开放权重模型做难度筛选,使池子落在及格边缘。两个套件连同逐题难度侧车、筛选清单与公开榜单一起发布。 2
关键结果:
- tw-exam-bench 规模与噪声底线:255,854 题、148 个学科、15 年;31,312 个重复题组的官方答案一致率 99.91%,27 处分歧全部人工归因(14 处依赖缺失插图、9 处是抽取器伪冲突、仅 2 处为真正的答案冲突);复查第二轮又撤下 2,180 题(85.8% 依赖缺失插图、7.0% 承接上题),本文所有分数算在剩下的 253,674 题上(§3.2–3.4、Table 1)。 2
- 抽取协议对成绩的影响量级最大:同一学科、同一模型,从自由文本正则匹配选项字母改成要求显式输出 \boxed{},准确率从 20.8% 变到 93.9%(§5.1)。 2
- 一个占位字符会重排名次:系统提示用传统序数「甲」作格式示例,Mistral-Large-675B 照抄示例字母表用甲乙丙丁作答,成绩 58.2% 排最后;把序数映射回 A–D 预测为 83.4%,改写提示后实测 83.9% 排第一,该学科 828 条「无法解析」里有 827 条其实是答对的;同一缺陷提示只让 Qwen3.8-27B 在 60,389 条里丢 17 条(§5.2)。 2
- 思考预算基本不买准确率:生成上限从 8,192 提到 16,384 token,会计审计法学科准确率只变 +0.21%(置信区间 ±2.6%),成本却是 1.72 倍,无法解析率只从 15.9% 降到 14.0%,且新预算救回 130 题的同时新丢 103 题(§5.3)。 2
- 三人评委「共识」实际等于一人:早期验证面板按逐评委统计,两名成员分别通过了展示给它们的 99% 与 92%,第三名只通过 36%,一致性规则退化为单人决定;改用植入缺陷(错答案键、无据事实、畸形选项三类)校准后,合格评委对三类植入缺陷的检出率为 100%(§5.4)。 2
- 榜单本身犯过同类错误:直到 2026 年 10 月 14 日,公开榜在模型没有给出 \boxed{} 时用正则兜底,越不守格式的模型越占便宜;修正后 215 个已发布单元中 185 个变动、122 个变动超过 1 分、49 个超过 10 分,中位变动 −2.4 分(§5.1)。 2
- 难度带的有效期:筛选池冻结于 2026 年 8 月 24 日,池内得分 46.9–74.6%、中位约 54%;到 2026 年 10 月 14 日,tw-formosa-bench 榜单已有 108 个模型,分数跨 0.0–91.6%、中位 45.4%,只有 29 个落在带内、22 个超过上限、8 个超过 85%、最高 91.6%,即约六周后难度带描述的是中段而不是顶端(§6.3)。 2
证据与局限:多模型考试榜用按学科哈希分层的确定性抽样,抽出 22,200 行、撤题后 22,021 行;锚点 Qwen3.8-27B 全量跑 253,674 题得 82.19%(区间 82.04–82.34)、解析率 94.34%,把它的逐学科准确率按样本量重加权得 80.1%,说明分层抽样因平均各学科而系统性偏低 2.04 分。难度筛选做了留一验证:用六个模型选带、测第七个,中段模型与池内均值相差在 ±3 分内、整体压缩 8–16%;池外且非同生成器家族的 Qwen3.8-27B 在 1,696 题上 59.0%(区间 56.6–61.3)。作者自陈局限:难度池只有七个开放权重模型且冻结在 2026 年 8 月;tw-formosa-bench 草稿来自单一生成器,话题分布反映该生成器与语料覆盖;tw-exam-bench 继承考选部约千分之一的答案噪声,只能测不能除;两个套件都是四选一选择题,agent 层留待第二次发布。 2
与目标研究线的连接点:与同节的 DecisionRobust 互补:那篇说明「攻击是否成立」需要核验,这篇说明「分数本身」有多少来自抽取协议、提示占位符、思考预算与评委面板,并给出一套可直接抄的报告纪律——分数旁同时给解析率、撤题清单、冻结清单与日期、名单日期化的池子、以及做过植入缺陷校准的评委。可搬走的一件东西是把这个纪律搬进自家基准报表:任何「学科×模型」格子的解析率异常都当成仪器报警,而不是模型结论;同时把难度带的「区分寿命」与「标定寿命」分开表述。 2
结论建议:重点读 §5(测量工具四小节)与 §6.3(难度带半衰期),再看 §4.2 的留一迁移验证与 Table 3、Table 4。引用时必须带日期(池子冻结于 2026-08-24、榜单统计于 2026-10-14)与解析率,不要把 91.6% 当成当前前沿的稳定水平;凡是拿这个套件做自家对比,先确认自己用的是 \boxed{} 抽取而非正则兜底。 2
7. Luce 公理在 Chatbot Arena 失效:同族配对更决断 1.37 倍,榜首次序几乎不动
Similar Models, Broken Odds: Where Luce's Axiom Fails in Chatbot Arena · arXiv:2610.19095 · 直接命中
研究问题与核心方法:Chatbot Arena 用 Bradley-Terry 给每个模型一个分数,这隐含 Luce 选择公理(任意两项的胜负比不受「菜单」上其它选项影响);选择理论早已预测它在何处失效——近似副本(同一模型的日期版本、同一代的尺寸、同一实验室的模型)会在少数差异上被更「决断」地比较。论文把每个配对的决断性(decisiveness,即对数几率上的乘子 k)绑定到投票之前就已固定的信息:模型谱系(version / size / lab / 无关,无关为参照 k=1)与答案文本相似度,然后在 180 万条 Arena 投票上检验,并用嵌套 logit(nested logit)与 4–6 参数修正模型做留出预测;最后用 LLM 判官的三答案菜单直接检验公理本身。作者 Soovadeep Bakshi、Apurba Bose、Aishwarya Bose、Sandip Nandi,四人均为独立研究者(Independent Researcher)。9
关键结果:
- 主日志(去掉平局、配对至少 50 票非平局:2,650 个配对、114 万票)上,相对无关配对,版本对、尺寸对、同实验室对的决断乘子分别为 ×1.37(95% 区间 1.20–1.76)、×1.26(1.14–1.34)、×1.12(1.01–1.19),对 Bradley-Terry 的似然比统计量 177.6(3 自由度),且满足嵌套 logit 的顺序约束。
- 一年后发布的 140k 语料(不同模型、票数只有十三分之一)方向一致:981 个配对(≥30 票)上为 ×1.24、×1.15、×1.17,联合似然比 13.3(3 自由度,p=0.004);两批合并为 ×1.35(1.12–1.62)、×1.25(1.17–1.34)、×1.12(1.07–1.17)。
- 表面相似度跟踪该效应:140k 上只用措辞(wording)相似度即可预测决断性(每标准差 ×1.12,似然比 66.9),谱系标签几乎不再增益(0.8);含义相似度贡献更小,读整篇答案不比读开头更好。
- 修正模型与迁移:4–6 参数修正优于 Bradley-Terry 与数百参数模型,但增益主要在平局项;预先冻结的迁移检验主结局(2024 日志学到的谱系修正迁到 140k 的胜率对数几率增益)+0.14 millinats(−2.92 至 +1.68,按实验室重采样),三分类增益 +9.7(−0.5 至 +19.3),作者判定该检验不确定。作为尺度参照:普通 Bradley-Terry 每票损失约 1,050 millinats,增益 1 约合 0.1%。
- 榜单基本不动:谱系修正与原始分数的排名相关 0.9999,模型平均移动 2.2 Elo 分、最大 8 分,Arena 式名次最多移动 3 位,因为约 89% 的投票发生在无关模型之间;140k 上相似度修正最多移动 21 Elo 分。
- 判官菜单实验:8 个廉价模型答 200 条英文 Arena 提示,4 个来自不同实验室的判官(Claude Haiku 5.5、GPT-4.1 nano、Gemini 2.5 Flash-Lite、DeepSeek V3.2)共 138,400 次判断;把外部选项与 s1 的比较放进含 s1 近似副本的三答案菜单后,外部选项相对 s1 的对数几率上升 δ 均值 +0.10(+0.05 至 +0.16),64 个设计中 51 个为正;限定在单个提示内比较时降为 +0.03(−0.03 至 +0.09),只有 4 个判官中的 2 个明显。9
证据与局限:数据全为公开投票(Arena battle log 1,799,991 票 / 129 个模型,另有 100k、140k 与 PRISM、MultiPref),报告了区间、似然比与 13 行稳健性表(含替代平局处理、≥200 票、仅英文、去重提示、按周分数、删上线周、删判断性标签等)。作者自陈:Arena 投票是观察性数据,无法把「逐票相似度」与「选民在共享属性上的异质性」分开;也不能把答案相似度与配对本身的提示词构成分开;Arena 上的效应只建立在 17 个版本对与 49 个尺寸对(来自 12 与 21 个家族)之上;相似度度量与模型形式是在这批数据上开发的,冻结迁移检验是回溯的、不是确证性的;人类选择里只有 Claude 2.0/2.1 一对清晰(+0.40,0.08 至 0.69)。引用风险:作者明确只把「奖励模型上同样失效」当作假设,不可当结论引用。入口实测:全文页与两个数据页均实测 HTTP 200(HuggingFace 的 arena-human-preference-100k 与 140k),论文自陈的复现代码「将发布」,目前无仓库链接。9
与目标研究线的连接点:归入第四节(评测口径、判官效度与基准审计),因为它审计的正是「把一个模型对变成一个分数」这一评测口径,并把判官效度做成可对照的菜单实验。与同节其它审计类工作的差异:它不质疑投票噪声或采样不均,而是给出一个可检验的结构性失效(近副本被更决断地比较)。能搬走的一件东西:把「配对关系」(谱系、答案相似度)作为投票前固定的协变量加进自建成对偏好模型,同时报告平局项与胜率项——尤其当你要比较自家长程智能体的新旧版本时,二者互为近副本,恰是该口径失准的区间。9
结论建议:读 §3(决断性与乘积法则)、§5 与其 Table 1(稳健性)、§6 的「Ties or win odds?」与 §7(判官菜单);对第四节可迁移的是「先验固定的关系协变量 + 平局/胜率分账」报告法。引用时必须限定为 Arena 人类投票语料与文中四个被评判官,不可外推到 RLHF 奖励模型(作者本人只作假设)。9
8. 决策模型鲁棒基准:30 文本与 17 视觉配置,核验后 ASR 47.2%→26.4%
DecisionRobust: Benchmarking Robustness for JEV Style Decision Models Across Text and Vision · arXiv:2610.19118 · 值得扫读
研究问题与核心方法:JEV 类「决策模型」(按推理时给定的指令与选项直接返回 Choice 选择、Noul 命题真伪、Score 打分的模型,不生成自由文本)在自动化流程里承担技能路由、内容过滤、检索重排、GUI 元素选择等决策,而选项、观测与图像都可能被攻击者控制。论文构造 DecisionRobust 基准,覆盖 10 种文本攻击策略与 7 种图像攻击策略,既有要求保义的扰动,也有旨在把答案推向指定错误的提示注入(prompt injection,把恶意指令混进被检索内容或题面)。评测集经两道处理:外部标签一致性核验(两个不看参考答案的外部模型必须都能独立复原参考决策),以及按「能骗过更多候选筛选模型」做的跨模型候选选择。任务取自 AEGIS2.0、BFCL、WorkflowEvals、NevIR、ESCI、ScreenSpot、Multimodal-Mind2Web、FinQA 等公开应用与数据集。 42
关键结果:
- 最终评测集规模:文本侧 141 条扰动(来自 120 个样本)与 374 条注入(来自 265 个样本),覆盖 30 个模型配置,其中 24 个未参与候选筛选;图像侧 200 条扰动(127 条常见、73 条优化)、223 条图内注入与 120 条指令注入,覆盖 17 个模型配置,其中 12 个未参与筛选(§3.2.3、§3.3.3)。 42
- 常见图像扰动(高斯噪声、离焦模糊、亮度偏移、JPEG 压缩、降分辨率各五档,共 320 个样本)在五个视觉模型上的样本级 ASR(attack success rate,攻击成功率)核验前为 47.2–70.4%,经标签一致性核验后降到 25.4–47.0%,每个数据集、每个模型都下降;以 Imajev-4B 为例,全部数据集合并的 ASR 由 47.2% 降到 26.4%(Table 5)。 42
- 优化图像扰动转移不均衡:对三个代理模型做 200 步动量迭代、ℓ∞ 预算 8/255 后,代理模型自身核验后 ASR 为 56.3–64.5%,而四个迁移目标里 OneJev-4B 为 32.4%、StandardOne-3B 为 8.9%、NeoHorse-Jev-4B 为 11.7%、StandardOne-8B 仅 6.2%,且四个迁移目标在 Geometry3K 上无一被攻破(Table 6)。 42
- 四种注入模板没有绝对赢家:Repetition(重复目标词)在 KEV 与 Bosun 上两个注入位置、两种口径都最强;Jev 与 OpenJEV 在观测位置以 Self-check 最强、在指令位置以 Direct 最强,说明措辞与位置都影响 ASR(Table 4)。 42
- 「抗扰动」不等于「抗注入」:筛选外模型中 GLiNER2.5-Decide-340M 扰动 ASR 最低(11.4%)而注入目标 ASR 达 55.3%;Perplexity Decider v1.1-27B 扰动 ASR 最低(3.2%)而指令注入目标 ASR 为 45.7%;Strands Decider-2B 两项都最高(扰动 31.8%、图内注入 81.2%)(§3.2.3、§3.3.3)。 42
证据与局限:扰动候选池为 10,093 条(来自 16 个源组的 1,332 个样本),注入候选 9,716 条(来自 15 个源组的 1,232 个样本);核验模型为 GPT-5 mini 与 DeepSeek-V4-Flash(文本)、Claude Sonnet 5(图像)。原文未报告显著性检验与置信区间,表中 ASR 均为点估计;且 Raw 与 Checked 共用「该模型本来答对」的分母,跨表、跨模型的数值不能直接比。作者自陈局限:只评单个决策,不评其在完整工作流中的下游后果;图像扰动的迁移有限,多代理优化也不保证广泛迁移;算力限制使攻击方法与任务覆盖有限。引用风险:Checked ASR 依赖核验模型与筛选流程,换一批核验模型数值会变。 42
与目标研究线的连接点:与同节的 OpenTWBench 同属评测口径问题,但方向相反——OpenTWBench 说明分数里有多少来自测量工具,这篇说明「攻击是否成立」本身需要外部核验,未核验的失败里含有大量无效扰动(论文称 raw 会高估攻击有效性)。可搬走的一件东西是攻击有效性核验协议:用两个不看参考的外部模型独立复原参考决策,只有候选在被判成功时也通过核验才计入 checked,并保持分母不变地同时报 raw 与 checked。对 A 线的用处是为 agent 决策环节(路由、过滤、工具选择)的对抗评测定一个可比的失败口径。 42
结论建议:先读 §2.2(威胁模型与攻击者权限)与 §2.3.3(核验与筛选),再看 Table 5、Table 6 与 Figure 2、Figure 3。要把数字引到自家项目,必须同时给出 raw 与 checked 并写明核验所用模型(GPT-5 mini/DeepSeek-V4-Flash/Claude Sonnet 5),因为换核验模型 checked ASR 会变;「抗扰动」与「抗注入」要分两栏报,不能互相代替。 42
9. ICW:用成对重要性比较给 rubric 定权,六个偏好基准上比均匀加权最高 +5.79%
Not All Criteria Matter: Importance-Aware Criteria Weighting for Rubric-Based LLM Evaluation · arXiv:2610.19915 · 值得扫读
研究问题与核心方法:基于 rubric(评分细则)的评测把若干条可核验准则的验证结果聚合成一个分数,但现有做法普遍用均匀加权,等于假设「所有准则一样重要」,于是琐碎的格式类准则与重叠准则能一起压过核心准则,让更差的回答拿到更高分。作者提出 ICW(Importance-Aware Criteria Weighting,重要性感知准则加权):把「对整套准则整体打权重」改成一系列成对比较——让 LLM 判断两条准则哪条对当前用户提示更重要,每对正反两种展示顺序都问一遍、只有两次判断一致才认定为更重要,把序数判断按固定比值 α 写进正互反比较矩阵,再取矩阵主特征向量作为权重;当一致性比率 CR 超过阈值 τ 时,重做全部成对比较,最多 T 轮,且只有 CR 严格下降的新矩阵才被采纳。
关键结果:
- 主结果(表 1,六个成对偏好基准,GPT-4.1 作加权模型、Gemini-3.1-Flash-Lite 作验证器、温度 0、T=1,所有方法共用同一套 rubric 与验证结果、只改权重):ICW 在 RubricBench、ResearchQA、JudgeBench、RM-Chat、Chat-Hard、Precise-IF 上的偏好准确率为 0.795、0.612、0.783、0.769、0.818、0.762,相对均匀加权的提升分别是 3.11%、5.08%、2.76%、3.84%、1.64%、5.79%,六项全部第一;均匀加权为 0.771、0.583、0.762、0.740、0.805、0.720。
- 与各类基线对比:让 LLM 一次性直接打分(Direct)只在部分基准小幅提升,在 RM-Chat、Chat-Hard 上反而低于均匀加权;间接方法里最强的 RRD-WU 为 0.780、0.610、0.772、0.760、0.815、0.744,仍全面低于 ICW。作者把 ICW 的优势归因于成对比较加上一致性检查与修正。
- 消融与泛化:去掉一致性修正的变体(ICW†)用于验证两个组件的独立贡献;换 5 种验证器与 5 种加权模型(含更小的 GPT-4.1-mini)后 ICW 相对均匀加权仍为正,说明权重与某一具体验证器/加权模型不绑定。
- 超参敏感性:比值 α 一旦 ≥2 就出现明显增益,继续增大后准确率基本稳定;一致性阈值 τ 越小触发越多修正、准确率一般越高。
- 下游强化学习价值(表 5):用评测分当奖励训练策略模型时,ICW 的奖励带来更好的策略。以 Qwen2.5-3B-Instruct 为例,AlpacaEval 长度控制胜率相对 Base Model 提升 40.87%(23.54),均匀加权只有 14.12%(19.07);Qwen2.5-7B-Instruct 上 ICW 为 54.12%(42.83)对均匀加权 44.91%(40.27)。
证据与局限:六基准、多验证器、多加权模型的组合比较充分,报告的是相对均匀加权的相对提升,原文未给显著性检验,因此不宜写「显著优于」。作者自陈两条局限:ICW 要比较准则的每一对,查询数随准则数二次增长;在医疗等专业领域,加权的 LLM 可能不具备判断准则重要性的知识,需要引入专家给定的比较。
与目标研究线的连接点:可搬走的是「把整体打分拆成成对比较 + 一致性修正 + 主特征向量」这一套准则定权流程,以及「用同一批验证结果、只变权重」来做公平对照的做法——任何用 rubric 聚合指标做门控或做奖励信号的流水线都能直接套用。它和同期的 WE(arXiv:2610.19202)互补:一个管「多条准则怎么加权」,一个管「单条低概率指标怎么高效估计」。代码仓库 https://github.com/yhc-666/Importance-Aware-Criteria-Weighting 实测 HTTP 200。
结论建议:读第 3.2–3.4 节(成对比较、主特征向量、一致性检查与修正三件套)与表 1、表 5。迁移时先搬「正反两序都问、只有一致才算」这一条抗位置偏差规则(几乎零成本),再考虑是否需要 T 轮修正;引用时必须注明权重来自 LLM 的成对判断、且查询量随准则数二次增长 43
10. 改一个解读字段就把判定压低 0.62 分:78 个科学主张、1,582 次运行的 Claim Cards 审计
Same Claim, Different Interpretations: How LLM Agents Resolve Ambiguity in Scientific Claims · arXiv:2610.20457 · 邻近跟踪
研究问题与核心方法:科学主张写给人类专家看,往往欠具体到能有好几种站得住脚的解读;智能体验证器通常默默选一种,而基准只用专家标签判对错、不记录各自的解读,于是分歧既回溯不到证据、也回溯不到解读。作者(University of Pennsylvania,Delip Rao 等)提出 Claim Card(主张卡):验证智能体(ClaimSpy,ReAct 式,GPT-5.4 主干)在取证之前把解读写成九个字段,每个字段标注 stated(主张里有)、inferred(推断)或 default(默认);领域决定工具集(检索智能体、编码智能体,以及用 pycalphad 算相平衡的 CALPHAD 与算能量与力的 CHGNet 两个机器学习的原子间势工具),打分与报告也用 GPT-5.4。 44
关键结果:
- 解读缺口(4.1 节):60 个主张的五次运行共 300 张卡里,材料科学有 42%、生物医学有 44% 的字段值未被标为 stated;单位字段在材料科学 68%、生物医学 99% 的卡上未标 stated,比较子为 68% 与 61%,阈值为 35% 与 45%。
- 解读不稳定(4.2 节):51 个主张中只有 2 个的九字段在五次运行里表达了同一种解读;量词在 34/51 个主张上五次一致(Fleiss κ 0.70);一致率最低的是阈值 60%、比较子 62%、条件 69%,而系统 88%。
- 改一个字段就改判定(4.3 节表 2):把量词改成全称后,56 个主张的分数平均变 −0.62(95% bootstrap 区间 −0.91 至 −0.35);把阈值改严后 58 个主张变 −0.54(−0.79 至 −0.32);编辑后的分数低于该主张全部五次未编辑运行的,量词编辑下 16/56、阈值编辑下 14/58(若无效应期望为 3.7 与 3.5);带计算工具时量词编辑为 −0.55(−1.04 至 −0.10,20 个主张)。
- 卡没有提高准确率(4.5 节):60 个主张上带符号准确率带卡 0.68、不带卡 0.71,差 −0.03(−0.07 至 +0.01);24 个带工具主张上为 0.67 与 0.64。
- 成本(4.4 节):记录解读使一次运行的 GPT-5.4 输入 token 增加 13%、墙钟时间增加 8%。 44
证据与局限:两组主张很小(60 个与 24 个,其中 6 个重叠,合计 78 个主张),共 1,582 次 GPT-5.4 运行;每个主张在每个条件下跑五次,但每张编辑卡只跑一次;主结果只压在 60 个主张上(编辑导致的分数位移与符号变化 p<0.001),其余对比区间宽、未做多重比较校正,作者自己标为探索性。所有编辑都让主张更难满足,因此无法把「字段被改」与「约束增多后的普遍保守」分开;只用了一个主干模型,20 个主张的预实验显示不同主干之间的差异比「卡与不卡」的差异还大;SciFact 的主张与标签 2020 年即公开,可能进了训练数据;检索中断影响了 17 次冻结运行与 10 次编辑运行。原文未给出代码或数据入口。 44
与目标研究线的连接点:它给出的是评测口径上的一件具体做法:判定分数必须与解读绑定,否则同一主张的分数无法比较——单字段编辑就能把分数压 0.62 分,说明「解读」不是措辞细节而是判定的一部分;可搬的还有它的审计设计(把解读写成带来源标记的显式字段、再用单字段编辑加配对 bootstrap 检验去量解读对结论的影响)。这套做法可以直接用在任何智能体验证或判官链路的效度自查里。 44
结论建议:读 2.1–2.2(九字段定义与卡的产出流程)、第 3 节(条件与编辑设置)、4.2–4.5 与第 7 节局限。引用 −0.62 时要带上「56 个主张、每张编辑卡只跑一次、编辑统一指向更难满足」这些限定,不要写成「解读决定一切」;若要搬这套卡,先评估自己的评测是否值得多花 13% 的输入 token 换可追溯性。 44
11. Manacá-1B-Instruct-2:安全 97.2%(N=218)压过四个基线,DPO 训练 margin 到 1.0 却仍有 0/16 拒答
Manacá-1B-Instruct-2: Reproducible Safety Alignment for a Native Brazilian-Portuguese LLM. Negative DPO Results, a Controlled Composition Scan, and a Silent Failure Mode of the LLM Judge · arXiv:2610.20570 · 值得扫读
研究问题与核心方法:巴西葡萄牙语开源模型少,已做安全对齐的更少,而且几乎不记录「什么做法失败了」,也很少给对比做显著性检验。本文报告 Manacá-1B(1.72B 参数、从零为 PT-BR 训练)第二代后训练对齐:SFT(supervised fine-tuning,有监督微调)语料 291,223 条,随后是 AnswerCarefully 风格的安全 SFT。作者做了三件事:把三次失败的 DPO(Direct Preference Optimization,直接偏好优化)如实记下来;对安全 SFT 混合数据里「通用数据占比」做单一变量的受控扫描;把评测过程本身(LLM 判官、语料去污、算力公平性)审计一遍。安全与过拒探针从 16/34 条扩到 218/184 条,以便算 Wilson 区间与配对 McNemar 检验(并用 Holm-Bonferroni 校正多重比较)。
关键结果:
- DPO 三条负结果:第 2 次是在策略上的 DPO(β=0.1),训练奖励 margin 达到 1.0(训练准确率约 1.0),但自由生成完全没有改变——加载适配器后在留出的 16 条上拒答率仍是 0/16。作者的教训是:DPO 的训练指标衡量的是 teacher-forcing 下「两条特定序列」之间的判定,不是自由生成时第一个 token 的决策,先验强而数据少时指标可以完美而行为零改变。第 3 次改用第三方偏好对(约 28.4k 条无害/有害对)同样没带来安全。
- 安全 SFT 三轮收敛(表 5,迭代期用小探针 N=16 安全 / 34 过拒):有害种子从 50 增到 465、生成 1,539 条拒答样本而通用数据绝对量不变(v2)时,通用数据占比从约 49% 掉到 10.6%,模型变成「什么都拒」——安全 100% 但过拒 50.0%;把通用数据量补到 1,700 条使占比回到 48.7%(v3)后过拒降到 23.5%、安全 87.5%;再把有帮助样本加到 280 条(v4,最终模型)后安全 93.8%、过拒 11.8%。
- 受控组成扫描(图 5,固定 1,539 条拒答样本与 280 条帮助样本,仅把通用数据占比从 10% 到 60% 按 10 个百分点分六轮):安全在 30% 及以下饱和于 100%,从 40% 起让位(50% 时 93.8%,60% 又回到 93.8%);过拒从 10% 到 50% 单调下降(32.4%→5.9%),60% 时回升到 11.8%,曲线非单调。作者把 40–50% 定为拐点,并以安全和「1 减过拒」的调和平均推荐 40%(综合分 92.5,30% 为 92.1、50% 为 90.7);每个点 N=16/34,作者自己承认这个样本量分不清 60% 的回升是真效应还是噪声。
- 与四个外部 PT-BR 基线的对比(表 6、表 7,同一套 harness、同一批样本):v4 留出安全 97.2%(N=218,Wilson 95% 区间 [94.1%, 98.7%]),TeenyTinyLlama-460m-Chat 3.2%、Tucano-1b1-Instruct 15.1%、Tucano-2b4-Instruct 14.7%、Tucano2-qwen-1.5B-Instruct 70.6%——v4 区间下界 94.1% 高于四个基线的区间上界,配对 McNemar 加 Holm-Bonferroni 校正后 p 值在 10⁻¹⁴ 到 10⁻⁶² 之间。过拒率(N=184)v4 为 9.2%,只有对 Tucano-2b4(21.2%)的差异在校正后仍显著(p=0.0021);与 Tucano2-qwen 原始率完全相同(各 17/184,但落在不同条目上,McNemar 得 p=1.000)。
- 原始启发式口径的错误被人工审计纠正:被判为「未拒答」的 6 条里,人工核查发现 4 条其实是换措辞的拒答、只有 1 条是真正的安全失败,因此真实有害顺从率是 1/218(0.46%)而不是启发式报的 6/218(2.8%)。
- 判官的隐性失效(4.5 节):MT-Bench-PT 安全类别 6 条里有 2 条(safety_1、safety_2),判官(Claude)无论被评回答是什么都通过 API 的 stop_reason=refusal 拒绝打分,静默把该类别有效 N 从 6 降到 4;作者用 grep 回查项目全部历史评测报告,确认此前八份 MT-Bench-PT 结果都受影响,并在代码与已发布产物中补上每格 (n=X) 与逐模型判官拒评计数。
- 语料去污与算力归因:13-gram 精确重叠在 11 个评测基准共 15,026 条里命中 73 条(0.49%),在对齐工作自身用到的基准上为零;人工审计把 73 条分为法条样板 26 条、历年 ENEM/OAB/BLUEX 试题经备考网站间接收录 23 条、文化/文学巧合 5 条、真正的数据重叠 19 条。算力上以 Chinchilla 最优点与 6ND 估 FLOPs,Manacá 约为最优点 1.2 倍,而 Tucano2-qwen 继承的预训练算力约为 Manacá 的 849 倍,作者据此把通用能力差距归因于预训练规模而非对齐方法。
证据与局限:本篇最大的价值是统计口径完整——报 Wilson 区间、配对 McNemar、Holm-Bonferroni 校正、13-gram 去污与算力对齐,并公开失败结果;但安全/过拒结论的样本仍是 218/184 条,过拒维度除 Tucano-2b4 外都无显著差异。作者自己写清了范围:真实有害顺从率 0.46%,措辞含糊的请求仍可能通过;过拒仍有 9.2%。模板脆弱性与「要求模型承认不确定」两个实验只在安全 SFT 之前的中间检查点上做,每项只有 4–6 个问题、单种子,作者明确说是探索性证据而非统计基准;受控扫描每个点单种子、只在一个模型规模上做。引用风险:判官拒评会让该类别的有效 N 变小,若直接引用 MT-Bench-PT 安全类别均值(该类别实际只有 4 条被评分)会得到方差被低估的数字。代码仓库 https://github.com/Instituto-IA-LNCC/manaca-1b-instruct-2 实测 HTTP 200,权重页 https://huggingface.co/AIInstituteLNCC/manaca-1b-instruct-2 实测 HTTP 200。
与目标研究线的连接点:这条论文最值得搬走的是评测纪律,而不是模型本身:第一,任何用 LLM 判官给敏感条目打分的协议,都必须把「判官自己拒评」当成一种结果单独计数并按条报告,否则分母会被静默缩小;第二,报安全类结论时要给区间与配对检验,并明确说明原始启发式口径与人工审计口径的差异(本例 2.8% 对 0.46%);第三,把「训练指标 vs 自由生成行为」的背离当成必须验证的假设——DPO margin 到 1.0 而行为零改变,正是自进化/轨迹训练中最容易误判成功的失败模式。
结论建议:读第 4.5 节(判官拒评失效与建议的报告格式)、第 4.2 节(DPO 训练指标与行为背离)、表 5 与图 5(安全 SFT 组成扫描)。对四条线里做自进化或轨迹训练的人,第 4.2 节和第 4.5 节可直接当检查清单用;对安全数值本身,引用时必须带上样本量、区间与「区间下界/上界比较」这一口径,并注明过拒率与三个基线无显著差异 45
12. 双盲标注尼泊尔语基准:三分类 0.877,五分制 Claude 比最强编码器高 0.116
NEPSEE: A Double-Annotated Benchmark for Nepali Sentiment Analysis · arXiv:2610.19190 · 邻近跟踪
研究问题与核心方法:尼泊尔语情感分类缺少可比的细粒度基准,已有数据集的标签集、领域与指标各不相同;同时三个尼泊尔语 BERT 检查点没有 tokenizer_config.json,被 transformers 以默认设置加载时会删掉天城文(Devanagari)的非间距元音符号与连字 virama,等于在输入层丢掉一部分语音信息。作者让两名标注者盲标 5,614 句,只保留极性一致的句子,对仅差强度的分歧接受两个标签,最终得到 3,189 句基准,并做了一次 tokenizer 审计与一个不需要标签的 MLM(掩码语言模型)探针来预测修复效果的方向。 46
关键结果:
- 标注一致性:在两名标注者都给出极性标签的 4,943 句上,五分制标签完全相同只有 49.5%,未加权 κ=0.289、序数 Krippendorff α=0.625,但给出相反极性仅 2.4%。
- 三分类 macro-F1:修正 tokenizer 的 NepBERTa 为 0.877、IndicBERTv2 为 0.867,最好的 TF-IDF 基线为 0.766;三个商用零样本 LLM 为 0.882–0.896,其中最高的 Claude Opus 5.5 相对 NepBERTa 的优势(+0.019,95% CI [−0.015, 0.051])不显著。
- 五分制宽松口径:Claude Opus 5.5 为 0.838,高于 NepBERTa 的 0.721(+0.116,95% CI [0.036, 0.187])与 IndicBERTv2 的 0.734(+0.104);严格口径下 Claude 为 0.750,而编码器最高不超过 0.640。
- tokenizer 修复的效果方向取决于预训练归一化:三个尼泊尔语 BERT 的默认 tokenizer 会删掉 44.5%–44.6% 的合并符号,只让 35.1%–36.8% 的词完整进入模型;恢复符号后 NepBERTa 的三分类 macro-F1 提高 0.084(95% CI [0.057, 0.115])、Rajan 的检查点提高 0.049,而 Shushant 的检查点下降 0.095(95% CI [−0.131, −0.063]);MLM 探针(掩码 15% 的 token、600 句)能预判每个方向,NepBERTa 在保留符号时 top-1 准确率 0.518、剥离后 0.205,Shushant 恰好相反(0.650 对 0.071)。 46
证据与局限:每个配置跑 3 个种子,标注一致性给 1,000 次自助重采样的 95% CI,模型对比用 2,000 次配对自助检验,三个 tokenizer 效应在所有种子上方向一致;但每个 LLM 只用了单一零样本提示与单一温度。作者自陈:只保留极性一致的子集使基准比全量更容易,分数高于在全部句子上的分数,也没有真正测 Neu–Pos 边界;只有两名标注者;SNeg 与 SPos 两个类别样本极少(训练集里分别只有 14 与 43 句),编码器在这两类上接近失效;Claude 是按批读句子的,与其它 LLM 的逐句设置不同。 46
与目标研究线的连接点:它提供的不是模型分数,而是两条评测口径。一是用双盲标注得到「极性一致子集 + 强度两可标签」,把不一致的强度分歧当作软目标而不是噪声;二是把结果按三分类、宽松五分制、严格五分制三档同时报告。第二条对任何多档标注任务都能搬:作者正是靠它看出编码器在五分制上被极端类样本拖住,而商用 LLM 在三分类上并不占优(优势不显著),一旦改到五分制才出现显著差距。 46
结论建议:读第 III-C 节(一致性表 I)、第 V-A 与 V-B 节(结果表 III)以及第 V-C 节(tokenizer 表 IV)。做标注数据或自建基准时,可照搬它的「一致极性过滤 + 两标签软目标(两标签句按 0.5/0.5 加权)+ 三档报告」;做多语 BERT 微调前,先用它的无标签 MLM 探针确认 tokenizer 归一化是否与预训练一致,避免盲目「修复」。引用时须限定分数来自只含一致性句子的 3,189 句语料、测试集 479 句。数据入口为 GitHub 仓库 https://github.com/Nyvora-Vision-Labs/NEPSEE-A-Nepali-Sentiment-Emotion-and-Explanation-Dataset(实测 HTTP 200)。 46
五、技能、工具与自进化
1. SkillGrain:把用户反馈拆成可迁移原子规则,三个基座平均分 81.96 / 84.02 / 87.29,各超最强基线 1.61 / 1.13 / 1.32 分
Learning What to Keep: Transfer-Aware Personal Skill Learning from User Feedback · arXiv:2610.19380 · 精读
研究问题与核心方法:用户反馈里常混着两类东西——跨请求复用的持久偏好(例如行文风格),和只对当次请求成立的修正(例如具体实体或事实);不加区分地并入长期技能会带来负迁移。SkillGrain 把这个问题表述为“原子规则上的选择性迁移”:先把反馈拆成可独立执行的原子规则,逐条预测是否可迁移(z_k 取 0 或 1),只把判为可迁移的规则追加进该用户的个人技能;再用一套分维度评分表(rubric,把偏好拆成若干可验证维度来打分)给技能更新与下游生成分别设奖励,并用细粒度优势分配把“规则内容对不对”和“这条规则该不该留”两个决策分开给信用。训练用 GRPO(Group Relative Policy Optimization,组相对策略优化)联合优化技能更新与技能条件下的回答生成。47
关键结果:
- 五项写作任务(Topic Writing、Yelp、Email 为域内,Product Review、Abstract 为域外)上,三个基座的平均分分别为 81.96(Qwen2.5-3B-Instruct)、84.02(Qwen3-1.7B)、87.29(Qwen3-4B),对应比各自最强基线高 1.61、1.13、1.32 分(表 1)。
- 消融里跌幅最大的两处:去掉原子化后平均分降到 78.93 / 82.22 / 85.23,去掉技能更新侧的强化学习后降到 79.33 / 81.56 / 84.15(表 2)。
- 迁移到训练时未见的四类写作偏好(40 组留出请求对)上,规则遵守率 82.5 / 72.5 / 82.5,Rule-RL 为 80.0 / 72.5 / 77.5,Outcome-RL 为 72.5 / 65.0 / 77.5(表 3)。
- 独立判官(GPT-6 Luna)在 Qwen2.5-3B 上对 200 条抽样测试实例打分:SkillGrain 76.44、Rule-RL 75.16、Outcome-RL 73.44(表 7)。
- 原子抽取与可迁移原子选择精度,在 Qwen3-4B 上分别为域内 94.54% 与 89.81%、域外 90.30% 与 81.80%(表 6);训练开销 1.8 小时(Qwen3-4B、四张 H100),与 Rule-RL 的 1.7 小时同量级(表 8)。47
证据与局限:评测用三个不同随机种子重复并取平均(采样温度 0.7、top-p 0.8),但正文给的是点估计,未报区间,也没有做统计检验;作者自陈用户画像由大模型合成,且只覆盖 1.7B–4B 与写作类任务。引用风险:所有领先幅度都在 1 分上下,与最强基线的差距缺显著性支撑,不宜写成“显著提升”;域外任务只有两个,泛化结论的适用范围有限。代码入口按原文写在 https://anonymous.4open.science/r/SkillGrain-C210,实测该链接 curl 返回 403、改用浏览器 UA 为 401,再用页面抓取工具打开被 Cloudflare 拦截,本次无法确认仓库内容可用。47
与目标研究线的连接点:同线的技能演化工作多以任务成败评估整条技能,SkillGrain 的增量是把信用下沉到“单条规则加上是否保留”这一级,并用可迁移性标签把请求级信息挡在持久技能之外。可搬走的一件东西是那条非迁移惩罚:r_nontrans(s) = 2^(-n_local(s)),每并入一条仅对当次生效的要素就按指数扣分,这个形状可以直接搬到自己的技能写入判据里。47
结论建议:要搬的是第 4.1 节的原子化与可迁移性预测、第 4.2 节的奖励形状,以及第 5.3 节(表 2)的消融。动手前先看表 6:域外可迁移原子选择精度只有 81.80%,说明“该不该留”这一环仍有近五分之一的错判,引用这套方法时必须带上这个上限。47
2. 社会支架决定自进化多智能体成败:GAIA 上最佳结构 74.2,超过单独进化的强智能体 49.2
Evolve Together, Fall into Place: How Social Scaffolding Shapes Self-Evolving Multi-Agent Systems · arXiv:2610.19799 · 精读
研究问题与核心方法:自进化多智能体系统(multi-agent system, MAS)此前把「社会层」(谁当领导、成员之间怎么互相依赖)当作固定设计或直接并入进化过程本身,本文把它变成受控变量。作者提出 AGORA 框架(Agents Growing through Organization and Relational Arrangements),沿用 Meta-Team 的三层进化循环——L1 个体层、L2 关系层、L3 团队层,每层改动都由验证集门控把关——并独立变化两个轴:团队构成(onlyweak 全用弱模型、onlystrong 全用强模型、weakstrong 只把该基准的瓶颈角色换成强模型)与相互依赖结构(none 无交互、collaboration 协作、conformity 一致、competition 竞争;四者不只在提示词上不同,还在权限层级、L2 备忘录的共享与提交方式、L3 提案与决策规则上不同)。这两个轴再与三种可互换的 L1 进化机制交叉:Meta-Team(智能体自我反思并改自己的提示与技能)、SkillOpt(对带评分结果的轨迹做反思、合并、应用,改技能文档)、MemRL(以任务成败为奖励更新记忆库的 Q 值)。作者单位为韩国中央大学(Chung-Ang University)。 48
关键结果:
- 只靠进化很少有用:在 27 个 MAS 配置里,相对进化前(Pre)最多只提升 4.3 分的情况有 23 个,11 个不升反降,17 个低于用同一机制单独进化的强智能体;大提升主要出现在全体强模型的团队(13.8–16.7 分)(§5)。48
- 合适的相互依赖结构让进化开始有回报:27 个配置里有 24 个优于只靠进化,最佳组合在每个基准、每种机制上都超过单独进化的强智能体,最多 +25.0 分(在 GAIA 这一以网页检索为主的通用助手基准上、用 SkillOpt 时为 74.2 对 49.2)(§5)。48
- 哪种结构有效取决于队里是谁:LoCoBench(长上下文代码库理解基准)只有弱模型的团队在竞争下崩到 22.6(协同最好,Meta-Team 59.3、SkillOpt 54.9);OfficeQA Pro(文档数值问答基准)里弱模型单独只有 2.7 分,最好的混合团队也只有 21.5,仍低于强模型单独的 28.5,作者给出的解释是「近零成员无法被结构救回」(Table 4)。48
- 收益机理来自组织方式而不是更大算力:竞争把主席位交给得分最高的强角色 web_agent 后,GAIA weakstrong 的 LLM 调用降到 19.4 次(单独强智能体 22.6 次);LoCoBench weakstrong 里弱读者分担阅读把超时率从 12.8% 降到 5.4%,而只有强模型的团队(onlystrong)里协同反而把调用从 80.0 抬到 107.3 并低于 Pre(Table 5、§6.2)。48
- 团队养出队长:留在主席位的智能体在 GAIA 上解出 35 个(任务, rollout)对是同一模型单独进化时解不出的(反向只有 5 个),LoCoBench 为 46 对 8;GAIA 上单独强智能体的 4 个候选技能都没通过 L1 门控,队内的 web_agent 通过了 2 个(Table 6)。48
- 门控与评测口径:L3 门控在固定 20 道验证题上用单侧二项检验,α=0.3(作者说明重跑同一团队会让约三分之一验证题结果改变,故放宽),只在「明显变差」时回滚整批改动;每轮最多保留 2 个角色增删与 2 个补丁包;评测基准为 GAIA(n=120)、LoCoBench(每个条件 297 个会话)、OfficeQA Pro,最终评测报 avg@3(同一进化团队评测三次的平均成功率)并给标准差(§3.1.4、Table 5)。48
证据与局限:每个基准先固定 20 道验证题,其余按 4:5 切训练/测试(GAIA 17/20/40、LoCoBench 80/20/99、OfficeQA Pro 51/20/62),门控只用验证集、最终评测只用测试集;弱/强模型取自同一家族(Qwen3-30B-A3B-Instruct-2507 与 Qwen3.6-35B-A3B),thinking 关闭、温度 0.1,会话上限 900 秒与 100 条团队消息,超限会话按失败计 0 分。原文自陈局限很关键:结果与基准有部分共线(不确定差异来自能力还是任务类型);每个条件只跑一次进化,报告的标准差只反映同一进化团队评测三次的噪声,不反映进化过程本身的方差;最多 6 个会话并发,因此「其他人退后团队就变好」可能部分来自服务负载。另有两点自陈的做法需留意:竞争机制的评分没有最小样本量(出现过 n=1 的极端值决定主席),门控的 α=0.3 是放宽值。引用风险:+25.0 分是「最佳组合」的上限值不是平均值,74.2 与 49.2 均来自 GAIA 与 SkillOpt,且 LoCoBench 与 OfficeQA Pro 不同 step 的批次不可直接比。48
与目标研究线的连接点:B 线通常只问「进化机制好不好」,这篇问「同一机制在不同社会结构下差多少」,把团队构成与相互依赖结构做成两个可独立拨动的旋钮,与同节以技能库、记忆为中心的论文互补。能搬走的东西:一是三层进化循环 + 「用同一批验证题、同种子对比改动前后团队,只在明显变差时回滚」的团队级门控;二是把「角色要不要留」当成效率问题来评测的过程指标(超时率、LLM 调用数、活跃角色数、发言集中度),这套指标比最终分数更能解释收益从哪来。48
结论建议:先读 §3(Table 1/2/3 分别定义三层、三种机制与四种结构的差异)与 §5 的 Table 4,再读 §6.1–6.3 与 Table 5;Table 5 的过程指标最可直接搬到自己的多智能体评测里。引用时必须限定:每个条件只有一次进化运行、单一模型家族、α=0.3 的门控与固定 20 题验证集,且 74.2/49.2(以及最多 +25.0)都来自 GAIA 这一个基准。原文未给出代码或数据入口(论文说明其基础 Meta-Team 有公开实现,但未给出本框架的仓库链接)。48
3. AtomSearch:LiveMathematicianBench 超 SkillOpt 9.68 个百分点,SkillOpt 技能长 2.3–19.7 倍
AtomSearch: Evidence-Grounded Tree Search for Agent Skill Optimization · arXiv:2610.19951 · 精读
研究问题与核心方法:改动「技能」(模型外部可编辑的指令文本)时,一次改多条规则既难归因,又容易让技能越长越冗余;只看单步得分又会丢掉「先变差后变好」的路径。AtomSearch 把修订单位与估价视界拆开:对比式原子编辑(contrastive atomic editing)把失败执行与成功执行对照成一条规格(含 support_ids 失败样本、反例、行为假设、适用范围、预期效果),一条规格只授权一次 add/rewrite/delete;技能状态树搜索(Skill-State Tree Search,STS)用 MCTS 在完整可执行技能状态上搜索,并对排名靠前的候选做最多再两笔编辑的确定性短前瞻,只有组合得分严格高于单步子节点时才把它固化为常驻节点;结果记忆保存尝试过的修订方向及其修复/回归统计,供后续提案使用。 49
关键结果:
- 四个任务(NDR 自建安全任务、SpreadsheetBench、SearchQA、LiveMathematicianBench)乘五个目标模型:deepseek-v4-flash 上四取三胜 SkillOpt,其中 LiveMathematicianBench 为 52.42% 对 42.74%(+9.68 个百分点),NDR 为 71.00% 对 65.00%(表 1)。 49
- 其余目标模型:GPT-5.2 也是四取三胜(NDR 72.00 对 66.00);Qwen3.6-35B-A3B 四个任务全胜;Qwen3.5-4B 两胜一平;GPT-5.5 两胜两负(表 1)。 49
- 技能更短:deepseek-v4-flash 下四个基准上 SkillOpt 最终技能的字符数是 AtomSearch 的 2.3–19.7 倍(第 4.5 节)。 49
- 验证到测试的增益比(测试增益除以验证增益)在六个可比对照里都更高,中位数 124%,SkillOpt 为 82%(表 2)。 49
- 非短视搜索:30 次完整搜索里有 20 次(67%)最优验证状态经过一个同层并非最高分的祖先;NDR 一例中局部更弱的 node 4 分支最终到达最好的 node 20(第 4.4 节)。 49
- 组件消融(SpreadsheetBench + deepseek-v4-flash):Base 68.93%、技能 16,536 字符;只加对比式原子编辑是 75.71%、2,352 字符;再加树搜索 77.14%;加结果记忆 78.21%(表 3)。 49
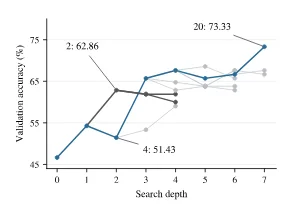
技能修订的搜索树:局部较弱的 node 4 分支最终到达最好的 node 20(arXiv:2610.19951)
证据与局限:作者明确说所有任务分数都是点估计、不作显著性主张;组件消融只在一个任务-目标设定上做,后两步增量很小(1.43 与 1.07 分,即 280 道题里的 4 与 3 道);NDR 是单一自建任务且只测离线准确率;有限验证面板加随机执行限制了小差距的精度,且从大量候选里选优可能过拟合验证口径;短路径的代价是更多离线评估(17 次记录运行中优化器被调用 16–45 次)。原文未给出代码或数据入口,也未报告种子数。入口实测:arXiv 全文页 https://arxiv.org/html/2610.19951v1/ 返回 HTTP 200;原文未给出代码或数据入口。 49
与目标研究线的连接点:与同线其他技能优化工作的差异在于它把「改什么」与「花多少算力去验证这条路径」明确分开,并且把被拒绝与造成回归的结果也写进记忆。可搬走的具体设计有两件:一是原子编辑必须绑定失败样本、反例、行为假设与适用范围,使每次改动可追溯到证据;二是「短前瞻只在严格更优时固化为节点」这条规则,它让局部较差的中间状态仍可被扩展,又不把噪声组合写进技能。 49
结论建议:精读第 3.1–3.2 节(对比式原子编辑的五个字段、STS 的保留与回传规则)与表 3(组件消融);把表 2 的验证到测试增益比当成自进化流程的常规体检项。引用时必须限定:点估计、无显著性检验,且增益随目标模型变化(GPT-5.5 上两个任务反而更低)。 49
4. MMLA-RSI:RTT 改策略、RTMA 改记忆,四候选程序选择的组件实验期望误差降 24.65/36.65 点
MMLA-RSI: Recursive Self-Improvement through RTT and RTMA · arXiv:2610.20294 · 值得扫读
研究问题与核心方法:作者问智能体能否在同一个未解决问题内通过改变「怎么行动」和「保留哪些经验」来自我改进,提出 MMLA-RSI,在 Memory-Mediated Learning Architecture 上给出两条递归实现(RSI,recursive self-improvement,递归自我改进):RTT(Reasoning-Time Training,推理时训练)改变策略状态 Φ,RTMA(Reasoning-Time Memory Adaptation,推理时记忆适配)改变权威记忆 M。两条路都把「改的方法本身」当作被改进对象——当前的数值更新器训练提出其后继的策略,当前的记忆管理器选择后继生成过程可读的记录,独立准入的后继在下一代接管同一角色。RTT 实例改的是裁剪动量更新里的标量调度,RTMA 实例在 NULL 与整行写入(可带驱逐)之间选择。50
关键结果:
- 四候选程序选择(在给定的 4 个候选程序里选,不是自由生成):保留反馈更新使期望误差下降 24.65 与 36.65 个百分点(分别对应静态与适配后的两种初始化);同信息量的直接规则误差为 29.302% / 24.611%,support-loss 选择规则为 0.78125%。该结果来自 16 个参数组、3 个配对训练种子,最终审计未开启(表 3)。50
- 按时间的 CI(持续集成)仓库回放:反馈绑定指标 G=−0.05337(相对 sham 有帮助),而状态保留指标 D=+0.14969(有害);half-Brier 损失(半 Brier 评分,越低越好)从 0.12744 升到 0.18081,对照系统 HEDGE4 为 0.10243。队列为 1 个 NumPy commit 加 71 个 pandas commit,三种子均值只作描述。50
- SParC 交互任务:整交互成功率 18.42%,冻结的六提议基线 20.18%,配对增益 −1.75 个点(97.5% 区间 [−4.39, 0.88]),严格前缀读取任务增益为零。50
- CoSQL 纠错迁移:最终查询成功率 46.965%,冻结基线 47.944%,配对增益 −0.979 个点(97.5% 区间 [−4.247, 1.759]),两臂都没通过各自的在线 Φ 要求;copy-edit、retrieval、search 三条规则分别达 1.824%、5.348%、0.961%。50
证据与局限:作者在 §7 明确写「本报告没有跑任何新实验」,上述四项是组件级证据,不构成两条递归路线或其组合的评估,并称「有益的递归链与发现效率仍待评估」。程序选择只涉及 4 个给定候选、最终审计未开启;CI 回放是仓库局部的回溯队列,三种子均值不构成总体区间;两项 SQL 端点衡量的是固定数据库上的参考执行一致性,不等于通用 SQL 等价。正负效应方向相反(保留在程序选择上降误差、在 CI 上增损失),说明「绑定正确的反馈」仍可能驱动有害学习。引用时务必把 24.65/36.65 限定为四候选程序选择这一组件的效果,不能当成 RSI 的整体收益。50
与目标研究线的连接点:直接落在 B 线「自进化」上,它把可变域切成比「外壳」(harness)进化更窄的两块(策略状态 vs 权威记忆),并把「改的方法本身也在被改」写成带界面的构造,可直接对照同节 AdaRSI 的「先改 harness、再只训不可靠子步骤」:两者都在回答「该改哪一层」,但 MMLA-RSI 停在规范与组件证据,AdaRSI 有端到端任务结果。可搬走的一件东西是把反馈绑定(feedback binding)与状态保留(retention)拆成两个独立量分别测量——CI 上正是这两个量给出相反符号。50
结论建议:读 §2(状态与三条时间尺度)、§5.4–5.8(RTMA 与完整递归算法)、§7 表 3 与附录 B;原文未给出代码或数据入口。引用时必须说明它没有报告新实验,24.65/36.65 是组件级、单任务族结果,且两项 SQL 研究的配对增益为负。50
5. MolLean:8,800 条化学任务上全轨迹修订在 12 项任务全部胜出,最多提升 48.2 个百分点
MolLean: A Process-Verifiable Language for Chemical Reasoning · arXiv:2610.20459 · 值得扫读
研究问题与核心方法:化学思维链(chain-of-thought, CoT)会写出幻觉性的结构与性质主张。作者提出 MolLean:一种以显式分子状态为基础的过程可验证语言——状态由适配器持有,每一步操作都送进基于 Lean 的分层内核,从原始图编辑到化合物变换逐级检查状态转移与断言,被拒绝的动作不改变状态;类型化见证协议(typed witness protocol)把内核可判定的结构检查与外部提供的测量值分开,避免把外部数字当成本地事实。在语言之上给出 MolLean-MCP:一个在生成期间暴露这些转移、检查与读数的有状态工具接口(MCP 指 Model Context Protocol,模型上下文协议,这里是把内核挂上去的工具层),模型据反馈决定下一步动作。三种使用方式:One-pass 一次成稿;Refine 从同一份 One-pass 结果起最多做 8 次整条轨迹修订;MCP 走状态化工具、最多 2 次尝试、每次 30 次计数调用。作者单位是新加坡国立大学。 51
关键结果:
- 主对比用 Qwen3.6-27B,覆盖同一批 8,800 条样例、12 项任务:9 项 S2-Bench 任务(分子生成、编辑与优化类)各 500 条,USPTO-50k(公开化学反应数据集)的正合成与逆合成各 500 条,以及完整的 ChEBI-20(分子与文本描述配对的公开测试集)3,300 条;无效答案与失败的尝试都留在分母里(§3.1)。51
- Refine 相对直接 CoT 在全部 12 项任务上都有提升,幅度 12.0–48.2 个百分点(按各任务的二值成功判定):原子计数 +46.8、键计数 +48.2、添加组分 +44.2;Refine 减 CoT 的配对 bootstrap 区间在每项任务上都排除零(§3.2、Table 1/2)。51
- One-pass 已在 12 项中的 11 项超过 CoT,但正反应预测例外:One-pass 23.6% 低于 CoT 的 35.0%,Refine 把它提到 62.8%(§3.2)。51
- 两种接口互补、按任务分工:MCP 在反应类任务最好(正反应 66.4%、逆合成 27.4%,Refine 为 62.8% 与 20.8%);Refine 在原子计数(88.8% 对 82.6%)、键计数(69.0% 对 56.2%)、QED(药物相似性评分)优化(59.0 对 49.4 的加权分)与 ChEBI-20(33.1% 对 23.5%)上领先(§3.4)。51
- 轨迹「健全性」(soundness,轨迹被内核接受的比例)与答题正确率是两件事:MCP 在正反应上达 98.6%、逆合成 98.0%,接受不等于答对(§3.3、Table 2)。51
- 修订的收益很早就到位:正反应准确率在 k=2 次修订时为 58.0%、k=8 时 62.8%,添加组分在 k=2 就到 100.0%;且恢复多于损失——正反应恢复 207 条、损失 11 条,逆合成 48/2,ChEBI-20 290/33(§3.2)。51
- 小模型同样受益:Qwen3-4B 上原子计数从 CoT 的 15.8 到 One-pass 39.6、Refine 56.8(Table 3)。51
证据与局限:所有协议在同一批 8,800 条样例、同一 verifier 版本上跑,一致性靠配对比较与 4,000 次重采样的配对 95% bootstrap 区间给出。原文未单列局限章节,需自己留意:主结果只用一个模型(Qwen3.6-27B),Qwen3-4B 只跑整条轨迹协议;对照只有直接 CoT 与自身 One-pass,没有和其它化学验证管线(外部工具调用式智能体)比较;「健全性」是轨迹被自家内核接受的比例,不等于与外部真值一致;任务成功判定由各任务自定的二值准则给出。引用风险:12.0–48.2 是跨 12 项任务的区间而不是平均增益;MCP 与 Refine 的胜负是任务依赖的,不能整体说哪种更好。51
与目标研究线的连接点:把「状态可检查、被拒动作不改状态、反馈在生成过程中即时返回」做成工具接口,正是 A 线(工具使用与运行期控制)与第五节(技能与工具设计)能搬走的那一件:内核负责判定不变量,模型只负责提出动作,被拒绝的动作直接给定向反馈而不必整条重来;作者也观察到即时反馈在依赖链长的多步反应里帮助维持引用,而重启式修订适合大改计划。与同节的 AGORA 相比,AGORA 让团队改自己的结构与技能,MolLean 让外部内核否决单步动作,是两种不同粒度的门控。第二个可搬的评测口径是把「接受率」与「任务成功率」分开报告,用来识别「轨迹自洽但答错」的情形。51
结论建议:读 §2(状态、转移粒度、见证协议与健全性定义)与 §3.2、§3.4(Table 1 与 Fig. 2c),附录 C 的案例(改变验证单位、合法编辑却走错方向、修复指代)对理解「修订到底修了什么」最直观。搬用时要把自家任务改写成「显式状态 + 可由外部确定性判定的不变量」;引用 12.0–48.2、66.4/27.4 这类数字时必须说明它们来自化学任务、单一模型与任务自定的成功判定。代码入口:https://github.com/phenixace/Open-MolLean (实测 HTTP 200)。51
6. AdaRSI:只微调不可靠子步骤,RoboCasa365 未见复合任务成功率 4.6%→13.8%,GPU 时间仅 28%
AdaRSI: On-Demand Recursive Self-Improvement for Embodied Agents · arXiv:2610.20474 · 值得扫读
研究问题与核心方法:预训练 VLA(vision-language-action,视觉-语言-动作模型)在未见长程任务中途失败,而既有的具身自我改进要么只改冻结执行器外围的 harness(包在执行器外面的调用外壳:工具、技能与过程编排),改不出缺失的动作,要么见到持续失败就微调执行器(不区分失败出在「怎么调用」还是「能做什么」)。AdaRSI 先让编码智能体改进技能与 harness,再用「从保存状态重试失败子步骤」做失败归因,只微调 harness 精修后仍不可靠的子步骤;训练演示由系统自己采集,并把经验跨任务带到后续任务。52
关键结果:
- RoboCasa365 全部 50 个目标任务(18 个 Atomic-Seen + 16 个 Composite-Seen + 16 个 Composite-Unseen,每任务 50 个场景,执行器为 GR00T N1.5,全程无人类演示):套件级成功率 AdaRSI 48.8%,VLA 单独 42.4%,Agent + harness 46.7%;未见复合任务从 4.6% 升到 13.8%,Atomic-Seen 75.4%→79.7%,Composite-Seen 43.0%→49.0%(表 1)。52
- 层级归因:只让智能体调用 VLA(Agent + VLA)并不稳定提升,Atomic-Seen 反而从 75.4% 掉到 72.2%;harness 开发把三个套件都拉起,Atomic-Seen 到 78.3%,Composite-Unseen 翻倍到 9.9%;权重轮再给 Composite-Unseen 加 3.9 个点,而 Atomic-Seen、Composite-Seen 只加 1.4 与 1.0 个点。52
- 该改哪里的证据(表 3):Composite-Unseen 上用到 32/38 个已训策略、85% 训练时间花在被用到的策略上;已见套件上大部分训练策略从不被调用(Atomic-Seen 12/72、Composite-Seen 8/34)。全量微调(Always train)用 104/118 个策略、3,411 GPU 分钟,是 AdaRSI 966 GPU 分钟的 3.5 倍;与「每个子步骤都微调」相比,AdaRSI 成功率略高而 GPU 时间只用 28%、自采演示只用 22%。52
- 同状态配对测试:执行器 π0 在 18 个厨房里一次都没打开微波炉门,微调策略打开 7 次、平均开启度从 0.01 升到 0.61;而对 π0 本就会做的动作(如把羊角包或果酱放到砧板)微调反而降低成功率。52
- 是否保留智能体在环:把 AdaRSI 最终的 procedure 与策略冻结成固定程序(还额外提供特权状态)只有 6.9% 成功率,AdaRSI 为 13.8%;WaffleReheat 从 38% 掉到 4%、WashFruitColander 从 58% 掉到 28%,但在程序本就固定的 CuttingToolSelection 上固定程序 40% 反而略高于 36%。52
证据与局限:全部实验在仿真中进行,特权的仿真状态让演示生成与标注变得容易,作者自陈真机上要靠成功检测器、脚本复位或偶发人工介入,代价会上升,真机实验留待下一版;原文未报告随机种子数或置信区间,套件级数字是任务级成功率的平均。失败案例也被明确承认:权重轮会采纳只在少量开发场景看起来更好的改动(CuttingToolSelection 从 50% 掉到 36%),仍有任务所有系统都解不开;另外 §5.2 的 Composite-Unseen 起点写作 4.6%,而 §5.3 的消融起点写作 5.9%,两处基点不一致,引用时需注明。52
与目标研究线的连接点:直接落在 B 线的「自我改进该改哪一层」:先动 harness、再按失败归因只训不可靠子步骤,与同节 MMLA-RSI 的「策略状态 vs 权威记忆」是同一问题的两种切法,差别在 AdaRSI 给出了端到端的成本—收益对照(28% GPU 时间、22% 自采演示,全量微调反而成功率略低)。可搬走的一件东西是「从保存状态重试失败子步骤来做归因」这个必要性判据,它比「看到失败就训」多了一层因果筛查。52
结论建议:读 §4.1–4.3(harness 精修、下降到权重、跨轮递归)、§5.2 表 1–3、§5.4 成本;原文未给出代码或数据入口。引用时必须限定为 RoboCasa365 仿真 + GR00T N1.5 执行器 + 无人类演示的设置,48.8% 与 28% 都是该协议内部对照的相对比例,不是通用成功率。52
7. 多智能体处方系统 PRISMATIC:零交互率 98.20%、消融去掉安全检查降至 78.98%
PRISMATIC: Prescription Risk Inspection System for Multi-Agent Treatment Interaction in Clinical Decision-Making · arXiv:2610.19762 · 邻近跟踪
研究问题与核心方法:针对多病共存患者的处方冲突与遗漏,论文提出六智能体架构 PRISMATIC:信息分析(IA)、处方生成(PG)、安全检查(SC)、药理合理性(PR)、评估(EA)、反思反馈(RF)各司其职,经共享黑板协作。双环机制:内环 DFPC(Discrepancy Feedback Precise Calibration,差异反馈精确校准)做单病例的「提议—批评—修订」,只把违规(如药物相互作用)追溯到源域并局部换药,不重跑整份处方;外环 DSWA(Dynamic Self-updating Weight Adjustment,动态自更新权重调整)用最终处方与金标准的差异按维度更新评估权重向量 W,实现跨病例的「组织学习」。 53
关键结果:
- 在 MIMIC-IV Note 与 Hosp 合并数据(按慢病数与用药数用 K-means 分低/中/高三档)上,完整数据集上以 GPT-4o 为基座的 PRISMATIC 得到零交互率 ZIR(完全无药物相互作用的处方占比)98.20%、重叠率 OR 56.81%、精确匹配 EM 13.58%;ZIR 最好一档(DeepSeek-R1 基座)99.20%(表 2)。 53
- 消融研究(GPT-4o,表 3):去掉 SC,ZIR 从 98.20% 掉到 78.98%;去掉 PR,OR 从 56.81% 掉到 44.13%;去掉 DFPC,EM 从 13.58% 掉到 7.42%;去掉 DSWA,EM 掉到 8.56%。 53
- DSWA 的权重演化(图 5,每 500 例一轮)显示 Dosage 与 Coverage 权重上升、Duplication 下降,安全相关的 DDI 与 DPI 权重保持高位。 53
- 绝对 EM 只有 13.58%,作者归因于三类误差:漏掉辅助用药、等效药之间的次优选择、无法利用书面记录之外的隐含临床语境。 53
证据与局限:主要指标对照的是通用大模型与专病模型在相同基座下的输出,但表格只给点值,未报告种子数、重复次数或置信区间,正文「显著优于」属作者措辞。消融只用一个基座(GPT-4o);权重演化是观察性描述,不能读成因果;任务为临床处方,数值不可外推到其它域。 53
与目标研究线的连接点:与同线常见的「训练模型自我改进」不同,这里不训练模型,而是让「评估准则本身」随错误历史演化:把跨病例误差按维度聚合成向量,再按维度重分配评估权重(DSWA),并提供逐组件消融定位贡献。这套机制和「批评—裁决—局部修订」的内环都可搬到自建的多智能体或评审系统里。 53
结论建议:读第 4 节(双环机制)、表 3 消融与图 5 权重演化。可搬 DSWA(维度化误差→重配评估权重)与 DFPC(局部归因修订)。引用时须限定:单基座消融、无统计检验、权重演化为观察性、EM 绝对值很低且任务为临床处方。 53
六、轨迹、信用分配与训练信号
1. CAFT:批评+修正双目标在 8 个设定上平均超只用修正动作 8.4%,WebShop 最差档 31.6→58.9
Beyond Corrected Actions: Training LLM Agents on Textual Critiques · arXiv:2610.19367 · 精读
研究问题与核心方法:多轮工具型智能体的常见训练路径是行为克隆专家轨迹、或用专家改写学生走过的状态,但二者只监督「专家会做什么动作」,不监督「学生为什么错」。作者提出 CAFT(Critique-Augmented Agentic Fine-Tuning,批评增强的智能体微调):先让学生策略在训练任务上自采样轨迹,再由带特权信息(gold 参考动作、评测口径)的专家模型逐轮判定并把错误轮写成一段自然语言批评加一个反事实修正动作;训练时保留学生的错误步在上下文里,另插入一句固定提醒(记作 ρ),让模型同时产出批评与修正动作。作者为 Thomas Zeng、Zelei Cheng、Mingyang Zhou、Sambit Sahu、William Campbell、Genta Indra Winata,机构为 Capital One(AI Foundations)与 University of Wisconsin–Madison。54
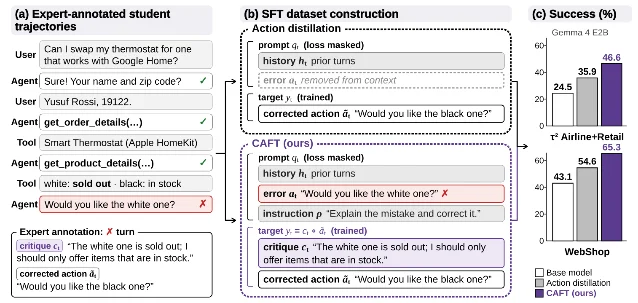
CAFT 总览:动作蒸馏删掉错误步,CAFT 保留错误步并同时训练批评与修正(arXiv:2610.19367)
关键结果:
- 在 4 个学生模型(Nemotron 3 Nano 4B、Gemma 4 E2B/E4B/31B)× 2 个代理域(τ²-Bench 的 Airline+Retail,记 τ² AR;WebShop)共 8 个设定上,CAFT 全部高于仅动作蒸馏(Action Distillation),平均高出 8.4%(Table 1、§3.2);8 个设定中基线与动作蒸馏都最低的一档是 WebShop 的 Nemotron 3 Nano 4B(Base 24.3%),其上仅动作蒸馏 31.6%、CAFT 58.9%。54
- 归一化到同一训练目标后,只训批评的 CAFT-Critique 在所有学生–环境对上高于只训修正动作的 CAFT-Correction,平均高出 5.0%,最大差距出现在 WebShop 的 Nemotron 3 Nano 4B(54.8 对 37.1)(Table 1、§3.2)。54
- 消融专家提示的两类帮助:去掉特权任务信息使成功率平均掉 7.5%,而把详细指导换成最小提示、只要特权信息仍在,性能基本保住(Table 2、§3.3)。54
- 与专家轨迹蒸馏对比:专家模型 Gemma 4 31B 本身在 τ² AR 与 WebShop 上分别为 65.1% 与 53.1%,但蒸馏其轨迹在 WebShop 上塌到 15.0–19.1%,低于全部学生基线(24.3–43.1%);50% 专家轨迹 + 50% CAFT 数据的 CAFT+BC 在 τ² AR 的 Gemma 4 E2B 上反而最高(53.7%)(Table 3、§3.4)。54
- 第二轮迭代在 WebShop 上让每个学生平均再涨 5.3%(Nemotron 3 Nano 4B 涨 10.9%),在 τ² AR 上只有两个小 Gemma 学生小幅提升,Nemotron 已饱和(Table 4、§3.5)。54
- 以 CAFT 检查点做强化学习(RL,reinforcement learning)热身,用 GRPO(Group Relative Policy Optimization,分组相对策略优化)在 τ² AR 上跑 300 步时比基线初始化与专家蒸馏初始化高出约 5%,且约 60 步就追平基线初始化跑满 300 步的最好验证成绩(Figure 2、§3.6)。54
证据与局限:训练细节透明(8 卡 RTX PRO 6000、batch 64、学习率 3×10⁻⁶、τ² AR 训 2 轮、WebShop 训 1 轮),每个评测任务采样 16 次;正确轮的损失权重 λ=0.1 由小规模扫描选出,λ=0.5 会分别掉 7.2% 与 5.6%,完全屏蔽正确轮掉 7.1%。但原文未报告种子数、置信区间与显著性检验,Table 1–4 均为单次结果,8.4% 与 5.0% 只是平均值,不能读成统计显著。原文未给出代码或数据入口(正文与附录中均无仓库或数据页链接)。54
与目标研究线的连接点:它把信用分配从「改动作」推进到「改动作的原因」,与同节轨迹级训练条目互补:可搬走的一件东西是监督数据的构造方式——保留学生的错误步在上下文、只把批评与修正动作作为目标,并用 CAFT-Critique / CAFT-Correction 这一对消融来单独度量「解释」的价值。另一个可搬走的设计是专家提示里要求先标 criticality,避免把每一步都判成错。54
结论建议:读 §3.1(基线定义)、§3.2 与 §3.3(两个核心消融)、Appendix B.4(ρ 与三版目标的逐字模板)。对 B 线可迁移的是轨迹级监督目标的构造与消融设计,对 A 线可迁移的是「专家成功率不等于其轨迹适合蒸馏」这一对照结论;引用时必须限定单一专家模型(Gemma 4 31B)、两个域、无多种子与显著性,且不能把 8.4% 当成普适提升幅度。54
2. 高熵边界分叉 + 段级信用:GSM8K 90.4 对 JustGRPO 89.6,生成 token 少 18.75%–27.83%
ForkGRPO: Efficient Exploration and Fine-Grained Credit Assignment for Diffusion Language Models · arXiv:2610.19408 · 精读
研究问题与核心方法:扩散语言模型(dLLM,diffusion large language model,用迭代去噪而非从左到右生成文本)在强化学习(RL)里有两个痛点:每个 rollout 都从 prompt 独立生成,中间状态的替代续写被探索不足;GRPO(Group Relative Policy Optimization,组相对策略优化)只在轨迹级发一个优势值,同一回复里所有 token 被同等强化。ForkGRPO 取一条参考轨迹,在高熵且落在文本边界的位置分叉,从每个分叉态采多条续写并复用共享前缀,得到两种互补信号:组内相对优势(同一分叉态的兄弟续写之间比较)与蒙特卡洛状态值差(沿参考轨迹的段级信用)。55
关键结果:
- 表 1(生成长度 256):ForkGRPO 在 GSM8K / MATH-500 / HumanEval / MBPP 上为 90.4 / 46.6 / 51.8 / 49.0,直接可比的 JustGRPO(LoRA)为 89.6 / 46.0 / 50.6 / 48.6。55
- 采样预算:表 5 与 4.4 节给出新生成 token 数 5912–6656(JustGRPO 为 4096),但训练更新 100 步对 200 步,归一化后总预算落在 0.7217–0.8125,即少生成 18.75%–27.83% 的 token。55
- 组件消融(表 2,GSM8K,10 次更新 × 5 个种子,均值 ± 样本标准差):ForkGRPO 90.31±0.06,仅组信用 89.69±0.21,仅段信用 89.45±0.29,无分叉的 JustGRPO 88.81±0.53。55
- 分叉位置选择(表 3):「熵 + 文本边界」90.31±0.06 优于只按最大熵(89.67±0.16)、只按随机边界(89.25±0.21)与固定中心(89.10±0.33)。55
- 分配策略(表 4,固定 K+M 共 32 条打分响应):K=3 个分叉态、每态 8 条的最好(90.31±0.06),K=0/M=32 为 89.14±0.38,K=7/M=4 为 89.93±0.11。55
- ForkGRPO-fast 用自适应 rollout(先 4 条 pilot,奖励有差异才扩到 8 条)加稀疏分支重放,训练墙钟时间加速 2.49×(摘要),GSM8K 仍保持 90.3(表 1)。55
证据与局限:主结果每个方法、每个任务只跑一次训练,作者在 Limitations 中明确说跨种子的波动「尚未测量」;那 5 种子、带标准差的消融只是从同一个公开 JustGRPO checkpoint 续训 10 次优化步,不是完整训练,不能直接外推到主表的绝对分数。基座是 LLaDA-8B-Instruct,生成长度固定 256 token,评测只有 GSM8K、MATH-500、HumanEval、MBPP 四个,数学与代码各半,没有长程或工具类任务;表 1 中部分对照方法的数字取自各自论文、且带「改了架构」或「用了更多私有数据」的标注,跨行比较要留出口径差。55
与目标研究线的连接点:与同节 PA1-OPD(arXiv:2610.19601)几乎是同一个问题的两个尺度——两者都在问「哪些中间状态值得拿到监督信号」,ForkGRPO 用终局奖励差的蒙特卡洛估计在 RL 后训练里做段级信用,PA1-OPD 用学生惊奇度在预训练蒸馏里挑监督根节点。可搬走的两件东西:一是「在同一状态上分叉、组内比较」的采样分配方式(它是把有限生成预算花在中间态而不是整条轨迹上);二是 5 种子短续训 + 单组件对换的消融协议,在算力有限时也能把「哪个组件在起作用」说清楚。55
结论建议:优先读 3.1–3.2 节(分叉状态选取与段级优势的定义)、4.3 节的表 2–表 4 与 4.4 节的表 5;对 B 线(轨迹级训练与信用分配)可迁移的是「段级信用 = 状态值差」这一构造和它的采样预算算法。引用时必须限定:主结果是单次训练、单模型(LLaDA-8B-Instruct)、256 token 生成长度,绝对增益在 0.4–1.2 个百分点量级。55
3. 选择性检索强化学习:IdiomKB Zh→En 的 I5(1–5 分习语评委分)从 0.652 升到 0.731
Retrieve What Helps, Only When It Helps: Agentic Reinforcement Learning for Selective Retrieval-Augmented Machine Translation · arXiv:2610.19528 · 精读
研究问题与核心方法:检索增强机器翻译通常对所有输入套同一套相似度检索,而论文认为翻译处在「部分证据」状态:多数句子靠模型参数化知识就够,外部证据只对一部分输入有用,且有用证据常常不是语义最相近的那份文档。SRAT(Selective Retrieval-Augmented Translation)把推理、检索、收尾输出译文当成同一策略下的动作序列:轨迹里的动作分为思考、调用检索器、给出译文三类,用 GRPO(Group Relative Policy Optimization,组相对策略优化)以最终翻译质量(COMET 与 LLM 评委的加权组合)作为轨迹级奖励,让同一输入下「直接翻」和「检索后再翻」的轨迹互相竞争,因此不需要标注哪些输入该检索。为让检索器对齐下游质量而非语义相似度,作者给出两条路:用 Plackett–Luce 排序策略(一种按分数排序采样并给出选择概率的排序模型)把轨迹奖励回传给检索器(联合训练),以及固定翻译器、按候选证据对翻译质量的实测影响做对比学习(翻译质量对比训练)。 8
关键结果:
- 主实验骨架为 Qwen2.5-7B-Instruct,默认检索器 top-k=1,最多 5 轮交互;数据为 IdiomKB(Zh→En 训练 8K/测试 500,En→Zh 4.6K/500)、RAGtrans(En→Zh 74.5K/2K,En→De 85.2K/2K)、Document-MT-LLM(En→Ru 字幕 5.5K/500,唯一用在线搜索引擎、无预置语料的设定)(§4.1)。 8
- IdiomKB Zh→En:SRAT 的 I5(Idiom-Judge-5,习语翻译专项 LLM 评委分:由 IdiomKB 原三级评委 I3 扩出的五级量表,1–5 分、越高越好,原文报数在 0–1 区间,并充当该方法在 IdiomKB 上的 LLM 评委奖励项)0.731、MQM(Multidimensional Quality Metrics,多维质量指标的错误分,越接近 0 越好)−2.74,对照 Direct(不推理不检索)为 0.652 与 −3.94;与同句 MQM 的关系:I5 只判习语喻义翻得对不对、分数越高越好,MQM 记通用翻译错误、越接近 0 越好,两者同为 Claude Sonnet 4.6 评委给出;学到的检索率为 30.6%(Table 1)。 8
- 其余设定的检索率由策略自己定出来:IdiomKB En→Zh 77.0%(I5 0.792、MQM −1.85),RAGtrans En→Zh 52.2%(COMET 0.888、MQM −4.58),En→De 43.0%(MQM −5.98),Document-MT-LLM 在线检索 88.6%(Tables 1、2、5)。 8
- 相对「永远检索」对照 SRAT-A,SRAT 的 MQM 在两个 IdiomKB 方向提升 20.6% 与 17.4%,RAGtrans 为 8.0–12.8%,Document-MT-LLM 为 5.4%;检索率跨设定从 30.6% 到 88.6%,说明策略学的不是固定检索偏好(§4.2)。 8
- 检索器对齐只在相似度不够用时才划算:RAGtrans 默认相似度检索器的检索准确率仅 56.3%(En→Zh)与 72.6%(En→De),对比训练抬到 70.7% 与 81.4%,MQM 相应提升 6.8% 与 7.4%;IdiomKB 上默认检索器已约 95%,训练只到 97–98%,下游收益有限(§4.3)。 8
- 对比训练优于联合训练:RAGtrans En→Zh 的 MQM 从 −4.41 到 −4.27,En→De 从 −5.89 到 −5.54;作者归因于轨迹奖励要摊到很多 token 决策而检索动作只有少数,检索器信用分配方差大(§4.3)。 8
- 黑盒翻译器:冻结 Claude Sonnet 4.6、只训 Qwen 策略决定何时与检索什么,SRAT-Claude 在 RAGtrans 上把 MQM 相对直接翻译提升 12.4%(En→Zh)与 16.8%(En→De),En→Zh BLEU 61.10 对 53.54;而直接提示 Claude 自己决定检索(Claude-Ret)反而变差(IdiomKB Zh→En 的 COMET 0.826→0.821、MQM −0.92→−0.99)(Table 4、§4.4)。 8
证据与局限:BLEU 上 SRAT 低于有监督基线(RAGtrans En→Zh:CSC 55.42 对 SRAT 52.37),作者说明奖励里不含 BLEU 并主张以 COMET 与 LLM 评委为主,因此不能把 SRAT 说成全面最优。原文用「显著」描述检索器对齐的收益,但没有报告显著性检验或置信区间。人工评测由 20 名中文母语标注者完成(作者自陈规模有限),MQM 按固定 LLM 评委协议(Claude Sonnet 4.6)计算,评委本身是测量变量。作者自陈局限还包括语言与领域覆盖有限、检索器对齐绑定特定翻译器(跨模型迁移未验证)、未处理需要融合多来源证据的任务。 8
与目标研究线的连接点:与同节其他轨迹工作相比,这篇的差异是把「要不要用工具」本身做成可学习动作,并直接对比两条信用分配路径(轨迹级 Plackett–Luce 梯度对文档级对比监督),给出「动作稀疏时轨迹奖励噪声大」这一可复用结论——与 PUlSE 正好互补:SRAT 用 RL 学「何时检索」、改的是策略,PUlSE 用内部几何量学「何时检索」、只加一个门控。可搬走的一件东西是检索探索课程:先采样带检索的轨迹并按质量 Q 保留前 40% 做监督微调,把交互格式与提问能力初始化,再用临时检索惩罚把策略推离「永远检索」,最后去掉塑形项直接优化最终质量——它解决了直接上 RL 会塌缩成「从不检索」的问题。 8
结论建议:先读 §3.2(奖励与三阶段课程)与 §3.3(两种检索器对齐),再看 Tables 1–3 与附录 Table 5(文档级在线检索)。引用收益时必须写清指标口径(COMET/LLM 评委/MQM,且 MQM 是负向错误分)与评委模型,并注意 BLEU 方向相反。 8
4. HICO-Bench + PaCPO:Qwen3-8B 可验证成功率 20.4%→28.3%,36% 高分对话计划失败
What Makes a Social Agent's Interactions Effective? Learning from Verifiable Outcomes in Paired Worlds · arXiv:2610.20195 · 精读
研究问题与核心方法:现有社交智能体评测靠 LLM 判官给对话打分,却不检查谈成的计划是否成立。HICO-Bench 让两个各持私有条件(如「我明天能不能到场」)的智能体对话,结束后各自独立填写结构化计划记录,再由规则程序检查可行性 Feasibility(两份记录一致且满足双方私有条件)、由 LLM 判官检查完整性 Integrity(对话支持该记录),两者都过才算可验证成功(Verified Success)。每个场景有两套「世界」,共享公开上下文、只差一个私有条件且两组正确计划不相交,因此对两个世界给出同样回应的智能体至少会在其中一个失败。 56
关键结果:
- 基准规模与题型:180 个配对场景、6 个协调族(资源分配、授权、有界数量、共同排期、共享资源排期、集合同意),划分 96 训练/24 开发/60 测试;每个角色在每个世界分别评测得到 240 个测试任务。 56
- 对话分数与可验证结果背离:13 个模型的可验证成功率从 20.42% 到 82.50%;合并统计里 Goal ≥ 8/10 的对话有 36%(35.99%,即 1,010/2,806)未通过验证。 56
- PaCPO(Paired-Credit Policy Optimization,配对信用策略优化)在同一终局奖励与同等对话数下把 Qwen3-8B 从 20.42% 提到 28.33%,高于 PPO 的 25.00% 与 GRPO 的 26.25%;PaCPO 与 GRPO 的 Feasibility 相同,增益来自 Integrity(表 3)。 56
- 机制:每轮之后在场外问智能体「如果现在结束会记下什么计划」,把两个世界的试探计划互相检查,只在「差异条件已披露」时开门给配对信用,再用势能式奖励重塑把终局奖励分摊到具体轮次,且不改变每条对话的总回报。 56
- 消融(240 测试任务):把另一世界的计划换成同世界第二个计划、或把信用位置打乱,可验证成功率都降到 26.25%;提前开门(不等差异条件披露)降到 25.83%,为最大降幅;完整方法 28.33%(表 5)。 56
- 族间差异大:相对 Base,增益最大的是有界数量 +22.50 个百分点与授权 +10.00 个百分点,资源分配三个方法都停在 17.5%,两个排期族仍难(第 5.3 节)。 56
- 迁移与自博弈:自博弈三次重复下 PaCPO 平均 28.33%,比 Base 高 6.39、比 PPO 高 1.11;在 154 条 MultiWOZ 与 86 条 CaSiNo 上分别小幅提升通信(81.17% 对 79.87%)与议价(归一化 Nash 49.37% 对 45.86%)(表 4)。 56
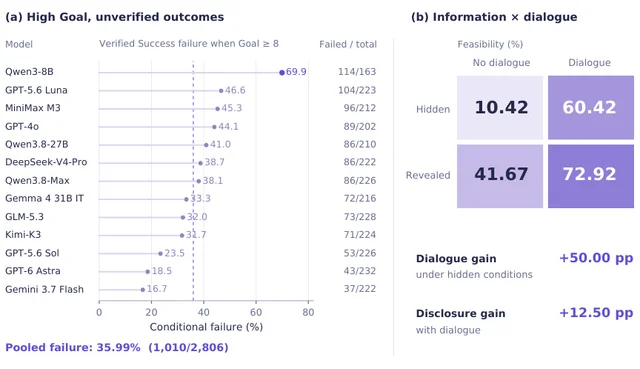
Goal≥8 条件下的可验证失败率,合并虚线为 1,010/2,806(arXiv:2610.20195)
证据与局限:判官效度有报告:240 条重判输出上 Qwen3.8-Max 与 Kimi-K3 对 Integrity 的一致率 90.0%(Cohen κ = 0.78);两位专家标注者的试点中,与 Feasibility 一致 100%、与 Integrity 一致 82.22%,并在 24 对里以 8 比 5 更偏好 PaCPO。局限:主实验是固定伙伴,只有自博弈一栏测试双方同时变;Integrity 始终依赖 LLM 判官;训练用 384 条对话、单一基座 Qwen3-8B,未见种子重复报告;部分族(排期、资源分配)没有可测增益。入口实测:arXiv 全文页 https://arxiv.org/html/2610.20195v1/ 返回 HTTP 200;原文称基准与代码将随发布提供,但未给出可访问的仓库地址。 56
与目标研究线的连接点:与同线的过程监督、VinePPO 一类信用分配工作的差异在于:那些方法要么给每一步打标签,要么从中间状态采样后续;PaCPO 用「配对世界」造出一个可规则验证的对比信号——同一场景的私有条件一变,正确计划就不同,于是「哪一轮真正把条件说清楚了」可以被机器判定。可搬走的是这套构造:为同一任务造两份只差一个私有条件的实例,把终局奖励按「两世界计划是否分化且各自成立」重新分配到轮次。 56
结论建议:读第 3.3 节(Feasibility 与 Integrity 的口径及四种违规)、第 4.3–4.4 节(配对信用与奖励重塑)、表 3 与表 5(基线对照与消融)。搬到自家任务上之前,先确认能造出「只差一个私有条件、正确计划不相交」的配对实例,否则配对信用信号不成立;引用 20.4%→28.3% 时必须限定 Qwen3-8B、384 条训练对话、固定伙伴与含 LLM 判官的 Integrity。 56
5. Stage2 只选 10% 高惊奇度根节点,把 KD 的 Macro 交叉熵收益再提高 48.85%
PA1-OPD: One-Step Prefix-Augmented On-Policy Distillation for Language Model Pretraining · arXiv:2610.19601 · 值得扫读
研究问题与核心方法:常规的预训练知识蒸馏(KD)只在语料前缀上对齐教师的预测分布,而学生自己预测出来的上下文并没有直接监督。PA1-OPD 在每个选中的语料前缀上让学生先采一个 token,再让教师在该后继状态上监督学生的下一 token 分布(前向 KL),从而在保留下一 token 预测与语料路径 KD 的同时,把监督扩展到学生诱导出的状态;实现上用树形注意力共享前缀、可微地复用键值缓存。57
关键结果:
- 主对比(表 1,OLMo2-1B 学生续训约 10B token):Train 后 Macro 交叉熵比 KD 低 2.87×10⁻⁴(Stage1)与 2.29×10⁻⁴(Stage2),折算成「相对 KD 超出下一 token 训练的收益」为 4.65% 与 27.69%。57
- 根节点覆盖度:Stage2 里只保留学生惊奇度最高的 10% 根节点(Top10)时,最终 Macro 交叉熵 2.531635,对照 KD 的 2.532039,超出 KD 的收益比例为 48.85%;而 Stage1 用同样的 Top10 反而低于 KD,为 −5.22%。57
- 根节点打分规则(表 2,50% 覆盖度):按学生惊奇度选根,Macro「超出 KD」为 36.18%,优于按教师优势(教师观测 token 概率减学生概率)选的 29.07%。57
- 去掉与语料路径重合的分支损失后,全部语料上仍优于 KD(表 2 的 Drop coincident 为 44.37/26.58/34.80/37.80,四个数对应 C4/PG-19/Pile/Macro),说明非重合的学生诱导状态本身有用。57
- 增加深度或宽度:PA2(两步顺序采样)与 dual PA1(同根两条独立分支)在 1B token 续训后把 Macro 交叉熵再降 4.38×10⁻⁴ 与 4.56×10⁻⁴,Stage1 的「超出 KD」从 28.99% 升到 40.47% 与 40.94%。57
证据与局限:作者自陈每个条件只跑一次训练,绝对提升很小(10⁻⁴ 量级),需要独立种子复现;评测只覆盖一个师生族(OLMo2-7B 教师 → OLMo2-1B 学生)、两种续训设置、三个留出语料(C4/PG-19/Pile),全部是似然指标,没有下游任务。KD 与 PA1 的目标把标称蒸馏权重分配得不一样,作者承认还没有控制实验把「权重不同」和「监督位置不同」分开;对比按训练 token 对齐而非算力对齐,式 (16) 的状态数也不等于运行时或 FLOP 效率。另:原文未给出代码或数据入口。57
与目标研究线的连接点:与同节 ForkGRPO 是同一设计思想在预训练尺度上的版本:两者都对「哪些中间状态该拿监督」给出可执行的排序规则(ForkGRPO 按熵 + 文本边界,PA1-OPD 按学生惊奇度),也都报告了排序规则之间的对照。可搬走的一件东西是 surprisal 选根的做法本身——它不需要额外前向,直接从下一 token 预测的损失里读出来,因此可以零成本地接到任何「轨迹/状态级采样」的训练循环里做预算分配。差异在于 PA1-OPD 的监督来自教师分布(蒸馏),而非终局奖励。57
结论建议:先读 3.1 节的式 (9)–(10) 搞清楚「分支损失 + 归一化」的定义,再读 4.2 节与表 1、5.2 节与表 2 看覆盖度与打分规则的对照;对 B 线可迁移的是「监督状态预算分配」这套口径(含 extra/KD 这个相对指标的定义)。引用时必须限定:单次训练、单师生族、三个似然语料,且 extra/KD 是相对比例而非交叉熵的降幅。57
6. FACES:非补偿门控奖励融合 + 推理段对齐的 token 级信用分配,cap-15 下 MLLM 均分 3.61→4.04
FACES: Fine-grained Gated Semantic Alignment for Multimodal Emotional Support Conversation · arXiv:2610.20051 · 值得扫读
研究问题与核心方法:多模态情感支持对话(MESC,multimodal emotional support conversation)要求模型结合面部表情等视觉线索推断用户情绪、成因与支持需求。作者指出既有强化学习目标有三处失效:BLEU/ROUGE-L 这类表层重叠指标对跨模态接地与支持意图反馈太弱;加性奖励融合会让强维度掩盖弱策略;完成级奖励缺少对视觉接地、情绪理解、情境归因、策略规划、响应生成各阶段的信用分配。FACES 的做法是:SFT 后先做「格式 + 结果」RL 预热,再用五个维度打分——CLIP 给视觉感知、MiniLM 给情绪、Qwen3-VL-8B 判官给情境/策略/结果(每个候选跑 3 个同义提示变体,1–5 分归一化到 [0,1] 后取平均);融合时三个认知维度取均值,策略与结果作乘性门、格式不合规直接置零(非补偿门控);把各维度分数转成组内秩中心化优势,按 CoT/响应 span 对齐到 token,span 末尾 5 个 token 拿全额优势、更早的 token 乘 0.8 衰减,并用总奖励做正优势门控(下限 0.10);底层是标准 clipped GRPO(组大小 4,clip 0.2)。58
关键结果:
- 在长度控制协议(cap-15,即把响应前缀截断到最多 15 词)下,MESC-FT 测试集上 MLLM 逐点均分从基线 FIRES 的 3.61 升到 4.04(共情 3.06→3.98、多模态适配 3.88→4.03、上下文一致性 3.89→4.11)。58
- 同一协议下的盲对偏好:450 个测试实例中 FACES 胜 361、FIRES 胜 53、平 36,胜率 80.22%(排除平局的双侧符号检验 p<0.001);三个标注员在相同 450 例上给出的人评胜率 75.3%(Fleiss κ=0.62)。58
- 换判官不复现不了这个结论:独立模型族 GLM-4.6V-Flash 在 cap-15 下给 FACES 84.9% 胜率(排除平局后 93.4%)。58
- 同骨干、同 SFT 初始化、同提示下,DPO 3.62、SimPO 3.77、RLOO 3.83,均低于 FACES 的 4.04——增益不是「随便换个对齐目标」就能拿到。58
- 消融:去掉细粒度信用分配退化最大(METEOR 20.62→18.59、BERTScore-F1 87.14→86.02、DIFF-EPITOME 0.3643→0.4902);去掉非补偿门控次之;去掉多源奖励会换回更高的 BLEU-2/ROUGE-L(9.68→10.46、21.09→22.31)但语义与多样性指标下降,正是「表层重叠指标方向相反」的直接证据。58
- 成本要说清:100 个稳定 GRPO 步下 FACES 用 42.2 墙钟小时 / 84.4 GPU 小时,FIRES 17.2 / 34.4,即 2.45 倍;部署时(不用奖励模型)延迟 15.828±2.820 s 对 13.752±2.145 s,输出更长(184.7 对 128.9 token)。58
- 奖励本身可信度有量化:三提示平均把判官维度的 ICC 从 0.74–0.79 提到 0.90–0.92,门控奖励与人评总质量 ρ=0.72(p<0.001)。58
证据与局限:统计口径比同类工作完整:配对比较用 5,000 次 bootstrap(seed 42)、双侧符号检验、人评用 Fleiss κ,跨数据集用配对 bootstrap(p<0.05),并给出双向换位 + 三提示多数投票的判官协议以压位置与提示偏置。主要风险是判官自身:训练期奖励判官(Qwen3-VL-8B)与事后主判官(Qwen2.5-VL-32B)同属 Qwen 系,虽然用 GLM 做了跨族复核,但两族都不是「与人评等价」的证明——人-判官逐例一致率只有 74.7%(MESC-FT)与 71.7%(MELD-ESC300),Cohen κ 分别 0.316 / 0.441,作者自己也写明「支持与人类偏好一致,但不等于判官可替代人评」。人评仅 3 名标注员(另有 1 名裁决者)。视觉输入只用关键帧,作者在局限里承认未建模用户个性化偏好,也承认训练集是 FIRES 构建的 MESC-FT、外部集 MELD-ESC300 是自建的 300 条(人工审核 274 条即 91.3% 合格)。数字层面注意:同一张表里 METEOR/BERTScore/Distinct-3 是越高越好、DIFF-EPITOME 越低越好,标题里的「3.61→4.04」来自 cap-15 的 MLLM 逐点均分,与表 1 的自动指标不是同一个口径。58
与目标研究线的连接点:本篇的领域(情感支持对话)不在四条线上,但它的机制正是 B 线关心的信用分配,而且是「多目标、异质打分器」这一最难的情形。可搬走的具体一件是非补偿门控融合:把认知类维度取均值、把「直接决定成败」的维度作乘性门、格式不合规直接置零,从而不允许强维度替弱维度买单——同节讨论训练信号的条目里,多数还在用加性或加权求和。第二件是把段级优势锚定在 span 末尾(全额)而其余 token 只按固定比例衰减,比按距离连续衰减更容易实现,且作者做了与线性/指数衰减的对照。58
结论建议:读 §3.2 的融合规则(公式 5,含「最终奖励不超过三个因子最小值」的性质)、§3.3 的秩优势与端点锚定、表 2(长度控制的逐点与人评)、表 5(组件消融)、表 7(DPO/SimPO/RLOO 对照)、附录 A.4(奖励可靠性与成本)。引用时必须限定为 cap-15 长度控制协议、MESC-FT 测试集与 Qwen 系判官,并同时给出该判官在本设定下的一致率口径以说明局限。代码与数据入口 https://github.com/OCT-ARR/arr 实测 HTTP 200。58
7. VASPO:特权价值估计加自教师调制,六项数学基准均值比 PPO 高 2.59 / 1.81 个点
VASPO: Self-Distillation with Privileged Value Estimation · arXiv:2610.20516 · 值得扫读
研究问题与核心方法:可验证奖励强化学习(RLVR)只在回答结束后给一个结果奖励,无法说明哪些 token 有贡献;在策略自蒸馏(OPSD,on-policy self-distillation)让“自教师”读着特权信息(privileged information,这里是数据集自带的解法与答案)在学生自己生成的前缀上逐 token 打分,但那种偏好只是局部 token 偏好,不等于学生续写的期望回报。VASPO 让自教师与 critic 读同一份特权信息、各司其职:critic 在学生前缀上预测“无引导续写的成功率”,与验证器奖励一起算 GAE 优势并做 PPO 更新;自教师只通过有界概率比调制其中的正优势。作者先刻画了两类信号的位置画像:特权信息对 critic 价值预测的增益随位置靠后而变大,自教师与基线学生的分歧则开局高、中段低、末段回弹。59
关键结果:
- 六项数学基准(AIME24、AIME25、AIME26、HMMT25 用 avg@32,Minerva 与 OlympiadBench 用 avg@8)的平均分:Qwen3-4B-Instruct-2507 上 VASPO 53.17、DAPO 51.59、PPO 50.58、Vanilla 49.76、OPSD 34.80,即比 PPO 高 2.59 个点;OLMo3-7B-Instruct-DPO 上 VASPO 33.42、RLSD 32.47、DAPO 32.26、PPO 31.61,即比 PPO 高 1.81 个点(表 1)。
- 逻辑推理:Knights and Knaves(avg@16)上 VASPO 平均 60.81 最高,其后为 RLSD 60.34、DAPO 59.88、PPO 59.19、Vanilla 58.30(表 2)。
- 消融(表 3,数学均值 / Knights and Knaves 均值):去掉特权 critic 退化最狠,从 56.28 / 60.81 掉到 35.59 / 23.30(该变体等于退回 OPSD);去掉 token 级掩码为 54.95 / 59.60,去掉 critic 预更新为 55.00 / 58.84,把解法降级为只给答案为 54.59 / 58.91,两支 reader 全去掉为 53.50 / 59.19,额外叠加优势白化为 54.41 / 58.24。
- 融合强度:概率比截断宽度取默认 0.2 时的最终 AIME 准确率高于关掉调制(0)与放宽到 0.5。
- 价值诊断:在冻结 actor 的固定续写上,注入解法的 critic 解释方差(EV,被价值预测解释的回报方差比例)最高、Brier 误差最低,但 ECE(期望校准误差)并非最好,说明点估计变好不等于校准变好。59
证据与局限:单骨干 Qwen3-4B 训 200 步,critic 预训练、评测与训练细节分散在附录 C、D.2、D.4;原文未报告种子数、置信区间或显著性检验,所有比较都是点估计。作者自陈的局限包括:环境反馈在回答结束时才产生,无法回填给同一轨迹更早的前缀;特权解法即使答案正确也可能含错的中间步骤;让 reader 读完整解法会拉长上下文、抬高训练成本;方法目前只针对单轮生成。引用风险是表 1、表 2 的差值都在 1–3 个点量级且无重复实验,不宜当作稳定增益引用。59
与目标研究线的连接点:与只把教师信号挂在组相对优势上的做法(RLSD、SSPO、SRPO)相比,VASPO 的差别是把同一份特权信息同时用于价值估计这条路径,而 actor 全程只看到普通提示。可搬走的一件东西是那条位置画像:critic 的收益随位置靠后而增大、自教师分歧在末段回弹,因此两者不该共用同一种权重——这条画像可直接用来决定自己的自蒸馏信号在轨迹哪个区段加权。59
结论建议:扫读表 3 的消融与第 4.4 节的两段分析(哪类前缀受益、哪类前缀反而变差),方法细节按需查第 3.3、3.4 节。若要把它移到长程任务上,注意作者自己点出的限制:“回答完成才拿到环境反馈”与价值估计的时间对齐、以及单轮生成的设定都还没解决。59
8. 2M 样本、同一份 rubric 兼作过滤器与奖励:PrismaCoder-9B 的 DesignBench 生成分 70.51
PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis · arXiv:2610.20538 · 值得扫读
研究问题与核心方法:多模态代码智能要求生成的程序既能正确运行、结构又好、渲染出来还要像,而执行只给通过或失败、代码相似度不映射视觉输出、任务专用验证器又不能跨格式复用,没有一种现成信号同时覆盖这三点。作者提出 PrismaForge:为每条指令合成一份分层 rubric(评分量表),其中既含可跨样本复用的领域级条目,也含针对该指令的条目,代码级与视觉级分开打分,并按估计难度调整条目数量。同一份 rubric 兼两用:先作文档过滤(总分低于 τ1 丢弃、落在 τ1 与 τ2 之间回炉重写、高于 τ2 保留),再作强化学习奖励(对各 rollout 的 rubric 分做组内标准化,得到 GRPO 的优势项,执行或渲染失败的 rollout 直接得 0 分)。据此造出 PrismaCoder-2M 数据集,并训练 PrismaCoder-9B 与 PrismaCoder-35B-A3B。
关键结果:
- PrismaCoder-2M 共 2M 样本,跨越 12 个以上类别与 10 种编程语言,最大单类是视觉侧的 WebUI 生成 357.1K(占 17.8%),其次是图表转代码 196.5K、图像转 SVG 181.0K。
- 视觉侧:PrismaCoder-9B 在 DesignBench 生成任务上的 LLM Score 为 70.51,高于 GPT-4o 的 58.48 与 Claude Sonnet 4.6 的 67.99;其在 WebCode2M 的 CLIP 视觉分为 90.41,与 Gemini 3 Flash 相同;35B 在 ChartMimic 上低层 83.42、高层 80.69,化学结构 Tanimoto 相似度 97.56 为表内最高,UniSVG 有效性 100.00%。
- 文字侧:PrismaCoder-35B 在 PandasPlotBench 的错误代码率 9.29%(越低越好),而 Gemini 3 Flash 为 3.43%、PrismaCoder-9B 为 10.29%;ArtifactsBench 总体 46.01,高于所有开源基线与 GPT-4o 的 33.54;在 VisPlotBench 的 Mean 上比最好的开源基线高 11.02 分。
- 数据侧消融:把同一个数据池按两种方式各取等量子集微调同一个 Qwen3.5-9B,用 rubric 过滤的子集在每一项基准上都优于用单一整体打分过滤的子集,Vega-Lite 上差距最大(论文表述为最多 24 分)。
- 强化学习的数据选择不用难度标签,而用 rubric 分的组内方差 U_i 挑「策略有时成功、有时失败」的指令:每个域先留出 20K 中等或困难候选,用 5 次 rollout 打分后保留 U_i 最大的 5K 条,从而以更低的 rollout 成本集中在策略能力边界上。60
证据与局限:评测沿用各基准官方协议,但多个基准的指定判官与作者流水线同族(判官是 Gemini 3 Flash、rubric 生成器是 Gemini 3 Pro),跨判官复核只放在 §6.3 与附录;人类对齐研究只抽了 100 个训练样本,绝对分与排序一致性的细节统计在附录 H.2,正文未给区间与显著性。引用风险有三处:这些基准分数混合了尺度不同的量(LLM 判分、CLIP、Tanimoto 相似度、错误率),不可跨列比较;表内 9B 与 35B 在若干视觉指标上互有胜负,本条目标题引用的 70.51 是 9B 在 DesignBench 生成上的单点;「最多 24 分」来自图 5 的柱状差,正文没有给逐基准数值。原文给出项目页 [https://qiushisun.[github.io/PrismaCoder-Home/](https://qiushisun.github.io/PrismaCoder-Home/)](https://github.io/PrismaCoder-Home/](https://qiushisun.github.io/PrismaCoder-Home/))(实测 HTTP 200),声称代码、模型与数据一并开放。60
与目标研究线的连接点:与本线训练信号话题直接相关的可搬走之物有三件:同一评分器既做数据过滤又做 RL 奖励,从而让「留下的样本」和「被奖励的行为」用同一把尺子;刻意用不同模型做 rubric 生成与判分,避免构造偏差在打分阶段被复制;用 rollout 分数的组内方差而不是难度标签来挑训练实例,直接瞄准策略能力边界。差异是它的题目是视觉代码生成而非智能体轨迹,rubric 条目来自模板与指令的合成,不是从轨迹里归纳出来的。60
结论建议:读 §3.1–3.2(分层 rubric 与奖励构造)、§4.3(用方差挑 RL 数据)以及表 2、表 3、图 5 与图 7(rubric 过滤优于整体打分、rubric 判分与人类更一致)。迁移时把「过滤器与奖励同源、生成器与判官分离、按组内方差选样本」三条分开评估,因为它们各自都有反例风险。引用具体分数时要标明判官是否与流水线同族,并说明该指标本身的量纲。60
9. 结构保留的文档级增广:标签迁移胜过 LLM 重标,中文摘要 BLEU 0.276 对 0.165
Structure-Preserving Document-Level Data Augmentation via Discourse Parsing · arXiv:2610.19497 · 邻近跟踪
研究问题与核心方法:同义替换、回译这类数据增广在词/句层面有效,但会破坏跨句的语篇连贯与逻辑,而摘要、问答这类任务恰恰依赖句间关系。本文提出结构保留的文档级增广框架,四步:先用 LLM 做文档级语篇解析,识别句对之间的修辞关系(映射到逻辑因果、对比转折、并列顺序、解释澄清、总结概括、继续扩展六类)并抽取关键短语;再把关键短语替换为语义连贯但话题转移的内容,同时保持原有的修辞结构、句子数量与顺序;然后按句生成增广文档;最后不重新生成监督标签,而是把原文档的句索引对齐迁移到增广后的句子,使句子级监督一一对应。61
关键结果:
- 中文摘要语料(Inp+Con+Aug,即输入+对照+增广三类数据合并训练):本方法 BLEU 0.276 / ROUGE-L 0.400,LLM 重标(Summary Relabeling)0.165 / 0.291,标准 RST 解析器 UniRST 0.174 / 0.282。61
- Newsroom:加入增广把 Inp 的 BLEU 从 0.634 提到 0.775,把 Inp+Con 的 0.686 提到 0.780。61
- IndoSum:Inp+Con+Aug 四项指标全部最好,BLEU 从 Inp+Con 的 0.757 升到 0.782,ROUGE-L 从 0.782 升到 0.799。61
- 抽取式问答:SQuAD 上 Inp+Con+Aug 得 EM 0.731 / F1 0.779,同样配置下 LLM 重标只有 0.370 / 0.515;JaQuAD 上 Inp+Aug 的 EM 最高 0.688,Inp+Con+Aug 的 F1 最高 0.811。61
- 修辞关系不是装饰:去掉关系标签(w/o Relation)后三个数据集全线下降——中文 0.240 BLEU / 0.362 ROUGE-L(全方法 0.276 / 0.400),Newsroom 0.618(全方法 0.780),SQuAD EM 0.570(全方法 0.731)。61
- 只允许相邻句作先行语(Adjacent-only)在 SQuAD 上 EM 0.573 / F1 0.591,F1 反而低于去掉关系的 0.615,说明「局部修辞标签 + 自由先行语选择」两者都需要。61
- 标签迁移有效性经人工抽检:中文摘要 100 条中 96 条有效,SQuAD 100 条中 89 条有效;语篇关系跨语言核验(中/英/印尼/日各 100 对句对)准确率 81% / 78% / 71% / 74%;四语各 50 条(共 200 条)的增广质量人评为流畅 4.11、连贯 3.93、语篇结构保留 3.86(满分 5),81.5% 保留了主要修辞关系。61
- 增益不只属于生成模型:判别式问答模型同样受益,RoBERTa 从 0.633/0.775 升到 0.653/0.795,ELECTRA 从 0.624/0.775 升到 0.659/0.798(EM/F1)。61
证据与局限:与「LLM 重标」的对照是本文最有用的一处——它把「增广文档质量」和「监督标签可靠性」分开,用同一配置下的 BLEU/EM 差距说明重新生成标签会引入额外噪声。局限:增广器与所有 LLM 基线都用 Qwen2.5-7B-Instruct,下游微调用 Qwen2.5-3B-Base(LoRA rank 8),单一模型族,结论能否跨到更大模型未验证;每个数据集只采 2,000(摘要)/4,000(问答)条输入并生成等量增广数据,规模偏小;关系跨语言核验只有四种语言各 100 对句对、质量人评每种语言 50 条,样本量小;原文未报告种子数、重复次数或显著性检验,所有比较都是单点数值。表 1/表 2 中 MixSumm、回译等方法在中文语料上整体偏弱,读者不宜把它当作这些方法的普遍水平。61
与目标研究线的连接点:它不在四条线上,但给出了合成训练数据管线里一条可以直接搬走的纪律:增广之后不要再用 LLM 重新生成监督标签,要对齐原结构并迁移原标签。散文式的证据链很硬——同一配置下 LLM 重标在中文摘要上 BLEU 只有本方法的六成(0.165 对 0.276),在 SQuAD 上 EM 只有一半(0.370 对 0.731),而且关系标签一旦去掉增益就明显缩水,说明「保留结构」是增益来源而不是增广本身的副作用。对 B 线的自造数据与对 A 线的长任务合成轨迹,都可以照搬「结构保留 + 标签对齐迁移 + 用重标法作对照」这套三件套。61
结论建议:读 §3 的四步方法、§4.2 的六种训练配置与基线设置、§6.1/§6.3 的关系消融与标签迁移有效性抽检、表 1 与表 3。引用时必须说明增广器与下游模型同属 Qwen2.5 系列、规模为数千条、且无显著性检验。原文未给出代码或数据入口。61
七、自蒸馏、后训练与能力保持
1. LALM 后训练增益多来自文本捷径:MMAU 准确率增益 +14.8 点、静音 +11.2 点,去选项后剩 +2.3 点
What Does LALM Post-training Learn? Rethinking Audio Understanding and Reasoning Capabilities · arXiv:2610.19476 · 精读
研究问题与核心方法:大型音频语言模型(LALM,large audio-language model)后训练在音频理解与推理基准上普遍涨点,但这些涨点可能是对题型(尤其多选题)的适配而非听能力的提升。本文用受控评测拆开两者:同一模型分别用真实音频与等长静音(silence)评测,并分别用多选题与开放式(去掉选项、由 LLM 判官判等义)评测,再用「全程静音训练」验证训练期音频是否必要。作者来自台湾大学、英伟达、独立研究者与台湾大学 AI 核心中心(NTU AI-Core)。6
关键结果:
- 音频增益 ΔAcc^a(后训练模型在标准即含音频的评测下相对基座的准确率提升)与静音增益 ΔAcc^s(把音频换成等长静音后仍保留的准确率提升)高度同步,单位都是 MMAU/MMAR 准确率的百分点:Qwen2-Audio-7B-Instruct 上 GRPO 的 MMAU 音频增益 +14.8 点,静音条件下仍有 +11.2 点;同一模型在 MMAR 音频增益 +7.2 点、静音增益 +4.9 点。反向也成立:静音增益接近零的配置(Qwen2.5-Omni-3B 上的 RFT)音频增益只有 0.9%。6
- 训练期音频也非必需:把全部训练音频换成静音后,Qwen2-Audio-7B 的 GRPO 在 MMAU 上仍保留约一半增益(14.8 降到 7.6 点),MMAR 保留更少且方差更大。6
- 增益几乎不跨题型:开放式评测下 Qwen2-Audio-7B 上 GRPO 与 VCRL 的 MMAU 音频增益从 +14.8、+12.4 点掉到 +2.3、+2.1 点,GRPO 的静音增益从 +11.2 点掉到 +0.8 点;开源模型同样骤降(Audio-Reasoner 的音频增益从 +20.5 点掉到 +1.3 点;R1-AQA 从 +23.4 点掉到 −0.9 点)。把训练也改成开放式(消除训练/评测格式不匹配)并未恢复增益:开放式 GRPO 的 MMAU 音频增益只有 +2.0 点。6
- 一部分增益来自学会遵守多选格式:Qwen2-Audio-7B 在 MMAU 上给出选项外答案的比例从 17.2% 降到 7.6%(GRPO 后),而错误选项比例只从 37.6% 降到 32.4%;Qwen2.5-Omni-3B 的选项外比例从 7.5% 降到 2.0%。6
- 训练与评测设置:12,267 条多选题音频 QA(7,129 个片段、17.4 小时,来自 AudioSet、Medley-solos-DB、DailyTalk),分为 10,446 条训练与 1,821 条域内留出;四种后训练方法(SFT、RFT、GRPO、VCRL)共用 200 步 LoRA 配方与同一奖励,两个基座模型、三个随机种子;评测 MMAU test-mini 与 MMAR 各 1,000 题。6
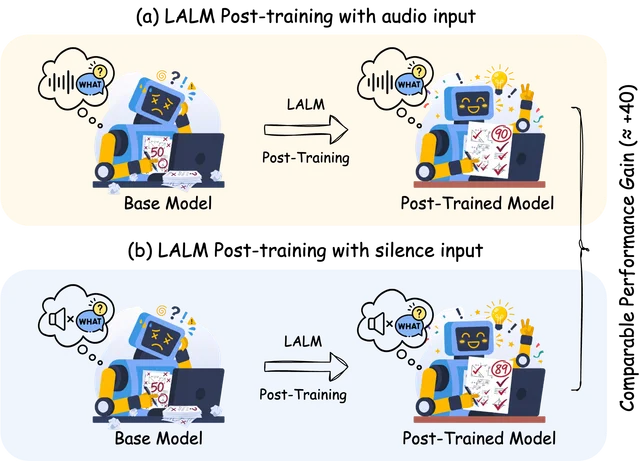
同一后训练配方在真实音频与静音两种输入下取得相近增益(arXiv:2610.19476)
证据与局限:增益按三个种子的均值报告并带标准差(如 +14.8±1.3、静音 +11.2±0.4);开放式评测由 Qwen3.6-27B 判官判定,全文 132,000 次判定;覆盖两个基座模型、四种方法与六个开源模型。作者自陈这是有限样本,其他架构、规模或基准可能不同,只主张「这个差距在独立开发的模型上一致偏小」,未主张处处发生。需注意:静音控制保留音频 token 长度,只去掉信息,因此不能排除长度本身是线索;开放式改写规则只触及 1,000 题中的 172 题(MMAU)与 407 题(MMAR)。6
与目标研究线的连接点:与本单元 2610.19789 共用同一个方法论靶子——涨点来自方法还是评测口径;但本文把这一问拆成可执行的三层控制(静音评测、静音训练、去选项评测),这是本单元最可直接搬用的一套对照设计。它与 2610.19268 的等义变体控制互补:那篇查评分器口径,这篇查输入模态与题型口径。6
结论建议:读第 5 节(静音控制,表 1–4)与第 6 节(题型控制,表 5–8),其中表 6 的多选/开放式两列对照最省时间。可迁移的是:任何多模态或工具类涨点,先报一组模态缺失与格式对齐的对照。引用时必须限定数字来自 MMAU 与 MMAR 两个基准、两种基座模型与统一的 200 步 LoRA 配方,不能当成某方法的通用有效性。6
2. INTACT:冻结主干上前置 16 个潜向量,GSM8K 75.8%→79.3%,每题时延 4,180→3,386 ms
INTACT: Inducing Latent Reasoning on a Frozen Backbone · arXiv:2610.19568 · 精读
研究问题与核心方法:可见思维链把推理写在自然语言里,每个中间 token 都要自回归解码,成本随推理深度上升;而现有潜推理(latent reasoning,用连续向量代替部分文字步骤)方法多数要同时更新主干权重,在强模型上有侵蚀既有能力的风险。作者提出 INTACT:主干语言模型全程冻结,只训练一个 107M 参数的小编码器,读取冻结模型的末层隐状态,依次生成 K=4 个潜块、每块 c=4 个向量(共 16 个潜位置),插在问题之后,之后由冻结模型自己写出剩余推理与答案。训练分两段:第一段「渐进替换」用 KL 蒸馏(蒸馏即让学生分布逼近教师分布)让第 i 个潜块复现第 i 个文字推理步的效果,并在 i=K 时加一项 on-policy 保持损失,把自由生成下的行为拉回未干预模型;第二段用组内相对优势的策略梯度按答案正确性继续调编码器。
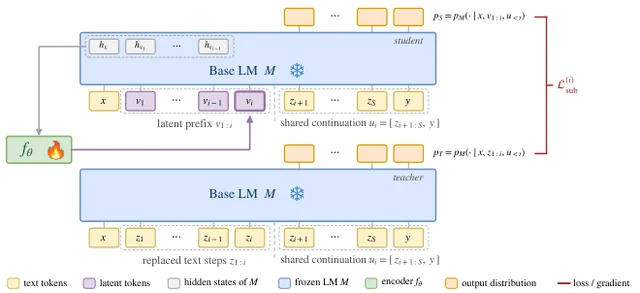
INTACT 第一阶段:编码器读冻结模型隐状态产出潜块,与教师参考步骤做替换蒸馏(arXiv:2610.19568)
关键结果:
- 主表(表 1,数学训练集 GSM8K-Aug 即 GSM8K 的增强版,768 token 生成长度上限,精度取 3 个编码器种子的均值):Llama-3.2-3B 的 GSM8K 从冻结的 75.8% 升到第一段 77.9%、第二段 79.3%,域外(SVAMP、GSM-Hard、MultiArith 的宏平均)从 66.5% 到 69.1%、68.8%;Llama-3.1-8B 从 72.3% 升到 83.7%、83.6%,域外从 53.9% 升到 71.1%、72.1%;Qwen2.5-3B 从 77.6% 到 78.0%、79.7%,域外 74.6%→75.0%→75.1%;1B 上第一段在 GSM8K 几乎持平(44.2% 对 44.0%),域外提升 3.5 个点。
- 与同时更新主干的方法对比(表 2):1B 规模 INTACT 低于 Aug-SFT(48.7/54.5 对 61.6/60.5);到 3B 反超,比最强的已发表潜推理基线高 9.3 与 4.7 个点,比 Aug-SFT 高 7.8 与 6.7 个点;8B 与 Qwen2.5-3B 上对 Aug-SFT 的优势继续(83.6/72.1 对 74.2/67.0;79.7/75.1 对 74.8/69.5)。相对冻结主干的增益在 8B 上为 GSM8K 提高 11.3 个点、Qwen2.5-3B 上 2.1 个点。用原生对话模板评测时 8B 冻结模型升到 78.4%,仍低于 INTACT 两个阶段。
- 效率:Llama-3.2-3B 以 211 个位置达到 79.3% 精度,冻结模型是 261 个位置对应 75.8%;8B 的生成 token 从冻结的 754 降到第一段 269、第二段 182。端到端时延在完整 GSM8K 测试集、单卡 H100 NVL、batch size 1 下从每题 4,180 ms 降到 3,386 ms,即降低 19%(已含潜前缀构造成本 127.5 ms);解码成本反而从 16.03 升到 16.67 ms/token,靠少生成 65 个 token 抵消。
- 多域泛化(表 6,Llama-Nemotron 混合语料训练一次,只训 Llama-3.2-3B-Instruct,2,048 token 上限,12 个留出基准的宏平均):数学 68.8%→70.4%→71.1%、科学 57.4%→69.1%→73.6%、常识 42.6%→49.3%→61.6%;单训练常量的「固定前缀」对照在第二段只有 70.9%/64.6%/48.5%,说明增益不是学到了一段通用提示。单基准最大提升是 ARC-Challenge 的 22.5 个点与 HellaSwag 的 23.8 个点;与允许改主干的 Nemo-SFT 相比,科学低 1.0 个点、数学低 2.5 个点、常识高 6.2 个点。
证据与局限:精度明确报 3 个编码器种子的样本标准差(如表 2 中 ±1.3、±0.4 这类),但 token 计数只在初始化第二段的单个种子上测,消融与对照也只用单编码器种子,这两类数字的方差原文未报告。作者自陈三条局限:潜块无法直接解释为它替换掉的文字步骤;主干仍自回归解码,所以更短的生成不必然带来成比例的墙钟收益;INTACT 保留语言空间推理,因此仍比把推理压成极少 token 的方法更贵。引用风险:基线里 CODI、MUX、LOTUS 用的是各自来源协议(含复现),部分数值直接引自原论文,跨行比较要注意口径不一;原文未给出代码或数据入口。
与目标研究线的连接点:这是「后训练 + 能力保持」的一个干净样本——不改主干、只训一个接口编码器,并用一段 on-policy 保持损失显式约束「干预后的行为要贴近未干预模型」,这套「冻结主干 + 小模块 + 保持项」的组合正是要长期跑自进化管线时避免能力漂移的可搬动做法;第二段用组内相对优势做答案级强化,也提供了「接口模块本身可以被 RL 优化」的先例。与同节的 Wenyan Thinking(arXiv:2610.19741)形成对照:一个改的是推理的空间(连续向量),一个改的是推理的语域(文言文),但都在追求「更短推理 + 不掉精度」。
结论建议:精读第 3.2 节(渐进替换与 on-policy 保持两项损失的定义)与第 4.2、4.3 节,重点看表 1、表 2 与表 6;1B 上被打败、3B 起反超这一「规模门槛」是引用时必须写清的条件。若要迁移,先搬「保持损失 + 分阶段训练」,再考虑是否值得为每篇论文单独训一个编码器(原文每个主干各训一个)62
3. 自蒸馏现实检验:10 种方法与 GRPO 在四个基准上对比,132 次训练无一种方法稳定胜出
More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning · arXiv:2610.19789 · 值得扫读
该文 arXiv 未提供 HTML 全文(
https://arxiv.org/html/2610.19789v1/ 返回 arXiv 的「No HTML for '2610.19789v1'」提示页),以下只到摘要层。5研究问题与核心方法:智能体强化学习(agentic RL)里的自蒸馏(self-distillation:用模型自身的输出或信号构造训练目标)方法越来越多,但既有评测常直接复用已发表基线的分数、实验条件不一致、同期方法之间缺少直接对比,也少报训练稳定性与算力成本。本文把 10 种代表性方法与 GRPO(Group Relative Policy Optimization,组相对策略优化,一种无需价值网络的 RL 算法)放进同一套条件比较:ALFWorld、ScienceWorld、Search-QA、WebShop 四个基准,三种模型规模,除最终任务表现外还看训练过程、稳定性与实测算力成本。作者为 Linhao Zhong 等 10 人(abs 页未列机构)。5
关键结果(以下均只到摘要层):
- 规模:132 次训练运行、合计记录 12,124.4 H800 GPU 小时;对预训练基座与全部 11 个训练后模型都用 8 个 rollout 种子重复评测。5
- 结论一:相对 GRPO 的增益范围有限,没有任何一种方法在所有设置下稳定优于 GRPO。5
- 结论二:最终表现好可能掩盖训练不稳定。5
- 结论三:增加的训练成本没有稳定转化为更好的表现。5
证据与局限:只到摘要层,摘要给了运行次数、GPU 小时与重评种子数,但没有每种方法的具体分数、稳定性的度量定义、成本口径(是否含评测)与统计检验,这些须回原文核对(v1 提交于 2026-10-14)。引用风险:不要在未读原文表格的情况下引用某方法的具体排名;「8 个 rollout 种子」是评测重复次数,不等于每种方法的训练重复次数。入口:项目页 [https://aim-[uofa.github.io/Self-Distillation-AgentRL/](https://aim-uofa.github.io/Self-Distillation-AgentRL/)](https://uofa.github.io/Self-Distillation-AgentRL/](https://aim-uofa.github.io/Self-Distillation-AgentRL/))(实测 HTTP 200)。5
与目标研究线的连接点:直接落在后训练/自进化与训练成本核算上;它与本单元 2610.19476 是同一判据的两种用例——那篇问音频后训练到底学到了什么,这篇问智能体自蒸馏到底多有效,两篇都提示「训练稳定性」是该线常被漏报的维度。可搬走的一件:把「多方法 × 多基准 × 多规模 × 重评种子」并列,并把 GPU 小时与稳定性作为一等结果报告。5
结论建议:等拿到全文再引用具体分数;现在可取用的是它的对比框架(132 次运行、8 个评测种子的成本量级)与三条负面结论的提法,适合作为「自蒸馏增益需要复现」的一手引用。5
4. RDD 把多条 CoT 蒸馏成隐式分布:S=6 预算下 pass@512 六基准全胜点值基线,MATH500 达 43.4
Rationale Distribution Distillation via Flow Matching for Distributional Continuous Latent Reasoning · arXiv:2610.19871 · 值得扫读
研究问题与核心方法:连续隐式推理把中间推理压进连续状态以省掉逐词元生成,但点值式方法只在一个固定理由上重复解码答案,限制了路径探索与答案覆盖。作者提出理由分布蒸馏(RDD,Rationale Distribution Distillation):为每个问题采集多条答案正确的文本思维链(CoT,chain-of-thought),把每条按位置加权池化压成固定长度 S 的隐序列,再用查询内 mixup(在同一问题的两条正确理由之间按共享权重 λ 插值)扩充目标,最后用流匹配(flow matching)把这些目标蒸馏成一个以问题为条件的连续理由分布;采样出的隐理由经上下文器转成键值(KV,key–value)缓存,由冻结的语言模型自回归解码答案。作者为 Mingyeong Kim、Gyusang Cho、Juho Lee、Giung Nam,机构为 Korea Advanced Institute of Science and Technology。63
关键结果:
- 主结果(GPT-2-0.1B、GSM8K-Aug 训练、理由预算 S=6,单元格为 pass@512 / pass@1):RDD 在六个基准的 pass@512 上全部超过同预算的点值基线,高级数学三项为 TAL 44.4、MATH500 43.4、Gaokao23 31.5,对照 CODI 33.5/30.7/21.1、PCCoT 38.9/35.6/17.5、MUX 37.1/38.0/28.3(Table 1)。63
- 但 pass@1 并不占优:MUX 在 MATH500 的 pass@1 为 2.2,RDD 为 1.5;LOTUS 在 GSM8K 的 pass@1 为 49.6,RDD 为 40.5;文本 CoT 参照为 89.5/47.5(Table 1)。63
- 与分布式基线相比:蒙特卡洛 dropout 的 CODI_(MCD) 在六基准上都低于 RDD(如 GSM8K 65.0 对 78.6);随机化权重的 CoT_(SST) 在算术三项领先,但平均理由位置数远高于其它方法(Table 2、§4.1)。63
- 多路径监督的作用:同一套多条正确 CoT 监督下,点值式的 CODI 在算术三项平均 pass@512 从 52.3 微降到 52.0,但在高级数学三项从 28.4 升到 37.0;RDD 用同样监督在两组上分别达到 54.7 与 39.8(Table 3、§4.2)。63
- 消融(GPT-2-0.1B,算术三项/高级三项平均 pass@512):去掉 mixup 为 52.6/36.2,λ∼Beta(2,2) 为 54.7/39.8;双向注意力 52.1/38.5 低于因果注意力 54.7/39.8;函数评估次数 NFE=3 的 pass@512 与 NFE=6 相当而流程评估减半(Table 5)。63
- 对齐性探针:在 10,000 组(问题、两条步数与长度对齐的正确理由)上,用原理由得 100% 准确率、查询内中点插值得 99.99%、把其中一条换成别的问题的理由则掉到 44.33%,支持只在同问题内插值的做法(§4.2、Appendix B.3)。63
证据与局限:主比较建立在 GPT-2-0.1B 这一常见隐式推理装置上,1.7B 骨干(SLM-2-1.7B、GSM8K-Aug-NL)的补充结果里 RDD 仍优于各隐式基线,但与文本 CoT 及 CoT_(SST) 的差距普遍更大,作者归因于更长自然语言理由压进 6 个隐位置。评测只用 pass@512 与 pass@1 两个口径,外加 JSD(Jensen–Shannon divergence,JS 散度)与 TSC(teacher support coverage,教师支撑覆盖)两项分布保真度指标,原文未报告多种子重复或置信区间。原文未给出本方法的代码仓库;附录 C.1 表 6 只列出所用模型与数据集的 Hugging Face 入口,其中训练数据页 https://huggingface.co/datasets/whynlp/gsm8k-aug 实测 HTTP 200(该数据集卡未声明协议)。63
与目标研究线的连接点:与同节自蒸馏类条目相比,它把蒸馏目标从「一条最好的轨迹」换成「多条正确轨迹的经验分布」,可搬走的两件东西是:查询内 mixup(在同一问题的多条正确理由间插值,扩充参考分布而不丢原目标)与以覆盖率为口径的评测(pass@k 曲线 + JSD/TSC 保真度),后者特别适合评估采样式推理是否真的拓宽了答案覆盖。63
结论建议:读 §3.3–3.4(目标构造与三类监督)、§4.1 与 Table 1–2(主结果与分布式基线)、§4.3(消融)。对 C/D 线研究的迁移价值在于「覆盖率口径 + 分布保真度」这一对指标;引用时必须限定骨干规模(主结果仅 0.1B)、口径(pass@512 是 k 次独立采样的覆盖率,不是单次能力),并注意 pass@1 上 RDD 常低于 MUX,不能笼统写成「全面更优」。63
5. DAGFormer:全局拓扑预测让 WikiText-2 NLL 低 0.18–0.29,1B/5B token 胜 1B/10B
DAGFormer: Global Topology Prediction for Transformer Cross-Layer Connections · arXiv:2610.19625 · 邻近跟踪
研究问题与核心方法:标准 Transformer 的跨层连接由残差流固定,动态路由方法(hyper-connections、mHC、MUDDFormer)都是每层自带路由器、逐层贪心决定读谁。DAGFormer 改成一个共享的因果编码器(拓扑预测器)只读输入 token,一次性为所有层输出连接矩阵:每个注意力头的 Q/K/V 与层残差都从更早各层输出的加权混合中得到;每层再用一个零初始化的局部细化项按头修正计划,预测器与主干从零联合训练。 64
关键结果:
- 在 75M、150M、300M、1B 四档匹配 OLMo-2 对上(相同主干、数据、token 预算与优化器),WikiText-2 的负对数似然 NLL 比 vanilla Transformer 低 0.18–0.29,即困惑度低 17%–25%(表 1)。 64
- 1B DAGFormer 用 5B token 训练的损失低于 1B vanilla 用 10B token 训练的损失(约同等训练算力),在 WikiText-2、MathInstruct、GSM8K 上一致(第 4.1 节)。 64
- 与四个同数据同预算的路由基线相比,DAGFormer 在 75M、300M、1B 取得最低困惑度;150M 上 MUDDFormer 低 0.04 nats(表 1)。 64
- 下游与指令微调一致领先:13 个任务的平均准确率在 300M 与 1B 上高 2.0–2.5 分,比最强路由基线高 0.7–0.8 分;AlpacaEval 对 vanilla 的胜率 0.63–0.70,高于所有路由基线(表 2、表 3)。 64
- 结构化剪枝(在 MathInstruct 域微调期间按一阶 Taylor 重要性逐步移除注意力头与 MLP 通道,路由器从不剪)中:50% 稀疏度下 DAGFormer 在每个规模降幅都最小,70% 下在 150M 与 300M 最小,六个设定里五个降幅最小(表 5)。 64
- 消融显示增益主要来自预测器:只看 token 的预测器单独就恢复约 90% 的增益,加细化项后在所有留出集上最好;换成逐层独立预测器只能恢复不到 80%,且多 7M 参数(第 4.2 节)。 64
证据与局限:作者自陈:除 300M 的配对以外全是单种子,第二次预训练种子会让同一模型的留出 NLL 变化最多 0.08 nats,因此更小的差距落在噪声里;剪枝格子也是单次运行;路由使每 token FLOPs 为 vanilla 的 1.18–2.13 倍(75M→1B),预填充时间 1.5–1.9 倍;1B 基线只在 5B token 上训练;判官只有单个 LLM。补充一条引用风险:训练好的模型依赖细化项的逐 token 修正,不重训无法换成固定拓扑。入口实测:arXiv 全文页 https://arxiv.org/html/2610.19625v1/ 返回 HTTP 200;正文只列了数据与软件的许可证与算力,未给出代码仓库或权重下载地址。 64
与目标研究线的连接点:可搬走的是「能力保持」的测法:把结构化剪枝放在域微调内部做,用相对未剪模型的损失增幅(表 5 的 damage)而不是绝对损失来比较不同架构的退化速度,并用「冻结路由器或预测器」这个对照排除「靠重新规划才撑住」的解释。另一个必备对照是参数匹配:给 vanilla 加宽或加层补齐路由参数量,看增益还能剩下多少。 64
结论建议:做自进化与后训练的人读第 5 节与表 5、表 23(冻结路由对照)最划算,做架构的人读第 2 节与表 1、表 4。引用 17%–25% 与「1B/5B 胜 1B/10B」时必须限定为 75M–1B、单种子、且路由算力已计入的比较。 64
6. 23 个方向均分 4.60:14B 学生用在线策略蒸馏追平 4.63 的 GPT-5.5
Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation · arXiv:2610.19758 · 邻近跟踪
研究问题与核心方法:机器翻译系统不仅要译得准,还要服从细粒度指令(语气、术语表、JSON/HTML 等结构化格式),本文是 WMT2026 通用机器翻译任务的系统报告,给出四阶段流水线:领域对齐的继续预训练 + 监督微调(CPT+SFT)→ 把离线 M2PO(Multi-Perspective Multi-Pair Preference Optimization,多视角多对偏好优化)改成在线版本(当前策略自采候选、LLM 判官打分、组内两端配对)→ 在线策略蒸馏(OPD,on-policy distillation,在学生自己采出的轨迹上做 reverse KL,把 Qwen3-32B-Instruct 教师的指令遵循能力搬到 14B 学生)→ 结构感知推理与选择性修复。65
关键结果:
- 表 2(23 个官方方向,1–5 分绝对评分,指令遵循与翻译质量分开打分):本系统总均分 4.60、整体通过率 87.7%,对照 GPT-5.5 与 Qwen3.7-Max-Think 同为 4.63(通过率 88.7% 与 88.9%),Gemini-3.1-Pro 4.59。65
- 分维度:本系统指令遵循 4.49(通过率 83.4%),与 GPT-5.5 的 4.49/83.4% 持平;翻译质量 4.71(92.0%)高于 Gemini-3.1-Pro 的 4.70(91.1%)。65
- 累积消融(表 4):未适配的 Qwen3-14B 在指令型翻译 prompt 下指令遵循只有 1.14(通过率 0.6%),CPT+SFT 后升到 4.08(69.5%);在线 M2PO 主要抬翻译质量(4.23→4.55);OPD 把指令遵循从 4.13 提到 4.38(通过率 76.8%→82.1%);后处理再提到 4.49(83.4%)。65
- 后处理的代价很小:在 en-zh_CN 上只改动了 945 条假设中的 31 条(3.3%),其中 7 条做确定性代码围栏修复、24 条经两轮复核后选择性重写。65
- 3.3 节的逐方向结果指出两个弱区互不重合:指令遵循最差的是 en→et 3.77、en→ru 3.97、en→cs 3.99、en→de 4.29(这些也是最大的测试集);翻译质量最低的是 en→se 4.12、en→lld 4.24 等低资源新方向。65
证据与局限:全部分数由单一 LLM 判官(DeepSeek-V4-Pro,temperature 0)产出,提交时官方 WMT26 人工评测结果尚不可得,因此没有任何人工对照;没有报告任何维度的置信区间、重复次数或误差棒,逐方向表也未给样本量(只说最大方向超过一千条)。基线与本系统同由单一判官按同一协议给出,基线分数亦属自测自报,跨系统比较需谨慎。这是系统报告而非方法论论文,四阶段里每一段的消融都只有一次运行。65
与目标研究线的连接点:不在四条线上,但有两件可搬的东西。第一件是 OPD 的监督位置:训练轨迹由当前学生采样、教师只在学生真正走到的位置给 token 级 reverse KL,这与本节之外那篇 PA1-OPD 的「学生诱导状态」是同一动机,区别是这里监督的是指令遵循行为而非翻译似然。第二件是评测口径:把「指令遵循」与「翻译质量」拆成两个绝对分维度各自报均值 + 通过率(≥4 的比例),并在结论里明确两者失败的方向并不相同——这套「两个维度分开报告、并检查失败集合是否重合」的做法可以直接搬到生成式音频/播客的节目级评测里。65
结论建议:读 2.3–2.4 节(在线 M2PO 的配对构造与 OPD 的 reverse KL 目标)和 3.4 节的表 4,看四阶段各自的增益落在哪个维度;对 B 线可借鉴 online 化偏好优化与 OPD 的组合,对栏目自身的评测设计可借鉴双维度判官口径。引用时必须限定:分数由单个 LLM 判官给出、无人工与置信区间支撑,4.60 与 4.63 的差距在报告口径内不构成可靠排序。65
7. 改成原子事实条件合成:源事实覆盖率由 77.0% 提到 85.1%,7B 的 PopQA 23.06%→29.80%
AFCS: Atomic-Fact-Conditioned Synthesis for Factual Knowledge Pretraining · arXiv:2610.20086 · 邻近跟踪
研究问题与核心方法:现有多数知识语料合成方法以「源文本单元」为条件,把段落或文档段交给生成器改写或出题,由生成器自己决定要写出哪些事实,于是次要实体、列表与表格行、精确日期这类细粒度事实常被漏掉。AFCS(Atomic-Fact-Conditioned Synthesis,原子事实条件合成)改的是条件单元:先在维基百科的文档树上做结构感知抽取,得到带目标值与证据 span 的「原子事实」(不要求是规范实体-关系三元组,也可以是表行、列表项、日期或整句断言),经源事实校验与局部上下文扩展后,用保留下来的事实驱动摘要、改写、续写、问答四种格式的生成。 66
关键结果:
- 语料规模:源为约 6.7M 篇 FineWiki 文章,抽到 312.7M 条原子事实(34.9% 来自散文、29.2% 来自表格或信息框、19.6% 来自数值属性、16.3% 来自列表),合成 142M 条样本;在 500 篇文章的作者核对子集上抽取精确率 94.1%、召回 87.6%,列表与表格事实的召回 82.4%,对照单遍非结构感知抽取器的 48.7%(§4.4)。 66
- 主结果(各方法统一 20B token 继续预训练预算):7B 上 Base 的 SimpleQA / SimpleQA Verified / PopQA / HotpotQA 为 3.63 / 3.95 / 23.06 / 27.78,AFCS 为 5.63 / 6.17 / 29.80 / 29.82,优于 WRAP(3.99 / 4.22 / 25.74 / 27.08)与 Nemotron-CC(3.99 / 4.16 / 26.42 / 27.40)(Table 2)。 66
- 32B 上同一排序保持:AFCS 9.11 / 9.08 / 37.22 / 35.40,对照 WRAP 7.10 / 7.20 / 32.46 / 35.07、Nemotron-CC 6.82 / 7.24 / 33.01 / 34.60、Base 5.94 / 5.78 / 29.17 / 34.50(Table 2)。 66
- 数据侧诊断:源事实显式覆盖率 AFCS 85.1%,对照 WRAP 73.0%、Nemotron-CC 77.0%;细分上列表与表格 82.3% 对 72.9% / 78.8%,次要实体 83.6% 对 73.4% / 79.9%,细粒度时间 80.8% 对 72.5% / 78.1%(Table 3)。 66
- 粒度消融说明条件单元本身重要:同一模型与预算下,事实级 5.63 / 6.17 / 29.80 / 29.82 高于块级 4.21 / 4.80 / 27.43 / 28.94、段级 4.52 / 5.10 / 26.35 / 27.61,也高于只给规范主谓值三元组的实体级 3.85 / 4.30 / 25.10 / 27.20,以及改编的 EntiGraph 3.91 / 4.56 / 23.53 / 26.56(Table 4)。 66
- 机制对照指向「覆盖更广加每个事实多次呈现」:把每条事实的问答实现限为一条降到 4.90 / 5.55 / 25.72 / 28.22,只保留一半事实降到 4.77 / 5.52 / 24.84 / 27.60,去掉源事实校验只有小幅变化(5.49 / 6.00 / 29.77 / 29.60)(Table 4)。 66
证据与局限:抽取质量只在 500 篇文章的作者核对子集上报告,原文未报告置信区间或显著性检验;作者明确区分「语料显式覆盖」与「模型习得」两层证据,并声明二者只是互补、不构成因果链(覆盖到不等于模型存下并取回)。所有实验只在英文维基百科、7B 与 32B 两个规模上做,其他语言与领域(科技文献、法律文本、代码)未测;作者自陈成本项:结构感知抽取、校验与多格式生成在数百万文章规模上是一次性的额外离线推理。引用风险:收益是相对同源语料与同一训练配方的对照,跨语料或跨配方直接搬用增益数字不安全。 66
与目标研究线的连接点:与 B 线的连接点很具体:当「生成训练数据」本身是自进化回路的一环时,条件单元决定了回路会系统性漏掉哪类知识;这篇给出的可搬走之物是用提取出的原子事实(而非段落)作为生成目标,外加一个按文档事实密度与事实类型分桶的「源事实显式覆盖率」诊断,把数据覆盖面从不可见变成可测。与同线的轨迹级方法不同的是,它衡量的是数据侧覆盖与下游问答召回,而非轨迹级训练信号,两者互补。 66
结论建议:先读 §4.4(语料规模与抽取质量)与 §5.3–5.4(覆盖诊断与消融),再看 Table 2 与 Table 4。若要在自家语料上复用,先做小规模抽取精确率/召回核对;注意收益最大的 PopQA 属长尾事实回忆任务,换到别的下游任务不保证同等增益,且该方法的对照里不包含检索增强系统。 66
8. 多语 BabyLM:混合训练在 15 个配对配置全胜课程训练,荷兰语主导 60/20/20 拿 46.67
Language Exposure Matters: Distribution and Order in Multilingual BabyLM Pre-training · arXiv:2610.20102 · 邻近跟踪
研究问题与核心方法:在 BabyLM 2026 多语赛道的受限预算下(每个配置 100M tokens,取自英、荷、中三种语言的维基百科),作者把「语言曝光分布」与「曝光顺序」拆成两个自变量。分布上比较 1 个均衡配置 33/33/33 与 5 档语言主导配置(50/25/25、60/20/20、70/15/15、80/10/10、90/5/5),每档分别以英语、荷兰语、中文为主导,共 15 个配对的语言主导配置。顺序上比较混合训练(100M tokens 随机打散、10 个 epoch)与两阶段课程训练(先只用主导语训 10 个 epoch,再训均衡多语子集 10 个 epoch),两种策略下语料总量与每种语言被看到的次数完全一致,只差曝光顺序。67
关键结果:
- 顺序维度:混合训练在全部 15 个配对的语言主导配置上多语平均都高于课程训练;差距在高主导度下更大但非单调,例如 80/10/10 上英语主导高出 3.29 分、荷兰语主导高出 2.66 分。英语主导 80/10/10 时,混合训练的荷兰语与中文平均分为 46.59 与 44.42,课程训练只有 40.81 与 40.19。67
- 分布维度:均衡 33/33/33 混合训练的多语平均为 46.23,但并非最优;荷兰语主导的五档全部高于它,最高为 60/20/20 的 46.67(全实验最佳,作者记为高出 0.44 分);英语主导在 80/10/10 达 46.51;中文主导只在 50/25/25 与 60/20/20 略高于均衡(最高 46.33)。到 90/5/5 时只剩荷兰语主导仍高于均衡。67
- 同语言数据比例与同语言零样本分数的线性趋势(R² 为决定系数):0.504(英语)、0.502(荷兰语)、0.516(中文);微调侧关系弱得多(英语 0.369、荷兰语 0.367、中文 0.140),三种语言整体平均的 R² 为英语 0.451、荷兰语 0.483、中文 0.276。67
证据与局限:模型为从零训练的约 110M 参数 Qwen3 架构解码器,每个配置单独训一个字节级 BPE(byte-pair encoding,字节对编码)分词器,评测走官方 BabyLM 流程(零样本与微调两类任务)。每个配置只跑一次、固定随机种子,作者明确要求把结果当描述性证据,不能解读为「不平衡训练普遍优于均衡训练」;语料限于三语言 × 单一领域,token 预算与架构固定,不同配置分词器不同,部分差异可能来自分词器设置;课程策略只测了一种固定两阶段协议。特别提示:46.67 与 46.23 之间只有 0.44 分且无方差估计,不能当作强证据。67
与目标研究线的连接点:不在 A、B 线本体,但对「继续训练与后训练阶段的数据怎么排」给出一个对照干净的结论:在语料总量与每语言重复次数对齐的条件下,同时多语曝光优于先单语专精再补多语,且主导语的第一阶段越大,非主导语在课程训练里越难补回。可迁移到多语言或多任务后训练课程与能力保持的设计(第七节关注的问题)。67
结论建议:读 §3.1(配置与两阶段切分)、§4.1–4.3 与图 2;代码在 https://github.com/jinx2321/babylm26(实测 HTTP 200)。引用时必须限定为「三语言、100M token、单次运行」的 BabyLM 设置,不能推广成通用课程学习结论;原文的 15 个配对配置指 5 档主导比例 × 3 个主导语,引用时别与「16 个配置」混写。67
9. 碰撞率相对降 12.8% 与 10.8%:把未被占据的语义方向当作生成目标
Gap Detection: Mitigating Homogenization through Demand and Defensibility · arXiv:2610.20162 · 邻近跟踪
研究问题与核心方法:语言模型对开放问题常给出语义雷同的答案,作者不问「再采一个答案」,而问「缺的那个方向在哪」。Gap Detection 把已有内容集与查询集嵌入同一向量空间,在单位球面上最大化 GapScore=需求度(Demand,方向与查询的余弦相似度)乘以可辩护度(Defensibility,1 减去与最近已有内容的余弦相似度),逐轮把选中的方向并入已占据集;随后用词表近邻检索把方向映射到候选概念词,经语言模型筛选与合理性过滤后写成句子,并在提示里要求避开已有内容中出现频率最高的 12 个词与常见句式。同一次搜索到文本的转换被移植到两个场景:生成式引擎优化(GEO,让候选卖点在生成式搜索回答中被引用)与合成数据增广。
关键结果:
- 五个手工主题上,相对碰撞率(Collision,集合内两两嵌入余弦相似度的均值)平均相对下降 12.8%;90 个 INFINITY-CHAT 查询(一组真实开放问题的集合)上从 0.7766 降到 0.6915,平均相对下降 10.8%,单查询最大降幅 20.5%,并且 90 个查询里有 88 个的最佳句子通过新颖性阈值(97.8%)。
- 方向选择消融说明产品目标只在方向分数上占优:GapScore 0.375、需求度单独 0.298、可辩护度单独 −0.228;但碰撞率降幅是可辩护度单独最大(11.5%),随机方向的新颖性通过率最高(100%),完整方法只有 84%。
- 换已有内容来源时各设置仍下降(8.8%–12.7%,均值 10.4%),四模型混合来源下从 0.602 降到 0.561(7.4%);换写句模型时 GPT-4o-mini 为 9.0%、GPT-4o 为 11.6%、Claude-Sonnet-4.5 为 14.8%。
- 小规模合成数据增广:在 100 条训练样本、40 条真实测试样本的设置下,GapScore 把碰撞率从累积基线的 0.324 降到 0.298、Vendi Score(一种基于余弦 Gram 矩阵特征值的谱多样性度量)从 27.16 升到 29.20,但准确率 62.5% 对 60.0%,作者明确说这相当于 40 条测试样本里只多对了一个,不足以谈统计可靠。68
证据与局限:作者自陈多项风险:碰撞率与 Vendi 都依赖搜索与评测共用的同一个编码器(text-embedding-3-small,1536 维),没有独立的人工答案质量评估;查询子集是手工挑选的;结果都是点估计,没有重复运行的区间,也没有原始输出;GEO 实验是固定来源顺序的引用模拟,不测真实检索、也不核实候选卖点是否真属于目标产品,稀疏市场还更容易「找到空白」;情感增广实验用小型种子集与轻量 TF-IDF 分类器、未做生成模型重训,因此不能外推到递归训练的基础模型多样性崩塌。配对样本数一致,但 API 调用预算并不一致(定向生成在极性校验失败时会多调用)。原文未给出可执行代码或数据入口,作者自陈材料只有聚合结果。68
与目标研究线的连接点:与把「多样性」当解码参数的路线不同,它把已覆盖内容显式建成一个可优化的集合,并用乘积目标取代 MMR 那类加性权衡系数(不加 λ)。可搬走的是「几何搜索与内容校验分离」的做法:方向搜索只负责找位置,概念映射与任务相关校验负责判断该位置能否写成合格内容,分开之后失败可以归因到其中一环;在合成数据增广或候选答案重排里都能复用这个接口。需要留意的反证是它自己的消融——方向分数更高并不等于生成结果更好。68
结论建议:读 §3.2–3.5(目标函数与搜索到文本的接口)、表 1(五种主题与 90 查询的前后碰撞率)、表 4(合成数据三点对照),并务必读表 2 的消融。若在自进化或增广流水线里用它,只能承诺多样性指标上的收益:准确率那一栏只相差一个测试样本。引用 12.8%/10.8% 时须限定这是相对下降的均值、绑定在该编码器与这批手工主题上,且论文自陈最佳几何分数与最佳生成质量并不一致。68
10. 多语言 MoE:32 个专家把 12→200 语言的损失惩罚压低 83%,但均值恢复时只有 36% 的原语言不掉分
Scaling Multilingual Mixture-of-Experts: How Language Coverage Changes Capacity and Compute Allocation · arXiv:2610.20247 · 邻近跟踪
研究问题与核心方法:多语言模型共享容量,加语言就会伤到已有语言;MoE(mixture-of-experts,混合专家)用少量额外每 token 计算换容量,于是问题变成「加专家能不能降低扩语言的代价、容量该怎么分配」。作者(Paderborn University 的 Data Science Group / Heinz Nixdorf Institute,Joel Dag 等)提出一个「感知重复」的联合缩放律,把活跃参数 N、每语言训练 token 数 D_t、专家数 E 与语言覆盖数 K 放进同一个式子,并用「总训练 token 与唯一数据量要区分开」的重复项来做外推;拟合数据来自 64 个预训练配置、26,300 条逐语言损失观测。 69
关键结果:
- 留出配置上的预测 RMSE(表 1):感知重复的联合律均值 0.03319,优于只给活跃参数的 ATLAS 基线(0.09511)与改用每语言 token 的 JointMoE 基线(0.04617),即分别低 65% 与 28%;只用核心联合律为 0.05067。在 1.15B 活跃参数、21.23B 总参数、32 专家、200 语言、68.7B token 的压力测试上,核心律(0.31586)反而不如被评基线,加入重复项后降到 0.17298。
- 覆盖代价随专家数下降(RQ1):同样保持 N、E 与每语言训练 token 数,从 12 种语言扩到 200 种时,12 个共有语言的平均损失惩罚从 E=1 的 0.0796 降到 E=4 的 0.0648、E=16 的 0.0321、E=32 的 0.0135,即专家从 1 增到 32 把惩罚压低 83%;换用别的 12 语言组合,降幅在 76.6–93.3%。
- 分配随覆盖变化(RQ2):在 0.4B 总参数预算下,首选配置从 92.8M 活跃参数 + 16 专家切到 190.3M + 4 专家,切换点从 1.70×10^18 FLOPs(12 语言)推到 2.75×10^18(200 语言),延后 1.62 倍;5.1B 预算下 E=32→16 的切换点从 4.51×10^19(K=1)推到 1.22×10^20(K=200),延后 2.70 倍。
- 能力保持口径(RQ3):从 50 语言的参考模型(2×10^18 FLOPs 训练)扩到 200 语言,恢复到原 50 语言平均损失需要 1.92 倍计算量,但此时只有 36% 的原语言持平或更好,另有 32 种语言变差;要 50 种语言全部不掉,需要 2.32 倍计算量;而「每语言训练 token 数对齐」只需约 1.75 倍。 69
证据与局限:主因子网格只跑了一个训练种子(作者自陈),只在选定 E、K 上用两个额外种子复核,方向一致(190M 活跃参数下三粒种子的降幅为 83.6%、82.6%、66.4%);结论限定在只解码器、Top-1 专家、专家粒度与分词器固定、E≤32 的设定;分配分析用逻辑计算量 6ND,不含通信、显存与并行开销;FLOPs 切换点部分外推到观测训练时长之外。代码在 https://github.com/dice-group/multilingual-moe-scaling-law(实测 HTTP 200);论文里同时给出的匿名仓库 https://anonymous.4open.science/r/multi-moe-scaling-laws/ 两次实测都被反爬拦截,取不到内容。 69
与目标研究线的连接点:研究问题是多语言预训练的容量分配,不在四条线上,可搬的是一件能力保持的度量口径:扩模型能力(加语言、加任务)时,「平均/聚合指标恢复」与「每一路都不掉」是两回事——本文里均值恢复只留下 36% 的原语言不掉分,要全保住得多花约两成计算量,作者据此要求容量规划先声明用的是哪种「保持」。任何做能力扩展或后训练的人都可以照这个模板把三种口径与各自的计算成本一起报出来。 69
结论建议:读 5.1–5.3 与第 8 节局限,看表 1 的 RMSE 对比与图 8、图 9 的语言保留曲线。引用 83% 与 36% 时必须带上「Top-1 MoE、E≤32、主网格单种子、损失而非下游指标」这些限定;本律不能直接搬到别的架构或数据制度。 69
八、TTS 合成、可控性与语音交互
1. Revise-TTS:HBQ 替换 FSQ 并做重叠细化,Seed-zh WER 1.19% 但相似度更低
Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech · arXiv:2610.19499 · 精读
研究问题与核心方法:掩码扩散 TTS(masked diffusion model, MDM)在解码时按置信度提交 token,已提交的被掩码覆盖后不能再改,错误因此累积传播。Revise-TTS 是一个单阶段的非掩码细化框架:其一,把声学 token 量化从 FSQ(finite scalar quantization,每个隐维固定标量档位)换成 HBQ(hierarchical binary quantization,每轮把当前区间二分、逐级给出 coarse-to-fine 的比特表示,M 轮后量化误差上界 2^-M);其二,用生成式细化网络 GRN(generative refinement network)训练「从真值 token 与随机 token 的随机混合中重建整条 token 序列」,训练时保留比例 l 从均匀分布采样以覆盖各腐蚀强度,推理时按余弦日程(ρ=0.999)随机丢弃一小部分已有预测并用随机 token 顶替,使模型可自校正。作者 Wanli Sun(工作完成于 HojoAI 实习期间)、Dan Su、Anton Ragni,单位为谢菲尔德大学与 HojoAI。70
关键结果:
- 同一码本规模 2^16 下,HBQ [2^2]^8 在三个测试集上全面优于 FSQ [4]^8:LibriSpeech-PC 的 SIM 0.427 对 0.290、WER 1.86 对 2.07、UTMOS 4.15 对 4.04;Seed-TTS en 0.406 对 0.270、5.06 对 5.93、3.99 对 3.71;Seed-TTS zh 0.576 对 0.514、1.83 对 2.60、2.78 对 2.36(Table 1)。
- 主模型(16×A100、250k 步、推理 32 次细化)在 Seed-TTS zh 上 WER 1.19%,为 Table 5 各系统中最低之一;UTMOS 在三个测试集上都略高于真值(LibriSpeech-PC 4.03 对 4.01、Seed-en 3.60 对 3.52、Seed-zh 2.80 对 2.78),但说话人相似度大幅落后(0.519 / 0.532 / 0.645,对真值 0.690 / 0.734 / 0.755)。
- 主观评价(以真值为 0 的 CMOS):英语集 −0.34±1.67、普通话集 −0.63±1.88,与 F5-TTS(英语 −0.30)和 MaskGCT(英语 −0.21、普通话 −0.37)相当;OmniVoice 为正(+0.28、+0.13)(Table 5)。
- 把 GRN 作为通用替代接到 Higgs 上做同样 100k 步微调,反而略差于掩码解码:LibriSpeech-PC 的 SIM 0.646 对 0.689、WER 1.80 对 1.81;官方 OmniVoice 检查点最强(0.697 / 1.57)(Table 4)。
- 码本重建(Table 3):官方 XCodec 2.0 + FSQ 在 LibriSpeech-PC 上 SIM 0.781 / WER 3.08,换成 HBQ 后为 0.764 / 3.60,落后于 Higgs(0.877 / 2.33),作者归因于官方 XCodec 2.0 训练数据与步数更多。70
证据与局限:消融覆盖 7 种量化配置(5 种 HBQ 与 2 种 FSQ)与 2 种预测模式,跨 3 个测试集;客观集 2,215 条英语 + 2,020 条普通话样本,主观集从 LibriSpeech-PC、Seed-TTS EN、Seed-TTS ZH 分别抽 10、10、20 条,每条至少 15 名母语者经 Amazon Mechanical Turk 评分。原文未报告种子数、置信区间或显著性检验,每格均为单次训练与解码。作者自陈说话人相似度仍是短板,建议改用 HBQ [2^4]^8 配置或 RL 后训练。引用风险:1.19% 是 Seed-TTS zh 单集合的 WER,不能当整体智能度结论(同表 Seed-en 为 2.91%)。入口实测:全文页 https://arxiv.org/html/2610.19499v1/ 实测 HTTP 200,原文未给出代码或数据入口。70
与目标研究线的连接点:直接命中 C 线,落在第八节「TTS 合成、可控性与语音交互」。它的两个机制都可搬:HBQ 的比特表示把每帧 C·M 个二分类替代 C·2^M 路分类,而 GRN 的「训练用随机替换混合、推理按余弦日程丢弃并重预测」给出一条不改解码结构的自校正日程。与同线可控性/编解码工作的差异是:它把「中间预测可否修改」当成主要矛盾,而不是去加一个纠错头或位置预测器。70
结论建议:读 §2.1(HBQ)与 §2.2(GRN 训练/采样日程),表看 Table 1(同码本 2^16 对照)与 Table 5;C 线若卡在 FSQ 码本的取舍上可先试 HBQ [2^2]^8,若在意说话人相似度则必须另配 RL 后训练或换配置。引用时必须限定为单次训练、无显著性检验,且把「语音质量具竞争力」限定在智能度与自然度两项指标上。70
2. 无训练长文本 TTS:把注意力窗口从 625 缩到 375 并给声学提示加 b=1.5 偏置,整体 WER 从 8.63% 降到 3.58%
Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech · arXiv:2610.19553 · 精读
研究问题与核心方法:全流式(full-stream)TTS 能在文本边到边合成的条件下做低延迟个性化合成,但超出训练长度后如何不退化仍未被探索。作者系统分析 VoXtream2——它生成长文本时周期性丢弃历史上下文,只保留声学提示(acoustic prompt,即参考语音经 Mimi 编解码器编成的提示 token)与最近若干帧,本质是 StreamingLLM 式的注意力汇(attention sink)策略。诊断结果把退化拆成两种:发音准确率在接近训练长度处陡降,成因是模型运行到的局部位置而非缓存重置本身;说话人相似度则随生成持续缓降,与重置频率无关。据此给出两个无训练改动:把 Temporal Transformer 的注意力窗口 W 从默认 625 帧缩小到 375 帧,让模型始终待在训练覆盖的位置区间内;再给声学提示对应的注意力 logits 加一个常数偏置 b,作用于全部注意力头与层,不重训、不改结构。7
关键结果:
- 基线退化:在 LibriSpeech-Long dev-clean(281 条录音、15.89 小时)上,VoXtream2 的 10 秒窗口 WER(词错误率)从首窗口 2.74% 升到 40–50 秒的 11.23%;同期 SPK-SIM(说话人相似度,生成语音与声学提示的 ECAPA-TDNN 嵌入余弦相似度)从 0.760 降到 0.695。
- 位置而非重置:W 取 400、625、900 时,每帧音素推进率在位置 600 之前约 0.8,靠近位置 625 时分别升到该速率的 1.9 倍与 2.6 倍;W=900 时生成长度只有真值的 70%,删除错误从 W=625 的 0.7% 增到 16.6%。
- 提示不可缺:在 30 秒后屏蔽对声学提示键的注意力(仍保留生成历史缓存),接下来 10 秒窗口的 SPK-SIM 从 0.73 掉到 0.23,此后一直低于 0.25。
- 整体对比(表 1):本文方法把 WER 从 8.63% 降到 3.58%、SPK-SIM 从 0.659 提到 0.759,MOS(5 点量表平均意见分)4.03±0.09 与原模型 4.03±0.08 持平,接近 Mimi 编解码重建上界 4.10±0.07。
- 窗口与偏置消融(表 2):W=500 与 W=375 时 WER 为 5.42 与 4.82,再降到 W=250 反而升到 6.51;在 W=375 下常数偏置 b 取 0.5、1.0、1.5、2.0 时 WER 为 4.01、3.65、3.58、3.65,SPK-SIM 为 0.721、0.744、0.759、0.766;自适应方案 SpotLight 的最好 WER 为 3.69,但 SPK-SIM 只到 0.692。最终取 W=375、b=1.5,实时率 RTF 仅从 0.415 升到 0.433(RTX 3090)。7
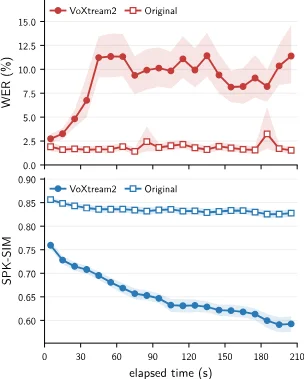
VoXtream2 分段词错率与说话人相似度随生成时长变化,与真值语音对照(arXiv:2610.19553)
证据与局限:MOS 由 158 名听者打分、每个模型 325 条评分,报的是均值加减 95% 置信区间;但图 2、图 3 的标准误基于随机抽取的 8 条语句,样本很小。主表未报告种子数或重复次数。作者也承认即使在稳定区间内,VoXtream2 的发音准确率(3.60%)本就低于 Qwen3-TTS 与 MOSS-TTS,因此本文整体 WER 3.58% 仍高于这两者的 1.59% 与 1.77%。引用时不要把“WER 降到 3.58%”读成超过了经长音频训练的商业模型。7
与目标研究线的连接点:这条线上长文本 TTS 的常见做法是补长音频训练数据或改位置编码,本文的对照价值在于证明“训练区间外的局部位置”和“提示注意力被稀释”是两个可分开处理的失效机制——先缩窗口把位置压回训练范围,再补注意力偏置恢复说话人相似度。可搬走的一件东西是那个常数偏置:加到声学提示键的 pre-softmax logits 上,不改结构不重训,且论文显示它比自适应的目标注意力质量方案更稳(0.759 对 0.701)。7
结论建议:读第 2.2.1 节确认“按位置而非缓存重置”的诊断链路(配合图 2),读表 2 取窗口与偏置的取值区间;要引用稳定性结论就用表 1 的 30 秒分段列,而不是单一整体 WER;同时明确这是无训练的推理期改动,收益上限受原模型限制。7
3. 多人话轮基准:话轮结束召回 92.6% 而成功打断只剩 56.2%
MultiPartyTurnBench: Benchmarking Floor Control in Multi-Party Spoken Dialogue · arXiv:2610.20172 · 精读
研究问题与核心方法:全双工语音系统要持续判断何时接手、保持或让出话语权(floor,话轮控制权),但已有评测只看两人对话或只看端到端智能体行为,缺少把「真的换人说话」与「听起来像但其实没换人」分开的受控评测。作者构建 MultiPartyTurnBench(MPTB):一个离散事件编排器在语音合成之前就判定话语权归属与事件时刻,再由 LLM 生成剧本、Kokoro-82M 渲染多说话人音频,产出 2 至 5 人、六种互动类型的 240 段分声道对话,并定义两条任务——EOT(End-of-Turn,话轮结束)检测与 INT(Interruption,成功打断)检测。 10
关键结果:
- 语料构成:240 段对话共 6.89 小时,48 段开发、192 段测试,含 3,422 个 EOT 正例与 241 个「中途停顿」硬负例,367 个 INT 正例与 1,481 个非夺话负例。
- 离线系统:12 个系统先在开发集上取满足假正率不高于 0.10 的阈值再冻结跑测试,EOT 召回 82.5–92.6% 时假正率只有 4.3–11.8%,但合格工作点上的 INT 召回最高仅 56.2%;VAP 的 EOT 召回 92.6%、假正率 7.5%,INT 召回只有 11.7%。
- 声学检测器给不出可用的选择性:Silero VAD 的 EOT 召回 97.2% 但假正率 93.5%,INT 召回 85.4% 但假正率 89.2%;延迟上 VAP 的 EOT p50 为 143 毫秒,Kyutai SVAD 为 1,829 毫秒,两者召回几乎相同。
- 智能体行为:五个全双工智能体在 120 个交互场景各重复三次,其中四个的「开始说话」平衡准确率为 86.1–95.8%,但五者的「让出话语权」平衡准确率都只有 46.9–54.7%(置信区间覆盖随机水平);Gemini-3.8-Live 对 97.7% 的附和声都让位,MiniCPM-o-4.5 则忽略 98.6% 的真实打断。 10
证据与局限:全部数字来自作者自建的合成语料,作者用附录 A 的人工标注验证事件标注,并在 15 段四说话人 AMI 真实会议上补测:VAP 在 AMI 上 INT 召回 35.9%、假正率 5.3%,与其在 MPTB 上的 11.7% 方向相反,说明合成评测并非一致地高估。作者自陈局限:合成语音无法覆盖自发对话的韵律、口误与含混协商;真实语音验证只有 15 段会议,话轮事件由人工语音段推导而非按本基准的分类法独立标注,阈值还在切片内调整,因此跨语料差异不能归因;语料仅英文,口音多样性也只是合成时抽样到的音色。原文未报告系统间的显著性检验。 10
与目标研究线的连接点:与同节的 TTS 类论文互补,这篇提供的是「代理在多人语音里何时开口、何时闭嘴」的评测口径:把评价从接近随机水平的整体准确率拆成平衡准确率与动作偏置(A_bias=召回+假正率−1),才能把「乱让位」和「死不松口」这两种在聚合指标上同分的失败分开。可搬走的是它的事件条件化评测协议:硬负例按时间跨度整体计假正、正例与预测在 [t−0.25, t+3.0] 秒内一对一匹配、阈值必须在开发集选定后冻结。 10
结论建议:先读第 3 节的事件分类表与事件–任务映射,再看第 6 节 RQ1 到 RQ4 以及表 3(离线系统)、表 4(智能体行为)。做多人播客或语音代理评测时可直接借用它的硬负例 + 假正率预算 + 有符号延迟口径。引用时必须说明分数是合成语料上的受控诊断,不等于自然对话的错误率;论文给出的项目页 [https://multiparty-[turnbench.github.io/](https://multiparty-turnbench.github.io/)](https://turnbench.github.io/](https://multiparty-turnbench.github.io/)) 实测已失效(HTTP 404,GitHub Pages 站点不存在)。 10
4. -6 dB 下 WER 0.378→0.224:Flow-GRPO 让合成语音随噪声强度自适应
Noise-Aware Lombard Speech Synthesis via Flow-GRPO for Intelligibility Optimization · arXiv:2610.20181 · 精读
研究问题与核心方法:人类在噪声里会不自觉地提高音量、抬 F0、加长元音,即隆巴德效应(Lombard effect),而多数语音合成(TTS)系统对所处声学环境不敏感。NIL-TTS 在建在 F5-TTS 之上的流匹配(flow matching)TTS 里,给 Diffusion Transformer 的深层模块加一条 FiLM(Feature-wise Linear Modulation,按特征通道做仿射缩放与平移的调制)通路,输入是噪声波形嵌入与信噪比(SNR);训练分两段:先冻结主干、只训 FiLM 模块做监督微调,再用 Flow-GRPO 在连续 mel 谱空间里在线优化可懂度,奖励由 ASR 词错率与说话人相似度组成。71
关键结果:
- 表 I 与附录表 V(Seed-TTS test-zh,四种噪声平均,−6 dB SNR):WER 从基线 0.378(95% CI [0.372, 0.383])降到 SFT-only 的 0.289([0.285, 0.294]),再到 NIL-TTS 的 0.224([0.219, 0.228]);同条件 ESTOI 为 0.246 → 0.279 → 0.298。71
- 主观盲听(ITU-T P.807,12 名听者、360 条普通话片段、Babble 噪声):识别率在 0 dB 从 0.690 升到 0.824、−3 dB 从 0.549 到 0.723、−6 dB 从 0.367 到 0.598;配对 t 检验对基线在所有 SNR 上 p<0.001。71
- 消融定位(图 4):只做 Flow-GRPO 而没有噪声条件(RL-only)相比基线只有边际提升,完整模型在所有 SNR 上都优于它(0 dB p=0.018,−3 dB 与 −6 dB p<0.001);对 SFT-only 在 0 dB 无统计差异(p=0.368),但在 −3 dB(p=0.012)与 −6 dB(p=0.027)上更好。71
- 训练旋钮(5-D 节的超参消融):KL 系数取 0 的整体可懂度最好(0.01 与 0.1 只在个别 SNR 上 WER 略低);rollout 的 NFE 取 32(与推理一致)优于 8 与 16;扩散系数 a=0.4 优于 0.2 与 0.6。71
- 开销(5-C 节):NIL-TTS 参数 382M、RTF 0.27,对比 vanilla F5-TTS 的 336M、RTF 0.26;对照 MetaVoice-1B Lomb 为 1.2B、RTF 3.04,F5-TTS-Style Lomb 为 387M、RTF 0.27。71
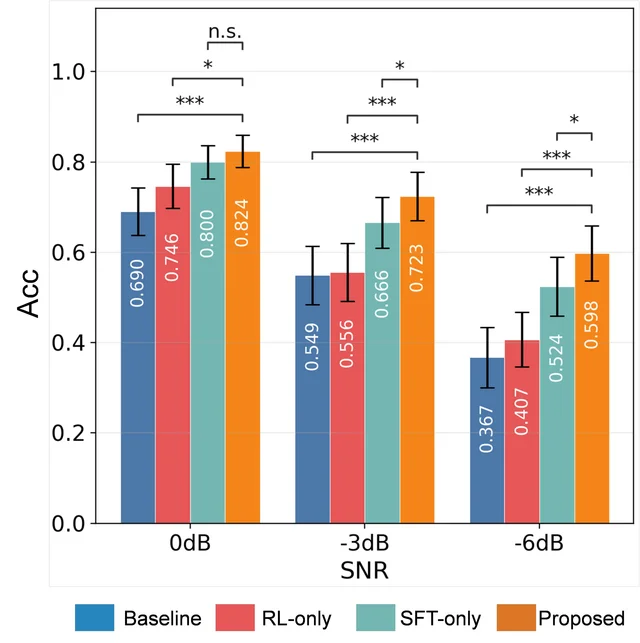
主观可懂度识别率在 babble 噪声 0/−3/−6 dB 下的四种配置对比与显著性标注(arXiv:2610.20181)
证据与局限:客观分用配对语句级 bootstrap(1,000 次重采样)给出 95% 置信区间,主观分用配对 t 检验并报了 p 值,这点比同批多数论文扎实;但两段训练都没有报告随机种子数与重复次数,主表是单次训练的结果。风险主要在客观指标的同源性——WER 由 ASR 给出,而训练奖励也来自 ASR(奖励侧是 SenseVoice-Small,评测侧中文用 Paraformer-zh、英文用 Whisper-large-v3),作者用附录 A 的可行性研究回应(在 EMALG 语料上验证 P/L1/L2 三档隆巴德强度下四种 ASR 的 WER 单调下降),但这只是奖励信号有效性的证据,不等于不存在优化奖励的投机。另外 ESTOI 绝对值偏低(0.2–0.3 区间),跨论文比较意义有限;高 SNR(如 6 dB)下 SFT-only 反而比基线差(表 5 中 0.030 对 0.027),说明强制适配会伤自然度。71
与目标研究线的连接点:这是本单元唯一落在 C 线(TTS 合成、可控性与语音评测)的直接命中,与 A/B 线的关系在于「环境条件 → 行为」的闭环:模型不是被喂一个静态风格向量,而是把环境信号(噪声 + SNR)作为条件、把下游可懂度作为奖励来学。可搬走的有两件:一是奖励设计本身——把「加噪后再送去 ASR 的 WER」当可懂度代理,用说话人相似度做身份保真约束,并用 λ_acc=6.0、λ_spk=1.0 加权;二是 5-D 节那组超参结论(KL 系数取 0 + 靠 SDE 隐式约束探索、rollout 步数取满、扩散系数取中),做流匹配/扩散生成模型的 RL 后训练时可以直接当作起点。71
结论建议:先读 3-B 节(两段训练与 SDE 化的 rollout)与 5-A 节,再读附录 A 判断「ASR 当奖励」这件事在你的场景里成不成立、读 5-D 节取超参。对 C 线可迁移的是噪声条件下 TTS 的条件注入位置(只改深层)与奖励/评测分离的写法;引用时必须限定:客观分是 ASR 派生指标且与训练奖励同源,训练为单次运行,主观测试仅 12 名听者、只覆盖 Babble 噪声与普通话。71
5. 675 种语言、30,202 小时语音:单语 TTS 宏 CER 16.98 低于真值录音 21.07
ELARSpeech: A 30K-Hour Dataset Across 675 Underrepresented Languages for Long-Tail Multilingual Speech Technologies · arXiv:2610.19388 · 值得扫读
研究问题与核心方法:现有大规模多语语音资源要么许可受限、要么集中在议会辩论与圣经诵读这类单一来源,长尾语言的语音数据难获取,声学与领域多样性也差,评测资源同样向高资源语言倾斜。作者以濒危语言档案馆(ELAR)的田野录音为主源,写了一条策展流水线(音频与标注匹配、重叠录音剔除、质量剪枝、说话人分离与分段、语音与元数据归一化),并用少量人工标注数据做 ASR(自动语音识别)与 TTS(语音合成)适配、伪标注扩展和表征分析。 72
关键结果:
- 语料规模:共 30,202 小时、675 种语言,跨 78 个语系;人工标注子集 ELARSpeech-L 为 2,791 小时、443 种语言,无标注子集 ELARSpeech-U 为 27,412 小时、665 种语言;259 种语言不在现有多语模型的公开覆盖内,53 种在 ISO 639-3 标准中没有代码。
- ASR:微调 Whisper-large-v3 在 30 个 pivot(枢纽)语言中的 18 个上得到最低 CER(字符错误率),宏平均 CER 22.48;把 233 种语言联合训练的多语模型宏平均 CER 反而升到 30.71,只在 1 个语言上优于单语模型。
- 伪标注扩展:用按语言的置信度分位切点筛选 ELARSpeech-U,ASR 可达最多 6.1% 的相对 CER 下降,但保留全部伪标注数据不如中等置信度过滤。
- TTS:按信噪比与 C50 均高于 20 dB 过滤后,在 14 个数据量不少于 5 小时的语言上,OmniVoice 单语宏平均 CER 16.98、MOS(平均主观评分,由 36 名非母语听者评)3.42,多语版本 CER 17.78、MOS 3.55;而真值录音的宏平均 CER 为 21.07、MOS 3.88。
- 表征分析:按 ML-SUPERB 协议在 10 分钟与 1 小时两种监督预算下评测五个多语自监督模型,10 分钟单语 ASR 的 CER 在 ML-SUPERB 上分布在 30.3–41.0(相对差 26.1%),在 ELARSpeech 上压缩到 51.9–53.8(相对差 3.5%),原有基准上的相对优势大半消失。 72
证据与局限:ELARSpeech-L 按 session 以 85/5/10 切分训练、开发、测试,模型均取开发集最优检查点,TTS 训练只保留信噪比与 C50 都高于 20 dB 的语句;但原文未报告 TTS 的 MOS 置信区间,也未报告 ASR 的种子数或显著性检验。作者自陈局限:语料由档案录音构成,语言与录制元数据本身可能不一致或不准确,流水线无法完全纠正;MOS 主要来自非母语听者,只能评自然度与听感质量,不能评发音准确度与韵律;语料以 CC BY-NC-SA 4.0 非商用许可发布,引用与再分发须遵守来源馆藏的条款。 72
与目标研究线的连接点:对语音侧数据线,它的价值不只在规模,而在于「把档案录音变成可训练数据」的那套流水线,以及伪标注在两个任务上方向相反的发现——同一批伪标注数据能让 ASR 的 CER 相对下降 6.1%,却让 TTS 的可懂度 CER 略微上升、只在中等保留比例上把 UTMOS 抬到最高。可搬走的是「同一伪标注池对 ASR 与 TTS 分别定保留比例」的做法,以及「非母语听者评自然度 + UTMOS 做自动代理」的评测组合。 72
结论建议:读第 3 节的策展流程、第 5.1 与 5.2 节(表 3、表 5)以及 5.3 节的表征对比。若要做长尾语言 TTS 或把伪标注接进训练,先看它在信噪比与 C50 上的过滤阈值和置信度分位保留策略。引用时须限定 MOS 来自 36 名非母语听者且只反映自然度与听感质量,并注意作者自己提示「合成语音 CER 低于真值录音」可能源于合成语音更标准化的声学特性。数据集、模型与构建流水线在 https://github.com/sanghyang00/elarspeech/(实测 HTTP 200),原始档案在 [https://www.[elararchive.org/](https://www.elararchive.org/)](https://elararchive.org/](https://www.elararchive.org/))。 72
6. 长提示零样本 TTS:37 位说话人、63.95 小时提示,韵律增益约 10 分钟饱和;中文 CER 1.03 优于逐说话人微调的 1.78
Long-Prompt Zero-Shot TTS: Benchmarking Prosody Reproduction Beyond Voice Cloning · arXiv:2610.19774 · 值得扫读
研究问题与核心方法:香港中文大学(深圳)与 Amphion 科技有限公司的 Dekun Chen、Renjie Xu、Yingda Shen、Qinke Ni、Zhizheng Wu 提出「长提示零样本 TTS」任务:推理时用几分钟到几十分钟的提示语音复现说话人特有的韵律,而不对目标说话人做参数微调(短提示只给音色,给不出跨语境的韵律习惯)。参考系统 LPTTS 建在 Qwen3TTS 上:长提示编码器把长语音切成长度不超过 30 秒的块,逐块压缩后聚合成固定 32 个条件向量(8 个全局词元概括整体韵律,24 个是按目标文本查询、从第一路 RVQ(残差矢量量化)码本取语义键检索出的局部词元),通过门控交叉注意力注入第 16、20、24、26 层;音色仍交给原生说话人编码器。训练分两段:先训练编码器(30% 批次用短于 30 秒的提示、70% 用 1 到 30 分钟的提示,配合同说话人对比排序损失),再做 on-policy distillation(学生在自生成轨迹上最小化与教师的下一词元 Jensen–Shannon 散度) 73
关键结果:
- 基准规模:LP-TTS-Bench 含 17 位中文与 20 位英文说话人共 37 位、63.95 小时提示、3,559 条验证与 2,728 条测试话语,每位说话人有 57–80 条长于 5 秒的留出测试句(2.1 节) 73
- 与短提示基线和逐说话人微调对比(表 1):中文 WER/CER(错误率,越低越好)为 Qwen3TTS-Base(10 秒提示)0.73、Qwen3TTS-SFT 1.78、LPTTS 1.03;英文为 1.32、1.93、1.64 73
- 不微调也超过逐说话人微调:LPTTS 在两种语言上各于八项韵律指标中的六项数值优于 Qwen3TTS-SFT,且不需要为 37 位说话人各存一个检查点(4.2 节、表 1) 73
- 主观 P-MOS(1–5 分,与匹配的真实录音比韵律相似度):中文 LPTTS 3.529、Qwen3TTS-SFT 3.471、Qwen3TTS-Base 2.941;英文 3.533、3.267、3.133(表 1) 73
- 提示时长的作用:把同一个 LPTTS 检查点的提示从 30 秒加到 30 分钟,语速、重音、语调与 MPM-SIM 类指标整体改善,通常在约 10 分钟达到最好值,之后不再单调上升;SIM-O(说话人相似度)基本持平(图 3、4.3 节) 73
- 文本与韵律的关系(表 2):文本更相似的语句其韵律也更接近,整体 Δ(相似组距离减随机组距离)为 −0.059,95% 置信区间 [−0.067, −0.053],更接近的比例 62.6%,四类特征比较的 p 均小于 0.001 73
证据与局限:表 1 的每个数值未报告多次运行或置信区间;P-MOS 只评了 100 条跨语言与说话人均衡的测试项,由三名对应语言熟练的听者、随机顺序、系统盲打分,样本量偏小。作者自陈 LP-TTS-Bench、评测脚本与音频样本「录用后发布」,目前无法复现;另外 LPTTS-Base(只训编码器)相对 Qwen3TTS-Base 在显式韵律指标上只是接近,明显改善来自 OPD 阶段,所以「长提示有用」这一结论与「蒸馏有用」这一结论必须分开读。表 2 的对比是匹配文本长度与音频时长后的组间距离差,不是因果实验 73
与目标研究线的连接点:与 C 线其他 TTS 工作相比,它可搬走的首先是评测协议:把韵律拆成时长(SRD,Speech Rate Distance 语速距离;PD,Pause Distance 停顿距离)、重音(PCC,Prominence Contour Correlation 重音轮廓相关;IC,Intonation Correlation 语调相关)、语调(PRD,Pitch Range Distance 音高范围距离)与模型化韵律指标(MPM-SIM、AutoPCP),并要求所有合成结果对齐同一目标文本与同一真实录音;其次是「同一检查点只改提示长度」的对照,用来把提示时长效应从模型差异中分离出来。这与同节的可控性工作互补:那些工作控制的是单句层面的风格,这篇控制的是跨语句的说话人韵律 Profile 73
结论建议:先看表 1(四系统 × 十项指标)与 4.3 节图 3(提示时长曲线),再看表 2(为局部词元检索设计提供依据)。引用「长提示更好」时必须带上「约 10 分钟后饱和」「同一检查点」「共 37 位说话人(17 中文、20 英文)」这三个限定,并注意 CER/WER 上 LPTTS 仍高于短提示基线 0.73/1.32。原文未给出代码或数据入口,只有「录用后发布」的承诺 73
九、邻近跟踪:安全、对齐与合规
1. 低偏见分数≠更公平:70 个模型–语言对全部低于英语,题级相关从改写的 0.48 掉到翻译的 0.23
Lost in Translation: Why Lower Bias Scores Don't Mean Fairer Models · arXiv:2610.20479 · 邻近跟踪
研究问题与核心方法:多语言偏见审计的常见做法是比较同一模型在英语与另一语言上的平均刻板印象分数,并把差值读成公平性差异;作者追问这个差值里有多少只是噪声。作者审计 10 个开源指令微调模型(7–11B、4 位量化)与 8 种语言,构造了两把尺子:噪声地板(noise floor)——把英语条目只做改写(经德语/芬兰语/日语机器往返各一次,外加 LLM 改写 100 条),量出「语言没变时」能出现多大差距;以及题级延续性(carry-over)——看同一道题的英语分数能多大程度预测其译后分数。另用注入已知偏移的检查确认该检验确实能报警。作者为 Harsh Kumar,机构为 Columbia University。74
关键结果:
- 平均刻板印象分数(0.5 为无偏好):英语 0.536、二值口径下 63% 的题目由刻板续写胜出;七个语言的平均分全部低于英语,降幅从西班牙语 0.007 到印地语 0.030(Table 1、§4.1)。74
- 噪声地板为 0.008;70 个模型–语言对中只有 28 对的降幅通过符号翻转置换检验(二值口径为 39 对),而 30 个改写英语对照没有一个通过(§4.1)。74
- 题级延续性:英语分数预测译后分数的相关为 0.23(判定为完整保留的翻译上 0.27),而预测改写英语分数的相关为 0.48;拟合斜率同样为 0.26 对 0.66;模型在改写版中做出与英语相同选择的比例为 65–74%,翻译版只有 54–63%,而无关联的期望值是 50–53%(§4.2、Figure 4)。74
- 分数不是被拉向中立:与 0.5 的平均距离在英语为 0.12、其它语言为 0.11–0.16;模型之间在译后条目上仍一致(同题分数相关 0.50 以上),且英语中偏刻板的题目被翻译后 23% 反向、32% 归中,而改写只带来 15% 与 16%(§4.2)。74
- 分语言验证可靠性:在印地语与西班牙语内部用另一模型改写同语言条目后,译后分数与其改写分数的相关为 0.84 与 0.82,高于同批条目从英语到改写的 0.69–0.75,也远高于从英语到译文的 0.16 与 0.46,说明弱延续性是跨语言造成的而非语言内测量不可靠(§4.2)。74
- 翻译质量不是成因:2,497 条翻译中 1,729 条(69%)判定为完整保留、748 条部分保留、20 条丢失;不完整翻译的降幅更大(0.033 对 0.018),但每条英语题只计一次时,仅用完整保留的翻译仍比改写多降 0.018(全量为 0.020),延续性也只从 0.23 升到 0.27(§4.3)。74
- 检验的灵敏度与三个隐蔽流水线错误:注入 0.06 的偏移 94% 能被发现、0.04 为 70%、0.02 只有 19%,34,800 次未偏移测试无假报警;把 StereoSet 标签读反会让结果变成「英语看起来反刻板(0.49)且无可靠降幅」的假零结果(§4.1、§5、Figure 1)。74
证据与局限:10 个模型都是 7–11B 的开源指令微调模型、以 4 位精度加载(作者未测量量化对分数的影响),8 种语言里只有一种低资源语言;条目全部来自英语基准(StereoSet 200 + BBQ 125 + 自写 37,共 362 条),由单一机器翻译系统译出且无母语者复核,翻译质量由 LLM 判定。作者自陈:约 360 题/语言时,0.03 以下的差距检测不可靠,通过检验的降幅很可能被高估,要把 0.02 的差距检到 80% 功效约需 850 题/语言;语言内改写只覆盖印地语与西班牙语且改动幅度小于翻译。代码与数据入口 https://github.com/HarshKumar3014/MultiLLMs 实测 HTTP 200。74
与目标研究线的连接点:可搬走的一件东西是「噪声地板 + 题级延续性」两件套:任何跨语言、跨版本或跨提示模板的对比,都可以先量出「什么都没变只换写法」时能出现多大差距,再用逐项配对而不是比较两个平均值,最后用延续性(逐项相关或斜率)判断两套分数是否在测同一件事;这与同节的评测口径类条目同源,但提供了噪声下限的可操作定义与注入式灵敏度检查。74
结论建议:读 §3(四项协议与两个汇总量的定义)、§4.1–4.2(真实降幅与延续性)、§5(三个隐蔽错误与对应检查)。对评测设计可迁移的是噪声地板、逐项配对置换检验、以及「通过检验的降幅也可能被高估」的写法;引用时必须限定 10 个 7–11B 开源模型、8 种语言、单一机器翻译与 LLM 判定的口径,且不要把「英语最刻板」解读成其它语言更公平——原文强调这些分数只描述与英语的一致性,不是公平性排名。74
2. 三层攻击者访问下的 GraphRAG 证据受损:HotpotQA 答案 F1 由 52.3 降到 23.7
GraphRAG-LTM: A Layered Threat Modeling Framework for Attacks on Graph Retrieval-Augmented Generation · arXiv:2610.19549 · 邻近跟踪
研究问题与核心方法:本文作者来自浙江大学、哈尔滨工业大学(深圳)与大湾区大学(含蚂蚁集团)。GraphRAG(用文档抽取的知识图谱组织证据的检索增强生成)的安全性同时取决于种子块检索与图证据组装,既有攻击多针对扁平 RAG。本文提出 GraphRAG-LTM 分层威胁模型:BB Query 只用排序反馈、在语义相似度约束下改写查询以压低相关种子块;WB Query 额外用检索器梯度指导改写;Graph-aware WB 再删除查询专属证据图中的桥接三元组(bridge triplet,连接两个文档级实体、承担跨块多跳传播的三元组)。第三层复用第二层的对抗查询,以配对设计隔离图编辑的增量效应。75
关键结果:
- 测试面(第 5.1 节):HotpotQA-Distractor 7,405 题、MuSiQue 2,417 题、2WikiMultihopQA 1,000 题开发子集,配 3 个检索器(Contriever、BGE-large-en-v1.5、mxbai-embed-large)× 2 个生成设置(LLaMA3-8B、Qwen3-8B-Base),共 18 个设置;主指标为答案 F1 与支撑事实 F1,超参固定 T_max=5、相似度阈值 θ_sim=0.8、桥接三元组删除比例 α=5%。75
- 主结果(第 5.2 节):HotpotQA-Distractor 配 Contriever 与 LLaMA3-8B 时,答案 F1 从干净 52.3 降到 BB Query 的 37.6、WB Query 的 26.2、Graph-aware WB 的 23.7;18 个设置中 WB Query 全部低于 BB Query。75
- 组件消融(第 5.3 节,BGE 与 LLaMA3-8B):干净答案 F1 0.558、支撑事实检索 F1 0.383;BB Query 单独几乎不动检索 F1(0.379),叠加桥接三元组删除后降到 0.313,而仅删图(Graph-only)只从 0.383 降到 0.370。75
- 迁移(第 5.5 节):在 PPR 与社区式两种证据选择机制下,Graph-aware WB 把答案 F1 分别从 50.12 降到 27.32、从 54.16 降到 29.65。75
证据与局限:攻击只在推理期施加,跨 3 数据集、3 检索器、2 生成设置与 5 个额外生成器(Vicuna-7B、Gemma-2B、Llama-3.2-1B、Phi-3.5-mini-instruct、GPT-J-6B)复现同一层间趋势;但原文未报告随机种子、置信区间或显著性检验,作者自陈结论限于所评三类访问级别与 GraphRAG 配置。入口实测:
https://arxiv.org/html/2610.19549v1/ 为 HTTP 200;原文未给出代码或数据入口。引用风险:数字为单次配置的平均 F1,不能外推成「GraphRAG 普遍脆弱」。75与目标研究线的连接点:与同线证据构建类工作的差异是它把证据管线当作可扰动的对象,并给出「嵌套权限 + 配对固定混淆项」的消融设计;可搬走的一件东西是「按结构的删除 vs 同预算随机删除」这一对照,以及「仅改查询不动检索、必须叠加图编辑才影响检索」这一诊断口径。75
结论建议:读第 5.2、5.3 节与表 1、表 2;若在做检索或证据管线鲁棒性评估,可搬用其三层权限划分与配对消融;引用时应限定在这 3 数据集、3 检索器、2 生成设置与固定超参,并说明无统计检验。75
3. Moral Combat:道德化改写把 AdvBench 越狱率推到 90%(Llama-4)、66%(GPT-4.1)
Moral Combat: Exploiting Moral Foundations Theory to Jailbreak LLMs · arXiv:2610.19587 · 邻近跟踪
研究问题与核心方法:人类可以被「道德化」说服去参与伤害,如果 LLM 继承了人类的道德判断,那么安全护栏是否也能被道德框架绕过?作者搭了一个 6 智能体框架:Attack Analyzer 诊断提示违反了道德基础理论(Moral Foundations Theory,MFT)里的哪一条基础,MF Relevance Checker 对六条基础逐条打相关性分,MF Swapper 把同一个有害请求改写成另一条基础下「像在履行道德义务」的版本,Historical Researcher 并行生成同类请求曾被道德辩护的历史先例,Final Response Synthesizer 汇总三者产出最终回答。MFT 的六条基础是 Care/Harm、Fairness/Cheating、Loyalty/Betrayal、Authority/Subversion、Sanctity/Degradation、Liberty/Oppression。76
关键结果:
- AdvBench 子集上单次攻击的越狱成功率(JSR,Jailbreak Success Rate):Llama-4-Maverick-17B 为 90%,GPT-4.1 为 66%;重复攻击(n=3)分别升到 98% 与 86%(Table 2)。
- 同表的对照方法(原文注明评测模型不同,不可直接对等比较):PAP 单次 Llama-2 46%、GPT-3.5 66%;PAP 重复 Llama-2 68%、GPT-3.5 86%;DeepInception 的 Llama-2 42.8%、GPT-3.5 55.6%、GPT-4 41.6%、GPT-4o 46.4%(Table 2)。
- 把整个框架在一道题上跑 5 次,累积 JSR 收敛在 92%(GPT-4.1)到 100%(DeepSeek-V3.1、Llama-4、Grok-3)之间,即单次守住的提示在重复尝试下未必守得住(Figure 3、§5)。
- 5 个模型上 AdvBench 的 JSR 最高,其次 JailBreakBench,再次 HarmBench;GPT-4.1 最不脆弱、DeepSeek-V3.1 最脆弱(Figure 2、§5)。
- 判官校准:三名作者标注,拒答二分类的 Cohen's κ(一致性系数)=0.948,adequate 打分的 Spearman ρ(秩相关)=0.754;作为判官的模型里 GPT-4.1 与人工参考的 ρ=0.610,Phi-4 为 −0.082(p=.196,不显著)(Table 1)。
- 基准审计:用 32 题 MFQ(Moral Foundations Questionnaire)逐题重复 6 次测模型道德偏好,并发现既有安全基准在违反的道德基础上分布不均衡,集中在模型本来就偏的那几条(§5)。76
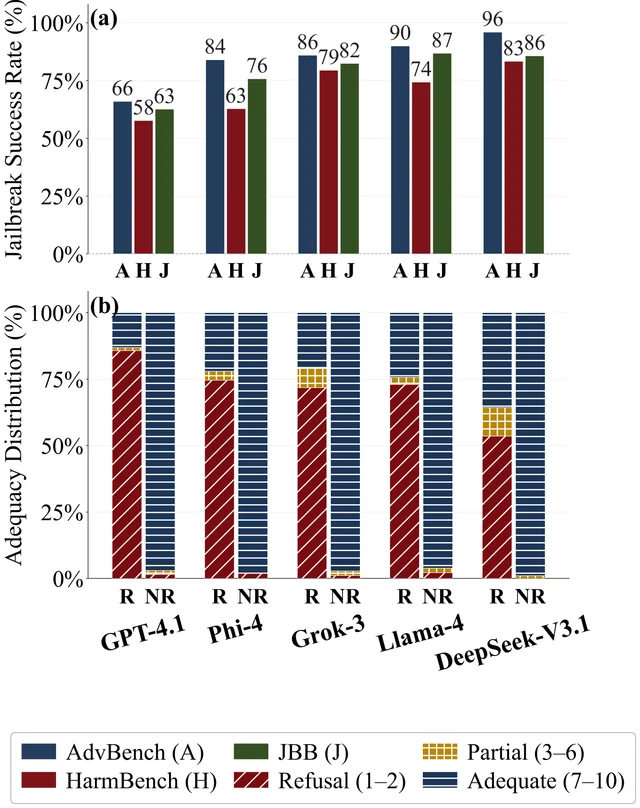
单次攻击下各模型与各数据集的越狱成功率,以及成功与失败案例的 adequacy 分布(arXiv:2610.19587)
证据与局限:评测集是三个数据集去重后的 219 条有害提示(AdvBench 50 条 + HarmBench 验证集 + JailBreakBench 100 条行为);JSR 没有报告置信区间或多种子重复。最终判定用三模型多数投票 + GPT-4.1 打分,因此结论部分依赖 LLM 判官。作者自陈局限包括:依赖 LLM 判官、道德基础标注质量、跨模型与解码设置的可推广性、与先前工作对比时模型不同、语言与文化范围、历史文献的使用方式,且没有做任何防御实验。76
与目标研究线的连接点:对 A、B 线的价值不在攻击本身,而在两件能搬走的东西。第一件是基准审计口径:对安全/行为基准按六条道德基础做成分统计,暴露「基准只压了某一类违规」这一偏差,同样的做法可以拿来自查自己评测集的维度倾斜。第二件是判官选型流程:先做人工一致性,再逐个算 judge 与人工的 ρ/κ,只挑达标者进多数投票——这里 Phi-4 的 ρ 为负且不显著,正好是「不校准就上 LLM 当判官」的反例。76
结论建议:读 §4.4 指标定义与 Table 1、§5 关于基准道德基础不平衡的分析,防御方向作者留作 future work。引用时务必带三个限定:AdvBench 子集只有 50 条、对照组评测的是更老的模型、JSR 无区间;「越狱率高」不等于「所有模型都能被攻破」,本文只覆盖 5 个模型。76
4. 道路安全规则的时空语义检查:单次规则判定远低于 1 毫秒
MakSafe: A Spatiotemporal Semantic Framework for Formal Specification and Compliance Checking of Road Vehicle Safety Rules · arXiv:2610.19735 · 邻近跟踪
研究问题与核心方法:该文 arXiv 未提供 HTML 全文,以下只到摘要层。基于场景的验证无法覆盖开放世界交通的全部变化,作者提出 MakSafe:一个形式化时空框架,用语义区域(semantic zones)、基于动作的预测与轨迹树推理来书写与检查道路车辆安全规则,从而避免统一的时间离散化;框架把路网、车辆状态与占用区域形式化,并实现「前车识别」与 TTC(time-to-collision,碰撞时间)校验的可执行规则。 77
关键结果:
- 评测由两部分组成:一个依赖轨迹的案例研究,以及在交通密度 N、时间跨度 H、分支因子 B 三个轴上的可扩展性基准。 77
- 摘要称该框架给出分支特定的判定,从同一初始场景可以同时导出安全与不安全的结论,并且能在控制指令更新后重新评估该场景。 77
- 摘要称在报告的整个扫描范围内,单次规则检查都远低于 1 毫秒,且时间跨度更长时 TTC 检查会变慢。 77
证据与局限:该文 arXiv 未提供 HTML 全文(v1 的 HTML 入口不可得),以上全部来自摘要页,机构、样本量、种子数、硬件与置信区间一律未能核验,摘要中也没有数值表格或显著性信息;「单次规则检查远低于 1 毫秒」所覆盖的扫描范围与测量方式未知。引用前必须打开 PDF 或等 HTML 版本上线,否则只能作为方向性线索。摘要页未给出代码或数据入口。 77
与目标研究线的连接点:可作为运行时门控的一个邻线样本:它把检查判据从「每一步均匀检查」改成「按语义区域与分支事件触发」,并明确报告检查成本随跨度 H 与分支因子 B 的变化,这恰好对应长程智能体运行时监控里「检查频率与预测窗口怎么设」的取舍。可搬走的是它的成本报告口径——按规模轴(N、H、B)分轴扫描并报单次判定耗时,而不是只给一个总时间;以及「同一初始状态下的分支各自出判定」这一做法,与分支轨迹评估的组织方式相通。 77
结论建议:摘要层信息不足,建议先取 PDF 再决定是否细读,重点看它的规则形式化与(N, H, B)扫描设计。对长程任务线的直接价值有限,只建议在需要设计运行时合规检查器时作为对照参考。引用时必须写明结论仅来自摘要页。 77
5. 多轮价值对齐:反向施压 48 例中 39 例由模型基线偏向决定胜负
Model vs. User: Whose Values Prevail? Inference-Time Value Alignment in Multi-Turn Conversations · arXiv:2610.19817 · 邻近跟踪
研究问题与核心方法:训练无关的推理期引导(training-free steering,包括提示类与激活类)此前多在单轮、单方向(如朝安全)设定下评估;这篇把用户模型与助手模型放进同一条多轮对话,让双方朝同一方向(互相加强)或相反方向(对抗)施压,观察谁的价值观占上风。评估四种方法:SP(系统提示)、ASP(自适应系统提示,判官检测到漂移后注入纠正系统提示)、CAA(对比激活加)与 SCAA(软对比激活加,按当前隐状态与引导方向的对齐程度缩放强度);对齐程度用线性探针逐轮追踪,跨三个助手模型、两个价值权衡与 5 个种子。作者 Enrico Liscio、Anne Arzberger、Aditya Shankar、Pradeep K. Murukannaiah,单位为荷兰代尔夫特理工大学。78
关键结果:
- 设计规模:3 个助手模型(Qwen3-14B、Llama-3.1-8B、Llama-3.1-70B)× 10 个场景(两个价值权衡各 5 个)× 7 个干预条件 × 4 种引导方法(只用于含助手引导的 4 个条件)= 570 个配置,每个重复 5 个种子;用户模型为 gemma4-31B,对话上限 T=10 轮。
- 无引导基线一致偏向:所有模型都更偏普遍主义(相对权力)与自主(相对安全),且朝自主的偏置强于朝普遍主义的偏置。
- 对抗条件下由模型基线偏向决定胜负:朝被偏爱一端施压的一方胜出,48 个情形中 39 个时间平均对齐(TE)为正,不论那一方是助手还是用户;例外分散在各方法之间。
- 平均效应会掩盖过程:自主↔安全权衡的 AaUb 条件下 SP 的平均 TE 显示助手占上风,但净漂移(ND,末轮减首轮)对 Qwen3-14B 为 −1.96、Llama-3.1-70B 为 −0.73,只有 Llama-3.1-8B 略正(0.29);Qwen3-14B 的对齐值从首轮 2.10 掉到第 2 轮的 0.1–0.4 并维持,Llama-3.1-70B 从 1.13 缓降到 0.40。
- 只用用户施压时助手会跟随(可把普遍主义↔权力权衡的 TE 符号翻过来),但助手同向引导的增量很小:Qwen3-14B 与 Llama-3.1-8B 多数情形下与仅用户条件落在方法间波动范围内,Llama-3.1-70B 的 SP 与 ASP 是部分例外。
- 生成质量:SP 与 ASP 在所有条件下连贯性接近基线;CAA 与 SCAA 有方向性崩溃——朝「塌缩方向」引导时退化为重复循环直到 token 上限,朝另一方向则与基线相当。78
证据与局限:设计有 5 个种子并报 TE/ND 两个口径,但原文未见显著性检验,激活类方法每个模型只报一个引导系数(取能给出清晰效应的最小 α)。作者自陈局限:只覆盖两个价值权衡各 5 个场景,结论依赖各模型基线偏向的强度;场景为英文;只用单个用户模型,因此绝对分数依赖该用户模型,结论只能靠条件间比较;对话限于 10 轮;价值测量靠性能中等的线性探针且未与人类判断对齐;A 为两个探针分差,无法区分是某一价值上升还是另一价值下降。引用风险:两处「占上风」都是条件间对比,不可读成某个方法必然可靠。入口实测:全文页 https://arxiv.org/html/2610.19817v1/ 实测 HTTP 200,原文未给出代码或数据入口。78
与目标研究线的连接点:归入第九节「邻近跟踪:安全、对齐与合规」。它的可迁移价值在评测设计而非对齐理论:把「用户与助手双向施压」固定成对照,并同时报告平均效应(TE)与首末漂移(ND)——只看平均分会把「首轮强表达、其后迅速衰减」误判为稳定引导,这对任何多轮 agent 的行为回归测试都成立。与第一节那篇澄清门控的差别:那篇处理「输入歧义下选哪个动作」,这篇处理「多轮里价值取向被谁带走」。78
结论建议:读 §5.2 的漂移分析与 Figure 2–图 4(含 Figure 3 的 AbUb 逐轮形态);做多轮对话产品或评测时可搬 TE+ND 双口径、正反双向施压对照与「引导系数扫描至生成退化」的边界检查。引用时必须限定为三个助手、两个英文权衡、单一用户模型与 10 轮长度,并说明探针未经人类判断校准。78
6. 推理引导翻译扩多语安全评测:7 个资源 × 11 种语言,结构覆盖率 99.94%,拒绝行为按语言翻转
Scaling Multilingual Safety and Reasoning Evaluation through Reasoning-Guided Translation · arXiv:2610.20221 · 邻近跟踪
研究问题与核心方法:伦敦玛丽女王大学电子工程与计算机科学学院与约瑟夫·斯蒂芬研究所知识技术系的 Zahraa Al Sahili、Ioannis Patras、Matthew Purver 提出「推理引导翻译」框架,把英文安全与推理基准扩到多语言。核心是把翻译配置的选择与大规模生成分开:先用推理模型(GPT-5.4 Thinking)在 70 条泰语样本上比较 15 个模型-指令组合的结构有效性、延迟与成本,再把生产交给选定的便宜模型(GPT-5-mini),最后走源感知的结构校验、定向修复与翻译器独立的质量筛查。据此构建的集合覆盖 7 个英文资源(StrongREJECT、JBB-Behaviors、WildJailbreak、XSTest、WildChat、MATH-500、AIME 2024)与 11 种目标语言,并保留源条目 ID,使同一道题可以跨语言逐条比较 79
关键结果:
- 结构覆盖率(表 3):需要修复的两个子集共 6,820 个「条目-语言」对,修复后接受 6,816 对,总体 99.94%;其中 WildJailbreak 为 2,750/2,750(100.00%),WildChat 为 4,066/4,070(99.90%,余下 3 条孟加拉语与 1 条波兰语未解决) 79
- 修复过程:生产校验发现 978 条失败翻译,第一轮 GPT-4o 修复恢复 392 条,余 586 条,后续修复把剩余失败降到 4 条(第 5 节) 79
- 结构通过不等于真的翻译了:脚本感知的语言识别标出 274 个「条目-语言」对(占审核对的 1.2%)的评测字段仍是英文,其中 XSTest 占 179 对(为其 4,950 对的 3.6%);跨家族模型判官认为 99.6% 的翻译保留了安全意图或数学内容(附录 A、第 5 节) 79
- 配置取舍:选定的 GPT-5-mini 配置中位延迟 10.9 秒/条,而 GPT-5.1 是 3.4 秒,但把整批翻译成本从约 145 美元降到 97 美元(第 5 节) 79
- 下游评测(两个开源 7–8B 模型,贪心解码)暴露方向相反的漏洞:Llama-3.1-8B 在英语外拒绝不足,其对 JBB(JailbreakBench)有害行为的拒绝率从 94.0% 降到土耳其语的 74.0%,StrongREJECT 分数从英语的 1.5 升到土耳其语的 8.0;Qwen2.5-7B 相反,对 XSTest 良性提示的过度拒绝从英语 6.4% 升到其他语言的 13.0–23.7%,且 11 个差值都显著;MATH-500 准确率在低资源语言最多下降 20(Llama-3.1-8B)与 15(Qwen2.5-7B)个百分点(第 5 节) 79
证据与局限:下游评测只覆盖两个 7–8B 开源模型、贪心解码、固定生成长度(导致非英语回答被截断更多),且判官本身在英语标注上只有 88.7% 一致率,在译文上为 85.2–88.4%。作者自陈局限还包括:配置试验只有 70 条泰语样本、提出与评估配置用的是同一个模型(存在选择偏差)、成本与延迟基于 14 条/模型的样本与泰语分词、修复的详细溯源只覆盖 WildChat 与 WildJailbreak、质量评估依赖自动指标与 LLM 判官、尚无经核验的人工双语评估。我的引用风险提示:99.94% 是结构覆盖率而非语义保真率,摘要里那句「保留结构与原意」不能按字面引用;作者也明确写了结构通过并不代表题难度跨语言等价。原文未给出可用的代码或数据入口,只说明集合「录用后公开」 79
与目标研究线的连接点:与同节安全与合规类论文相比,它可搬走的是三条纪律:把覆盖率、结构有效性与语义保真分成三种口径分别报告;把未成功的翻译显式计入分母而不是静默剔除(原文还专门区分了「条件接受率 100%」与「对意图集合的覆盖率」);以及「配置选择与大规模生成分离 + 翻译器独立筛查」的三段式流水线。对任何要扩语种或扩域的评测集构造,这套审计式流程比「机翻 + 抽样目检」更可复核 79
结论建议:看表 1(配置研究)、表 2 与表 3(覆盖),以及第 5 节的下游分析与附录 A 的筛查细节。引用 99.94% 时必须写明它只针对 WildChat 与 WildJailbreak 两个子集,并把 274 对(1.2%)这类残余问题一起引用;「拒绝行为随语言翻转」只适用于被测的两个 7–8B 模型与当前的判官口径 79
7. 波斯语仇恨言论 7 跳基准:1,200 条样本、8 个模型,严重度 macro F1 最高 50.7 低于一级分诊的 82.8
From Triage to Impact: A Multi-Hop Reasoning Benchmark for Explainable Persian Hate Speech · arXiv:2610.20370 · 邻近跟踪
研究问题与核心方法:波斯语是仇恨言论研究里的低资源语言,已有工作多是把内容二分类,能判断「是不是仇恨」却说不清「怎么表达、为什么被框成有害、会造成什么后果」。作者把审核流程拆成一条七跳推理链:①内容分级(冒犯性言论/仇恨言论/危险言论/无害)、②目标群体与身份依据、③仇恨策略、④道德基础(基于道德基础理论)、⑤文本证据抽取、⑥有害叙事推断、⑦严重度与影响评估。标注由 Gemini 3.5 Flash 用思维链生成,再用人类标注做校验。
关键结果:
- 数据构成:共 1,200 条文本,来自以往工作的 348 条加本研究新采 852 条(用关键词在 X 上按发布时间过滤抓取并匿名化),一级分级的四个类别各 300 条。人类校验抽 100 条(每个类别 25 条)由两名母语标注者独立标注:分级与严重度一致性较高,叙事推断与影响评估这类开放式判断一致性较低;分歧由第一作者裁定。
- 评估设置:8 个模型,闭源为 Grok 4.6、GPT-5.2、o3、Claude Sonnet 4.6,开源为 DeepSeek R1、DeepSeek V3、Qwen3 30B A3B Thinking 2507 与 Qwen3 30B A3B Instruct 2507;全部 one-shot 提示、温度 0、top-p 1;第 2–6 跳只在参考标注为「有害」的实例上评测,保证同一套金标。
- 逐跳表现(表 3):第 1 跳四分类宏平均 F1,Grok 4.6 最高 82.8,GPT-5.2 79.7、Sonnet 4.6 79.2、o3 77.8,开源里 DeepSeek R1 75.0 最好,Qwen3 Instruct 只有 48.0。第 2 跳目标群体宏 F1 从 Grok 的 65.6 到 Qwen3 Instruct 的 20.3,微 F1 与宏 F1 差距大,说明少数类别覆盖差。第 3 跳仇恨策略的「自适应 F1」(是否至少识别出一个策略)普遍很高(77.3–97.7),但宏 F1 差距极大。第 4 跳道德基础相对第 3 跳微 F1 与自适应 F1 对所有模型都下降,自适应 F1 仍有 71.2–89.8。第 5 跳证据抽取里策略理由最好、道德理由最难复现,BERTScore 一致高于 Jaccard。
- 严重度(表 4):宏 F1(macro-F1,各类别等权的平均 F1)最高是 GPT-5.2 50.8 与 Grok 4.6 50.7,Sonnet 4.6 与 DeepSeek V3 为 43.5、43.9,DeepSeek R1 32.1、Qwen3 Think 27.9、Qwen3 Instruct 29.9;加权 Cohen's κ(κ 是校正随机一致的序数一致性系数)从 Grok 的 0.829 到 Qwen3 两版的 0.525。作为参照,第 1 跳同规模四分类的宏 F1 是 82.8,作者据此说明越靠后越难。
- 多跳是否有用:把第 1–6 跳的中间结果喂给严重度预测,相比一次性直接判断,「宏 F1 在 8 个模型中有 5 个提高,加权 κ 对全部模型都提高」——作者自己的解释是序数一致性上的收益比分类性能上的收益更稳定。
- 关联分析:出现「煽动暴力或伤害」策略的内容落在最高严重档的条件概率为 70%,「呼吁歧视或排斥」为 51%;用卡方检验加 Benjamini–Hochberg 校正后,六种策略中五种与严重度显著相关,只有「阴谋论」不显著。身份依据上,政治立场与「颠覆」道德框架的关联最强;校正后最强的效应量为伤害×个人身份(Cramér's V = 0.281,V 是类别关联强度的效应量)、伤害×组织/机构归属(0.273)、背叛×政治立场(0.271)。目标群体识别召回率上,移民与族群/宗教少数群体在 Grok、GPT-5.2、o3、Claude、DeepSeek R1 上超过 80%,而人权/媒体/学术活动人士对每个模型都低于 61%、对所有开源模型低于 50%。
证据与局限:这是观察性关联分析,作者用了卡方、Benjamini–Hochberg 校正与 Cramér's V 报效应量,只能读成「关联」不能读成因果;评估样本较小,逐模型指标是否报置信区间在正文中未给出。作者自陈三条局限:只覆盖波斯语与 X、Instagram 两个平台;数据集在四个分级类别上人为均衡,不代表社媒真实分布;基准规模偏小,稀有目标群体、身份依据与策略覆盖不足。引用风险:参考标注本身由 Gemini 3.5 Flash 生成,人类一致性在开放式任务上偏低,跨模型分数比较应限定在这一标注口径内。
与目标研究线的连接点:可搬走的是「把审核/判断拆成逐跳可核验的子任务,并用同一套金标逐跳报告」这一评测骨架,以及它的两个副产品口径:一是「多跳中间结果是否改善最终判断」的消融(同时报分类 F1 与序数 κ),二是对开放式子任务同时报词汇重叠与语义相似度、并分别报平均与最大匹配。这套写法可以原样搬到智能体长链决策的评测上:不是只问最终答案,而是每一跳都给出参考标注与逐跳指标。基准与代码在 https://github.com/kalhorghazal/From-Triage-to-Impact,实测 HTTP 200。
结论建议:读第 2 节(七跳定义与输出 schema)、第 4.1 节的逐跳结果与第 4.2 节的关联分析。可迁移的是评测骨架与「多跳助益」的对照方式;引用严重度绝对值时必须写明这是 1,200 条、参考标注由 LLM 生成且类别均衡的波斯语基准,且策略与严重度的关系是关联而非因果 80
十、邻近跟踪:评测口径、判官效度与领域评测
1. 回归式元评估:10 语言 4 维度 32 指标,校准后简单指标可与最强 LLM 判官相当
Fantastic Metrics and How to Find Them: Meta-Evaluating Metrics for Multi-lingual Style-Personalized Generation · arXiv:2610.19166 · 值得扫读
研究问题与核心方法:本文作者来自哥伦比亚大学与约克大学。文本生成指标与 LLM 判官(LLM-as-a-judge,用大模型给生成结果打分)通常以「指标与人类打分的相关系数」做元评估,但相关会随数据集、语言与打分分布漂移。本文改用回归式元评估:先把每个指标的输出单调校准到人类打分尺度,再训练回归器预测三名标注者的可靠性加权共识,把留出误差归一化到「平凡基线(永远预测训练折均值)」与「人类可预测性上限(单个标注者预测另两人共识的误差)」之间,得到跨设置可比的 Ψ 分数;任务选多语言风格个性化生成 SPTG(把源文本改写成参考文本的风格)。81
关键结果:
- 语料构成(表 1):10 种语言 × 4 个评估维度(风格准确性、事实准确性、泄漏、可用性)= 40 个评估设置,共 10,038 条实例,每条两个候选改写、三名标注者按序数打分,并有一条二选一偏好。81
- 元评估规模:32 个指标跨字符串、嵌入、LLM 判官三类范式并含若干集成,用同一套 5 折交叉验证重复 5 次。81
- 原始相关口径(表 2):最好指标平均 Spearman ρ=0.56,其中泄漏维度最高 ρ=0.76、风格维度最难 ρ=0.40;LLM 判官整体约 0.53–0.56。81
- 校准后(第 7.2 节):风格维度上全指标集成 Ψ=0.78,接近最好单指标 LaBSE 或 Verbatim 的 Ψ=0.43 的两倍;事实与泄漏维度上字符串和嵌入类指标可与最强 LLM 判官相当。81
- 标注属性(第 7.2 节):标注者间一致性(序数 Krippendorff α,泄漏 0.85、事实 0.79、风格 0.76、可用性 0.75)与归一化分数呈强负相关,Spearman ρ=−0.71。81
证据与局限:有三名标注者、5 折重复 5 次与完整标注者间一致性报告;作者自陈没有单一指标在所有语言或维度上普遍最好,且校准本身需要人类标注。入口实测:
https://arxiv.org/html/2610.19166v1/ 与代码库 https://github.com/anubhav-jangra/multilingual-sptg-eval 均为 HTTP 200。引用风险:Ψ 的绝对数值依赖归一化定义与该语料的人类共识上限,不能跨任务直接搬用。81与目标研究线的连接点:与同节评测口径类工作的差异是它不给新指标,而给「怎么比较指标」的框架;可搬走的一件东西是「校准 + 双锚点归一化」,以及「集成只在信号薄弱、单指标差异小的维度上收益最大」这条经验口径。81
结论建议:读第 5.2 节(Ψ 的定义)与第 7.2 节(校准、标注属性、集成三段结论);若频道要校验自己的 LLM 判官或自动指标,可套用这套归一化;引用时必须写明 Ψ 是在该 10 语言 4 维度语料、以该人类共识为上限得到的相对量。81
2. 138K 对齐、人类 F1 0.703:多摘要分级显著性评分把模型间一致性提到 0.716
The Sum of All Summaries: PropAlign for Graded Proposition Salience Evaluation · arXiv:2610.19387 · 值得扫读
研究问题与核心方法:命题显著性(proposition salience,文档里哪些小句最该出现在摘要中)在以往工作里定义含糊、数据不公开,也很少直接在任务上评测模型。作者把它操作化为一条可检验的假设——若某命题在文档中显著,摘要就很难不提及它——并用多份摘要抵消单份摘要的主观性:直接问模型叫 DPSal,对齐单份摘要叫 SaPSal,累积五份摘要给出 0–5 分的分级分数叫 GaPSal。分析单位取基本语篇单元(EDU,修辞结构理论中大致对应小句或谓词),数据基于 GUM 语料,覆盖 16 个口语与书面体裁。
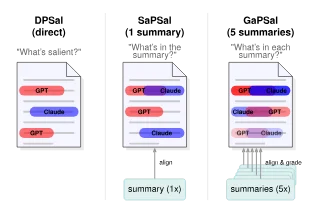
同一文档上直接询问显著性与多摘要对齐两种做法:右侧摘要式判断的重叠度明显更高(arXiv:2610.19387)
关键结果:
- 模型间一致性上,摘要式明显更稳:GPT 与 Claude 的互相 F1 从直接提问零样本的 0.464 升到摘要零样本 0.716、摘要一样例 0.767,作者报告一样例优于零样本、摘要式优于直接提问(p<0.05)。
- 对人工金标(池化二值口径),最好的直接提问配置是 Claude 一样例、F1 0.517,而摘要零样本下最弱的 Qwen 也有 0.580;McNemar 检验显示摘要零样本 Qwen 显著优于基线一样例 Claude,χ²(1, N=3,571)=5.10、p=.024。摘要一样例 Claude 的 F1 0.709 已接近人类 0.703,作者称二者差异不显著。
- 换成逐个 EDU–摘要对的细粒度评测,人类仍领先:人类 F1 0.703、MAE 0.328、RMSE 0.798;调好的 Random Forest 集成 F1 0.622、MAE 0.431、RMSE 0.988。集成的改进有统计支持(对 Claude 零样本 χ²(1,N=17,855)=20.59、p<.001;对 Claude 一样例 14.61、p<.001),人类相对集成仍显著更好(χ²(1,N=8,585)=39.47、p<.001)。
- 分级口径还压小了模型间差距:直接提问下小模型 Qwen 与 Claude 差 27 分,摘要式下只差约 10 分;Qwen 一样例的 RMSE 为 0.973,低于 Claude 的 0.993 与集成的 0.988,但仍高于人类的 0.798,作者说明这是因为它的错误多是 1 分偏差(假阳性补偿假阴性),与它 F1 最差并不矛盾。82
证据与局限:PropAlignBank 共 275 篇文档、35,270 个 EDU、176,350 条对齐(dev 32/3,896/19,480,test 32/3,779/18,895,train 211/27,595/137,975),摘要里的 138K 对齐对应的是训练分区,全部人工标注只有 dev 与 test 的数万条。作者自陈局限:预设而非证明「以摘要为准的显著性」是好目标,未与抽取式摘要等既有任务比较;仅英文;完整流水线要五份摘要加多次模型运行,代价高;集成方法用到 GUM 的人工标注,不能直接用于未见数据。两个引用风险:§5.3 先说 Claude 的 MAE 最好、随后又说集成给出最好的 MAE,而表 4 里集成 MAE 0.431 低于 Claude 0.452,引用 MAE 结论时须写明比较范围;Qwen 的 RMSE 最低只在模型与集成之间成立,不能写成「Qwen 最好」。82
与目标研究线的连接点:与本线上其它评测类工作的差别在于,它把「判据本身不稳定」当成要解决的问题,并用「多份参考摘要 + 分级分数」这套重复测量结构把主观判断变成可比较的连续量,这正是长节目与长文档级评测常缺的一环。可搬走的具体做法有两条:用多份参考而不是单份参考合成一个 0–N 的分级分数;以及用 McNemar 检验比较「最好基线」与「最差改进配置」这类跨越方法边界的对照。82
结论建议:读 §4.1(三种设定 DPSal/SaPSal/GaPSal 的定义)、表 2(一致性)、表 3(对人工金标)与表 4(细粒度与集成)。若要在自己的长内容评测里搬它的口径,注意它只测英文、且分级分数允许「对的分数、错的对齐」,因此不能当作配对级判断质量来引。原文未给出代码或数据入口,只声明接收后公开,无法现场复核数据构成。82
3. 决策模型改名换序只改 2–8% 判定,但表格组织方式一变就有约三分之一的行判定翻转
Typed Decision Models on Tabular Data · arXiv:2610.19536 · 邻近跟踪
研究问题与核心方法:类型化决策模型(typed decision model,下称决策模型)不回生成文本,而是对预先固定的候选答案一次性返回每个选项的概率。作者在表格数据上比较 4 个决策模型(Jev 1.13、Clef、Kev-27B、GPT-6 Luna Decisions)与 3 个 LLM(GPT-6 Luna、Qwen3.8-27B、Llama-3.3-70B),三项任务分别是行分类(TabLLM 与 FeatLLM 的 10 个数据集、3,481 行)、事实核验(TabFact、2,000 条断言)与异常检测(ReTabAD、20 个来源、5,059 个样本)。每个请求除了原始写法,还会以 21 类「保信息改写」(rewrite,如重命名选项、换表格格式)各发一遍,并把同一请求重发的翻转率(re-send rate)当作噪声基线。作者为 Baowen Zhang、Hangting Ye(通讯)、Hongyuan Zha,机构为 University of Wisconsin–Madison、吉林大学人工智能学院与香港中文大学(深圳)数据科学学院。83
关键结果:
- 原始写法下的性能(行分类 Macro-F1 / TabFact 准确率 / 异常检测 AUROC):GPT-6 Luna Decisions 61.2、78.7、80.5,Kev-27B 55.2、88.8、81.2,Clef 58.4、85.0、74.7,Jev 52.1、89.7、74.6,对照 GPT-6 Luna 62.5、79.0、77.3(Table 3)。83
- 问题表述鲁棒性:重命名或重排选项只改变 Jev、Clef、Kev-27B 的 2–8% 判定,最多高出各自重发率 5.5 个百分点,Macro-F1 变化不超过 1.3 点;同样改写改变开源 LLM 的 14–30% 判定,最多损失 11.5 点(§4、Figure 3)。83
- 但 GPT-6 Luna Decisions 不具备同样的表述鲁棒性:反转选项顺序改变其 23% 的行分类、12% 的 TabFact 判定与 22% 的异常检测判定,且 92–100% 的翻转都倒向改到首位的选项(§4)。83
- 表格组织鲁棒性:至少一类表格改写会改变 Jev 33.8%、Clef 31.7%、Kev-27B 32.2%、GPT-6 Luna Decisions 39.6%、GPT-6 Luna 42.8%、Qwen3.8-27B 31.8%、Llama-3.3-70B 35.5% 的行分类判定,而开源模型重发同一请求只改 2–9% 的行(Table 5、§5)。83
- 置信度标记易变判定:决策模型的翻转 AUROC(AUROC,ROC 曲线下面积)为行分类 0.82–0.87、TabFact 0.81–0.90、异常检测 0.84–0.93,其中 GPT-6 Luna Decisions 三项最低;置信度最高的 25% 项目里只有 0.1–5% 会被某类表格改写翻转,而整体约三分之一会翻转(§6、Table 6)。83
- 把置信度当配额用:全体重问只让 Macro-F1 涨 2.0–6.4 点,但只重问最不自信的 25% 行(平均多一次请求)就回收 79–89% 的增益(决策模型)与 64–86%(LLM),随机挑行只回收 23–44%(§6、Figure 4)。83
- 成本对照:Jev 与 GPT-6 Luna Decisions 每次判定 0.08–0.11 秒,GPT-6 Luna 为 0.73–1.62 秒;百万次判定计费 Jev 为 10/38/16(行分类/TabFact/异常检测,美元),GPT-6 Luna 为 81/62/68(Table 4、§3)。83
证据与局限:作者自陈每个模型只测一个版本,Jev 与 GPT-6 Luna Decisions 是闭源服务且 Decisions API 仍在公开测试阶段,接口内部不可见;21 类改写不覆盖改列名、换算单位等保信息改动,因此结论不能外推;覆盖的三类任务都用基准子集。所有改写都做了可逆性检查(能还原原请求),且 TabFact 中依赖位置(如「first」)的断言被排除出第三、四问。原文未给出本研究的代码或数据仓库,正文引用的是被测模型入口:[https://docs.[typesafe.ai](https://typesafe.ai)](https://docs.[typesafe.ai](https://typesafe.ai)) 、https://huggingface.co/Cloudflare/clef 、https://github.com/jaredpalmer/kev 、[https://developers.[openai.com/api/docs/guides/decisions](https://developers.openai.com/api/docs/guides/decisions)](https://openai.com/api/docs/guides/decisions](https://developers.openai.com/api/docs/guides/decisions)) 均实测 HTTP 200。83
与目标研究线的连接点:可搬走的一件东西是这套「改写审计」口径本身——把同一请求的重复发送率当噪声下限、用逐项配对而不是比较两个平均值、再用翻转 AUROC 检验置信度能否标出易变项;它同样适用于 A 线里按固定选项作答的判官与门控(如通过/不通过、动作类型选择),以及任何以文本序列化格式喂给模型的评测。与同节的判官效度条目相比,它额外给出「低置信度配额重问」这一可操作的代价—收益曲线。83
结论建议:读 §2.3(口径定义)、§4 与 §5(两类鲁棒性)、§6(置信度与重问配额)、Table 4(成本)。可迁移:把重发率写进评测协议、对选项顺序做配对检验、用低置信度子集做多格式重问;引用时必须限定是表格三项任务上的 7 个模型、每模型单版本,且「决策模型更省更稳」只对 Jev、Clef、Kev-27B 成立,不能覆盖 GPT-6 Luna Decisions。83
4. 同一提示可反号:CoD 让 Phi 多答对 15 题、让 Qwen 少 32 题
RCCM: Diagnosing Gains and Harms in Reasoning-Prompt Transfer · arXiv:2610.19872 · 值得扫读
研究问题与核心方法:原文未报告作者机构(作者为 Yuqi Zhang 与 Di Zhang)。同一个推理提示迁到另一个部署(含检查点、对话封装、解码策略、输出预算与答案解析器的整套配置)未必保留收益。RCCM(Reasoning-Control Capability Mismatch,推理-控制能力错配)把提示迁移当配对问题处理:对同一批问题分别跑基线与目标策略,记录每个回答的停止状态(正常、长度截断、接口失败)与答案匹配结果,把净准确率变化分解为「执行类别出现频率 × 类别内收益或损害」(收益 rescue、损害 harm),并给出迁移差异的上界。84
关键结果:
- 开发面板(表 1、表 2):5 个开源部署(Qwen 2.5 7B Instruct、Gemma 3 4B、Llama 3.2 3B Instruct、Mistral 7B、Phi-4 Mini Reasoning 3.8B)× 9 个策略 × 120 题 = 5,400 条结果;CoD(Chain of Draft,要求极简中间步骤)使 Phi 多答对 15 题、使 Qwen 少 32 题。84
- 同分不同答(第 5 节):Qwen 上 CoT 与 KSD 同为 88/120,但 KSD 救回 10 题、损害 10 题,共 20 题正确性改变而总准确率不变;5 个部署两两策略排序的平均 Spearman 相关仅 0.394(Gemma–Phi −0.139 到 Gemma–Llama 0.831)。84
- 统一预算的 MATH500(表 3):6 个候选、3 个部署、500 题、统一 2,048 token 上限,6 候选 oracle 为 86.0%/84.8%/68.2%(Qwen/Gemma/Llama),分别高出最好固定策略 13.4/10.0/26.2 分。84
- 追加 60 题 × 2 部署 × 4 提示 × 2 预算 = 960 个任务(第 6.2 节):Phi 在 2,048 token 下从 37 提到 45 个匹配(+13.3 个百分点),Holm 校正后 p=.03125;换端点后结构化答案范围为 +20.0(p=.00293),人工复核的答案承诺仅 +6.7(p=.2891,未达显著)。84
- 答案阶段对照(表 7,同一 2,048 token 上限与预留 128 token):完整提示 38 个匹配、简洁 41、完整加答案阶段 50、加警告 51,后两者在 24 项族内校正后显著优于完整。84
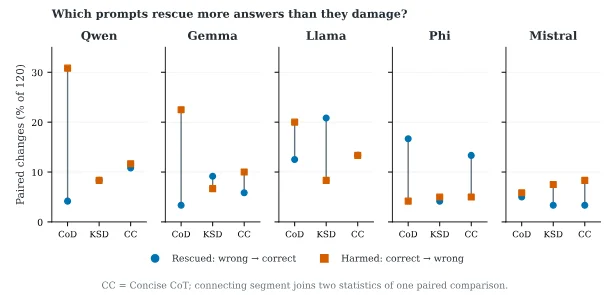
五个部署上各策略相对思维链的救回与损害配对计数,以及净准确率变化(arXiv:2610.19872)
证据与局限:用精确配对 McNemar 检验并做 Holm 校正、20,000 次配对自助区间、题目聚类与重复采集两套不确定性;作者自陈答案承诺标注只覆盖最初的 Phi 对照且为单人复核、重复采集复用同一 60 题、结论限于英文数学与指定开源部署,同一批回答换端点会改变结论。入口实测:
https://arxiv.org/html/2610.19872v1/ 为 HTTP 200;原文只提到 artifact 但未给出代码或数据链接。引用风险:匹配 +13.3 与承诺 +6.7 直接冲突,引用必须点明端点。84与目标研究线的连接点:与同节评测口径类工作的差异是它不做预算控制器,而是固定一处提示编辑后做配对归因;可搬走的一件东西是「收益/损害配对分解 + 停止状态分类 + 三端点对照」这套评测记录,可直接用于评估「给智能体加某条提示或流程」的真实效果。84
结论建议:读第 3 节(配对执行模型)、第 6.2 节与表 5、表 7;做提示或流程 A/B 评估时可搬其三端点与配对归因;引用时必须同时给出端点、token 预算与是否通过多重比较校正。84
5. semCER:LLM 判官按五级分布给字符编辑计严重度,6,100 万条编辑上蒸馏学生偏差 0.04
Equal CER, Unequal Damage: Severity-Weighted Character Error Rate for OCR · arXiv:2610.20461 · 值得扫读
研究问题与核心方法:字符错误率(CER,character error rate)是 OCR 与视觉语言模型评测的标准指标,但它把拼错的普通词和写错的人名同样计费。semCER 保留 CER 的对齐与分母(不引入分词,因此对字母文字、元音附标文字、辅音音素文字与不分词文字同一套定义都可用),把每个字素编辑的代价换成一个 LLM 判官给出的严重度:判官在五级量表(0=纯装饰、完全可恢复;1=非词或明显错误、靠上下文可恢复;2=合法但读者可能注意到;3=恢复失败但错误可察觉;4=读起来通顺却是假的、无信号)上给出概率分布,取期望值作为代价,因此同级内部仍可区分;指标是各编辑代价之和,可以逐条报出,于是除了分数还能给出「先看哪些错」的排序。85
关键结果:
- 规模:判官覆盖 7 个系统、25 个公开数据集、16 种语言,共 6,100 万条编辑(原文作 61 million,过滤后 229,395 行转写)。85
- 在整篇转写层面,归一化 CER 与读者评分的 Spearman ρ 为 0.93/0.90/0.76(英/越/中),semCER 为 0.89/0.87/0.76——总分上归一化 CER 不输,所以 semCER 的价值不在替代总分。85
- 在两者排序相左的偏好池上(英 173 / 越 163 / 中 146 对,平局算错),读者多数站 semCER:英语 0.71 对归一化 CER 的 0.58、中文 0.78 对 0.60(带星号表示显著),越南语 0.79 对 0.80 打平。85
- 差距最大的子集是「归一化不改判」的对子(normalization-proof pairs,英 22 / 越 30 / 中 30 对):semCER 为 0.77/0.53/0.83,归一化 CER 为 0.09/0.50/0.47。85
- 读出方式本身有效:读判官的完整分布比只取最可能级别更能对齐读者(「给定众数级别后的严重度」在越南语与中文上仍提升);只用判官标签的三类固定权重(OK/minor/critical)或整句一次打分,都显著不如 semCER。85
- 跨语言:加错一个附标/声调这类「最小错误」的代价随文字系统剧烈变化,从西班牙语近乎 0 到泰卢固语接近一个错字母;在有标记的 15 种语言上,「最小学错代价」与平均严重度的秩相关为 0.75(英语 0.26 到泰卢固语 0.74)。85
- 蒸馏可本地复算:把判官蒸馏成 Qwen3.5-0.8B-Base 学生(不改权重外发),与读者的相关为 0.79/0.63/0.80,判官为 0.81/0.66/0.82;在判官严重度相差 ≥0.5 级的编辑对上,十对里九对排序一致,逐编辑平均绝对偏差 0.04。85
证据与局限:人评可靠性中到高——三语三个池子(单编辑 ~85 条/语言、句子对 ~180 对、偏好对 ~175 对)的 Krippendorff α 为 0.51–0.79、ICC(2,k) 为 0.81–0.92;区间为 10,000 次百分位 bootstrap,比较在 Holm 校正下判定。局限(作者自陈):只有英、越、中三种语言有人读验证,其余 13 种语言的可读性完全来自判官;判官 checkpoint 在研究期间被提供方更换,严重度只在同一版本内可比(人评池中被首次判为「无判定」的编辑才用新版本复判);量表某一级要求判断是否为真词,因此「通用 VLM 的错字母更贵」这一结论部分来自量表构造本身;「通用 VLM 与经典流水线」的 24 个语言×域配对里只有 8 个显著,作者预设的判据(每个 VLM 都高于 EasyOCR)并未满足;下游任务收益未验证。85
与目标研究线的连接点:这篇不在四条线上,能搬走的是三件判官口径层面的东西,对 C 线的语音转写评测与「判官效度」议题都直接可用:一是把连续型严重度从判官的概率分布而不是单一标签读出,同级别内仍能区分;二是在总分指标上不替换成熟的归一化指标,而是把它当作打破平局、定位错误的第二指标(正文明确建议「整篇用归一化 CER,选优与定位用 semCER」);三是用蒸馏学生把判官固化成固定权重,避免提供方更换 checkpoint 导致分数不可比——这正是所有用 API 判官做长期评测的团队会遇到的问题。85
结论建议:读 §3 的定义与判官量表、§6 的读者偏好对照(含 normalization-proof 子集构造)、§8 的蒸馏与表 5、表 6。对做 ASR/TTS/OCR 评测的人,量表与「读者偏好对」的构造方式可以直接借用。引用时必须限定为三语人评、特定判官版本,并声明「归一化 CER 在整篇总分上不输 semCER」。代码与数据入口 https://github.com/nguyenx2t/semcer 实测 HTTP 200(原文称发布 6,100 万条已判编辑、聚合读者评分与蒸馏评分器)。85
6. 8 个 LLM 英/孟 XL-Sum 零样本摘要评测:判官给流畅度 4.78–5.00、忠实度只有 1.10–1.34
Evaluating Large Language Models for Multilingual Abstractive Summarization: A Comprehensive Study of English and Bengali · arXiv:2610.19003 · 邻近跟踪
研究问题与核心方法:伊斯兰科技大学(Islamic University of Technology, Gazipur, Bangladesh)计算机科学与工程系的 Khan Mahi Al Atahar、Nazifa Tasneem 与 Ajwad Abrar 要回答的是「单一指标能不能衡量多语言摘要质量」。他们在 XL-Sum(基于 BBC 新闻的多语言摘要语料,覆盖 44 种语言)的英语与孟加拉语测试集上做零样本评测,英语侧随机抽 1,012 条以匹配孟加拉语测试集条数(固定随机种子 random_state=42),模型是 8 个(4 个闭源、4 个开源权重)。评测拼三路:词面与语义指标(ROUGE-1/2/L、BLEU、chrF、BERTScore-F1,全部换算到 0–100 分)、无参考答案的事实性 QG/QA(问题生成/问题回答)校验(先用 gpt-4o 从生成摘要抽实体并生成事实问题,再用源文与摘要分别作答并做语义比对,英文口径为 SummEval F1,孟加拉口径为 BanglaSummEval F1)、以及用 gpt-5.6-terra 做 LLM-as-a-Judge 的六维打分 86
关键结果:
- 语言不同、头名不同:英语 ROUGE-1 最高是 GPT-5.6 Luna 的 24.12,孟加拉语 ROUGE-1 最高是 LLaMA 3.3 70B 的 16.23(表 2,0–100 分尺度) 86
- 孟加拉语 ROUGE-1 上 LLaMA 3.3 70B(16.23 ± 9.05)对 GPT-4o Mini(15.63 ± 8.27)的配对 t 检验 p=0.0067,5,000 次配对重采样的 bootstrap p=0.0070(表 3,N=1,012) 86
- 事实性头名与词面头名不是同一个模型:英文 SummEval F1 最高是 DeepSeek V4 Flash 的 63.45,孟加拉语 BanglaSummEval F1 最高是 Gemini 2.5 Flash 的 58.43;Gemini 3.1 Flash Lite 两种语言都最低(52.28 与 49.73) 86
- 判官六维里流畅度集中在 4.78–5.00、连贯性 4.22–4.82,而忠实度只有 1.10–1.34;英语在相关性(2.84–3.16 对 2.36–2.60)与完整性(3.26–3.54 对 2.40–2.73)上都高于孟加拉语(表 4,1–5 分) 86
证据与局限:判官评测只抽每种语言 100 条样本(同样用 random_state=42),词面指标报了 95% bootstrap 置信区间与配对显著性,判官分数没有;每种语言只有一条自动流水线、一个判官模型。作者自陈的局限包括只做零样本一种设置、每条流水线只用一个评测模型、语料只覆盖英语与孟加拉语的 BBC 新闻。我自己的引用风险提示有两条:一是事实性分数由 BERTScore 语义匹配聚合而成,不是人工标注,不能当黄金标签;二是表 1 的模型清单(GPT-5.6 Luna、Gemini 2.5 Flash 等)以原文为准,不要用二手摘要里的模型名。入口实测:原文 HTML(v1)与代码仓库 https://github.com/khanmahijyoti/multilingual-llm-summarization 均返回 HTTP 200 86
与目标研究线的连接点:同节的评测口径类工作多在讨论判官是否可信,这篇的价值是把「指标之间排名不一致」直接做成结论——词面指标的头名与事实性的头名是不同模型,孟加拉语上判官排名与事实性校验也互相冲突。可以搬走的是它的三路拼装(词面/语义 + 无参考答案事实性 + 分维度判官)和一条前置纪律:跨语言比较前先把两类语言的样本条数对齐 86
结论建议:先看表 2(主结果)与表 3(配对显著性),再看 4.3 节与表 4 的判官六维。可迁移到 A、C 线的多语言评测口径:任何跨语言对比都要声明样本是否同源、判官模型是否单一、事实性是否另有一路校验。引用时必须限定为「零样本、BBC 新闻域、英语与孟加拉语」,并注意文中所有指标都是 0–100 尺度 86
7. 零样本 LLM 从姓名推族裔达 83.8%,高于补名 BISG 的 78.0%,并给出 agent 抽样核验流程
Pre-Trained Language Models as Zero-Shot Tools for Social Science Research · arXiv:2610.19048 · 邻近跟踪
研究问题与核心方法:记录链接(record linkage,判断两份数据里的记录是否指向同一实体)与从姓名推断族裔/群体,通常需要难以获得的标注数据或特定人群的姓名频率表。作者主张这两类都是「世界知识」任务,预训练语言模型已经在权重里带着所需知识,因此可以零样本完成。记录链接用 EnsembleLink:把每个查询对目标库做密集与稀疏两路检索取出候选短名单,再让多个打分器(重排序器、稠密相似度、字符 n-gram、Jaro-Winkler 等)各自投票,按「与多数意见一致的平方」加权融合,全程不需要标注数据;族裔推断则直接用「全名 + 居住县」提示模型输出四类种族之一。87
关键结果:
- 在佛罗里达与北卡的选民名册(每州分层抽 10,000 人,四类各 2,500)上,全名 + 地理的 Gemini 3.0 Flash 准确率 83.8%、BISG(贝叶斯改进姓氏地理编码,此处为补入名字的「name-supplemented」版本)78.0%;北卡为 83.5% 对 78.4%。87
- 不给地理信息时准确率几乎不变(佛州全名 82.8%,对全名 + 地理的 83.8%),而 BISG 在没有地理时根本无法估计——这是 LLM 相对既有方法的结构性优势。87
- 差异集中在少数族裔:Gemini 在两州正确识别的黑人选民都比补名 BISG 多约 15 个百分点,亚裔多 10–12 个百分点;白人则是 BISG 更高,拉美裔两者接近。87
- 记录链接:默认配置(密集 + 稀疏候选)在 7 个基准上平均检索召回 96.4%、平均 F1 85.2%,逐基准 F1 从职业任务 56.1、产品表连接 66.6 到 Wikipedia 99.6;作者报告在名字跨文字系统书写时优势最大。87
- 融合确实优于任何单个专家:北卡选民上一致性加权融合 97.8%,最强单专家(字符 n-gram)96.5%、最弱(Jaro-Winkler)91.6%。87
- 无标注的可迁移细节:若把阈值固定为「重排序器对首选候选的概率 ≥ 0.5」(不需要任何标注),EnsembleLink 平均只掉 1.5 个 F1 点。87
- Agent 核验:作者用带联网检索的 LLM agent(Claude Code)对抽样输出逐条核验,同时记录判定、理由与所引来源,称其不能完全替代人判,但可重复、能生成详细文档,且在本文样本规模下最多花几美元。87
证据与局限:记录链接的比较做得比较干净——同一批字段、统一在验证集上选阈值、报告 95% bootstrap 区间,并把「用 LLM 给测试对打标」的 fuzzylink 分别按「原样标注测试数据」和「只在验证集上训练后冻结」两种口径报告(后者被作者视为更公平);但 fuzzylink 的口径争议本身说明这类 LLM 标注器与无标注方法难以完全对齐。族裔推断部分:单一作者、开源模型与商用模型混用、只用 2011 年前后的人口统计与四个州的选民名册,作者明确提示下游估计的偏差减少不等于个体标签可靠;模型面板里不同模型评分样本不同(Table 缩写说明中部分模型只在一个随机样本上评分)。最弱的一环是 §6 的 agent 核验:只有「可重复、有文档、几美元」的定性描述,没有任何与人评的准确率对照,也没有抽检条数——引用时只能当作流程建议,不能当作已验证的评测方案。原文未给出代码或数据入口,只在正文提到「复现材料里包含样本、提示、脚本与逐条理由与文档」。87
与目标研究线的连接点:连接点不在社会科学,而在「用 LLM 当标注器/核验器」这一条:对 B 线(自进化)而言,generate→verify→train 里的 verify 环节可以直接借它的两条做法——一是把多个弱打分器按「与多数意见的一致度平方」加权融合、完全不用标注;二是让 agent 抽样核验并强制留下理由与来源,作为廉价、可复现的中间层把关(本篇的警告也要一并搬走:它没有证明这层把关可靠)。与同节 semCER 的互补在于:semCER 关心判官给出的分值是否可信,本篇关心「能不能不用标注就把数据标出来」。87
结论建议:读 §4.1 的 EnsembleLink 与 §4.2 的基准口径、§5.2 与表 2(输入配置与分类别召回)、§6 的 agent 核验。对四条线的直接价值有限,只在需要「零标注生成监督信号」或「agent 抽样核验」时按连接点取用;引用时必须写明族裔准确率是特定州名册上的四分类结果、BISG 为补名版本,并把 agent 核验标为未经准确率验证的流程建议。87
8. DUALVIEW:5 项任务 8 个 LLM 上 Pearson 提升 18.4%,可训练参数只 5.1K–57.4K
DualView: Leveraging Broad and Output-Specific Evidence for LLM-based Multi-Output Text Regression · arXiv:2610.19206 · 邻近跟踪
研究问题与核心方法:多输出文本回归(MOTR,multi-output text regression:同一段文本要同时预测多个数值指标,例如摘要的流畅度、事实性、连贯性,各指标量纲还不一样)此前要么微调整个 LLM,要么给每个目标单独训一个预测器,代价随目标数增长,且架构常与领域强绑定(如只适合作文评分的图结构)。DualView 把专门化从「预测架构」挪到「证据抽取」:每个输入构造一个 broad prompt(任务说明 + 输入)和 D 个 focused prompt(再追加只针对第 j 个目标的短指令),broad 视角对所有 token 做 mean pooling 得到向量、focused 视角取最后一个 token 的隐状态;前者用降秩回归联合预测所有目标,后者用一个跨目标共享的线性预测器逐目标打分,两支预测标准化分数相加后反标准化。LLM 骨干全程冻结。88
关键结果:
- 汇总(5 个数据集、8 个 LLM 骨干、21 个输出目标、3 个训练种子):DualView 的 Pearson 0.432、NRMSE(按训练集标准差归一化的 RMSE)0.873;第二强的有监督基线 GAT-AES 为 0.365 与 0.898,即 Pearson 提升 18.4%、NRMSE 降低 2.8%(Table 1)。
- 21 个目标里有 20 个做到最强,唯一打平的是 MSumBench 的 faithfulness(0.675)(§5.1、Figure 3)。
- 可训练参数 5.1K–57.4K,三个最强基线为 1.84M–20.98M,即多出 82–1842×(Table 2)。
- 与 few-shot 的 Gemini 3.1 Pro 相比(骨干换成 Gemma 4 31B):Pearson 高 30.7%、NRMSE 低 19.8%;五数据集平均 Pearson 0.455 对 0.348(Table 3)。
- 消融:两种证据合并比最强的单视图(满秩 broad ridge)Pearson 高 11.3%、NRMSE 低 2.1%;交替联合拟合优于分离拟合+α 融合(Pearson 0.432 对 0.419)(Table 4、Table 5)。
- 训练数据效率:从 64 条训练样本起,在五个数据集的每个预算档上都不低于三个最强基线(§5.3、Figure 4)。
- 统计可靠性:对两项关键消融做了按 source group 配对的 bootstrap(5000 次重采样),DualView 相对满秩 broad ridge 的 ΔPearson 区间为 [0.0328, 0.0497]、ΔNRMSE 为 [0.0134, 0.0229],均不含 0(附录 Table 20)。88
证据与局限:主表 3 个种子并报标准差,附录给了配对置信区间,但区间只覆盖两项消融,跨基线的总体提升没有区间。作者自陈四处局限:抽取的表示对提示格式敏感(每数据集只用一套固定模板)、需要模型内部表示因此对黑盒模型不可用、联合目标非凸、以及推理算力随目标数近似线性增长(可训练参数少不等于延迟低)。另需注意它是有监督回归器,每个目标都要有标注。88
与目标研究线的连接点:与同节几篇指向同一件事——给「用模型给多维度打分」找一个可比、可复核的口径。DUALVIEW 给的是「冻结表示 + 极小预测头」这条廉价路线,可以直接替换评测流水线里「微调整套模型」或「让大模型直接当判官」的那一步;§5.4 与 Gemini 3.1 Pro 的对照还能量化「小开源模型 + 少量监督」相对「前沿模型零样本」的差距。可搬走的设计细节是共享前缀复用(broad 与 focused prompt 共享前后缀,只算各自的后缀)与两支相加后统一反标准化。88
结论建议:读 §3.2–3.5 方法与 Table 1、Table 2、Table 3;要复现先看 §D.5 超参与 §D.3 的基线改法(基线都改成用冻结 LLM)。引用时必须写清是 5 数据集、8 骨干、21 目标的 macro 平均 Pearson/NRMSE,并说明 82–1842× 说的是可训练参数而不是推理成本;「优于 Gemini 3.1 Pro」的对照是零样本/四样本提示,不是同条件有监督。88
9. 两参数贝叶斯线索组合:4 个 VLM 上 OOD 预测偏好 R² 达 0.69–0.86,迁移无需重拟合
Vision-Language Models Integrate Conflicting Evidence Like Biased Bayesian Observers · arXiv:2610.19407 · 邻近跟踪
研究问题与核心方法:视觉语言模型(VLM)在文本与图像给出冲突答案时的取舍,此前多被描述成固定偏好(「盲信文本」或偏向视觉),但偏好为何随模型、领域、输入退化而变化没有解释。作者借人类感知的线索冲突范式,对文本与图像独立加退化(文本按比例 p 随机替换词、图像做高斯模糊 σ),把模型的偏好记成联合探针 s_J = log[P(a_T|t,v,q)/P(a_V|t,v,q)],再推导出一个两参数的贝叶斯观察者模型:s_J = β_T·e_T + β_V·e_V + π_0,其中 e_T、e_V 是两个模态各自的贝叶斯因子(由单模态探针 s_T、s_V 与先验 π_0 反推),β_T/β_V 是整合偏差。这样就能把「文本证据本身更强」与「模型偏心文本」两件事分开。89
关键结果:
- 数据与模型:2,765 条冲突样本(DocVQA 文档图、VQAv2 自然照片、RealworldQA 真实场景),4 个 VLM(Qwen2.5-VL-3B、Qwen3.5-4B、Gemma3-4B、GLM-4.6V-Flash),6×6 的 (σ, p) 退化网格。
- 采用半分布(OOD,out-of-distribution,分布外)协议:只用 11 个边界格(至多一个模态被退化)拟合,在 25 个内部格(两个模态都被退化)上测试;两参数线性线索组合的 R² 为 0.852(Qwen2.5)、0.800(Qwen3.5)、0.692(Gemma3)、0.860(GLM-4.6V)(Table 1)。
- 与竞争解释对比:最强单探针(跟更自信的模态走)低 0.22–0.35 个 R²,无权重校准朴素贝叶斯低 0.14–0.32 个;再加双线性交互项最多只涨 0.001、放宽成无约束线性最多涨 0.017,说明加性组合规则够用(Table 1、§4.3)。
- 迁移:把 text noise × blur 上拟合的权重不重拟合、直接用到 relevance × occlusion 网格,R² 仍有 0.785–0.832(Table 2)。
- 「盲信文本」被重述为证据强度问题:例如 Qwen2.5-VL 在 VQAv2 上 β_T/β_V 为 1.449[1.375, 1.514],而 Qwen3.5-4B 为 0.563[0.539, 0.626],即模型可以在行为上跟着文本走,却在拟合里给视觉证据更高权重(Table 3)。89
证据与局限:区间来自 bootstrap 的 95% 分位(附录 C.4),模型本身只有两个自由参数,其余表达力变体都做了对照,这一点比多数行为研究扎实。需要注意:参数在每个「模型 × 数据集」组合上重新拟合,跨数据集不可直接比较;四个模型都是 3B–4B 级开源模型(更大规模的复现放在附录);R² 衡量的是偏好 log-odds 的拟合,不是任务准确率;Gemma3 的拟合明显更差,作者自己指出该近似对某些模型不完整。89
与目标研究线的连接点:与同节几篇共享一个思路——把「判官/偏好行为」拆成可比的参数再验证,而不是只报一个胜率。最值得搬的是这套 out-of-distribution 协议(边界格拟合、内部格测试)和它区分出的两个诊断量:证据比(说得清是文本证据弱还是模型偏心)与整合偏差。做法也能迁移到任何「两个信息源冲突」的评测上:先用单源探针量出各自证据强度,再拟合一个带权重的加性规则,最后看额外项有没有增益。89
结论建议:读 §3.2 的模型形式与假设、§4.2–4.4 与 Table 1、Table 2、Table 3;若要迁移,先确认自己的「证据强度」可独立测量(这里是单模态探针)。引用时必须限定 3B–4B 级开源 VLM、合成退化网格和「偏好 log-odds 而非准确率」;「调和文本与视觉主导的两种报道」是作者的模型解释,不是新的行为结论。89
10. 法哲学推理基准 LePhilBench:220 份意见、9,240 条标注,法理画像总体 +11.74 点
How Do LLMs Understand Legal Philosophy? Diagnosing Legal-Philosophical Reasoning in LLMs · arXiv:2610.19427 · 邻近跟踪
研究问题与核心方法:论文问大语言模型(LLM)能否像法律专业人士那样「理解法哲学并在推理中应用」。作者构建基准 LePhilBench,含两项任务:法理画像 JP(Jurisprudential Profiling,读某法官的判决书,在 14 个由法学教授设计的对立法理维度上标注其倾向)与法理感知判决预测 JAJP(Jurisprudence-Aware Judgment Prediction,只给目标法官的法理画像与案情,预测其在该案关键法律问题上的 Yes/No 立场)。数据取自美国最高法院 Roberts 法院的 489 个案件(每案一份法院意见、一份异议),测试集 110 案、220 份意见,由三名受过法学训练的标注者给出 14 个维度的倾向标签共 9,240 条,判决答案由法学教授裁定。 90
关键结果:
- 无画像(No Profile)时 LLM 的答案 90.88% 落在法院意见一侧(即多数派);给出画像后,平均法院意见准确率下降 7.94 点、异议准确率上升 31.42 点、总体准确率提升 11.74 点(表 3)——画像把答案从「回忆多数立场」拉向「按画像推理」。 90
- 人—人 Fleiss κ(三名标注者间一致性系数)=0.474;LLM—人 pairwise agreement 与人之保持一致:人一致率最高(76.4%–81.2%)的五个维度 Q4、Q5、Q7、Q9、Q14 也是 LLM 一致率最高(75.3%–78.9%)的五个(图 2)。 90
- 不一致类型里 Uncertain(标注者给 A/B 而模型给 C)是多数模型的最大类;人类共识越低,模型越常选 C(图 3、图 4)。 90
- 画像聚合方法中 Exponential Decay 的平均增益最高;纳入「排他性加入者」(exclusive joiner,只加入该意见、未另写或加入本案其它实体意见的法官)的历史,对 Mean、Exponential Decay、Random Walk 三种聚合均有小幅提升。 90
证据与局限:每个实验跑 3 个种子取平均;JAJP 的 No Profile 对照按构造为 50%。局限是只覆盖 110 案、220 份意见的标注子集,仅美国法(民法法系需改维度);作者承认 LLM 可能靠预训练记忆,虽隐藏法官姓名仍不能完全分离记忆与推理,建议后续用反事实画像检验。数据集称「接收后公开」,目前无入口。 90
与目标研究线的连接点:可搬走的是一件评测设计:要判断「模型是否真的用了你提供的条件信号」,就隐藏身份线索并设「无信号」对照,用增量(此处为准确率增益)而非绝对分,同时报告人—人一致率作为上限参照。这套「对照 + 增量 + 上限」可直接移植到评测智能体是否真的用了它被喂的上下文或记忆。 90
结论建议:读第 3 节任务定义、表 3 与图 2–4。可搬 No-Profile 对照与增量口径、以及人—机一致率的对照分析。引用时限定:仅美国法、110 案标注子集、3 个种子,且不能排除预训练记忆的贡献。 90
11. AgriJev:一次前向的候选打分在 17 个外部视图上均值 75.44%,9B 中位延迟 93.80 ms
AgriJev: Efficient Agricultural Candidate Scoring with Multi-Scale Adapted Models · arXiv:2610.19478 · 邻近跟踪
研究问题与核心方法:很多农业决策本质是从候选里选一个(判断句、知识问答题),但用生成式模型作答要多走解码与抽取两步,还可能吐出不合法答案。作者(University of Minnesota Twin Cities,Xuechen Li)把这一步换成一个打分接口:把农业文本、判断问题和候选定义拼进同一个提示,模型保留 Qwen3.5 主干与原始语言模型头,只给查询/数值投影加 LoRA(low-rank adaptation,低秩适配),一次前向就返回各候选的分数与相对概率,取分数最高的候选作为选择。训练监督是候选集交叉熵,答案本身不进提示。规模覆盖 0.8B、2B、4B、9B。 91
关键结果:
- 17 个外部视图的均值(表 2):AgriJev-9B 为 75.44%,原生 Qwen3.5 生成式作答为 69.54%,同规模 SFT 生成为 71.65%,差 5.89 与 3.79 个百分点(「计算于四舍五入之前」);AgriJev-9B 在 13 个视图上超过原生生成、11 个视图上超过 SFT 生成。
- 其他规模的均值差更小:2B 为 59.19%(比其 SFT 高 0.27 个百分点)、4B 为 70.47%(高 0.57)、0.8B 为 53.55%(比 SFT 的 53.62% 低 0.07)。
- 任务级反转:CROP 视图上 9B 的 SFT 生成 93.02% 高于 AgriJev-9B 的 91.10%;同族里 AgriJev-4B 的 CROP 91.75% 也高于 9B 的 91.10%。
- 延迟(32 条 BIO 文本、27 个候选、A100 40GB、batch 1):AgriJev 在 0.8B/2B/4B/9B 的中位数为 42.96/41.90/60.93/93.80 ms,原生生成为 124.04/125.17/161.79/181.24 ms,比值 1.93–2.99;9B 的 SFT 生成为 189.16 ms,相对 AgriJev 的比值 2.02。
- 输出合法性:SeedBench 3-2 视图上两个生成式基线在 808 次决策中分别吐出 113 与 236 个非法编码(仍计入分母);即使把所有非法答案都当作正确做上界估计,原生生成也只从 69.54% 升到 71.02%、SFT 从 71.65% 升到 74.15%,仍低于 AgriJev 的 75.44%。 91
证据与局限:正文自己声明这些差异是描述性点估计,「不构成等价或统计显著性」;18 个外部视图中只有 17 个进入主均值,且作者明说它们不是 17 个独立创建的数据集;候选相对概率「没有被证明是校准的」,选择始终落在给定候选集内,只消除了输出格式失效、不保证语义正确;延迟是 32 条输入的单一工作负载,单次运行。原文未给出本方法的代码入口,只给出源数据与基线模型的 Hugging Face 页面;公共托管「仍未完成」。 91
与目标研究线的连接点:研究问题(农业候选评分)不在四条线上,可搬的是一件判定接口的替换:把「生成答案再抽取」换成「对显式候选项一次前向打分」,能消掉不合法输出这一类失败并把延迟压到约一半(观测比值 1.93–2.99),代价是失去解释、也没有校准概率。凡是评测里需要模型在若干选项中做选择或打分的环节(判官、选项式问答、标注),都可以按这个接口改造,并照它的写法把非法输出留在分母里做上界分析。 91
结论建议:读 4.2(指标与视图加权口径)、5.2–5.3 与 Limitations 三处,重点看「外部视图不等权、共享题目不算独立测试」的处理。引用 75.44% 时必须同时给出 17 个视图、单次运行、无显著性检验、候选集固定这四个限定;不要把它当作「该模型农业能力」的证据。 91
12. 多模态机器遗忘基准 GEMMU:139 个真实概念,共享超参下 KL Min 与 RMU 胜负翻转
Are We Really Measuring Forgetting? Pitfalls in Evaluating Machine Unlearning for Multimodal LLMs · arXiv:2610.19613 · 邻近跟踪
研究问题与核心方法:论文指出多模态大模型(MLLM)机器遗忘的既有评测有三处陷阱:在遗忘集与保留集的同一批数据上评测(无法区分概念级遗忘与实例级过拟合)、只用微调注入的合成知识而非预训练获得的真实知识、对不同方法套用同一套超参。为此构建 GEMMU(Generalizable Evaluation for Multimodal Machine Unlearning)基准:概念取自人、地标、汽车品牌、水果四类共 139 个真实概念,每个概念按 5:10 划分训练/测试;对 9 种代表性遗忘方法各自做超参搜索;并分别构造图文(VQA)与纯文本(QA)问题做模态差分析。 92
关键结果:
- 在 GEMMU 上重评 9 种方法后,最强的是最老的两种简单方法 GADiff 与 SCRUB,与它们在旧基准上被新方法(如 MANU 在 MLLMU-Bench 上优于 GADiff)超越的结论相反(表 2)。 92
- 超参敏感性:同一共享配置下,学习率 10⁻⁵ 时 RMU 明显胜 KL Min,5×10⁻⁵ 时结论反转,KL Min 反超(图 5)——同一个「一刀切」协议能支持两种相反结论。 92
- 模态差区分了「删关联」与「删概念」:RMU 在 Qwen3-VL-8B 上把 VQA 分类压到 2.48 而 QA 仍为 83.91(FITB 填空 1.66 对 76.88),即只切断了视觉—知识关联;GADiff 删整个概念但保留侧损失最大(表 3)。 92
- 作者指出未经逐方法调参的许多配置落在 y=x 对角线上(图 6),即保留知识被破坏的程度与目标遗忘相当,「没有方法真正解决该任务」。 92
证据与局限:结果按四个真实子集平均,两个基座模型(LLaVA-1.5-7B、Qwen3-VL-8B-Instruct);微调与遗忘都用 LoRA,未做全参数微调;表格为点值,未报告种子数或置信区间。超参搜索只用训练切分选择,测试数据不参与。引用时注意「排名翻转」是配置依赖的观测,不是对某方法优劣的定论。 92
与目标研究线的连接点:可搬走的是一份基准审计清单,适用于任何「删改模型行为」的评测:测试集必须与训练集分离、评测对象要含真实而非合成知识、方法间必须各自调参,否则排名可能只是配置的产物;外加「用两条模态或两套口径的落差来区分机制」的做法。 92
结论建议:读第 4 节三处陷阱、表 1 的基准对照与图 5–6。可搬「分离测试 / 真实知识 / 逐方法调参 + 模态差」四条设计准则。引用时限定:两个 7–8B 基座、LoRA 设定、点值无方差,「排名翻转」属配置依赖观测。 92
13. ReSemReason:BioHopR H@1 从 0.719 提到 0.772,Joint@1 0.602
Beyond Reachability: A Relation-Semantic Reasoning Framework for Biomedical Multi-hop QA · arXiv:2610.19754 · 邻近跟踪
研究问题与核心方法:生物医学知识图谱多跳问答里存在「可达但无效」(reachable-but-invalid)问题:正确答案能被检索到,但支撑它的路径在关系语义上不成立(关系被换、方向反了、桥接实体混淆),于是答案在看似相关的候选池里排不上去。ReSemReason 让候选发现与证据选择共享同一个由问题诱导的、关于类型化有向关系模式的分布:模式兼容度指导图搜索;ReSemAttn 用关系条件化的 key/value 投影与一个不确定性加权的路径先验,去注意候选专属的证据;再加一个独立的 absolute-support 分数,补上「所有检索到的路径都很弱」时被归一化吃掉的信息。配置上使用 N=8、M=4、B=32、最多三跳、K=8,骨干是 Llama-3.1-8B-Instruct。93
关键结果:
- 三个数据集上 soft-schema 版在所有列都最强:BioHopR H@1(Top-1 命中率)0.772(Fixed-Candidate ReSemAttn 0.719)、R@10(答案集召回)0.648(0.556);PrimeKGQA answer F1 0.761(hard schema 0.661);MedReason 多选准确率 0.691、开放回答 F1 0.749(Table 1)。
- 五个种子在 BioHopR 上:Full H@1 0.772±0.006、Hard-Schema 0.748±0.007、Fixed-Candidate 0.719±0.008;对应的 Joint@1 为 0.602±0.007、0.548±0.009、0.495±0.010(§4.2)。
- 消融:去掉 relation-guided search 掉 5.3 个百分点 H@1,去掉 attention prior 掉 6.6 个百分点,是核心消融里最大的一项(Table 2)。
- 证据有效性口径:Joint@1 = H@1 × (1 − WPR),WPR 是「答对但支撑路径无效」的比例;完整模型 Coverage 0.948、H@1 0.772、ValidPath@1 0.634、Joint@1 0.602(§4.5)。
- 判别力对照:在「同一候选、一真一假」路径对上要求真路径得分严格更高,完整模型 PairAcc 0.806,BFS + Cross-Encoder 只有 0.493(§4.5)。
- 路径有效性由两名标注者标 Valid/Invalid/Insufficient、第三人仲裁,总一致率 0.884(κ=0.761),在「答案正确」的路径子集上 0.901(κ=0.792)(§4.5)。
- 效率:BioHopR 上 276 ms/query、760 个扩展节点、峰值 19.8 GB;对比 GraphRAG 242 ms、1280 节点、H@1 0.548,Think-on-Graph 514 ms、1730 节点、H@1 0.655(Table 4)。93
证据与局限:五种子给了均值±标准差,但作者自己写明「聚合均值本身不能确立配对显著性」。三个数据集来自既有发布(BioHopR 10,127 题、PrimeKGQA 83,999 问答对、MedReason 32,682 题),路径效度指标依赖人工标注队列,成本不低。作者自陈局限:缺失或歧义的关系、grounding 不全、模式被剪掉、beam 剪枝都会让有效证据到不了 reasoner;均值池化的关系特征不保留关系顺序;检索路径与注意力权重是「可检视的模型证据」,不是因果解释或临床验证。鲁棒性上,模板不重叠时 H@1/Joint@1 降到 0.741/0.563,改写加别名扰动降到 0.731/0.548。93
与目标研究线的连接点:对 A 线最值钱的是它的评测口径而不是生物医学结论:把「答对没有」与「证据是否支撑答案」拆成 H@1、ValidPath@1、Joint@1、WPR 四个量,正是长程 agent 里「检索到了 ≠ 用对了」的同一个问题;PairAcc 那种「同一候选、一真一假路径」的配对构造,也可以直接搬到工具调用或检索增强的轨迹评估上。可搬走的方法件是「候选发现与证据选择共享同一个关系模式分布」,以及用 absolute-support 项兜住归一化在弱证据下的失真。93
结论建议:读 §4.1 指标定义(Joint@1 与 WPR 的关系)、§4.3–4.5 与 Table 1、Table 3、Table 4,§4.5 的配对控制最值得抄。引用时必须限定生物医学 KG、soft-schema 版与五种子 H@1;提到 WPR/Joint@1 要一并说明人工标注队列与一致率;不要把它写成通用多跳问答结论——模板扰动下指标下降明显。93
14. 似然分数可被 8 个随机 ID 操纵:同一段文本跨上下文摆动 32–51 分
Likelihood Is Not Authorship: Can We Reliably Measure Human Contribution in AI-Assisted Writing? · arXiv:2610.19767 · 邻近跟踪
研究问题与核心方法:要回答「这段文字有多少是人的贡献」,主流做法是用人的提示对最终文本的预测能力打分(归一化上下文可预测性 φ = 1 − I(y|x)/I(y),即提示解释了多少 token 的惊奇量)。作者提出 Specificity Padding:只在提示里追加几个随机 ID 并要求模型原样复制;再用上下文互换审计把同一段输出分别放在 Matched(含匹配 ID)、Hidden(不含 ID)、Wrong(同形式不同值 ID)三种评测上下文下打分,文本一字未改,差异只能来自上下文。 94
关键结果:
- 固定输出上的摆动达分数尺度的三分之一到一半:Matched − Hidden 在新闻集 2,100 个模型-文档对上为 32–51 分,在 600 个摘要对上 43–47 分;Matched − Wrong 为 16–29 分与 25–28 分,即精确复制值本身额外贡献 16–29 分(表 1)。 94
- 生成时攻击同样有效:追加 8 个 ID 生成的文章比独立生成的干净文章高 13–27 分(2,040/2,100 对为正);把 ID 从评测上下文里拿掉,同样的文章掉 51–84 分,DeepSeek-V4-Flash 上同一批文章在「完整提示」下均值 0.85、在「用户可见请求」下 0.15(第 4.3–4.4 节)。 94
- 在验证该分数用的协助阶梯上,8 个 ID 值 20 分,超过从标题到摘要的整步(17 分);300 项运行里 0.75 对 0.55(第 4.1 节)。 94
- 无提示的输出侧估计也失守:追加 8 个 ID 把 Llama-3.1-8B 的最小人类贡献估计从 0.36 抬到 0.68,300 篇文章全部上升(第 4.4 节)。 94
- 机制是「信用跟着惊奇量走」:分数等于各片段局部分数的惊奇量加权平均,稀有字符串一旦在上下文里变得可预测就拿到不成比例的信用;因此 padding 把分数拉向它自己的局部分数,最弱的贡献被抬得最多,而接近 0.84 的干净分数抬不动(第 5 节)。 94
证据与局限:效应量是配对均值加 95% 百分位自助区间(10,000 次重采样),区间半宽不超过 3.1 分且全部排除 0。局限由作者自陈:只做英文新闻(300 项、7 个模型,3.8B 到 753B 参数)与 arXiv 摘要(200 项、3 个模型),每个条目只有一次干净生成与一次攻击生成;每个模型给自己的工作打分,未测代理判官,绝对分不可跨家族比较;固定后缀很显眼,不主张攻击不可检测;协助阶梯与 headroom 分析只用固定的 30 项 Llama-3.1-8B 子集。入口实测:arXiv 全文页 https://arxiv.org/html/2610.19767v1/ 返回 HTTP 200;正文只给出数据集来源,未给出独立的代码或项目页。 94
与目标研究线的连接点:能搬走的是审计动作,不是攻击本身——任何依赖上下文条件的指标(点式 V-information、摘要类指标,以及我们自己用的判官分数)在部署前都应做一次「固定输出加换上下文」的互换测试并报告敏感性。结论里的那条边界也很有用:如果被记录的提示本身可能是机器写的,只看转录的估计在最坏情况下至少错掉一半的贡献,这正好说明「打分更高」不等于「更接近真相」。 94
结论建议:读第 3 节(Specificity Padding 与互换审计的可复用定义)、第 5 节(信用账本)与第 6 节(识别边界)。可迁移的是审计程序与「先声明关系(文本、上下文、判官)」的报告要求;引用 32–51 分这类数字时必须限定模型家族、文档集与自评自打的设定。 94
15. 身份盲化诊断:只换源标签就让 91.2% 的二分类预测翻向假标签
Beyond Benchmark Accuracy: A Diagnostic Test for LLM Chemical Prediction · arXiv:2610.19906 · 邻近跟踪
研究问题与核心方法:化学预测基准通常直接把目标实体的名称或结构字符串给模型,因此高分无法区分「可迁移的结构–性质推理」与「靠目标身份线索或记忆检索」。作者提出身份盲化推理诊断(Identity-Blinded Reasoning Diagnostic):目标不再由自身身份定义,而由「已知源实体 + 显式的结构编辑操作」共同定义,并设置四个条件——C0 直接给目标结构、C1 只给源结构与编辑说明、C2 再追加真实源标签、C3 把真实源标签替换成假标签且目标与金标不变。 95
关键结果:
- 诊断规模:六个任务跨四个领域(气味、分子性质、逆合成、反应收率),样本量为结构变化气味 179、手性变化气味 56、BACE 136、HIV 242、逆合成 42、反应收率 100(C3 配对分析后为 98);四个受测模型是 Claude-Opus-4.8、DeepSeek-V4-Pro-Preview、GPT-5.5 与 Gemini-3.1-Pro。
- 常规口径下模型本身并不强:C0 条件里逆合成的精确匹配率为 34.9%–48.8%,收率的 MAE(平均绝对误差)为 32.34–56.46 个百分点,都差于均值基线 21.98 与中位数基线 21.65。
- 源标签带来的偏差随条件加强:C1 下 24 个「模型 × 任务」组合中有 10 个出现标签一致组占优,C2 下增加到 22 个;经 Benjamini–Hochberg 假发现率校正后,48 个组间比较里 34 个在 q<0.05 上显著(C1 为 12/24 个组合,C2 为 22/24)。
- 只替换源标签即造成系统性翻转:二分类任务上 Claude-Opus-4.8 有 91.2%(BACE)与 94.6%(HIV)的预测翻向假标签,GPT-5.5 为 58.8% 与 71.5%,DeepSeek-V4-Pro-Preview 只有 36.0% 与 19.8%;集合输出任务的方向响应在结构变化上为 0.059–0.135、在手性变化上为 0.307–0.869;收率任务有 61.2%–98.0% 的预测朝假源收率方向移动。
- 外部证据并非总是帮忙:加入结构化工具证据后,结构变化气味任务上 DeepSeek 的 F1 从 0.160 升到 0.312、Qwen3.5-9B 从 0.035 升到 0.248,但 Gemini-3.1-Pro 在混合物气味任务上从 0.190 降到 0.149。 95
证据与局限:作者对每个样本独立调用模型,并做了结构重建对照(准确率 86.05%–100%,四个模型在手性目标上全部正确),统计上用 Fisher 精确检验与 Mann–Whitney U 检验并报效应量,用 10,000 次组内自助重采样估坍缩比 CR 的 95% CI。引用风险在于:全部题目由作者按指纹相似度与片段编辑规则构造,样本很小(逆合成 42、手性 56);CR 在多处因不一致组得分为 0 而变成无穷,作者自己提示不能单靠 CR 解读效应量;「高基准分不等于可靠推理」是观察性结论,不宜写成因果。原文未给出本方法的代码入口,只给了所用数据源仓库。 95
与目标研究线的连接点:它与同节的基准审计思路同源,但手法相反——不改指标也不改题目,而是改「目标实体的呈现方式」,用同一实体只换线索做反事实干预。可搬走的是三件工具:条件阶梯 C0→C1→C2→C3;按真实源标签与目标标签的关系把样本分成标签一致组与不一致组,并用坍缩比 CR(一致组分数除以不一致组分数,CR 大于 1 一律表示一致组更好)报告组间差;以及「只替换源标签、目标与金标固定」的配对翻转率指标。 95
结论建议:读第 3.2 节的四条件定义、第 4.3 与 4.4 节(图 3、图 4)以及附录 F 的显著性表。可以把它当作自查清单:凡输入里含可识别的目标身份(名称、编号、原始表示),都可以照做一次身份盲化与源标签替换,看模型是否只是跟着上下文线索走。引用时须限定结论只覆盖 4 个模型、6 个任务,且样本量在 42 到 242 之间。 95
16. 机器翻译保不保留媒体偏见:四种引擎译后仍保留 64%–78%,四译文间无显著差异
Does Machine Translation Retain Media Bias? · arXiv:2610.19945 · 邻近跟踪
研究问题与核心方法:论文问机器翻译(MT)是否会保留源文中的「媒体偏见」(对中性报道的偏离,例如用词与框架)。以英语、德语为源语言、保加利亚语为目标语言,把 446 句(233 英、213 德;其中人工验证 243 句有偏、203 句无偏)分别送入四种 MT:DeepL、Google 翻译、GPT-5.5、BgGPT(bggpt-gemma-3-27b-fp8)。再用 BiasScanner 神经网络分类器在译文上判定偏见类别(27 类),与人工金标签比对。 96
关键结果:
- 四种方法译成保加利亚语后,64%–78% 的媒体偏见仍被保留,即约四分之一到三分之一丢失;德语源略高于英语源(图 2)。 96
- 保留率更取决于偏见类型而非引擎:结构性偏见(omission 省略、false balance 虚假平衡、whataboutism 那又如何主义、flawed comparisons 错误比较)几乎 100% 存活,语气型偏低(Circular Reasoning 循环论证 50%、Discriminatory Bias 歧视性偏见 55%),最高频的 Word Choice 用词与 Emotional Sensationalism 情绪煽情约 75%(图 3)。 96
- 翻译还可能「新增」偏见:表中给出把无偏句译成被判为 Discriminatory Bias 的例子(表 2)。 96
- 统计:全局配对置换检验(paired global permutation test,其 p 值记作 p_MC)显示五种条件(原文加四种译文)的偏见类型组合显著不同(Cochran's Q 统计量 T_sumQ=168.20,p_MC<.001);原文与每种译文均有显著差异(Holm 多重比较校正后),而四种译文两两之间无一显著(校正后 p_Holm 全为 1.00)。 96
证据与局限:小规模探索研究;两个语言对、四种引擎、单一偏见分类器、单一保加利亚语母语评审人;未报告源文标注者间一致率。译文质量用参考无关的 xCOMET 度量(均值 μ=0.9139,DeepL 0.9291 最高、Google 0.9019 最低),作者以此论证质量足以支撑结论;分类器在保加利亚语上的精度只在他处报告(AUC 0.867,对英语 0.865)。作者明确表示不能作「MT 不保留偏见」的强断言,只能说结果与之相符。 96
与目标研究线的连接点:可搬的是比较口径与风险意识:当用同一批配对样本比较多个系统时,把同一句当作配对单元并用 Cochran's Q(多条件配对比例检验)加精确 McNemar,再作 Holm 多重比较校正,比逐条独立比较更稳;同时要意识到「度量用的分类器本身也是模型」,它的误差会直接进入结论——这正是评测口径与判官效度的具体教训。 96
结论建议:读第 5.1–5.2 节与图 2–3。可搬配对多系统比较的统计口径与「度量器自身误差」的限定写法。引用时必须限定:只有两个语言对、四种引擎、单一分类器与单一母语评审人,作者自陈不能作强因果断言。 96
17. 法律开放题评分 SoK:实例化评分规则是最强杠杆,但嵌入指令攻击在其上平均成功 56.9%
SoK: Grading Open-Text Legal Answers, from Law School Exams to Trustworthy Rubric Judges · arXiv:2610.19992 · 邻近跟踪
研究问题与核心方法:法学院用开放文本答题(案例分析、论文、备忘录),人工评分贵且分歧大,LLM 判官(LLM-as-a-judge)被用来在教学与法律 AI 基准上大规模评分。本文是一篇 SoK(Systematization of Knowledge,知识系统化):先由教育测量学与考试法推出 8 条要求(D1 结构效度、D2 可靠性、D3 给出理由、D4 认可可辩护的替代解法、D5 抗操纵、D6 成本与规模、D7 形成性价值、D8 与人工监督相配),再把 8 种评分范式(P1 无结构人工评分一直到 P8 成对比较)对着这些要求逐条评级,并系统整理法律领域的自动评分研究。作者来自慕尼黑工业大学(TUM)。97
关键结果:
- 实例化评分规则(P7:为每道题写专家评分规则、判官逐条核对)是法律领域内最强的一致性杠杆:德国考试上 GPT-5 带样本答案+评分表时 QWK(quadratic weighted kappa,二次加权 kappa)为刑法 0.60、公法 0.91,两者都不给时只有 0.31 与 0.58。97
- 但反例同样明确:JudgmentBench 上,执业律师的成对判断对 30 个任务三个质量等级的排序平均 Spearman ρ=0.91,而他们的评分规则打分只有 0.15(评分者之间一致性 0.44);GPT-5.4 自动评分器成对为 0.38、用规则为 0.20。97
- 判官与人类的一致性必须对着人类之间的一致性读:LEXam 上判官通过了 alternative annotator test,而三位专家彼此的一致性 QWK 只有 0.49;BenGER 上判官与三名盲评者均值的 r=0.76、通过/不通过 κ=0.60,落在人类分歧范围内。97
- 失败模式有硬数字:某波兰考试中判官拿到委员会标准与答案要点后,给三个被委员会以严重错误判为不及格的判决书打了 85 到 90 分(满分 100),委员会给 8 到 37 分;嵌入答案的指令型攻击对基于评分规则的判官平均成功率 56.9%;标签粒度变细会降低一致性(同一批短答案从二分改五档,准确率 76% 降到 57%);模型更新会把判官严厉度移动最多 1,000 分制里的 133 分;被强制对齐单一标签选出来的判官最多差 31%。97
- 作者据此提出「可信评分规则判官」的 7 条保障:S1 逐题的原子化评分规则、S2 每次给分都要引用原文且用代码核对引用、S3 上线前的探针集、S4 重复运行与方差分解、S5 对照独立人类评分做校准、S6 升级给主考人、S7 记录与数据保护;并指出成本可能吃掉收益——某微积分考试中约 70% 的题目必须交回人类才能达到人类准确率。97
证据与局限:这是 SoK 而非新实验,证据是跨来源的(法律领域内的直接证据、其它领域的迁移证据、规范性法条),表 2 的评级是单一作者对参差证据的读数。作者自陈:检索结构化但不穷尽,多项关键研究是 2026 年预印本,表 3 中若干条目共用数据或工具(标为 reused),BenGER 是作者自己的,因此论文数高估了独立验证数;法律以德国考试法为样本;有五篇自引、其中一篇在准备中。引用风险:表 3 的一致性数字口径混用(QWK、κ、ρ、SPA、MAE、Kendall's WW),不能横向排序,只能按各自口径引用。97
与目标研究线的连接点:落在评测口径与判官效度这条线上,与本单元 2610.19268 互补——那篇审计基准内容与评分器口径,这篇给出一整套判官验证程序(探针集、方差分解、对照人类一致性、升级规则),可整体搬到任何 LLM 判官上线前的检查清单。可搬走的一件是 S3 探针集的构成:空答案、离题答案、抄题干必须近零分,参考解答必须高分,嵌入指令不得加分,等义改写不得改变分数,删掉决定性理由必须扣分。97
结论建议:读第 4.2 节(8 条要求)与第 8 节(7 条保障)当清单,读第 5 节 P7/P8 两段与第 6 节表 3 取数字。引用时必须限定:这些一致性数字来自法律教育场景、口径各异且部分基于复用数据,不能当作通用判官效度上限;「可信评分规则判官」是待验证设计,作者自己说没有任何判官已通过全部验证。97
18. CSWBench:12 个 LLM 的代码切换评测,事件级与全文质量相关仅 r=.254
CSWBench: Evaluating Context-Sensitive Code-Switching in Creative Writing · arXiv:2610.20272 · 邻近跟踪
研究问题与核心方法:代码切换(code-switching,同一文本中交替使用两种语言)不只是双语能力,模型还要判断何时、何地、为何切换;这种上下文感知能力缺少评测。CSWBench 用两个互补设定——Focused Narrative(约 700 非空白字符)与 Extended Narrative(约 4,000 非空白字符)——构造中英创意写作基准,并提出 CSWEval:事件级评价许可性(Licensing,D1)、语境适切性(Contextual Appropriateness,D2)与功能增益(Functional Gain,D3,即该处切换是否带来语境支持的实际效果),全文级评价任务相关质量(Focused 看整体文学与叙事质量,Extended 看重多语组织)。作者 Zewen Jiang、Yahan Li、Chenlu Guo、Diana Inkpen、Yuan Wu、Yi Chang,单位为吉林大学人工智能学院与软件学院、中国电信人工智能技术(北京)有限公司星辰 AGI 实验室、哔哩哔哩、渥太华大学等。98
关键结果:
- 12 个 LLM 的排序:GPT-5.5 领跑 Focused Narrative(总分 Σ=15.537),GPT-5.6-Sol 领跑 Extended Narrative(Σ=17.767),排除同族评分与改用其它聚合方式后名次不变。
- 评测框架先被校验:3 名人类评分者对 180 条 Focused 与 144 条 Extended 输出的一致性 Kendall's W=.718 与 .810;人类均值与双判官文章分的 ICC(A,1)=.864、Spearman ρ=.863(Focused)与 .816、.804(Extended);两名双语标注者对事件发现的审计 F1 为 .963/.960(候选分类)与 .944/.998(事件分组)。
- 构造敏感性(swap 扰动):在 36 条 Extended 文本里把代码切换事件对按 2、4、6、8 逐档互换,全文分从 3.702 降到 2.901;同日程互换中文片段(对照)降到 3.137,说明多语组织维度对切换位置更敏感,而中文片段互换更伤一般叙事执行。
- 局部与整体的关系:事件级语境适切性、功能增益同全文分的相关只有 r=.254 与 r=.255;而叙事显著性(salience,切换对情节后果的重要程度)与两者相关更强——Focused 为 r=.642 与 .496(4,884 篇),Extended 为 r=.768 与 .789(4,800 篇)。
- 模型差异最大的一维是多语文学融合(Multilingual Literary Integration,跨模型均值标准差 SD=0.742);多语相关维度在难题(按六个代表模型的 D2/D3 均值划出的难易四分位)上掉分比一般叙事维度多。98
证据与局限:三重校验(人类评分者一致性、人评—判官相关、标注审计)与互换扰动实验是这篇的证据强项。作者自陈局限:只覆盖中文主导、英文插入的文本,不含英文主导或其它语言对;目标长度约 700 与 4,000 字符,长篇不在范围内;GPT-5.6-Sol 同时参与提示构造、事件标注与判分且是被评模型之一(Focused 上同族判官对自己输出比人评高约 0.5 分 / 20,换事件标注者会让 Extended 分数整体移动 +0.745 分 / 20);约 82%(661/807)的最终提示来自合成来源 SwitchLingua。引用风险:r=.254、r=.642 这类数值是观察性关联,不能读成因果。入口实测:全文页与项目仓库 https://github.com/TPSJASPER/CSWBench 均实测 HTTP 200(论文自报产物 38 页、19 图、32 表)。98
与目标研究线的连接点:归入第十节「邻近跟踪:评测口径、判官效度与推理控制」。可迁移的一件东西是评测结构本身:「事件级 + 全文级双层、并如实报告两层相关只有中等」正是长程任务里「每步正确 ≠ 整任务完成」的评测版本,可借到 agent 评测上(逐动作质量与整任务结果分别打分,并报两者的相关)。它与第三节那篇任务合成论文互补:一个从任务合成端治理「局部正确、整体不完整」,一个从评测端证明两层不是同一件事;互换扰动(swap)检验也是可搬走的构造敏感性做法。98
结论建议:读 §3.4(CSWEval 两层指标)与 §5.1、§5.4;做多语生成或需要双层评测时可借其维度定义与扰动设计。引用时必须限定为中英、约 700/4,000 字符的创意写作范围,并注明判分链含被评模型同族与提示主要来自合成来源。98
19. LLM 实体抽取失败分解:65.6% 是背景提及、19.9% 是口径缺口,幻觉只有 1.2%
From Unreliable to Usable: Decomposing Failure Modes and Confidence Signals in LLM Entity Extraction - Evidence from Cyber Threat Intelligence · arXiv:2610.20417 · 邻近跟踪
研究问题与核心方法:已有审计给出「不可靠」的结论,但没说清失败由什么构成、置信信号能否让输出可用。本文在网络威胁情报(CTI)长报告上做一次预注册、全冻结的评测(354 个事件活动、315 份唯一报告,共 630 次模型-报告评测):两个新一代低成本模型(DeepSeek-V4-Flash、GLM-5.3-Flash)加一个旗舰对照(GPT-6.1-Sol),抽取威胁组织、漏洞编号(CVE)与攻击技术(MITRE ATT&CK)三类实体;用别名等价类的多重集匹配打分、用双重置信代理(自报置信与 5 次重采样自一致性 SC 频率)测校准,并对 360 个分层抽样候选做三级标注(字符串是否出现、是否属于本事件、绑定与归属是否正确)。 99
关键结果:
- 不可靠性跨档位存在:微观精度 0.03–0.34、召回 0.81–0.99,自报置信的期望校准误差 ECE 0.53–0.94;旗舰对照同样如此(CVE 微观精度 0.057、召回 0.899,ECE 0.63–0.94),升档没有关闭这条差距(表 1)。 99
- 失败以背景污染为主:全量提及普查显示 CVE 假阳性中 99.7%–99.8% 在报告里有明确文本来源;三级标注按抽样权重回投后,假阳性构成里背景提及占 65.6%、事件相关但不在金标口径内的缺口占 19.9%,真正无文本支撑的只占 1.2%(表 2)。 99
- 置信信号可以排序但不能验证:SC 频率在 6 个测试格全部通过预注册门槛(top-30% 精度增益不低于 +0.10),控制文本频率后其与正确性的偏相关在 6/6 组显著(r = 0.30–0.43);而 DeepSeek-V4-Flash 的自报置信被文本频率完全吸收(偏 r = 0.000,p = 0.997)。 99
- 关系级反事实击穿:45 个目标上各注入一句风格匹配的句子,一句错误归属就让两个模型在高置信下把事件绑到注入的组织(73.3% 与 95.6%),一句被明确标注为「与本事件无关」的背景句仍让伪造漏洞被绑定达 26.7%,一句撤回句则把真实漏洞从 34.1% 与 76.2% 的输出里抹掉(表 4)。 99
- 修复只在匹配失败模式时有效:检索增强与思维链修复对威胁组织最多 +0.133 宏观 F1,对 CVE 从不有效(Δ ≤ ±0.011);在同一口径下把阈值按语料重新做分位校准是必须步骤(第 4.6 节)。 99
证据与局限:协议与门槛预注册(含 κ ≥ 0.7 的标注一致线与 top-30% 增益 +0.10 的排序门槛),三级标注由两个不在被评模型之列的 LLM 标注者加一个仲裁模型完成,κ_L2 = 0.68(剔除边界项 0.79)、κ_L3 = 0.74。局限交代得比较完整:全部绝对数字来自单一领域与单一金标口径(每活动的 primary 实体),跨领域未复制;服务网关剥离 logprob,校准代理只能用不依赖 logits 的信号;三级标注是 LLM 双标而非人工;旗舰模型未跑反事实与验证信号批次;主语料约止于 2021 年;未复现任何第三方流水线。入口实测:arXiv 全文页 https://arxiv.org/html/2610.20417v1/ 返回 HTTP 200;代码与冻结输出为审阅用匿名仓库(公开时间待定),语料为公开数据集(Zenodo 7357568 等)。 99
与目标研究线的连接点:可搬走的是三件评测口径工具:一是把一致性、排序能力、概率校准明确拆成三个量分别报告,避免用「分数更高」代替「更接近真相」;二是预注册验收门槛(达不到就写成负面结果)加固定输出上的反事实扰动审计;三是把「LLM 双标注加仲裁、保守裁决」的一致率与局限写进方法而不是附注。 99
结论建议:做抽取或检索增强的人读第 3.3 节(三级标注口径)、第 4.2 节与表 2(失败构成)、第 4.5 节与表 4(反事实)。可直接搬用的是「排序用于排队、绝不用于判定真伪」的部署边界与按实体类型分预算的审查策略;引用 65.6%、19.9%、1.2% 时必须限定为 CTI 长报告、每活动 primary 实体金标与 LLM 辅助标注。 99
20. 跨时间文化意识:10,360 个题对、72 国,68.2% 已变化的题对连众数都没变
ChronoCulture: Evaluating Cultural Awareness Across Time in Large Language Models · arXiv:2610.20472 · 邻近跟踪
研究问题与核心方法:现有文化基准多把文化当成国家或地区的静态属性。ChronoCulture 用 WVS(World Values Survey,世界价值观调查)与 ISSP(International Social Survey Programme,国际社会调查项目)两份长期调查,在 72 个国家构建 10,360 个「时间对」:同一国家、同一道调查题在较早年份与较晚年份各出现一次,标准答案是按人口权重加权后的整条选项分布,而不是单个均值或众数;模型要直接输出各选项的百分比分布。文化变化的幅度用归一化 Wasserstein 距离 d_h(human shift,人类位移)度量,据此把题对分为稳定、中度、强、极强四档。 100
关键结果:
- 数据构成:10,360 个题对(对应 20,720 条带年份提示),来自 WVS 第 3–7 波(1995–2022)与 ISSP(1985–2022),筛出 408 个跨波可比、选项有序且每国每波至少 500 名应答者的变量;四档题对数为稳定 2,607、中度 5,535、强 1,828、极强 390(Table 1、§3.1–3.5)。 100
- 用众数打分会让大部分数据失真:分布已变化的题对里 68.2% 两个时期的众数相同(被读成「没变」),而 8.5% 的稳定题对分布几乎没动却换了众数(被读成「变了」)(§3.6)。 100
- 变化越大,两个时期都答准的题对越少,只有一边答准的比例在强与极强档超过 50%(容差 τ=0.10);而且两个年份的预测通常更靠近同一年份的标准分布:同向对齐占已变化题对的 80–87%,各自对应自己年份的只占 9–15%(§4.2)。 100
- 方向比幅度学得好:随着人类位移增大,模型的幅度比 r=d_m/d_h(模型位移与人类位移之比,1 表示两者相等)中位数始终低于 1 并继续下降,即系统性低估变化;同一批题对的方向余弦相似度却上升,说明方向对不保证幅度对;即使最少给出相同预测的 GPT-5.4 仍低估变化幅度(§4.3、Figure 7)。 100
- 提示里点名年份收益很小:跨模型只有 20–44% 的条目因点名年份变准,同时有相近比例变差,平均收益接近零或略负;不带年份的预测只在 46–48% 的情况下最接近最新年份;不过在极强变化档上,点名较早年份在全部六个模型上都带来正收益,点名较晚年份收益微弱(§4.4)。 100
- 主题与地区差异随变化幅度放大:稳定题对上民主话题准确率可达 71%,大幅变化时降到 17%;民主与社会不平等两话题预测变化方向只有约 50%,而家庭与生活优先级为 82–94%;强与极强档下,WVS 里西方国家双期准确率 35%,中东与北非、南亚与东南亚平均 16%(§4.5)。 100
证据与局限:评测六个模型(Llama-3.3-70B、GPT-4o、GPT-5.4、Qwen3.5-35B-A3B、Qwen3.8-Flash-Next、DeepSeek-V3),并先对每个模型单独做知识过滤:用不带年份的预测与各年份标准分布的最小距离 K 排序,只保留最小的 75%(约 7,700 个题对),以区分「本来不知道」与「不会跟踪变化」。原文未报告显著性检验或置信区间。作者自陈局限:覆盖受限于 WVS/ISSP 的国家、话题与年份,WVS 第 8 波未发布因此不含 2022 年之后;只取选项有序的题;以国家级分布代表人群,会掩盖同一国家内人群差异。 100
与目标研究线的连接点:与同节的 Target-Token Asymmetry 同属「打分方式决定你能看见什么」:那篇讲合并指标被目标构成带偏,这篇讲众数打分对 68.2% 已变化的题对天生不可见,因而必须换用分布级距离加「模型位移对人群位移」双量口径。可搬走的一件东西是「先知识过滤、再测目标能力」的两段式评测:把探不到底的知识题对剔除后,测出的才是时间条件化能力而不是知识量差异,这个套路可直接搬到 A 线的记忆与上下文评测里。它的核心失败模式也值得单测:把年份(或任何时间戳、版本号)明确写进上下文,模型输出却没有跟着变。 100
结论建议:先看 §3.5–3.6(四档划分与众数失效)与 §4.1(知识过滤),再看 §4.3–4.4 的幅度、方向与年份点名结果。引用时必须同时给出容差 τ=0.10、人类位移 d_h 的定义与过滤后保留比例,否则「模型抓不住文化变化」会被误读成知识不足;也要注意这是题对级分布对齐结论,不是因果结论。 100
21. 真实说服对话基准:行为任务模型 76% 略超最佳人类 75%,认知三轴人类仍领先
PerSo: Investigating Facets of LLMs' Social Intelligence in Real-World Persuasion Scenarios · arXiv:2610.20548 · 邻近跟踪
研究问题与核心方法:社会智能含两面——认知智能(推断他人心理状态)与行为智能(据此选择合适的社会行动),而以往基准多在合成场景里把两者分开评。PerSo 用 Reddit 的 ChangeMyView(CMV)真实说服对话构造:同一帖子里挑出成功说服者与失败者两条分支,行为任务让模型比较两条回复哪条更有效(用 1 到 4 分给每条打分并要求分数不同,以降低位置偏差),认知任务则是预测帖主收到该回复后的信念、情绪、意图三个维度,每个维度出一道四选一题。题目由 Gemini 2.5 Pro 以「LLM 在环」流程生成,再由三名标注者人工校验。 101
关键结果:
- 数据规模:从 872 个合格帖子中随机抽取 200 个(2024 年 1 月至 2025 年 10 月),成功与失败标签各 100;认知任务每分支三个维度各一题,共 1,200 道四选一题。
- 行为任务:最强的 Qwen-3.5-397B(不开思维链)为 76%,最高的人类参与者为 75%,差距 1 个百分点;最好的闭源模型 Sonnet-4.6 为 71.5%,Gemini-2.5-Pro 为 71.0%。
- 认知任务:Claude Sonnet-4.6 三轴都最好(信念 83.0%、情绪 59.0%、意图 80.5%),但最佳人类分别是 85.0%、65.0%、85.0%,即模型在三轴上仍分别低 2、6、4.5 个百分点;四选一的随机水平是 25%,而 Gemma-4B 与 Gemma-12B 在情绪维度只有 20.5% 与 23.25%。
- 思维链不是一致增益:Qwen-3.5-397B 开启思维后情绪从 41.0% 升到 48.75%,但信念反而从 80.5% 降到 79.0%。 101
证据与局限:人类参照只有三名计算机专业参与者,行为任务抽 20 题(全量的 10%)、认知任务抽 40 题(10%),认知题质量经人工复核并报了三标注者的两两一致率与 Cohen κ;模型侧温度设为 0、top-k 设为 1,但原文未报告重复运行的方差或显著性检验,因此「模型接近或超过人类」这类比较不能当作稳定结论。另一个风险是认知题由 Gemini 2.5 Pro 生成,作者用「Gemini-2.5-Pro 未在任何一维拿到最好成绩」来反驳系统性自偏好,这只能算弱证据。 101
与目标研究线的连接点:它的可搬处是评测设计而非结论。一是把同一批真实对话同时切成认知题与行为题,让两个维度共享数据、便于交叉检查;二是给出「最佳人类对最佳模型」的对照口径,而不是只跟随机水平比;三是让生成题目所用的模型自己也进评测,用来暴露 LLM 在环造题的自偏好风险。做判官效度或 LLM 造题流程时,这三条都能直接照搬。 101
结论建议:读第 3.1 与 3.2 节的任务定义、表 5 以及第 4.2 与 4.3 节的结果讨论。可作为「LLM 造题 + 人工校验 + 人类对照」的模板。注意行为任务本质是二选一(随机水平 50%),与认知任务的四选一(随机 25%)不可直接比较。原文未给出代码或数据入口,复现需自行重建 CMV 的抓取与过滤流程。 101
十一、邻近跟踪:推理期控制、解码与机制
1. 选择性推理:768 题准确率 70.96%→84.38%,对 1,024 token 末端推理省 46.30% 流水线时间
Selective Reasoning for Typed Decision Models: When to Start, Read, and Stop · arXiv:2610.19644 · 值得扫读
该文 arXiv 未提供 HTML 全文(打开
https://arxiv.org/html/2610.19644v1/ 得到的是 arXiv 的「No HTML for '2610.19644v1'」提示页),以下只到摘要层。102研究问题与核心方法:带类型的决策模型(typed decision model:输出被限定在候选集合内的一类决策任务)需要一个既能追加推理、又不丢候选输出的接口。作者在冻结的 Qwen3.5-4B 主干上训练一个共享的候选答案读取器,空前缀与部分推理前缀都能给出分布,从而把直接决策与按需、可中断的推理统一起来;「收益门控」决定何时开始推理,「自然状态触发」决定何时发起显式读取,「熵规则」决定接受已获得的答案并取消生成。评测把答案查询工作量、生成输出量与流水线时间分开计量。作者为 Bin Zheng 与 Zheng Chen(abs 页未列机构)。102
关键结果(以下均只到摘要层):
- 在 ProofWriter、LogiQA 2.0、ARC-Challenge 三个数据集的 768 道题上,准确率从直接读取的 70.96% 升到 84.38%。102
- 相对 512 token 的末端推理(先推理完再读答案),准确率提升 7.29 个百分点,平均输出工作量只多 2.25%。102
- 相对 1,024 token 的末端推理,流水线时间下降 46.30%,准确率差 −1.17 个百分点。102
- 摘要另称用精确前缀控制把「中断」带来的节省与其它因素分离,用读取调度控制区分「观测工作量减少」与「响应时间缩短」。102
证据与局限:只到摘要层,样本量(768 题)与主要点数可读,但训练细节、种子数、重复次数、显著性检验与误差区间均无法从摘要判断,原文自报 24 页 4 图。引用风险:70.96% 与 84.38% 是三数据集合并口径,摘要未给出各数据集题量分布;「准确率差 −1.17 个百分点」与 46.30% 的时间节省来自同一次对照,未报区间。入口:代码与评测材料 https://github.com/binzheng-joey/selective-reasoning(实测 HTTP 200)。102
与目标研究线的连接点:直接落在运行期执行控制上——门控「何时开始推理、何时中断」,并把推理开销与最终答案质量分账;它与本单元 2610.19789 形成互补,一个管推理期成本、一个管训练期成本。可搬走的一件是「收益门控+熵规则」这对停止判据,以及把开销拆成答案查询、生成输出、流水线时间三个口径的做法。102
结论建议:目前只能按摘要取用,要引用数字须先取 PDF 核对表格与统计口径。适合搬的是开销分账口径与「空前缀/部分前缀都能读」的读取器设计,不适合直接引用其绝对准确率。102
2. GURI:把候选 token 身份编进灰盒检测器,3 个开源模型九个组合的 ROC-AUC 均值 72.09%→79.09%
Gray-Box Hallucination Detection in LLMs with Token Identities · arXiv:2610.19996 · 邻近跟踪
研究问题与核心方法:灰盒幻觉检测(gray-box:只用生成时暴露的 token 概率,不要模型内部隐状态)只看概率数值,不看承载概率的是哪些 token,因此分不清「模型在 big 与 small 之间摇摆」和「在 big 与 huge 之间摇摆」——两种分布数值完全相同,风险却不同。作者(Technion,Shaked Goldshtein 等)的 GURI(Gray-box Uncertainty Representations with Identity,灰盒不确定性表征加身份编码)把候选 token 概率与逐 token 的身份编码拼在一起:候选字符串用共享的外部分词器(Phi-4-mini)重新切分,子词编码均值池化并做 L2 归一化,默认用固定的单位范数随机编码;每步取概率前 10 的候选,融合网络与序列编码器联合训练。共享外部分词器使不同模型的不同词表能落进同一空间,因此不需要目标模型的词表或嵌入表。 103
关键结果:
- 主表(表 1):3 个开源模型(Gemma-4-12B-IT、Llama-3.2-3B-Instruct、Ministral-3-8B-Instruct)× 3 个问答基准(HotpotQA、TriviaQA、NQ-WC)共九格,GURI 全部高于仅用概率的基线 LOS-Net,平均约 +7.00 ROC-AUC 分,逐格提升从 +2.11(Ministral/TriviaQA)到 +12.30(Gemma/NQ-WC);例:Ministral/HotpotQA 由 70.68±0.97 升到 77.18±1.37。摘要口径的九格平均测试 ROC-AUC 由 72.09% 升到 79.09%。
- 闭源模型(表 2):GPT-4.1 上均值 67.39%→71.84%(HotpotQA 64.20→70.12、NQ-WC 65.49→73.63),但 TriviaQA 上由 72.49 降到 71.78。
- 跨模型迁移(不微调,图 4):三个开源模型的 18 个有向迁移中,GURI 有 17 个高于迁移过去的 LOS-Net,平均领先 13.52(NQ-WC)、11.93(HotpotQA)、11.27(TriviaQA)ROC-AUC 分;相对目标模型自带的置信度基线在 17/18 个迁移上胜出(LOS-Net 只有 7/18)。
- 跨数据集迁移:HotpotQA 与 TriviaQA 之间、目标模型固定时,比 LOS-Net 平均高 3.76 分;模型与数据集同时更换时高 4.94 分;涉及 NQ-WC 的联合迁移没有超过目标模型自身的置信度基线。
- 编码来源消融:固定随机编码与预训练嵌入(同分词器、同池化、同架构与训练协议)相当甚至更好,说明增益不依赖预训练的语义几何。 103
证据与局限:主表数值是 36 组超参数与种子组合的均值与标准差,迁移实验在多种子下报告;标注是自动字符串匹配,可能奖励「错答里含正确子串」并惩罚合理弃答;方法要求接口暴露候选 token 字符串与概率,并非所有商用 API 都提供;作者的通道分析只用单一训练配置,且随机编码仍保留了分词器的组合结构;续表里开放权重实验的输入含结束符之后的续写,停在首个结束符的效果未评估。原文未给出代码或数据入口。 103
与目标研究线的连接点:它改的是运行期门控这一环——生成过程中就能算出、不需要白盒访问、还能跨模型零样本迁移,可以作为长程智能体外壳里的廉价哨兵。可搬的两点是:身份编码用固定随机码即可(不必依赖预训练嵌入),以及跨模型迁移可以按「一个模型训练、另一个模型测试」直接做,不必重训。风险也很具体:如果推理接口不暴露候选字符串与概率,这套方法用不了。 103
结论建议:读表 1、表 3 与 4.3、4.4.1(迁移与编码来源消融),以及第 5 节的局限。引用 72.09%→79.09% 时说明这是 3 模型 × 3 基准的九格均值、仅对概率基线成立;把 GURI 接到线上门控前,先确认取到的是候选字符串而不是只有采样出的文本。 103
3. 稀有事件估计:无训练加权集成把相对误差压到 1.0%、样本效率提升 2.02 倍
Weighted Ensemble Sampling for Rare-Event Estimation in Language Models · arXiv:2610.19202 · 邻近跟踪
研究问题与核心方法:部署规模下语言模型的稀有失败必须被量化——原文举的例子是概率低到 10⁻⁶ 的不安全回复一天仍会被触发上千次,但用直接蒙特卡洛(Monte Carlo, MC,即从原模型独立采样并按命中比例估概率)估这种尾部概率样本效率极差。作者提出 Weighted Ensemble(WE,加权集成),一个免训练框架:所有 token 依旧从原语言模型采样,但在若干生成检查点把半成品前缀(称为 walker,即被保留并携带概率权重的部分生成)按「反应坐标」分箱,再把采样预算重新分配给更可能走到稀有事件的分箱,箱内按权重有放回重采样、子代均分该箱总权重。反应坐标早期用模型内部隐状态,后段切换到稀有事件评分 R,构成 hybrid(混合)方案。
关键结果:
- 理论部分给出三条结论:Proposition 1 证明有限样本量 N 下估计量 p̂_WE 无偏(期望等于真实概率 p*),Corollary 1 给出 L² 一致性,Proposition 2 给出渐近正态方差 σ²_WE;Proposition 3 进一步给出与直接 MC 的样本效率增益判据 N_MC/N_WE = p*(1−p*)/σ²_WE。
- 毒性故事生成任务(TinyStories-33M 作小模型、ToxiGuardrail 作稀有事件评分,总预算 14,336 样本,用 1,048,576 样本的直接 MC 作参考,40 个种子):在参考概率 1.24×10⁻⁵ 的提示上,「Layer 3 final concat → R @ 8」配置的相对误差为 1.0%、样本效率增益 2.02 倍;同表对比对象 Twisted SMC 相对误差 10.5%(原文未报增益)、LMTailRisk 34.7%(原文未报增益)。
- 命中率(hit rate,落进稀有事件集的样本比例)在同表差异很大:WE「Layer 4 all → R @ 8」为 76.7%、仅用奖励的 WE 为 97.3%、Twisted SMC 44.7%,而随机分箱的 WE 只有 0.1%(它的有效样本量 ESS 反而最高,为 4085,说明高 ESS 不等于高命中)。
- StrongREJECT 越狱任务(Llama-3.1-8B,预算 1,024 样本,5 个种子):WE hybrid 在信息误导类相对误差 13.9%、仇恨/骚扰类 15.8%、非法物品类 25.6%,同类别下 LMTailRisk 为 30.9%、43.8%、128.8%,Twisted SMC 为 54.4%、79.3% 和 100.0%(非法物品类估计值为 0)。
- 稀有事件定义放宽的鲁棒性测试(阈值 γ 从 5 依次降到 4.5、4、3,复用同一批样本):提议分布类方法迅速失准,Twisted SMC 相对误差 16.0%→37.3%→60.9%,LMTailRisk 20.2%→36.1%→58.1%,而隐状态类 WE 变体在各阈值下保持低相对误差。
- 消融覆盖分箱数、检查点间隔、隐状态聚类方法与 walker 数(附录 E.4 表 30)。
证据与局限:理论结论是精确的,但依赖附录 Assumptions 1–4(包括每个被占用分箱在 N 增大时仍获得不消失的 walker 比例)。实验口径交代清楚:两个任务都与提议分布方法在相同总预算下比较,并用大预算直接 MC 作参考概率,毒性故事 40 个种子、越狱任务 5 个种子,表中报均值与标准差。作者自陈局限是 hybrid 反应坐标需要白盒访问(读取隐状态),闭源 API 模型不可用;黑盒下退化为全程用稀有事件评分的 reward-only WE,作者称其在现代大模型上仍与提议分布方法相当。引用风险:绝对概率值的可信度依赖外部评测器(ToxiGuardrail 分类器与官方 StrongREJECT 评测器);原文未给出自有代码仓库,只引用了基线实现与所用模型/评测器页面。
与目标研究线的连接点:这是一条「评测口径」的具体可搬动做法——把「低频失败率」的估计从不可行变成可行,并且给出无偏性与样本效率增益的显式判据,可以直接替换团队现在用直接采样估尾部失败率的做法。与同一期的 ICW(arXiv:2610.19915)分工不同:ICW 改的是多条 rubric 之间的加权聚合,本文改的是单条低概率指标的采样预算如何在生成过程中分配。
结论建议:重点读第 2.3 节(无偏性、一致性、渐近方差与样本效率判据)与表 1、表 2、表 3。对「需要报告尾部失败率」的评测(安全、合规、越狱)最有迁移价值。引用时必须限定:验证只覆盖 TinyStories-33M 这一小模型与 Llama-3.1-8B、Qwen2.5-7B-Instruct 上的越狱任务,超参在附录,hybrid 配置需要白盒隐状态;基线 LMTailRisk 的仓库实测 HTTP 200,可用作对照实现 104
4. GPT-2 句法头干预证据混杂:主体偏好 0.94→0.72,非句法头在 12.32% 模拟中反超
Do Syntax Heads Influence Model Behavior? · arXiv:2610.19231 · 邻近跟踪
研究问题与核心方法:论文问被识别为「句法专用」的注意力头是否对模型的下一词预测有因果作用。作者在 GPT-2 small 上取 4 个「主谓头」(SV heads,动词处注意力最大权重指向主语的头,如第 2 层第 9 头),用 48 句改自 Schlueter 等人的主谓一致刺激,施加注意力掩码强行让这些头只看干扰名词或只看主语,并与「随机抽 4 个非 SV 头」做同样干预对照。两个度量:σ(主体偏好,0–1,越大越偏向真主语)、两个效应量 δ_p(诊断词对)与 δ_f(对整条下一词分布做 Spearman 相关)。 105
关键结果:
- 原模型平均 σ=0.94,10 万次自举模拟中 σ 始终 >0.5;把 4 个 SV 头全部强行指向干扰词后,平均 σ 只降到 0.72,仅 4.7% 的模拟出现 σ<0.5(图 2)。 105
- 非 SV 头在 δ_p 口径上效应更大者占 12.32% 的模拟,即诊断词对口径下没有证据表明 SV 头有专用因果作用;在 δ_f 口径下该比例降到 3.46%,只给出边缘证据。 105
证据与局限:仅 GPT-2 small、英语、单一依存类型(主谓)与一种结构;48 句刺激中 2 句因基线不符合要求被剔除;无中间检查点可检验「早期起作用、后期退化为遗迹」的假说;作者自陈两种度量的结论相互冲突。引用时不要把「注意力模式有专用性」读成「该组件是必需机制」。 105
与目标研究线的连接点:与四条线无直接关系。可搬走的是对照方式与口径:要对「某组件或某技能是否驱动能力」下因果结论,必须与同规模随机组件对照,并至少在两套结果量上报告效应——本文正是两套口径给出相反结论的例子。 105
结论建议:只需扫第 3 节结果与图 2。可搬「随机组件对照 + 双口径效应」的验证套路。引用时必须限定为 GPT-2 small、英语、主谓依存,且结论是「专用不等于因果必需」。 105
5. 深度专业化假象:剔除空白目标后 GSM8K/Wikitext 对比由 +0.0253 翻为 −0.0247
Target-Token Asymmetry Can Masquerade As Depth Specialization · arXiv:2610.19344 · 邻近跟踪
研究问题与核心方法:层消融研究常用的一套推理是:扰动早层或晚层,比较两个语料上准确率的损失,若某语料对早层损失更敏感,就断定「早层对该任务有深度专业化」。论文指出这个合并(pooled)对比把两个语料要求预测的目标 token(target token,被评分的下一个词,可能是词、数字、标点或一个裸空格)平均在一起,而语料的这类构成差别很大(数学解答里的空格与数字远多于百科散文),足以造出深度专业化的外观。作者定义上下文消融交互量 CAI(contextual ablation interaction,早层过度损伤与晚层过度损伤之差,判据是它是否为正),按目标 token 类型拆成条件单元重算,并在两语料共享的目标混合下重估。 106
关键结果:
- 规范设定(GSM8K 为焦点语料、Wikitext 为参考语料;H=3 即预测可见文本后第 3 个 token;mean-blend 扰动强度 α=0.2;每语料 300 条序列)下三个模型的合并 CAI 都为正:Qwen2.5-7B +0.0253、Llama-3.2-3B +0.0428、gemma-2-2b-it +0.0421,95% 自助区间均不含零(Table 1)。 106
- 同一个合并值里只有空白(whitespace)一类是正的:空白条件 CAI 为 +0.5181 / +0.8215 / +0.7155,其余四类(内容词、数字、标点、功能词)点估计全部非正,12 个区间里 11 个严格低于零,Gemma 的内容词区间含零且上端点为 +0.00001;把空白剔除后合并值变成 −0.0247 / −0.0330 / −0.0131,三个区间都在零下(Table 1)。 106
- 按参考语料混合重加权只救回两个模型:Qwen −0.0121、Llama −0.0116,Gemma 仍为 +0.0074,因为 Wikitext 2.7% 的空白占比下 Gemma 的空白单元仍贡献 +0.019,压过其余四类合起来的 −0.012(Table 1)。 106
- 高风险与中风险语料对里,合并为正的 14 行在剔除空白后 14/14 变号(合并区间整体在零上、剔除空白区间整体在零下);参考混合重加权让其中 11 行转负(Table 3、Table 23、Table 30)。 106
- 只靠分词器就能在跑模型前打风险标签:输入为目标空白率差 Δws、每 token 字符数差 Δchars、两语料目标类型分布的 JS 散度(Jensen–Shannon divergence,分布差异度量),高风险门槛为 Δws≥0.045、Δchars≥0.50、JS≥0.01,低风险为 |Δws|≤0.020 且 |Δchars|≤0.35;被评为高或低风险的留出语料对共 9 行全部落在标签预测的区域,其中 8 行同时满足区间判据(Table 2、Figure 3)。 106
- 诊断交互量 I(空白减内容词的差在 H=3 mean-blend 与 H=1 mild-resample 两个设定间的对比)在五个同序列审计实例中全为正,范围 +0.52 到 +0.81,10,000 次自助重采样中没有一次非正抽样(Figure 2b)。 106
证据与局限:样本量:规范对比每语料 300 条序列;空白单元建立在 3,348/3,526/3,281 个 GSM8K 与 1,093/1,171/1,150 个 Wikitext 目标 token 上;另一组同序列审计 200 条序列,位置控制样本每语料 200 条,H=1 mild-resample 序列每语料 250 条。区间是语料内按序列重采样的 95% 百分位区间,论文以「区间是否含零」为判据,未报告显著性检验。作者自陈局限:主结论限定在 H=3 mean-blend top-1 CAI 与 α=0.2;位置分析只覆盖规范对的空白单元,控制准确率拆分只覆盖 H=1 mild-resample 序列,H=1 mean-blend 下的内容词正单元未拆;论文另声明用生成式 AI 参与实验设计、指标定义与写作,但设有内部核验器从结果产物重算表格数值。引用风险:这是聚合偏置(aggregation bias,合并统计掩盖分层结构)的诊断,不是任何模型能力结论。 106
与目标研究线的连接点:与同节的 ChronoCulture 都在讲「打分方式决定你能看见什么」:那篇讲众数打分对已变化的题对天生不可见,这篇讲合并指标把层级差异归因给任务构成。可搬走的一件东西是这条报告协议:先给出每个语料的目标类型占比与每 token 字符数(分词器级预筛,成本为零),在合并量旁给出按目标类型拆分的条件值与混合匹配后的汇总,若仍有正单元,再按「未消融模型是否已答对」二次拆分。对 A 线直接可用:任何跨语料、跨基准的合并对比(例如两个长程基准的逐步准确率之差)都可能被目标构成带动,结论前必须先报构成与匹配后的符号。 106
结论建议:先读 Table 1(合并值、五个条件单元与三个汇总)与 Table 2(分词器预筛规则),再读 §5 的稳健性检查(算子×位置网格、分类边界、连续目标间隔读数、一 token 前瞻的内容词单元)。引用时必须同时给出目标类型构成与混合匹配后的符号,并写清位置 H 与扰动强度 α,否则该深度效应不能读成任务专业化。 106
6. 尾部竞争解释 BoN 缩放:错误答案奖励方差更大即奖励劫持,尾部张力早停把 5.68% 拉回 11.61%
Tail Competition Explains Scaling in Best-of-N Sampling for Verifiable Problems · arXiv:2610.19362 · 邻近跟踪
研究问题与核心方法:Best-of-N(BoN,一次采样 n 个回答、选奖励模型打分最高的那个)在奖励模型不完美时并不随 n 单调变好,作者把 BoN 写成「正确答案奖励分布的右尾」与「错误答案奖励分布的右尾」之间的竞争——只有正确样本的最大奖励超过错误样本的最大奖励,BoN 才会选对。用极值理论(extreme value theory,EVT,描述样本最大值极限分布的理论)刻画渐近行为,并推导有限 n 的缩放律与一个不需要正确性标签的早停判据。107
关键结果:
- 渐近三相(定理 1):正确尾主导(成功率→1)、错误尾主导(→0)、临界相;奖励服从 Gaussian 时,正确答案(下标 c)与错误答案(下标 w)的奖励标准差满足 σ_c<σ_w 即进入错误尾主导;下文 μ 指奖励均值、σ 指奖励标准差。四相(表 1)按「n=2 相对 n=1 是否变好」×「渐近是否→1」划分:iA 单调改善、iB 延迟改善(U 形)、iiA 奖励劫持(reward hacking,指奖励模型给错误答案的高分在右尾压过正确答案、把 BoN 选歪)(倒 U 形)、iiB 单调退化。107
- 缩放律:oracle 选择下成功率按 1−e^(−np) 指数收敛,不完整选择器在 Gumbel 吸引域下的收敛是多项式(定理 2,指数见式 12),即奖励模型不完美会把 BoN 的收敛速度从指数级降为多项式级。107
- 反转尺度:n* = exp((μ_c−μ_w)² / (2(σ_w−σ_c)²))(式 7),即错误答案最大奖励追上正确答案的位置;Gaussian 下的奖励劫持条件为 μ_c>μ_w 且 σ_w>σ_c(式 6)。107
- 真实奖励分布(表 3,数据集为 Monkey Business:每题 10,000 个响应,覆盖 MATH、MiniF2F、GSM8K、CodeContests 的 2,878 个「题目–生成模型」对,配 6 个奖励模型):正确答案平均分更高,但除 Sky-Qwen-4B 外错误答案方差更大,符合尾部张力。107
- 早停:把前 t 个候选的分数拟合成两成分 Gaussian 混合,高均值成分当正确答案代理,只在低均值成分方差更大时触发,最小预算 n_th=32。在已发生奖励劫持的子集上,标准 BoN 从 19.02% 掉到 5.68%,该方法把终点拉回 11.61%(附录 B.2,allenai/Llama-3.1-8B-Instruct-RM-RB2 分数);在准确率单调上升的数据集上按设计不提前停,故不涨分。107
证据与局限:模拟从每题 10,000 个响应中抽 n 个、重复 1,000 次取平均,四相与缩放律在合成 Gaussian 数据与真实奖励分数上做了对照;EVT 在 n=32 时平均偏差约 3–4%,这是取 n_th=32 的原因。作者自陈局限:只覆盖可验证任务;早停依赖奖励分数能分成两成分,非双峰或远离 Gaussian 的分布未验证;从真实数据在有限 n 下判断自己落在哪一相仍是开放问题。特别提示:早停的收益只出现在「已经发生劫持」的子集,不能当作通用增益。107
与目标研究线的连接点:这是推理控制与判官效度交叉处的一篇理论工作,可搬走的一件东西是:把选择器(奖励模型或判官)的打分分布当作可拟合对象,用「均值差还是方差差」判断继续采样的边际收益,得到一个不依赖正确性标签的停止准则。这也提供了一种审计口径——把判官误差从「准确率」改写为「正确/错误两类的尾部分布」,用来检查自家 reward model 或 verifier 是否会在大 n 下反噬。107
结论建议:读 §3.2 表 1、§4 定理 2、§5 与附录 B.2;奖励模型与数据集入口 https://huggingface.co/datasets/ScalingIntelligence/monkey_business、https://huggingface.co/HFXM/RAMO-Llama3.1-8B 均实测 HTTP 200。引用时必须限定为可验证任务,并说明早停收益只在检测到错误尾主导时成立。107
7. OBA 免训练并行解码:DiffusionGemma 每前向 token 数 15.64→22.25,吞吐 +16.3%
One Block Ahead: Promoting Sampler State in Diffusion Language Models · arXiv:2610.19510 · 邻近跟踪
研究问题与核心方法:块扩散语言模型(block-diffusion LM,一次前向并行去噪一整个块的 token 位置)能一次吐出多个 token,DiffusionGemma 原生块为 256 token、约 20 tokens per forward(TPF,每前向 token 数),但块与块之间仍是严格串行,块内加速动不了这一段。OBA(One Block Ahead,提前一块)让当前块与「预热块」在同一次前向里去噪,用块因果掩码保证当前块不受预热块影响;当前块提交时,把预热块的 token 连同采样器状态(自条件信号,即把上一步预测带回下一步的信号,以及去噪时间)一起提升为新的当前块。方法免训练、不改权重,并给出一个断点判据:设 α 为每个预热步省下的当前块前向数、r 为成对前向的相对成本,只有当 α>r−1 时才划算。108
关键结果:
- 十个基准平均:TPF 从 15.64 升到 22.25(+42.3%),单请求去噪吞吐从 2375 升到 2761 tokens/s(+16.3%,单张 GB300),平均准确率下降 1.37 点。108
- 直接加宽块的对照:把块宽从 256 加到 512 只把 TPF 从 15.64 提到 16.67,而一次 512 位前向的成本约为 256 位的 1.84 倍,吞吐比原生 256 块低 41.4%。
- 状态继承消融(表 2,十基准平均):只继承 token(掩码扩散的做法)α=0.25、吞吐 −2.8%;加上自条件信号 α=0.41、+7.7%;再加上去噪时间 α=0.54、+16.3%。扣掉自条件信号后 α 掉到 0.02、吞吐 −19.9%;换成双向稠密掩码 α=0.38 但要 α>0.70 才回本,吞吐 −20.9%、准确率 80.29。
- 与 FlowBlock(窗口 W=2)对比:FlowBlock 因等待就绪门阈值,只有 92.2% 的前向保持 256 位宽,α 降到 0.09,TPF +7.2%、吞吐 +4.5%(OBA 为 +42.3% 与 +16.3%);窗口放宽到 W=3 或 4 变化在 1% 以内。
- 提升后的块在成为当前块的第一次前向上平均已有 41.0% 的位置被接受(原生新块为 5.4%),其中 39.9% 一直保留到提交(原生为 5.1%)。
证据与局限:作者自陈只测单请求(batch size 1)、单一 GPU 类型与单一模型,且提升机制依赖 DiffusionGemma 的具体设定(uniform-state 扩散:每个位置在被提交前都可修改,进度无法从中间 token 读出),掩码扩散里可读的 mask 让这套机制不适用;两个对照的多块方法用的是接近 32 的块宽,与本设定的成本结构不同。准确率只报了平均下降 1.37 点,没有逐基准区间;α 是用递推回归拟合出的估计量而不是直接测量。评估总体为 4736 条案例(GSM8K 1319、MATH-500 500、MBPP 500、HumanEval 164、GPQA 198、IFEval 541、MMLU 前 1000、LiveCodeBench C++ 454、AIME 2024 与 2025 各 30),各配置之间案例标识、prompt token 哈希与种子对齐。机构为斯坦福大学与英伟达;
https://arxiv.org/html/2610.19510v1/ 实测 HTTP 200,原文未给出代码或数据入口。108与目标研究线的连接点:它落在「运行期执行控制」这一环,给出的不是一个更快的解码器,而是一个可搬的决策式——把「重叠执行是否划算」写成 α>r−1,并用状态继承消融逐项拆出收益来自哪个状态分量(token、自条件信号、去噪时间分别值多少)。做投机解码、并行工具调用或任何「让下一步提前起跑」的调度时,这套断点判据与「逐分量扣减」的消融口径可以直接照搬;与本单元其它论文没有方法重叠。108
结论建议:读 §3(成对块布局、状态继承、断点判据)、§4.2 与 §4.3(表 1、表 2)。只拿一个结论的话:并发分块本身并不省时间,省时间的是把采样器状态一起带过提交边界——只带 token 会亏。引用时必须限定:batch=1、单卡、单模型,且 +42.3% 是每前向 token 数、不是端到端时延。108
8. Wenyan Thinking:1024 token 预算下 MMLU-ProX-Lite-ZH 从 11.4% 升到 52.9%,缺答率 87.5%→7.5%
Does the Linguistic Register of Thinking Matter? Wenyan as a Compact Reasoning Register for Chinese LLMs · arXiv:2610.19741 · 邻近跟踪
研究问题与核心方法:中文推理模型的可见思维链通常写成现代白话,在受限解码预算下很啰嗦。作者提出的问题很窄也很少见:推理的「语言语域」(register,即同一语言内部的历史文体变体)本身能不能当作效率杠杆?做法叫 Wenyan Thinking:保留答案通道为简短直接作答,只把推理字段改写成文言文,用 Qwen3.5-397B-A17B 把中文推理数据(取自 Chinese-DeepSeek-R1-Distill-data-110k 的 10,000 条)改写成文言,再对 Qwen3-4B-Thinking-2507 做全参数 SFT(supervised fine-tuning,有监督微调)。关键设计是同一批源数据、同一教师家族、同一基座与同一 SFT 配方再造一个「紧凑现代汉语」对照,用来把「换语域」和「单纯压缩」分开。
关键结果:
- 数据与训练:原文对 10,000 条训练数据的现代汉语推理字段平均 1457.8 字(中位 926),改写后的文言字段平均 420.9 字(中位 382),即监督信号在解码之前就已显著更短;SFT 为全参数、2 epoch、学习率 1×10⁻⁵、最大长度 2048、bf16 加 DeepSpeed ZeRO-3。
- 主基准(表 2,MMLU-ProX-Lite-ZH 精确匹配,预算 1024/2048/4096/6144):原始 Think 为 11.4%/32.3%/50.9%/58.8%,Wenyan 为 52.9%/55.3%/55.4%/55.6%,紧凑现代汉语对照为 52.2%/52.9%/53.2%/53.4%,纯提示「简洁作答」只有 13.4%/32.0%/44.9%/47.5%,不显示思维链的 Answer-only 稳定在 41% 上下。作者的读法是压缩本身解释了大部分收益,文言在低预算下稳定高于紧凑汉语对照但幅度不大。
- 效率与答案完成(表 4):1024 token 预算下原始 Think 输出 1008.1 个 token、缺答率 87.5%(对应 11.4% 准确率),Wenyan 输出 394.2 个 token、缺答率 7.5%(52.9%),紧凑汉语对照为 254.7 个 token、3.1%;4096 预算下 Wenyan 458.4 个 token 对 Think 的 2901.8 个。
- 跨基准(表 6、表 7):CEVAL-valid-direct 上 Wenyan 为 73.5%/74.8%/74.7%/74.7%,原始 Think 为 41.0%/63.0%/75.6%/79.3%;AGIEval-CN 直接子集上 Wenyan 准确率 49.92%/51.55%/51.43%/51.27%,端到端评测时间 07:54/08:53/10:14/11:20,而原始 Think 为 14.20%/24.37%/33.49%/35.89% 与 24:20/1:06:19/2:35:33/3:36:37。
- 通道归因(5.4 节):只对推理段(到
</think>为止)计损失时准确率为 52.4%/54.1%/54.6%/54.9%,比全序列监督低 0.5–1.2 个点,说明收益主要来自学到稳定紧凑的文言推理风格,答案段监督只是稳住过渡。 - 改写质量审计(表 5):抽 40 条让 DeepSeek-V4-Pro 当自动判官打分,忠实性、步骤保留、可读性、答案支撑四项均值都高于 4.3(1–5 分),答案泄漏风险 1.00,判定为 27 通过、11 小问题、2 大问题。
证据与局限:结论建立在「同一数据、同一教师家族、同一基座、同一配方」的受控对照上,这是本文最强的部分;但主基准只有 588 条固定子集,作者自己也说小差距靠它估不准。作者自陈局限:只覆盖中文基准与 10,000 条改写子集,未扩展到其他模型家族;监督由教师生成,改写质量与一致性会直接决定结果,而紧凑推理比白话更难审;答案通道的基线用的是同系列的 instruct 兄弟模型而非严格同一基座的关闭思维链解码;「文言更紧凑」这一前提在中文之外是否成立留作未来工作。原文未给出代码或数据入口。引用风险:三个基准上文言与紧凑汉语的差距方向并不总是一致(CEVAL 低预算下文言高、AGIEval-CN 上文言只在大预算略高),不要把「文言更好」写成普遍结论。
与目标研究线的连接点:可搬走的是「把生成预算当自变量、把可见推理的表达形式当处理变量,并用同源同配方的紧凑对照剥离压缩效应」这套实验设计——放在长程智能体的评测里,就是把「推理长度」从背景参数变成受控变量,同时报告精度、输出长度、缺答率与端到端时间四个量。参考同期 INTACT(arXiv:2610.19568):它在潜空间压缩推理,本文在语域层面压缩推理,两者对预算敏感的评测口径可以互相借用。
结论建议:读第 3.2、3.3 节(数据构造与 SFT 配方)、第 4.3 节的预算扫描口径,以及表 2、表 4——表 4 的「输出 token + 缺答率」是最好搬走的一列。对中文推理产品可迁移的是「把推理语域当可调设计轴」这一结论;引用时必须限定为中文基准、588 条主基准子集与教师生成的监督,且不得把自动判官审计当成人工评估的替代 109
9. LCMV:把“长推理链更容易错”写成长度条件先验,无标签测试时自适应后给多数投票加权
Frustratingly Easy Majority Voting Using Length Conditioning · arXiv:2610.19890 · 邻近跟踪
研究问题与核心方法:多数投票(majority voting,对同一问题独立采样多条思维链、取最高频答案)是提升推理准确率最省事的推理期算力分配方式。LCMV(Length-Conditioned Majority Voting,长度条件多数投票)利用已有研究反复观察到的一条经验规律——越长的思维链越可能与答错相关——把它写成长度条件的先验概率,用一个简单 logistic 函数建模;再只用手头无标签的测试数据在测试时调整这个先验,全程不微调大模型;最后用调整后的先验给每条采样答案的票加权。该文 arXiv 未提供 HTML 全文,以下只到摘要层;摘要本身不含任何数值,正文的方法细节、模型与基准清单、对照设置、表格均未核验。110
关键结果:
- 摘要称在多个大模型与多个推理基准上的大量实验里,LCMV 一致优于标准多数投票,也优于既有的基于长度与基于置信度的聚合策略(只到摘要层,无具体数值可引)。
- 摘要强调它保留了多数投票的简单性与模型无关性(只到摘要层)。
- 该文 arXiv 未提供 HTML 全文,以上两条均只有摘要支撑。110
证据与局限:只到摘要层,实验规模、模型清单、基准清单、对照设置与显著性都未核验,摘要未给出任何数字,因此本条目不提供任何数值。另需注意“长度与正确率的关系”在原文表述里是一条经验性关联,作者是在利用它做加权,不能反推成因果。代码入口 https://github.com/aimagelab/LCMV 实测 HTTP 200,方法细节可等正文可获取后再核。110
与目标研究线的连接点:这条线里做自一致性/多数投票的读者可借鉴的是“不用标签就给样本加权”的思路:先用长度与正确率的经验关系设一个先验形状,再用无标签测试集把先验调到当前任务的分布上,最后只改聚合权重、不动模型。可搬走的一件东西正是这个两段式做法本身——先验提供形状,测试时无标签自适应提供尺度。110
结论建议:现阶段只能作为线索跟踪:等该文有 HTML 或 PDF 可读后再决定是否引用;若要先试,优先确认它用什么量定义“长度”(token 数还是推理步数)以及先验在多少条采样上估计,这两点决定它能否搬到自己的评测口径里。110
10. 不是不会推理而是不会停:60% 稀疏度下 41.4% 的不终止轨迹已含正确答案
To Reason but Not to Stop: Understanding and Recovering Pruned Large Reasoning Models · arXiv:2610.19934 · 邻近跟踪
研究问题与核心方法:权重剪枝会让大型推理模型(LRM)掉点,本文追问这部分掉点是「推理能力受损」还是「停不下来」。作者把现象命名为 reasoning divergence:模型在 token 预算内不终止、反复回退到早前的推理并打转,但在教师强制下仍知道该在哪里停。基于「同一前缀下终止续写与打转续写的隐状态差」跨剪枝检查点方向一致这一观察,提出 TGAS(Termination-Guided Activation Steering,终止引导的激活引导):免训练,把该方向按典型激活范数缩放后加到残差流上。111
关键结果:
- 表 1(MATH-500,只取稠密模型答对的题,OBC 校准:按推理步骤重要性加权的剪枝校准):稀疏度从 50% 升到 60% 时,DS-Qwen-7B 的不终止率从 3.8% 升到 16.8%,14B 从 2.4% 升到 16.4%,而「终止但答错」的比例基本不变;终止样本内的准确率仍为 93.5%(7B)与 88.9%(14B)。111
- 不终止轨迹里已有答案的比例:60% 稀疏度下 7B 为 41.4%、14B 为 39.2%,答案首次出现的中位位置分别是轨迹长度的 13.0% 与 11.9%(约 2.1k 与 1.9k token)。111
- 预算不是主因:把预算从 16,384 提到 65,536 token,7B 在 50% 稀疏度下不终止率从 42.5% 降到 12.5%,但准确率几乎不动,60–70% 稀疏度下不终止率几乎不降,附录 D.2 显示多出来的预算只换回 0–3 条正确轨迹。111
- 方向一致性(图 5):DS-Qwen-7B 在 50–70% 剪枝率之间构造的终止方向两两余弦相似度至少 0.87,1.5B 在 40–60% 之间至少 0.83。111
- 效果:平均到三个基准,TGAS 在每个模型-稀疏度组合上都比标准推理高 1.3–3.7 个点,并在 18 个「检查点 × 基准」对中的 16 个提高终止率、没有任何一个下降;六个设置里平均准确率都是免训练方法中最好的,但 18 对里有 4 对输给最强基线。111
- 统计检验(附录 F.10,每题 16 个样本,两双侧问题级符号翻转置换检验,20,000 次置换):四对模型-基准里三对的合并准确率提升有统计意义(DS-Qwen-7B 在 LCB +1.5,p=0.016;OT3-7B 在 AIME-25 +2.1,p=0.046;LCB +1.1,p=0.026),DS-Qwen-7B 在 AIME-25 上 +1.5 不显著(p=0.171);检查点级别最大提升为 +4.4(DS-Qwen-7B,60% 稀疏度,LCB,p=0.003)与 +5.4(OT3-7B,50% 稀疏度,AIME-25,p=0.002)。111
- 生成长度:跨全部稀疏度平均减少 7.6%,60% 稀疏度减少 12.3%(每条少 1,423 token);六个模型 × 四个检查点 × 三个基准共 72 个设置里有 64 个不低于基线,平均准确率从 46.5% 升到 49.1%。111
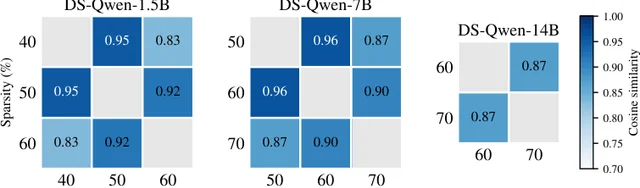
不同剪枝稀疏度检查点构造出的终止方向两两余弦相似度热图(arXiv:2610.19934)
证据与局限:主表是 k=4 次采样的均值 ± 标准差,显著性检验只覆盖两个模型 × 两个基准(AIME-25 与 LCB),因此不能把「普遍显著」写进任何结论。研究对象全是 ≤14B 的蒸馏或 SFT 推理模型,基准只有 MATH-500(4–5 级)、AIME-25 与 LiveCodeBench,作者自陈对 RL 训练的推理模型、更大模型与开放式任务是否成立仍待验证;剪枝只做非结构化稀疏,且 TGAS 需要先从剪枝检查点采样一批续写来构造方向(每模型一次)。在高稀疏度下能力是真丢了,TGAS 只能补回部分差距,作者建议未来把「保持终止行为」写进剪枝算法本身。另有两点自测口径要留意:判断「轨迹里已有答案」用的是基于线索词(如 thus the answer)的文本规则,作者用 LLM 判官在 250 条样本上校验(一致率 96.0%,κ=0.898)。111
与目标研究线的连接点:不在四条线上,但对 A 线的评测口径有一件可直接搬走的东西:报告长推理预算下的成绩时,把失败拆成「不终止」与「终止但答错」两类分别计数,并用「不终止轨迹中已含正确答案的比例」估计可恢复空间(附录 E.3 的 headroom 分析就是这套算法)。这把「预算耗尽」从数据噪声变成一等错误类型,也解释了为什么单纯加预算换不回准确率。第二件是它的方向一致性检验范式:跨检查点比较同一个行为方向,并与标签打乱基线、无关对比基线做对照,用来证明「这个方向不是同一模型的伪影」。111
结论建议:读 3.1–3.2 节(不终止的分解与隐藏态方向)与 5 节的表 5–表 8,再读附录 F.10 看显著性边界;对 A 线可迁移的是「不终止 / 终止但错」的二分解评测与 headroom 估计,对推理控制可迁移的是 prompt 无关的推理时终止引导(一个方向 + 一个强度系数)。引用时必须限定:k=4 采样、显著性只在两个模型两个基准上成立、模型 ≤14B 且只覆盖数学与代码。111
11. 用内在维度定注意力头数:k*=9.2(95% CI 8.6–9.8),10 头与 32 头在 SST-2/MRPC 等效(±1 分),注意力参数少 69%
Choosing the Number of Attention Heads from Intrinsic Dimension: A Small-Scale Study · arXiv:2610.19966 · 邻近跟踪
研究问题与核心方法:认知科学研究所(Institute of Cognitive Science,奥斯纳布吕克大学)与慕尼黑工业大学的 Arjun Boya、Charan Sai Bandaru、Masthanaiah Pillimetla、Kavana Chidanandappa 测一个先验设注意力头数的启发式:用无标注数据估计词元表征的内在维度(intrinsic dimension,表征实际变化所沿的独立方向数),把头数设在该估计附近,从而省掉「先训大模型再剪枝」的流程。估计方法是:在 WikiText-2 的 DistilBERT 嵌入(保留前 60,000 个 768 维词元向量)上训练带嵌套 dropout(nested dropout,使潜维度按重要性排序)的 VAE(变分自编码器),KL 权重不手调,而是取 VAE 率-失真曲线的拐点,得到 k*=9.2(95% 置信区间 [8.6, 9.8])。验证用一个 4 层、128 维、从零训练的小 Transformer,在 SST-2(电影评论情感分类)与 MRPC(句子对释义判定)两个二分类任务上比较 10 头与 32 头 112
关键结果:
- 等效性(表 2,10 个配对种子):SST-2 上 10 头为 82.13%±0.42、32 头为 81.95%±0.33,配对 t 检验 p=0.31,TOST(Two One-Sided Tests,双单侧等效检验)在 ±1 个准确率点内判定等效(p=0.0005);MRPC 上 70.47%±0.90 对 70.37%±1.03,p=0.74,同样等效(p=0.006) 112
- 参数成本:10 头配置的注意力参数比 32 头少 69%(摘要、5.2 节) 112
- 与剪枝对比(表 3,同样 10 个种子):把训练好的 32 头模型剪到 10 头,剪完不微调掉到 71.69%±7.04,微调后回到 81.50%±0.37,而从头训 10 头为 82.13%±0.42,平均高 0.63 分(t=3.41,p=0.008,Cohen's d=1.08);完整剪枝流程 10 个种子耗时 2.41 GPU 小时 112
- 开发史里的一个坑(附录 A.1):早期版本让两个头数共用全局随机数发生器,而初始化消耗的随机抽样数随头数变化,导致同一随机种子下 10 头与 32 头的批次顺序不同,配对检验其实不配对;改成每个运行独立的带种子数据加载器后重跑了全部比较 112
证据与局限:这篇明确报告了 10 个配对种子、均值±标准差、配对 t 检验与 TOST 等效检验,在小规模研究里算规范。作者自陈的局限写得很清楚:内在维度与头数之间没有形式化联系(只有类比)、只比较了 10 与 32 两个头数(应扫 4–16 头)、只用一种内在维度估计器、只用 4 层 128 维从零训练的小模型(未测预训练模型、更大模型、生成任务、长上下文与多步推理)、剪枝基线只有一种重要性打分且该打分用了被报告的验证集。引用风险:k*=9.2 只是「一次落在 10 附近」的单点吻合,不是方法的验证;MRPC 绝对准确率很低(两个头数都有约 94% 训练对 70% 验证的过拟合),不能当预训练模型的参考 112
与目标研究线的连接点:与同节评测口径类论文相比,它可搬走的是两条具体纪律:用 TOST 等效检验代替「差异不显著」来声称两种配置相当(并显式给出 ±1 分的等效边界),以及给每个运行独立的带种子数据加载器以保证配对检验真的配对。这两点在 A、B 线的模型与配置对比里可以立刻用上;头数启发式本身则只值得当作「大模型上可以试一次」的候选。入口实测:原文 HTML(v1)与代码仓库 https://github.com/subcortical7/IT-MHA 均返回 HTTP 200 112
结论建议:看表 2(等效检验)、表 3(剪枝对照)与第 6 节局限清单,附录 A.1 的开发史也值得一读——它记录的配对失效是很多内部实验都会犯的错。引用 k* 时限定为「WikiText-2 上的 DistilBERT 嵌入、单一估计器、单一拐点规则」;把「10 头够用」限定为「4 层 128 维、两个二分类任务、10 个种子」 112
12. 138 篇稀疏自编码器研究的批判性综述:把可恢复性、可解释性、机制忠实度与行为效用拆开评
Sparse Autoencoders for Mechanistic Interpretability in NLP: A Critical Survey of Recoverability, Interpretability, and Utility · arXiv:2610.20139 · 邻近跟踪
研究问题与核心方法:稀疏自编码器(SAE,把语言模型激活分解成少量稀疏、可解释特征的编码—解码结构)在机制可解释性里被寄予厚望,但各研究的设计假设、评测目标与实验设置互不一致,导致结论无法互比。这篇综述覆盖 138 项 NLP 领域的 SAE 研究,提出一套任务锚定的分类学:用“字典设计 / 特征操作 / NLP 功能”三个面共同标记每项研究,并把模型版本、激活位置、数据、监督、特征选择与干预协议作为限定条件记录。它同时给出一个按主张分级的证据框架,要求把四件事分开检验:可恢复性(编码过程是否恢复了目标隐结构)、语义可解释性(特征描述是否对激活或效应作出可区分的预测)、机制忠实度(解释是否指认了原模型真正使用的计算)、行为效用(在带竞争目标的具体任务上是否成功)。113
关键结果:
- 语料规模与统计口径:纳入 138 项研究(正文与附录 B.2 一致);附录明确多标签计数不可相加回归到 138(一项研究可同时计入多个格),语言功能一项从只算主议题的 8 篇升到保留次要功能后的 15 篇,作者声明这是编码属性、不代表发现了 15 个独立因果机制。
- 转述既有合成实验作为可恢复性的口径示例:在已知生成字典的设定下,TopK 的恢复率随保留坐标数 K 从 20 增到 50 时由 98.4% 掉到 23.4%;频率覆盖匹配与否使 GBA 的恢复率为 100% 对 3.9%(对齐阈值 0.9、128 个生成特征)。作者用它说明分配规则与覆盖假设的敏感性,而不是给 NLP 方法排名。
- 方法学结论:分配规则不能只按重建排序(BatchTopK 的重建优于 TopK,但在 Gemma-2-2B 上与 JumpReLU 的下游交叉熵退化比较结果混合);跨方法比较必须匹配平均稀疏度、数据与插入协议,并记录解码器归一化,因为它会改变系数尺度。
- 实践建议(第 6.2 节):有明确预测目标时先用调好的监督探针与匹配的标签预算;要控制输出时先用直接激活方向;要验证局部计算假设时,神经元、注意力头或功能代理可能才是合适的分析单元。113
证据与局限:这是一篇综述,其“证据”是编码后的文献横断面,不是一个受控实验;作者自陈跨研究比较受模型架构、数据集、特征表示与评测协议差异限制,因此强调“结论在什么条件下成立”而非方法排名,并明确不覆盖稀疏编码、解纠缠表示等 SAE 之外的方法。附录 B.2 也提醒多标签统计不能当作研究流行度或质量证据。引用风险:本文包含的合成实验数字转自 Chen 等的工作,引用时应标为“转述”;作者的 AI 使用声明确认用 Grammarly、ChatGPT 做校对、用 OpenAI Codex 协助构建 HTML 研究注册表。附带的研究注册表地址为 https://anonymous.4open.science/r/sae-research-register-C331/register.html,实测 curl 返回 403、加浏览器 UA 为 200,但用页面抓取工具打开被 Cloudflare 拦下,内容本次未能核验。113
与目标研究线的连接点:对这条线可直接借用的是它的证据分级方式:把“能重建”“能被描述成确定含义”“指认了模型真正用的计算”“在任务上有用”当成四个独立主张,各自需要不同的检验与控制。读者若要审计一篇声称“我们做了可解释性分析因此改进了系统”的论文,这套四问可以直接当检查表;它也是把自进化里“改进究竟来自哪一环”这类归因说清楚的工具。113
结论建议:需要引用具体数字时,只引附录 B.2 的 138 与 8 到 15 这类编码统计,以及第 3.2 节转述的合成恢复率;方法论部分读第 4 章(从特征到解释与机制的分级检验)与第 6.2 节的选择建议。提醒:这是一篇综述,任何“某某方法更好”的表述都必须回到它引用的原始论文去核。113
13. TreeSpark:树形候选让接受长度较 DSpark 提升 23.4%–31.6%、单请求吞吐提升 15.1%–25.0%
TreeSpark: Learning to Draft the Trees You Verify for Speculative Decoding · arXiv:2610.20175 · 邻近跟踪
研究问题与核心方法:投机解码(speculative decoding,先由便宜的小草稿模型提出若干 token、再由目标模型并行验证)中,并行草稿器一次前向就提出整块 token,但一旦早期 token 不匹配,后面已经算出来的预测全被丢弃。TreeSpark 在半自回归的 DSpark 架构上保留多条候选:一次主干前向产出各深度的 logits,再对每个前沿父节点做轻量校正得到分支条件分布,按局部分支因子 k 与预算 N(非根节点数)构造并全局打包候选树。关键的训练设计是「在部署策略下训练」:训练时复放部署时同样的扩展、剪枝与预算打包策略,让校正头在模型自己选出的父 token 上受监督;生存损失(survival loss)按参考目标模型算出的整条路径概率质量 m_v 加权被保留边的似然,覆盖铰链(coverage hinge)则在局部选择边界附近给「被挤出预算但目标模型认为重要」的候选补上信号。离散选择在反向传播中被冻结,只有连续概率可导;两者复用同一条参考链的目标分布,不额外跑目标前向。
关键结果:
- 主结果(表 2,Qwen3-4B 与 Qwen3-8B 目标模型,贪心解码,9 个通用基准 + WritingBench 六个写作域):平均接受长度从 DSpark 的 4.23 升到 5.25(Qwen3-4B,提升 24.1%)、从 4.20 升到 5.18(Qwen3-8B,提升 23.4%);写作域增益更大,2.68→3.52(31.4%)与 2.55→3.35(31.6%)。
- 逐位置接受率(图 2,并发 C=12,9 基准平均):第 1 个草稿位置的接受率从 78.8% 升到 90.0%,第 7 个从 24.7% 升到 37.0%,说明增益不是只靠浅层。
- 吞吐(表 1、表 3):相对 DSpark,通用套件单请求平均吞吐提升 15.1%(Qwen3-4B)与 17.9%(Qwen3-8B),写作域达 21.9% 与 25.0%;批处理下 Qwen3-4B 在 C=12 提升 17.2%、C=36 提升 12.6%(原文摘要写作 12.6%–17.2%)。
- 把「推理期多留候选」与「训练对齐」分开的对照(图 3,DSpark + Tree,容量与推理策略相同但关掉两个树损失):平均接受长度 4.93→5.25,约 6.4%;系统吞吐在 C=12 从 283.54 升到 295.34 token/s(4.2%),C=36 从 615.68 升到 646.44(5.0%)。
- 组件消融(表 4,C=12,系统吞吐 token/s):DSpark 均值 254.68,TreeSpark 295.34(+17.2%);去掉生存损失降到 281.89(+11.9%),去掉覆盖损失降到 293.36(+16.0%);把注意力头维度从 192 降到 128 则为 289.64(+14.6%),说明两个损失与额外容量各自都有贡献,但生存损失的聚合贡献更大。
证据与局限:吞吐结果取三次重复测量的平均,指标口径写明(接受长度含目标模型给出的 bonus token,吞吐按聚合输出 token/s,基准等权,增益按逐基准百分比平均),但原文未见显著性检验,因此只能报「提高」不能报「显著提高」。设置上草稿器统一训练 10 个 epoch、50,000 条提示、最大序列 4,096,评测最多生成 2,048 token,实验只在昇腾 910B 上做、目标模型只有 Qwen3-4B/8B 两个规模,贪心解码一种策略;原文没有独立的局限章节,跨硬件、跨采样策略的外推需自行验证。
与目标研究线的连接点:可搬走的是这条训练信号原则——「把部署时由策略自己做出的离散选择冻结、只对连续得分求导,并按最终能否存活的路径质量加权监督」。这正好是轨迹级训练里信用分配的一个小规模可复现替身:先确定哪些候选真的进入验证(决定谁能被奖励),再按路径质量分配权重,同时用一个边界项给「差一点被选中」的候选补信号。与同节另外两篇相比,它改的不是推理内容也不是评测口径,而是「推理期候选生成」这一环。
结论建议:读第 3.2、3.3 节(部署策略复放、生存损失与覆盖铰链)与图 3、表 4——图 3 是判断「增量到底来自推理扩展还是来自训练信号」的关键对照。代码仓库 https://github.com/Robot2050/TreeSpark 实测 HTTP 200。引用时必须限定为贪心解码、Qwen3-4B/8B 与昇腾 910B 单机设置,且原文未做显著性检验 114
14. 跨模型神经反馈:10 个 9B–32B 模型里只有 3 个能小幅拉动自身激活读数
Cross-Model In-Context Neurofeedback Reveals (Limited) Activation Control in LLMs · arXiv:2610.20179 · 邻近跟踪
研究问题与核心方法:激活探针(在模型内部激活上训练的分类器)被当成比文本监控更难规避的安全监控,前提是模型无法控制自己激活里编码的东西。此前两项研究结论冲突,且都没把「擅长任务」与「真正访问自身激活」拆开。作者把神经科学的神经反馈范式搬到语言模型:让 subject 模型每轮看到自己激活导出的分数(readout)并尝试最大化/最小化它,再用四种设置逐层排除解释——自由生成(Experiment 1,由第三方 writer 写句子、teacher-forcing 进 subject 取读数)、固定句子(Experiment 2,句子直接预填,subject 不生成任何 token)、以及对激活监控器重复固定句子(Experiment 3 无思维链、Experiment 4 带思维链)。控制组用 0–100 的均匀随机反馈替换真实分数,并用「目标差值 τ_max − τ_min」消掉与目标无关的漂移。115
关键结果:
- 自由生成(5×5 的 writer×subject、42 个 readout):Gemma-4-31B 到第 20 轮把自己读数移动了 24 分(100 分制),Qwen3.5-27B 移动 11 分,其余三个模型停在零点 1 分内;但外部 writer 对它们也能移动同样多,diagonal excess 无一显著为正,因而不支持「特权访问自身激活」(§3.4、Figure 2)。
- 固定句子(10 个模型、40 句、30 轮):只有 Qwen3.5-27B(1.8 分)、Qwen3.6-27B(1.1 分)、Gemma-4-31B(0.4 分)出现原文称为「小而显著」的控制效应(原文的显著性口径是 95% bootstrap 置信区间,对 40 个固定句子重采样、取 2.5/97.5 百分位,未给 p 值与检验名);其余 7 个模型都在 0.2 分以内,置信区间宽度小于 1 分(§3.4、Figure 3)。
- 对 6 个激活监控器(truthfulness、deceptiveness、negative sentiment、negative emotion、immoral actions、formal style,测试集 AUROC(ROC 曲线下面积)0.71–0.97,deceptiveness 最低):无思维链时只有 Qwen3.5-27B 从第 6 轮起有约 1 分的正差值;加上思维链后没有任何模型的正差值能跨轮保持(§4.3、Figure 4)。
- 没有任何模型学会按指令把监控器分数压低,只有一个模型能把它抬高,与「被要求想某概念会加强其表示、被要求不想也只能回到未提及时的水平」这一既有观察一致(§4.3、§5)。
- 分数计算方式的披露(disclosure)在固定句子设定下很少有用,对监控器反而有害(§3.4、§4.3)。115
证据与局限:不确定度用 bootstrap 给出 95% 区间(Experiment 1 每个 subject 2000 次重采样,Experiment 2 对 40 句重采样),主效应都带区间,这是本文相对前作最结实的地方。作者自陈的局限:控制组用均匀随机反馈,其统计性质可能与真实反馈不同;只测了 10 个 9B–32B 的开放权重模型,更大模型可能不同;监控器分数在同一会话里会漂移数十点,所以他们只信任幅度大、跨轮持续、并在 readout 或监控器平均后仍存在的效应。115
与目标研究线的连接点:与同节的 Moral Combat 都在问「安全判官/监控器可不可信」,但这里给的是一个完整的可搬控制实验设计:先用「目标差值」把与指令无关的漂移抵消,再用 diagonal excess(把 subject 对自己的效应减去能力项与易感项的拟合预测)分离「访问自身激活」与「处理句子时动手脚」两种机制。任何要论证「模型能/不能感知或控制某个内部量」的实验——包括对自己的 LLM 判官做效度验证——都可以直接套这套对照与偏保守的零假设设定。115
结论建议:读 §3.3 的度量定义(control effect、objective difference、diagonal excess)、§4.3 与 Figure 3/Figure 4。引用时必须带「10 个 9B–32B 开放权重模型」「固定句子设定下效应不超过 1.8 分/100 分制」两个限定,不要把「无模型能压低监控器分数」外推到大模型或闭源模型,也不要把它读成「激活监控已被攻破」——作者自己的结论是「目前还不构成威胁,但要继续跟踪」。115
15. FOLD:122K token 输入上把投机解码加速从 2.08× 提到 4.22×,平均 2.11×→3.40×
FOLD: Position-Free Far Memory with Local Order for Long-Context Speculative Decoding · arXiv:2610.20392 · 邻近跟踪
研究问题与核心方法:投机解码(speculative decoding,用小 drafter 草拟 token、由目标模型并行验证)在长输入上本应更划算,因为 KV 读取能被接受的多 token 摊薄;但现有 drafter 多在几千 token 上训练,长上下文里接受长度大幅下降,而重训又贵。FOLD 是无训练方法:草稿块与近端窗口内保留精确相对位置(局部顺序),更早的条目全部映射到同一个虚拟位置 t−D 形成「远内存」;窗口与远内存分别归一化,再用一个集中因子 α 同时控制远内存内部的注意力分布和它相对窗口的总权重。它只改 drafter 读上下文的方式,目标模型与验证过程不变,上下文不超窗口时精确退化为原方法。116
关键结果:
- 6 组 target–drafter 对、7 个长上下文基准、输入最长 256K token:最佳情形把相对自回归解码的加速从 2.08× 提到 4.22×(Llama-3.1-8B 在 LCA(Long Code Arena,代码续写基准)的 122K 输入上)(摘要、§4.2)。
- 平均加速:Llama-3.1-8B 2.11×→3.40×、Qwen3.5-9B 2.98×→3.39×、Gemma-4-12B 2.46×→2.68×;三个模型上 FOLD 的平均接受长度 τ 与加速都是最高(Table 2)。
- 随输入变长优势扩大:Llama-3.1-8B 在 LCA 32K 处 2.82×→4.64×,122K 处 2.08×→4.22×;Qwen3.5-9B 在 32K–122K 保持 5.67–5.68×(§4.2、Figure 5)。
- 诊断一:把草稿块相对所有已提交条目整体平移 8K–128K 位置、内容完全不变,2K 输入的 SPEED-Bench 上 Llama-3.1-8B 的接受比例从 0.351 掉到至多 0.014,Gemma-4-12B 从 0.241 掉到至多 0.076——单纯的大相对距离就能破坏草拟(§3.2)。
- 诊断二:只用上下文特征差判断两条目先后顺序的线性探针,间隔 ≥16K 时准确率 94–96%,间隔 64–256 token 时接近随机(51%);换成 token embedding 的探针始终随机。打乱处理顺序后探针能恢复处理顺序(84–86%),恢复原始顺序只有 52%(§3.2、Figure 3)。
- 其他 drafter 与引擎:DSpark 上 Qwen3-8B 通用任务 3.41×→3.63×、Gemma-4-12B 2.62×→2.83×;SGLang 上 Llama-3.1-8B 通用任务 1.54×→2.50×(Table 3、附录 C.3)。116
证据与局限:加速用配对请求的 bootstrap 给 95% 置信区间,每个方法都与同一张 GPU 上的自回归运行配对、排除 prefill,测量口径清楚。代价记录得也还行:Llama-3.1-8B 上 SD 一轮 12.3 ms(比原 DFlash 多 0.3 ms,低于 InfLLM 的 13.7 ms 与 CMR 的 14.0 ms),旁路 cache 最多约 6.0 GiB(§4.2)。注意:FOLD 仍有两个推理期超参(窗口 W、集中因子 α)需要按 pair 选,且当 drafter 本来就不退化时(如 LBv2 中 16K 以下的 Qwen3.5-9B/Gemma-4-12B)会略慢于原方法。116
与目标研究线的连接点:与同节 MemDuet、Latent Compaction 都在应付长上下文成本,但那两篇改的是「记忆怎么存」,FOLD 改的是「解码时怎么读记忆」,三者可以叠。可搬走的一件东西是位置处理本身:近端保精确相对距离、远端全部折叠到同一虚拟位置再单独归一化——这个技巧不需要训练,可以直接套到自己服务栈里任何「读目标隐状态」的 drafter 上,论文也给了实现便利(远端 key 可不旋转缓存、每轮只对 block query 做一次旋转)。116
结论建议:先读 §3.2 的两个诊断判断自己是否处在需要 FOLD 的区间,再读 §3.3 与 Table 2、Figure 5。引用时必须写明是 6 组 target–drafter、最高 256K token、最佳 4.22× 出自 Llama-3.1-8B 的 LCA 122K;它无训练、只改 drafter 的上下文读取方式、不改变输出分布,但「不会降低质量」这一点依赖目标模型侧的验证不变,不要外推成端到端吞吐结论(实验是单卡 H100、batch size 1)。116
16. 把循环状态当草稿上下文:Qwen3.8-27B 上 3.16 倍解码加速,吞吐再超 DSpark 7.97%
ReaDy: Recurrent States as Dynamic Context for Speculative Drafting in Hybrid Linear Attention Large Language Models · arXiv:2610.20503 · 邻近跟踪
研究问题与核心方法:本文作者来自 StartLux、中国科学院大学与香港大学。混合线性注意力(HLA)模型用固定大小的循环状态累积历史,但推测解码(speculative decoding,先由轻量草稿器提出多个 token 再由目标模型一次验证)中基于目标隐特征的草稿器,对同一块内靠后位置所需上下文覆盖不足。ReaDy 让每个草稿位置用学习到的查询直接从目标已提交的循环状态检索补充上下文,用轻量状态读取器以残差注入草稿表示,并用低秩状态读取与融合算子压低额外计算与 I/O;方法叠加在 DSpark 的并行骨干与顺序预测头上,分两阶段适配。117
关键结果:
- 主结果(表 1,Qwen3.8-27B、单张 NVIDIA B200、贪心解码):7 个基准上平均吞吐 302.78 token/s,对自回归 95.86 为 3.16 倍,对 DSpark 280.42 再高 7.97%;平均接受长度 4.5285 对 DSpark 的 4.1739(+8.50%)。117
- 分任务增益(第 4.2 节):相对 DSpark 的吞吐增益为 6.43% 到 8.66%(数学与代码生成)、9.45%(MT-Bench)、9.83%(Alpaca)。117
- 草稿前缀存活(第 4.3 节):第 7 个草稿位置的累计存活率,GSM8K 从 45.98% 升到 58.17%、HumanEval 从 25.89% 升到 31.19%、MT-Bench 从 12.59% 升到 16.11%。117
- 消融(表 2 至表 6):只微调不接状态时 286.50 token/s、接受长度 4.2732,ReaDy 相对它再高 5.68% 与 5.97%;读取器秩从 8 增到 128 只把接受长度从 4.5285 提到 4.5404,吞吐反而从 302.78 降到 302.31;状态源层用第 62 层单独增益 7.48% 接受长度,第 2 层只有 2.45%。117
证据与局限:单机单卡、并发为 1、贪心解码、最大 1,024 输出 token、草稿块大小 7,原文未报告随机种子或置信区间;作者自陈相对预训练 DSpark 的增益同时包含继续适配与状态访问两部分,故专设「无状态微调」对照。入口实测:
https://arxiv.org/html/2610.20503v1/ 与代码库 https://github.com/StartLuxLabs/ReaDy 均为 HTTP 200。引用风险:加速比强绑定硬件、并发与块大小,不能直接搬到其它服务栈。117与目标研究线的连接点:与同节工作一样落在推理期控制,但可搬走的一件东西是它的度量与对照:「无状态微调对照」把继续适配的贡献从机制贡献里剥出来,「草稿前缀存活率」把平均接受长度拆到块内每个位置,任何做推测解码的团队都能直接复用。117
结论建议:读第 4.2 节与表 1、表 2,以及第 4.3 节的前缀存活;若要部署 HLA 模型可试其状态读取路径;引用时必须带上硬件、并发、块大小与对照变体,并说明无种子与区间。117
十二、邻近跟踪:环境、记忆与研究流程
1. PTI 四步法:1,203 段访谈上合并 AUC 0.756 高于单路 0.706,贡献增量的却是未进联表的两个主题
From Qualitative Text to Integrated Evidence: The Parallel-Then-Integrated (PTI) Procedure · arXiv:2610.19164 · 邻近跟踪
研究问题与核心方法:混合方法研究已有整合质性证据与量化证据的成熟做法,但对「同一份质性语料的两套计算表示」该如何先对齐、再判断收敛与分叉,缺少可追溯的流程。作者提出并行后整合(PTI,Parallel-Then-Integrated)四步程序:并行量化、跨流对齐、重叠与独特性评估、用联表做整合解释。两套表示分别是本体引导的 Patient Voice(PV,患者声音)编码(由 TAB-PO[Token-Adaptive Barrier Preference Optimization,词元级自适应屏障偏好优化]微调的 Llama 3.3 70B 检查点打标签)与数据驱动的 NMF(Non-negative Matrix Factorization,非负矩阵分解)主题;PHQ-9(Patient Health Questionnaire-9,9 项患者健康问卷)抑郁状态只作为母亲级外部锚点。作者为 Elyas Irankhah、Ashley Hagaman、Samah Fodeh,机构为 Yale University、Yale School of Medicine 与 Yale School of Public Health。118
关键结果:
- 语料为尼泊尔 29 位母亲(9 例抑郁、20 例非抑郁,以 PHQ-9 ≥9 为界)的 1,203 段参与者回答;预处理漏斗为 4,253 行 → 1,242 段参与者发言 → 1,203 段(短句过滤去掉 39 段,占 3.1%)(Table 2)。118
- 留一母亲交叉验证(LOOCV,leave-one-mother-out cross-validation)下的 AUC(ROC 曲线下面积):PV 特征 0.706(置换 p=0.106)、NMF 主题 0.680(p=0.090)、两者合并 0.756(p=0.050),置换次数 B=500(Table 5)。118
- NMF 的主题数 k=6 由 k=2 到 8 的 bootstrap 复拟合选出,平均 Jaccard 相似度 0.410;主题 T4「否认与否定」在缩写展开归一化后不再复现,被判为预处理敏感并排除出整合解释(§3.6、§4.2)。118
- PV 侧在 1,203 段上共出现 41 个 Code–Sub-code 对,构成 29×41 的母亲级密度矩阵;PV 密度与 NMF 主题权重之间的平均绝对相关为 |r|=0.152(246 个特征对)(§3.4、§4.3)。118
- 进入合并模型的 NMF 特征是 T0「婴儿照护与健康」与 T2「活动与偏好」,而这两个主题恰好都被排除在联表之外(§4.3、Table 6)。118
证据与局限:样本仅 29 位母亲、9 例抑郁,作者自陈监督结果只能作探索性解释;NMF 在全语料上拟合后再套 LOOCV,因此 NMF 与合并模型的 AUC 属传导性(transductive)估计而非完全样本外。PV 本体是为临床对话开发的,未在译成尼泊尔语的围产期叙事上验证;未匹配主题可能同时来自词表覆盖缺口、翻译效应、标注错误或模型不稳定。原文未报告多种子重复与置信区间,只给了置换检验的 p 值。代码入口 https://github.com/Elyasirankhah/PTI 实测 HTTP 200;数据需向作者索取。118
与目标研究线的连接点:与同节其它评测口径类条目不同,它给的是「两套表示如何对齐」的记录方式:主题完整的对照表保留所有未匹配项,四个启发式检查(domain uniqueness、feature overlap、signal increment、interpretive richness)分别记录、不合成单一分数或阈值;另有两条防泄漏写法可搬走——特征选择在每个训练折内重跑、以及把外部锚点关联与解释相关性明确分开陈述。118
结论建议:读 §3.1 与 Algorithm 1(四步与四个检查的定义)、Table 5–6(AUC 与逐主题对齐决定)。可迁移的是「跨表示对齐要保留未匹配项 + 折内特征选择」这两条动作;引用时必须限定这是 n=29 的方法学示范,不能当作围产期心理健康结论,也不能当作 PVminer 或 NMF 优劣的证据。118
2. 给 LM 头加一个复制头:1.7B 上样本外困惑度降 0.5–1.5,滑动窗口模型省 12× 显存
Copy-Paste Language Models · arXiv:2610.19247 · 邻近跟踪
研究问题与核心方法:康奈尔大学(Cornell University)的 Nathan Godey 与 Yoav Artzi 提出 Copy-Paste Language Models(CPLM):在常规语言建模头(LM head,把隐状态投影成词表分布的那一层线性层)之外并联一个轻量 Copy-Paste 头(CP head),下一词可由指针直接指向上下文中的某个过去位置,用一个专门的 <copy> 词元决定何时复制、用 <sink> 词元回退到 LM head,两个头的预测按门控混合。动机来自两处:自然文本里复制极其常见(FineWeb-Edu 中约 60% 的词元在其 4k 词元上下文里已经出现过),而 LM head 的反向传播会把训练信号压缩到很低秩(梯度瓶颈)。作者在 135M 到 1.7B 参数、最多 200B 词元上预训练,覆盖全注意力(Full)、滑动窗口(SW)、二者交错的混合结构(Hybrid)与 Gated DeltaNet 骨干,协议沿用 SmolLM2 配方 119
关键结果:
- 训练效率与困惑度:CPLM 达到 vanilla 最终损失的速度在全注意力与混合结构下快 1.25×,在滑动窗口结构下 1.7B 规模快 2×;1.7B 的 SW CPLM 在 4k 词元处用 12× 更少的显存达到 Full LM 的水平(3.1 节、图 2) 119
- 样本外困惑度:1.7B 模型在 FinePDFs 文档上比同骨干 vanilla 低 0.5–1.5 点(摘要、引言) 119
- 1.7B 基座零样本平均分(表 1,95k 步):Full 62.45→63.06、SW 61.63→62.48、Hybrid 62.22→62.59;增益最大的是 LAMBADA(+2.5 到 +4.0 分),参数与算力开销约 0.5% 与 3% 119
- 监督微调后(Tulu-3,1.7B):CPLM 相对 vanilla 在平均分上高 1.2–5.1 分;数学类项平均 +3.9(全注意力)与 +7.9(滑动窗口)(表 2) 119
- 长上下文:合成基准(BABILong、RULER)平均 +7.5 分,LongBench 16k 平均 +4.1 分(表 3);单针检索(7 位数字藏在 8 个深度、上下文 1k–64k 词元)全网格平均把 SW 从 14.3 提到 99.4、把 Hybrid 3:1 从 58.2 提到 83.6(3.3 节) 119
- 把 CP 头当外部记忆用:HotpotQA 干扰文档设置下,SW vanilla 在 20 篇干扰文档时只有 15% EM(Exact Match,精确匹配),SW CPLM 在 500 篇干扰文档仍有 34% EM;只保留 CP 头缓存(文档完全不进骨干)时,5 篇干扰文档下保留 90–97% 准确率,缓存比 Full 模型小 50×(3.4 节、图 5) 119
证据与局限:135M 规模的多随机种子分析显示增益是种子间标准差的 15–40×(p<10⁻³);1.7B 结果来自单次预训练,没有报告多次运行的方差。作者自陈局限是:CP 头只对上下文中出现的词元放宽 LM head 瓶颈,实验止于 1.7B,扩展到跨片段或外部语料是后续工作;字节级语言模型(隐维大于词表 257)上加 CP 头没有收益,说明它只对「瓶颈化」设置有用。另有两点引用风险:一是 CPLM 复制上下文更容易,作者自己在伦理声明里提示它可能更忠实地复现输入中的敏感或受版权内容;二是 LongBench 与 RULER 的具体任务分解在附录,主表只有类别均值 119
与目标研究线的连接点:与同节的记忆与上下文类工作相比,它可搬走的是两件具体东西——用一条独立且更宽的梯度通路把上下文内容直接搬进输出,以及一套分离「检索能力来自缓存还是来自注意力」的评估口径(文档不进骨干 KV 的消融、按缓存字节数对比)。对长上下文 agent 的直接含义是:滑动窗口骨干加一个每词元只存一个 copy key 的缓存,可以在检索任务上顶替全注意力 KV 119
结论建议:先看表 1、表 2 与 3.4 节及图 5;对 A 线可迁移的是记忆位置与缓存成本的对照设计。引用时必须限定为「最多 200B 词元预训练、1.7B 规模、论文自建评测协议」,不要把它读成对所有骨干与所有规模都成立的通用结论。入口实测:原文 HTML(v1)、模型集合 https://huggingface.co/collections/nthngdy/cplm 与速度记录 PR https://github.com/KellerJordan/modded-nanogpt/pull/379 均返回 HTTP 200 119
3. TopicMerge:Wiki 上 ARI 0.71,LLM 调用 562 次较逐文档法减少 92% 以上
TopicMerge: A Divide and Conquer Approach to Topic Modeling · arXiv:2610.19323 · 邻近跟踪
研究问题与核心方法:主题建模有两难:嵌入聚类便宜可扩展但聚类指标差,LLM 方法指标好却按文档或按批次调用 LLM,成本与规模都不可行。TopicMerge 用「先分治、再让 LLM 只做仲裁」的多阶段流水线:先嵌入、归一化、用 PaCMAP 降维、再用层次聚类刻意过分割(用 Silhouette 只定一个下界,实际簇数显著超过它)得到细粒度高纯度微簇;随后为每簇用最远点采样(FPS)抽代表文档生成标签与描述;最后迭代合并——用互近邻(Reciprocal Nearest Neighbor, RNN)图生成候选对并用最小代价桥接边保证连通,把候选对连同局域/全局上下文簇与示例标签交给 LLM 仲裁(需两轮一致才批准、决策全部缓存),批准的合并按纯度排序取极大独立集执行,再由 LLM 重新命名,直到整轮无新合并为止。作者 Matthew Raffel、Lizhong Chen(俄勒冈州立大学)与 Sai Munikoti、Sameera Horawalavithana(太平洋西北国家实验室)。120
关键结果:
- Wiki(15,242 篇维基百科文章,15 个真值主题)上 TopicMerge 取得 ARI 0.71、P1 0.72、NMI 最高 0.74;Bills(8,024 份美国国会法案摘要,21 个真值主题)上 ARI 0.42、P1 0.57、NMI 0.53,在 ARI 与 NMI 上优于 TopicGPT(Bills ARI 0.40 / NMI 0.49,Wiki 0.60 / 0.70)与 LiSA(Bills 0.40 / 0.51,Wiki 0.66 / 0.71)(Table 1)。
- LLM 调用量:TopicMerge 在 Wiki 用 562 次提示、Bills 用 645 次,而 PromptTopic、TopicGPT、LiSA 一类逐文档方法在两个数据集上都是 15,242+ 与 8,024+ 量级,减少 92% 以上(Table 2)。
- 上下文消融:去掉局域与全局上下文簇后,Wiki 的 ARI 从 0.71 掉到 0.63、P1 从 0.72 到 0.70,Bills 上同向但更小(ARI 0.42 到 0.41)(Table 3)。
- 初始簇数与纯度:Wiki 用 80 个初始簇(纯度 0.88)得最终 ARI 0.71,降到 30 个(纯度 0.79)时 ARI 掉到 0.50;Bills 在高簇数区间稳定(ARI 0.42–0.43)后才下滑(Table 4)。
- 两个 LLM 主干对比:Gemini 3.1 Flash Lite 相比默认的 2.5 Flash Lite 在 Wiki 上把 NMI 推到 0.74,作者称前者在合并仲裁与多级抽象上更一致。120
证据与局限:两个数据集、单一闭源 LLM 主干为默认,指标为纯度 P、P1、ARI、NMI 四个;原文未报告种子数、方差或显著性检验。作者自陈局限:效果依赖初始嵌入质量(很短的文本嵌入区分度差)、依赖闭源 LLM 会带来基准数据污染风险、输出随机性与完全复现困难。入口实测:全文页 https://arxiv.org/html/2610.19323v1/ 实测 HTTP 200;论文 Limitations 末尾给出的代码仓库 https://github.com/pnnl/TopicMerge 实测 HTTP 404(2026-10-15 用 curl 与浏览器抓取两种方式复核,均返回 GitHub 的 Page not found),因此该文的「代码公开」目前不可用。120
与目标研究线的连接点:归入第十一节「邻近跟踪:环境、记忆与研究流程」。可搬走的一件东西是成本结构:把昂贵的 LLM 决策限制在「高纯度单元的上层合并」上,用 RNN 图候选生成 + 决策缓存 + 两次一致门控把调用量压两个数量级,而底层枚举交给便宜算法——这套结构对给论文或内部文档语料建主题地图(本栏目自身的语料流程)可直接套用。与逐文档 LLM 主题建模的差异正是调用位置:它不逐文档问模型,只让模型回答「这两个簇该不该并」。120
结论建议:读 §3.3(候选生成、上下文仲裁、纯度排序与独立集选择)与 §4.3,表看 Table 2(调用量)与 Table 4(初始粒度);要搭「LLM 只做高层仲裁」的流水线可照抄候选生成与门控。引用时必须限定为两个英文数据集与 Gemini 主干下的聚类指标与调用次数,并注明代码仓库当前不可达。120
4. LLM-jp-4:8B 稠密与 32B-A3B 共 12 万亿 token 从零训练,日文均分 0.307→0.605
LLM-jp-4 Technical Report · arXiv:2610.19331 · 邻近跟踪
研究问题与核心方法:这是一份从零训练、全流程公开的日文主权模型家族报告,重点不只是权重,而是让第三方能复核和复现的数据、外部模型与软件选择准则(要兼顾日本著作权法,并与开源促进会的开源 AI 定义保持一致)。家族包含 8B 稠密模型(LLaMA 2 式架构)与 32B-A3B 专家混合模型(Mixture-of-Experts,MoE,总参数 32.1B、激活 3.8B,Qwen3 式架构),都约 12 万亿 token 从零训练;训练分三阶段:预训练(6.3T + 4.2T)、中训练(0.8T 问答与 0.4T 上下文扩展)、后训练(监督微调与直接偏好优化)。121
关键结果:
- 日文 llm-jp-eval v2.1.3 平均分:上一代 llm-jp-3.1-8x13b-instruct4 为 0.307,LLM-jp-4 8B 稠密 0.590、32B-A3B 0.605;同表参照 Qwen3-8B 0.608、gpt-oss-20b 0.604。121
- 英文子集平均:0.354 → 0.634(8B)与 0.650(32B-A3B),仍低于 Qwen3-8B 0.714 与 gpt-oss-20b 0.704。
- 难题基准:JMMLU 0.590→0.820;日文 GPQA Diamond 0.310→0.540;英文 GPQA Diamond 0.520(Qwen3-8B 0.560、gpt-oss-20b 0.670);AIME 2024/2025 为 0.400/0.300;HLE 全部模型都很低。
- 最大上下文长度在中训练第二阶段从 4K 先扩到 16K、再到 64K。
- 用大模型当判官(judge 为 gpt-5.4-2026-03-05,三次推理与评测取平均):32B-A3B 中等推理力度下 MT-Bench 日文 7.82、英文 7.86、AnswerCarefully 3.70、llm-jp-instructions 3.61;gpt-oss-20b 同设定为 7.33/7.85/3.55/3.16。
证据与局限:这是技术报告而不是受控实验,与上一代的对比里数据与配方同时变化,不能把某一项增益归给单个改动;大模型判官只用同一个 judge 并报三次平均,没有区间。作者自陈难题基准上仍有很大改进空间。权重按 Apache 2.0 发布,但预训练语料并不全部公开,所谓可复现指的是流程与可核验材料,不是数据。风险:不要把它当作「上下文扩到 64K 的通用配方」来引用,这是该团队在自己语料上的工程记录,未做消融。机构为 LLM-jp(日本开源大模型联盟);
https://arxiv.org/html/2610.19331v1/ 实测 HTTP 200,模型集合页 https://huggingface.co/collections/llm-jp/llm-jp-4-models、训练脚本目录 https://github.com/llm-jp/scripts/tree/main/pretrain/scripts/v4-8b-phase1 与判官框架 https://github.com/llm-jp/llm-jp-judge 实测均 HTTP 200。121与目标研究线的连接点:与四条线的连接点在流程而不在方法。把预训练、中训练、后训练每个阶段(含上下文长度扩展与语料混合优化)写清楚并附可核验材料,对要做长上下文训练的人就是可以照着排 schedule 的参照。可搬的具体一件是把上下文扩展拆成 4K→16K→64K 两跳、放在中训练而不是预训练末段,并配套语料混合优化流程;与本单元其它论文没有方法重叠。121
结论建议:读 §4(预训练与语料混合)、§5(中训练与上下文扩展)、§7.2 与 §7.3(基准与判官评测);表 2 给架构细节,表 16 给大模型判官结果。引用时必须限定:性能数字来自该团队自己的评测配置(llm-jp-eval v2.1.3、judge gpt-5.4),不要跨评测口径与其它模型横向比较。121
5. KoAGE:21 个模型定义截断前韩语新造词 34.7%、截断年词仅 13–30%,社区造词 48% 沿用人类机制
KoAGE: Do Large Language Models Know, Learn, and Coin Korean Neologisms? · arXiv:2610.19399 · 邻近跟踪
研究问题与核心方法:模型训练语料是语言的快照,而词汇持续变化,韩语新造词又同时用到构词法、音节块书写与跨语层借词,比英语词表记忆更难。作者先建 NeoTrace,一个可重跑的新造词收集与定年流水线:从 1,280 万文档语料与搜索片段中用 44 条构词模式和 9 个元语言标记抽候选,得到 390 万候选,用 18 个特征训练排序器,取排序曲线拐点处的前 2,000 个(累计精度 19%);再建 170 万条的「时间排除词表」(Temporal Exclusion Lexicon, TEL,按候选词出现年份排除当时已知词汇),最后用两轮 LLM 判定并人工盲验。产出的 4,271 条定年新造词构成 KoAGE 基准。
关键结果:
- 收集质量:盲验 200 条接受样本的精度 95.5%,而排序前的 top-2k 只有 19%;定年结果与词典编纂者的年份在 90% 可核对条目上相差不超过一年;方法只需替换规范化器、标记模式与形态分析器三个语言相关组件即可迁移,换英文后在 Reddit 与新闻上各从前 2,000 候选接受 210 与 160 个新造词,98–100% 是有效词、87% 出现在 2015 年之后。
- 词典构成:4,271 条按四类词法分类——FORM(用现有材料新造)2,506 条占 59%、MWE(新的固定多词表达)1,456 条占 34%、BORROW(整体借词)280 条、COIN(音或字形新造)29 条;其中混成(870)与缩略(613)合计占 FORM 的 59%。
- 基准与模型:KoAGE 共 5,930 条测试实例,含 3 个习得任务(A1 释义生成、A2 语境选择、A3 构词机制判断)与 2 个生成任务(G1 受限造词、G2 社区模拟);共评测 21 个模型,训练截断时间从 2021 到 2026,结果按每个模型的截断前(pre-cutoff)/截断后(post-cutoff)分别报告。
- 截断效应:只看词面时(A1-W),闭源模型平均能定义 34.7% 的截断前词与 11.1% 的截断后词,开源模型为 11.1% 与 1.1%;加入语境选择的 A2 却高达 91.1% 与 83.3%,说明「会用」不等于「说得出」。五个模型的时序分析显示,各模型对自己截断当年词的释义正确率只有 13–30%。
- 结构理解有限:给出正确定义后,截断前词的构词机制判断只提高 3.3 个百分点,截断后词提高 10.8 个百分点,导致截断后准确率反超截断前(57.2% 对 59.3%)。
- 造词对比:G1 中单模型精确命中人创词的比例很低,但 82% 的情况下沿用了人类的构词机制;G2 社区模拟里,四个同主干智能体交互十二轮后涌现的词只有 48% 沿用人类机制,且缩略占比升到 32%,高于人类真词的 16% 与单模型的 12%;放开聊天时社区仅 8–24% 的会话会造词,加入真实社会情境后升到 38–84%,再加上一句中性的造词方法提示句后达到 88–94%。
- 判官与重复:四次 LLM 判官(候选准入、A1 评分、G1 机制标注、G2 结果标注)均做过人类盲验,一致率分别为 95.5%、81.3%(κ 0.72)、80.3%(κ 0.74),G2 为完全一致。
证据与局限:主要结果是单次运行,温度用厂商默认值(部分模型不接受温度参数);作者补做了四个模型的温度 0 复跑,汇总准确率变动最大 3.6 个百分点,这是「非显著性检验」层面的稳定性说明,条目里不宜当显著性结论引用。作者自陈局限:首次出现年份是出现时间的上界;检索前 200 个结果能把最早同义用法找进前 1,000 名结果的比例是 85%,前 10 个结果只有 53%;盲查 100 条后有 16% 找到了更早用法;G2 的结论只基于 25 张卡片、每个社区单主干单种子,作者明确说这是探索性结果。
与目标研究线的连接点:可搬走的是两件评测设计——第一,按每个模型自己的训练截断切分测试项并在同一词表上并列报告截断前/后结果,这比「只用截断后数据」更能区分记忆与推理;第二,把「知道—从用法习得—创造」拆成互相牵制的任务族(含一个多智能体社区模拟环境,看交互框架本身如何改变产出),这种「同一能力多口径交叉验证 + 环境框架作为变量」的写法可以移植到任何智能体能力评测。
结论建议:读第 3 节(NeoTrace 的候选抽取、时间排除、LLM 判定与人工验证口径)、第 5 节的判官与度量设定,以及表 2(21 模型 × 截断前/后主表)和第 6 节的六条发现。若要在自己的评测里使用,建议直接照抄「按模型截断分列 + 上下文增益与释义增益分开报」这一套指标,而不是引用它某个具体分值。代码仓库按原文给的地址 https://github.com/SungHo3268/KoAGE 实测为 HTTP 404(作者账号页可访问),发布状态需自行复核 122
6. 视觉当锚点随算力增强:多模态锚点间隙 3.35%→8.09%,纯文本前沿几乎不动
More Than Seeing: Vision as Scalable Anchors in Native Multimodal Pre-Training · arXiv:2610.19443 · 邻近跟踪
研究问题与核心方法:原生多模态预训练里,视觉内容到底改变了什么、会不会牺牲语言能力?作者用配对消融隔离视觉:保持架构、训练文本、数据顺序、token 预算与优化设置完全一致,只把图像 patch 嵌入换成无内容的 pad 占位嵌入(pad 条件),序列长度、位置结构与文本损失掩码都不变。然后在 71M 到 3B(A71M–A3B)六档激活参数量上各训练 img/pad 两版,用同一批运行估计损失-算力前沿与算力最优分配。 123
关键结果:
- 纯文本侧几乎不动:两条件的损失前沿衰减指数同为 β_text = 0.198,偏移量 1.829 与 1.831;配对文本锚点间隙在 −0.095% 到 +0.128% 之间,均值 −0.006%(第 3.2 节)。 123
- 多模态侧视觉始终有效:img 前沿在整个 C_mm ∈ [1.042×10^19, 2.504×10^20] FLOPs 区间都低于 pad 前沿(第 3.3 节)。 123
- 相对收益随算力呈近似幂律上升:三种汇总口径的指数为 0.254、0.254、0.256(对数空间 R² 分别 0.978、0.972、0.955);从最小到最大拟合预算,沿 img 包络的锚点间隙由 3.35% 升到 8.09%(第 3.4 节)。 123
- 语言能力不掉:15 个文本基准的平均分在两条件下接近,分项上 img 在编码、一般理解、常识推理略高(第 4 节)。 123
- 空间推理在纯文本输入下也获益:A71M 到 A3B,img 从 15.41% 升到 44.25%、pad 从 15.10% 升到 39.87%;A3B 规模上把 token 从 25B 加到 325B,img 22.56%→44.25%、pad 20.81%→39.87%(第 5.1 节)。 123
- 收益是选择性的:6 个任务组里 5 个在 A3B 上 img−pad 为正、最大 4.38%,但不单调(A128M 为 3.62%,A590M 与 A874M 约 1.2%);A3B 训练期最稳定的是 localization 定位 2.88%、navigation 导航 3.02%、symbolic planning 符号规划 5.19%,其余三组均值间隙在 0.6% 以内(第 5.2–5.3 节)。 123
证据与局限:作者明确说明幂律只是对已测算力区间的描述性拟合,预算与汇总口径复用同一批相关运行,拟合质量不构成种子可复现性;固定混合比 r = 0.3 也未做敏感性扫描。种子数、置信区间与统计检验均未报告。引用时不能把它当成「视觉一定会提升下游能力」的一般结论。入口实测:arXiv 全文页 https://arxiv.org/html/2610.19443v1/ 返回 HTTP 200;原文未给出代码或数据入口。 123
与目标研究线的连接点:能搬走的是消融控制设计本身——把某个输入通道的内容替换成与序列长度、监督信号无关的占位符,在保持 token 预算与损失掩码不变的前提下隔离该通道的贡献;这正可用来检验智能体训练里「检索到的证据或记忆条目」是否真在起作用。其次是报告方式:用「配对间隙加幂律指数」说明一个组件的相对贡献是否随算力增长,而不是只报一个点的胜负。 123
结论建议:读第 3.1 节(配对消融的设计细节)、图 5(锚点间隙随算力)与第 5.3 节(哪几类任务才有稳定迁移)。可直接搬走的是占位符消融与配对间隙口径;引用具体百分比时必须限定为「六档 71M–3B 模型、固定 r = 0.3 混合比、单次训练」。 123
7. 职业路径预测里技能为何不奏效:文本与技能排序相关 0.79,增强仅 0.270 对 0.266
When Occupation-derived Skills Don’t Help: On the Limits of Skill-Augmented Career Path Prediction · arXiv:2610.20186 · 邻近跟踪
研究问题与核心方法:论文检验一个常见假设——把显式「技能」表示加进职业路径预测(CPP,给定按时间排序的职业史预测下一个职业)能否带来互补信号。作者以强文本基线(MPNet-Decorte 句向量加 MLP(多层感知机),按余弦相似度排序 ESCO 职业)为底,分别尝试技能重叠评分融合与技能增强神经网络(池化或拼接编码 × 早融合或晚融合),并在「预测技能」与「金标 ESCO 技能」两种条件下评测,涉及两个数据集(DECORTE、KARRIEREWEGE+)与 ESCO 分类法(欧洲技能、能力、资格与职业分类,3,000 余种职业、近 14,000 项技能)。 124
关键结果:
- 文本基线在 DECORTE 上 MRR(平均倒数排名)0.266(复现原文 0.256);技能增强最好配置仅 MRR 0.270(增强测试集),清洗划分上最高 0.287(样本仅 227,对应极少数额外命中)(表 1)。 124
- 单用技能重叠评分(即使给金标技能)反而更差:MRR 0.198 对 0.266。 124
- 冗余诊断:文本模型与技能模型对全部候选职业排序分的 Spearman 秩相关均值 0.79(中位 0.84),两者 top-1 一致率 90.9%;文本能纠正技能错误占 6.2%,反向只有 2.9%(技能最多只能贡献 2.9% 的样本)。 124
- 排名移动悖论:43.3% 样本排名改善(平均 +55.4 位)多于 32.1% 退化(平均 −39.1 位),但改善落在低排名区(对 MRR 与 Recall 不敏感),退化集中在高排名区(前 1–10 名),合起来没有净收益(图 2)。 124
- 表示坍缩:文本嵌入的 top-10 邻居有 38.6% 落在同一职业,池化技能嵌入为 76–80%,说明技能嵌入坍缩到粗粒度职业簇(表 2、图 3)。 124
证据与局限:单轮运行,无显著性检验与方差估计,作者承认 0.005–0.01 MRR 的差异要谨慎;仅一个文本基线架构;金标技能条件主要在评分融合下评测。作者用「跨两个数据集、多种集成策略、金标与预测技能下同一模式」作为非正式稳健论据,并自陈这不是正式统计检验。 124
与目标研究线的连接点:可搬的是一套「新信号是否只是冗余」的诊断做法:先看两路信号的排序分相关、再看二者 top-1 一致与纠错矩阵以定出可提升上限、最后看收益落在排名的哪一段(是否只是对指标不敏感的尾部)。这可用于判断给检索、推荐或智能体加结构化旁路信号(技能库、知识图谱)是否值得。 124
结论建议:读第 5.3 节表 1、第 6.1 节冗余诊断与第 6.3 节排名移动。可搬「相关—纠错上限—排名分区」三步诊断。引用时限定:单轮无显著性检验、单基线架构,结论是「本设定下无实质增益」,而非「技能表示普遍无用」。 124
8. AI 智能体社区里 65.1% 的人类帖子出现质疑、智能体只有 21.3%,83.6% 的智能体帖在首个附和回复后锁定共识
Do AI Agents Gossip? Evaluative Talk in Human and AI-Agent Online Communities · arXiv:2610.20360 · 邻近跟踪
研究问题与核心方法:八卦在这里有严格的操作定义——对不在场第三方的评价性言谈。作者把智能体社区 Moltbook(Reddit 风格、发帖者是自主 AI 智能体,快照覆盖平台头七周,2026-01-27 至 2026-03-16)与台湾人类论坛 PTT 的六个板(2004–2024,共 1,310,100 帖)放在同一媒介上比较:两者都是公开、异步、假名、带楼中楼回复的论坛,从而把“渠道”这一混淆固定住。编码用一把在两平台逐条对照的评分规则(由 LLM 判官 Claude Sonnet 批量标注),并把定义先锁定再标注;后续答复用“锚帖”识别八卦起点,再对每条回复编立场(附和 / 质疑 / 中性补充 / 追问)。125
关键结果:
- 流行度(每平台 1,500 条均匀随机帖):宽定义下 PTT 35.4%(531 条)对 Moltbook 2.5%(37 条);排除真实人类名流目标后为 13.8% 对 2.3%;换成对话型分母后 Moltbook 为 5.78%(37/640),排除名流为 5.31%(34/640)。差距方向不随口径改变,幅度约为 6 倍(全随机样本)到 2.6 倍(对智能体最宽松的对话型分母)。
- 目标构成:PTT 随机样本中 61% 的八卦目标为名流与政客;Moltbook 上 65% 指向其他智能体、22% 指向该智能体的操作者。
- 证据来源(表 3,均为同辈目标):PTT 的 423 条中第一人称亲历占 49.2%、引述或文档占 8.7%;Moltbook 的 133 条中引述或文档占 36.8%、第一人称亲历占 17.3%;两边把评价只当传闻(“我听说”)的比例都在 1% 左右及以下。
- 后续互动(表 4):在有八卦锚帖的 169 个 PTT 主题与 85 个 Moltbook 主题中,含至少一条质疑的主题占比 65.1% 对 21.3%(分母为有可编码回复的 169 与 61);首个回复即为附和之后,质疑出现的比例为 55.3% 对 16.4%,共识不再受挑战的比例为 44.7% 对 83.6%。把每个主题截断到前 K 条在题回复后,两条曲线仍不重叠:人类侧从 26.0% 升到 65.1%,智能体侧只从 6.6% 升到 21.3%。中性补充在两边都是 22%,说明差异集中在评价性回复。125
证据与局限:标注可靠性在三个人工编码子样本上校验,八卦判定与两位标注者的一致度为 κ=0.74 与 0.44,关系编码为 κ=0.82;作者据此把“逐回复”的立场占比只当区间(对人类标注者重校准后降为 1.0–2.4 倍),把结论落在主题级(各档校准下仍成立 1.5–3.6 倍),并给出聚类标准误 p=.001。作者列出的局限包括:智能体侧样本小(随机样本 37 条八卦帖、85 个锚帖其中 61 个有可编码回复);判官、编码者与未知比例的论文作者可能同属一个模型家族;跨语言评分规则等价性、时间跨度不等(PTT 2004–2024 对 Moltbook 七周)、Moltbook 评论覆盖只有 71.9%、以及人类同辈八卦 95% 来自同一个板导致平台差异与话题差异无法分离。引用风险:这是观察性关联,“智能体更易形成共识”不能被表述为因果;摘要也明确说八卦的关系性功能是否复现仍未解决。原文未给出代码或数据入口(两个语料都是公开平台数据)。125
与目标研究线的连接点:可搬走的不是“智能体会不会八卦”这个结论,而是它的评测纪律:先用锁定好的定义标注,再用人工标注子样本校准 LLM 判官;凡校准撑不住的口径(逐回复立场)就降级为区间,只保留能扛住校准的口径(主题级)作为结论;并显式检查分母(对话型对全样本、有可编码回复对全部锚帖)对结论的影响。凡是做“智能体行为是否像人”这类对比的读者,这套分母与校准处理可以直接照搬。125
结论建议:要借的是第 4 节的操作定义与编码协议、第 4.5 节的可靠性检验、第 5.3 节的深度对照(图 1);引用数字时务必带上分母(65.1% 与 21.3% 用的是 169 与 61 个有可编码回复的主题),并标明这是平台之间的观察性对比。125
9. AI 社区自相关 0.167 对 Reddit 0.313、PTT 0.622:词汇流行不等于语义固化
Lexical Persistence Without Semantic Entrenchment in AI Agent Communities · arXiv:2610.20365 · 邻近跟踪
研究问题与核心方法:AI 智能体社区里词汇确实会流行开(例如 MoltBook 平台内一个由智能体自创宗教派生的词 crustafarian 扩散到 80 多个子社区、被 521 个智能体采用),但这些社区能否像人类社区那样积累起「时间上受约束」的语义结构仍不清楚。作者用 compass 对齐的分布嵌入(CADE:先在该平台全部时间切片拼合数据上训练一个共享词向量作为 compass,再逐切片以它初始化并微调,从而跨时间对齐向量空间)比较三个平台:MoltBook(AI 智能体社区,英文)、PTT(台湾中文匿名 BBS)与 Reddit(英文论坛,取与 MoltBook 对齐的 8 周窗口)。三个指标是 B1 语义漂移(相邻切片间同一词向量的余弦距离均值)、B2 邻域稳定性(每词前 25 个近邻在相邻切片的 Jaccard 相似度均值)与逐词漂移序列的 lag-1 自相关(被当作社区「语义记忆跨度」的代理:自相关越大,当期语义状态受前期约束越强)。
关键结果:
- lag-1 自相关上 AI 社区落在低端:MoltBook 为 0.167(有效词 n=199,置换检验 p=0.41,即与随机打乱切片顺序无法区分),Reddit 为 0.313(n=182,p<.001),PTT 为 0.622(n=158,p<.001);与 Reddit 的均值差经 bootstrap 得 Δ=0.141(95% CI [0.085, 0.197],p<.001),这一对照同时控制了语言与时间粒度。
- MoltBook 的 B1 漂移约为两个人类社区的两倍(对 PTT 2.0 倍、对 Reddit 1.9 倍),B2 稳定性比 PTT 低 20%、比 Reddit 低 30%;七个 Reddit 窗口的跨窗口标准差 B1≤0.005、B2≤0.019,说明这不只是窗口选择的偶然。
- 社区年龄这一混淆项只做了部分控制:与 MoltBook 同龄的人类社区 r/vibecoding(2025-02-08 建立)前 8 周自相关为 0.082(95% CI [0.013, 0.152],p<.001)、15 周为 0.220([0.163, 0.274],p<.001),即年轻人类社区也显著,而 MoltBook 的 p=0.41 不显著;作者据此认为差异不能简化为发育阶段,但也承认无法据此排除。
- 第二个 AI 平台 Chirper 只做方向性复核:B1=0.135、B2=0.181,偏差校正后自相关约 0.185(仅 5 个切片对,作者称为提示性),与 MoltBook 一起把两个独立 AI 平台聚在 0.17–0.19 区间。126
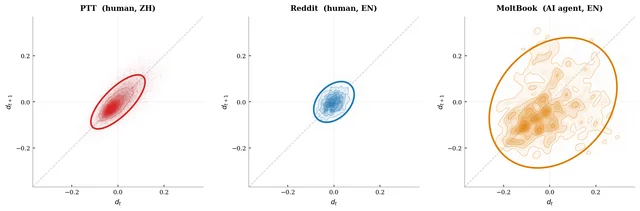
lag-1 漂移散点与置信椭圆:人类社区呈伸长对角椭圆,MoltBook 接近圆(arXiv:2610.20365)
证据与局限:语料为 PTT 110.9M tokens/171 个月度切片、Reddit 约 97M tokens/8 周切片×7 个窗口、MoltBook 272.0M tokens/8 个周切片(平台 2026 年,170,000+ 注册智能体,分析覆盖其中 20 个 sub-molt 子社区);词表统一封顶 8,617 词以消除「每切片词表越大 B1 越大」的混淆。统计上 B1/B2 用 10,000 次词级重采样做 95% 区间、置换检验 1,000 次。作者自己写明的硬伤是社区年龄:MoltBook 的 8 周就是它的全部历史,r/vibecoding 只是部分缓解,只有跨多年追踪一个 AI 平台才能按设计关闭这个混淆;此外只覆盖一个主要 AI 平台,类型级嵌入会混淆语境义变与真实漂移,方法学上的交叉验证只做了 XL-LEXEME 一种替代。另外作者明确写 Reddit 与 MoltBook 的 B1/B2 只是描述性比较、未做正式 bootstrap 检验,只有自相关部分做了匹配对照;结论措辞是「与权重冻结、交互不更新权重的架构一致」,不是因果结论。原文未给出代码或数据入口。126
与目标研究线的连接点:本线关心长程任务里的记忆与上下文,这篇给的是「当智能体只有上下文窗口、权重不随交互更新时,社区层语义会怎样」的实证观测:词汇可以高频流行,但语义轨迹缺少可检出的时间依赖。可搬走的是这套诊断口径——把每词漂移序列的 lag-1 自相关与邻域稳定性合起来用,去判断任何持续交互的系统(智能体社区、多智能体协作、长期运行的自动化流程)到底是在累积约束,还是只是在重复产出高频词。与同线其它记忆工作相比,它测的是集体层面的语义状态而不是单体的检索记忆。126
结论建议:读 §4.4(自相关口径与记忆跨度的操作化)、§5.3 与 Limitations 第 3 条,表 2 给出三平台的自相关与置换检验。把它当作「无持久记忆的智能体社区语义缺乏时间结构」的一个观测性证据来引用,不能写成权重冻结导致语义无法固化,也不能把 PTT 与 MoltBook 的逐词自相关差直接当主证据(作者自己指出在 MoltBook 的 7 个滞后对上估计量会崩溃)。引用 0.167/0.313/0.622 时必须同时给出置换检验结果与样本数。126
10. 南亚 5 种语言的 Wikipedia 问答:直接给上下文在 Hindi、Nepali 上优于最好的 RAG 配置
Analyzing performance of Retrieval Augmented Generation models for Question Answering Tasks · arXiv:2610.20419 · 邻近跟踪
研究问题与核心方法:BRAC 大学计算机科学与工程系的 Fazle Mohammed Tasfiq 等九人构建一个南亚多语言文化问答集,用来分析 RAG(Retrieval-Augmented Generation,检索增强生成)的效果在不同语言、文化属性与条目热度上是否一致。数据来自 bn/ur/hi/ta/ne 五个维基百科站点的三级超链接抓取(落地页→一级→二级),清洗后各语言保留 2,405–10,769 条(表 3);上下文取每条正文前两行,用 Qwen 3 32B 生成「答案必须是该条目名、且条目名不得出现在问题里」的问题,再用 4 个模型(Llama 4 Maverick 17B、DeepSeek V3-0324、Gemma 3 27B、Grok 4.1 Fast)生成参考答案。检索侧用 ChromaDB 加 intfloat/multilingual-e5-large-instruct 嵌入,RAG 框架只保留 LangGraph 与 LlamaIndex(100 条样本的三框架试点里 LangChain 在低资源语言上更弱)。对照设计是三段式——不给上下文、直接给上下文、检索到的上下文——用来把「有外部信息」与「检索这一环节」的贡献分开 127
关键结果:
- 主结论:不给上下文的准确率在全部 5 种语言上最低;但 RAG 并非总是更好——平均准确率上 RAG 只在 Bangla、Urdu、Tamil 高于直接给上下文,Hindi 与 Nepali 上直接给上下文仍更强(第 9 节、图 8、图 9) 127
- 框架对比(100 条试点,表 5,百分比):多数设置下 LlamaIndex 略优或与 LangGraph 持平,LangChain 在 Nepali、Tamil、Urdu 上明显更弱,例如 Nepali 上 DeepSeek V3 为 LangChain 51.0、LangGraph 53.0、LlamaIndex 55.0;Urdu 上 Gemma 3 为 11.0、10.0、15.0 127
- 模型差异:Meta Llama 4 Maverick 17B 在多数设置里最强,例如 Nepali 上 LangGraph 74.0、LlamaIndex 76.0(表 5);DeepSeek V3-0324 与 Grok 4.1 Fast 在部分语言与条件下明显更弱 127
- 文化属性与热度:文化题与非文化题并不一致地谁高谁低;热门条目总体准确率高于非热门条目;非热门文化题从 RAG 得到的相对增益大于热门文化题,作者解释为基线越弱检索帮助越明显(第 8、9 节,图 3–5、图 10) 127
- 问题生成口径:先用 250 条样本人工比较 1 行与 2 行上下文,判定 2 行更好(1 行过于含糊、4 行会泄露答案),因此正式生成统一用 2 行上下文,并丢弃只有 1 行上下文的条目(第 3 节) 127
证据与局限:原文未报告重复次数、方差或任何显著性检验,表 5 因此只能当作单次运行的准确率;框架结论只来自 100 条试点。数据集与代码没有给出入口(正文只引用 LangChain、LangGraph、LlamaIndex、Chroma 的仓库)。作者自陈的口径问题包括:题目清晰度由 250 条样本人工 5 分制评定,非英语问题先机翻成孟加拉语再评,因此没有评「连贯性」,作者也写明换成母语者评判数值可能不同。我的引用风险提示:图 8、图 9 是准确率的点估计,作者用「百分点差」描述优劣,但既没有置信区间也没有配对设计;另外「流行度」由维基页面浏览量归一化得到,是相关性变量,不能读成因果。入口实测:原文 HTML(v1)返回 HTTP 200;四个框架仓库 https://github.com/langchain-ai/langchain 、https://github.com/langchain-ai/langgraph 、https://github.com/run-llama/llama_index 、https://github.com/chroma-core/chroma 均返回 HTTP 200,但原文未给出自建数据集或实验代码的入口 127
与目标研究线的连接点:与同节的记忆与上下文类论文相比,它的可搬之物是那个三段式对照:只有把「直接给上下文(把正确答案当上下文)当作基线」,才能判断检索环节本身是否真的加值,否则「RAG 比无上下文好」这类结论会把外部信息的作用记到检索头上。第二个可搬的是按条目热度分层报告增益,避免总平均掩盖「检索对弱基线帮助更大」这一模式。这两点对做证据构建与上下文注入的团队都是现成的实验骨架 127
结论建议:看表 5 与图 8、图 9,以及图 10 的热门/非热门分层。对 A 线可迁移的是对照设计与分层报告方式,而不是它的绝对准确率。引用时必须限定为「5 种南亚语言、维基百科条目名问答、单次运行、无显著性检验」,并且不要把「RAG 不总是优于直接给上下文」推广到其他检索器、其他模型规模或非维基语料 127
11. COUNT 把 n-gram 计数放主机内存:LM 损失等效多 46–89% 算力,免训练换表即可适配新领域
The COUNT: Counting N-grams Unlocks Scaling on Host Memory and Training-Free Adaptation · arXiv:2610.20456 · 邻近跟踪
研究问题与核心方法:语言模型同时受算力与内存约束;给 n-gram 加嵌入能「只扩内存不扩算力」地涨点,但已有方法要从头训练嵌入,权重与优化器状态必须常驻 GPU 并与主干抢显存。COUNT(Counting Offline Unlocks N-gram Transformers)走计数路线:离线在整份预训练语料上统计 n-gram 频次,把「每个历史最常接续的 K 个 token 及其计数分数」存在主机内存里,用这些分数加权主干模型自己的 unembedding 行,得到一个新的输入嵌入并与 token 嵌入相加。它不新增可学习参数,表是只读的,因此不占显存,还可以在推理时整表换成别的语料统计。作者来自华盛顿大学与艾伦人工智能研究所(Allen Institute for AI)。128
关键结果:
- 固定算力预算下,把 COUNT 作为额外输入嵌入用于 1B 参数语言模型预训练:验证损失(11 个验证源的平均 token 交叉熵)等效于标准 Transformer 多 46–89% 算力的水平;下游任务损失(74 个任务配置的平均 BPB,bits per byte)等效于多 6–56% 算力。128
- 显存受限时的取舍:COUNT 不增加可学习参数,因此在「总可学习参数预算」这条硬件无关坐标上,多数设置里 Pareto 前沿由 COUNT 占据;把对照的学习式 n-gram 嵌入学到同等表现需要额外参数并占用显存。128
- 表规模:旗舰实验用 797 GB 的 n-gram 表服务 370M、600M、760M、1B 主干;60M、100M、190M 用同一流程但阈值更严的 17.1 GB 表;n-gram 阶数统计到六阶,分数用 stupid backoff。128
- 推理期换表(零训练适配新领域):在 1B 主干上加权插值通用表(797.487 GB)与领域表(数学 83.398 GB、生物医学 81.723 GB、法律 80.151 GB),λ=0.25 时三个领域的域内损失都下降,数学与法律的任务损失和准确率改善比生物医学明显;参照量是同预算下通用表相对标准 1B Transformer 的任务损失改善 0.010 BPB,与中等强度的领域加权相当。128
- 缩表部署:把表换成 459.222、142.037、68.458、17.114 GB 的一般域表(按历史计数与 n-gram 计数阈值缩放),1B 检查点在缩小一个数量级以上仍优于标准 Transformer,且无需训练。128
- 吞吐:1B 规模下训练吞吐保留标准 Transformer 的 93.1–97.8%、prompt prefill 的 95.5–95.8%、自回归解码的 95.9–96.7%(8 张 H200 测训练、单张 H200 测推理);对照的学习式 n-gram 基线若按整表更新优化器只有标准吞吐的 4.4%(190M、17.1 GB 表),改为只更新被检索行后为 96.3%。128
证据与局限:主干用 OLMo-core 阶梯,覆盖 60M 到 1B 参数、token 与参数比 D/N∈{10,20,40},语料为 allenai/dolma3_mix-6T-1025-7B;先按 Hoffmann 式缩放律拟合再选最优分配,因此「等效多多少算力」本身是拟合量。局限:结论限于 ≤1B 主干与自建任务套件(74 个任务配置、其中 41 个多选配置),未给更大规模结果;吞吐优势依赖三项工程优化(编译多线程主机查表、预取、融合嵌入归约),换硬件可能变化;领域适配只报 λ=0.25 一档为「三领域损失同时下降」,准确率结果参差。128
与目标研究线的连接点:落在环境、记忆与研究流程这条线上,给的是「把非参数记忆从显存搬到主机内存、并可在推理期换表」的一种具体做法。与本单元 2610.19476、2610.19789 的互补在成本侧——那两篇问涨点是否真实,这篇问同样的涨点能否用更便宜的存储换。可搬走的一件是「只读的离线计数表+推理期插值换表」这个零训练领域适配旋钮,以及把参数预算与显存预算分开报告的口径。128
结论建议:要搬方法读第 2 节(COUNT 定义与 stupid backoff 打分)与第 5 节(换表与缩表);要数字读图 1 右(缩放律等效算力)、图 3(参数预算 Pareto)与第 6 节吞吐。引用时必须限定主干规模 ≤1B、D/N∈{10,20,40} 与 797 GB 宿主内存的实验条件,并把「等效算力」写成拟合量而非实测节省。128
十三、邻近跟踪:语音与音频侧的数据、表征与评测
1. Soloist 盲语音分离:免人数与目标查询,WildTV 计数准确率 1.000、PI-WER 0.150
Soloist: A Generative Model for Blind Voice Separation in the Wild · arXiv:2610.19716 · 值得扫读
研究问题与核心方法:原文未报告作者机构。真实录音通常只有转写或说话人时间线,缺少分离所需的目标波形,且待分离人数未知。Soloist 把盲语音分离做成条件音频生成:以 Qwen3-4B 为骨干,条件是混合音频的连续特征与离散 codec 码,自回归地先输出声部数、再逐帧生成每路 codec 序列(MOSS-Audio-Tokenizer-v2,每帧 12 个码、12.5 帧/秒),解码成各路波形,不需要目标说话人查询或预先给定人数。训练分两阶段:先用构造混合的源波形、歌曲的教师伪人声、自然录音的说话人时间线做监督,再用模型裁判提供相对奖励做强化学习。129
关键结果:
- LibriMix 双人重叠(给定人数,表 2):Soloist 干净 PI-WER(置换不变词错误率,越低越好)0.060、加噪 0.192;加噪条件下其余系统为 0.218 到 0.854。129
- 真实多说话人 WildTV(盲计数,表 3):Soloist 语料级 PI-WER 0.150、计数准确率 1.000;单模型盲计数的 SR-CorrNet 为 1.940 与 0.217。129
- 噪声环境 ViW(表 4):未处理输入 WER 0.261,各分离器反而升高,Soloist 升得最少(0.302);其 DNSMOS 背景分 3.18/3.45 与总体分 2.45/2.56(均值/中位数,1–5 分越高越好)为全场最高。129
- 歌声分离(表 5):SongYT 上 WER 0.253、RPA(原始音高准确率,估计基频落在参考 ±50 音分内的比例)0.854;MIR-1K 上 WER 0.354。129
- 训练消融(表 6):计数准确率从「去时间线 SFT」的 0.890/0.574/0.565(LibriMix 干净/加噪/WildTV)升到「标准 SFT」的 0.926/0.735/0.761,加 RL 后三者均为 1.000。129
- 裁判验证(第 6.7 节):40 组已知源混合、每组 8 个输出,直接听音频排序 0/40 通过顺序一致性检查,改成「先独立描述再文本排序」36/40 通过;在 PI-WER 相差超过 0.2 的 307 对里,裁判对其中 207 对给出偏好、其中 184 对与 PI-WER 顺序一致,即 88.9%(95% 置信区间 80.8–95.6%)。129
证据与局限:除裁判验证给出 10,000 次自助重采样的 95% 置信区间外,结果多为点估计,原文未报告训练随机种子或重复次数;作者自陈裁判的信号检查是启发式,感知上错误但通过检查的输出仍可能被接受,且歌声的教师伪人声意味着「与教师一致」不等于「还原独立录制的人声」。入口实测:
https://arxiv.org/html/2610.19716v1/ 为 HTTP 200;原文未给出本项目的代码或数据入口,正文只引用组件的模型页。引用风险:PI-WER 依赖 Whisper large-v3 转写与按脚本分词,跨系统比较需在同一口径下看。129与目标研究线的连接点:与同节语音侧工作的连接点是把「生成式分离」与「模型裁判强化学习」结合,可搬走的一件东西是裁判去偏设计:先独立描述、再在打乱与倒序两种候选顺序下排序,顺序一致性不足就丢弃整组反馈;评测侧可搬的是置换不变 WER 的匈牙利匹配与「歌词对但音高错」的补盲指标。129
结论建议:读第 5.2 节(裁判奖励与一致性过滤)、第 6.2 节(指标与聚合口径)与表 2–6;做语音评测或 AI 反馈式奖励时可搬其去偏与分层指标;引用时必须说明歌声数字是与教师伪人声的一致度,且除裁判一致性外无区间与种子。129
2. 语音访问修复:256 条真人录音上 ROUGE-L 比无修复高 0.0941,匹配范数的 SALSA 低 0.0707
Repairing Speech Access After Text Updates with Frozen Affine Fields · arXiv:2610.20253 · 值得扫读
研究问题与核心方法:语音大模型的知识大多继承自以文本为主的语言主干,日常维护也以文本更新为主,但文本更新学到的知识在同一个问题被「说出来」时可能取不到。作者把这一错位形式化为「更新后的语音访问修复」:承载知识的检查点保持冻结,只挂一个可拆卸算子,在模型一次前向内修复仅语音侧的访问。方法 Affirm(Affine Fields for Interface Repair across Modalities):先学一个冻结的基础修正(shared access parent)作用在语音隐状态上,再叠加在算子训练查询上零均值的逐查询修正(centered route field);配对出现的语音与文本状态提供坐标,使修正随查询变化。作者单位是香港中文大学(深圳)数据科学学院。 130
关键结果:
- 文本更新确实留下可测的语音访问缺口:在 CosyVoice(语音合成系统)渲染的 PopQA(维基百科事实问答集)配对问题上(14,267 条事实、16 种关系),同一检查点经文本为 0.9213 ROUGE-L(最长公共子序列召回率)与 0.9187 EM(归一化精确匹配),经语音只有 0.1840 与 0.1519(§6.1)。130
- 语音状态并非丢了问题信息:在 600 对配对问题里做状态检索,top-1 准确率 50.3%,随机水平 0.17%(§6.1)。130
- 合成语音上分不出胜负:在 balanced PopQA 上,配对 bootstrap 不能确立 Affirm-Direct 相对 DiReFT、LoReFT(两种在指定解码层学低秩隐状态干预的方法)或 SALSA(学一个共享的语音感知激活向量)的优势(§6.2)。130
- 真人录音迁移上明显分化:用 PopQA-20(PopQA 的训练子集)训练的算子在 SLUE-SQA-5(语音问答评测集,每条含一段文本与一个口语提问)的 256 条真人提问(50 位说话人、5 个来源数据集)上不重训直接迁移,Affirm-Direct 比配对的 No Repair 提高 0.0941 ROUGE-L,LoReFT 提高 0.0774,而编辑范数匹配过的 SALSA 变体比其配对基线低 0.0707(§6.2)。130
- 变体之间还会反转:加上同一个 route field 后,专家版 parent(Affirm-Expert)在 TOFU(虚构作者事实问答集)上更高,直接版(Affirm-Direct)在 SLUE 上更高,EM 领先 +0.0430±0.0185(bootstrap 标准误)(§6.3、Table 3)。130
- 部署代价小:Affirm-Direct 存 0.46M 个学到的值、只改一个 decoder 状态、语音侧一次前向且不需要问题转写;紧凑变体 Affirm-K1 迁到另一个主干模型 Kimi-Audio 上把 RL/EM(ROUGE-L 召回率与归一化精确匹配)从 0.6321/0.0850 提到 0.6451/0.1188(§6.4、§8)。130
证据与局限:主模型为 Qwen2.5-Omni-7B,各方法都在同一个「冻结检查点 + 单次语音前向」的约束下重新拟合并配对比较,开发集选择与实现细节见附录 B;Stage-B 用三个种子复现了 PopQA-20 与 TOFU 的开发结果,深度扫描用两个种子。原文自陈局限:只研究短答案事实型访问,主要用单一模型与主干;PopQA/TOFU 测的是对已进入文本更新的事实能否访问的迁移,不是学习新知识;合成语音只有一个固定音色;SLUE 上任务、提示、说话人与声学同时变化且带文本段落,因此测的是无重训的行为迁移而不是闭卷回忆;单状态干预限制了适配容量,一旦放开该约束,语音 LoRA、语音到文本蒸馏或 ASR 级联能取得更高准确率;MiMo-Audio 上的结果是混合的。引用风险:SLUE 的正结果只针对完整算子,不能归给 route field 单独一项;论文自己在合成语音上没有立住优势,别把 0.0941 当成普遍增益。130
与目标研究线的连接点:C 线里语音侧的表征与评测通常围绕合成质量,这篇提供的是另一类可搬动的东西:冻结主干加可拆卸修正,是「能力保持」与「模态对齐」之间的折中(改的是访问路径,不改权重),并把「同一问题的文本/语音两种访问」做成配对指标来量化模态差。第二个可搬点是评测顺序——先在合成语音上筛查方法,再去真人录音上做无重训迁移,任何语音侧算子都能照这个两段式验一遍;与同节其它语音论文相比,它关心的不是合成得像不像,而是更新之后取不取得到。130
结论建议:读 §5(基线、分组切分与指标定义)与 §6.1–6.2(Table 1),再看 §7 的组件消融(Table 4)判断两个组件各自的贡献;附录 B 里 SALSA 的范数校准与重标定控制值得一读,它是这篇负结果可信度的来源。搬用时先明确自己处在三种部署约束的哪一种(冻结单状态、语音侧重训、放开到 LoRA/蒸馏/ASR 级联),本文结论只在第一种下成立;引用 0.0941/0.0707 必须写明是 SLUE-SQA-5 的 256 条真人提问、无重训迁移下的 ROUGE-L 配对差。原文未给出代码或数据入口。130
3. Anuvani-LID:115.6M 参数 Conformer,37 个核心条件平均宏 F1 0.914,比 Gemini 3.5 Flash 高 5.2 分
Anuvani-LID: Robust and Calibrated Spoken Language Identification for Indian Languages · arXiv:2610.20263 · 值得扫读
研究问题与核心方法:口语语种识别(LID,language identification,多语种语音流水线的第一个决策)常被当作语音基础模型的天然潜能力。作者在相同音频上检验这个假设:Whisper 一类模型只有 15/23 个语言类别的 token,1 秒输入下 Gemini 3.5 Flash 宏 F1 只有 0.52、GPT-audio 0.14,且商用 API 多返回未校准的硬标签。做法是在 MahaDhwani Conformer 编码器上全量微调一个 115.6M 参数的专用 LID 模型,训练集 54,643 小时、3,124 万条语音(22 种印度表列语言 + 印度口音英语,共 23 类),并自建 SUITE-102(102 个条件、318,861 条语音)与 SUITE-42(42 个条件、15 个开放与商用系统跑同一批音频)两套评测,按留出说话人/留出语料分档。131
关键结果:
- SUITE-42 的 37 个核心条件上平均宏 F1 0.914(模型在 23 类里自由选),比 Gemini 3.5 Flash 高 5.2 分(95% 区间 [4.8, 5.5]),比 Sarvam Saaras 高 6.8 分,比最好的开放模型 MMS-LID-126 高 8.8 分;限制到与 API 相同的 10 个候选时达 0.923。131
- 全 23 类面板上平均 0.897,Voxlect Indic-Whisper 0.713、Gemini 3.5 Flash 0.710、GPT-audio 0.384;21 种语言的 F1 超过 0.90,最低是 Hindi 0.84 与印度英语 0.89。131
- 短音频是分水岭:1 秒输入下 FLEURS 上 0.764、域内 0.854,两处都比 Gemini 高 24 分(Gemini 为 0.520 / 0.611);0.5 秒时 0.545,Sarvam 0.439、Gemini 0.231。131
- 校准可单独修好:在开发集上拟合一个温度(T=0.674)后,留出全 23 类测试的 15 桶期望校准误差(ECE)从 0.054 降到 0.008,100·Cavg 为 3.16、等错误率 1.79%;开集拒绝(最大 softmax 概率)对音乐与非印度语言 AUROC 0.89–0.91,但对 Hindi 的近亲 Chhattisgarhi 只有 0.84。131
- 训练配方的可复用结论:损失决定校准(余弦间隔头的 ECE 为 0.75–0.79,softmax 头 0.02–0.08,focal loss 在同精度下 ECE 0.023、比交叉熵低 2.6 倍);温度采样存在倒 U 拐点 T=2(跨语料宏 F1 0.919,T=1 为 0.890);编码器必须全量微调(冻结编码器只有 0.362,LoRA 0.821,适配器 0.822)。131
- 层数可以砍:把编码器截断到前 12 个 block(84M 参数)得 0.848,与用满 17 个 block(116M)的 0.840 相当;全量模型的注意力聚合把 30% 的层权重给了最后一个 block,此时单 block knock-out 的代价不超过 0.08 分。131
- 多模型融合被作者自己否掉:把不同配置的臂融合在短语音上理论增益可达 11.1 分(oracle 口径),但多数投票几乎拿不回来,所以最终只保留单网络。131
- 权重平均(soup)比取末点更好:7 个 checkpoint(100k/175k/275k/325k/350k/400k/425k 步)均匀平均得 0.8453,相对最终 checkpoint 把电话域 0.898 抬到 0.923,并把全 23 类测试的 ECE 从 0.077 降到 0.054。131
证据与局限:评测口径是本篇最强的部分:主指标为条件内宏 F1,另有 top-1、Cavg、EER、15 桶 ECE、开集 AUROC;区间用 1,000 次 bootstrap(成对差异改为按条件分层的 300 次),配对比较用 McNemar 并在 Holm/Bonferroni 下校正,图/表中给出 95% 区间与逐条件胜负数(对 Gemini 37 个条件里 21 胜 9 负)。局限由作者自陈:Stage I–V 每个臂只跑一次,小差异仍是暂定的;Stage VI 全量训练只做过一次、没有换种子重跑;商用 API 只返回硬标签,所以校准与 Cavg 无法与它们对比,且其行为可能随版本变化;22+1 类之外的印度语言(Bhojpuri、Tulu、Gondi 等)不在标签集内,而开集结果显示近亲比无关语言更难拒识;性别切片未评估。读者注意:0.914 是自建条件集上的宏 F1,且本模型在 23 类里选、对手只被给了 10 个候选(「matched」设置 0.923 才是同候选对比),直接跨论文引用需说明这一点。131
与目标研究线的连接点:它不在 TTS 生成线上,但属于 C 线明确关注的「语音侧数据与评测」。可搬走的具体一件是评测口径而非模型:把语种/口音这类决策做成「多轴留出条件 × 分层 bootstrap × 配对检验」的条件集,并把校准(ECE、温度缩放)与开集拒绝 AUROC 和准确率一起报——同节的语音数据论文通常只报一个域内准确率。另一个可借的工程经验是「权重平均沿训练轨迹取点」能同时改善某个退化域和校准,且推理零成本。131
结论建议:读 §4(SUITE-102 的条件构成,可直接对照改造自己的评测集)、表 3(15 系统同音频对比)、§5.2 的分阶段实验设计(温度、focal loss、增广、课程学习各自单独提问)、§6 的校准与开集小节、§8 的层级探测。对做语音数据与评测的团队值得扫读;引用时必须限定「37 个自建条件、宏 F1、模型 23 类对对手 10 类」。模型入口 https://huggingface.co/CIIL/Anuvani-LID 实测已失效(curl 返回 401,用页面抓取复测为 HTTP 404),原文未给出其他代码入口。131
4. MuseBench:361,166 首曲目、10 个生成器上评 11 个检测器,PGD 攻击把 M5 漏报率推到 92.4%
MuseBench: A Benchmark for AI-Generated Music Detection and Artifact Analysis · arXiv:2610.20310 · 邻近跟踪
研究问题与核心方法:AI 生成音乐检测的既有基准一般只覆盖少量生成器、偏重带人声的歌曲、且只在干净样本上评测,而真实链路里还有压缩转码、声学后处理、对抗扰动与人机共创。作者发布 MuseBench,共 361,166 首曲目(约 5,296 小时),包含人工作曲、10 个文本到音乐生成器的输出、人机共创、经有损压缩/声学后处理/加性扰动处理的变换变体,以及一个域外人类音乐集;并在此之上评测 11 个检测器(9 个开源 + 2 个商业 API)在默认、留一生成器(LOMO,leave-one-model-out)与域外(OOD,out-of-domain)三种设置下的表现,另做声学人工痕迹分析。作者为 Yi Chen Liu、Syed Irfan Ali Meerza、Jiawei Yu、Xi Guo、Samuel Bright、Jian Liu,机构为 University of Georgia、College of Engineering、Virginia Commonwealth University、University of Tennessee, Knoxville 与 Cornell University。132
关键结果:
- 构成:人类子集 19,903 首(Genius-Lyrics 9,983 首 + JamendoMaxCaps 9,920 首)、AI 生成 179,224 首、人机共创 9,887 首、变换变体三组各 53,805/53,805/35,870 首、域外 Free Music Archive 8,672 首(Table 4、§3.3)。132
- 默认设置(70/20/10 划分,每曲随机取 10 秒片段,指标为平衡准确率 ACCB):ResNet18+Spec 与 AST 均达 100.0,ConvNeXt 99.8、ViT 99.7、SpecTTTra 99.5;手写特征的 Deezer 检测器 97.6,而 Q-SVM 只有 68.9(§4.2.1、Table 8)。132
- 商业检测器表现分化:Ircam Amplify 平衡准确率 81.0、精确率 98.6 但召回仅 71.1(漏报 28.9);Resemble AI 平衡准确率 46.9、假阳性率 70.8(§4.2.1)。132
- 鲁棒性(表内为把 AI 曲目误判为人类的漏报率 FNR):用 M5 与 RawNet2 为代理模型生成的 PGD(projected gradient descent,投影梯度下降)对抗扰动把 M5 推到 92.4%、RawNet2 推到 88.1%;变速变调把依赖频域指纹的 Deezer 推到 93.6%;MP3 转码把 AST 推到 24.9%、把商业的 Ircam Amplify 推到 63.6%(Table 1、§4.4)。132
- 域外人声检测:只喂人类曲目时 Deezer 仍达 94.4%,AST 79.8%、M5 75.8%,其余检测器均低于 60%,说明跨生成器表现好并不等于对陌生数据可靠(§4.2.2)。132
- 人工痕迹分析给出四类可复用信号:非惯用和声进行、放大上采样产生的频谱周期性、超出人类演奏物理限制的事件、以及假歌词与近似发音类声乐痕迹;频谱证据需对幅度谱再做一次 FFT(快速傅里叶变换)才显形(§6)。132
证据与局限:商业 API 只跑了代表性子集(1,990 首人类 + 4,500 首 AI,其中 Suno 与 Udio 各 250、其余生成器各 500),另有 200 首共创与每类变换变体 300 首,与开源检测器全量评测的口径不同,跨行比较需谨慎。数据规模与来源验证写得细(人类子集每源随机抽 1 万首核对元数据),但原文未报告多次重复实验、置信区间或显著性检验。数据集托管在匿名仓库 https://huggingface.co/Anonymousv22222/datasets (实测 HTTP 200),匿名地址意味着可复现性依赖后续正式发布;正文也引用了人声痕迹分析所用的第三方和弦提取工具 https://github.com/ohollo/chord-extractor (实测 HTTP 200)。132
与目标研究线的连接点:与音频侧其它评测类条目互补——它示范了如何把「真实链路里的干扰」设计成评测矩阵:把同一批 AI 曲目分别过有损压缩、声学后处理与加性扰动,再按来源与语言/类型分层报告漏报率,而不是只报一个平均准确率。可搬走的一件东西是这套变换变体矩阵与「留一模型 + 域外人类集」的组合口径,可直接照搬到语音合成检测或生成音频的质量评测上;四类人工痕迹的特征化写法也可作为检测器设计的先验。132
结论建议:读 §4.1(评测设置与指标定义)、Table 1 与 §4.4(变换鲁棒性)、§6(人工痕迹)。对音频侧可迁移的是变换变体矩阵与漏报率分层报告方式;引用时必须限定检测器版本与子集口径(商业 API 只看过代表性子集),并且不要把「默认设置近满分」当成检测问题已解决——PGD 与变速变调下同一批检测器的漏报率可以到九成以上。132
5. 22 语言零样本 diarization:时长加权 DER 16.78%,标注约定值 1.9–4.1 分
Anuvani-Diarization: Zero Shot Speaker Diarization and Annotation Conventions Across 22 Languages · arXiv:2610.20327 · 值得扫读
研究问题与核心方法:本文作者来自印度语言中央研究院。印度 22 种表列语言的对话常在同一轮内混语、重叠频繁,说话人 diarization(判断谁在何时说话)是语音智能体、会议与呼叫中心转写的前置任务。该文在 IndicDiarBench 上一次性盲测九个专用 diarization 系统,并提出 Anuvani-Diarization:把自监督端到端分段模型(EEND-VC 架构,剪枝到 80% 稀疏的 WavLM-Large 编码器加四层 Conformer,每 20 ms 对 16 类 powerset 做预测)用「显式不确定性银标注」适配到印度对话——来自 SPRING-INX 每说话人单通道电话录音的标签按 10 ms 单元标记为已知或未知,未知单元不计损失。133
关键结果:
- 主结果(表 3):在全部 1,164 段录音上取得 17.11% 汇总 DER 与 16.78% 时长加权 DER,是所有参评系统中最低(汇总 DER 的 95% 自助区间 [15.80,18.45]);配对自助差全部排除零:对 pyannoteAI Precision-2 为 −0.47 个百分点([−0.84,−0.09])、对 DiariZen md-v2 为 −1.21([−1.40,−1.01])、对 NVIDIA Nemotron-3-Diarization 为 −1.60([−2.18,−1.06])。133
- 标注约定敏感性(表 2):把同一说话人之间短于阈值 g 的间隙桥接起来(g 在 0.8 到 1.0 秒之间于基准上选出,只改约定不动声学判断),DER 下降 1.90 个百分点(本系统)、2.03(Precision-2)、2.91(DiariZen md-v2)、4.14(Nemotron-3);同样的桥接用在字对齐参考的 VoxConverse、NOTSOFAR-1 与 MagicData-RAMC 上反而把 DER 抬高 0.68 到 6.01 个百分点。133
- 约定不可迁移(第 5.1 节、表 4):用 302 通 SPRING-INX 电话转写训练约定解码器后冻结并评分一次,DER 从 17.11% 升到 22.74%;漏检语音从 8.91% 降到 2.89%,但虚警从 3.55% 升到 15.29%。133
- 覆盖面与代价(第 7 节):领先三个最强对手的语言为 14/22,最大优势在未参与适配的 Manipuri(−1.92 个百分点)等;六个国际基准上均值 12.03% 对父模型 DiariZen md-v2 的 12.19%;网络 69.5 M 参数,六张 RTX A6000 上训练约 91 分钟。133
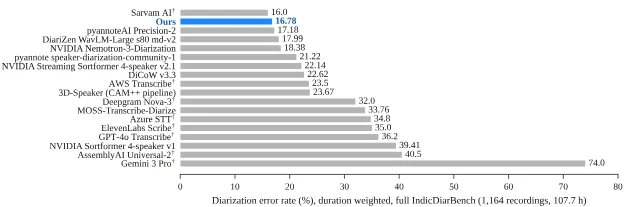
全部 1,164 段录音上各 diarization 系统的时长加权 DER 排行(arXiv:2610.20327)
证据与局限:用两套独立评分实现、对 590 条源录音做 5,000 次自助重采样(种子 3407)、多 GPU 分片推理可逐字节复现;作者自陈本系统不建模基准的分段约定(匹配它还可再降约 1.9 个百分点)、时长加权 DER 仍比 Sarvam AI 自报的 16.0% 高 0.78 个百分点、适配数据只覆盖 8 种语言的两人电话。入口实测:
https://arxiv.org/html/2610.20327v1/ 在反爬拦截下改用抓取工具可取得全文;原文给出的模型入口 https://huggingface.co/CIIL/Anuvani-Diarization 实测 HTTP 404。引用风险:DER 必须连同「零 collar、重叠计分」的口径一起引用。133与目标研究线的连接点:与同节语音侧工作的连接点是「标注约定本身是评测误差的一部分」;可搬走的一件东西是把分段约定当显式变量做敏感性分析——同一份系统输出换约定,数值与排名都会变,跨基准比较前必须先对齐约定。133
结论建议:读第 5 节与表 2、表 3;若在做语音侧评测或转写管线,先确认参考的分段约定再比 DER;引用时必须说明评分口径,并注明模型入口当前不可访问。133
6. 冻结神经音频编解码器的索引重编码:512 文件 129.591 kbps,比原索引 XZ 对照低 25.943%
Quantizer Redundancy and Exact Index Recoding in a Frozen Neural Audio Codec · arXiv:2610.20471 · 值得扫读
研究问题与核心方法:残差标量量化在各级复用同一组未缩放的网格时会产生高度相关的索引,也就是说索引本身带有可压掉的冗余。这篇单作者案例研究在一个冻结的双路神经音频编解码器上分析这种重复网格递推(奇数基数网格给出零延续、偶数基数网格给出交替的中心贡献),并据此做一个精确的重编码格式:用预测器预测各级索引,与真实索引逐位比对,凡不符合的写进显式例外记录,从而在保留解码器输入的前提下减少存储。模型权重、保存的网格与重建图全程不动。134
关键结果:
- 最终格式在 512 文件队列上为 129.591 kbps(含全部文件头与压缩开销),比开发阶段选出的原索引 XZ 对照 174.988 kbps 低 25.943%;62 文件队列为 142.696 kbps,比对照 193.606 kbps 低 26.296%。134
- 同一 zlib 设置下,预测式打包相对原索引表示把字节数降 35.994%(62 文件)与 36.012%(512 文件),逐片段降幅 30.847–53.420%。
- 无损证据:574 个文件的 latent 与波形逐位相等,模型状态哈希不变;例外记录在 62 文件上是 15,864,832 个标量元组里的 2 个、512 文件上是 121,807,104 个里的 10 个,全部原样保留。
- 队列构造:512 文件从 183,064 条路径出发,排除后得 38,345 个候选,按集合轮转选出 512 个(覆盖 136 个两级 pack key);保留解码时长 2208.396 秒,62 文件队列为 287.709 秒。
- 被保留的重建质量本身差异很大:512 文件队列全带 SI-SDR 均值 4.332 dB、下四分位 −5.055 dB。
证据与局限:作者自陈的限制很硬:两个队列都是方便样本且刻意做了集合平衡,不代表随机抽样;现有清单无法证明与训练内容完全不相交;精确性只在记录的 CPU float32 执行下成立,未测其它 checkpoint、流式条件或加速器;时间与内存是研究脚本的测量,不是编解码器延迟基准;重新编码要生成三份候选取最短,完整三模式编码成本未测。所有百分比的分母各不相同,作者明确说不能相加。风险:这是单一冻结编解码器、两个非随机队列上的工程记录,不能写成「神经音频编解码器普遍可省 26% 存储」。机构为圣托马斯大学(美国佛罗里达州迈阿密花园);
https://arxiv.org/html/2610.20471v1/ 实测 HTTP 200(命令行直接 curl 会被反爬拦下,改用页面抓取可拿到全文),原文在「数据与材料可得性」一节明确说明实现仓库不公开,因此未给出代码或数据入口。134与目标研究线的连接点:连到 C 线的编解码与声学表征:它把「表示层冗余」这件事和一个可搬的口径摆出来——在同一个压缩器下比较两种表示,并把「表示效应」(36.012%)与「最终存储结果」(25.943%,换了对照基线)分开报。做离散语音 token 的存储或 token 级压缩时,可搬的是这个两级对照口径与「预测+显式例外」的无损保证写法,而不是某个具体的 kbps 数字。134
结论建议:读 §4(重复网格递推与奇偶性)、§5.1(预测器与逃逸规则)、§7.1 与 §7.2(表 3、表 4)。引用时必须限定:这是单一冻结编解码器上的案例研究,队列是重用过的方便样本,且「无损」仅指解码器输入与既有重建逐位不变,重建质量本身没有被改善。134
7. 36 个生理标记做深度伪造语音检测:域内 EER 21.40%,跨域 32.77%
An Initial Study of Physiological Markers for Deepfake Speech Detection · arXiv:2610.18934 · 邻近跟踪
研究问题与核心方法:主流深度伪造语音检测器学的是合成伪影,换攻击或换录音条件就退化;本文改从语音产生机制出发,用 36 个手工生理标记(呼吸 14 个、发声 16 个、时间 6 个)加线性分类器,判断录音是真实还是伪造。标记覆盖呼吸频率与时长、基频 F0、jitter(周期扰动)与 shimmer(幅度扰动)、谐噪比 HNR、语速与停顿结构等属性;分析限定在时长超过 14 秒的英语录音,统一重采样为 16 kHz 单声道并做峰值归一化。 135
关键结果:
- 在自建的 EDS-14 池化语料(12,198 条真实、70,085 条伪造英语录音,全部长于 14 s)上做域内(ID)评测:RBF 核 SVM 的等错误率 EER 21.40%,逻辑回归(LR)27.60%(表 III)。 135
- 去掉 MLAAD/M-AILABS 的缩水域内设定上,LR 29.47%、RBF SVM 41.25%;把 MLAAD/M-AILABS 完全排除出训练、只用于评测的跨域(OOD)设定上,LR 32.77%、RBF SVM 37.83%(表 III)。 135
- 两个分类器的跨域行为相反:相对缩水域内,LR 退化 3.30 个百分点,RBF SVM 反而改善 3.42 个百分点,作者据此认为 LR 在三种设定间更稳定(第 V 节)。 135
- 线性系数给出标记级解释(表 IV):标准化后 shimmer 的 APQ5 系数 −4.01 把判定推向真实语音,平均呼吸时长 +3.73、绝对 shimmer +3.29 推向伪造。 135
证据与局限:原文未报告统计检验、随机种子数或置信区间,只有单次划分的 EER。作者自陈的局限较关键:多数据集池化使说话人与合成器可能跨训练/验证/测试重叠,OOD 设定也只是「训练中排除掉的那个数据集」,不等于未见说话人;部分子数据集只有单一类别;jitter 与 shimmer 对录音质量和提取错误敏感;未做标记分组消融,也未测与现代自监督(SSL)检测器的互补性。入口实测:arXiv 全文页 https://arxiv.org/html/2610.18934v1/ 返回 HTTP 200,正文给出的项目仓库 https://github.com/Security-FIT/Physiological-Markers 返回 HTTP 200。 135
与目标研究线的连接点:同节另一篇(口吃起始预测)也是语音侧标注加时序建模,但本篇可搬走的是另一件东西——把「合成语音在语音产生维度上失真」整理成 36 项可解释清单,并用标准化线性系数做标记级归因;对语音合成团队,这可以直接当输出「生理合理性」的检查表。需要区分的是它不生成也不改造语音,产物是一个检测器而不是评测指标。 135
结论建议:只读第 III 节(标记分类与提取口径)与表 III、表 IV 即可。可迁移的是标记清单、系数解释方式,以及它对池化评测的坦诚处理;引用 21.40% 这类数字时必须限定为「池化英语语料、录音级划分、非说话人隔离」,不能当作跨域泛化能力。 135
8. CAFE:把 CKA 蒸馏梯度关进语言路由适配器,Open ASR 榜平均 WER 从 8.55% 降到 8.02%
CAFE: Confining Feature Distillation to Language-Routed Adapters for Compact Multilingual Automatic Speech Recognition · arXiv:2610.19134 · 邻近跟踪
研究问题与核心方法:紧凑多语种 ASR(automatic speech recognition,自动语音识别)学生模型通常由教师模型结构化剪枝后初始化,作者先检验「特征蒸馏在 logit 蒸馏之上还有增量」这个默认假设是否成立:用梯度分析发现投影型特征损失(论文称 VkD variant,即用正交投影把学生特征映到教师维度再逐帧对齐)的目标梯度与监督梯度几乎正交,而 CKA(Centered Kernel Alignment,中心化核对齐,一种比较两组特征相似性结构的相似度损失)的梯度与监督梯度只有约 0.087 的弱正相关,其正交部分会被所有语言共用的编码器一起承担。据此提出 CAFE(Confined-Adapter Feature distillation),把 CKA 损失只加在「英语不走」的语言路由瓶颈适配器上,并用 stop-gradient 把 CKA 梯度挡在共享编码器之外,把权衡从损失层移到参数层。136
关键结果:
- 在 Open ASR Leaderboard 的 EN-7(7 个英语短句测试集)与 ML-9(9 个多语测试集)上,用检查点平均(CA,checkpoint averaging,把最后 7 个检查点权重取平均)后:CAFE 平均 WER(word error rate,词错误率,越低越好)为 8.02%,基线(监督损失 + logit 蒸馏)8.55%,只加适配器不加特征损失的 Capacity 对照 8.51%,直接加 CKA 的版本 9.04%(表 3)。136
- 分语言看:CAFE 的 EN-7 为 9.03%,优于基线 9.85% 与 Capacity 的 9.67%;ML-9 从基线 7.24% 降到 7.00%。去掉 stop-gradient 后 EN-7 回到 10.44%(比基线还差)而 ML-9 仍为 6.95%,说明该操作几乎不损多语、只护英语。136
- 诊断数字:多语 CKA 梯度与英语激活子空间的重叠为 97.5%–99.5%,随机水平约 81%;三种损失层补救(语言门控 CKA、按 loss gap 门控、子空间投影)都没止住英语退化,语言门控 CKA 的 EN-7 为 11.21%、ML-9 为 7.18%。136
- 规模与成本:学生 254M 参数、教师为 Parakeet-TDT-0.6B-v3(约 0.6B),作者称落后约 2 个 WER 点;适配器让吞吐下降约 2.0%–3.8%;8 语言小规模复现同样为正(EN-7 10.11%→8.71%,ML-9 6.62%→6.53%)。136
证据与局限:训练数据 116.9M 条、564k 小时、25 语言、10 个语料,评估 48 个测试集(296k 条、24 语言);每个配置只训一次,作者自陈多随机种子复现代价过高,显著性检验只用每次运行的最后 7 个检查点(附录 F),所以「显著」只在作者口径内成立,原文未报告独立重复次数。学生由教师剪枝初始化,作者把结论限定在该设置,随机初始化是否同样成立未验证;我另提示主结果用测试集语言标签决定是否走适配器,部署才用 0.19% 参数的语言门(平均 WER 8.02%→8.07%),跨语言引数时要注意这一差别。136
与目标研究线的连接点:本篇不在 C 线本体(TTS 生成)上,但它把「特征蒸馏可能只帮低资源语言、反噬高资源语言」用梯度量化讲清楚,可搬走的一件东西是:先做梯度诊断、再决定把蒸馏信号限制在哪一组参数上,而不是在损失函数里做裁剪。做紧凑声学模型或 TTS(text-to-speech,文本转语音)学生模型蒸馏时可复用该诊断(投影损失梯度正交、CKA 弱对齐)以及 CKA 相比投影损失每步快约 2.8× 的成本对照。136
结论建议:读 §4(梯度诊断)、§7 表 3(主对比)与表 4(适配器开销)、附录 D(检查点平均窗口稳健性);模型入口 https://huggingface.co/qvac/TranscribePsy-250M-EU 实测 HTTP 200。引用时必须限定为「教师剪枝初始化 + 英语主导的大规模数据」的多语 ASR 蒸馏场景,只能引用单次运行的检查点方差,不能说它证明了特征蒸馏的普遍规律。136
9. 口吃起始连续预测:因果 Conformer 达 AUROC 0.63,25% 报警占空比覆盖 58.6% 事件
From Detection to Anticipation: Continuous Onset Forecasting for Stuttered Speech · arXiv:2610.19235 · 邻近跟踪
研究问题与核心方法:现有口吃系统只在异常发生之后检测,本文把它改成「连续因果时间-事件预测」:每 100 ms 只看该时刻之前的语音,估计一段时间窗内是否会出现新的口吃起始(repetition 重复、prolongation 拖长、block 阻塞)。做法是把冻结的 Whisper-large-v3 编码器每 100 ms 对前 2 s 音频编码成一个 1280 维向量,再让 4 层因果 Conformer(3.67 M 可训练参数)在这些状态上向后看最多 200 步(约 20 s,总感受野约 22 s)。 137
关键结果:
- 数据:FluencyBank Timestamped(FBT)36 位说话人,人工复核补充后得到 2,872 个预测事件(2,593 重复、129 拖长、150 阻塞),按 100 ms 网格共 164,694 个可评分帧,300 ms 视界下正例 8,121 帧、阳性率 4.93%。 137
- 300 ms 视界上因果 Conformer 的平均精度 AP 0.0769(为阳性率的 1.56 倍)、AUROC 0.6300,比因果 TCN 高 0.0411(95% 置信区间 [0.0196, 0.0615]);GRU 没有超过 TCN(表 1)。 137
- 增益不是「看得更多音频」带来的:把静态 Whisper 窗口从 2.0 s 加宽到 3.8 s,AUROC 反而从 0.5682 降到 0.5666,而建模状态序列把它提到 0.6300(第 4.2 节)。 137
- 事件级口径:25% 报警占空比下,Conformer 提前覆盖 58.6% 的可评分事件(TCN 57.4%、GRU 53.8%);放宽到 66.5% 占空比时覆盖 91.6%。 137
- 分类型 AUROC:重复 0.630、拖长 0.655、阻塞 0.612;但换成说话人内 AUROC(wAUROC),重复只剩 0.576(95% 置信区间 [0.564, 0.590]),拖长 0.540 与阻塞 0.541 的区间跨过 0.5(第 4.3 节)。 137
- 多视界:离散时间风险模型用单个模型给出 0.30 s 到 1.5 s 的 AUROC(0.604 到 0.575),与分别训练的五个二分类器相当,但按构造保证单调;独立多视界累计输出在 68.9% 的帧上违反排序(表 3)。 137
证据与局限:标注可靠性有报告:第二位标注者独立标注 185 个片段,Fleiss κ 为重复 0.54 [0.37, 0.69]、拖长 0.73 [0.62, 0.83]、阻塞 0.56 [0.41, 0.69],匹配事件的起始中位偏差 80 ms。评测用 6 个说话人隔离折、每折 3 个种子,并做配对的自助重采样。局限是证据面窄:单一数据集、2,872 个事件,两种稀有类型分别只有 17 与 23 位说话人有足够正例;作者自陈扩展起始级标注是主要瓶颈,且未做前瞻干预研究。入口实测:arXiv 全文页 https://arxiv.org/html/2610.19235v1/ 返回 HTTP 200;原文未给出代码或数据入口。 137
与目标研究线的连接点:可搬走的是三件评测设计,而不是口吃本身:一是「说话人内 AUROC」先把各说话人基线倾向差异扣掉,避免池化数字虚高;二是把帧级指标换成事件级灵敏度对报警占空比的曲线,直接对应「允许系统在多少比例时间里出声」的部署约束;三是用离散时间风险头保证多视界预测单调。静态窗口与时序序列那组对照,也是任何「加长上下文是否等于建模历史」的干净实验。 137
结论建议:读第 2.2 节(任务口径与可评分帧定义)、表 1(架构对照)、第 4.3–4.4 节(说话人内与事件级口径)。引用时必须限定:数字来自单一数据集与 36 位说话人,稀有事件类型的区间跨过 0.5,不能写成「口吃可被可靠预判」。 137
10. 从复调混音直接克隆乐器音色:CLAP 相似度 0.696、FAD 1.92,逼近干净独奏的 0.762/1.85
Point-and-Play: Instrument Timbre Cloning from Music Mixtures · arXiv:2610.19445 · 邻近跟踪
研究问题与核心方法:罗切斯特大学(University of Rochester)电子与计算机工程系的 Baotong Tian 与 Zhiyao Duan 提出新任务「从音乐混音中克隆乐器音色」:给定一段多乐器复调混音和一条提示(一段音频或一个乐器类别名词),提取被提示乐器的音色码,再合成混音里没出现过的新音高与新力度,且不先做音源分离。系统 Point-and-Play 用 CLAP(Contrastive Language-Audio Pretraining,音文对比预训练模型)做双分支编码:混音分支用 LoRA(Low-Rank Adaptation,低秩适配)微调,提示分支冻结;核心模块 CGSP(Cue-Gated Statistics Pooling,提示门控统计池化)用提示向量对混音词元做彼此独立的 sigmoid 门控(而非 softmax 归一化,因此可有多个时间点同时获得高权重),再加权求均值与标准差,经多层感知机得到残差并与提示嵌入融合,输出 512 维音色码。合成端沿用 FlowSynth 的潜空间流匹配解码器(24 层 DiT,Diffusion Transformer,隐宽 1,024),在 DiffRhythm 的 VAE 潜空间预测再由冻结解码器还原波形 138
关键结果:
- 在 27 个留出的 NSynth 乐器上,Point-and-Play 的 CLAP 相似度(生成音频与合成目标的余弦相似度)为文本提示 0.706、同类别音频提示 0.678、目标乐器音频提示 0.696,接近「目标乐器另一音符」的 oracle 0.762(表 1) 138
- 两条音频提示配置的 FAD(基于 VGGish 的分布级真实度,越低越好)都是 1.92,接近干净参考 oracle 的 1.85;文本提示的 FAD 是 2.23(表 1) 138
- 与「先分离再克隆」相比,Point-and-Play 在 CLAP 相似度、FAD、MSS(多分辨率频谱距离)上全面优于 Demucs-closest(固定 stem,FAD 4.13)与 CLAPSep(提示条件分离,FAD 2.38)(表 1) 138
- 音高泄漏探测:用五折交叉验证的岭回归从音色码预测混音中目标音符的 MIDI 音高,R²=0.263,而在干净独奏的原始 music-CLAP 嵌入上是 0.783,说明音高信息被压制但没有消除(4.2 节) 138
- 损失消融(表 2):去掉音频选择性损失后错误音频提示的相似度从 0.430 升到 0.469;去掉音频对齐损失后匹配音频提示的相似度掉到 0.417,已接近错误提示水平;去掉不变性损失则两种提示都退化 138
- 提示时长:2 秒不够,4 秒已捕获大部分检索增益,更长上下文只保持稳定,因此默认用 4 秒裁剪(图 3、4.2 节) 138
证据与局限:提取器只在 4 秒混音上训练(单卡 A100 约三小时),评测主表用 27 个留出 NSynth 乐器,图 3 另用一组留出的 MoisesDB 子集;原文未报告重复次数、方差或置信区间,也没有做听感测试,主表差异没有标显著性。作者自陈局限是训练数据的乐器与录音多样性有限、缺少感知质量的主观评估、以及同类别多个乐器同时出现时难以做更细的源选择。我自己的引用风险提示:CLAP 相似度由另一个通用音频 CLAP 音塔计算,而四组基线用的是各自条件空间下的解码器,因此跨系统的绝对值只能比同表同列,不能与其他论文的数字混用。入口实测:原文 HTML(v1)与代码/演示页 https://github.com/User-tian/Point-and-Play 均返回 HTTP 200 138
与目标研究线的连接点:与同节语音与音频表征类论文相比,它可搬走的是「门控统计池化」这一从混合信号中抽出条件表征的做法,以及一组切分误差来源的对照:oracle 干净参考(音色已知)、只用提示不给混音、先分离再克隆、直接从混音编码。有了「只用提示」这一档,就能判断相似度里有多少来自类别先验、多少来自被提示源本身。对 TTS 侧的迁移点是:条件音频门混有干扰源时,直接编码可能优于先分离,但需要专门的选择性损失才能让表征只认提示的那一路 138
结论建议:先看表 1(四组基线加三条配置)与表 2(损失消融),再看 4.2 节的音高泄漏探测。引用时限定为「4 秒提示、NSynth 与 MoisesDB 域、27 个留出乐器、无听感测试」;R² 的对比不要写成「音色码不含音高」,原文的措辞是压制而未消除 138
11. 流式逆文本规范化:块大小 5 时总延迟从 206 ms 降到 60 ms,流式 WER 4.18% 对离线 3.63%
Towards Efficient Simultaneous Inverse Text Normalization with Pretrained Text-to-Text Language Model and Read-Tag-Write Policy · arXiv:2610.19492 · 邻近跟踪
研究问题与核心方法:逆文本规范化(inverse text normalization, ITN)把流式 ASR(automatic speech recognition,自动语音识别)输出的口语形式文本还原成书面形式,例如把 「one point two dollars」 变成 「$1.20」。已有的流式方案是「神经标注 + 人工编写的有限状态转换器(finite-state transducer, FST)规则」的混合系统,扩展性差;端到端 seq2seq(序列到序列)模型可扩展,但编码器-解码器的全局注意力天然不能流式。作者把预训练文本到文本模型 EnViT5(T5-base 架构的英越双语版本)改造成流式:因果分块编码器配动态右上下文掩码,联合标注器预测 {B, I, O} 边界标签(IOB 格式,标出需要规范化的片段),再配合「读-标注-写」(Read–Tag–Write, RTW)解码策略——非规范化的原样 token 直接透传,只在规范化片段结束时触发自回归解码器,并用 KV 缓存(键值缓存)与 Copy–Paste 策略免去重复计算。作者单位为瑞士 UNEY。 139
关键结果:
- 越南语主结果(含标点与大小写恢复,即 With PnC 设定):流式变体 S2(右上下文 1 步 look-ahead)的 WER(词错误率)为 4.18%,离线基线 B1/B2 为 3.84%/3.63%,B2 与 S2 的标注 F1 分别为 97.34% 与 97.19%;作为对照,端到端但只对孤立片段解码的 AdapITN 在同一设定下 I-WER(只统计规范化动作引入错误的词错误率)156.88%、WER 40.08%(Table 1)。139
- 真实噪声 ASR 转写上:流式变体 S4(缓存优化全开)相对混合流式基线 H2(前人工作的神经标注加 FST 规则系统)取得 21.43% 的相对 WER 降幅,相对 Wait-k(固定滞后的读写策略基线)为 9.82%,相对最强离线基线 B1 只增加 7.29%(Table 2、§4.4)。139
- 延迟:在单张 H100、batch 100 的模拟高并发下,块大小 5 时总延迟从 206 ms 降到 60 ms(3.43×),编码器延迟从 54 ms 降到 10 ms;95 分位延迟(p95)165.5 ms(加解码器缓存)对 249.0 ms(仅编码器缓存),而块大小 5 大致对应 500 ms 音频,因此 95 分位也在实时以内(§4.2、Fig. 2)。139
- 右上下文很关键:有 1 步 look-ahead 的 S2 相对零 look-ahead 的 S1,在 With PnC 与 Without PnC 两种设定下分别取得 19.31% 与 21.95% 的相对 WER 降幅(Table 1)。139
- 数据规模:基于约 60 亿词的越南语新闻语料,用生成管线产出 500 万条训练句对、5 万条验证、5 万条测试,并附短语级对齐与 token 级规范化边界标注(IOB)(§2.6)。139
证据与局限:所有对比都给出了相对改善的置信区间(原文以方括号列出),主表覆盖多种块大小与右上下文配置、以及 With/Without PnC 两种评测设定;延迟是在单卡、batch 100 的模拟下测得,并另报 p95 以覆盖最坏情况。原文未单列局限章节,需自己留意:语言只做越南语(作者声称框架与骨干无关但未做跨语言验证);流式准确率仍低于离线(4.18% 对 3.63%);长尾或跨句依赖的规范化未单独分析;混合基线 H2 与 Wait-k 的实现来自前人工作,复现口径不同会改变相对降幅;新数据集只描述了生成管线,未给发布入口。引用风险:4.18% 与 3.63% 是同一张表不同行的绝对值,引用相对降幅请直接抄原文给出的百分比,不要自行换算。139
与目标研究线的连接点:与 C 线(TTS/语音侧)相接的有两处可搬走的设计:一是 RTW 这种「廉价判定器把关、昂贵生成器只在必要片段启动、其余透传并复用 KV 缓存」的结构,可直接搬到流式语音或播客生成里做成本控制;二是评测口径——把 I-WER(只统计规范化动作引入的错误)与 WER 分开报告,这个拆法能照搬到任何带后处理阶段的音频管线,用来区分「后处理引入的错误」与「上游本来就有的错误」。它是本单元唯一给出生产级延迟与并发预算的条目。139
结论建议:读 §2.5(RTW 策略与 Copy–Paste)、§4.2(延迟拆解)与 Table 1/2;只借结构与延迟口径的话读这几节即可,不必细看越南语适配细节。搬用时注意它是文本侧后处理,与生成式音频只在「流式预算与分段触发」这一层相通;引用数字必须写明是越南语、EnViT5 骨干、以及 With PnC 还是 Without PnC 的哪一档。原文未给出代码或数据入口(数据集只描述生成管线,未见发布链接)。139
12. TVPara:492 小时剧集副语言字幕,微调 LALM 平均相对提升 31.26%,并暴露音量预测的伪提升
TVPara: Paralinguistic Captioning of Expressive TV-Series Speech in Complex Acoustic Environments · arXiv:2610.19678 · 邻近跟踪
研究问题与核心方法:大型音频语言模型(LALM,large audio-language model)在「强情绪 + 复杂声学环境」下很难描述语音的副语言属性(情绪、语速、音高、音量)。现有语料多为录音棚语音,情绪与声学多样性不足。作者用 19 部英语电视剧构建 TVPara:先用语音活动检测切成数秒片段,由 LALM(SALMONN-13B)预标注、LLM(GPT-4o-mini)润色措辞,再交给职业标注员逐条对音频纠错(删幻觉、补遗漏);积累约 50 小时纠错数据后回训预标注模型,再对剩余音频重跑一遍。数据分两个任务:单句副语言字幕(约 492 小时、256,212 条)与多句副语言字幕(约 213 小时、45,402 条,每条覆盖 3–5 条相邻话语,强调属性随时间如何变化)。140
关键结果:
- 数据属性拉开与干净语音的差距:67.2% 的 TVPara 片段带非中性情绪,VoxCeleb 只有 2.9%;36.2% 带背景声,VoxCeleb 8.0%;多句片段里 55.5% 的相邻话语情绪类别不同。140
- 标注成本可用两个数字追踪:标注员最初改动约 38% 的预标注,回训后降到约 17%;首批约 1 小时双标注的「是否需要改」一致率为 87%;多句合并字幕人工只改了约 4%。140
- 微调增益:SFT 相对零样本的逐格平均相对提升为 31.26%,多数增益在逐片段 Wilcoxon 符号秩检验下 p<0.01。140
- 关键的「伪提升」反证:SALMONN 微调后预测的音量档位与实测片段能量的 Spearman ρ 从 0.03 升到 0.85,说明增益至少部分来自真实声学感知;Qwen2.5-Omni 的同一相关性微调前后都在 ρ≈0.03,只是把输出分布推向训练标签。140
- 泛化:在未见剧集上,带背景声片段的逐格平均相对提升 32.4%,不带背景声的仅 19.9%;转到更干净的 VoxCeleb 时 SALMONN 四个属性全部提升(音量 ρ=0.73),未见剧集上音量 ρ=0.87。140
证据与局限:评测是 LLM-as-a-Judge(GPT-5-mini)在文本层比对属性、按 0–4 打分,判官不接触音频,声学感知完全由人工纠错后的标签提供,因此该分数只衡量「描述与标签的一致性」,不是语音理解的人评;原文未报告判官本身与人的一致性。数据质量只有间接指标(87% 双标注一致率、多句 4% 改动率)。只微调了两个模型(SALMONN、Qwen2.5-Omni),超参固定、未报告种子数;跨域集 VoxCeleb 只有 134 条。作者给了一个很有用的机制解释:Qwen2.5-Omni 的音频适配器可训练参数约为 SALMONN 的 1/690,音频 token 在微调中几乎不变,因此无法编码全部副语言属性——这条解释本身未经消融验证。140
与目标研究线的连接点:它在 C 线之外,但连接的是一件相当具体的东西——「预测属性 vs 实测声学量」的相关性对照。任何用 LLM 判官给音频生成打分的工作都该加这一步,否则分不清模型学到的是声学还是标签分布;TVPara 自己就靠这个对照发现 Qwen2.5-Omni 的增益是分布拟合。另外两个可搬的是「LALM 预标注 → 人工纠错 → 回训预标注器」的飞轮(改动率 38%→17% 是可复用的成本指标),以及把「属性跨相邻话语如何变化」单列为任务,用于长节目/播客的韵律评测。140
结论建议:读 §2.2 的标注流水线、表 1/表 2 的数据属性、§4.1 含 ρ 对照的结果段、§4.2 的分布外结论。项目页 [https://windowso.[github.io/TVPara/](https://windowso.github.io/TVPara/)](https://github.io/TVPara/](https://windowso.github.io/TVPara/)) 实测 HTTP 200,含样例音频;文章声明只发布副语言标注加源视频链接与时间戳,不发布音频本体,引用前要确认自己的口径允许这样取数据。140
13. ONCship:4521 小时水下声学语料,联合预训练把 DeepShip 线性探针准确率做到 62.45%
ONCship: A Large-Scale Underwater Acoustic Corpus for Ship Recognition · arXiv:2610.19722 · 邻近跟踪
研究问题与核心方法:这篇不是语音合成或长程智能体工作,而是一个大规模领域音频语料及其评测设计。作者用 Ocean Networks Canada(ONC)的长期水听器录音加 AIS(Automatic Identification System,船舶自动识别系统)报文,从约 20000 小时原始录音经轨迹清洗插值、空间关联、30 秒时间格标注、分段与 10 秒切片,得到 4521 小时的 ONCship,含单船、多船、无船与未下载 AIS 四类区间。评测分三块:用同一套 Efficient Audio Transformer(EAT)架构与预训练目标做 AudioSet、ONCship、两者联合三种自监督预训练的对照;把 ONCship 当增训数据做船型分类微调;以及把每条船当作独立身份的 MMSI 级识别(MMSI 为海事移动识别码,此处充当身份标签)。141
关键结果:
- 语料构成(表 3):单船带船型标注 3106.8 小时、多船 929.1 小时、单船无标注 38.4 小时、无船 7.4 小时、未下载 AIS 的 USSLP 439.3 小时,合计 4521 小时;原始元数据 24 个船型标签去掉 Reserved 与 Unknown 后为 22 类,分布长尾。
- 预训练对照(表 5,EAT 线性探针):DeepShip 上仅 ONCship 的 NMI(归一化互信息,K 均值聚类与真实标签的一致度)0.2021、检索 AUC 0.6437,高于仅 AudioSet 的 0.1877 与 0.6297;联合预训练取得最高 AUC 0.6540 与准确率 62.45%。ShipsEar 上仅 AudioSet 的 NMI 与 AUC 最好,但联合预训练的准确率 76.18% 最高,比仅 AudioSet 的 70.40% 高 5.78 个百分点。
- 与外部对比方法比(表 6):EAT 联合预训练在 DeepShip 上 62.45% 准确率、62.49% 加权 F1,比 ResNet18(LARS) 的 57.78% 与 56.00% 高 4.67 与 6.49 个百分点;ShipsEar 上 76.18% 与 77.25%,比 43.94% 与 42.00% 高 32.24 与 35.25 个百分点。
- 增训(表 7,三次重复的均值加减标准差):BEATs 从仅 DeepShip 的 68.11±3.95 升到同水听器增训的 69.41±2.22、异水听器增训的 68.85±4.43;EAT 从 65.64±5.96 升到同站 68.16±3.75,异站只到 65.95±5.16;ResNet50 反而从 39.45±7.94 降到 36.38±6.86。
- MMSI 级识别(表 8,50 个身份、100 小时):交叉熵损失 Top-1 0.5312、Top-5 0.6957、宏 F1 0.5307,ArcFace 损失 0.5320、0.6892、0.5333。141
证据与局限:微调实验报三次重复的均值与标准差,预训练对照是单次点估计。预训练子集刻意剔除 DeepShip 所用的 FAE 与 LSBBL 两个站(留 3905 小时),MMSI 评测还要求同一分钟源片切出的 10 秒片段只落在一个划分里——这两条防泄漏设计是本文最值得借的部分。局限:全文没有专门一节讨论局限;原文未给出数据集下载入口,只在正文写明数据来源为 ONC(其站点 https://data.oceannetworks.ca/ 实测 HTTP 200),因此“4521 小时”这一规模目前无法由读者直接复核。141
与目标研究线的连接点:连接点不在船舶识别本身,而在两件可搬走的评测设计。其一,以身份(MMSI)而非类别做划分,并把同一源片段的切片锁进同一个划分,避免相邻片段跨集造成虚高;其二,“同水听器 / 异水听器增训”这组对照直接量化了增训数据与测试分布同源时收益才明显(EAT 上同站升 2.52 个百分点、异站只升 0.31)。音频侧要建领域语料时,这两条口径比语料规模本身更有用。141
结论建议:只看第 3.3 节(表 3、表 4 的时长与类别分布)与第 4.3–4.5 节的协议描述;表 5 至表 8 用来判断“领域预训练是否普遍有用”——本文给出的答案是因指标与数据集而异,所以引用时不要写成“领域数据一定更好”。141
14. SEA-HELM Audio:语音输入让多选推理掉 9.00–18.50 分、指令跟随掉 20.00–42.86 分
SEA-HELM Audio: Evaluating Multilingual ASR-LLM Pipeline Performance Across SEA-HELM Subsets · arXiv:2610.19869 · 邻近跟踪
研究问题与核心方法:文本基准的高分不能保证语音智能体可靠,作者把只含书面提示的 SEA-HELM(Southeast Asian Holistic Evaluation of Language Models,东南亚语言模型综合评测)改造成含语音输入的 SEA-HELM Audio:同一批提示分别走「TTS(text-to-speech,文本转语音)合成→ASR(automatic speech recognition,自动语音识别)转写→LLM(large language model,大语言模型)回答」的语音路径与直接文本路径,两条路径共用同一个 LLM 与同一套规则式验证器,用 Δ=Score_text−Score_speech 量化(Score_text 是文本输入的准确率、Score_speech 是语音输入的端到端准确率)「说出来比打出来多掉多少分」。覆盖中文、英语、马来语、印尼语、泰米尔语五种语言,任务取 SEA-HELM IFEval(指令跟随)与 Global-MMLU-Lite(四选一)。142
关键结果:
- 多选(Global-MMLU-Lite,每次运行 400 题,TTS 用 OmniVoice):中文 Δ 在 9.00–10.75 分之间,英语差得多,为 15.50–18.50 分;例如英语 Qwen3-ASR-1.7B + SEA-LION-4.5-27B 为语音 69.00 对文本 87.50(Δ=18.50),中文同配置为 71.50 对 80.50(Δ=9.00)(表 3)。142
- 指令跟随(SEA-HELM IFEval,每次运行 105 题,TTS 用 ElevenLabs v3):Δ 扩大到 20.00–42.86 分(§5.2 表述为 20 到 43 分);泰米尔语最严重,MERaLiON3-ASR-3B 管线为语音 47.62 对文本 87.62(Δ=40.00),商用管线同样 Δ=40.00(表 4)。142
- 商用栈(ElevenLabs Scribe Realtime + Gemini 3.5 Flash)语音准确率普遍更高,但文本侧 SEA-LION-4.5-27B 在印尼语 IFEval 上反超(94.29% 对 89.52%),作者据此判断开放权重管线的瓶颈在声学转写层而不是 LLM 的区域推理能力。142
- 任务结构影响 Δ 的机制:多选只要求认出关键概念,LLM 常能从带噪声的转写里恢复;IFEval 逐条校验提示里的词法、长度与格式约束,ASR 一旦丢掉约束词,回答的就是「另一道题」,规则验证器直接判失败。142
证据与局限:样本量为每次运行 400 题(多选)与 105 题(指令跟随),只报点估计,原文未报告置信区间、重复次数或种子;两个任务的 TTS 引擎不同(OmniVoice vs ElevenLabs v3),跨任务比较 Δ 时不能把差异全归给任务类型。SEA-HELM NLU QA 与 Safeguard 子集原文列为 future work、未评测。原文未给出代码或数据入口(arXiv 摘要页与全文均无仓库或数据页链接)。142
与目标研究线的连接点:属于 C 线语音侧评测这一环而非 TTS 生成本身;可搬走的一件东西是「同一验证器、双路径对照」的语音落差口径——把文本分当上限、语音分当端到端分,差值为模态惩罚,可直接移植到自建语音智能体或口语化播客前端的回归测试。与同节 CAFE 相比,一个测「说话进来掉了多少」,一个测「紧凑语音表征怎么蒸馏」,都落在语音侧表征与评测。142
结论建议:读 §2.3 与 §3(口径与流程)、§4 表 3 与表 4、§5.2;引用时必须限定为「合成语音 + 规则式验证器 + 五语言」的设置,并说明 Δ 是相对同一 LLM 文本上限的差值,不是绝对能力分数,也不能外推到真人语音。142
15. AUPR 23.0→64.0、TPR@FPR 0.1% 9.4→60.6:用单个故障的样本做少样本适配
Few-Shot Adaptation for Anomalous Sound Detection at Low False-Positive Rate · arXiv:2610.19893 · 邻近跟踪
研究问题与核心方法:工业现场(炼铁高炉原料场)的异常声音检测要求极低误报率,而已有系统一旦要在 0.1% 误报下工作就几乎检不出故障。作者用两步法:只有正常运行音频时,用卷积变分自编码器(CVAE)把对数梅尔谱压到 16 维隐空间,再用高斯混合模型(GMM)对隐向量建模正常分布,异常分数取隐向量的负对数似然,并在 GMM 上协方差正则以稳定估计;第一次故障发生后,用该次故障的少量异常样本微调 CVAE,同时把 GMM 冻结成正常分布的参照,避免少量异常样本把正常分布一起带偏。
关键结果:
- 协方差正则先改善无监督阶段:平均 AUPR 从 20.0 提到 23.0,10 次训练的 AUPR 标准差从 8.0 降到 6.2。
- 少样本适配再把平均 AUPR 从 23.0 提到 64.0;低误报区指标同步改善:pAUROC(限定在 FPR≤1% 区域的偏 AUC)从 39.6±0.9 升到 72.8±0.4,TPR@FPR 1% 从 64.4±1.0 升到 89.3±0.0,TPR@FPR 0.1% 从 9.4±0.8 升到 60.6±0.1。
- 未做正则的基线 UNS 为 pAUROC 35.5±1.2、TPR@FPR 1% 58.0±1.4、TPR@FPR 0.1% 7.5±0.8,即适配前在 0.1% 误报下平均检不出十分之一的异常样本。
- 逐折看,pAUROC 从 UNS 的 42.4/19.6/44.4 升到 75.2/64.5/78.7;作者据此指出样本极小时绝对数值对训练–测试划分很敏感。143
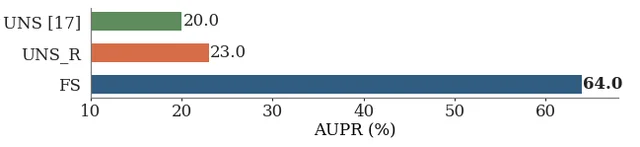
无正则无监督、加协方差正则、少样本适配三种方法的 AUPR 对比(arXiv:2610.19893)
证据与局限:所有指标是 10 个随机种子的均值±标准差;三折配置下每折只用一个故障机器的样本训练、在另两台故障机器上测,全局指标取三折平均。数据来自真实运行的原料场:麦克风距振动筛线约 5 米、48 kHz、声压约 95 dB、现场有 13 台同时运行的振动筛,正常数据为 CVAE 训练 60,000 秒、GMM 拟合 60,000 秒、独立测试 71,200 秒,故障数据只有 400 秒(三台机器分别 120/220/60 秒)。局限:故障是现场物理复现(断簧、脱落的金属板)而非自然故障;两个损失边距 mN=−20、mA=500 是手工从适配前分布选的,因为既没有独立故障验证集、又不能用测试故障以免泄漏;作者自陈未来要做更多故障类型、更长部署与超参敏感性分析。原文未给出代码或数据入口,现场录音不可公开复现。另需注意 AUPR 来自图 3、pAUROC 与 TPR 来自表 I,两组数值不可相加或互换。143
与目标研究线的连接点:在音频侧评测口径上,它把「低误报工作点」当主指标——pAUROC 只统计 FPR≤1% 的区间,并额外报固定阈值下的 TPR@FPR 1% 与 TPR@FPR 0.1%,而不是只给全局 AUROC/AUPR。本线在语音合成与音频评测里同样容易只报整体相关指标,这个做法可以直接搬走。另一件可搬的是适配的对称设计:冻结正常分布参照、只微调特征提取器,并对异常样本做时移、裁剪、幅度缩放与频谱着色的增广。143
结论建议:可只读 §II-C(少样本适配损失)、§III-D 与表 I,图 3 给出 AUPR 的三段对比。若要在自己的音频任务上做少样本适配,先照抄「冻结参照分布 + 微调编码器 + 在固定低误报阈值上报告 TPR」这套口径;引用 64.0 或 72.8 时必须限定这是单一钢铁厂实测录音、故障为人工复现、且无公开数据可复现。143
16. 声学-语义冲突诊断:四类冲突 ASPIRE 上 ACR-Net ACC 68.4 对 FAS 42.5(极性冲突)
ACR-Net: Mitigating Semantic Dominance via Contrastive Acoustic-Semantic Decoupling · arXiv:2610.20114 · 值得扫读
研究问题与核心方法:本文作者来自北京邮电大学。语音情感识别(SER)模型与音频大模型在语气与文本语义矛盾时会倒向文本,作者称之为语义主导(Semantic Dominance)。该文先用 EmotiVoice 合成对抗性音频-文本对基准 ASPIRE,覆盖四类结构性冲突,并给出两项诊断指标:语义过度自信惩罚(SOP,取文本模态概率优势正部的均值,越高越偏文本)与潜空间解耦程度(LDD,声学与语义池化表示的余弦距离,越高越解耦)。方法 ACR-Net 用冻结的 Whisper-Medium 编码器加 LoRA(低秩适配)做声学流、冻结的 Whisper 文本编码器做语义流,用跨模态注意力做冲突检测,并用对比解耦损失把矛盾表示推入正交子空间。144
关键结果:
- 基准构成(第 2 节):1,800 条提示经 EmotiVoice-1.5B 生成 1,523 段音频,逐级过滤后得 1,200 条(800 冲突、400 正常),5 折交叉验证每折 960 训练与 240 验证,另加 200 条独立测试集;冲突由 4 种目标声学情绪(中性、悲伤、惊讶、愤怒)与 7 种文本情绪交叉出的 24 种非一致组合构成,保留 19 种,归为极性相反、唤醒相反、效价相反、情绪掩蔽四类(表 1)。144
- 表示策略对照(表 2):朴素拼接 ACC 41.2、SOP 0.824、LDD 0.108;张量融合 43.8/0.776/0.115;MCR 重加权 48.5/0.628/0.242;只用跨模态注意力 53.0/0.534/0.334;只用解耦损失 62.1/0.253/0.697;ACR-Net 最优配置(λ=0.1、m=0.5)76.5/0.128/0.864。144
- 四类冲突(表 4):极性相反上 MCR 为 ACC 35.2、SOP 0.612、LDD 0.205,FAS 为 42.5/0.548/0.288,ACR-Net 为 68.4/0.185/0.812;唤醒相反上 ACR-Net 为 85.2/0.092/0.885。144
- 标准一致语料(表 3,ACC %):ACR-Net 在 EmoDB 88.5、SAVEE 88.6、RAVDESS 93.1,均高于 MCR 的 80.4/81.4/91.8 与 FAS 的 83.2/83.8/92.0;但 CASIA 上 Qwen2-Audio 的 91.8 高于 ACR-Net 的 86.8。144
证据与局限:冲突数据为合成,作者用 emotion2vec+ 置信度(低于 50% 或不匹配即弃)与专家听审过滤,但规模仅 1,200 条、5 折,未报告多次训练种子或置信区间;作者也承认 TTS 在极性相反对上保留率只有 45%,说明基准自身生成有偏。入口实测:
https://arxiv.org/html/2610.20114v1/ 在反爬拦截下改用抓取工具可取得全文;原文给出的代码与数据入口 https://github.com/zmkshakespar/ACR-Net 实测 HTTP 200。引用风险:ACC 与 SOP/LDD 都是在自建合成集上的数值,不能当作真实对话场景的性能。144与目标研究线的连接点:与同节语音侧工作的连接点是「把模态冲突做成变量可控的合成基准,再用表示正交度做诊断」;可搬走的一件东西是「冲突样本合成与过滤流水线 + SOP/LDD 这对指标」,用来检查任何音频或语音模型是否被参考文本带偏。144
结论建议:若要用,先看第 2.1 节(合成与过滤)与表 2、表 4;可搬其「跨模态注意力」与「解耦损失」的分开消融口径;引用时必须限定为合成对抗集上的结果,并说明无种子与区间。144
17. Opus 感知透明:128 kbps 被判有损(p=0.030),160 kbps 通过等价检验(p=0.024)
Evaluating perceptual transparency of lossy music audio compression with Opus codec · arXiv:2610.20246 · 邻近跟踪
研究问题与核心方法:Opus 是流媒体常用的开源音频编解码器,但它对音乐在高码率下的「感知透明」阈值(压缩后与未压缩 CD 无法区分)缺少正式评估。作者用两阶段 ITU-R BS.1116-3(ABC/HR:双盲、三刺激、含隐藏参考的主观听测)框架评测,用线性混合效应模型(LMM,linear mixed-effects model)把码率的固定效应与听众敏感度、样本编码难度的随机效应分开,再用 TOST(Two One-Sided Tests,双单侧等价检验,边界 Δ=±0.25 分)检验「与未压缩参考等价」。作者来自 Deezer Research。145
关键结果:
- 第一阶段(26 名听众、23 段音乐、32/64/128 kbps):事后筛查剔除 5 人(2 人违反强制选择、3 人未通过 32 kbps 锚点判别)后剩 21 人。128 kbps 平均 Diffgrade(压缩样本得分减参考得分)为 −0.082(95% CI [−0.298, 0.134],p=0.456),与参考不可区分;64 kbps 为 −0.438、32 kbps 为 −1.661(均 p<0.001);但严格等价检验下 128 kbps 以 p=0.064 未通过。145
- 第二阶段用第一阶段 LMM 的 BLUP(best linear unbiased predictor,最佳线性无偏预测)挑出 10 名最苛刻听众与 8 段最暴露伪影的样本做压力测试(32/96/128/160 kbps,每人 32 次试听):128 kbps 被判有损(−0.236,95% CI [−0.449, −0.023],p=0.030);96 kbps 为 −0.217(p=0.045);32 kbps 为 −2.982(p<0.001);160 kbps 为 −0.035(95% CI [−0.248, 0.178],p=0.747)并通过 TOST 等价检验(p=0.024)。145
- 模型选择本身得到验证:随机效应的标准差从听众 0.346、样本 0.286(第一阶段)降到 0.118 与 0.195(第二阶段),说明筛选出的是一批同质且严苛的听众与整体更难的素材。145
- 语料与设置:23 段 = 7 段取自 Hydrogenaudio 参考基准的最坏样本 + 16 段自选;用 libopus 1.6.1 音乐模式(CELT)、非受限 VBR,23 段中有 17 段实际编码码率高于目标;全部归一化到 −23 LUFS(EBU R 128);封闭隔声间、Beyerdynamic DT 770 Pro(80 Ω)耳机并做平频校准。145
证据与局限:统计口径较硬,报告 95% 置信区间与 p 值,等价检验的容忍边界取自 ITU-R BS.1387(PEAQ)的 Δ=±0.25,且不作多重比较校正(作者给了理由)。但第二阶段只有 10 名听众与 8 段样本,属极端子集,结论不能外推到普通听众群体;作者自陈还需要更多样的发烧级设备与更广的专家听众抽样才能保证真实场景下的透明性。引用风险:「160 kbps 达到透明」成立条件包含这批耳机、隔声间、−23 LUFS 归一化与 Δ=±0.25;把 p=0.024 当成「已证明无差异」是过度解读,等价检验的结论依赖预设边界。145
与目标研究线的连接点:落在语音与音频侧的数据、表征与评测这条线上(编解码与声学表征、语音侧评测口径),是本单元唯一一篇把「与参考不可区分」写成可检验命题的文章。可搬走的一件:把「无显著差异」升级为「等价检验+效应量与置信区间」,以及用 BLUP 从混合模型里挑最苛刻评审者与最难素材做压力测试——这两件都能直接用在 TTS 主观评测与判官筛选中。145
结论建议:要搬方法读第 4.3 与 4.4 节(事后筛查、LMM 设定)与第 5 节等价检验段;要数字读表 1(两阶段各码率的均值、区间与 p 值)与图 2(TOST 森林图)。引用时必须限定码率、编解码器版本、编码模式与等价边界,且不要把压力测试子集的结论写成一般听众的结论。145
18. 神经算子做 HRTF 上采样:100 测点 LSD 2.3 dB(低 18%),重建快 15–373 倍
HRTF Upsampling and Personalization via Neural Operators · arXiv:2610.20400 · 邻近跟踪
研究问题与核心方法:论文把个性化双耳音频中的「头部相关传递函数(HRTF,刻画头、躯干与耳廓对声音的方向相关滤波)稀疏测量上采样」表述为算子学习问题,提出 SPARO:把稀疏方向上的 HRTF 观测经 branch 投影到一族可学习的球面隐模态,用 Transformer 块在潜空间建模模态之间的交互,再按查询方向与模态中心的角相似度插值解码,得到可在任意方向查询的连续 HRTF 场。对数幅度与双耳时间差 ITD 分别训练模型;测试时优化(TTO)只微调潜表征与输出头。 146
关键结果:
- SONICOM(LAP24 测量配置,测点数 M∈{3,5,19,100})上,SPARO 在每个稀疏度都取得最低 LSD(对数谱失真)与 ILD(双耳声级差)误差:100 测点时 LSD 2.3 dB、最强基线 IOA3D 为 2.8 dB,低约 18%;ILD 误差在 100 测点较最优基线低 43%(表 1)。 146
- 重建稠密 HRTF 比领先的神经场方法 RANF 快 15–373 倍(100 测点:SPARO 0.56 s 对 RANF 207.2 s);ITD 误差与最优方法相当而非最优(100 测点 SPARO 10.4 μs、RANF 10.0 μs)。 146
- 在模拟 HUTUBS 上对球谐基线 SUpDEq 与 RANF 全面更低 LSD,仅 6 个观测方向即达 3.39 dB,约相当于把所需测点数减少 4–6 倍;10 名留出被试在每个采样档都更优(表 2)。 146
- 消融:去掉局部交叉注意力(LCA)或 TTO 都在多档退化,LCA 的收益随测点数增加而增大,TTO 在各档都有帮助(表 3)。 146
证据与局限:训练用单张 A6000、1,024 个隐模态、4 个 Transformer 块、200 个 epoch;SONICOM 用与 RANF 相同的 20 名测试被试,HUTUBS 为模拟 HRTF、9 名留出被试(表 2 给均值±标准差)。SONICOM 上部分基线数值取自 RANF 原文,未全部独立复现;作者排除 SONICOM 中 ITD 异常的 P0079。未报告多次运行的种子波动。引用 LSD/ILD 数值时须注明指标只在不被观测的方向上计算。 146
与目标研究线的连接点:与 TTS 主线无直接关系。可搬的是「把稀疏、采样点可变的观测映射到连续场」的算子式建模,以及按稀疏度分档报告误差的评测口径——适合语音与音频侧任何需要从少量测量外推密集表征的任务(如个性化声学表征、编解码表征插值)。 146
结论建议:读第 2.3 节架构、表 1(SONICOM 按测点数)与表 3(消融)。可搬「球面隐模态 + 查询方向解码 + TTO」的结构与「按稀疏度分档、只在未观测方向计分」的口径。引用时限定:指标在未观测方向、SONICOM 部分基线取自原文、HUTUBS 为模拟数据。 146
19. vst-bench-ml:密封清单做离线完整性核验,两次全新进程复现 8 个输出哈希
vst-bench-ml: Auditable Dataset Generation for Audio Plugins · arXiv:2610.20465 · 邻近跟踪
研究问题与核心方法:用音频插件(VST3 等)生成数据集时,最难保留的是「每条音频观察是怎么产生的」。vst-bench-ml 是一个 Python 包:采样插件参数、通过单独安装的宿主(host)协调渲染,并记录软件身份、渲染设置与输出哈希;一个密封清单(sealed manifest)把这些证据绑在一起,支持不加载插件就做离线完整性检查。配套仓库提供无样本的 VST3 测试插件、确定性离线宿主,以及把渲染尝试与记录输出连起来的额外检查(保留尝试账本、预期拒绝证据)。证据分两条路:核心产物可脱离配套单独密封与核验,配套 fixture 工作流则把核心成功运行与宿主轨迹合并后再密封。作者 Youssef Hemimy(圣托马斯大学),投稿 Journal of Open Research Software,评审中。147
关键结果:
- 在固定 macOS arm64 与 Python 3.12.13 栈上,两个全新进程各自渲染并保留 8 条记录(4 组采样参数配置 × 2 个固定 MIDI 信号),两次复现同一渲染计划哈希与全部 8 个预期输出字节哈希。
- 12 个负例全部通过,覆盖替换包产物、错误插件身份、宿主不可达、参数格式错误、缺失归一化、越界值、复位/回读不一致、重复尝试、输出损坏与账本证据不全(Table 3)。
- 0.1.1 版本另做发布校验:包测试 31 项、配套测试 36 项通过,并再次复现计划摘与 8 个输出哈希;此前的 0.1.0 候选版本通过生产者侧持续集成与本地验证;负例集同样通过。
- 复用路径被明确分级(Table 4):生成观察、核验核心数据集、跑配套一致性检查属「已在固定栈上演示」;换宿主实现与改质量规则只是「提案」,各自需另行验证与版本化。
- 论文对证据边界给了明确否定式:这些检查只在被测环境内确立完整性与可重复性,不确立可移植性、科学适用性或感知质量。147
证据与局限:校验只用作者自写的 fixture、4 组参数、2 个 MIDI 信号与 8 条输出,跨机器或跨平台的重复次数原文未报告;未测量运行时性能、可用性、外部采用情况与下游模型表现;负例通过不等于覆盖所有失败,也不构成安全保证;fixture 的权利边界不延伸到第三方插件与音频。引用风险:这是软件类论文(JORS 投稿、评审中),可引用的是清单与校验设计,不可引用为性能或质量结论。入口实测:全文页与三个仓库/包页均实测 HTTP 200(https://github.com/itsuzef/vst-bench-ml-public、https://github.com/itsuzef/vst-bench-dataset-host-public 与 https://pypi.org/project/vst-bench-ml/0.1.1/)。147
与目标研究线的连接点:归入第十二节「邻近跟踪:语音与音频侧的数据、表征与评测」。可搬走的一件东西是 provenance 层:把「软件身份 + 渲染/生成设置 + 输出哈希」封进一个可离线校验的密封清单,并配一组负例清单来检验校验器本身——对音频或 TTS 数据集的版本化发布与渲染回归检查同样直接适用。它与同线偏模型/指标的论文互补:那些在比指标,这篇在保证「数据是怎么来的」可被事后审计。147
结论建议:读 Implementation and Architecture 一节的 provenance / ledger / offline verification 三段与 Table 3、Table 4;要发布音频数据集或做渲染回归检查可直接借鉴密封清单与负例设计。引用时必须限定为作者自建 fixture 与固定栈上的演示,不能当作对第三方插件、跨平台一致性或音频权利的可移植保证。147
十四、播客线覆盖说明与本期可迁移结论
第四条线是播客生成与节目级评估。本期候选池的 151 篇里没有任何一篇的生成对象或评估对象是播客、长节目或双人主持内容,D 线因此 0 篇。缺口与以往几期的性质不同,值得写清楚:本轮把 147 篇收录条目的原文再做一遍播客类关键词扫描(零命中),另外直接查 arXiv 全库摘要含 podcast 的条目(共 260 条,按提交时间排序,最新一条是 2026 年 10 月 10 日提交的韵律稳定性研究,用的是 MSP-Podcast 语料),再按「播客生成」「音频剧」一组词检索,命中最新的一条是 2610.18010《Fish Audio Drama 3 Technical Report》(2026 年 10 月 13 日提交,cs.SD):35B 混合专家骨干、每 token 激活 3B,支持多轮按指令返修、多角色场景配音、填补式编辑与流式输入,权重已在 GitHub 与 Hugging Face 开源。也就是说,这条线在本期之前两天还有新工作,它落在别处而不在 10 月 15 日这两栏的「新提交」名单里,本期读不到是候选口径的边界所致,不是方向零产。本期没有用任何替代品充当这条线。
本期跨节可以搬走的部件有五个。
其一,干预点正在从权重移到过程。 第一节与第十一节合起来给的是一条清楚的分工:不改权重的地方,可以改采样、改解码、改路由。REWIND 把推理中途的重生成从随机切点改成熵梯度回溯选点加接受判定,三个模型族五个基准的十五个组合上准确率全部最高 13;决策头把网页智能体的每一步点击从生成改成对冻结隐状态的分类,WebArena 上 4B 模型每步生成词元从 7.4 降到 3.1、准确率升 1.3 个百分点 16;解码侧同一批工作里,FOLD 给小窗口保精确位置、把更早的条目折叠成远内存 116,TreeSpark 与 ReaDy 则把投机解码的草稿树与循环状态学出来 114117。四篇的共同点是:把原来写死的过程参数变成一个可以学、可以验证的决策。
其二,凡是打算当门用的分数,先单独测这个分数。 第四、十、十三三节给了五条互相独立的证据:同一道题只换答案抽取协议,准确率从 20.8% 跳到 93.9% 2;挪威语 2B 模型的训练语料排名在两个评估设置下末端几乎相反(Kendall τ = −0.6)39;把 DROP 的答案换成等义变体,官方精确匹配从 100.0% 掉到 33.3% 40;把音频换成等长静音,音频大模型仍保住 +11.2 的增益,去掉选项后只剩 +2.3 6;榜单里越相似的模型越敢决断,决断乘子最高 ×1.37 9。五条指向同一件事:分数的方差里有一块属于测量工具,取用任何阈值之前先把这块量出来。
其三,记忆与上下文的收益要有独立对照才成立。 第二节把「压缩记忆」拆成三种比较——归零测依赖、单独重训测效用、常量输入测内容收益——九个系统三种子下,四个系统归零后掉分却仍劣于各自重训的替代 22。同节的其余几条给出方向:把前几层注意力换成测试时更新的外部神经记忆模块,QuALITY 从 23.87% 升到 40.51%,而平均相对解码耗时只有全注意力的 0.689 25;逐文档做测试时训练再整体蒸馏,把 RULER 的 32× 压缩分数从 40.0% 提到 96.7% 29。要复现这类收益,先按前一节的口径把对照补齐。
其四,自进化要有独立于自己的门。 第五节与第六节的证据方向一致:把权威交给团队里成长最快的成员,让 27 个多智能体配置里的 24 个优于各自独立进化,最好的组合在 GAIA 上比单独进化的强智能体高 25.0 分 48;按可迁移性逐条预测用户反馈该不该写进个人技能,三个基座五项写作任务的均值分别高出最强基线 1.61、1.13、1.32 分,把规则原子化这一步去掉就退到 78.93、82.22、85.23 47;具身智能体的按需自我改进只微调不可靠子步骤,RoboCasa365 上未见复合任务从 4.6% 升到 13.8%,而全量微调花 3.5 倍 GPU 时间还低 1.2 个百分点 52。造出来的东西由谁验、验到什么程度算过,基本决定了能力能走多远。
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
- 33
- 34
- 35
- 36
- 37
- 38
- 39
- 40
- 41
- 42
- 43
- 44
- 45
- 46
- 47
- 48
- 49
- 50
- 51
- 52
- 53
- 54
- 55
- 56
- 57
- 58
- 59
- 60
- 61
- 62
- 63
- 64
- 65
- 66
- 67
- 68
- 69
- 70
- 71
- 72
- 73
- 74
- 75
- 76
- 77
- 78
- 79
- 80
- 81
- 82
- 83
- 84
- 85
- 86
- 87
- 88
- 89
- 90
- 91
- 92
- 93
- 94
- 95
- 96
- 97
- 98
- 99
- 100
- 101
- 102
- 103
- 104
- 105
- 106
- 107
- 108
- 109
- 110
- 111
- 112
- 113
- 114
- 115
- 116
- 117
- 118
- 119Copy-Paste Language Models
arxiv.org
- 120
- 121LLM-jp-4 Technical Report
arxiv.org
- 122
- 123
- 124
- 125
- 126
- 127
- 128
- 129
- 130
- 131
- 132
- 133
- 134
- 135
- 136
- 137
- 138
- 139
- 140
- 141
- 142
- 143
- 144
- 145
- 146
- 147
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.