猜 5090 快两倍得到三格答案、跑五遍把第一遍的冠军换掉、六张 2016 年的卡凑出 192GB 跑 52.5 tok/s
六组今天的实测:同一个模型改两个采样参数差 10.1 分、单跑六发六中的那个跑五遍只剩一分之五、他猜 5090 快两倍得到三格答案、六张 2016 年的卡 500 美元凑出 192GB 跑 52.5 tok/s——每组都写明先入为主被推翻在哪一格,以及作者自己承认的条件。

昨天傍晚 7 点整,公众号「陆兮科技 LuxiTech」发出手机端实测:16GiB 内存的骁龙旗舰跑 35B-A3B1。
预填充 470.661 tok/s,生成 14.262 tok/s,峰值内存约 5GiB。
今天凌晨 4 点 01 分,X 上 @JeremyCMorgan 转出一份编译题对照:五个本地模型在同一台 GB10 上各跑五遍2。
下午 1 点 26 分,r/LocalLLaMA 的 /u/KienShen 贴出 138 道双语 agent 题的小模型成绩3。
下午 1 点 55 分,小红书「汤包 Matthew」发出 5090 对 DGX Spark 的对照,标题写着「我猜错了」4。
傍晚 6 点 52 分,r/LocalLLM 的 /u/WiseAbalone4021 把六张 2016 年的 Tesla M10 拼成 192GB,单流跑出 52.5 tok/s5。
本期覆盖 11 月 3 日傍晚到 11 月 4 日傍晚。来源是 Reddit 的两个本地模型版块、X、小红书与公众号。
这六组材料有一点相同:动手之前,每个人都先有一个判断。
有人判断某个模型明显更强,有人判断某张卡一定更快,有人判断一台机器根本不该拿来算 AI。
六次实测把这个判断各自推翻在一格上,方式却不一样:有的是再跑四遍就变了,有的是换个采样参数就变了,有的是装不下就反过来。
| 材料 | 动手前那个判断 | 量出来的那一格 |
|---|---|---|
| 五个模型六个语言2 | 第一遍里 gpt-oss-120b 六发六中,就是它了 | 五遍后 Go 并发题只过 1/5,Qwen3.8-27B 以 28/30 最稳 |
| 9 个 4B 以下模型3 | 参数越大分越高 | 1.7B 开思考 63.8%,4B 不开 50.0% |
| RTX 5090 对 DGX Spark4 | 5090 快两倍 | 装得下时快 3.6–5.6 倍,跑 120B 打平,读长提示反而慢 4 倍 |
| 六张 Tesla M105 | 问谁都说不能拿来算 AI | 192GB 显存 500 美元,单流 52.5 tok/s |
| 同一个 DeepSeek 三台机6 | 卡越贵越快 | 单张 5090 只放得下 17% 专家,28.2 tok/s 垫底 |
| 手机跑 35B-A3B1 | 手机跑不动 | 厂方自测 prefill 470.661、decode 14.262 |
一、同一套题跑五遍,最快的两个掉到队尾
这条能进视野,是因为它今天凌晨被转上了 X。
原文写在 10 月 27 日,10 月 30 日又追加一节,作者 Boris Ivanov 是明尼苏达的工程师7。
机器是一台 ASUS Ascent GX10,也就是 NVIDIA GB10、128GB 统一内存。
跑得下的模型用 Ollama,跑不下的用 llama-server。
题是六个语言各一道:Rust、C++、Python、Go、TypeScript、React。
每道题有固定签名与隐藏测试,裁判是 cargo、g++、pytest、go test、tsc,不是人眼。
每个模型跑五遍,温度 0.2,输出上限 32k。「出结果平均」只算通过的那些次——你等一个能用的答案要等多久,就是这一列。
| 模型 | 编译过 | 测试过 | 墙钟中位 | 出结果平均 | tok/s | 抖动的题7 |
|---|---|---|---|---|---|---|
| Qwen3.8-27B Q4_K_M | 30/30 | 28/30 | 54 秒 | 57 秒 | 31 | Go 线程池 4/5、Rust 日期 4/5 |
| gpt-oss-120b MXFP4 | 30/30 | 26/30 | 22 秒 | 27 秒 | 39 | Go 线程池 1/5 |
| DeepSeek V4 Flash IQ2_XXS | 26/30 | 25/30 | 118 秒 | 169 秒 | 20 | Go 3/5、React 4/5、Rust 3/5 |
| Qwen3.6-35B-A3B Q6 | 18/30 | 17/30 | 22 秒 | 24 秒 | 95 | Rust 2/5 |
| Nemotron 3.5 Lightning IQ4_NL | 18/30 | 15/30 | 42 秒 | 34 秒 | 86 | C++ 2/5、Go 2/5、TS 1/5 |
第一遍只跑六道题时,gpt-oss-120b 六发六中,看着就是全球最划算的那一个。
作者也这么写了,然后把每道题重复到五遍。
结论翻过来:它的 Go 并发题五遍只过一遍,Qwen3.8-27B 以 28/30 成了这批里最稳的一档。
他的原话是「一次运行不是一次测量,报区间,不要报均值」7。
速度那一列更反直觉。Qwen3.6 出 95 tok/s、Nemotron 出 86,两个跑得最快的通过数只有一半上下。
两个最慢的反而最可靠。
10 月 30 日他把题量从 6 道扩到 36 道,同机同设置又跑了一遍:
| 模型 | 编译过 | 测试过 | 墙钟中位 | tok/s7 |
|---|---|---|---|---|
| gpt-oss-120b | 32/36 | 30/36 | 24 秒 | 42 |
| Qwen3.8-27B | 30/36 | 28/36 | 69 秒 | 32 |
| DeepSeek V4 Flash | 29/36 | 27/36 | 208 秒 | 15 |
| Qwen3.6-35B-A3B | 23/36 | 20/36 | 35 秒 | 96 |
| Nemotron 3.5 Lightning | 20/36 | 17/36 | 77 秒 | 88 |
题量一大,头名又换了,gpt-oss 反超 Qwen3.8,队尾没动。
这张表只有一轮。作者自己标了「是没测量的先看一眼」,也说了不能跟上面那张比。
一个是六题五遍,一个是三十六题一遍;DeepSeek 还有五道题撞了 30 分钟请求上限,全算失败。
他还手写了同一个提示,让四个模型各答一次,用来分清「快」和「对」不是一回事。
Nemotron 93 tok/s、27 秒,答案用英文写,只处理了日期。
gpt-oss 44 tok/s、95 秒,编了一个不存在的 chrono 0.5。
Qwen 30 tok/s、73 秒,干净,漏了一行
use Datelike。DeepSeek 17 tok/s、659 秒,代码最好,思考烧掉 11k token。
他试过给 DeepSeek 的思考加 2048 token 上限:快四倍,答案编译不过。
最后一条自陈比别人的都狠:第一轮那些失败里有一半是他自己的问题。
机器上没装 Rust、Go、TypeScript 的工具链;模型返回的代码没加 Markdown 围栏,被判读不出来;给推理模型的 token 预算给低了。
现在脚本第一件事是检查裁判在不在。
这条在 X 上没什么动静:1 条回复、266 次浏览。能拿来判断的就是那两张表和作者自己写下的折扣。
二、同一个 4B,只改两个采样参数就差 10.1 分
r/LocalLLaMA 这条来自 /u/KienShen,发的是 CamThink 团队自己的评测。
数据截到 10 月 29 日,文章 11 月 2 日发布,今天上午才在版块里贴出来。
这家做的正是 NeoMind 端侧 AIoT 平台和 NG4500 边缘盒子——评测方同时是平台方8。
题目是 69 个案例,每个写中文版和英文版,共 138 个样本;NeoMind 1.2.3,32K 上下文。
判定不用 LLM 判官。每条先要求命令真的跑成功,再由脚本检查设备、规则、看板的状态到没到预期值,两条都满足才算过。
九个模型,1.7B 到 4B,基本是 Q4 量化。下面这张是关思考的成绩:
| 模型 | 参数 | 总通过 | 中文 | 英文8 |
|---|---|---|---|---|
| DeepSeek-flash(云) | — | 81.2% | 82.6% | 79.7% |
| GLM-5.3(云) | — | 76.8% | 78.3% | 75.4% |
| Nanbeige4.2-3B | 3B | 60.2% | 55.6% | 64.8% |
| Qwen3.5-4B(T1.0) | 4.4B | 51.4% | 56.5% | 46.4% |
| Spark-X2.6-4B | 4.1B | 50.0% | 46.4% | 53.6% |
| Spark-X2.6-1.7B | 1.7B | 43.5% | 42.0% | 44.9% |
| LFM3-1.7B | 1.7B | 42.8% | 42.0% | 43.5% |
| Qwen3.5-4B(T0.7) | 4.4B | 41.3% | 40.6% | 42.0% |
| LFM2.5-2.6B | 2.6B | 36.2% | 36.2% | 36.2% |
| MiniCPM5-2B | 2.5B | 33.3% | 约 33% | 约 33% |
| Gemma-4-E2B | 约 2.6B | 26.1% | 27.5% | 24.6% |
Qwen3.5-4B 出现两次,是同一个模型、同一台机器,只换了采样参数。
按模型卡推荐的 T0.7/P0.8 是 41.3%,改成 T1.0/P0.95 是 51.4%——10.1 分,排名从第八跳到第四。
另外两个 LiquidAI 模型起步分更低,原因也在这里。
LFM2.5-2.6B 在错误配置下 24.6%,改到 T0.1/K50/rep1.1 是 36.2%;LFM3-1.7B 从约 20% 到 42.8%。
作者说模型卡上没写 top-p,他们不替它编一个值。
开思考之后,参数量那个排序彻底散了。
Spark-X2.6-1.7B 从 43.5% 升到 63.8%(中文 58.0%、英文 69.6%),是这批本地模型的最高分。
Spark-X2.6-4B 从 50.0% 到 59.4%,Qwen3.5-4B 到 55.1%。一个 1.7B 开思考,赢过所有 4B 关思考。
思考帮在哪也分模型。MiniCPM5-2B 从 33.3% 到 45.7%,涨的全在单步题:单步 58.2%,多步只有 15.0%。
它买到的是执行准确率,不是规划能力。
LFM3-1.7B 只涨 4.3 分,原因在 harness 不在模型。
每轮 ReAct 要吐 1,500–5,400 个思考 token,常常超过 300 秒;平台的思考看门狗这批响了 36 次,每次截断都作废那一轮。
多步题就一路塌下去,作者说这个 47.1% 更接近这套 harness 给的下限。
速度那一栏单独在 Jetson Orin NX 上量,8GB 模组与 16GB 整机两台,重叠数据差 2% 以内。
LFM3-1.7B 单流 49.0–49.3 tok/s;上下文推到 120K 还剩 28.6,保住约 59%,240K 深还有 20.1。
MiniCPM5-2B 掉得最狠,120K 深只剩约 4 tok/s。
八路并发的合计吞吐反过来:MiniCPM5-2B 约 183,Spark-1.7B 约 131,LFM3 约 125,LFM2.5 约 92,Spark-4B 约 81。
作者把口径写在最后一节:138 道题里一个百分点约等于 1.4 道题,4 到 5 分以内的差别不要当成能力差。
榜上记的是「模型 × 配置」,不写配置的名次没有意义;各模型跑在不同主机上,所以不报跨模型的延迟对比。
还有一条要读者自己留神:Nanbeige4.2-3B 的 60.2% 只跑完 108 道题,其余被显存卡住。
它是这批里唯一的全量注意力模型,32K 的 KV 缓存比别家大得多,作者说完整重测光 KV 就要约 14GB。
三、他猜 5090 快两倍:三格答案,其中一格反过来
小红书「汤包 Matthew」这条发出时 2 个赞、0 条评论,还没形成讨论。
作者写了两件事:两台机器都是自己买的,没有赞助;每边一台,家用环境,数字仅供参考4。
方法是同一个模型、同一段提示,插座逐秒记电。他动手前的判断写在标题上:5090 快两倍。
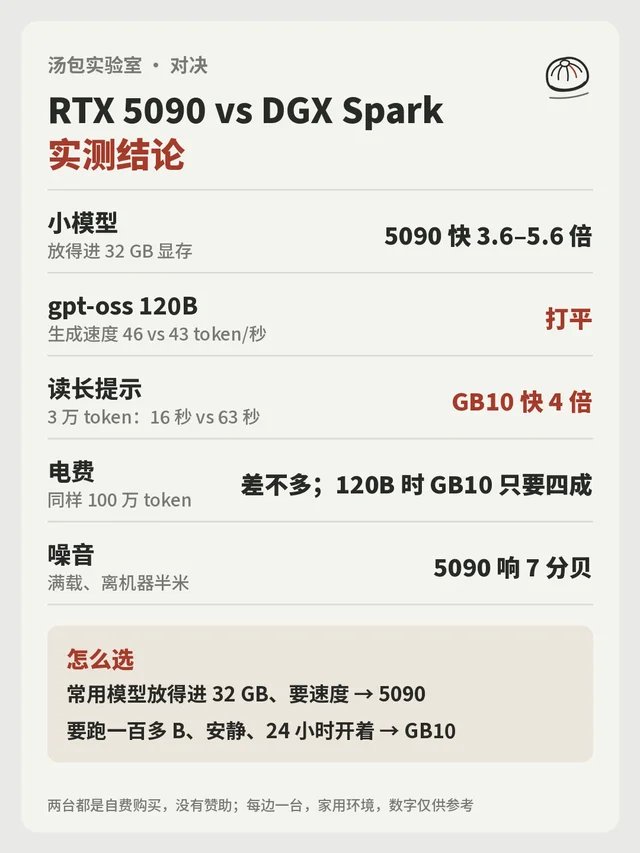
| 场景 | 结果 | 具体读数4 |
|---|---|---|
| 小模型,装得进 32GB 显存 | 5090 快 3.6–5.6 倍 | — |
| gpt-oss 120B 生成 | 打平 | 46 对 43 token/s |
| 读 3 万 token 的长提示 | GB10 快 4 倍 | 16 秒对 63 秒 |
| 同样 100 万 token 的电费 | 差不多 | 跑 120B 时 GB10 只要四成 |
「快两倍」这个猜测在第三行翻了:模型装不进 32GB,显存就不是主战场,读提示被内存带宽按住。
作者给的选择很干脆:常用模型放得进 32GB、要速度,选 5090;要跑一百多 B、要安静、24 小时开着,选 GB10。
限制也得写在旁边:只有一条笔记,没说重复次数,没写量化档、推理框架、提示长度,也没有第三方复现。
能拿的只有那张卡上的五格结论。
四、六张 2016 年的卡凑 192GB,单流 52.5 tok/s
r/LocalLLM 的 /u/WiseAbalone4021(账号背景未公开)开头先把常识摆出来。
Tesla M10 是 2016 年的 Maxwell,每张卡由四颗 GM107 用内部 PCIe 交换拼成 32GB,单颗 83 GB/s、约 1.67 TFLOPS。
他问过一圈,包括 Claude 和 ChatGPT,答案都是「不能用来算 AI」5。
一张 32GB 的 M10 二手约 80 美元,六张 500 美元,凑出 192GB。
理论带宽 4×6×83 约 1,992 GB/s,跟一张 RTX PRO 6000 Blackwell 同量级——后者只有 96GB,价钱贵一个数量级。
机器是当年那代家用件:ASRock B250M Pro4、i5-6400 四核、32GB DDR4,主卡一张 RTX 3070 Ti。
六张 M10 挂在 PEX8748 交换芯片后面,每张走 Gen3 x4,两个电源,650W 与 1650W。
装上就撞第一堵墙:主板看到 25 个 PCI 设备,开不了机。
他把原因挖到 BIOS 的 legacy I/O 端口只有 64 KiB、每个 PCI 桥 4 KiB 窗口,塞不下这么多交换端口。
绕法是改内核保留 PCIe 拓扑,先只开第一个电源启动,进休眠,再开第二个电源唤醒。
算力怎么分:RTX 3070 Ti 只跑注意力、GDN 和路由。
512 个路由专家切到 20 颗 GM107 上,每颗拿每个专家的 32 行中间维;第六张 M10 单独跑共享专家,保持 FP16。
归约分三级:卡内 P2P 相加、卡头汇总、RTX 把五行路由加一行共享合并成一层。
| 阶段 | 耗时5 |
|---|---|
| RTX 广播请求 | 29 微秒 |
| M10 往返(计算加回传) | 132 微秒 |
| RTX 合并 | 9 微秒 |
| 整层 MoE | 约 150 微秒 |
| 其中 gate/up | 39 微秒 |
| 其中 down | 18–23 微秒 |
48 层乘 150 微秒约 7.4 毫秒,一个 token 是 19 毫秒,折出来就是 52.5 tok/s。
这也解释了他开头那个「带宽同量级」为什么没兑现。
每颗 GPU 每个 token 只读 2.5MB 权重,按带宽算是 31 微秒,往返却要 132 微秒——这套系统是延迟受限,不是带宽受限。
质量只说了两句:LCB6 略低、MMLU 略高,没看到明显退化。
注意力层量化到 FP8,因为 3070 Ti 只有 8GB,剩下的显存刚够不到 100K 上下文。
评论区两条。一条说 1,500 美元跑到这个速度很值,等于买了个本地 Opus 4.8。
另一条(jimmoores)先问「你到底建成了还是在提议建」,接着给三个隐患。
换模型就要重写整套软件;注意力留在 3070 上可能让预填充成为瓶颈;最后追了一句「你的 pp/prefill 数字是多少」。
作者没回。帖子里从头到尾只有 decode,没有 prefill,也没有上下文深处的速度曲线。
这一格是空的。
五、同一个 DeepSeek 在三台机器上:谁快取决于驻留多少
今天傍晚 6 点 22 分,r/LocalLLaMA 的 /u/chota23 贴了四张 3090 的数据9。
四张卡都是 PCIe x16、256GB DDR4、Maya 引擎,模型是 orcarouter 的 abliterated GGUF mix-256G,上下文 524K。
预填 400–600 tok/s,解码 30–40、峰值 60(带 dspark)。
同一台机器把模型换成 Qwen3.8-Flash-Next 的 Q8,解码只剩 6–8、预填 65。
他把问题原样抛给了版块:同样的多卡机、不同的引擎,你们跑多少。
昨天傍晚 7 点 43 分,小红书「大灰」把同一个模型放进四套配置里算账,价格取 11 月 3 日的京东行情6。
模型的量级先摆清:552B 总参数,解码每 token 激活 16B;最小量化包 239GB,2.25bpw 要 274GB;1M 上下文下 KV 只占 0.93GB。
| 配置 | 价格 | 速度 | 量化6 |
|---|---|---|---|
| 单 5090 32G + 192G 内存 | ¥83,002 | 28.2 tok/s | 2.0bpw |
| RTX PRO 6000 96G + 256G | ¥136,901 | 35–45(预估) | 2.25bpw |
| 双 DGX Spark 128G | ¥82,898 | 57.5 tok/s | 2.9bpw |
| 4×R9700 32G + 256G | ¥110,389 | 80 tok/s | 2.25bpw |
同一个价位上,双 DGX Spark 比单 5090 快一倍。这跟第三节那句「装得下就选 5090」不矛盾,它正好是那句话的另一半。
作者的解释是驻留比例:32GB 显存只放得下约 17% 的专家,其余 83% 每次从 DDR5 取。
实测 GPU 只吃到 185W,算力在等内存。再加一张卡做层切分,速度从 28.2 掉到 27.6。
双 DGX Spark 那边反过来:256GB 统一内存,2.9bpw 下 62% 的权重直接驻留。
两台之间 200GbE,四路并发合计 111.6 tok/s,整机 480W。
他还顺手记了一个「不是钱的问题」:8 张 RTX PRO 6000 跑原生 FP8,因为 vLLM 在 SM120 上缺 CUDA graph,实测只有 2–4 tok/s。
最后是账单。设备按月摊 36 个月是 2,303 元,加 104 元电费,每月 2,407 元。
API 按 1.9456 元每百万 token 算,盈亏平衡点约 12.4 亿 token 每月。
月用量 6 亿 token 时,API 约 1,167 元,本地是 2,407 元。
按这笔账,纯为省钱不该自建;要数据不出内网、离线、可微调,才轮得到本地。
读这张表要留四个折扣。第二行标了「预估」;价格是当天京东价,作者自己说波动大。
他是「翻了一遍京东行情和社群实测」,不是四套机器都亲手跑。
评论区有人问 Mac,他答「反而更贵了」;也有人直接说「这段太重 AI 味了」,他回「是不是很明显」。
六、手机 16GiB 跑 35B-A3B:prefill 470.661、decode 14.262
公众号「陆兮科技 LuxiTech」昨晚 7 点发的这篇,讲的是他们自己开源的 LuxiInfer 开发者体验版。
这家公司做端侧推理方案,账号就是官方号,所有数字都是自测1。
要推翻的常识是「手机跑不动 35B」。他们靠三件事叠在一起。
专家权重压到 2-bit;做多级专家缓存,优先复用刚用过的专家,称相邻 token 的专家命中率 82%;把「要用再读」改成异步预取。
成绩是在一台 16GiB 运行内存的骁龙旗舰上跑的:
| 项目 | 读数1 |
|---|---|
| 35B-A3B 预填充 | 最高 470.661 tok/s |
| 35B-A3B 生成 | 最高 14.262 tok/s |
| 峰值运行内存 | 约 5 GiB |
| 自研 LuxiLLM-1.7B 预填充 | 2,617.54 tok/s |
| 自研 LuxiLLM-1.7B 生成 | 44.66 tok/s |
| 4K 输入的 KV 缓存 | 62.95 MiB |
他们的对照基线是高通官方的 NPU 参考实现(ai-hub-models)。
4K 上下文下,Dense 模型的解码最高是官方基线的 2.35 倍,预填充最高 2.17 倍。
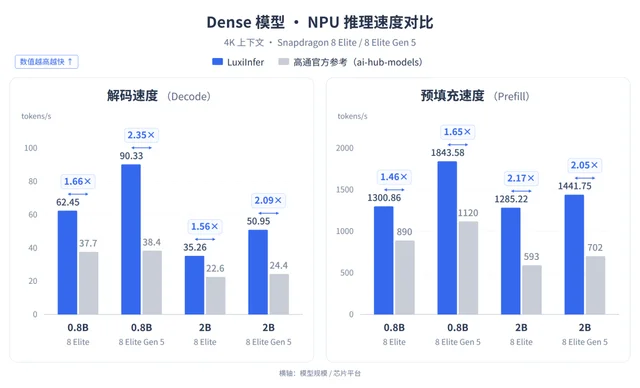
35B 那一档的对照更值得看。文章说其他开源方案在手机上的预填充一般在 100+ tok/s,这次是 470.661。
文章还称,这一档超过了高通官方披露的 30B-A3B NPU+GPU 双引擎方案。
工程上另有一条卖点:这套方案不需要重新训练模型,也不用先训前置路由或投机解码头。
限制要写清楚,因为这一节跟前面五节的性质不同。
第一,全部是厂方自测,这个时间窗里没有第三方复现。
第二,只说了「16GiB 运行内存的骁龙旗舰手机」,没给机型、系统版本、提示长度与重复次数。
第三,「其他开源方案 100+」这句没有点名是哪一个方案、哪一档量化。
剩下能自己算的是等待时间:按 14.262 tok/s,一个 300 token 的回答要约 21 秒。
同一篇里的 App 截图显示,35B-A3B 跑 461.98 预填、13.34 生成。
这个速度能读长文,按对话的节奏用,还是慢的。
顺带
- 同一个引擎的新版本,先把质量摆在速度前面。 Basalt 0.2.0 的作者 /u/jesdga95 这次先给质量表:以全精度权重为参照,llama.cpp 的 Q8 是 KLD 0.0325、首位一致 93.98%,Basalt 的 Q8 是 0.0200 / 95.34%10。新出的 NVFP4-DQ8 是 0.0561 / 92.25%,DQ6_K 是 0.0624 / 91.65%,GSQ-RCO 的 IQ3_S 是 0.1497 / 87.56%。速度在同一台 5090 加 5060 Ti 上:结构化 603.7 与 594.2、闲聊 363.8 与 321.9、散文 295.0 与 299.9,64K 预填 10,221 与 10,229。他自己写了折扣:「每个引擎用各自的工具量,不是完美对照」——这话是他上一版发现基线本身有误差之后说的10。
- 四个决策模型榜,两个榜的相关性是 0.33。 /u/Balance- 把 System One Bench、Artificial Analysis 决策指数、AIM System One Index 与一份 100 模型 Borda 榜的公开数字拉在一起看11。三条结论:5B 以下微调比底座重要,同底座不同微调最多差 22 分;1B 以下看语言,英语撑得住,阿拉伯语掉 16–22 分;别信任何一个「第一」,两个榜的相关系数只有 ρ=0.33,Tev1 4B 在 AIM 上是小模型第二,在别的榜接近垫底11。
- Arc Pro B60 空闲 70 秒,把显存搬回系统内存。 昨天贴 WSL2 那组的 /u/Ton-Llop 今天换了机器:Windows 11、llama.cpp b11889 Vulkan、同一张 B60 24GB、驱动 32.0.101.897612。七次都发生在 GPU 空闲 68 到 71 秒之间:专用显存计数从 20.3GB 掉到 0 用约 15 秒,系统可用内存同步从 16GB 掉到不足 5GB,llama-server 自己的计数一动不动。他怀疑是 WDDM 驱逐或空闲省电,暂时只在服务里等,没有解法12。
- 三张 3090 的 72GB,够不够放全部专家。 /u/Civil_Fee_7862 只有 32GB 内存,主板是消费级 B850,四张卡里一张只能走 Gen4 x1,于是发帖问这会不会毁掉 Strata13。评论里两派都同意一件事:72GB 显存足够把全部专家放进显存,Q3 再加 256K 上下文还有余量,真正卡住的是通道。有人报了自己的两台 R9700:解码 190–200、预填 6,300,8 个用户跑 200K 时解码 49013。
- 一家英国金融科技公司说自托管中国模型省了九成。 r/LocalLLaMA 今天有两条转同一件事:Revolut 把 Claude Code 换成自托管模型,称 AI 编码成本降十倍、少付约 90%14。这是公司口径,本期没拿到它跑了什么题、几轮、多少电费,只能当一条待核的说法。
先把这五件事问清楚
- 跑了几遍。 六道题单跑一遍时 gpt-oss-120b 是 6/6,跑到五遍,Go 那道只剩 1/57。
- 采样参数写没写。 同一个 Qwen3.5-4B,T0.7/P0.8 是 41.3%,T1.0/P0.95 是 51.4%8。
- 权重驻留了多少。 单张 5090 只放得下 17% 专家时是 28.2 tok/s,双 DGX Spark 驻留 62% 时是 57.5,两边价位相同6。
- 报的是 decode 还是 prefill。 手机那组 prefill 470.661、decode 14.262,差了三十几倍1;六张 M10 那组只有 decode,prefill 是评论区追问、作者没答的一格5。
- 基线是谁的。 手机那组比的是高通官方 NPU 参考,Basalt 那组比的是 llama.cpp,而作者自己承认两边用的是各自的测量工具10。
今晚可以顺手做一件事:挑一个你正在用的模型,把它的采样参数、你跑过的次数、权重驻留在显存里的比例,三样写在那个 tok/s 旁边。
下次再看到一条单跑出来的「最快」,你手里就有三句话可以问回去。
References
- 1公众号 陆兮科技LuxiTech《手机跑出全球最快速度!陆兮开源 LuxiInfer》
mp.weixin.qq.com
- 2
- 3
- 4小红书 汤包Matthew《5090对DGX Spark,我猜错了》
xiaohongshu.com
- 5
- 6小红书 大灰
xiaohongshu.com
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.