四个引擎在同一台 Mac 上等 115 到 293 秒、八个 agent 合计 657 tok/s、标称 273 GB/s 实测 233.6
同一天的五组实测:四台 DGX Spark 标称 273 GB/s 实测最高 233.6、Speedy 同一格预填 4,270 而解码 211、一台 M5 Max 上四个引擎等 115 到 293 秒、两张 3090 上八个 agent 合计 657 tok/s——每个数字都要配上它量的是什么才成立。

11 月 2 日 0 点 08 分,公众号「丘山录」把四台 DGX Spark 挨个测了一遍内存带宽,跑到 0 点 38 分1。
早上 9 点 19 分,r/LocalLLaMA 上有人发帖说,两张 3090 同时挂了八个 agent,每个带 25 万 token 上下文。
整机合计 657 tok/s。
下午 2 点 51 分,r/LocalLLM 上 Speedy 的作者贴出四张量化档、单双卡各一栏的预填表,最高一格 4,270 t/s2。
傍晚 6 点 29 分,小红书「Paul 大叔」在同一台 M5 Max 上装了四个引擎。
同一个 24 万 token 的输入喂进去,等的时间从 115 秒到 293 秒。
本期覆盖 11 月 1 日傍晚到 11 月 2 日傍晚,来源是 Reddit 的两个本地模型版块、小红书、公众号与 X。
五组材料里的每个数字都能复核,但它们量的不是同一件事。
| 材料 | 这个数字量的是什么 | 读数 | 旁边那一栏 |
|---|---|---|---|
| 四台 DGX Spark 的内存带宽1 | 算 tok/s 时的分母 | 标称 273 GB/s,实测最高 233.6 | 单条请求只跑到 233.6 的 72.9% |
| Speedy 在两张 3080 上2 | 预填 | 4,270 t/s(Q2_0) | 同一格解码 211,端到端只缩短 64%–72% |
| 同一台 M5 Max 四个引擎3 | 处理 24 万 token 输入的等待 | 115 秒到 293 秒 | 生成那一栏 40.0 到 100.5 |
| 两张 3090 上八个 agent4 | 八个人分到的合计 | 657 tok/s | 每人 69 到 90 |
| r/LocalLLaMA 的一条讨论帖5 | 这些数字该配什么才成立 | 216 赞、78 条评论 | 缺量化档、缺 KLD、缺对照模型 |
一、算 tok/s 用的那个分母,四台机器都拿不到
先说清楚量的是什么。「丘山录」测的是内存读写速度,单位 GB/s。这个数决定生成一个 token 时机器能多快把权重读一遍,是解码阶段的硬上限1。
四台同型号、同批次的 DGX Spark(GB10 统一内存),容器里用 torch 2.13.0 各自独立跑,三个张量尺寸、两种模式1。
| 测法 | 结果 |
|---|---|
| copy 64MB | 224.5 – 230.5 GB/s |
| copy 256MB | 226.9 – 232.3 GB/s |
| copy 512MB | 224.5 – 233.6 GB/s |
| read 512MB | 248.5 – 257.5 GB/s |
| add3 512MB | 229.3 – 232.8 GB/s |
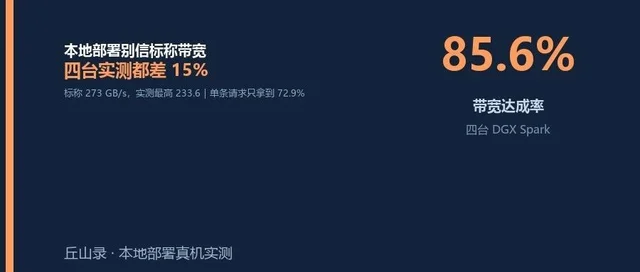
厂商标称 273 GB/s,四台 512MB copy 分别是 229.6、225.9、228.3、233.6。
最高的那台达成率 85.6%,最差 82.7%1。
四台之间的离散只有 3.4%,作者拿它当测法稳不稳的证据:差异来自硬件个体,不来自测量1。
有个顺带验证:read 比 copy 高约 11%,因为 copy 要同时占用读写两个方向。作者说这是校验,不是结论——两者一样快才说明测法有问题1。
真正让这个数字有意义的是下一步。
作者在生产环境里跑 DeepSeek-V4.1-Flash,四张卡 TP=4。
从 config 算出每个 token 要读 9.81 GiB 权重,摊到每卡 2.45 GiB1。
用标称算:273 ÷ 2.45 ≈ 111 tok/s。用实测算:229.6 ÷ 2.45 ≈ 93.7 tok/s1。
而实测产出是 56.32 tok/s。按实测带宽算,利用率 60.1%;按标称算,只有 50.7%1。
同一个分母选错,你以为剩下的空间从 40% 变成 49%,去调的方向也就换了1。
第二组读数是单条请求能拿到多少。
作者用一个 4096×4096 的 fp16 权重、32MB 测 GEMV。
batch=1 时 0.183 毫秒、有效带宽 170.3 GB/s;batch=32 时 0.135 毫秒、231.1 GB/s1。
170.3 是四台 copy 峰值 233.6 的 72.9%。
这就是「聚合跑 862.8 tok/s、单用户只有 55.4」的物理解释:不是调度不公平,是一条请求吃不满带宽1。
第三组是输出长度。
同一套服务、温度 0、关掉 eos 提前终止,只改输出长度。
输出 64 token 时 41.16 tok/s,输出 512 token 时 56.32 tok/s,差 27%1。
作者把这条写得很直白:「这个模型能跑 56 tok/s」如果不说是多长输出,等于没说1。
他自己列了四条边界:273 是厂商口径,他没拿到 NVIDIA 的原始测试条件。
233.6 是 512MB copy 的峰值。
170.3 只在 dgx1 上跑了一次、没取中位数。
prefill 与 decode 没有真正分离,56.32 里还含一点首 token 延迟1。
二、4,270 t/s 是预填,同一格解码是 211
Speedy 是 Strata 的一个分支,专做单卡和双卡的 RTX。
作者 /u/Motor-Translator-665 在帖子里说明,这个分支是他和一位叫 Claudinho 的朋友一起在 Strata 上改的。
改法来自网上能找到的思路与推理论文2。
机器是 P620 平台配 Threadripper 5975WX、128GB DDR4-3200,八槽插满。
显卡是两张解锁了 LHR FP16 限制的 RTX 3080,跑 Debian。
| 量化 | 卡 | 预填 t/s | 解码 t/s | 20 万 token 提示 | 追问首字 |
|---|---|---|---|---|---|
| Q2_0 | 2×3080 | 4,270 | 211 | 49 秒 | 1.8 秒 |
| IQ3_S | 2×3080 | 4,284 | 170 | 47 秒 | 1.6 秒 |
| IQ4_XS | 2×3080 | 3,400 | 154 | 59 秒 | 2.0 秒 |
| Q4_K_XL | 2×3080 | 3,118 | 120 | 65 秒 | 2.8 秒 |
| Q2_0 | 1×3080 | 2,824 | 164 | 78 秒 | 1.9 秒 |
| IQ3_S | 1×3080 | 2,347 | 140 | 89 秒 | 1.8 秒 |
| IQ4_XS | 1×3080 | 1,820 | 122 | 111 秒 | 2.8 秒 |
| Q4_K_XL | 1×3080 | 1,134 | 109 | 183 秒 | 2.9 秒 |
注意这张表:量化越轻,预填和解码都更快。
但最轻的 Q2_0 与最重的 Q4_K_XL 在双卡上解码只差 91 tok/s,预填差 1,152。
两个数的性子不一样2。
作者在帖子里写了一条反方向的选择:他把 route-tail skip 关成 0,而上游默认是 7。
他说这一档是有损的,光这一项就能再拿约 15% 的解码,他没要2。
质量门是他自己定的一条规矩:每一处改动都要在同一个会话里赢 A/B,并且过逐字节或容差校验,还要过到 1M 的 needle 测试,否则撤掉2。
最后的质量数字只有一个:IFBench 81.0,官方模型卡上 BF16 是 81.3。
他在帖子里写,INT8 与 Q8 那些改动不是逐字节相同,但过了他设的门2。
同一天凌晨,另一位用户在 r/LocalLLaMA 上把 Speedy、Avalon、Strata 三个引擎放上同一张 4090 比了一遍6。
他的机器是 4090、128GB DDR5-3600、Ryzen 9 7950X,模型是同一份 ISTA IQ3_S,三档上下文6。
| 上下文 | 冷预填(秒) | 帖内报的 tok/s | 生成 tok/s | 整段交换(秒) |
|---|---|---|---|---|
| 60K | Strata 54.7 / Avalon 22.4 / Speedy 13.7 | — / 2,678 / 4,389 | 75.0 / 102.5 / 110.0 | 66.6 / 32.1 / 23.9 |
| 120K | 110.7 / 42.1 / 26.0 | — / 2,849 / 4,622 | 71.8 / 101.6 / 105.8 | 123.2 / 52.0 / 37.0 |
| 198K | 187.2 / 71.2 / 44.1 | — / 2,779 / 4,494 | 71.9 / 103.0 / 104.3 | 199.8 / 81.5 / 56.1 |
这张表值得停一下:Speedy 的预填是 Strata 的四倍上下,生成只比 Strata 高 45%–47%,整段交换缩短 64%–72%6。
两条换算都对得上:60,000 ÷ 13.7 ≈ 4,380,与他报的 4,389 一致;整段交换里还含生成与首字,所以缩短的幅度小于预填的倍数6。
评论区给了他两个反例。
一位用 5070 Ti 加 64GB DDR4 的用户说,开箱跑出来「等于或不如 Strata」,自己调过配置只快一点,「离你的数字差很远」2。
作者回的是硬件账:他那组是两张卡、Linux、开了 gpu-unlock,对方是一张卡、Windows,CPU 与内存通道也没写。
他还请对方把调好的配置提 PR2。
另一位在 Speedy 与 Strata 上都跑过的人写得短:「Strata 在 Q4 更快,在 Q3S 上基本一样。」2
这帖当时 19 分、赞踩比 0.76,30 条评论。分歧不在「快不快」,在「换一张卡还是不是这个数」2。
三、同一台 Mac、四个引擎、24 万 token:115 秒到 293 秒
小红书「Paul 大叔」(账号背景未公开)测的是另一件事:输入进去以后,人要等多久3。
设备是 M5 Max、128GB 内存、macOS 27.2 的 MacBook Pro。
模型是 Qwen3.8-Flash-Next,上下文开到 256K,实际喂进去约 24 万 token。
他把处理输入与生成回答分成两栏,单位都是 token/秒3。
| 引擎与量化 | 处理输入 | 生成回答 | 按输入折算的等待 |
|---|---|---|---|
| Splash 1.5.0 · Q4 | 2,083 | 100.0 | 约 115 秒 |
| Splash 1.5.0 · 3bit | 2,089 | 94.5 | 约 115 秒 |
| Strata 0.2.9 · 3bit | 1,512 | 100.5 | 约 159 秒 |
| oMLX 0.7.3 · 2bit | 1,864 | 40.0 | — |
| Ollama 0.40.13 · 3bit | 821 | 41.2 | 约 293 秒 |
等待那一列是拿 240,000 除以输入速度算出来的,不含生成。作者自己也注明:这是折算,不是掐表3。
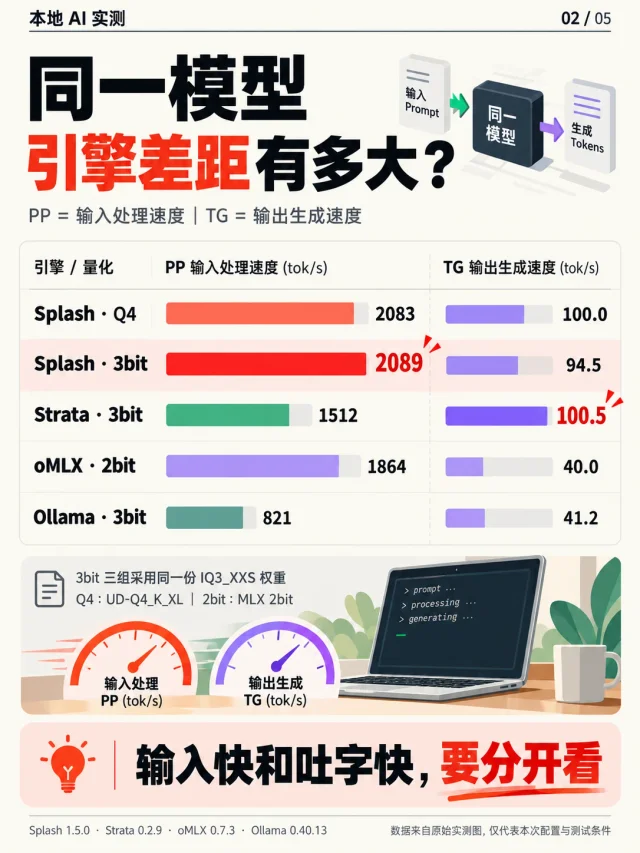
他补了两个细节,恰好都把「量化越轻越快」这条常识顶回去。第一,Q4 没拖慢输入:Splash 两组都在 2,080 多,生成时 Q4 还略快3。
第二,111G 的模型文件在 128G 的机器上真跑起来了:权重驻留 82.5G,进程峰值 86.7G。他提醒文件大小与实际内存占用不能直接画等号3。
他还单独测了窗口上限。
固定同一个 prompt,上限从 64K 改到 256K,输入 1,460 降到 1,401,生成 83.3 到 83.1,变化很小3。
他自己给这条划了界:开到 256K 和真的塞满 256K 是两回事,满载表现还得另测3。
这篇发出时 0 赞、0 评论,没有形成讨论。能拿来判断的只有表、分栏方式和他自己写的边界3。
四、657 tok/s 是八个人分的,每人 69 到 90
r/LocalLLaMA 的 /u/o2beast(账号背景未公开)走的是相反的方向。
他先试了 TokenGate 那类「先把 token 剪掉」的做法。
结论是单问一次还行,agent 会不停问新的问题,剪掉的 token 回不来,代码记忆掉得很厉害。
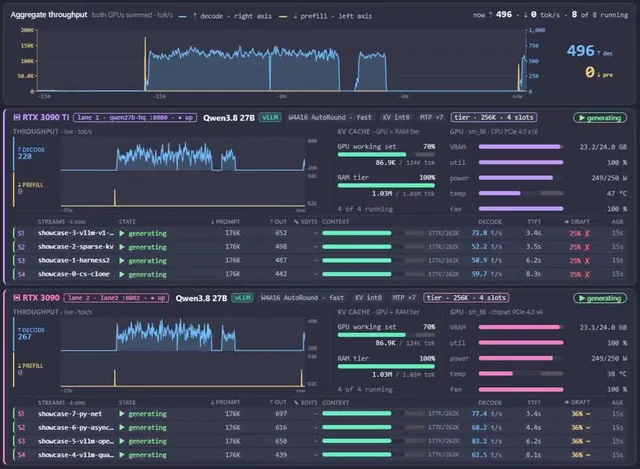
他的办法是全都留着,但一次只看一小部分:整个 KV 缓存放系统内存,每一步只把当下相关的约 1% token 拉进显存4。
机器是 i9-12900K、Z790、96GB DDR5,显卡 3090 Ti 加 3090、功耗上限 250W。
模型是 Qwen3.8-27B 的 W4A16 AutoRound,开 MTP-7。
他用的是一组打在 HyperQwen 某个提交上的补丁,不是分叉;所有数字都是在加载了 gpu-unlock 之后测的4。
| 场景 | 读数 |
|---|---|
| 8 路各 250K,解释型输出 | 合计约 545 tok/s |
| 同条件,复制型输出 | 约 790 tok/s |
| 8 路各自 176K–205K 连续生成 6 分钟 | 整机平均 657 tok/s,每路 69–90 |
| 250K 上的召回题 | 31/32 |
| 追问首字 | 约 5 秒 |
| 单条长对话(约 113K)对稠密路径 | 快 15%–41% |
他把代价也写在同一段里:注意力是近似的,相近的重复代码行偶尔会串4。
评论区的主线是「这还算不算原来那个模型」。
一条说 4bit 权重加 4bit KV「大概不会太好」,另一条更直接:int4 的 KV 上去,模型基本就是被切了4。
还有人问对了题:解释代码库这件事本身很宽容,换成「找出这个函数在跨文件里所有被调用的地方」才是剪枝类做法倒下的地方4。
作者自己补了一条关键结构:他这套只对 full attention 的那些层动手。
Qwen3.8-27B 的 64 层里有 48 层是 recurrent,仍然看全部上下文,只有 16 层走稀疏。
换一个模型,这套做法的收益就会变。这也是为什么他把「近似」写在限制里,而没有把它算成无损4。
五、社区自己问了一句:这些速度帖还需要吗
上面四组数字都是真的,但 r/LocalLLaMA 当天早上 8 点 52 分发的一条帖子拿到了 216 赞、78 条评论,问的是另一件事5。
发帖人把最近每天出现的 300 t/s 帖拆成三行。
跑的是 Q1_XXXS 的 REAP 量化、贪心解码、开了 TAIL_SKIP。
他的原话是「我只有 5GB 内存,但接口只要跳过不在内存里的专家,我照样能说生成了东西」。
然后没有任何 KLD 数据。
赞踩比 0.92,说明这不是少数人的抱怨5。
评论里的分歧有三处,都指向「数字旁边该写什么」,而不是「该不该测速度」5。
第一处是量化档与上下文。有人说这些帖最大的问题是多数不写自己用的什么量化;也有人把上下文长度补进去5。
第二处是质量。一条评论写:速度旁边没有量化、上下文长度和一点质量检查,这个数字说明不了什么,哪怕只补一个困惑度或 KLD 也好5。
第三处是参照物。有人只认一个问题:它比 Qwen3.8-27B 在 Q6 以上更强吗?不是就没用5。
也有第三种态度:出自己的一套题、把分数画成图,比展示 tok/s 更有用;以及一句更冷的——「这事被严重高估了,但人总得有点爱好」5。
把这条帖放回今天这四组材料里,问题就具体了。
一组的预填是 4,270 而解码是 211,一组是等待 115 秒到 293 秒,一组是八个人分 657,一组的分母根本不是 273。
四条都不缺速度,缺的是同一行里的另外两个数。
顺带
- 同一个模型,一张卡上是 271、395、503。 @MiaAI_lab 在 RTX PRO 6000 上用 TensorFold 跑 Qwen3.8-Flash-Next:解码单流 271 tok/s、两路 395、三路 503,预填 4K–32K 区间 8,500–9,200,功耗 600W7。
- 同一天,另外两条是 33.6 与 392。 回复里 @wecko_ai 写自己的 Mac mini M5 Pro 48GB 跑同一个模型中位 33.6 tok/s,本来还挺得意8。另一位 @trevorwood222 用 uzu 引擎在 Mac Studio M5 256GB 上报 128K 上下文下 392 tok/s、占用 46GB 内存、CPU 2.1%9。三条都写了自己的卡与模型,没有一条写清楚是单流还是合计——只有 @MiaAI_lab 那条把三档并列。
- 同一张 4090,97 对 29.8。 @agent_republic 介绍 tandem.cpp:这是一组 llama.cpp 补丁,把最热的 MoE 专家钉在显存里、剩下的交给 CPU;单张 4090 配 64GB DDR4 的 12400F 机器上跑到 97 tok/s,是 stock llama.cpp 的 3.3 倍10。
- 同一个盒子,73.4 到 126.9。 NVIDIA 的 TensorRT Edge-LLM 在 DGX Spark 上给 Nemotron-3.5 Lightning(NVFP4)配 DSpark 草稿器、每次草 3 个 token:HumanEval 提示 73.4 到 126.9 tok/s,SpeedBench 2K 72.8 到 105.3,首 token 延迟基本不变,峰值显存 27.9GB11。涨的全是单流解码,靠的是每次前向多出几个 token。
- 首字 100 秒压到几秒,改的是提示读取。 r/LocalLLaMA 的 /u/HearMeOut-13 给 Strata 的 DeepSeek V4.1 分支打了两个补丁:把新会话的提示与已存的对话对齐、把过时的行剪掉(KV 拼接),以及提示读取阶段只从已在显存或内存里的专家里路由12。他给的基线是每个新会话要重读约 37K token 的系统提示与工具、约 100 秒才出第一个字;标题写的 20 倍,具体结果写在帖内配图里,正文没有重复12。限制他全写了:只在 HIP(gfx1201)上做,拼接是近似的,resident routing 会微改答案(编码题 12/13 两边一致,各跑一次),默认开启12。
先给每个读数补三栏
- 看到 tok/s,先问它是预填还是解码。Speedy 那组同一格是 4,270 与 211,差二十倍2。
- 再问是单流还是合计。八个 agent 的 657 分到每个人头上是 69 到 904。
- 算产能时把分母换成实测带宽。标称 273 与实测 233.6 摆在一起,上限从 111 掉到 93.71。
- 窗口开到 256K 不等于塞满 256K。上限改大对速度几乎没影响,满载表现要另测3。
- 质量那一栏至少留一项。Speedy 的作者为了保住 81.0 对 81.3 的 IFBench,主动放弃了约 15% 的解码2。
今晚可以顺手做一件事:把你这周报出去的每一个 tok/s 翻出来,在旁边补上三样——量化档与引擎版本、输入长度与输出长度、几路并发。
三样补齐之后,今天这五组数字基本就能横向比了。补不齐的那些,按社区那条帖子的标准,还只是标题。
References
- 1公众号 丘山录《本地部署别信标称带宽,四台机器实测都差 15%。》
mp.weixin.qq.com
- 2
- 3小红书 Paul大叔《128G Mac 跑 Qwen 实测》
xiaohongshu.com
- 4
- 5
- 6
- 7
- 8X @wecko_ai
x.com
- 9X @trevorwood222
x.com
- 10
- 11
- 12
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.