Q8 打开引擎加速开关掉到 Q2 水平、128k 里 57% 补成 94%、同样 16GB 内存一条 14 tok/s 两条 24
五组实测各只换掉了一处:引擎的加速开关把 Q8 的 KLD 推到 2 比特档、128k 窗口里掉到 57% 的那组任务靠两处压缩补丁补回 94%、一张 33 题的榜修完语料名次仍在噪声里、同样 16GB 内存一根条 14 tok/s 两根条 24、一个字段名换来 503 或 200。

10 月 31 日晚上 10 点 14 分,Basalt 的作者在 r/LocalLLaMA 发帖,把自家引擎里两个加速开关逐个打开,再逐个关掉,各测一遍1。
11 月 1 日凌晨 2 点 06 分,Betelgeuse 的作者回应自己上一帖的两条批评——2 比特太低、为什么只插一根内存条——把量化换成 IQ4_XS、内存换成两条 8GB,同一张 3060 上的生成速度从 14 tok/s 变成 242。
早上 9 点 42 分,r/LocalLLM 上有人把 128k 窗口里掉到 57% 的那组任务修回来了,动的是上下文压缩,模型没换3。
下午 6 点 20 分,同一版块的评测作者把 33 道 DevOps 题重跑了两遍,新结论是上一版语料在扣「动手前先看一眼」的分4。
再往前一天中午,公众号「测途」写完一篇排查:ZCode 接 Gemini 4 Argon 一直转圈,日志里一条报错都没有,最后剥到请求体里的一个字段名5。
本期覆盖 10 月 31 日午间到 11 月 1 日傍晚,来源是 Reddit 的两个本地模型版块、小红书、X 与公众号。
五组材料各被换掉了一处,五处都在模型外面。
| 材料 | 换掉的那一处 | 换之前 | 换之后 |
|---|---|---|---|
| Qwen3.8-Flash-Next 加 Basalt | 引擎的路由偏置与尾部跳过 | Q8 的 KLD 0.031 | 0.401(2 比特的 Q2_0 是 0.436)1 |
| 同一个 27B,128k 窗口 | 压缩之后有没有把原始请求塞回去 | 57% | 94%3 |
| 33 道 DevOps 题、9 个模型 | 语料怎么记「先看一眼」这一手 | 一条 27B 通过 32 道 | 33 道,名次挪动落在噪声里4 |
| 同一张 3060,同样 16GB 内存 | 一根 16GB 还是两根 8GB | 14.0 tok/s | 24.0 tok/s2 |
| 同一个请求体 | max_completion_tokens 换成 max_tokens | 503 | 2005 |
一、同一批权重,引擎替模型挑了两个专家
发帖人是 Basalt 的作者(/u/jesdga95),帖子里标了两件事:他是这个引擎的开发者,这篇与实验由他跑、但经过 AI 润色1。
机器是 RTX 5090 加 RTX 5060 Ti、128GB DDR5,被测模型是 Qwen3.8-Flash-Next1。
两个开关都跟 MoE 专家住在哪张卡上有关。
路由偏置:引擎把模型往已经在 GPU 上的专家那边推,模型想要的专家有时候被换成了手边这个1。
尾部跳过:模型挑中的专家里,排在后面的几个如果不在 GPU 上,引擎直接跳过,不回内存里取1。
两个开关都省时间,因为要从内存里搬的专家变少了。他测的是省下来的时间拿什么换。
出厂那一档是偏置 1.5、跳过第 7 名以后的专家。他自己写明,这是别的引擎在小显存卡上当成默认值发出过的配置1。
最狠那一档是偏置 16、第 1 名之后全跳过,再加放宽草稿接受。他说这一档没人会用,属于「最坏情况」的锚1。
第一组读数是 KLD:100 段 wikitext、走解码路径、拿 llama.cpp 的 Q8 当参照1。
| 配置 | 文件大小 | PPL | KLD | top-1 一致 |
|---|---|---|---|---|
| Q8_0 原样 | 178 GiB | 3.276 | 0.031 | 94.1% |
| NVFP4 原样 | 122 GiB | 3.304 | 0.068 | 91.4% |
| IQ3_S 原样 | 81 GiB | 3.385 | 0.155 | 87.3% |
| IQ3_XXS 原样 | 74 GiB | 3.470 | 0.243 | 84.0% |
| IQ3_S 加出厂开关 | 81 GiB | 3.583 | 0.244 | 84.3% |
| NVFP4 加出厂开关 | 122 GiB | 3.931 | 0.348 | 81.8% |
| Q8_0 加出厂开关 | 178 GiB | 4.221 | 0.401 | 79.4% |
| Q2_0 原样 | 65 GiB | 3.949 | 0.436 | 78.2% |
| NVFP4 加最狠开关 | 122 GiB | 5.917 | 0.823 | 71.3% |
| Q8_0 加最狠开关 | 178 GiB | 12.858 | 1.616 | 56.8% |
整张表里最该看的是第七行和第八行:178GiB 的 Q8 打开出厂开关之后,KLD 0.401,和 65GiB 的 2 比特 Q2_0(0.436)落在同一档1。
作者自己补了一句校准:原样的 Q8_0 离参照还有 0.031,那多半是参照自己的噪声,每一行都摊到 0.01 到 0.02,行与行之间仍然能比1。
KLD 只是一个数,人感受不到。他又跑了一套题:300 步的连锁题按步计分,1,200 道事实题分五个热度档、跑三个种子,关思考、温度 1.0、top_p 0.95、top_k 201。
| 配置 | 连锁题 | 事实题 | 连锁题差 | 事实题差 | 散文 tok/s |
|---|---|---|---|---|---|
| Q8_0 原样 | 45.4 | 38.1 | — | — | 117 |
| NVFP4 原样 | 45.6 | 38.0 | — | — | 272 |
| Q8_0 加出厂开关 | 43.8 | 36.6 | −1.6 [−3.4, +0.2] | −1.5 [−2.5, −0.5] | 202 |
| NVFP4 加出厂开关 | 44.1 | 36.8 | −1.5 [−3.2, +0.2] | −1.2 [−2.2, −0.4] | 271 |
| IQ3_S 原样(小卡) | 44.1 | 36.7 | — | — | 192 |
| IQ3_S 加出厂开关(小卡) | 38.9 | 34.3 | −5.2 [−7.1, −3.2] | −2.3 [−3.4, −1.3] | 299 |
| Q8_0 加最狠开关 | 26.6 | 2.7 | −18.8 | −35.3 | 379 |
大卡上代价小得几乎看不见:NVFP4 从 272 到 271 tok/s,分掉 1.5 分,作者算成「它原本会的 4%」1。
小卡上是另一回事。把 5090 单独限到 16GB,出厂档换回 56% 的速度,代价是连锁题掉 5.2 分、事实题掉 2.3 分1。
最狠那一档把事实题从 38% 打到 3%,模型的输出变成「The Great Composer」这种语气十足的错误答案1。
他自己的总结是:简单的题几乎看不出差别,掉的是连锁推理和记起来的事实1。
第二条发现与引擎无关。有一句提示词让这个模型在思考里陷进无限的 01。
同一个请求跑四个种子:Basalt 的 NVFP4 四次全中,IQ3_S 四次全中,Q8_0 四次中三次;llama.cpp 跑同一份 IQ3_S 也中三次;走 OpenRouter 的阿里 API 六次全中1。
再出一个 0 的概率在每个量化和两个引擎上都一样:十个 0 之后是 0.99,一百个之后仍在 95% 以上1。
原因是采样:top_p 0.95 已经把 0 之外的候选全切掉了,温度 1.0 也救不回来1。
API 的做法是在约 500 个 0 之后截断这一轮。Basalt 后来补了同样的规则,连续 256 个相同的思考 token 就关掉思考块往下走1。
帖子的社区反应分成两半。74 个赞、60 条评论,赞踩比 0.74,最高一条置顶评论只有一句:「这帖有多少是模型写的,为什么」1。
另一条 8 分的评论来自一个自己写内核的人:他的规矩是每一个确定性比特都必须一致,跳过专家之后,跑的东西已经不是那个模型了1。
还有一条旁证值得记:一位俄语用户说,几天前升级 Strata 之后生成快了 40%,同一个模型开始犯低级错误,多语言能力明显变差,每四次工具调用就有一次失败1。
这条旁证来自评论区,作者没有在自己的帖子里提到。仓库与实验设置都在 github.com/jesdga95/basalt。
二、128k 窗口里掉到 57%,补的是压缩逻辑
作者 /u/fintip(账号背景未公开)在 opencode 里跑本地模型当编码代理,题目是他自己仓库里的真实 bug,判分用隐藏测试3。
最难的一批题把 6 到 12 个互不相干的 bug 打包成一次请求。模型是 Qwen3.8-Flash-Next 的 IQ3_XXS,跑在两张 7900 XTX 上,窗口 128k3。
症状是模型「做完了」:它收工交差,一半 bug 没碰3。
他从记录的请求里还原出三步。上下文满了以后,opencode 把整段会话换成一个由模型写的摘要,原始请求就此消失3。
第一次摘要把每个 bug 都列了;后面的摘要是「摘要的摘要」,只保留「已完成」与「进行中」,还没开工的那些就这么掉了3。
摘完之后,opencode 追加一句「如果有下一步就继续,否则停下并请求澄清」,代理于是汇报完就停3。
有一轮它直接请作者把第 3、4、5、7、8、9 条重贴一遍,因为它手上已经没有了3。
两个补丁都是小插件。第一个叫「塞回去」:每次压缩之后,把原始请求逐字放回上下文3。
第二个叫「清单」:要求摘要器每次都以原始请求的完整清单开头,逐条标「已完成/进行中/未开始」,不许漏;代理再把自己的待办同步到这份清单,收工前核一遍3。
成绩是 4 道多 bug 题、79 个隐藏检查、128k 窗口:
| 配置 | 通过率 |
|---|---|
| opencode 原样 | 57% |
| 只加清单 | 82% |
| 只加「塞回去」 | 90% |
| 两个都加 | 94% |
| 同一个模型、不改、262k 窗口(很少触发压缩) | 91% |
| Claude Opus 5.5(同样任务,跑了 19 次) | 94% |
「塞回去」这一项比清单更管用。作者的原话是,这件事明显到令人吃惊,之前居然没人做过3。
他也把话说清楚:Opus 那 94% 是两个数字碰巧相等,Opus 完整解出的题更多,本地模型是在子项上追平3。
限制有三条:本地这边每组只跑一次,题只有 4 道;单 bug 的题不受影响,因为它们几乎不触发压缩;opencode 仓库里已经有 issue #5934 在说压缩会清空待办,也有 PR #25982 想把待办带过去,但没人试过把原始请求塞回去3。
插件在 github.com/kylebakerio/opencode-compaction-anchor,能用自己的 git 历史出题的框架在 github.com/kylebakerio/LL-Dash。他的题库不公开3。
三、语料在扣「先看一眼」的分
同一版块的 /u/TaraVisionCode 维护一套离线 DevOps 评测:33 道题,覆盖 Kubernetes、Helm、Terraform、Docker、密钥、云与拒答,在真实沙箱里录一次,之后整套回放给模型,任何东西都不会真的执行4。
温度 0,每行一个模型跑一次,他自己造代理、也造被测的引擎4。
10 月 20 日他把 Nemotron 3.5 Bolt 放上榜时发现不对:这个模型的调用里有 54% 是语料没录过的,其中约三分之一是它在动手前先看一眼环境——
pwd、ls、which terraform、terraform version4。回放里没录过的调用一律算失败,于是谨慎的模型为谨慎付了钱4。
还有两道题本身是坏的:崩掉的容器那道题根本没录
kubectl 的答案,模型一查集群就吃一次失败;受保护路径那道题的提示说状态已损坏,回放出来的却是健康的 Terraform 状态4。显存那一列取的是四槽默认值,比单用户实际需要的大4。
第二版语料改了五处:只读探查(
pwd、ls、cat、head、tail、wc、stat、file、find、echo)在限定目录内真的执行;查工具在不在、什么版本,从沙箱录好的一份共享表里答;沙箱本来没有的命令(aws、gcloud、az)仍然算失败,不假装它不存在;目录内路径改成相对匹配;两道坏题重录,显存改成单槽4。语料封版,每份结果文件里都带版本号与哈希,一张榜不混两个版本4。
同一张 RTX 5090(32GB)、同一批 9 个模型,前后两版的成绩:
| 模型 | 通过(33 题) | 显存 GiB | 漏掉的调用(首轮) |
|---|---|---|---|
| qwen3.8:27b | 32 → 33 | 23.2 → 21.4 | 94 → 85 |
| glm-4.7-flash | 29 → 32 | 18.4 → 18.4 | 40 → 43 |
| qwen3.6:35b | 27 → 31 | 22.4 → 21.7 | 55 → 43 |
| gemma4:31b | 29 → 30 | 24.8 → 22.4 | 38 → 28 |
| nemotron-3.5-bolt:74b(IQ2_XXS) | 26 → 30 | 28.3 → 24.9 | 151 → 95 |
| qwen3.6:27b | 31 → 29 | 23.3 → 21.5 | 48 → 33 |
| gemma4:12b | 27 → 26 | 10.0 → 9.0 | 23 → 22 |
| gemma4:26b | 24 → 26 | 17.0 → 16.5 | 30 → 6 |
| gemma4:e4b | 20 → 17 | 4.8 → 4.8 | 11 → 12 |
漏掉的调用总数从 490 降到 367。按类型拆:写绝对路径的行从 27 降到 0,查工具存不存在、什么版本从 20 降到 7,探查运行目录从 49 降到 33 与 394。
两道重录的题回升最多:无集群的容器题,9 个模型里通过数从 3 变成 7 与 8;损坏状态的 Terraform 题从 5 变成 8 与 94。
作者自己拆了这张表。他在同一天把整张榜跑了两遍,两遍之间有的模型挪了 4 道题(gemma4:26b 从 26 到 22,gemma4:e4b 从 17 到 21),平均挪 2.4 道,297 个结果里 40 个自己翻了面4。
每一处前后变化都落在这个范围之内,因此他把结论落在被告知的内容上:这一版改的是模型看到了什么、这张榜能看见多少它的工作,名次本身没有因此重排4。
同一份语料在 Mac 上也跑了一遍,Apple M4 Max 48GB、8 个模型,多数行只差一道题,gemma4:e4b 掉了 6 道,超出他给的那条「4 道以内算平手」的线;这台机器同时从四槽换到单槽、llama.cpp 从 b11514 升到 b11750,他说分不清是模型还是这一跑4。
Mac 比 5090 慢 3.2 到 4.5 倍:qwen3.6:35b 124 tok/s,gemma4:26b 131,27B 到 31B 的稠密模型 39 到 424。
限制他自己列了:这是回放,模型看到的是录好的输出,语料没记下的调用仍算失败,第二版把它缩小了,没有消掉;33 道题、每行一次,平手线就是这么来的;语料由一个沙箱录制,换个沙箱有些探查会答得不一样;他是被测代理与引擎的作者4。
方法页与完整榜单在 code.tara.vision/evals。帖子发出时 2 个赞、2 条评论,没有形成讨论,能拿来判断的只有作者自己的表与他的自陈。
四、同样 16GB 内存:一根条 14 tok/s,两根条 24
上一帖的评论区压了两条意见:IQ2_XS 的 2 比特太低,要看 4 比特;为什么只插一根 16GB 内存条,正常 16GB 游戏机是两根 8GB2。
作者 /u/zyxciss 两条都接了。他把 IQ4_XS 那档(百 GB 级、专家全是 4 比特)打进引擎,在同一张 RTX 3060 12GB、同样 16GB 系统内存下,只换内存的插法再测一遍2。
| 模型/量化 | 内存 | stock llama.cpp | Strata(--low-ram) | Betelgeuse | 输出一致性 |
|---|---|---|---|---|---|
| IQ4_XS | 一根 16GB(单通道,约 19 GB/s) | 约 0.5 tok/s(狂换页) | 4–5 tok/s | 14.0 tok/s | 逐字节一致 |
| IQ4_XS | 两根 8GB(双通道,约 38 GB/s) | 约 0.6 tok/s(狂换页) | 5–6 tok/s | 24.0 tok/s | 逐字节一致 |
| IQ2_XS(GSQ-RCO) | 一根 16GB | 1.47 tok/s | 8.11 tok/s | 22.03 tok/s(峰值 48) | 逐字节一致 |
| Q8_K_XL | 一根 16GB | OOM/低于 0.1 | 塞不下 | 8.0 冷启/12.0 热态 | 逐字节一致 |
同一套引擎、同一张卡、同一份权重,把一根 16GB 换成两根 8GB,4 比特那档从 14 到 24 tok/s,涨了七成2。
他自己给的机制是:专家被挤出显存后落到主机内存的缓存里,再由硬件 DMA 从那里拉回来;单根 16GB 时单通道带宽只有 17 到 19 GB/s,CPU 与 PCIe 的搬运抢同一条 64 位通道;两根条把带宽翻倍,DMA 就能吃满 PCIe2。
「逐字节一致」这句由他提出,指的是与 stock llama.cpp 的输出逐字节相同,帖子里没有贴对比脚本或日志2。
他也是这个引擎的作者,设备那一栏只写了 3060 与 16GB 内存,CPU、主板、NVMe 都没写2。
这帖 139 个赞、52 条评论,赞踩比 0.93,是本轮热度最高的一条。仓库在 github.com/Betelgeuse-AI/Betelgeuse,他还提了一个给 llama.cpp 的 PR #314692。
下一件他打算做的事,是把同一套流式加缓存搬到 DeepSeek V4.1 Flash 上,说早期测试在同一档硬件上已经到 25 tok/s 左右2。
五、同一个请求体,只换一个字段名:200 还是 503
公众号「测途」的记录从 10 月 30 日下午 5 点 41 分开始:把 Gemini 4 Argon 加进 ZCode 桌面端 3.17.1,接口类型选 OpenAI 兼容,Base URL 填网关文档里的地址5。
发消息,转圈。当晚三次尝试分别在 17:41、17:45、17:58,会话时长停在 24.1 秒、14.9 秒、20.7 秒,全部手动停止5。
日志里有规律的退避重试,却没有任何一条 HTTP 报错5。
第一个坑摆在前面:网关强制一个会话头,不带就回 400
MissingSessionID,glm、deepseek、mimo、gemini 四个模型都一样;但 ZCode 自己会带,只要 Base URL 是这个网关5。他们一开始也怀疑是这个头,直到发现配置里同一个供应商、同一个地址的 glm-5.3-flash 直连跑了一个多月没事5。
10 月 31 日做的逐项隔离,同一份请求体每次只改一个字段:
| 字段 | gemini-4-argon | glm-5.3-flash |
|---|---|---|
max_tokens(标准) | 200 | — |
max_output_tokens | 503 Endpoint is unavailable | — |
max_completion_tokens | 200(10 月 30 日首测是 503,两天内漂移了) | — |
thinking、enable_thinking、reasoning 各单独加 | 各 503 | — |
reasoning_effort: "low" | 200,唯一放行的思考参数 | — |
| 四方言齐发(ZCode 实发形态) | 503 | 200 |
| 干净请求体 | 200 | 200 |
最后两行是这一节的要害:同一份 ZCode 形态的请求体,glm 全收,gemini 一个不认5。
原因在线上的模型规则里:glm-5.3-flash 没声明推理档位,请求体里没有思考方言;gemini-4-argon 配了三档,ZCode 就把整套方言发了出去,上游一个都不认,全回 503,报错再被 SDK 吞成退避重试5。
他们给了一个排查口诀:卡死、无错误日志、有退避重试,说明请求被网关拒了、报错被吞了5。
解法是本地起一层代理,做三件事:补会话头、把字段合回标准名、SSE 逐块刷出且不设空闲超时5。
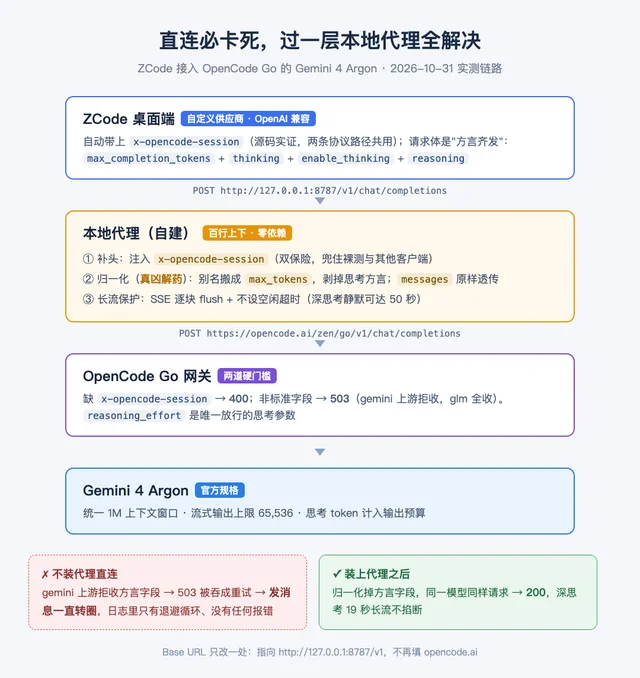
reasoning_effort 是唯一被放行的思考参数,其余三种方言一律 503;代理的第三步「不设空闲超时」针对的是中间层——ZCode 自己的流空闲超时是 600 秒,而 Bun、Nginx 这类默认 10 秒就断。5字段归一化他们列了五条边界,都是踩出来的:别名要无条件删除,和标准字段并存也 503;值只搬一次,两个别名同时在就都剥掉;
max_tokens: null 要先剔再搬;只动顶层标量,messages 一个字节不碰;解析失败就原字节透传5。他们强调过一件事:别拿「某个子代理回了我期望的字符串」当成功证据,提示词里含期望串时任何模型都会照抄;判据是代理日志里那条请求进没进来、剥了哪些字段、上游回没回 2005。
与钱有关的部分也值得抄。推广价到 11 月 30 日截止:输入每百万 2 美元、输出 10 美元、缓存读 0.10 美元;12 月 1 日起翻倍到 4/20/0.205。
还有一处口径差:额度按未折价扣。他们抓了一次真实请求,账面牌价 0.000702 美元,额度池实际扣了 0.001404,正好两倍5。
最后是他们自己的用量:DeepSeek V4.1 Flash 打了 5,911 次请求、3,040 万输入 token、15.06 亿缓存读、410 万输出,账面 15.64 美元;Gemini 4 Argon 只上场 240 次,440 万输入、2,610 万缓存读、19.4 万输出,账面 13.42 美元。作者说 DeepSeek 那侧九成八的输入走的是缓存,这也是它压得住单价的原因5。
顺带
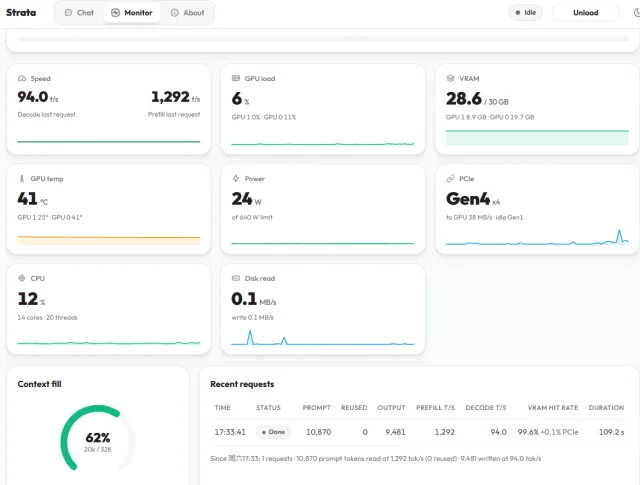
- 一根内存条的距离。 小红书「YH Chen」(账号背景未公开)用两张 3080——主卡是魔改 20GB 走 x16、副卡 10GB 走 x4——跑 Qwen3.8-Flash-Next,Strata 加 Q2_0、32K 上下文、开 MTP,写 9,481 个 token 时 94 tok/s、读 1.1 万 token 用 8.4 秒,显存命中率 99.6%。他顺手给了升级前后:32GB 内存加 SATA 固态时预填 232 tok/s,换成 64GB 加 NVMe 之后 1,292,同一次请求的解码从 62.1 到 94.0。他自己的说法是「64GB 内存加 NVMe 才是这套方案的本体,显卡反而没有卡住」。评论区第一条就来打假:0.2.7 那一版是虚胖的,他回的是「用的 0.2.7+0.1.52,主卡 20G 应不受 13GB 以下偏置路由影响,预填的提升来自双卡 layer-major,再测一次验证」——给自己的数留了一条待验的注。图里另有一处值得看:94 tok/s 那一格,GPU 负载 6%、功耗 24W、PCIe 只跑 Gen4 x4。6
SignatureDoesNotMatch。按他的理解,未知密钥会回另一条 InvalidAccessKeyId,所以那串密钥大概率是真的。路径格式固定,日期会变,其中一条用的正是当天的日期,说明模型在填模板。他自己划了界:一切都建立在同一个量化、同一个引擎之上,换 BF16 或换引擎他没试过。9 - 301 步做一条片子。 X 上 @pebaryan(账号背景未公开)用本地 GLM-5.3-Flash 在 raymotion 里做了一条 reel,跑了 301 步:模型时间 594 分 51 秒,工具时间 70 分 29 秒,首字平均 25.4 秒,9.4 tok/s,共 42M token。帖子里没写硬件与量化档。这组数是整条流水线跑完一条片子的账。10先给自己留一行配置
- 引擎比你以为的快,先看它开了什么。出厂档的加速开关能让 178GiB 的 Q8 在 KLD 上落到 65GiB 的 Q2 旁边1。
- 代理说「做完了」而活没干完,去数上下文压缩了几次。把原始请求塞回去这一项,单独就把 57% 拉到 90%3。
- 看任何一张本地榜,先找它给「平手」划的那条线。这套 33 题的榜,四道以内算平手,同一天跑两遍就能翻 40 个结果4。
- 内存条按根数买,不按总量买。同样 16GB,两根 8GB 比一根 16GB 快七成2。
今晚能做的:把你在用的那套写成一行——引擎与版本、量化档与 KV 精度、上下文长度、内存是怎么插的。下次再看到一对打架的数字,先对一遍这四项,剩下的差别才值得花时间去追。
References
- 1
- 2
- 3
- 4
- 5公众号 测途《ZCode 接 Gemini 4 Argon 必卡死?一个零依赖本地代理全解决》
mp.weixin.qq.com
- 6小红书 YH Chen《试水Qwen3.8 flash-双3080跑125B⚡94tok/s》
xiaohongshu.com
- 7
- 8
- 9
- 10
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.