十个客户端跑同一个 27B:通过率只差一题,token 从 9.2k 到 107.9k;同一张 B60 搬进 WSL2,生成慢 8.8 倍
五组 10 月 29 至 30 日的实测,换掉的都是模型外面那一层:十个客户端的 token 差 11.7 倍、端点上的权重被换掉后工具间思考从 85% 掉到 55%、同一张卡搬进 WSL2 生成慢 8.8 倍、四倍显存换 1.6 倍吞吐、砍掉六成思考 token 掉 0.46 分。

10 月 29 日晚上 11 点 05 分,小红书用户「伟哥 AI 实战」把一台八卡平头哥 PPU 一体机跑通,32B 走四卡、14B 走单卡,压出 1966 与 1223 tok/s 两个数1。
今天凌晨 1 点 46 分,r/LocalLLaMA 上有人把自己 40 天的 agent 日志按天摊开,标出中转站换掉模型权重的那一天2。
早上 8 点 34 分,同一个版块出现一份十家编码客户端的横评:模型、服务器、题目全一样,token 从每任务 9.2k 到 107.9k3。
晚上 6 点 54 分,r/LocalLLM 上有人把同一张 Intel Arc Pro B60 从原生 Windows 搬进 WSL2,生成速度从 36.2 掉到 4.1 tok/s,27B 直接段错误4。
这一期覆盖 10 月 29 日早晨到 10 月 30 日傍晚,来源是 Reddit 的两个本地模型版块、小红书、公众号与 X。
五组材料换掉的是五个不同的层:客户端、API 端点后面的权重、操作系统与图形栈、要几张卡、后训练过的权重。
| 材料 | 换掉的那一层 | 一个数 | 它旁边的数 |
|---|---|---|---|
| 十家编码客户端,同一个 27B | 客户端 | 每题中位 token 9.2k 到 107.9k | 通过率 6 家 5/5、4 家 4/5 3 |
| 40 天 agent 日志 | 端点后面的权重 | 工具调用之间的思考比例 85% 到 55% | 每百条提示的脏话 3 倍 2 |
| Arc Pro B60,24GB | 在 WSL2 还是原生 Windows 里跑 | 生成 4.1 对 36.2 tok/s | 预填 141.7 对 975.8 tok/s 4 |
| 8× 平头哥 PPU | 用四张卡还是用一张 | 32B 1966 tok/s | 14B 单卡 1223 tok/s 1 |
| Swift 1.5 GLM-5.3-Flash | 后训练过的权重 | 思考 token −61.4% | 九项平均 −0.46% 5 |
一、十个客户端跑同一个模型,token 差 11.7 倍
发帖人 /u/latent_lurker8587(账号背景未公开)用的是一台 M5 Max、64GB 内存的 MacBook Pro,Qwen 3.8 27B 走 Q4 量化,llama.cpp,思考关掉3。
十家客户端共用同一个模型和同一台 llama-server。五道小题各埋一个陷阱,每家跑在只属于自己的目录里,只能跟模型说话,自动批准打开、遥测关闭、限时五分钟3。
| 客户端 | 通过 | 中位耗时 | 中位 token | 缓存复用 | 是否尝试联网 |
|---|---|---|---|---|---|
| Pi | 5/5 | 38 秒 | 9.2k | 72% | 否 |
| DeepSeek Harness | 5/5 | 60 秒 | 35.3k | 83% | 否 |
| Codex CLI | 5/5 | 94 秒 | 36.3k | 79% | 每次都试 |
| OpenClaw | 5/5 | 106 秒 | 39.0k | 72% | 说不清 |
| Cline | 5/5 | 152 秒 | 29.6k | 79% | 每次都试 |
| OpenCode | 4/5 | 50 秒 | 32.4k | 75% | 每次都试 |
| Hermes | 4/5 | 80 秒 | 64.9k | 93% | 否 |
| Atomic Agent | 5/5 | 56 秒 | 30.4k | 86% | 否 |
| goose | 4/5 | 98 秒 | 20.3k | 76% | 每次都试 |
| Qwen Code | 4/5 | 183 秒 | 107.9k | 74% | 说不清 |
通过率这一栏几乎是平的:六家做对五道,四家做错一道,差的就是同一道题。耗时从 38 秒排到 183 秒,差 4.8 倍;token 从 9.2k 排到 107.9k,差 11.7 倍3。
吃得最省的是 Pi,每一道题上都是最低的。最费的是 Qwen Code,一道题烧掉 10.8 万 token,是 Pi 的 11.7 倍,也是它自己最慢的原因之一3。
Atomic Agent 是十家里唯一走 llama.cpp 原生接口的,用语法把工具调用强行捏成结构。它每步都给同样的提示词,缓存复用 86%,排在第二,全程没联网,五道全对3。
DeepSeek Harness 还是 alpha,却拿了 5/5、没联网、缓存复用 83%,只输 Atomic Agent 一档。发帖人自己的评语是这家的表现最出乎意料3。
陷阱题是那道读日志的:真正的错误行只有 64 条,另外一些正常行里也提到了 error。三家直接 grep「ERROR」,报出 244 条,从第一步就错了3。
最该看一眼的是联网那一栏。Codex、Cline、goose、OpenCode 每一轮都往外发请求,遥测关着、也没人让它联网。沙箱把请求挡了,所以没人知道它们想连哪儿;OpenClaw 与 Qwen Code 跑在裸 node 里,分不出来3。
29 条评论里,两条最值得抄走。一条是统计上的:五道题里 5/5 与 4/5 只差一道,每题只跑一次,就分不清那一题是实力还是运气,温度大于零、五分钟上限都会制造一次失败,token 与缓存那两栏才站得住3。
另一条说的是联网那一栏:四家每一轮都伸手,在笔记本上你看得见,在一台带着凭据的机器上你不一定看得见3。
他建议把这一栏拆成「试过」与「成功」两列,DNS 失败和一次成功的 POST 说的完全不是一回事3。
这组数也得打折:一台机器、五道题、每家一次、自动批准全开。顺带记两条运行时的事实,Codex 现在要 llama-server 的 /v1/responses,Hermes 至少需要 64K 上下文3。
Loading content card…
二、同一个模型 ID,10 月 19 日那天被换掉
发帖人 /u/Jipok_(账号背景未公开)上月中旬发现自己的编码 agent 突然变笨,于是把本地会话日志翻出来,按天对齐了 40 天:133 个会话、6,409 条用户提示、75,981 步 DeepSeek 调用2。
模型 ID 从头到尾是同一个,agent 外壳是同一个,项目也是同一批。10 月 17 日上游把 -1017 版本放到 Hugging Face,10 月 19 日各家中转站在同一个 ID 下换掉了权重2。
三个指标都在同一天转向。工具调用之间带思考块的比例从约 85% 掉到约 55%;每百条提示里的脏话跳了 3 倍;会话中途换走模型的次数跳了 6.7 倍2。
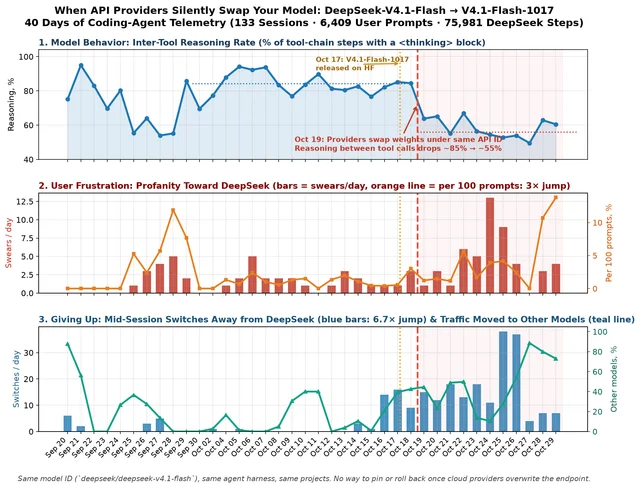
旧版本还有一个很好认的习惯:它会突然用中文回答,同时坚信自己在说英文。-1017 把这个漏洞修了,工具调用也变得更积极,作者的说法是顺手把模型弄钝了2。
96 条评论把这件事吵成了两半。最高的那条不认这组数:如果你直接买 DeepSeek 官方,别名本来就指向最新版,1017 是更好的那一个2。
他还补了两句:脏话变多可能只是项目变复杂,工具调用变少也可能是上下文用得更好2。
另一半的立场正好相反:有人翻出厂商自己的通知,确认升级时保留了同一个模型 ID;有人说花几周把 agent 调顺,第二天醒来面对一个回退,只能去查自己根本没改过的代码2。
这组数能用到哪里,作者自己划了线:一个人的工作流、一个 agent 外壳,脏话和换模型都不是模型能力的直接指标,它们只是同一条时间线上的行为痕迹2。
Loading content card…
三、同一张卡搬进 WSL2,生成慢 8.8 倍
发帖人 /u/Ton-Llop(账号背景未公开)手上是一张 24GB 的 Intel Arc Pro B60。同一张卡、同一个 Intel 驱动、同一版 llama.cpp(b11889)、同一批 GGUF,唯一变的是在哪儿跑:WSL2 里走 Mesa 的 Dozen,或者同一个 tag 的原生 Windows Vulkan 二进制,从 WSL2 通过互操作启动4。
| 模型 | WSL2 + Dozen 预填/生成 | 原生 Windows 预填/生成 |
|---|---|---|
| Ornith 1.5 9B Q8_0 | 141.7 / 4.1 | 975.8 / 36.2 |
| Qwen3-Coder-30B-A3B Q4_K_M | 34 / 2.5 | 788.8 / 99.2 |
| Qwen3.8-27B Q4_K_M | 49.9 / 段错误 | 339.4 / 15.6 |
三行都是 tok/s,从 llama-bench 来,-ngl 99。9B 的预填差 6.9 倍、生成差 8.8 倍;30B 的预填差 23 倍、生成差 39.7 倍;27B 的生成直接崩4。
差别写在设备列表里。Dozen 报的是矩阵核心为空,还附带一句「dzn 不是符合规范的 Vulkan 实现」;原生 Windows 报的是 KHR_coopmat4。
27B 的崩溃更值得记。四次崩溃、两个量化档、llama-bench 与 llama-cli 都试过,dmesg 里是同一个偏移量的段错误,落在 libLLVM-14.so 里4。
那个 libLLVM-14.so 是从 WSL 的驱动目录里加载的,属于 Intel 的 Windows 驱动包,不是他自己编的 Mesa。所以问题出在驱动这一层4。
排除也做得干净。-ngl 0 与 1 能跑,从 -ngl 2 起就崩,一层 transformer 放上卡就够触发;换量化不管用,Q4_K_M 与 IQ1_S 都崩;显存还空着 23.6GiB;同一族的小模型 Ornith 9B 没事4。
他还把七个 Vulkan 特性逐个关掉试:点积、MMVQ、融合、multi-add、dot2、f16、图优化,一个都不管用。最后留了三个公开问题,包括 WSL2 里 9B Q8_0 只有 4 tok/s 正不正常4。
这组数只有一个作者、一台机器,两边的 flash attention 开关还不一致,Windows 用默认,WSL2 关掉了;30B 那栏预填的方差是 ±27,他自己让人只看生成那列4。
发帖到现在只有一条评论,也没有人给出复现或解法,他还没把问题报给 Intel4。
四、八张平头哥 PPU:四倍显存换 1.6 倍吞吐
机器是 8 张平头哥 PPU-ZW610E,单卡 48GB,用开源的 GPUStack 做集群面板。镜像 16GB,走离线搬运,作者说光环境和镜像就排了十几个坑1。
两组配置是:32B 用四张卡、TP=4;14B 用一张卡、TP=1。判据写成 SLO:首字 p95 不超过 1 秒,且每 token 不超过 60 毫秒1。
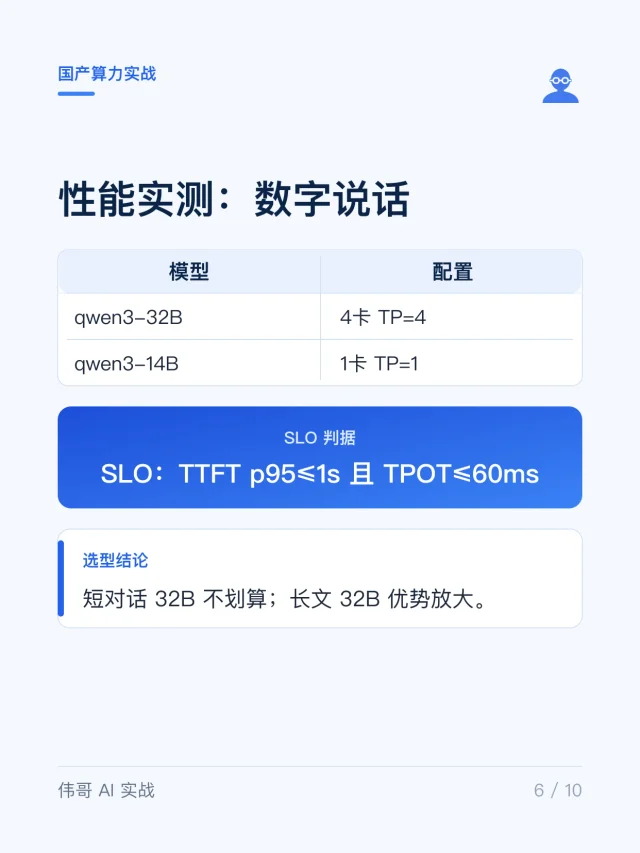
结论因此是分场景的:短对话上 32B 不划算,四倍显存换 1.6 倍吞吐;长上下文与 RAG 这类活上,32B 的优势才放大得出来1。
失败案例比读数更有用。多卡 TP>1 起不来,模型的环境变量要覆盖 NCCL_SOCKET_IFNAME=bond0,这是全篇最深的那个坑1。
TP 只能取 1、2、4、8。误选到 7 的时候,调度要 TP=7,注意力头数除不尽,就在 P6 那一层挂住,状态是 embedding pending1。
还有两个:自定义 source 会把后端整表替换,只写几行会清空并报 vllm not found,回滚是 null;gpu_ids 的格式是 worker:类型:序号,不是直觉的 1/41。
这份记录要按广告逻辑读。作者做部署服务,文末写的是完整实操记录与复刻清单在评论区找他1。
十张卡是排过版的结论页,没有原始压测日志,也没有第三方在别的机器上复跑1。
五、砍掉六成思考 token,九项平均掉 0.46 分
这是 UkisAI 的发布帖,发帖人 Jovan 是团队自己的成员。做法是先找出那些跟「病态过度思考」绑在一起的 token,给它们惩罚,再用后训练与 on-policy 蒸馏把准确率补回来;全程没有设一个统一的推理长度上限5。
Swift 1.5 GLM-5.3-Flash 的主数字是 MMLU-Pro 上思考 token 减 61.4%,九项基准平均掉 0.46 个百分点,每一项跑五个不同种子5。
九项是 Terminal-Bench 2.1、DeepSWE v1.1、GPQA-Diamond、MMLU-Pro、C-Eval、IFBench、AIME 2026、HMMT 与 LiveCodeBench v6,一项一项都跑了,帖子只给平均值,没贴逐项表5。
标题与正文给的不是同一个数。标题写 −57.7%,后面跟着「max reasoning 且准确率掉不到 1%」;正文的 61.4% 标明是在 MMLU-Pro 上量的。两个数对应不同档位,看的人得自己分清5。
小一号的 Swift 1.5 Ornith-9B 给的是另一组:思考 token 减 33.5%,准确率不掉,更有用的是「过度思考的循环少了约一半」,也就是提示词给下去之后,卡住不交活的概率下降5。
两个模型都能挂原来的 MTP 或 DFLASH2 头。量化放得比较全,GLM 那版有 1bit 到 8bit 的 GGUF,还有 W4A16 AWQ 与 NVFP4;Ornith 那版是 4bit 到 8bit5。
限制要一条一条看。这是发布方自测,没有第三方复跑5。
训练数据按模型重新采样过,所以 −61.4% 与 −33.5% 不能横向比。Ornith 那版被明确标成实验版本,而且在做这轮 token 优化之前已经后训练过一次5。
19 条评论里最有信息量的一条来自一个自称平时不碰微调版的人:他说这个底座本来就能跑到 150 到 300 tok/s,只是思考太多,现在正在下 W4A16 那一版,稍后回来更新。到发稿时还没有人贴出复现数字5。
顺带
- 2.8 万亿参数的那笔体积账,算完是「跑不动」。 公众号「老郭的学习空间」按 Kimi K3.1 Pro 的规格逐档算:总参 2.8 万亿,每 token 只激活 1040 亿,896 个专家里每次点 16 个(另加 2 个共享)。权重原生就是 MXFP4,4bit 约 1.5TB,1bit 的 649GB 也放不进 512GB 的 Mac,因为 macOS 只让 GPU 用统一内存的约七成,实际可用约 384GB。KV 缓存反而是好消息:93 层里只有 24 层随上下文长,32K 拉满到 100 万约多 28GB(这一个是推算)。作者也把体积数字标成按同结构 K3 的 GGUF 估算,11 月 4 日权重放出后以实测为准6。
- 单张 RTX PRO 6000 上,单流 287 tok/s。 96GB 的卡,Qwen3.8-Flash-Next 的 FP4 权重,TP1、FP8 KV、262K 上下文、vLLM 加 b12x 内核、MTP 深度 4,功耗压在 450W。单请求 287 tok/s,八路并发 965 tok/s,4K 上下文预填约 14.5K,128K 时还有 13.5K。测法写得很细:Python、TS、Rust、Go 四类「写实现加测试」的提示,约 250 token 输入、1,536 token 输出,温度 0、思考关闭;作者自己补了一句,编码是最适合投机解码的场景,短散文与多语种聊天接受率低,会慢几个百分点7。
- 不换模型,换它旁边那个 4.8 亿参数的草稿器。 Ling-3.0-Flash 是 124B 总参、5.1B 激活,配套的 UBTree 草稿器只有 482M。官方发布的检查点在六项测试上平均 3.43 倍,对上 DFlash 的 2.96 倍与 DSpark 的 2.88 倍,平均输出约 1,010 tok/s,研究配置最高报到 5.36 倍。发帖的 @TeksEdge(账号背景未公开)把 caveat 写在同一段里:llama.cpp 还没有,要用专门的 SGLang/CUDA 分支;有人只把 DFlash 那部分抽出来塞进原版 llama.cpp,Python 代码从 79 跑到 127 tok/s,+61%。权重是 MIT8。
- 同机换引擎,官方说最高 4 倍,数字只在图里。 Rapid-MLX 发到 1.0 正式版,官方账号的说法是和 mlx-lm 在同一台机器上比,最高快 4 倍,数字的出处写在配图里,正文没给绝对 tok/s。这一版还内置了 agent(rapid-mlx chat --harness,联网前先问你)、模型库 240 多个,能在本地生成带声音的视频。发帖的是项目方,帖子里也只在征集用户自己的机型与速度,还没攒出公开的民间表9。
在自己机器上先对一次账
- 看到「同一个模型」,先问外面那层是什么。同一台服务器、同一个 27B、同样五道题,十家客户端的 token 从 9.2k 到 107.9k 3。
- 看到「模型变笨了」,先把自己的日志按天切。思考比例、脏话、换模型次数能在同一条时间线上对齐,才有可能对上某一天2。
- 看到一个慢字,先看它跑在哪套图形栈上。同一张卡,WSL2 里生成 4.1 tok/s,原生 Windows 36.2 4。
- 看到「几倍吞吐」,先看它花了几倍显存。四卡 32B 拿 1966 tok/s,单卡 14B 拿 1223 tok/s,显存四倍、吞吐 1.6 倍1。
今晚能做的:打开你常用那个 agent 的会话日志,按天统计 token 与工具调用次数,找有没有一天突然跳变。真跳了,先怀疑外面那层换了,再怀疑自己2。
References
- 1小红书 伟哥 AI 实战《国产GPU跑大模型?8卡平头哥实测》
xiaohongshu.com
- 2
- 3
- 4
- 5
- 6公众号 老郭的学习空间《2.8万亿参数、100万上下文:Kimi K3.1 Pro 你的 Mac 跑得动吗?》
mp.weixin.qq.com
- 7
- 8
- 9小红书 Rapid-MLX 实验室《Rapid-MLX 1.0:最高快 4 倍,agent 内置》
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.