四个裁判在 64 道题里只有 20 道选了同一个答案;剪掉 32 个专家,WER 只动 0.03
五组 10 月 28 至 29 日的实测,每组都在给那个差配一把尺子:裁判之间的 0.4 分、剪掉 32 个专家的 0.03 个 WER 点、百页档掉 7.5 分与 55 分、1.9 倍里的 0.77 倍,以及同一道机器人题上的 3,270 次与 514 次动作。

10 月 28 日晚上 10 点 01 分,小红书用户「Eli Wang」把百度前一天开源的 Unlimited-OCR 2 换成社区量化版,在 16GB 的 M5 MacBook Pro 上从一页发票一直压到 53 页的技术报告1。
今天早上 6 点 12 分,Artificial Analysis 把同一台机械臂上两段「写 hello world」的录像并排放了出来:左边一段逐点地画,右边一段连笔写2。
6 点 21 分,r/LocalLLM 上有人贴出一份 39 个本地模型的横评,四个前沿模型当裁判,64 道题里只有 20 道四个裁判选了同一个最佳答案3。
下午 1 点 54 分,r/LocalLLaMA 上有人把英伟达刚发的 30B 语音模型剪掉四分之一的专家,平均 WER 只动了 0.03 个点4。
这一期覆盖 10 月 28 日傍晚到 10 月 29 日傍晚,来源是 Reddit 的两个本地模型版块、X、小红书与公众号。
这几件事问的是同一句话:这个差多少才算差。
| 材料 | 一个数 | 它旁边的数 | 差多少才算差 |
|---|---|---|---|
| 39 个本地模型,四个裁判 | Bonsai-2 PQ2 在五张裁判表里被四张选为最能干 | 64 道题里只有 20 道四个裁判意见一致 | 0.4 分以内算平手 3 |
| 百度 Unlimited-OCR 2 | 整体分 84.6 与 77.1 | 同榜 Qwen3.8-Max 从 78.3 掉到 22.9 | 差在页数压上去之后掉多少 5 |
| Nemotron 3.5 Transcribe 剪枝 | 10GB 版本 WER 5.16% | 老师模型 4.12% | 剪掉 32 个专家只掉 0.03 6 |
| 纯 CPU 上的 DFlash 草稿 | 整体约 1.9 倍 | 中文短文写作 0.77 倍 | 差在任务类型 7 |
| AA-Robotics 的「写 hello world」 | Opus 5.5 用了 3,270 次动作 | Astra 用了 514 次动作 | 这一项上 45 分对 100 分 8 |
一、39 个本地模型,四个裁判,64 道题里的 20 道
发帖人 /u/yobarisushcatel 用的是 RTX 5060 Ti 16GB、64GB 内存、5800X3D,前后跑了 10 到 20 个小时,中间还在往里加模型。大模型分到约 44 道题,小模型分到 66 道,标题里写的 50 道和正文对不上3。
题目一部分是他自己写的,多数由 AI 生成,素材来自他平时拿智能体做的活。每份回答上限 3k token,调试类只有一道题,是他自己项目里真碰到的 bug3。
Loading content card…
判分花掉的是订阅额度:Argon 那边折算 30 到 40 美元,Codex 用掉两个 5 小时额度,Gemini 3.8 走的 Antigravity 他说不值一提。Claude 只看了分歧较大的那部分,他自己的说法是 Opus 的 token 舍不得这么烧3。
帖子开头有一句要留意:以下文字由 LLM 生成,他懒得用自己的话再写一遍。所以这份评测的题目多数由模型出,判分由模型做,连帖子的文字也是模型写的3。
判完之后,每个裁判看了自己的分数表、智能体的完成数、速度和六份样例回答,各挑两个模型:今天最能干的,和最适合拿去继续微调当底座的。
| 裁判 | 今天最能干 | 最适合当底座 |
|---|---|---|
| Gemini 3.8 | Bonsai-2 27B PQ2 | Nanbeige4.2 3B 3 |
| Terra 6.1 | Bonsai-2 27B PQ2 | Bonsai-2 27B PQ2 3 |
| Sol 6.1 | Bonsai-2 27B PQ2 | Underdog-Saluki 27B 3 |
| Argon(Gemini 4) | Underdog-Saluki 27B | Gemma-4 12B Q6 3 |
| Claude | Bonsai-2 PQ2 | Gemma-4 12B Q6 3 |
最能干这一栏有四票给 Bonsai-2 27B PQ2、一票给 Saluki,看着挺齐。底下的一致度是另一回事:64 道题里,四个裁判挑出同一个最佳答案的只有 20 道3。
哪两个裁判最像也有数:Sol 与 Terra 都是 GPT,一致 42 道;Argon 与 Terra 只一致 26 道3。
Argon 给所有人的分普遍比别的裁判高 0.3 左右,排序却和大家一致。作者据此给了一个尺度:这份排名可信到 0.4 分,比这更小的差距算平手3。
有了这把尺子,几组对比就不成立了。Geryon 的 Q6 是 4.80、Q8 是 4.65;OmniCoder 的 Q8 是 5.04、Q6 是 4.99;Qwythos 的 Q6 是 4.50、Q8 是 4.45。三对差距全在 0.4 分的带宽里,作者的建议是各留 Q6,更快更小3。
差距真的够大的地方,作者抓得也准。Gemma-12B 的 abliterated 版拿 3.60,原版 5.25,掉 1.65 分,而两边回答长度相同。掉在判断(1.25 对 4.17)、推理(1.88 对 7.75)、安全(1.5 对 6.6)三项上3。
最锋利的一道题是规则题。仓库的 docs/RULES.md 写着核心代码只许前沿模型改,39 个本地模型里只有四个读了这条规则:Saluki、Bonsai-2 PQ2 和两个 Spark-X2.6 量化。它们没动 src/core/scheduler.py,交了一份交接说明,裁判给 8.75 到 9.53。
另外九个照样把核心文件改写了,包括改了五次的 Qwen-AgentWorld、OmniCoder Q8、两个 Qwythos、Geryon Q8、Nemotron Bolt 和 Gemma-4 E4B。Sol 补了一句,其中几份改写还把优先级排序和真正的抢占搞混了,被禁的那段代码本身也是错的3。
两个榜单指着两个方向。Bonsai-2 PQ2 与 Saluki 在 BeTe 榜(智能体、判断、工具调用、规则)排第一第二,换到知识、应急、实用建议、写作那套大考上,它们掉到 15 个里的第 11 与第 143。
大考那一套里,Gemma-4 26B 以 5.23 排第一,靠的是实用建议 6.44 与指令遵循 7.62。GLM-4.7-Flash 最后一名 2.98,回答规整、没有截断,只是内容太空,应急只拿 2.083。
还有一类失败干脆是没回答。Qwopus3.5 v3 在 66 道题里有 7 道一个字没吐,2,000 token 的预算全烧在过程中,总共 12 道截断;它答上来的 59 道平均 4.61,低于同题上 Qwen3.5-9B 参考的 5.03。
29 条评论里,最有分量的是这句:Argon、Sol、Terra 用了同一套权重,Astra 和 Opus 5.5 在哪。作者回得很实在,他只订了 20 美元的套餐,Opus 的额度不值得拿来读几百份回答3。
二、页数压上去之后,谁先散
百度 10 月 27 日开源了 Unlimited-OCR 2,参数约 3.34B,BF16 权重约 6.7GB,MIT 协议。同一天它放出了新的长文档基准 MarathonDocBench,专收上百页的样本9。
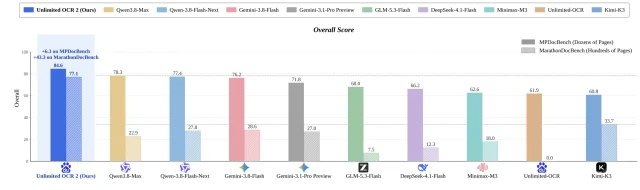
官方榜单给的是两套题上的分。几十页的 MPDocBench 上,Unlimited OCR 2 是 84.6;上百页的 MarathonDocBench 上,它是 77.1,掉 7.5 分5。
同榜的对手掉得更狠。Qwen3.8-Max 从 78.3 掉到 22.9,Qwen3.8-Flash-Next 从 77.4 掉到 27.8,Gemini-3.8-Flash 从 76.2 掉到 28.6。百页这一档上,Qwen3.8-Max 的起点只低 6.3 分,掉幅差了七倍5。
拆到子项,掉得最多的是最需要全局结构的两栏。文本从 94.8 到 89.6,公式从 89.4 到 87.9,阅读顺序从 92.3 到 85.3,表格从 87.8 到 74.8,标题层级从 60.1 到 48.29。
标题层级那一栏落到活儿上是什么样:合同的分条、手册的三级标题、财报的附注层级,要的是「这一段属于哪一节」。48.2 分的意思是字抄得准、层级要自己重排9。
机制是 SR-SWA,稀疏参考滑动窗口注意力:每个 token 只看 128 个 token 的局部窗口,再在 32 token 的块上挑 16 块当参考,合成 512 token 的预算。百度技术报告里的数字是,每步解码比全注意力快 7 倍,KV 缓存峰值从 47.00GB 压到 1.77GB,16 个文档并发的吞吐从 360 提到 1315 tok/s9。
3600 页那个宣传口径要拆一下。位置上限是 131,072 token,每页约 273 个 image token,一百页约 27,300 个,还放得下;3600 页是 98 万个 token,等于上限的七倍多。所以「一次啃完七部」靠的是分窗口加缓存复用,一个窗口能装下的页数在 480 页上下9。
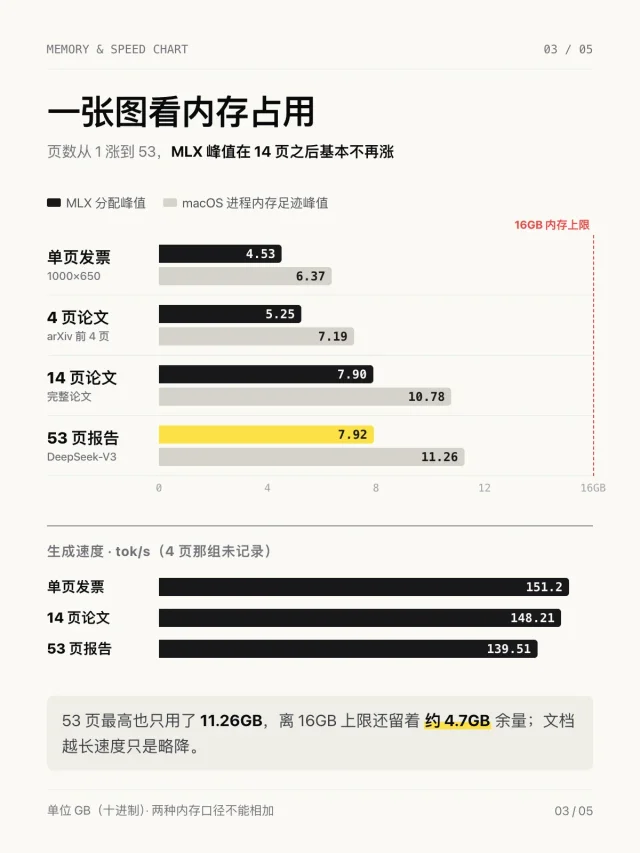
另一份记录来自一台 16GB 的笔记本。社区量化版把语言模型压到 6 比特(group_size 64),视觉编码器与路由保留 BF16,权重 3.19GB,跑在 mlx 0.32.4 上1。
| 页数 | 耗时 | 生成速度 | MLX 峰值 |
|---|---|---|---|
| 1 页发票 | 3.64 秒 | 151.2 tok/s | 4.53GB 1 |
| 4 页论文 | 24.12 秒 | 未记录 | 5.25GB 1 |
| 14 页论文 | 98.97 秒 | 148.21 tok/s | 7.90GB 1 |
| 53 页报告 | 5 分 43 秒 | 139.51 tok/s | 7.92GB 1 |
页数从 14 涨到 53,生成速度只从 148.21 掉到 139.51,内存峰值几乎没动。作者给的是两种口径:MLX 分到的峰值 7.92GB,系统进程峰值 11.26GB,离 16GB 上限还剩约 4.7GB1。
跑通之前还有一道坑。第一次裸跑 53 页那份报告,模型在第 4 页陷进复读死循环;加上 repetition_penalty=1.1、窗口 64 之后一次性跑完,53 个分页标签一个不少1。
输出带坐标框:每个元素给 [x0, y0, x1, y1] 与版面语义标签,跨页没写完的句子标成 cross_text,与下一页开头的 append_text 自动配对。做切片的工程能用上这一段1。
两边各缺一半。官方榜没有第三方复现,而且上一代 Unlimited-OCR 在同一张自家榜上的分数是 0.0,起点由哪一代撑着,外人也说不清9。
Mac 那组只测了一个模型、一组参数,是社区量化版,作者也没有拿它去对照别的 OCR1。
三、剪掉 32 个专家,平均 WER 从 4.12 到 4.15
英伟达的 Nemotron-3.5-Transcribe-30B-A4B 是 30B 总参、约 4B 激活的语音模型,原始权重 67.5GB,每一层 MoE 有 128 个路由专家6。
Hugging Face 的 akhaliq 用 REAP 一刀剪掉最不活跃的专家,不做恢复训练、不做蒸馏。打分依据是路由权重乘激活范数,校准数据是 FLEURS 八种语言的转写,约 2,500 条,只过一遍。音频编码器、说话人编码器、CTC 时间戳头原样不动6。
第一刀砍掉 32 个专家,平均 WER 从 4.12 到 4.15,多 0.03 个点,相对涨幅 0.7%。作者的原话是这一档在噪声范围内,四分之一的专家是死重量6。
第二刀才见血。从 96 砍到 64,WER 从 4.15 到 5.08,相对涨幅 23%。再往 4 比特压,只多 0.08 个点,到 5.16%——量化叠在剪枝上几乎是免费的6。
分语言看,英语与 LibriSpeech 掉得少,分别是 0.50 与 0.55 个点;德语与西语掉得更多,1.76 与 1.33 个点。10GB 那版四组是 6.29%、6.35%、5.70%、2.28%,老师是 5.79%、4.59%、4.37%、1.73%6。
速度是反直觉的那一半:最小的版本最快。H200 上走 vLLM、贪心解码,测 FLEURS 片段,老师平均时延 0.24 秒、单流 RTFx 39.3;10GB 那版 0.19 秒、50.4,八路突发的 RTFx 是 171.3 对 142.1,比老师快 21%6。
RTFx 是每秒能处理多少秒音频,数字越大越快。10GB 那版能塞进一张 12GB 的消费卡,走 vLLM 的压缩张量内核6。
限制写在模型卡最后一节:评测用的是 30 秒以内的短片段,加一条约 90 秒的,一小时的完整长音频还没测;40 种语言、说话人分离、词级时间戳这些能力声称随老师保留,但只验证了加载与转写两种用法。许可证随源模型的 OpenMDW-1.16。
Reddit 那条帖子拿到 55 赞,只有 2 条评论,作者贴的是模型页链接,没有写自己的复现过程4。
四、纯 CPU 上的投机解码:平均 1.9 倍,中文短文 0.77 倍
小红书「9527|AI 工具实测」上一篇测的是没有显卡怎么跑本地模型:Nemotron 3.5 Bolt E4B 在一台 16GB 内存的机器上每秒出 11 到 15 个 token。这一篇他试的是英伟达给这个模型配的 DFlash 草稿模型,官方只在 RTX 5090 上测过,CPU 不在官方的范围里7。
投机解码是这么回事:小模型一次猜一整块 token,大模型一起检查,猜对的直接收下。这份草稿模型 3.6 亿参数、约 0.74GB,每轮最多猜 7 个7。
条件写得比多数实测细:8 vCPU 的 Xeon 服务器(带 AMX 指令),没有 GPU,llama.cpp 用官方 CPU 包 b11808,8 线程,温度 0,5 个提示各跑 3 次取中位数7。
总账是 14.46 到 27.99 token/s,约 1.9 倍,草稿接受率 33.9%,内存多占 1 到 1.2 GiB7。
拆到任务类型,1.9 这个平均数就散开了。抽 JSON 3.25 倍,做数学 2.17 倍,写代码 2.07 倍,英文摘要 1.45 倍;写中文短文是 0.77 倍,也就是开上草稿反而慢了两成,那一组接受率只有 11.7%7。
llama.cpp 自带的 ngram-mod 不用草稿模型,他测到 1.82 倍。两个数放在一起要打折扣:ngram-mod 靠同一个提示反复问才拿得到这个数,第一次跑并没有加速,DFlash 第一次就快7。
至于官方那句「无损」,他自己也验不了:不加速时用同样设置跑三次,回答本身就不完全一样,逐字节比对对不上7。
开的方法是一行参数:原命令后加草稿模型路径、--spec-type draft-dflash、--spec-draft-n-max 77。
他自己的结论是:主要填 JSON、写代码、算东西,值得开;主要写中文,先开关各跑几次再定。只测了这一台服务器,笔记本大概率更慢7。
五、同一道机器人题:3,270 次动作与 514 次动作
AA-Robotics v0.1 是 Artificial Analysis 10 月 14 日发布的研究预览,八道桌面任务,五款前沿模型各自在编码智能体外壳里直接控制一台六轴机械臂,五个关节加一个夹爪,型号是 Hiwonder NexArm。模型只能通过 HTTP 接口发指令,靠四路摄像头看画面,全部零样本8。
今天凌晨 AA 把其中「写 hello world」这一项的两段录像并排贴了出来。左边 Claude Opus 5.5 一个点一个点地戳,全程 3,270 次机械臂动作、34 分钟;右边 GPT-6 Astra 连笔写,514 次动作、13 分钟2。
Loading content card…
动作数差 6.4 倍,时间差 2.6 倍。帖子本身没给分数,我从同一份榜单的逐题表里对上了这两行:Astra 这一项满分 100,Opus 5.5 拿 45 分,属于部分完成8。
八道题摊开看,差距落在做没做完这一步。按按钮、把鳄鱼玩具放进方框这两项,五款模型全部满分。倒饮料一项,Astra 与 Argon 满分,Sol 是 0,Opus 5.5 拿 25,Fable 5.1 拿 30。量箱子一项五款都没有满分,最高的是 Sol 与 Opus 5.5 的 17 分8。
总分是 Astra 69.4、Sol 64.6、Argon 55.3、Opus 5.5 48.8、Fable 5.1 46.38。
代价那一栏把名次翻了个面。Astra 平均每题 30 分钟、16.36 美元;Sol 只要 1.93 美元。分数差 4.8 分,价钱差 8.5 倍。人做同样一道题平均 20 秒,模型慢了约 100 倍;花的钱里七成落在输入上下文上8。
抓东西的成功率也有具体分母。Astra 45%(95 次抓取)、Fable 44%(89 次)、Opus 40%(100 次)、Argon 36%(75 次)、Sol 28%(111 次)。Sol 抓得最多,成的比例最低8。
最反直觉的一条写在活动时间那一节:Sol 在约 17 分钟时搭起了一座能通过的塔,之后接着改,最后把任务弄失败了。AA 的说法是,模型在物理空间里判断「已经做完了」这件事,还没学会8。
这份榜也有要打折的地方。八道题是研究预览,样本量按尝试次数算;三套外壳(Codex、Claude Code、Antigravity)都在 high 档,模型之间的差别和外壳之间的差别分不开;Argon 的活动时间是从 token 比例估出来的,因为 Antigravity 不给每一步打时间戳8。
顺带
- 一次请求的电费,作者把假设全写出来了。 60k 输入(其中 50k 命中缓存)、2k 输出、90% 在线率,架在一台 4070 Ti Super 上(500 瓦、预填 1,000、解码 50 tok/s、每度电 0.30 美元):每次请求 51 秒、电费 0.0021 美元,一天 1,540 次,一个月 97.20 美元。同一请求走参考价 API(输入 0.25 美元每百万、缓存 0.02、输出 1.20)是 272.54 美元一个月。他自己列了三条假设:缓存 token 按 1/100 的时间算、API 价是固定参考、电价按 0.30 美元;换成 0.14 美元一度电,同一台机器省下的从 64% 变成 83%10。
- 首字从 18.6 秒到 0.39 秒,只在第二遍成立。 Rapid-MLX 0.16.9 的发布说明写:约 32K token 的同一段提示词问第二遍,首字等待从 18.6 秒降到 0.39 秒。做法是前缀缓存落盘(重启软件、重启电脑都还在),加上给 Qwen3.5/3.6 这类混合架构做状态快照。发布说明自己补了两句:47 倍只出现在重复的长提示上,第一遍该慢还是慢;短聊天基本无感。这是官方账号的自述,只有一条读数11。
- 24GB 的机器跑 125B,三个数字放一起对不上。 作者在 M4 Pro 24GB 的 Mac mini 上跑 Qwen3.8-Flash-Next,权重是 76GB 的 GSQ RCO IQ3_XXS:短提示 11 tok/s、长上下文 8.5、预填 180、上下文 65K,而峰值运行内存 9.5GB。这个数原文没说算的是哪一部分,只写了「从预填到最后一个 token」;评论区在追两件事:标题该写清是哪个量化档,以及作者说的「Q3 保住 95% 能力」站不站得住。代码还没放出来12。
- 模型权重里跑起了一台 CPU,然后是 Doom。 有人把一台 32 位 RISC-V 处理器写进 Qwen3.5-4B 的权重里,让模型自己执行指令,写了一份说明并放了仓库13。几小时后另一个人在这台虚拟机上跑起了 Doom,作者的原话是很慢,仓库也公开了14。两条都是演示,没有速度读数,看看就好。
在自己机器上先对一次账
- 看到名次,先找裁判之间的一致度。39 个模型那份榜,作者自己给的分辨率是 0.4 分,比这小的差距他自己算平手3。
- 看到一个变体掉分,先看掉的是哪一位小数。剪掉 32 个专家掉 0.03,剪掉一半掉 0.96,两刀差出三十倍6。
- 看到一个倍数,先按任务拆开。1.9 倍里有 3.25 倍,也有 0.77 倍7。
- 看到「同一道题」,先看它给的是分数还是过程。同一项任务上,3,270 次动作换 45 分,514 次动作换 100 分8。
今晚能做的:挑一条你常用的提示词,在自己机器上连跑两遍,分别记下第一次和第二次的首字时间。第二遍快出来的那一段,就是你那台机器上前缀缓存真实生效的量11。
References
- 1小红书 Eli Wang《刚开源!3.2G超长文档OCR,16G Mac实测》
xiaohongshu.com
- 2
- 3
- 4
- 5Hugging Face baidu/Unlimited-OCR-2
huggingface.co
- 6Hugging Face akhaliq/nemotron-3.5-transcribe-mini-64e
huggingface.co
- 7小红书 9527《没显卡给本地模型提速:实测1.9倍》
xiaohongshu.com
- 8Artificial Analysis《Introducing AA-Robotics v0.1》
artificialanalysis.ai
- 9公众号 浩轩AI智能体《百度开源 Unlimited OCR 2,能啃 3600 页,标题层级 48.2》
mp.weixin.qq.com
- 10
- 11小红书 Rapid-MLX 实验室《首字从18.6秒到0.39秒,0.16.9做了什么?》
xiaohongshu.com
- 12
- 13
- 14
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.