900 t/s 是预填、20 tok/s 出自 48GB 的机器、72% 与 68% 的差 p=0.38
七组当日实测逐条拆开:AA 智能指数换到 v5 后六成是私题、四个本地模型在同一张 16GB 卡上各跑 112 次、一张 P40 的深度曲线、三篇公众号的预填与生成,以及四台 GB10 的八路合计。

10 月 27 日晚上 6 点 20 分,公众号「社畜小宏」把同一台 AMD Ryzen AI Max+ 395 小主机重测了一遍。上一篇里长文读入是 230 到 300 tok/s,有读者说他们测慢了1。
今天上午 10 点 11 分,独立评测机构 Artificial Analysis 把智能指数升到 v5,六成的分数改由私题与封存答案决定2。
今天下午 6 点 28 分,r/LocalLLM 上有人把四个本地模型塞进同一张 16GB 显卡,每个模型各跑 112 次,前两名的差距在配对检验里 p=0.383。
这一期覆盖 10 月 27 日傍晚到 10 月 28 日傍晚,来源是 X、Reddit 的两个本地模型版块、小红书与公众号。
这几件事放在一起,形状是一样的。被转发的那个数,和作者真正量到的东西之间,隔着一句被省略的限定:量的是预填(读入提示词那一段)还是生成、是单流还是八路合计、是 48GB 的机器还是 16GB 的机器、是一次改过内核参数才成立的读数。
| 材料 | 被记住的那个数 | 它量的是什么 | 换成另一种量法 |
|---|---|---|---|
| AA 智能指数 v5 | Opus 5.5 max 58 分 | 六成私题下的综合分 | v5 与 v4 是两套题,跨版本的分要重读 2 |
| 四个本地模型,各 112 次 | Sage 72%、Tiel 68% | 同一张卡上的通过率 | 配对检验 p=0.38,前三名落在噪声里 3 |
| AMD 395 换引擎 | 读入 1130–1250 tok/s | 预填 | 生成 20.5 对 21.5,基本没动 1 |
| 8GB 笔记本 | 900 tok/s | 提示词处理 | 生成 30 tok/s 4 |
| 16GB Mac 跑 105GB 模型 | 20 tok/s | 48GB M5 Pro 的实测 | 16GB 档是 1–6 tok/s 的推算 5 |
| 四台 GB10 | 171.66 tok/s | 8 路合计 | 单流 25.57,合计约 6.7 倍 6 |
一、一份换了算法的榜:六成的分数不再公开
v5 新加了两个基准。FrontierCode 2.0 是 Cognition 刚发布的私题,判分标准是仓库维护者会不会合并智能体提的那次改动;Terminal-Bench-Science 有 70 个在终端里完成的科研任务2。
Loading content card…
升级的三项是 HLE-Diamond、AA-Omniscience v1.1 和 CritPt v2。HLE-Diamond 从 Humanity's Last Exam 里取出 1,000 题,推理与知识各一半;CritPt v2 是 40 道私题,由原作者修订,运行时带代码执行工具2。
留下的是 AA-Briefcase、AutomationBench-AA、GDP.pdf 和 Terminal-Bench 4.0;移出的是 GDPval-AA v2.1、SciCode 和 AA-LCR v1.12。
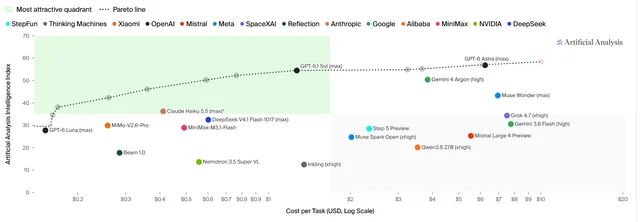
新排名里,Claude Opus 5.5(max)58 分第一,GPT-6 Astra(max)57、GPT-6.1 Sol(max)55 紧随其后,Gemini 4 Argon(high)50 排在后面。官方说前五名都由 Anthropic 与 OpenAI 占着2。
官方最想让人记住的是开源那一栏:差距从 3 分扩大到 12 分。Kimi K3.1 Pro 以 46 分当上开源第一,它的权重还没放出来;真正放出了权重的 DeepSeek V4.1 Flash 1017(max)与 GLM-5.3(max)都停在 32 分,比榜首低 26 分,也低于 Claude Haiku 5.5(max)的 362。
成本那一栏差得更开。分数最高的十款模型里,GPT-6.1 Terra(max)每做一道题 0.96 美元,Claude Fable 5.1(max)要 13.04 美元,超过 13 倍2。
v5 最实质的变化在这里:60% 的分数由私题与封存答案决定。它让榜单更难被针对性刷分,也让外人算不出那个分数是怎么来的7。
r/LocalLLaMA 上两条反应都冲着这件事。一位用户说,六成私题意味着复现结果已经不可能,他对排名的信任跟着下降7。
另一位用户 /u/Realistic_Gap_5871 贴出截图:v5 的「最有吸引力象限」里一个开源模型都没有。他自己补了一句,截图是在 AA 还在陆续上新分数时截的,右上角 GPT-6 Astra 的点还是浅色8。
这两条是评论,都没有给出自己的测量。它们能说明的是,换版之后读者最想知道的已经从「谁第一」变成了「这个分数还对应什么」7。
二、同一张 16GB 卡,四个模型各跑 112 次
这台机器的配置是 RX 7800 XT 16GB、Ryzen 5 5600、32GB DDR4、ROCm 7.2.4。发帖人是 /u/HIKKIAN,下一节要讲的 shura.cpp 也出自他手3。
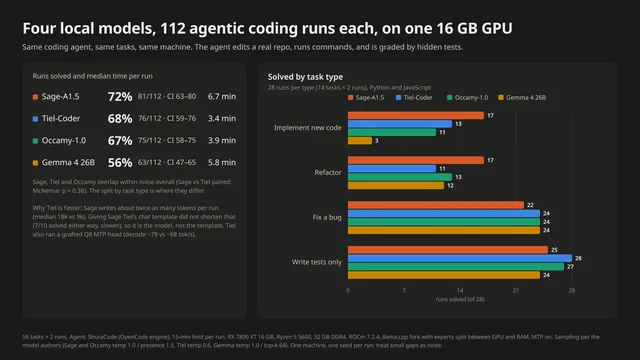
智能体用 ShuraCode(OpenCode 的引擎),题目要求它改一个真实仓库、自己跑命令,最后由隐藏测试判分。56 道题各跑两次,每轮 15 分钟上限,超时记零。采样参数按各家作者的建议:Sage 与 Occamy 温度 1.0、presence 1.5,Tiel 温度 0.6,Gemma 温度 1.0、top-k 64。每个模型每道题只跑一个种子3。
| 模型 | 解出 | 95% 区间 | 每次中位耗时 |
|---|---|---|---|
| Sage-A1.5 | 72%(81/112) | 63–80 | 6.7 分钟 3 |
| Tiel-Coder | 68%(76/112) | 59–76 | 3.4 分钟 3 |
| Occamy-1.0 | 67%(75/112) | 58–75 | 3.9 分钟 3 |
| Gemma 4 26B | 56%(63/112) | 47–65 | 5.8 分钟 3 |
四个模型的分数排成一条队,看着像三个梯队。配对检验给出的是另一个答案:Sage 对 Tiel 的 McNemar 检验 p=0.38。按作者自己的说法,前三名落在同一个噪声范围里3。
按题型拆开,差异就从分数里露出来了。
Gemma 4 26B 在「写新代码」这一栏只拿到 3 次,其余三栏都在 24 次上下。它靠修 bug 和写测试补回了大半差距,最终落在 56%3。
Tiel 快,原因写在作者自己的统计里。Sage 每轮写的 token 中位数是 18k,Tiel 是 9k,整整两倍;他把 Tiel 的对话模板套给 Sage,输出没有变短,7 道题两种模板都解得出,速度也一样慢3。
Tiel 还额外接了一个 Q8 的 MTP 头(多 token 预测,一次起草几个 token),解码从约 68 提到约 79 tok/s。这部分提速来自引擎,和模型本身的能力无关3。
作者把边界写在图下:一台机器、每个组合一个种子、小分差当噪声看。帖子发出时评论区还是空的,这些数字还没有别人复现或反驳。112 次看着不少,实际是 56 道题乘 2 次3。
三、为了让浏览器不卡,他改了一版引擎
同一张显卡上跑 Tiel-Coder-35B-A3B,模型本身没毛病,麻烦出在别处。显存被模型吃满之后,打开一个视频或者进个会议,整个桌面就开始卡,合成器还会被挤出显存9。
他在 llama.cpp 上加了一个显存调节器。默认给桌面留 1.5 GiB,再加 256 MiB 缓冲;桌面忙的时候缓冲提到 512 MiB。平时每 200 毫秒看一次空闲显存,紧张时改成 50 毫秒9。
他自己的实测是这样:模型正在读提示词,Brave 突然多要 1.7 GiB。空闲显存跌到预留线以下 0.05 到 0.2 秒就恢复,那次请求照样做完了9。
长预填也能被打断。后端每 3 秒留一个回滚点,预填被打断就从最近那点重来,作者量的开销在 1% 以内。缓存已经缩无可缩时,服务把请求状态存盘退出,网关换个更小的内存占用重启,再接着同一条回答往下写9。
AMD 的驱动坑他单独写了一节。释放一块内存,不等于那块显存马上能用;他让缩放先等旧内存真正交还,再申请新缓存。改之前,会看到最多 1.8 GiB 的假缺口9。
读数:短提示解码约 75 tok/s,100K 上下文约 49;预填比上一版快 16.3%(28K)和 7.9%(100K);短提示的解码基本没变。KL 散度 0.0346,自比基线 0.0343,质量上的差别量不出来9。
压力测试是 40 分钟、384 个请求,28K 到 34K 的长提示混着短提示,没有失败请求,显存也在预热后稳住。100K 上下文的超长预填在暂停时,他会量到约 1.15 秒低于预留线9。
限制他自己列了:只在 AMD gfx1101 加 ROCm 上正经测过,CUDA 版本能编译但没跑分;装法是从源码编译;还有一个已知的 bf16 MUL_MAT_ID 测试会抖。仓库是 MIT 许可10。
上一节那张 112 次的表,就跑在这支 fork 上。同一台机器、同一个作者、同一版引擎,工具与考卷出自同一个人,这一层读者需要知道9。
四、一张 P40 上的两天:短提示 65–74,100K 深度 29
r/LocalLLaMA 的 /u/sargetun123 把一张 Tesla P40 24GB 插在 PCIe x1 上,系统是 Windows,引擎是他自己改的 llama.cpp 分支。模型是 Ornith 1.5 35B-A3B,Q4_0 由官方 BF16 自己量化,MTP 草稿长度 2,上下文开满 262k,KV 缓存(模型记上下文用的中间状态)用 q8_011。
Loading content card…
他先关 ECC,换回 1.5 GB 显存,解码快约 9%。KV 缓存坚持用 q8_0:Pascal 上 q4 的 KV 会随深度垮掉,32K 深度是 30.6 对 42.2 tok/s11。
接着是 MTP 头。这份权重第一次上传时草稿头没训好,判断办法是看
blk.40.nextn.shared_head_norm 的均值:约 1.02 是没训,约 2.93 是训过。换到训过的版本,草稿接受率从约 45% 升到 60%–85%11。他还给 flash-attention 分块内核里 KQ 那一半写了 int8 的 dp4a 路径。Pascal 没有张量核心,fp16 也被砍过,dp4a 反而快:32K 预填 +26%,100K 预填 +41%11。
最后一项是让 MTP 头只读提示词的最后 8K。它是全注意力层,长提示上要吃掉约 13% 的预填;改成只看尾巴之后,121K 提示的预填从 327 回到 373 tok/s。主模型照样复核每一份草稿11。
表是 llama-bench 跑的,关掉 MTP,每档两次。真实服务开着 MTP,短提示落在 65 到 74 tok/s;10.1 万 token 的提示读入约 415 tok/s,生成 35 到 3911。
三件试过没成的事写在同一节。f16 KV 在 llama-bench 里更快,进了带 MTP 的真实服务反而更慢、上下文更少;在核心里把 V 反量化掉了 5%;官方 Q4_K_M 的质量分与他自己的 Q4_0 相同,速度更慢、上下文更少11。
他说找不到别人发 P40 的深度数据,所以把整条曲线和补丁一起放了出来。表里的 60.8 与真实服务的 65–74 是同一张卡上的两个数,一个关 MTP、一个开 MTP11。
五、三个公众号:四到五倍、900 t/s、20 tok/s
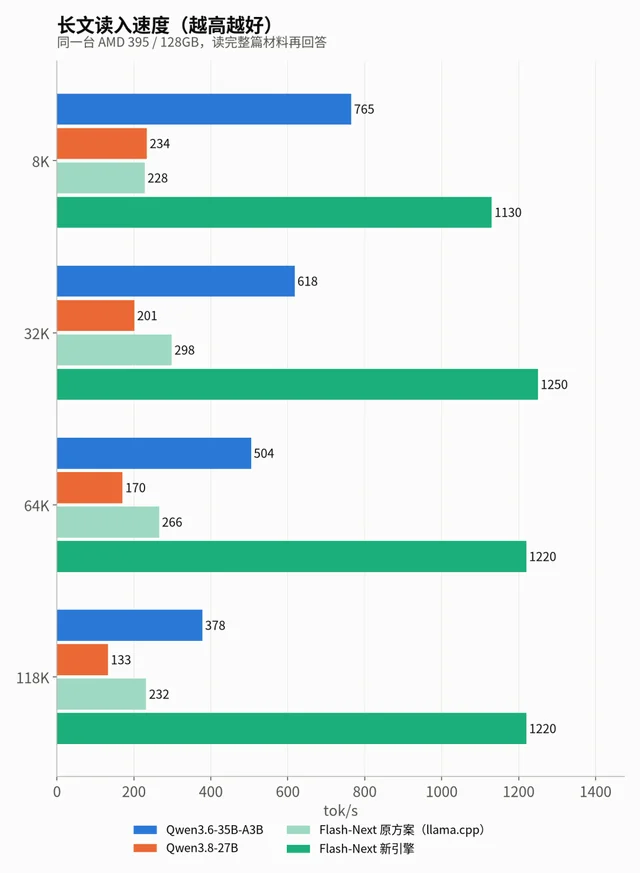
「社畜小宏」那台机器是 AMD Ryzen AI Max+ 395、128GB 内存、Ubuntu。旧方案是 llama.cpp 配 IQ4_XS,权重 93.7GB;新方案换了 strix-halo-engine-lab 引擎,权重换成 UD-Q4_K_XL,111GB1。
| 上下文 | 新引擎首字 / 读入 | llama.cpp 首字 / 读入 |
|---|---|---|
| 8K | 6.8 秒 / 1,130 | 34.5 秒 / 228 1 |
| 32K | 25.8 秒 / 1,250 | 110.2 秒 / 298 1 |
| 64K | 52.6 秒 / 1,220 | 242.3 秒 / 266 1 |
| 118K | 96.9 秒 / 1,220 | 510.2 秒 / 232 1 |
生成那一栏几乎没动。不开 MTP 时,新引擎 20.5 tok/s,旧方案 21.5;64K 与 118K 深度上,两边都掉到 16 到 171。
开 MTP 之后差距才回来:中文写作 35.9 tok/s,写代码 57.8,旧方案分别是 21.5 与 33.4。写代码时草稿接受率高,提速就明显1。
并发上,新引擎 1/2/4/8 路是 30.7、40.0、59.5、57.7 tok/s。同门的 Qwen3.6-35B-A3B 在同一台机器上是 48.0、69.0、88.6、95.6,并发越高领先越多1。
引擎与量化是一起换的,四到五倍里两者各占多少,这份记录分不开。他自己也没做单变量对照1。
这笔账有四个门槛:把内核启动参数的 GTT 提到 124GiB 并重启;给引擎的内存估算打补丁;服务模式手动补两个 flag;还要接受只支持贪心采样。缺一样,快速读入就不开,8K 读入掉到 117 tok/s1。
他还在文末纠正了一位网友的读数。对方说 2 路并发 78 tok/s,他用 llama.cpp 开 MTP、同款 Q4_K_XL、两个槽位复现,1 路 20.0、2 路合计 25.3,草稿接受率约 37%,自己没跑出那个数1。
同一天晚上 8 点 30 分,「墨知有道」发的是另一台机器:RTX 5060 笔记本版 8GB、Ryzen 9 8945HX、32GB DDR5-5200、1TB 硬盘读取 5,200 MiB/s、Linux。模型是 Qwen3.8-Flash-Next 的 Gyro-S 版,量化到 TQ1_0,作者自己写明属于 Q2 级别的激进量化4。
标题里的 900 t/s 是提示词处理,输出是 30 t/s。原文没给提示词长度、上下文长度、batch size,也没有日志,所以那 900 只可参考、不可复算4。
他给的参数是
--mmap-experts、--kv-resident 20480、--vram-reserve-mib 500、--pcie-frac 0.35,外加环境变量 STRATA_RESIDENT_HEADROOM_GIB=4。方法来自复现一位 Reddit 用户的公开配置,他写明了这一点4。三个坑也值得抄下来:8GB 环境先别开 MTP,显存先紧,预填会掉;视觉模块放 CPU 跑,每张图 1 到 2 秒;131K 以上的长上下文别开
--parallel,容易 OOM4。晚上 8 点整,「老郭的学习空间」写的是第三个数字。他介绍的引擎叫 Slotstream,MIT 许可,原生 Swift 加 MLX,把 105.3GB 的 Qwen3.8-Flash-Next 4-bit 从固态硬盘流式读进来,共享权重常驻内存、专家按 token 取用5。
标题写的是 16GB Mac,实测的机器是 48GB 的 M5 Pro。33GB 内存预算下,短提示 20.91 tok/s、较长上下文 23.69、完整编码答案 21.59,三次运行都没有发生内存交换5。
16GB 那一档写在速度表里,标着「约 1–6 tok/s」,同时注明除 48GB 一档外都是按实测曲线推算的。8GB 直接拒绝启动;16GB 机器的完整门槛是 Apple Silicon、macOS 14 以上,外加约 110GB 可用硬盘5。
他还搬来一条第三方对照:Hacker News 上有人在 48GB Mac 上热解码约 12 tok/s,首 token 约 3 秒,峰值内存 32GB。这个数低于官方成绩5。
0.2.23 版把 16K 长提示的预填从 155.22 秒压到 53.94 秒。作者也把缺口写完:只支持这一个模型、一次只能跑一个生成任务、没有工具调用、图像输入、JSON Schema、logprobs 与 embeddings;96GB 以上的机器不建议用,全驻留引擎更快5。
三篇文章,三个数字,落在三个位置:一个是预填,一个是另一台机器,一个还在等硬件达标。仓库是公开的,能不能用还得看自己那台12。
六、四台 GB10 的 171.66:八路合计,单流 25.57
新华三智能终端今天下午 6 点 32 分贴出一组自测:四台 MegaCube,每台一颗英伟达 GB10 芯片,把 DeepSeek-V4.1-Flash-1017 的原生权重按 TP4 切成一个副本,每个节点本地存一份完整权重6。
配置写得比多数厂商细:DSpark5、Engram FAST128 线程、RoCE 互联,上下文 300,000、最大序列数 8,每个节点容器上限 112 GiB,预填充批 8,192 token,GPU 内存利用率 0.806。
| 指标 | 读数 |
|---|---|
| 8 路整组吞吐 | 171.66 tok/s 6 |
| 8 路单流解码 | 25.57 tok/s 6 |
| 8 路首输出 P50 | 0.466 秒 6 |
| 长文实测输入 | 260,119 token,中段事实找回 6 |
| 基础功能检查 | 17/17 6 |
| 视觉与工具原脚本 | 7/7 6 |
171.66 除以 25.57 是 6.7。八路并发换来的总吞吐,是单流读数的 6.7 倍,平均每一路约 21.5 tok/s。这个换算没有写在原帖里,是我按两个读数除出来的6。
0.466 秒的首输出 P50 需要留一句:P50 指一半请求在这段时间内开始输出,原文没写这批请求的提示长度。26 万 token 的那次是单独一项,两者能不能对上,图里看不到6。
整组数字出自厂方自测,帖子里附了八张配置与结果图,没有第三方复现。同一天社畜小宏在 118K 上量到 96.9 秒首字,两边量的是不同长度、不同硬件、不同模型,摆在一起只能看量级1。
顺带
- 同一道题四种编排,本地当工人 0.40 美元。 一个小型 Python 记账应用分五部分,配 38 个隐藏测试,M5 Max 64GB,每种编排跑一次:Codex 配 GPT 5.5 用 5 分 38 秒、38/38、1.32 美元;Claude Code 配 Opus 5.5 用 6 分 57 秒、38/38、1.27 美元;Paseo 团队 5 分 25 秒、38/38、1.13 美元;Opus 5.5 规划加本地 Qwen3.8-27B 执行的 Fusion 模式,3 分 11 秒、38/38、0.40 美元。四组都没有合并冲突。Paseo 那组的领队看了任务之后自己干完了,一个工人也没派13。
- 免费模型当质检员,五天没省下钱。 公众号「启成 AI」把质检位交给免费池,五天里遇到五种情况:审到一半没声音、写不出凭证就总结、引用不存在的代码行、整池限流、格式不匹配被机器判成没附凭证。免费上游崩溃那次,104 条路由里 5 条被限流、99 条没有 key,冷却实测约 41 分钟。他的结论是把判断位和供给位分开算账,判断位留给最贵的那个模型14。
- 一个 1.3B 的 OCR 模型,配一个 2B 的判官。 OpenBMB 放出 MiniCPM-OCR 1.0,在 Real5-OmniDocBench 上报 93.68 分,DSpark 解码把端到端效率提了 55%;另一个 MiniCPM-OCR Jev 拿原图与候选文本比对,AUROC 0.936(给对错排序的能力,1 为满分),官方称接近同一评测上一个 397B 参数模型。两个数都是厂商自报,模型页今天下午刚更新1516。
- 64GB Mac Studio 上换了一版引擎。 X 上一位日本用户把 Strata 更新到 0.2.7、引擎 0.1.52,装入 Qwen3.8-Flash-Next 的 IQ3_S(83.6GB)。他的说法是 tok/s 比 Q2_0 慢,长文里不再混进中文,回答质量明显上来。这组只有体感与一句速度比较,没有逐项读数17。
在自己机器上先对一次账
- 看到 tok/s,先问它量的是预填还是生成。老郭文里那 20 tok/s 是生成,社畜小宏的 1,130 是预填,同一台机器上两者差五十倍很正常1。
- 看到总吞吐,先找单流那一栏。四台 GB10 的 171.66 除以 8 路单流 25.57,只剩 6.7 倍6。
- 看到「某台机器跑得动」,先确认那台机器的内存。105GB 模型在 48GB 上报 20.91,16GB 档标的是推算值5。
- 看到名次,先找区间。四个本地模型的第一名与第三名只差 5 个百分点,配对检验 p=0.383。
今晚能做的:挑一条你正在用的提示词,在自己机器上分别记一次预填耗时和生成耗时,再把这篇文章里任意一个数字按同样的口径换算一遍。换完你大概会发现,能对上号的只有那么一两个11。
References
- 1公众号 社畜小宏《复测 Flash-Next:换了引擎,AMD 395 上长文读入快了 4~5 倍》
mp.weixin.qq.com
- 2
- 3
- 4公众号 墨知有道《8G显存的笔记本,把新模型跑到了900t/s》
mp.weixin.qq.com
- 5公众号 老郭的学习空间《105GB大模型塞进16GB Mac》
mp.weixin.qq.com
- 6小红书 新华三智能终端《DeepSeek-V4.1-Flash-1017本地部署实测》
xiaohongshu.com
- 7
- 8
- 9
- 10GitHub hikkian/shura.cpp
github.com
- 11
- 12GitHub carloslfu/slotstream
github.com
- 13
- 14公众号 启成AI《我让最便宜的模型当质检员》
mp.weixin.qq.com
- 15
- 16Hugging Face openbmb/MiniCPM-OCR-1.0
huggingface.co
- 17
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.