4090 的指令吞吐翻一倍、2080 Ti 只换回 4.15%、KV 降到 5 比特要留一道 2k 窗口
七组来自公众号、小红书、Reddit、X 与 arXiv 的实测:每个「翻倍」都量在硬件或内核那一层,旁边写着它到真实任务里被哪道墙截住——功耗上限、PCIe 通道、张量利用率、缓存窗口,或一道训练。

10 月 25 日傍晚 6 点 42 分,公众号「论文认知」发出一篇自测。
作者在自己那张 4090 上量到,FP16 输入、FP32 累加的吞吐是 165.6 TF/s,和官方规格表上的 165.2 几乎重合。解锁后的公开数据是 331.6 TF/s1。
今天上午 9 点 30 分,小红书用户「小猪」交了自己两张 2080 Ti 22G 的成绩:张量算力从 55.4 拉到 85.7 TF/s,涨 54.8%;同一台机器上跑 Strata,26 档提示词长度平均只快 4.15%2。
昨晚 11 点 05 分,r/LocalLLM 上一张 KV 缓存的逐档对照表给出第三个数。缓存压到 8 比特,相对 16 比特的损失测不出来;压到 5、6 比特,只要最近 2,048 个 token 保留 8 比特,损失也回到零附近3。
今天下午 2 点 06 分,r/LocalLLaMA 转出一篇斯坦福与伯克利的论文:长上下文预填的首字时间最多快 11.3 倍。帖子标题下面第一条评论只有一句「i hope it's real」4。
这四个数字分别量的是寄存器里的指令发射率、张量算力、缓存精度和首字时间。它们都成立,而你自己的任务里量不到这四个数。中间隔着几道具体的墙:功耗上限、PCIe 通道、张量利用率、缓存窗口,还有一道训练。
| 材料 | 量的是什么 | 主读数 | 到任务里剩多少 |
|---|---|---|---|
| 4090 的 gpu-unlock 分支 | 寄存器内 FP16 指令吞吐 | 165.6 → 331.6 TF/s,2.002 倍 5 | 同卡 cuBLAS GEMM 只涨 12% 到 34.4%,4096³ 反而持平 |
| 小红书 小猪的两张 2080 Ti | 解锁后张量算力与同机预填 | 55.4 → 85.7 TF/s,+54.8% 2 | Strata 26 档平均 +4.15%,wait copy 占 72.8% |
| 双 3080 20GB 的 vLLM 对照 | 8K / 32K / 128K 单流预填 | +33% / +34% / +36% 5 | 换 Strata 只剩 0.8% 与 12% 到 13%,decode 两边都不动 |
| Qwen3.8-27B 的 KV 缓存 | 相对 q8_0 的 KL | q8_0 与 fp16 等价 3 | 5/6 比特要配 2,048 token 的 8 比特窗口才接近无损 |
| 30 天墙插电表 | 自建电费对 API 账单 | 14.05 美元 6 | 作者把 10.72 倍改成约 2 倍,显卡钱还没算 |
| TokenGate 的 1.7B 实验 | 长上下文首字时间 | 1.4 到 11.3 倍 7 | 每个任务要单独训门控与 LoRA,11.3 倍是上限 |
一、4090 上的 2.002 倍,在矩阵乘上只剩一成二到三成四
10 月 18 日,一个叫 gpu-unlock 的 Linux 内核模块仓库上线。它在 NVIDIA 驱动绑定显卡之前运行,往 speed-select 寄存器写值,再发起一次 PCIe 复位5。
被锁的是 SM 里 FP16、BF16 结果往 FP32 累加时的指令发射率。同一颗芯片上,出厂把这条通路写成半速,锁写在寄存器里,和电压、频率、散热都没有关系1。
「论文认知」的作者把自己那张 4090 量了一遍,半速档的 165.6 TF/s 与官方规格表几乎一样。他还试着抬功耗墙,
nvidia-smi -pl 600 直接被打回,450W 是这张卡 VBIOS 里写死的上限。五天后,Ada 移植分支在 4090 上跑通。
公开记录里,FP16 加 FP32 从 165.6 到 331.6 TF/s,正好 2.002 倍;BF16 从 165.5 到 330.6,1.998 倍。INT8、dp4a 与标量 FP32 原地不动,一个 E4M3 的 FP8 GEMM 只变 0.3%5。
同一个仓库后来补了一组同卡、同驱动、同 450W 的复测,结果分两层。
指令吞吐从 160.4 到 320.4 TF/s,确实翻倍。换成 cuBLAS 的真矩阵乘,FP16 在 12% 到 34.4% 之间,BF16 在 1024³ 与 8192³ 上 16% 到 19.6%,4096³ 那一档是 0.995 倍,等于没变5。
到应用层,收益取决于你的程序有多少时间花在这条通路上。
双 3080 20GB、每卡锁 220W、vLLM 跑 27B 的 W4A16 双卡张量并行,8K、32K、128K 单流预填分别提升 33%、34%、36%,首字时间缩短 25% 到 26%5。
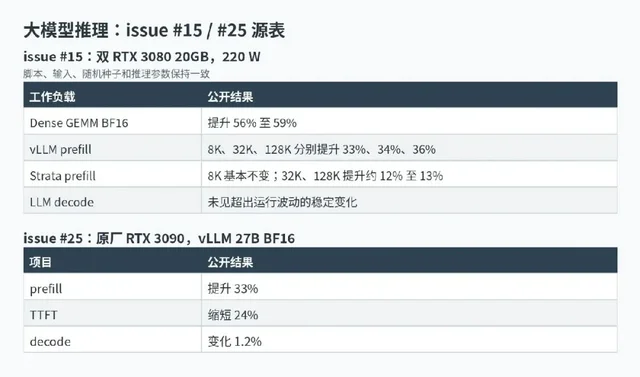
同样的双卡,换成 Strata 引擎,8K 只提升 0.8%,32K 与 128K 约 12% 到 13%。decode 在两种引擎上都没有超出运行波动的变化。
原厂 3090 那一组也一样:约 2.9K 提示下预填提升 33%、首字时间缩短 24%,decode 只变 1.2%5。
再往应用深处走一步,收益还会被摊薄。两个 INT4 的扩散模型在 ComfyUI 里,热运行时间从 9.30 秒降到 7.98 秒、从 9.34 秒降到 8.17 秒,缩短 14.2% 与 12.5%,出图逐字节一致。
一个 INT8 占比很高的 vLLM 分支里,BF16 与 FP16 的 kernel 只占 29% 的 GPU 时间,端到端约 5%,落在运行波动里5。
所以同一张卡上有三个数:寄存器里 2.002 倍,矩阵乘上一成二到三成四,引擎预填里三成三。它们量的是同一件事的不同层,各自被不同的东西卡着。
二、2080 Ti 的 +54.8%,为什么只换回 4.15%
「小猪」手里是两张 2080 Ti 魔改 22G。她刷到的项目叫 KohakUnlock,只认 Leadtek 那一版 2080 Ti,作者自己在说明里写着「Not a universal GPU unlocker」。
她的是 MSI 卡,设备号对不上。
于是她把移植这件事丢给了一个 agent,过程里撞上三处坑。
第一处,她改的
#else 分支根本没被编译进去,真正的开关是 #ifdef TX_EXPERIMENT_V4,日志看起来和「改了没效果」一模一样。第二处,选择器的取值每张卡每次开机都不同,同一张卡她见过 0/0、0x4010/0x5、0x0/0x2 三种。
第三处最阴,脚本只检查
tu102_lab.target= 这个键在不在,不检查它的值,取值缺失时回落到硬编码的默认值,日志正常,却解锁了另一张卡2。解锁本身是易失的,断电就没了。同一张卡上一轮读到 88.32 TF/s,下一轮 55.34。最后她把整套流程塞进 initramfs,做成开机自动重放。
硬件这一层确实动了。FP16 到 FP32 的累加从 55.4 拉到 85.7 TF/s,涨 54.8%,另一张卡 88.3;BF16、TF32、INT8 全部落在 ±2.3% 以内。
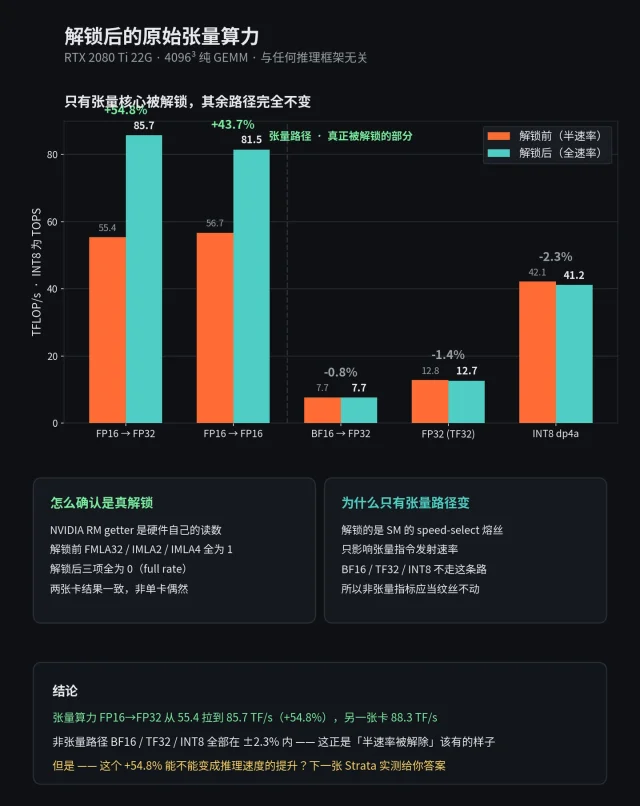
落到推理上,同样这套权重、同一个引擎,26 档提示词长度全部为正,平均只快 4.15%。
她在第 4 页把三条限制逐条量了出来。
第一,这两张 22G 魔改卡跑在 PCIe x4 上,实测单向带宽 3.94 GB/s,换到 x16 是 15.75 GB/s。
第二,一次 3,059 token 的预填,时间线 9,480 毫秒里有 6,899 毫秒耗在 wait copy,占 72.8%。真正干活的 gate/up、gemm down、反量化加在一起不到两成。
第三,MoE 的每个专家只分到 71.9 个 token 行,而张量 tile 高 64 行,第二个 tile 只填到 56.1%,张量算力利用率落在 1.2% 到 1.9%2。
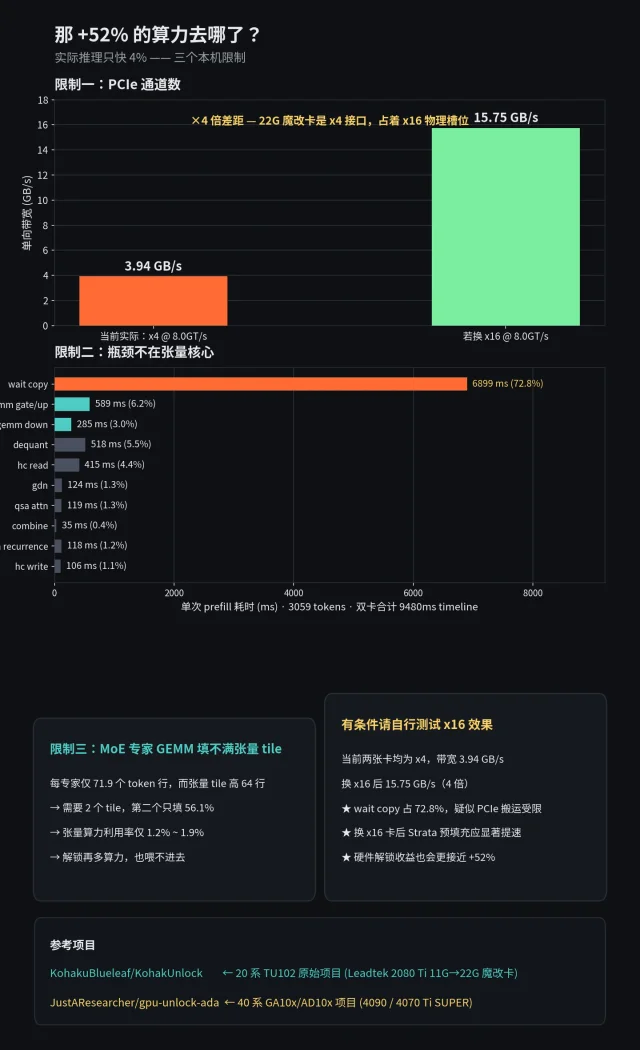
她自己的建议是换 x16 再测一遍,那时收益应该更接近 +52%。这也解释了为什么同样一套解锁,在别人机器上能拿到三成以上:瓶颈落在不同的位置上。
同一天还有两个反例。
一个是 RTX 3080 Ti 20G OEM:模块全程走完,SS0 在驱动运行期间也保持目标值,BF16 仍然停在半速。日志里「unlocked」四个字说明不了性能5。
另一个是今天傍晚 6 点 46 分刚发的一张 4090-48G:参数上标称 ×2,撞在 450W 功耗墙上,实际到手约 ×1.28。
「论文认知」那篇把三类做了也白花的负载列了出来:decode 密集型是纯带宽瓶颈,实测提升接近 0;量化推理走 INT4、INT8,不经过这条通路,FP8 GEMM 只有 0.3%;20 系与笔记本型号不在受理范围,Turing 没有公开的 payload1。
小红书用户 Will 的提醒有 54 个赞:30 系本来散热就成问题,他建议多等,或者干脆设一道更严的功率墙再降压;他也点明 int8 拿不到好处,而实际跑 LLM 的人很少用 fp16、bf169。
代价在启动链上。这套流程要关 Secure Boot、改启动参数、把模块写进 initramfs,上游自己标的是 experimental。
「论文认知」的交付流程里还多一条:开机后先跑一次
nvidia-smi,这张卡这一轮就再也解不开。掉电即恢复,最坏情况是这次没解开。三、KV 缓存:q8_0 不要钱,K 比 V 敏感 2.3 倍
这条帖子的作者正在为 Qwen3.8-27B 写自己的引擎,顺手把 KV 缓存的每一档量化代价量了一遍。
方法值得看一眼。他用 llama.cpp 自己的 q8_0 输出做参照,在每个位置比较前 256 个 token 的概率分布,取约 13,000 个短提示位置,再加 32k 与 64k 的长上下文。
模型是 unsloth 的 UD-Q4_K_XL,跑在一张 3090 上3。
选 KL 是因为困惑度会把大部分差异抹平。每张表里的数都是「比 q8_0 缓存差多少」,越低越好。
第一条结论最省钱:q8_0 等于免费。64k 上下文上,fp16 缓存读 0.00161,q8_0 读 0.00163。这个模型上没有理由跑 f16 的 KV。
第二条:8 比特以下,K 比 V 疼。逐层扫描下来,K 的敏感度约是 V 的 2.3 倍。
不开窗口、用普通格式,短提示上 K 压到 6 比特是 +23%;V 压到 6 比特 +12%、5 比特 +40%、4 比特 +181%。K 和 V 都压到 4 比特,KL 是 q8_0 的 4.6 倍。
所以显存不够时,先把 V 降下去3。
第三条最实用:伤害几乎全在最新的 2,000 个 token 里,因为注意力把大部分权重放在那儿。把最近的位置留在 8 比特、更老的随便压,32k 那组里 V 压到 5 比特就从 +16% 变成 0%,K 6 比特配 V 5 比特是 +1.4%。
这个窗口很便宜:所有注意力层的 K 与 V 加在一起,2,048 的窗口占 114 MiB,32k 和 262k 上下文都是这个数3。
第四条推翻了不少流行做法。Lloyd-Max 码本、逐行缩放、随机符号、角度编码,都不比朴素的 per-32 网格好,3 比特的格式大约 +300%。
有了 2k 窗口之后,旋转(Hadamard)也不再重要:K6 配 V5 在窗口下是 +1.4%,旋转后 +2.7%,落在噪声里。
他自己跑的是 K 6 比特、V 5 比特、最近 2,048 个位置 8 比特。120k 上下文比 q8_0 省 1.1GB。
262,144 的完整上下文放进 23.5GB 显存,在该深度解码 66 tok/s,needle 4/4;六套题上 230/282,和 q8_0 逐套相同3。
边界写在最后:Qwen3.8 是混合模型,64 层里只有 16 层是注意力,其余是 DeltaNet,全注意力的模型未必同一个结论,他希望有人跑一遍同样的窗口扫描。另外 32k 那组本身的噪声约 4%,小于这个幅度的差异只能当噪声读。
四、30 天电表:作者把 10.72 倍改成了约 2 倍
一位在瑞士的用户把一台专门跑推理的机器插上功率计,记了 30 天。
硬件是一张 RX 7900 XTX 24GB,llama.cpp 跑 GGUF 格式的 Qwen 与 Ornith 模型,机器 24 小时开着6。
30 天的账:输入 9.64 亿 token,输出 1,300 万 token,墙插电量 30.20 kWh,电费 14.05 美元(12.38 瑞郎)。
按 qwen3.8-flash 每百万 token 输入 0.15 美元、输出 0.47 美元折算,同样的量走 API 是 150.71 美元,10.72 倍。
这条帖子最有价值的部分是他自己的编辑。评论区指出,他把 9.64 亿输入全按未命中的价格算了;缓存命中的输入是每百万 0.016 美元,而 agent 类负载里 90% 到 95% 的输入本来就是命中缓存的。
重算之后,API 那一侧是 28 到 34 美元,差距约 2 倍6。他还说功率那条也要拆成空闲与推理两段,正在重算。
没算进去的东西他自己列了:那张显卡约 1,135 美元(1,000 瑞郎),整机折旧,还有一整个月的学习成本——量化、预填与解码的区别、KV 缓存调参、ROCm 的兼容问题、装上又删掉的模型。
他的结论是:本地跑模型得当成个人研发投入来算;只想更快写完代码的人,买便宜的 Flash API 更划算6。
五、DeepSeek 1017 的配方:预填 1,147 到 1,975,解码 26 到 74
r/LocalLLM 上一位用户在一台 L40S 48GB、两颗 EPYC 9754、约 1TB 内存的机器上跑 DeepSeek-V4.1-Flash-1017 的 IQ1_M,引擎是 Strata v0.2.6,嫌慢。
他让 6.1 Sol 充当推理研究员,改了一夜,最后交出一张三栏对照:官方引擎自动档、官方引擎手动打开 DSpark、本地改写版10。
预填那栏:32K 输入是 1,179.9、1,306.7、2,025.7 tok/s;128K 是 1,274.0、1,432.8、2,344.9;510K 是 1,147.2、1,278.4、1,974.7。
解码那栏的差距更整齐:短提示 36.2、37.2、72.0 tok/s;10K 是 34.5、31.4、73.7;510K 是 26.1、22.9、73.7。
官方自动档在这台机器上选择关掉了 DSpark。手动打开时,置信阈值 0.65、预填块 8,192 token。
本地改写做了四件事10。
- 把 CPU 专家与工作线程绑在同一个 NUMA 节点。进程快照显示,原版把线程和内存分在了两个节点上。
- 预填块放大到 16,384 token,配一个 384MiB 的重建权重缓存。
- 预填结束后,把 scratch 里已经分配好的安全区域留给解码用的专家,约 3.7GB、约 500 个专家,不再另开显存。
- MTP 的 GPU 专家槽从 384 减到 192,把省下的显存让给目标模型。
代价也写着:更大的预填块要更多 scratch 内存,还可能引入浮点差异;0.15 那个草稿置信阈值是这台机器上调出来的。
六、TokenGate:11.3 倍的首字时间,换每个任务一道训练
论文 10 月 19 日挂上 arXiv,作者是斯坦福与伯克利的 Liana Patel、Rishabh Ranjan、Ion Stoica、Matei Zaharia、Carlos Guestrin7。
做法是在模型的早期层放一个小门控,给每个文档 token 打分,只保留分数最高的 K 个。
top-K 不可导,他们就把保留 token 的分数当作注意力 logits 的偏置,像 MoE 路由那样处理。上面各层只处理这 K 个 token,其余的连 KV 都不存11。
数在 Qwen3-1.7B 上:首字时间快 1.4 到 11.3 倍,峰值预填内存低 1.5 到 3.4 倍,论文称没有精度下降;相对此前最好的 token 剪枝基线,最多快 6.4 倍7。
混合注意力的 Qwen3.5-2B 上,门控放在第 3 层、匹配标准预填的精度时,首字时间是 3.8 倍低;放到更低的 GatedDeltaNet 层能到 7.8 倍,代价是精度差 6%。
门槛在训练上。报告里的每个任务都要单独训门控参数,同时训一份 LoRA(r=16、α=32,作用在 query 与 value 投影上),用满上下文与对数均匀的剪枝预算一起训到收敛。
论文 5.2 节还记了一处具体失败:K 取 256 时,模型会把短语末尾的停用词留下7。
r/LocalLLaMA 那条转帖拿到的回应就是「i hope it's real」一句。这个怀疑有道理:11.3 倍是 1.7B 上的最好成绩,而要用在自己的活上,先得有那个任务的训练数据。
顺带
- Nanbeige4.3-33B 自报 Terminal-Bench 2.1 为 80.9。 这个 33B 稠密模型上下文到 524,288,模型卡同一张表里 Qwen3.8-27B 是 73.0;它同时是这个系列用来蒸馏 3B 小模型的教师模型。80.9 与 73.0 都来自模型卡自己的对比表12。
- llama.cpp 的 CVE-2026-116096:一个恶意 mmproj 文件能触发越界写。 受影响的是 Pocket-TTS 里的
list_pockettts_state_slots,需要本地访问,利用代码已经公开,升到 b11796 可修13。发帖人补了一句:最新 b11871 上同一个文件会触发 GGML_ASSERT 直接退出,根因修法(PR #29360)还开着14。 - Mac Studio 上 12 件小事:自建与 Sonnet 5.5 都做到 36/36,一边 0 美元,一边每试 0.39 美元。 作者用 Qwen3.8-Flash-Next 跑每天要做的 12 类小活(选对命令、测试失败就直说、承认工具不存在、别反复重试),每件 3 次共 36 次,Opus 5.5 盲评;修了一天之后从 29/36 变成 36/36,Claude 更快。换思考模式后两位评审互相打架:Opus 判他 22 胜、Claude 19 胜、平 18,DeepSeek 判他 16 胜、Claude 10 胜、平 34。他自己说 Claude 那 3 次失分是测试环境的问题15。
- Snapdragon X 的 NPU 上首字最多快 18 倍,但只吃得下小模型。 作者在 16GB 的 Surface Laptop 7 上做了个开源 app,他量到 NPU 跑首字比 CPU 最多快 18 倍、风扇几乎不转,而 CPU 会热到掉 4 到 5 倍性能;Qwen3-4B-Thinking 约 14 tok/s,LFM2.5-8B-A1B 约 31 tok/s。Q4_0 最稳,混合注意力的 Qwen3.5 会成段掉回 CPU,高通预编译包在他的驱动上只加载到约 1.7B16。
在你自己的机器上,先量这四样
- 先问这个数是峰值还是端到端。4090 的 2.002 倍只在寄存器里成立,同卡真矩阵乘剩一成二到三成四5。
- 再看你的活走哪条路。INT4、INT8、FP8 不经过被解锁的那条通路,decode 是带宽瓶颈,这两类做完没有感觉1。
- 硬件账要把通道一起算。2080 Ti 那 4.15% 里,PCIe x4 与 72.8% 的 wait copy 占了大头,换 x16 会比现在更接近 +52%2。
- 便宜的办法往往要先训练或先调参。TokenGate 每个任务要一个门控,KV 的 5、6 比特要配 2,048 token 的 8 比特窗口3。
现在就能做的一件事:用你最长的那条提示跑两组读数,8K 与 128K 各一次,记首字时间和同一段输出的 token/s,同时看一眼
nvidia-smi 或 rocm-smi 里的功耗有没有贴住上限。首字降得动、decode 不动,瓶颈在算力。两个都不动,先查通道和内存。
References
- 1公众号 论文认知《4090、3090 算力解锁实测:张量吞吐翻倍,但这三类负载别碰》
mp.weixin.qq.com
- 2小红书 小猪《2080Ti解锁张量核心:算力+52%只快4%》
xiaohongshu.com
- 3
- 4Reddit r/LocalLLaMA《TokenGate》
reddit.com
- 5公众号 NeuralTalk《五个 GPU Unlock 开源项目》
mp.weixin.qq.com
- 6
- 7arXiv:2610.26754《TokenGate》
arxiv.org
- 8小红书 Weidows《NVIDIA 4090-48G成功解锁, 提升很大》
xiaohongshu.com
- 9小红书 Will《不建议30系n卡强行解锁显卡算力》
xiaohongshu.com
- 10Reddit r/LocalLLM《DeepSeek 1017 prefill》
reddit.com
- 11X @lianapatel_
x.com
- 12Hugging Face Nanbeige4.3-33B
huggingface.co
- 13NVD CVE-2026-116096
nvd.nist.gov
- 14Reddit r/LocalLLaMA
reddit.com
- 15Reddit r/LocalLLM
reddit.com
- 16Reddit r/LocalLLM《Open NPU》
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.