同一模型换个壳子从 69% 掉到 63%、一个 763B 在十台机器上跑出 40 到 410 tok/s、同一个 SD 1.5 四套引擎差 2.76 倍
八组来自 Reddit、X、小红书与公众号的实测,每组把读数与它旁边那个决定读数的东西并排给出:壳子、harness、机器、量化档、框架版本与引擎。

今天傍晚,一位开发者把同一道 Rust 功能交给六种组合各跑两遍,一共 12 个 PR,全部公开。最高那份 6.94 分(满分 8),43.5 分钟,17.78 美元;最低那份 5.06 分,48.1 分钟,0.56 美元 1。
一个多小时后,另一个人把过去 48 小时里同一个 DeepSeek-V4.1-Flash 的解码速度排成一张单。4 张 RTX PRO 6000 报 410 tok/s,同样 4 张卡的另一条报约 200,2 台 DGX Spark 报 40 到 113 2。
今天凌晨,一个公众号在一台没有独立显卡的 5700G 上跑了四套引擎,模型与种子都锁死。换引擎对照批里,同一句提示最快 87.4 秒,最慢 241.6 秒 3。
这三件事量的是同一类东西:一个模型名后面,挂着多少种能把它跑出不同数的方式。本期每组材料都给两栏,读数与它旁边那个决定它的东西。
| 材料 | 相同的是什么 | 差的是谁 |
|---|---|---|
| 同一道 Rust 功能,12 个 PR 1 | 任务、仓库、两遍运行 | 壳子与思考档:87% 到 63% |
| Ornith-1.5-122B 的评测表 4 | 同一批基准、同一张卡 | harness 与反作弊规则:76.9 对 43.9 |
| 一个 763B 的十份解码读数 2 | 权重与模型 | 机器与量化档:40 到 410 tok/s |
| 12 个模型、22 道题、两张卡 5 | 同一套 22 道题 | 显存:×3 与 ×1.6 两种倍数 |
| 10GB 的 3080 6 | 同一张卡、同一套题 | 模型规模与量化档:70.0 到 85.7 |
| EAGLE-4 发布 7 | 同一份发布 | 发布帖与仓库表:961.6 与 241.6→722.8 |
| M4 上的 PyTorch 2.15 8 | 同一台 M4、同一块 GPU | 框架版本:1.11 倍与 4.96 倍 |
| SD 1.5 的四套引擎 3 | 同一个模型、同一种子 | 引擎与后端:87.4 秒与 241.6 秒 |
六种组合,同一道 Rust 功能
任务是 LlamaStash 路线图上一件真事:把 llama-server 的 KV 缓存在卸载前存下来,模型回来时再恢复。六种组合,每种跑两遍,一共 12 个 PR 1。
Flash-Next 跑在他自己的 Strix Halo 笔记本(Flow Z13)上,走 Halogen,约 Q4、4.16bpw。Opus 5.5 走 API。每个 PR 由 Opus 5.5、Flash-Next 与 Kimi K3 一起打分,七道评审题加一条 CI,折成 8 分制 1。
| 组合 | 得分(满分 8) | 耗时 | API 成本 |
|---|---|---|---|
| Claude Code + Opus 5.5,xhigh 1 | 6.94(87%) | 43.5 分钟 | 17.78 美元 |
| Claude Code + Opus 5.5,medium 1 | 6.25(78%) | 23.4 分钟 | 6.52 美元 |
| Claude Code + Flash-Next,medium 1 | 5.50(69%) | 45.3 分钟 | 0.32 美元 |
| Pi + Flash-Next,xhigh 1 | 5.44(68%) | 63.8 分钟 | 0.67 美元 |
| Claude Code + Flash-Next,xhigh 1 | 5.38(67%) | 49.5 分钟 | 0.39 美元 |
| Pi + Flash-Next,medium 1 | 5.06(63%) | 48.1 分钟 | 0.56 美元 |
12 个 PR 全部跑完,全部通过端到端测试。Opus 平均 82%,Flash-Next 在 Claude Code 下 68%、在 Pi 下 66%。差距落在边界情况、测试和文档,核心功能都能用 1。
真正分岔的是 CI 那一栏。同样是 Flash-Next,Claude Code 交的 4 份 PR 里 4 份过了 CI,Pi 交的 4 份里只有 1 份过 1。
评审分只差 0.44(5.50 对 5.06),CI 差了三份。评论区把这一条单独拎出来,说同一个模型下 4/4 对 1/4 说明壳子比多数人以为的更要紧 1。
成本那一栏同样能算。最贵的 17.78 美元与最便宜的 0.32 美元相差约 55 倍,而后者拿到了 69% 的分 1。
作者自己把限制写在最后:Flash-Next 是 4.16bpw 的笔记本权重,Opus 是 FP16 或至少 FP8,两边档位不同;每个组合只跑两次;跑 Flash-Next 的机器全程压在 70W,把上限提到 90W 会更快,他没这么做 1。
Loading content card…
Ornith 的榜上,同一个 Qwen 是 43.9
它官方那张表,是我这两天见到写得最细的一张。每一项下面都注明用什么跑、跑几次 4。
| 基准 | 用什么跑 | Ornith-1.5-122B | Qwen3.8-Flash-Next |
|---|---|---|---|
| Terminal-Bench 2.1 4 | Claude Code 2.1.126,5 次平均 | 81.2 | 83.4 |
| SWE-bench Verified(non-hack)4 | OpenHands,256K 上下文 | 84.5 | 82.8 |
| SWE-bench Pro(no-hack)4 | OpenHands,反作弊全程生效 | 76.9 | 43.9 |
| SWE-bench 多语言 4 | OpenHands | 76.4 | 73.0 |
| NL2Repo 4 | 400K 上下文,封掉 GitHub 与 pip | 51.2 | 45.2 |
| Toolathlon-Verified 4 | 官方评测服务,128K 上限 | 70.8 | 71.4 |
| HLE(带工具)4 | Claude 4.6 Opus 当裁判 | 48.0 | 38.0 |
| MCP-Atlas 4 | 500 题公开子集,Claude 4.8 Opus 判 | 74.6 | 74.1 |
| 爬取类 BrowseComp 4 | 未在脚注单列 | 78.5 | 75.3 |
| ClawEval 4 | 真实用户分布,temp 0.6 | 79.4 | 76.5 |
同一张表里换了四种跑法。Terminal-Bench 用 Claude Code,三项 SWE 用 OpenHands,NL2Repo 把外网和包源关掉,HLE 与 MCP-Atlas 的裁判分别是 Claude 4.6 与 4.8 的 Opus 4。
最扎眼的是 SWE-bench Pro 那一行:76.9 对 43.9。模型卡写明这一项的反作弊规则——本地仓库的 git 历史被删掉,网络被关掉,模型被明确告知哪些是刷分行为,任何仍然这样做的解法直接判错 4。
这一行量的是「被告知规则之后仍然守规矩」的那部分能力。别的榜上同名基准给出更高分时,差别很可能就落在这条规则上;横向读之前,先看每一行的 harness 那一栏 4。
它也有输的地方。模型卡上的十四项里它赢了十二项,Terminal-Bench 2.1 落后 2.2 分,Toolathlon-Verified 落后 0.6 4。
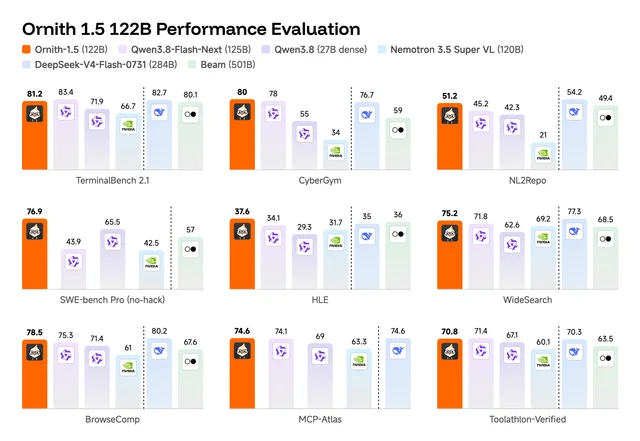
体积方面,社区给的量化档是 IQ1_M 约 40GB、Q4_K_XL 约 80GB;一位博主提醒先等外部复测,因为 76.9 对 43.9 这个领先幅度是 Ornith 自己的数 12。
官方博客另有一句自陈。所有 Ornith-1.5 的成绩都是五次独立运行的平均;SWE 三项用 OpenHands、温度 1.0、top_p 0.95 13。
一个 763B,十台机器
这条帖子的价值在它的口径声明。作者把 48 小时内 X 上的读数收进一张表,开头就写:所有数字都是自报,配置各不相同,只能当成同一批读数看 2。
| 机器 | 引擎或量化 | 解码 tok/s | 发布者 |
|---|---|---|---|
| 4× RTX PRO 6000 2 | 未注明 | 410 | @0xSero |
| 8× RTX PRO 6000 Max-Q 2 | vLLM 加 DSpark,TP8 | 约 320 | @hshimodaira |
| 4× RTX PRO 6000 2 | vLLM,rtx6kpro 配方 | 约 200 | @siegl_rene |
| 2× DGX Spark 2 | Blackfold | 113 | @Blackwellboy |
| M3 Ultra 2 | 未注明 | 79 | @dataphwj |
| 2× DGX Spark 2 | MiaAI-Lab 配方加 knapcio TP4 分支 | 70–100 | @unsignedbytes |
| M3 Ultra 512GB 2 | oMLX 加 MTP | 68 | @jundotkim |
| 2× DGX Spark 2 | EXL3 2.9bpw | 68–71 | @easthambuilds |
| 2× M3 Ultra 2 | ds4 MXFP4 | 48.5 | @ivanfioravanti |
| 2× DGX Spark 2 | vLLM,EXL3 2.7bpw | 40–50 | @sfxnz |
两组值得并排看。同样是 4 张 RTX PRO 6000,一条报 410,一条报约 200,相差一倍,两条都没写全引擎与量化档 2。
同样是 2 台 DGX Spark,五条从 40 到 113,跨度 2.8 倍;写清配方的三条分别落在 40–50、68–71、70–100 2。
排在最前那条 8× Max-Q 拿的是聚合数,TP8 下每张卡的负载与单机两卡是两类东西 2。
40–50 那一档的配方自报了质量代价:EXL3 2.7bpw,对未量化模型的 KL 是 0.025,1M 上下文,视觉走 vLLM,配了 run.sh 14。
十份读数都可以是真的。它们说明的只有一件事:只报 tok/s、不报机器与量化,读者拿到的只是一个厂牌名。
12 个模型、22 道题,8GB 换 16GB
条件是一台 Windows 机器:i7-14700K、32GB 内存、llama.cpp b11370,路由器模式一次只装一个模型。第一轮用 RTX 3060 Ti 8GB,第三轮换成 4070 Ti SUPER 16GB 5。
22 道题分四类:11 道编码(隐藏单测判分)、3 个小型仓库的 agent 修复、4 道指令遵循(自动检查)、4 道设计(匿名后由云端模型盲评 0–10)5。
换卡换到的倍数分两种:
| 模型 | 3060 Ti 8GB(生成/读取) | 4070 Ti SUPER 16GB(生成/读取) | 倍数 |
|---|---|---|---|
| gpt-oss-20b 5 | 54.5 / 897 | 163–170 / 5,600–7,000 | 生成 ×3,读取 ×7 |
| Ornith-1.5-35B-A3B Q4 5 | 55 / 393 | 86–91 / 约 1,030 | ×1.6 / ×2.6 |
| Qwen3.6-35B-A3B 5 | 54 / 405 | 88–91 / 约 1,065 | ×1.6 / ×2.6 |
| Qwen3.8-27B 稠密 5 | 3.8 / 21(不可用) | 23 / 约 1,300 | ×6 |
规律他写得很清楚。整模型能装进显存的那一档拿到大倍数,gpt-oss-20b 是 ×3 生成、×7 读取。专家还得留在内存里的 MoE 只有 ×1.6,因为它卡在内存带宽上 5。
一个 30K token 的 agent 上下文,8GB 那台读 35 到 75 秒,16GB 上 gpt-oss 读约 5 秒 5。
更值得看的是他后来两次推翻自己。第一次结论是投机解码在 16GB 上没用:Qwen3.8 的 MTP 让 23 tok/s 掉到 13–18 5。
更正来了:慢的原因是模型没装下。IQ4_XS 那份 14.3GB,有 6 层 FFN 落在系统内存;换成装得下的 IQ3_S,同条件从 40 提到约 63,草稿接受率 54% 5。
同一个 IQ3_S 加 MTP,把上下文从 56K 拉到 64K,读数从 63 掉到 15。多出来的那点 KV 让 Windows 溢进共享内存,速度就塌了 5。
第二次更正更基础。他发现自己从来没设过 reasoning_effort,而 Qwen3.8 的默认值是 xhigh——之前所有 27B 的结果都跑在最高思考档 5。
改成 medium 加温度 0.7,编码 98.9%、5.8 分钟、生成 25.7k token;xhigh 那档是 90.9%、20.4 分钟、73.5k token。他把上一条「比 MoE 慢」的话收了回去 5。
他自己给这件事总结了一句:光看 tok/s 说明不了什么,答完一题要多少 token 一样要紧。Ornith 每 token 更快,但它想得比对手多 2.3 倍,整体反而更慢 5。
Loading content card…
10GB 的 3080 上,领先的是那个 35B
这是一张 10GB 卡上一周的 agent 榜,题目是一套叫 PA Core 的个人助理题,满分 100 6。
| 模型 | PA Core | 预填 tok/s | 首字 |
|---|---|---|---|
| MiniCPM-V 4.7 35B-A3B 6 | 85.7 | 550.7 | 6.7 秒 |
| Ternary Bonsai 2 27B 6 | 81.7 | 1,096.7 | 未给 |
| Ornith 1.5 35B-A3B 6 | 71.2 | 480.4 | 未给 |
| Nemotron 3.5 Bolt 74B-A9B,IQ1_S 6 | 70.0 | 194.7 | 19.5 秒 |
前三名都是 35B 上下的 MoE,或者三元权重。74B 那个能在这张卡上跑,靠的是 IQ1_S,分数 70.0,首字要等 19.5 秒 6。
他自己对 1 比特那档的评价只有一句:Bolt 能在 1 比特下跑,但 IQ1_S 太狠 6。
三元权重的那个拿到了全场最高的预填 1,096.7 tok/s,比 74B 快 5.6 倍,分数高 11.7 6。
他的结论很直接:10GB 卡上做 agent,找 35B 的 MoE,或者换三元权重 6。
限制也在同一屏里:一套题的分数,一周之内会有浮动;三个模型的预填与首字没给,表里只有分数可比 6。
EAGLE-4:发布帖一个数,仓库表另一个数
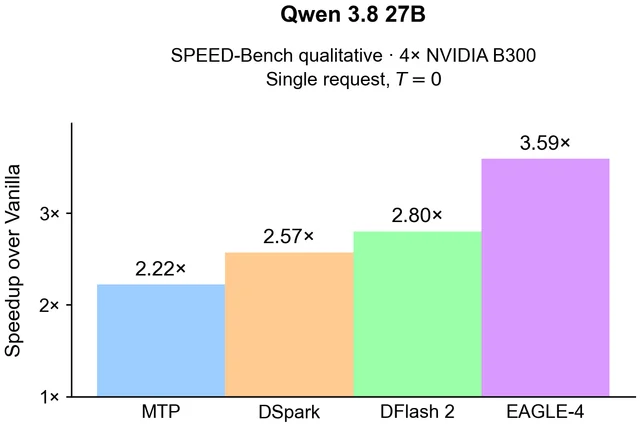
Eagle 在今天清晨放出 EAGLE-4。发布帖写的头条是:Qwen3.8-27B 在 TokenSpeed 上 961.6 tok/s,BF16、4 张 B300、TP4、单请求、温度 0 7。
仓库自己的表是另一组数,每一行都带条件:SPEED-Bench 客户端、温度 0、两次起服务的平均 15。
| 引擎 | 卡 | 并发 | 不开投机 | EAGLE-4 | 倍数 |
|---|---|---|---|---|---|
| SGLang 15 | 4× B300,TP4 | 8 | 1,479.4 | 2,820.6 | 1.91× |
| SGLang 15 | 4× B300,TP4 | 64 | 3,925.3 | 5,281.3 | 1.35× |
| SGLang 15 | 1× MI355X | 8 | 552.7 | 1,145.9 | 2.07× |
| SGLang 15 | 1× MI355X | 32 | 1,269.2 | 1,980.8 | 1.56× |
| vLLM 15 | 4× B300,TP4 | 1 | 241.6 | 722.8 | 2.99× |
| vLLM 15 | 4× B300,TP4 | 8 | 1,699.9 | 2,883.9 | 1.70× |
同一页里还有一句:「No TokenSpeed throughput is claimed」——仓库不为 TokenSpeed 的吞吐背书。那句话正好落在发布帖的头条下面 15。
并发越高,倍数越小。vLLM 单请求 2.99×,同引擎 8 路 1.70×;SGLang 8 路 1.91×,64 路 1.35× 15。
仓库还设了一道正确性闸门:出现解释不了的贪心解码不一致,即使投机服务更快也算失败 15。
许可证这一栏也换了。仓库里的许可证正文第一行写着「NOT AN OSI-APPROVED OPEN-SOURCE LICENSE」,并定义了「竞品」的边界。主营业务实质替代 EAGLE-4 的产品或服务,需要单独商用许可 16。
同一份许可证里还写明,只有版权方明确标注为 Apache-2.0 的文件才适用 Apache-2.0。前几代是这个许可,这一代换成了源码可见 16。
Loading content card…
Mac mini 上,官方说的 6 倍落成 1.11 倍
一张关于 PyTorch 2.15 的截图最近在传:Qwen 推理快 6 倍,Wan 视频解码内存从 270GB 降到 8GB,FP8 又把模型体积砍半。这些数大多出自 Hugging Face 的官方测试 17。
一位作者在一台 M4 Mac mini 上装了两个隔离的 Python 3.11 环境,机器是 24GB 统一内存、macOS 26.6.2。2.14.1 与 2.15.0 各顺序跑两轮 8。
| 测试项 | 2.14.1 | 2.15.0 | 倍数 |
|---|---|---|---|
BF16 F.linear,4096×4096 8 | 454.784 µs | 409.806 µs | 1.11× |
FP32 softmax [1,128256] 8 | 58.622 µs | 11.823 µs | 4.96× |
constant padding [1,16,128,128] 8 | 15.174 µs | 13.142 µs | 1.15× |
torch.mps.Stream 接口 8 | 不可用 | 可用 | 新能力 |
FP8 tensor 与 scaled_mm 8 | 报错 | 成功 | 新能力 |
6 倍的那条落在 MoE 上。官方在 M3 Ultra 上测两个 MoE:Qwen3.6-35B-A3B 从 9.4 提到 61.3 tok/s,LFM2.5-8B-A1B 从 23.6 提到 123.6 17。
换成普通稠密层就温和得多。官方另测了 96 组 BF16 单行 linear,几何平均 1.23 倍,许多大层接近 1 倍 17。
270GB 到 8GB 那一栏,指的是 MPS driver memory 的峰值,与整机内存是两回事。allocator 保留的内存在两版里都是约 8.07GiB 8。
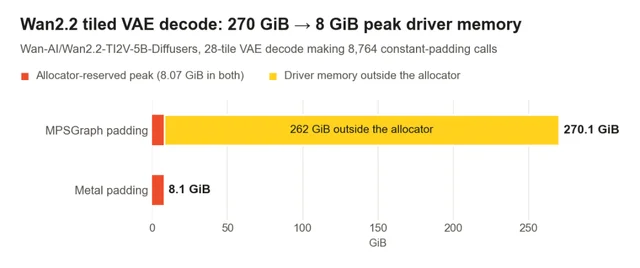
两条限制要提前说。2.15 到 10 月 20 日还是候选版,正式版计划 10 月 28 日发布,稳定版仍是 2.14.1 8。
FP8 不会把你硬盘上那份 BF16 权重自动减半。35B 的模型按每个权重 1 字节算,下限就约 35GB,再加 scale、KV 与系统占用,24GB 的 Mac mini 装不下 8。
同一个 SD 1.5,四套引擎
机器没有独立显卡:锐龙 7 5700G、27.9GB 内存、Windows 11。模型固定为 Stable Diffusion 1.5,4.27GB 的 safetensors 3。
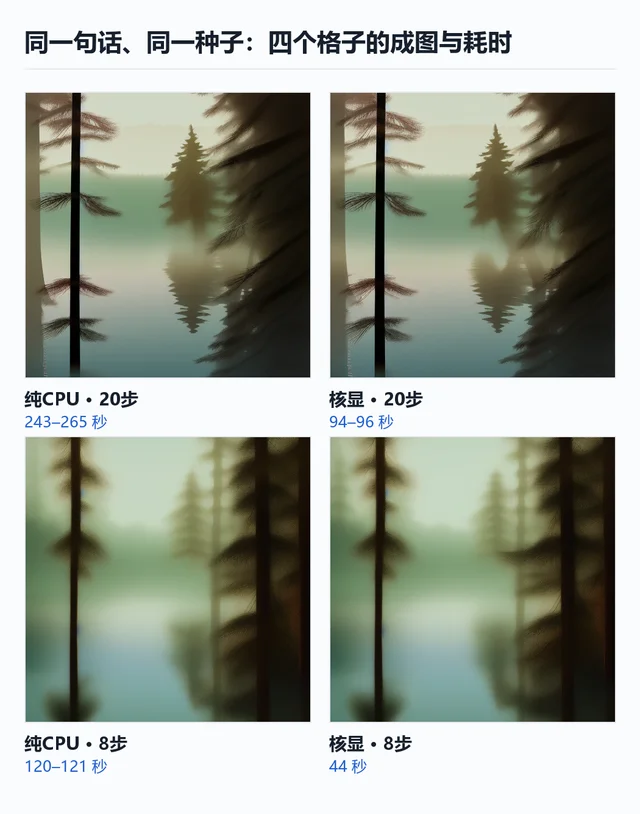
他先量一条可控的对照:同一个引擎、同一句提示、同一个种子,纯 CPU 与核显各跑 20 步与 8 步,每格两次 3。
| 方案 | 512×512、20 步 | 768 | 1024 | 峰值内存 |
|---|---|---|---|---|
| sd.cpp 纯 CPU 3 | 中位 250.9 秒 | 770–771 秒 | 1,951–1,973 秒 | 4.64GB |
| sd.cpp 核显(Vulkan)3 | 中位 94.4 秒 | 507 秒 | 两次都失败 | 1.5GB |
| diffusers 纯 CPU 3 | 119.4 秒 | 295.4 秒 | 649.7 秒 | 5.63GB |
| ComfyUI 纯 CPU 3 | 190.84 秒 | 542.6 秒 | 1,573.6 秒 | 未给 |
| ONNX + DirectML 3 | 115.49 秒 | 跑不通 | 跑不通 | 未给 |
512 那一列里,sd.cpp 的两个数出自速度批,另外三套出自换引擎批,各自内部取中位。作者把这条写进了方法一节:不同批之间不横比 3。
同一批里的三个方案好横着看:sd.cpp 核显 87.4 秒、sd.cpp 纯 CPU 241.6 秒、diffusers 纯 CPU 119.4 秒。换引擎能省一半时间,核显能再多省一半 3。
同一个种子换个引擎,出来的是另一张图。sd.cpp 两后端的成图 HSV 饱和度均值 0.424,diffusers 是 0.261 3。
尺寸一放大就撞墙。核显画 1024 两次都崩在同一处。采样跑完 1,392.34 秒,解码那步报
vk::Queue::submit: ErrorOutOfDeviceMemory 3。ONNX 那条在 512 上最快,768 就报内存不足(
8007000E),1024 在采样第一步失败 3。五个题材里唯一翻车的是图表:柱子画对了,图上的字全是假字。作者把五句提示词原样列了出来,方便照抄复现 3。
限制他列得很实:没清后台任务(Windows 更新与杀毒都留着),所以用 n=3 与离散度去量化;主测不限核;1024 档纯 CPU 要 33 分钟,等于不可用 3。
顺带几条
Kapitsa 0.2 与 Splash 1.4.0 同一天落地,作者把两台真实的 Mac 并排测。M4 Pro 48GB 上跑 27B:Kapitsa 63 tok/s、Splash 53、mlx-serve 54、oMLX 45、llama.cpp 18;35B-A3B 上 161 对 135。作者自己就是 Kapitsa 的作者,帖子里写「我也不信基准,你自己跑一遍」 18。
1.66bpw 的 EXL3 量化能把 Flash-Next 整个塞进一张 5090,专家一个都不留在外面,解码 200 到 300 tok/s。留下来的问题是上下文:32GB 的卡哪怕量化了缓存,余地也不多 19。
DeepSeek 的 DeepInfer 公开了几个生产读数。单集群每天 155 万亿 token,验证过的草稿 token 从 5.00 降到 3.2,256 并发下每张卡 25k 输出 tok/s,只支持 SM100 与昇腾 950 2021。
决策模型这边,pplx-decider-v1.2 在 Decisions API 上做出与 GPT 6 Luna 相同的判断,成本是十分之一;比 Jev 便宜 2.5 倍,两个模型都是 Apache 2.0 2223。
小红书那边,一位作者让 Opus 5.5、Gemini 4、GPT-6 Astra、Grok 4.7 和 DeepSeek 新版各用 Python 驱动 Blender,做一段 3D 鹈鹕骑单车。名次依次排下来,DeepSeek 新版第五:第一轮它把车架留在了原地,第二轮才补上。同一个任务他自己开 max 档,跑了 1 小时 29 分 24。
看完先查四件事
- 先看壳子。 同一个 Flash-Next,Claude Code 交的 4 份 PR 全过 CI,Pi 交的 4 份只过 1 份;评审分几乎一样 1。
- 再看判分规则。 76.9 与 43.9 之间,隔着 OpenHands、删掉的 git 历史与关掉的网络 4。
- 然后看机器。 同是 4 张 RTX PRO 6000 报 410 与约 200;同是 2 台 DGX Spark,五条从 40 到 113 2。
- 最后看答完要多久。 Ornith 每 token 更快,想得多 2.3 倍,一题整体反而更慢;改一档思考档,27B 从 20.4 分钟降到 5.8 分钟 5。
一个当场能做的动作:把常用那条命令固定下来——同一份提示、同一档上下文、同一个量化档,连跑三次取中位。然后只改一处,壳子、量化档或思考档,再跑同一组。两次之间只差一个数,第二次的读数才搬得走。
References
- 1
- 2
- 3公众号 AI积木师:同一个 Stable Diffusion 1.5,四套引擎文生图实测
mp.weixin.qq.com
- 4Hugging Face:Ornith-1.5-122B 模型卡\
huggingface.co
- 5Reddit r/LocalLLM:8GB 换 16GB 的完整数字\
reddit.com
- 6
- 7
- 8公众号 JasonKou:Mac 本地 AI 真快了 6 倍?\
mp.weixin.qq.com
- 9
- 10deepu.tech:Flash-Next 对 Opus 5.5 的完整记录
deepu.tech
- 11
- 12
- 13Ornith 博客:Ornith-1.5 的方法与脚注
ornith.ai
- 14
- 15GitHub:eagle-hq/EAGLE-4 的实测结果表
github.com
- 16GitHub:Eagle 4 Source-Available License
github.com
- 17Hugging Face:MPS in PyTorch 2.15
huggingface.co
- 18
- 19
- 20
- 21GitHub:deepseek-ai/DeepInfer
github.com
- 22Reddit r/LocalLLaMA:决策成本的十分之一
reddit.com
- 23Artificial Analysis:决策指数
artificialanalysis.ai
- 24小红书 菲戈传输:五个模型各用 Blender 做一只鹈鹕
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.