实验室自报平均高 6.4%、14 次同题 6 次没跑完、一道 1998 年的游戏题六个模型都没答全
七组来自 Reddit、小红书与公众号的实测,都在问同一个数是谁按什么口径记的:611 组配对里实验室自报平均高 6.4%、14 次同题里 6 次没跑完、同一台 Mac 上换引擎从 15 到 63 tok/s。

今天傍晚,一个叫 whatmodel.sh 的开源榜把 611 组「同一个模型、同一项测试」的配对摆到一起:实验室自己报的分数,平均比独立测试方高 6.4% 1。
今天早上发出来的一组实测里,10 月 16 日夜里起,四个国产免费 Flash 模型在同一道需求上跑了 14 次:13 次最终通过,其中 8 次是一口气跑完的 2。
今天下午,一台 M4 Pro 上,同一个 27B 在八个引擎里从 15 tok/s 跑到 63 3。
三件事问的是同一个问题:这个数是按谁的口径记的。
| 材料 | 谁在算这笔账 | 两个读数 |
|---|---|---|
| 611 组配对 1 | 实验室自报对独立测试 | 平均高 6.4%,中位差 1.2 个百分点 |
| 4 个国产模型 14 次 2 | 一次通过对三轮内通过 | 8/14 对 13/14 |
| 八个引擎同一台 Mac 3 | 引擎作者自己的表 | 同一个 27B:15 到 63 tok/s |
| Nemotron 3.5 Bolt 4 | 参数量对 KV 占用 | 74B,256K 上下文 1GB |
| 六模型答游戏规则题 5 | 自己出的题 | 第一名也错三处 |
| DGX Spark 一周 6 | 本地账单对 API 账单 | 月省 180 美元 |
| 四个 agent 拆路由器 7 | 托管模型对开源权重 | 四种分工,托管模型中途被拦 |
611 组配对里,实验室的数字平均高 6.4%
这个榜把「厂商公布的分数」与「别人独立测出的分数」按模型与测试一一配对:1,629 条公开成绩,最终配出 611 组,覆盖 180 个模型、103 项测试 8。
算法写得很清楚:每一对算 (实验室 − 独立) ÷ 独立 × 100,再等权平均,低的和平的也算进去 8。
平均差 6.4%,中位差只有 1.2 个百分点,均值的 95% 区间 3.8% 到 9.5%,按整个模型重抽样 8。
两边分数不一样的 591 组里,63% 是实验室更高:实验室高 375 次,独立方高 216 次,20 组完全打平 8。
把测试拆开看,差距的去向就清楚了。
| 测试 | 配对数 | 中位差(百分点) | 实验室更高的比例 |
|---|---|---|---|
| SWE-bench Verified 8 | 13 | +9.0 | 92% |
| MBPP 8 | 13 | +9.0 | 77% |
| ARC Easy 8 | 14 | +4.7 | 79% |
| AIME 2024 8 | 14 | +3.8 | 86% |
| GPQA Diamond 8 | 51 | +1.1 | 67% |
| MMLU 8 | 20 | 0.0 | 50% |
| HumanEval 8 | 34 | 0.0 | 47% |
| ARC Challenge 8 | 14 | −0.6 | 50% |
| τ²-bench Telecom 8 | 18 | −1.3 | 39% |
模式是「设定的比重越大,差距越大」。格式固定的老测试几乎不动;SWE-bench Verified 这类 harness 参与结果的测试,13 组里 12 组是实验室更高 8。
对手是谁也影响差距。对榜单、Epoch AI、不发布模型的论文这类中立测试方,236 组里实验室更高占 56%;对竞品实验室自己的发布文档,446 组里占 63% 8。
竞品对中立测试方的 272 组里,竞品更低 131 次、更高 130 次,中位差 0.0——同行互测的中位差是零 8。
作者自己在页面上写了三条限制:设置常常不同(推理档、harness、few-shot、子集版本),实验室会挑测试发布,这 611 组因此不是一个随机样本 8。
数据以 CC BY-SA 4.0 开放,代码 MIT,每一对的两个来源都挂在模型页上 9。
Loading content card…
同一道需求 14 次:跑完的全对,6 次没跑完
题目是一个叫 mdtoc 的小仓库加「目录生成」功能:slugify、忽略围栏代码块、重复锚点加后缀、标记之间幂等替换、再加一个 CLI 2。
需求文档 42 行,判分是 24 条模型看不到的验收测试,作者拿自己的参考实现先跑到 24/24;事后又按原文补了 8 条更刁的边界题 2。
壳统一是 OpenCode 1.19.3,每次运行用独立的临时 HOME 与 XDG 目录,工作目录与验收测试分在两棵互不包含的目录树里。
| 模型 | 运行 | 一次通过 | 最终通过 | 单次耗时 | 付费折算 | 典型情况 |
|---|---|---|---|---|---|---|
| DeepSeek V4.1 Flash 2 | 3 | 3 | 3 | 104–347 秒 | $0.026–0.030 | 无 |
| GLM-5.3-Flash 2 | 5 | 1 | 4 | 582–1564 秒 | $0.046–0.078 | 429 限流 3 次、推理写满 1 次 |
| LongCat 2.5 Preview 2 | 3 | 2 | 3 | 702–1101 秒 | 无公开价 | 路径笔误 1 次 |
| MiMo-V2.6-Flash 2 | 3 | 2 | 3 | 674–1388 秒 | 无公开价 | 编造目录 1 次、漏写测试 1 次 |
| Nemotron 3.5 Lightning 2 | 3 | 0 | 0 | 9 轮全部 20 分钟超时 | 无公开价 | 3 小时只写出一个文件 |
13 次跑完的运行全部 24/24,补的 8 条边界题也全过。作者自己的判断是,题目难度上限太低,测不出模型之间的编码能力差距 2。
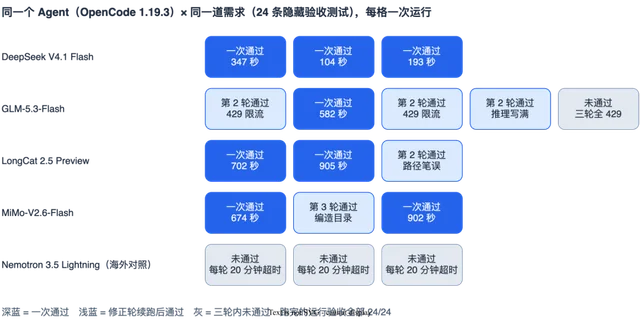
6 次半路倒下分三类。第一类是通道限流 3 次,全是 GLM 的
429 Upstream request failed: Endpoint is unavailable.。第二类是推理预算写满 1 次,32,000 个推理 token、输出 0 个。第三类是路径错误 2 次:一次多打了一个「2.」,一次编了一个本机不存在的 /Users/dev/workspace-726f2afd/ 2。每一次出现「自动拒绝」,本轮就结束,仓库里要么没有新代码,要么只写了一半。代码本身每一次都写对了 2。
账单那栏也值得看。GLM 的输入单价是 DeepSeek 的一半、输出不到一半,单次账单却是 2.5 倍。GLM 每次 14 到 36 步,输出加推理 2.6 万到 6.4 万 token;DeepSeek 是 9 到 16 步、1.2 万到 1.5 万 2。
控制变量还踩出一个坑。同一句「Reply with exactly: PONG」,用本机真实 HOME 跑是 21,213 个输入 token,换空的临时 HOME 只剩 7,842 个。差出来的 13,371 个,是壳顺手加载的本机配置 2。
作者自陈的局限写得很直。每个模型 3 到 5 次,样本小;免费通道是共享资源,耗时里混着排队,同模型三次能差三倍。壳只用了 OpenCode 一个,24 条验收测试也测不出更高的能力上限 2。
同一台 M4 Pro,八个引擎跑同一个 27B
Kapitsa 是一个只跑 Qwen 与 Nemotron 两族的 Apple Silicon 引擎,Apache 2.0,需要 M1 或更新、macOS 14 以上 10。
作者在帖子里贴了三台 Mac 的对照表,单位 tok/s:
| 机器与模型 | Kapitsa | mlx-serve | oMLX | MTPLX | Ollama | MLX | llama.cpp | LM Studio |
|---|---|---|---|---|---|---|---|---|
| M4 Pro 48GB/Qwen3.8 27B 3 | 63 | 54 | 45 | 36 | 32 | 28 | 18 | 15 |
| M4 Pro 48GB/Qwen3.6 35B-A3B 3 | 154 | 124 | 127 | 80 | 89 | 86 | 69 | 86 |
| M4 Pro 48GB/Qwen3.5 4B 3 | 179 | 137 | 102 | 104 | 109 | 88 | 70 | 81 |
| M5 Max 128GB/Qwen3.6 35B-A3B 3 | 272 | — | 232 | 123 | 166 | 112 | — | 127 |
| M5 Max 128GB/Qwen3.8-Flash-Next 3 | 105 | 108 | 107 | 88 | 60 | 77 | 96 | — |
| M1 Pro 16GB/Qwen3.5 4B 3 | 85 | 62 | 55 | 42 | 55 | 46 | 38 | 47 |
同一个 27B,在同一台 M4 Pro 上从 15 到 63,四倍多的差距全部落在引擎这一层 3。
它输的那一格很具体:表里标 180B-A7B 的 Flash-Next 在 M5 Max 上是 105,mlx-serve 108、oMLX 107,作者自己把这一行标了出来,说领导层答应拿到 128GB 之后再优化 3。
快的原因作者列了五条:按架构与权重量身写的 Metal 内核、投机解码、给混合模型补上带递归状态的缓存、27B 与 Bolt 让一部分预填走神经引擎、并发的多个请求共用 GPU 趟数 3。
他自己的态度写在表头:「我们不喜欢 benchmark,不要相信它」。仓库里给了
kapitsa bench,跑完可以把自己的机器加进社区结果 3。限制也在帖子里:只支持两族模型,新代码、预计有 bug,4 bit 量化会掉一点质量,M1 Pro 16GB 那台只跑得动 4B 这一档 3。
Loading content card…
74B 的 Bolt,账记在 KV 上
Nemotron 3.5 Bolt 是 74B 总参、9B 激活,解码器按 2 bit 量化,敏感部分用 NVFP4,整份权重 22GB,另加 1.7GB 视觉投影 4。
它每 5 层线性注意力(Mamba2)配 1 层全注意力,注意力头宽也窄,于是 KV 便宜得不像这个参数量:
作者在 4 张 MI100、128GB 的机器上试,速度大约是 27B 的两倍;它本质上是剪过专家的 Nemotron 3.5 Super 再加后训练 4。
智能这一栏他自己写「按今天的标准一般」,大约跟 Qwen3.6 27B 持平;相对强的是非幻觉率,表现是会在很多轮里反复查证、诊断,再动手 4。
真正适合它的场景是「很多上下文、少量用户」:内存里塞得下几百万 token,一台 5090 32GB 或 128GB 的小主机就是它的理想位置 4。
这条帖子的数字都出自作者自己的机器与自己的量法,公开复现的人目前只有他一个。它给的是一份「按 KV 算账」的样板。
一道 1998 年的游戏规则题,六个模型都没答全
题是《Anno 1602》的升级条件:市民升商人要什么、定居者要教堂、商人与贵族要哪些地标。作者不许模型联网查 5。
六个模型的名次与错处:
- Nemotron 3.5 Super VL 120B-A12B:第一。给市民升商人编了盐,定居者漏了教堂,商人与贵族漏了必需地标。
- Gemma 4 31B IT QAT:第二。漏掉的升级条件太多。
- DeepSeek v4 Flash Vision Exp:第三。编了另一套升级条件。
- Qwen3.5-122B-A12B:第四。编了游戏版本与升级条件。
- Qwen3.8-Flash-Next:第五。同上。
- GPT-OSS 120B:第六。同上。
作者的评价是「从完全不准确到只有小错」,第一名的三处错他也逐条写了 5。
跑法是双 RTX 5060 Ti 16GB 加两条 48GB DDR5-6000,llama.cpp 0.7.0,按层切分走 Vulkan,关掉 MTP。生成 8 到 10 tok/s,读取 150 到 170 tok/s 5。
这是一道他自己出的题、六次运行,名次出自他本人逐条核对。它只能当成「谁离正确答案更近」的一个读数 5。
Loading content card…
一台 DGX Spark 一周:单路 70、双路 65、三路 50
作者用社区的 Blazux vLLM 方案在一台 DGX Spark 上跑 Qwen3.8-Flash-Next,最多三路并发、256K 上下文、内存占用 80% 6。
他报的三档读数是:单路平均 70 tok/s,双路每路 65,三路每路 50。按他每天的使用情况,平均每路 60 到 65 6。
他选 vLLM 的理由是并发。官方发布的单流 decode 不如 sglang,多路并发高得多;而他习惯同时开多个 worktree,让子代理读代码、写代码 6。
账单是这样算的:以前走 DeepSeek API,综合价 0.14 元每百万 token;现在这台机器每天跑 300M 以上 token,一天省约 6 美元、40 元,一个月 180 美元 6。
机器本身他是 3,400 美元买的,他称同款现在 6,000 美元以上。他在本地三路占满后把请求代理到 opencode go 或 GPT-6 Luna 的订阅 6。
限制是他自己说的。这是他一个人的使用形态,几乎全用作读写代码的子代理,产出以结构化代码为主。速度里有一部分归功于更强的散热和自己做的散热支架 6。
四个 agent 一下午拆开一台路由器
起因很具体:三台 TP-Link Deco XE75 Pro V3 跑 2026 年的 1.5.0 固件,AP 模式下按 SSID 打 IoT VLAN 的功能被拿掉了,作者不想把三台好路由器扔了 7。
四个 agent 用一个只追加的共享文本文件协调,那个文件记了 1,346 行、75 条以上 7。
分工写在提交记录里。claude 11 条,负责 Dropbear SSH 与
direct-tcpip 转发。codex 49 条,离线解密并验签固件、解开 SquashFS、恢复 555 条 tmpsvr 操作码表、反编译 Lua。gemini 5 条,追 OpenWrt 的 init 与 hotplug 脚本。跑在 Hermes 壳里的开源 Qwen 6 条,外加跨 lane 调度 7。结果是完整的。
0xC456 写入原语在三个路径上被验证,io.popen 拿到 root,libtrkutil 的 AES-256-CBC 密钥与 IV 被取出。14 份 NVRAM 配置离线解密,三台机器上的 VLAN 30 都通了 7。真正值得记的是中途那一段。一到现场验证、真机命令执行、改 PoC 脚本,托管模型就被平台拦下。Opus 4.8 与 5.5 在会话中途变得完全不可用 7。
作者自己的结论是两边都要:托管模型擅长深度静态反编译与长上下文脚本追踪,开源权重提供不中断的执行 7。
这是一台自己的路由器、一个下午、n=1;流程与成品都放在公开仓库里,可以自己顺着走一遍 11。
Loading content card…
顺带几条
公众号 犀牛的奔跑 在一台 RTX 4060 Laptop 8GB、32GB 内存的笔记本上试了三条路。llama.cpp 调 MoE 层,把 Qwen3.6-35B-A3B 放到 40–52 tok/s;NInfer 加 KVmem,把三值量化的 Qwen3.8-27B 跑到 35 tok/s;Strata 加载 68.15GB 权重加 6GB MTP 草稿与 0.91GB 视觉投影,跑 Flash-Next 最高 30 tok/s 12。
小红书 趋势算法狗 把一个开源项目更新到 10 月 17 日的新版权重。机器是 8 张 RTX 4090 48GB,卡间没有 NVLink;支持 256K 上下文、DSpark 推测解码与三路并发。部署脚本与避坑说明都在
ykk648/deepseek-v4.1-flash-8x4090 13。llama.cpp 在 v0.7.0 把 llama server 的默认端口从 8080 改成了 9931,写在 release 与 PR #30159 里 14。所有写死
localhost:8080 的脚本今天都会连不上 15。两张 CMP 170HX 只走 PCIe Gen2 x4,用 W4A16 权重、改过的 vLLM、流水线并行加原生 MTP,把 Flash-Next 跑到单请求 226 tok/s。八路并发时聚合 840 tok/s,每路 116、首字 231 毫秒,262K 窗口。HumanEval 157/164、GSM8K 1,271/1,319 16。这是他自己的 sparkDash 协议:贪心解码、关思考、固定 400 token 输出、三次取中位 17。
看完先查四件事
- 这个分数是谁报的。 厂商自报、独立测试方、竞品实验室,三者给出的中位差不一样。
- 记的是一次通过还是最终通过。 同一批运行,8/14 与 13/14 是两个问题。
- 同一台机器上换引擎差多少。 27B 从 15 到 63 tok/s,换的都是引擎。
- 显存账里 KV 占多少。 256K 上下文,Bolt 要 1GB,27B 要 8.5GB。
一个当场能做的动作:把手头一个无人值守的任务派两次,一次记「第一轮结束时交了没有」,一次记「三轮内能不能救回来」。夜里排任务时,用前一个数。
References
- 1Reddit r/LocalLLaMA:实验室自报比独立测试平均高 6.4%
reddit.com
- 2公众号 1024 工程笔记:4 个国产 AI 模型同题实测
mp.weixin.qq.com
- 3
- 4
- 5
- 6小红书 在波屯搞AI的TWX:DGX Spark 一周的账单\
xiaohongshu.com
- 7
- 8whatmodel.sh:实验室申报 vs 独立测试
whatmodel.sh
- 9GitHub jakemanger/whatmodel
github.com
- 10GitHub nace-ai/kapitsa
github.com
- 11
- 12公众号 犀牛的奔跑:8GB 显存笔记本三条路线
mp.weixin.qq.com
- 13小红书 趋势算法狗:8×4090 部署 V4.1-Flash-1017
xiaohongshu.com
- 14
- 15GitHub ggml-org/llama.cpp v0.7.0
github.com
- 16
- 17
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.