同一套权重换三种跑法从 89.5 掉到 83.6、一个开关让 2017 年的显卡跑到 93 tok/s、官方涨 11 分的模型在盲测里排第四
八组来自 Reddit、X、小红书与公众号的最新实测:同一批模型在不同尺子、部署路径、问法与壳子下报出不同的数,每组写明换掉的那一层、换回来的那一栏,以及作者自陈的限制。

10 月 17 日,小红书用户 AI 观模者在一块 RTX 5090 D 上,把同一套 Qwen3.8-Flash-Next 权重用三种方式各跑了一遍 803 道题:本地 Unsloth 量化版 89.50,官方 API 86.99,另一份更小的本地量化 83.62 1。
同一天,一块 2017 年的 Tesla V100 16GB 把 35B 的视觉模型跑到 93 tok/s。改动只有一处:把视觉编码器挪到 CPU,腾出的 0.9GB 让全部专家留在显卡上 2。
下午,DeepSeek 放出 V4.1-Flash-1017。官方表上 11 项基准全部高于上一版,最多涨 11.1 分,DeepSWE v1.1 到 77.0 3;当天独立盲测里,它在 105 道隐藏 bug 上修掉 34 个,排第四 4。
八组材料里,模型几乎没换,换的是它外面那一层:量它的尺、部署的路、问它的方式、引擎补丁、KV 落点、一个开关、一个壳子、一个免费渠道。
| 材料 | 换掉的那一层 | 换回来的那一栏 |
|---|---|---|
| DeepSeek-V4.1-Flash-1017 3 | 尺子:官方自测表 → 105 道盲测 bug | 官方 11 项全涨,独立盲测 34/105 排第 4 |
| Qwen3.8-Flash-Next 三种跑法 1 | 部署路径:官方 API / Unsloth IQ4 / Swift IQ3 | 89.50 / 86.99 / 83.62,零分项 20 / 43 / 54 |
| Jev-Omni 光伏质检 5 | 问法:整板判断题 → 局部三选一 | 5 处白点从 90–96% 正常 → 99% 白点 |
| Arc Pro B60 6 | 引擎补丁与一串旗标 | 解码 16 → 53 tok/s |
| RX 9070 XT 7 | 一个自己移植的 KV 流式分支 | 262K 下 9.5 → 31.1 tok/s |
| V100 16GB 2 | 一个开关:视觉编码器去 CPU | 35B 视觉模型 93 tok/s |
| Strix Halo 对 Opus 5.5 8 | 壳子:opencode v2 对 Claude Code | 同一迁移任务 60 分钟对 50 分钟 |
| 电信星辰 29B 9 | 免费渠道 | 六项全过,三个坑 |
官方涨 11.1 分,独立盲测里是第 4
官方那张表有 11 行,每一行都高于上一版 V4.1-Flash。涨幅最大的是 Terminal-Bench 4.0,31.2 到 42.3;DeepSWE v1.1 从 74.2 到 77.0,略高于 Opus 5 的 74.0;不带工具的 HLE 从 36.8 到 42.6,仍落后 Opus 5 的 56.3 3。
表下面有一行小字:Terminal-Bench 4.0 用的是 Claude Code 的 harness,DeepSWE 用的是 Mini-SWE-V2。成绩和量它的那套壳子绑在一起。
同一套模型换到另一把尺上,名次换了位置。Paweł Huryn 用两个真实仓库、105 个年初前沿模型漏掉的隐藏 bug 做盲测,只数修掉几个:Muse Wonder Full 1.0 拿 42,Opus 5.5 拿 41.7,Gemini 4 Argon 拿 40.7,V4.1-Flash-1017 拿 34,Grok 4.7 拿 29,Qwen3.8-Max 拿 25.7,上一版 V4.1 Flash 拿 21.7,GLM-5.3 拿 19 4。
他自己的判断是这一版比上一版涨了 12.3 个,进步很大,只是「奇怪的是没标成 V4.2」。他还写了一句浮动范围:重复三次后分数会变约 1.7 分;34 与 40.7 之间差 6.7 分,是这个范围的四倍左右。
Loading content card…
权重挂在 Hugging Face,MIT 许可,763B 参数,1M 上下文,模型卡上已经列出 4 份量化 3。
同一套权重,89.50 与 83.62 之间隔着部署
这场对照的题目是 ZXBench 的 803 道源题,展开成 920 个执行实例、11 个维度,全部在同一块 RTX 5090 D 上跑 1。
三个总分:Unsloth Qwen3.8-Flash-Next 的 UD-IQ4_XS 本地版 89.50,阿里官方 qwen3.8-flash API 86.99,Swift 的 IQ3_XXS 本地版 83.62。
差得最开的是零分项。Unsloth 版交了 20 个零分,官方 API 交了 43 个,Swift 交了 54 个。官方 API 的零分里有 12 次是超时,作者另外统计它 94.88% 的输出花在思考上。
最难的渐进题上,官方 API 又反超回来:69.20 对 Unsloth 的 68.46。
跑得最快的那个分数最低:Swift 版每秒 147 个 token,总分 83.62。
作者自己把三者身份写清楚了:官方 API 和 Unsloth 版用的是同一套权重,分数差来自部署侧——引擎、数值格式、失败后的恢复策略。他的结论是这三项不能拿来证明「量化让模型变强」。
选型那句话也很干脆:要综合质量用 Unsloth IQ4,要省心跑 agent 用官方 Flash 并把题限放宽,要快、显存紧用 Swift,代价是接更多错误。
同一块光伏板,整板看是正常,切到局部是白点
公众号 子非 AI 把一个 12B 的决策模型 Jev-Omni 装在一台 M3 Pro、18GB 统一内存的笔记本上,断网跑完一段 78.20 秒的无人机光伏巡检视频 5。
流程是三条:先把每块组件拉平成正视切片,再对每条轨迹最多取 3 个时间点,最后按概率把轨迹分进正常、异常候选、待复核。149 条轨迹因此触发了 343 次单板判定。
整板这一层的结果是:149 条里 70 条判为完全正常放行,79 条进了待复核。单次整板判定的中位耗时 42.46 秒,78 秒的视频跑了 4 小时 18 分。
漏检出现在小目标上。现场复核指出 5 处肉眼可见的白色小斑点,5 张整板图里有 4 张被模型给了 90% 到 96% 的「外观正常」,剩下 1 张的污染提示没到报警门槛。加大整板图的推理预算,这 5 张板仍然判正常。
作者的归因是尺度:一块光伏板近两米,毫米级白点在整张切片里占比不足 0.5%,模型在整板尺度上给「正常」符合它的逻辑。
改法没有动权重,只改了问法:裁出局部高清切片,把问题从「整板状态」收窄成三选一——有可见白点、正常表面、无法判断。同一套模型底座,5 处已知白点全部给出超过 99% 的白点选项概率。
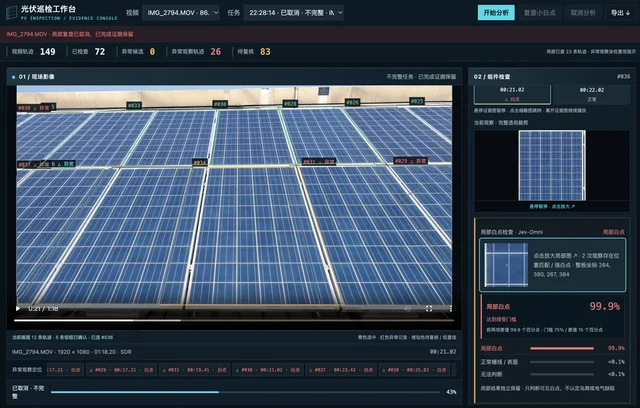
误报的代价也写了:拿同一套白点提示去扫正常的银色主栅线,反光会被误选成白点,得靠几何规则和置信度门槛二次拦截。
最后是物理边界。可见光航拍只能看表面污渍、鸟粪、植被遮挡、大面积碎裂,内部隐裂与发热热斑要靠红外或 EL 检测,这次实测没有覆盖。
一张 999 澳元的 Intel 卡,16 到 53 之间是三个改动
Reddit 用户 Sad-Seaworthiness259 在一块 Intel Arc Pro B60 24GB(澳元 999 元)上,把 Qwen3.8-27B 的 UD-Q4_K_M 从每秒 16 个 token 调到 53 6。
第一个改动是 DFlash2 草稿模型,每轮 7 个 token,7 道编码任务上解码均值 16 到 53,峰值 58,7 道全对。
第二个是 Intel 的 flash-attention 预填充内核,取自一个尚未合并的 llama.cpp PR,32K 提示的读取从 118 到 420 tok/s。这条只在 f16 KV 下有效,换 q4 KV 没有收益。
第三个是凑显存:
-ub 256 加草稿模型的 q8 KV、再关掉 -fit,释放 0.55GiB,正好把 64K 窗口塞进 24GB。还有一个与优化无关的发现:显卡上留着一个闲置的 Ollama 模型时,解码从 52.7 掉到 22.2。他建议测之前把别的模型都卸掉。
Loading content card…
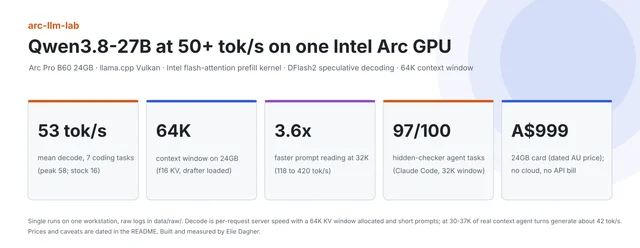
智能体那一栏也给了:100 道隐藏检查任务,Claude Code 在 32K 窗口下过 97 道,Codex 过 95 道。
限制他写在最前面:单次运行、一台工作站;预填充不是最快的,别的引擎在约 30K 上能到 589 到 657 tok/s,对照表在仓库里。
Loading content card…
16GB 的 A 卡开满 262K,代价是一个自己移植的分支
Reddit 用户 bottlestreet3d 在单张 16GB 的 RX 9070 XT 上,把 Qwen3.8-27B 的 IQ4_XS 开到完整的 262,144 token 上下文,并用 MTP 把解码拉到 31.1 tok/s 7。
这张卡装不下的部分要逐个解决。模型文件约 14.3GB,他先用 ASCII 精简词表压到 12.6GiB,留下约 3.4GiB 可用显存;262K 的 KV 张量本身还要约 7.4GiB,llama.cpp 在 65K 左右就 OOM。
他的办法是把 KV 整个放在主机内存,再把有限的工作集异步搬过 PCIe:预填充约 450MiB,解码约 2,100MiB。这不是现成功能——原作者只为 NVIDIA/CUDA 写过自适应 KV 流式,他把它移植到了 ROCm/HIP,又并入另一份 RDNA 优化分支的内核改动。
四档上下文的结果:解码 36.5 / 32.1 / 27.0 / 9.5 tok/s,对应 1K、65K、131K、262K;开 MTP 后 71.8–86.5 / 72.9 / 78.6 / 31.1;预填充 1,368.4 / 1,120.3 / 863.0 / 585.8。
他还测了功耗:把这张卡限到 231W(比默认 304W 低 24%),预填充只损失 3.6%,解码基本不变。
Loading content card…
2017 年的 16GB 卡,把 35B 视觉模型跑到 93 tok/s
Reddit 用户 Actual_Dragonfly5169 在一张 2017 年的 Tesla V100-SXM2 16GB 上,用纯 Windows 11、原生 llama.cpp 和 OpenBMB 官方的
mix_q3gud_im 量化,把 MiniCPM-V 4.7 35B-A3B 跑到 128K 上下文每秒 93 个 token,262K 下 70 2。关键在那个开关:
--no-mmproj-offload 让视觉编码器留在 CPU,省出约 0.9GB 显存,全部 MoE 专家因此能上显卡(--n-cpu-moe 0),再配 -c 131072、q4_0 的 K 与 V、开 flash attention。他用一段 12 万 token 的提示验证过:答对、不崩,显存占用 16.17 与 16.38GB,贴着 16GB 的天花板。
投机解码在这里反而更慢。草稿模型占用的显存会把专家挤回内存,所以 DSpark 那套 n-gram 方案被他关掉了。
他另建了一套 72 题、代码判分、不用模型当评委的题库,把 15 个模型放在这张卡上排了一次。第一名和最快的是两个模型:Qwen3.8-27B 的 IQ3_XS 拿 88.6 分、每秒 42;MiniCPM-V 4.7 的 Q3 拿 87.5 分、每秒 93。
Loading content card…
同一个迁移任务,本地 60 分钟对 Opus 5.5 的 50 分钟
Reddit 用户 cupant 在一台 128GB 内存的 Strix Halo 笔记本上,用 Unsloth 的 Qwen3.8-Flash-Next Q4_K_XL、Gufo 的 Windows 移植、以及 macOS 上的 opencode v2(effort 设为 high)做壳子,接了一个真实任务 8。
任务是把一个生产应用里的若干个界面从 Flutter 迁移到 SwiftUI,应用带大量业务逻辑和网络请求,线上有几千日活。
对照是 Opus 5.5 走 Claude Code 的 xhigh 档。Opus 用 50 分钟做完,本地这套用 60 分钟,作者的评价是「结果几乎一样」,打磨程度差一点,再补两三句提示、五到十分钟能追平。
这条的边界很清楚:n=1,两边壳子不同(opencode v2 对 Claude Code),effort 档也不同,作者没有给第二次运行。他自己想验证的是「本地这套能不能接住真实工程活」,答案是一次性任务的完成时间接近。
免费额度上六项全过,三个坑都不在模型里
公众号 大壮的 AI 武器库 用硅基流动的免费额度,实测了中国电信的 Xing4.0-29B-A4B:29B 总参、4B 激活、Apache 2.0,硅基流动与 OpenRouter 上都免费,OpenRouter 那档给 262K 上下文 9。
六项测试全部通过:回文函数 7 个用例全过(含「上海自来水来自海上」)、严格三行格式一字不差、80 字写作题 67 字且三个禁用词没出现、20,918 字材料里捞中藏在第 442 段的代号与日期、
get_weather 的工具调用参数正确、水池注排题答对。三个坑都在渠道这一层。第一,思考默认开着且关不掉:传
enable_thinking=false 平台没透传,在 system 里写「不要输出思考过程」反而让思考更长、首字涨到 9.4 秒;写作题里它写了 1,664 字思考才给出 67 字正文,等了 16.4 秒。第二,
max_tokens 给到 800 时,思考阶段把额度吃光,正文返回空白且不报错。作者的建议是开到 2000 以上。第三,硅基流动这条链路的流式响应不返回
usage,token 数全是 0,文中的字数只能按字符估。还有两处口径对不上,他放在了「买卡前先核对」里:官方说 4 bit 约 15GB 显存,仓库报的完整 checkpoint 是 31B 张量;官方自测表里 AA.LCR 61 分输给 Gemma4 的 66,而且表里对手的成绩是电信自己重跑的。
顺带几条
一台 400 美元的老机器能跑什么,有人给了具体数:Dell T420、双 Xeon E5-2470、192GB DDR3-1600、一张 2015 年的 Tesla M40 24GB 限到 180W。Swift 1.5 Qwen3.8 Flash Next 的 IQ3_S 跑到 19–20 tok/s,GLM 5.3 Flash 的 IQ3_XXS 只有 3–4(作者判断是 CPU 瓶颈,显卡占用没超过 40%),Qwen3.8 27B 的 UD-Q4_K_S 即使 100% 放显卡也只有 2–3 10。
Kimi K3 发布三个月后有人重算了一遍账:完整权重 1.56TB,Unsloth 推荐的最小量化 594GB、要约 610GB 内存加显存,512GB 装不下;1 bit 版与完整版下一个 token 的一致率 79%,2 bit 版到 90% 但体积 861GB。它在 Artificial Analysis 上从 57 掉到 44,作者指出大部分是榜单改版,GLM-5.3 已经 45 分。许可证那条也写清了:做模型即服务、12 个月收入超过 2000 万美元,就要单独和月之暗面谈 11。
扩散语言模型这条线出了一个大数:ORL 与自建引擎 dlmrt 在单张 RTX 5090 上跑到 2,788 tok/s(LLaDA-2.1-mini 加 NVFP4),8 张 B200 上 7,708;单张 H100 上 QwenDLM-4B 是 1,298,对投机解码 DFlash 的 746 与 EAGLE3 的 405。作者自己注明这些是单请求、特定基准上的峰值 12。
Jetson AGX Thor 128GB 上跑 MiMo-2.6-Pro 的读数更极端:约 566GB 的 FP8 权重从磁盘边读边算,0.646 tok/s。作者把每一层、每个路由专家、每次 SSD 读都记下来做成可回放轨迹,标题写得很直白——它确实加载并跑起来了 13。
新引擎 MoE4All 1.0.3 在 RX 7900 XTX 上给了两档:Qwen3.6 35B-A3B 预填充峰值 3,604.71 tok/s,2K 上下文单路 130.26、双路合计 168.09、三路 206.63,150K 双路 50.87;Qwen3.8 FlashNext 4.27bpw 预填充 1,445.5,30K 单路 49.15、双路 65.17,150K 双路 49.50 14。
Strata 上还有一个便宜的旋钮:把
--adapt-every 从校准值的 1 调到 6,RTX 4070 Ti Super 上四段提示的解码涨幅 19%、12%、23%、55%,另一档 IQ4_XS 是 9%、24%、24%、16% 15。同一版块另有人问了个更根本的问题:Strata 会剪专家,这些速度是不是拿质量换的,回复里还没有人贴出同题对照 16。看完可以先查四件事
- 这个速度是在多长上下文下取的。同一张 16GB 卡,1K 时 36.5 tok/s,262K 时 9.5,开 MTP 是 31.1。
- KV 放在哪。放在显存、主机内存、还是 SSD,决定了你能不能开满上下文,也决定预填充掉多少。
- 你用的壳子读多少提示词、跑哪个 effort 档。同一个任务 60 分钟对 50 分钟,差在这两样上。
- 免费渠道有没有把思考关掉,
max_tokens给够没有,返回里有没有 usage。
一个当场能做的动作:拿你手上最长的一份材料,先用一句话问整体,再把同一处裁出来问三选一,比较两次的答案与置信度。光伏那组的 5 处漏检,就是在这一步翻出来的。
References
- 1小红书:同一套权重三种跑法
xiaohongshu.com
- 2
- 3Hugging Face:DeepSeek-V4.1-Flash-1017 模型卡
huggingface.co
- 4
- 5公众号 子非AI:决策模型做工业质检\
mp.weixin.qq.com
- 6
- 7
- 8
- 9公众号 大壮的AI武器库:实测免费模型电信星辰29B\
mp.weixin.qq.com
- 10
- 11Reddit r/LocalLLaMA:Kimi K3 发布三个月后的账
reddit.com
- 12
- 13
- 14小红书:MoE4All 1.0.3 在 7900 XTX 上的两档读数
xiaohongshu.com
- 15
- 16Reddit r/LocalLLaMA:快是快,质量那一栏谁测过
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.