816B 的开源权重要两台 512GB 的桌面机、2 比特量化在 28 道工单上追平 API、同一台 6GB 笔记本换个壳子从 12/12 掉到 7/12
八组来自 Reddit、X、小红书与公众号的最新实测,每组都贴着一台具体机器的边界跑——816B 的开源权重、68GB 的模型、6GB 的显存、35 瓦的小主机;第二栏写的是先撑不住的是哪一样,原帖与作者自陈的限制都留在正文里。

10 月 15 日到 16 日这批实测里,最贵的一道门槛出现在开源模型上。
Meta 当天放出 Muse Spark Open:816B 总参数、42B 激活、100 万 token 上下文。官方给的落地方式,是两台 M5 Ultra Mac Studio 加 MLX 一起跑 1。
同一天,一台只有 24GB 内存的笔记本把 68GB 的 Qwen3.8-Flash-Next 跑到每秒 12.5 个 token,原生 llama.cpp 在同一条件下是 5.2;作者写明,默认模式下两边出的 token 逐字节相同 2。
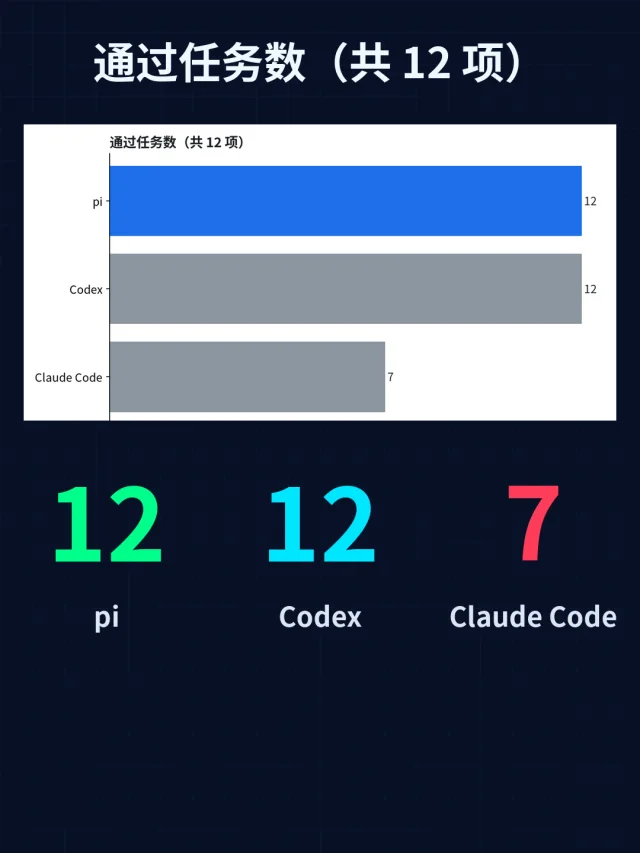
还有一组,差别落在模型外面那一层:一块 6GB 显存的笔记本上,同一个本地模型分别交给三个编程智能体跑 12 项检查,两个壳子做完 12 项,第三个只做完 7 项 3。
八组材料各自贴着一条线在跑,第二栏写的是先撑不住的是哪一样。
| 材料 | 跑到了哪一步 | 先撑不住的是哪一样 |
|---|---|---|
| Muse Spark Open 816B 4 | 权重开源,单机跑不动 | 显存:BF16 要 2TB,NVFP4 也要 700GB 起步 |
| moe-cache 2 | 68GB 模型在 24GB 内存上 5.2 → 12.5 tok/s | 模型装得进内存时,它比原生 llama.cpp 慢 |
| 一周 28 道 DevOps 工单 5 | 本地 2 比特量化 49/56,追平完整版 API 的 49/56 | 换成官方推荐采样,掉到 37/56 |
| 6GB 笔记本上的三个编程智能体 3 | pi 12/12、Codex 12/12、Claude Code 7/12 | 壳子自己的提示词:1,400 对 15,800 个 token |
| £299.99、35W 的骁龙小主机 6 | 35B coder 出字 24.5、带 MTP 约 30 tok/s | 32GB 内存:80B 要靠专家流式从 NVMe 读 |
| capy-flash 7 | 两块 16GB 卡跑 125B NVFP4,预填 3,435 tok/s | 张量并行的 BF16 部分和,把误差放大到单卡约 5 倍 |
| 两张消费卡上的常驻专家 8 | 长文预填 4K 约 750、32K 约 1,750 tok/s | 同一份文档问三遍,11.2 → 4.1 → 2.6 秒 |
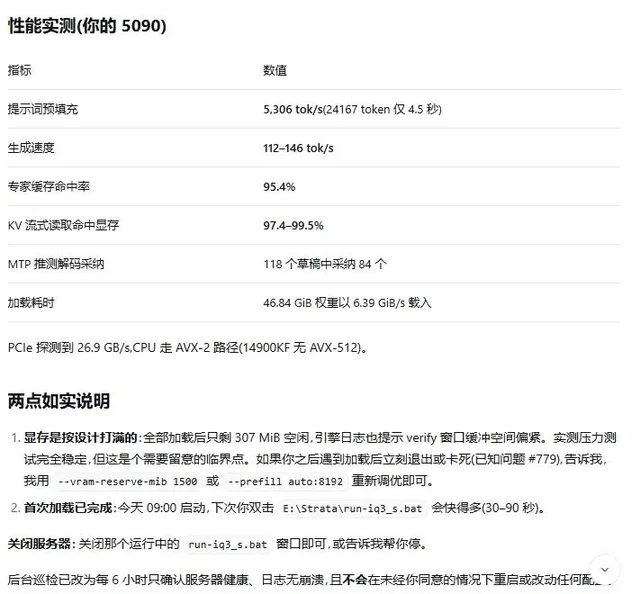
| 5090 上的本地标书系统 9 | 生成 112–146 tok/s,专家缓存命中 95.4% | 长链任务把上下文撑爆,得重启服务再压缩 |
816B 的开源权重,落地是两台 512GB 的桌面工作站
Muse Spark Open 在 10 月 15 日(美国时间)发布,权重挂在 Hugging Face。模型是原生多模态,文本、图像、视频、音频都能进上下文,输出只有文字 1。
公众号 模型茶馆 在发布当天去 Hugging Face 走了一遍上手流程,把三道关都记下来了 4。
第一关是下载。权重页挂着 gated 标记,要提交申请、等通过、登录之后才能下;许可证一栏写的是 other,展开叫 Muse Model License,官方说明是「带有限商业条款,允许多数开发者免费使用」,仓库里另有一份 USE_POLICY.md。
第二关是硬件。他数了权重索引:65 个分片、实际总量 822B。BF16 全量要 2TB 显存,NVFP4 量化版也要 700GB 起步;激活 42B 省的是算力,权重仍要整个住进显存。
官方的桌面方案是两台 M5 Ultra Mac Studio,每台 512GB 统一内存,拼出 1TB 走 MLX。作者算了一笔账:在售的 256GB 版本标价 10,799 美元,512GB 配置 10 月底才开卖、价格未公布,按四台 256GB 折算同容量约 43,196 美元。
第三关是能力。Meta 模型卡自评 Artificial Analysis 智能指数 39 分,独立已发布的 MiMo-V2.6-Pro 是 46 分。它自家表格里领先的是 JobBench 与 MCP-Atlas 工具调用,落后的是终端编码、长程软件工程和 GDPVal-AA 专业工作。
另一条路是 API。OpenRouter 挂牌输入每百万 token 1.25 美元、输出 4.25 美元,首发托管还有 Baseten、Fireworks AI、Groq、Modal、Nebius、Together AI。
限制写得很直白:作者没有跑推理,816B 需要的显存他的环境够不到,所以这一篇实测的是上手门槛,生成质量留给独立评测;发布 24 小时内这个模型在 Hugging Face 上是 402 次下载、259 个星标。
Loading content card…
模型比内存大时,速度悬崖可以绕过去
Reddit 用户 Zephyr__100 发了一个叫 moe-cache 的插件,挂在未修改的 llama-server 上,不用 fork、不用打补丁 2。
它解决的问题是:MoE 模型一旦比内存大,llama.cpp 会把全部专家权重映射进内存,页缓存开始抖动,解码速度直接掉下悬崖。moe-cache 改成自己管 CPU 这一侧的专家,热的留在内存,其余从 SSD 用大块并行直读拉进来。
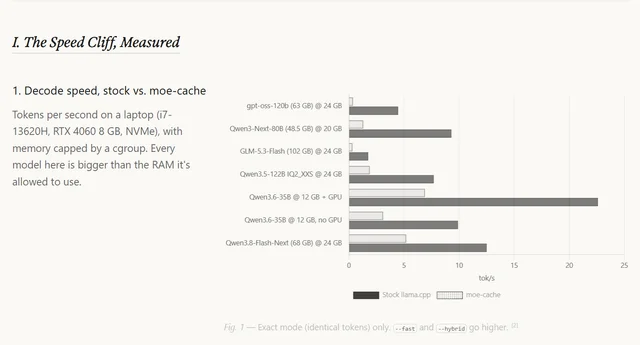
测试机是一台 i7-13620H、RTX 4060 8GB 的笔记本,内存用 cgroup 限住,六个模型都大于允许使用的内存。
| 模型与内存上限 | 原生 llama.cpp | moe-cache |
|---|---|---|
| GLM-5.3-Flash(102GB),24GB | 0.32 tok/s | 1.75 tok/s |
| Qwen3.5-122B IQ2_XXS,24GB | 1.89 | 7.7 |
| Qwen3.8-Flash-Next IQ2_XS(68GB),24GB | 5.2 | 12.5 |
| Qwen3.6-35B,12GB 加 GPU | 6.9 | 22.6 |
| Qwen3.6-35B,12GB,不开 GPU | 3.1 | 9.9 |
| gpt-oss-120b(63GB),24GB(v0.1) | 0.37 | 4.47 |
旁边那个能证伪速度的数字是输出本身。插件走 llama.cpp 自己的内核,默认模式下两边出的 token 逐字节相同,CI 每次提交都对着原生版本校验一次 token 一致性,插件本身跑在 ASan、UBSan、TSan 下。
作者把「不该用它」的情形也写在了同一节:模型装得进内存时,原生 llama.cpp 更快,Qwen3.6-35B 在 24GB 上限下是 42.9 对 36.6 tok/s,启动脚本检测到这种情况会自动切回原生。
他还提醒读者别只信他的数:每次限内存跑原生版本之前,他会把模型文件从页缓存里丢掉,否则原生版本读的是不计入上限的缓存,看起来能快上 4.6 倍。同一套对照被拆成独立仓库,读者可以拿自己的模型和提示词在自己机器上跑,它同时检查两边产出是否一致。
限制:作者写明代码是在 Claude 大量协助下写的,提交记录里有共同署名;目前是 alpha(v0.2.3.5),在 Linux 加 NVIDIA、Intel 核显和纯 CPU 上测过,Windows 只过 CI,AMD 未测。
Loading content card…
2 比特量化跑一周 28 道真实工单
Reddit 用户 BadSuzi 是一家托管公司的系统运维工程师,他把自己的工作写成了 28 道一次性任务,每道跑两遍,一共 56 个答案,全部由代码判分,没有用模型当评委 5。
题目就是他每天干的活:Terraform 的 S3 模块与
moved 块、Cloudflare 的 DNS 与 WAF 表达式、最小权限 IAM 策略、jq 与 CloudTrail 日志、几道隐藏测试的 Python 题、systemd 与 nginx 限流,还有一批波兰语的邮件分诊与发票抽取。机器是 RTX 5070 Ti 16GB 加 Ryzen 9 9950X3D 与 64GB 内存,模型是 Qwen3.8-Flash-Next 的 GSQ-RCO IQ2_XS,跑在 Strata 0.1.38 到 0.1.43 上。
同一批题摆在一起跑,本地这档 2 比特量化的成绩是 49/56,中位延迟 12 秒;走 OpenRouter 的完整版 Qwen3.8 Flash 是 49/56、22 秒、一次全跑 0.09 美元。GPT-6.1-sol 拿 55/56,DeepSeek V4.1 Flash 拿 51/56,本地另一档 Qwen3.8 27B IQ3_S 只有 42/56、中位 46 秒。
真正有信息量的是后面这一段。他按社区建议把采样从贪婪换成 Qwen 官方推荐的温度 1.0、top_p 0.95、top_k 20,分数从 50 掉到 37/56,16 道题丢掉、3 道题捡回(符号检验 p 约 0.004);丢分多是单 token 打滑,比如 JSON 用波兰语引号开头、英文引号结尾。
把推理档位从 medium 提到 high 同样更差:42 对 50/56,耗时翻倍。原因是这个量化档在思考里打转,有一次 903 段推理里重复了 847 段;重复文本可预测,MTP 命中率反而冲到 170–185 tok/s,所以 16k 预算的整轮跑得比想象中快。「high 在这档权重上是负收益,8k 预算当保险丝用」是他的原话。
校准那一栏最值得暂停一下。跑一次
./setup.sh --calibrate 之后解码中位从 118 涨到 143–147 tok/s,整轮从 20.6 分钟缩到 15.4–16.0 分钟,速度换来 25%。但分数两次都掉到 44/56。他把失败拆成硬失败(代码跑不起来)与软失败(判分口径更严)两类,发现掉的全是软失败,而且两次校准跑出的错误一模一样——校准改了哪些专家上 GPU、以及 CPU 求和顺序,贪婪解码在接近平局处翻面,翻完就在两次运行里稳定复现。
限制他列了四条:每档只跑两遍、任务是一次性而非智能体、数据是合成的、部分提示词是波兰语;即使贪婪解码,同一次运行里的两次重复也只有 28 道中的约 24 道一致,所以 ±3/56 是噪声,要看是哪几道翻了。
他还补了一个与自己测试环境的取舍:内存故意跑在 4800 MT/s、没开 EXPO,因为前两颗 9950X3D 在这块 ASRock 板子上坏了送修,代价是 CPU 算专家的部分带宽更紧,他估计数字比同配置开 EXPO 低几个百分点到两成。
Loading content card…
6GB 显存上,同一个模型换三个编程智能体
小红书用户 KUN 技术志 在一台 RTX 3060 笔记本、6GB 显存加 64GB 内存上,用 llama.cpp 开 32K 上下文、全程断网,把 LFM2.5-24B 交给三个编程智能体,另用 Qwen3.6-35B 做对照 3。
三道题:修一个 bug、写一个计时器网页、画一只骑自行车的鹈鹕。每个智能体数 12 项检查。
pi 12/12,修 bug 用了 47 秒,最快;Codex 也是 12/12,但工具参数传错了 12 次;Claude Code 只做完 7/12。
差在哪一步,作者指向了每个智能体开口前先读自己的提示词:pi 约 1,400 个 token,Codex 约 6,400,Claude Code 约 15,800。32K 的上下文里,Claude Code 一上来就吃掉一半,光读提示词要 48.8 秒,pi 只要 5.7 秒。
最坑的一幕出在换成 Qwen 之后:Claude Code 说网页做完了,目录里什么都没有。
他的两条建议也很具体:本地小模型上优先选提示词短的智能体;跑完自己
ls 看一眼。限制:这是一个人在一台机器上、两个模型、三道题的记录,没有重复次数;判分是他自己数的 12 项。
£299.99、35W、没有独显的小主机
Reddit 用户 WorldlyAd7946 买了一台 £299.99 的 Lenovo IdeaCentre Mini(Snapdragon X1-26-100、32GB 内存),想验证便宜 ARM 机器到底能不能跑本地模型 6。
这台机器里的 Adreno X1-45 核显目前跑不了有用的 LLM,NPU 也闲置,所以全部推理落在 CPU 上,整机功耗约 35 瓦。测试设置是 llama.cpp、512 token 提示、8 线程。
Qwen3.6 35B-A3B coder 的 Q4_0 版本:读提示约 118 tok/s,出字 24.5,挂上 MTP 之后 29–33。Gemma 26B 读 134、出字 29.5。
内存是这台机器的墙。他找来 Janas 这个引擎——把常用的 MoE 专家留在内存、其余从 NVMe 流式读——但它只支持 x86,于是自己把内核移植到了 ARM:为每一档量化写了 NEON 内核与 i8mm,并对着标量参考实现逐档测过逐比特一致(Windows ARM64 与 Linux 两边都测)。
移植版跑同一批设置:coder 读约 60、出字 17.2,带 MTP 29–31;Gemma 26B 读 115、出字 23.5,带 MTP 32–34;Qwen3-Next 80B-A3B 纯出字 9.8,带 MTP 17–18。
原生 llama.cpp 在读取和不开草稿的出字上仍然更快,但挂上 MTP 之后移植版追平或反超,而且占用的内存少得多。他把 coder 的专家缓存压到 12GB,出字仍有 24 tok/s;这台机器还能跑一个 llama.cpp 根本加载不起来的 80B 模型。
旁证一条:他又把手上两台同样的机器用 USB4 连起来,已经跑起来一个 122B 的 Qwen,作者说细节还在整理。
限制:作者自陈没有多少本地 LLM 经验、也是第一次碰 ARM;80B 那一档的读取速度他没敢用(「我不信任自己的结果」),只有出字数;两台机器串联的效果仍在进行中。
两块 16GB 消费卡上的 125B
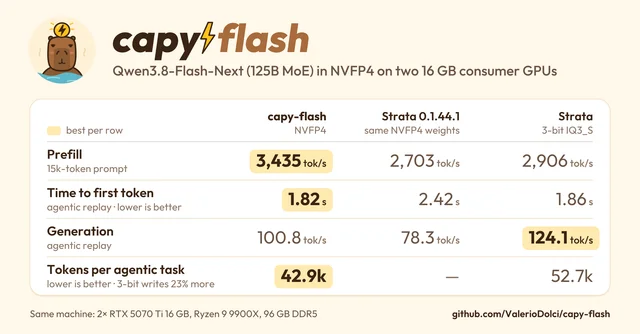
Reddit 用户 FeydRowan 发布了自己的引擎 capy-flash:Qwen3.8-Flash-Next 的 125B MoE,专家卸载到内存,直接使用 NVIDIA 官方的 NVFP4 权重,两张卡走张量并行,切换它和 Qwen3.8-27B 只差一个参数 7。
机器是两张 RTX 5070 Ti 16GB、Ryzen 9 9900X 与 96GB DDR5。同一份 NVFP4 权重下,capy-flash 预填 3,435 tok/s,Strata 0.1.44.1 是 2,703;首 token 1.82 秒对 2.42 秒;生成 100.8 对 78.3 tok/s。
生成这一栏的赢家另有其人:Strata 的 3 比特 IQ3_S 版本跑到 124.1 tok/s,比两边都快。质量检查用的是对数据中心 NVFP4 参考的 GSM8K、MMLU-Pro 与智能体编码任务。
作者在这场对照里顺手挖出一个给所有张量并行引擎的结论。走 TP 时,每张卡会先把自己的部分和舍入到 BF16 再进 all-reduce,所以 TP=2 会舍入两次,单卡只舍入一次;当两半正好抵消时误差被放大,Qwen3 在 TP=2 上出现大误差的频率约为单卡的 5 倍。把部分和改写成 FP16(字节数一样、精度细 8 倍)之后,误差回到单卡水平,速度基本没损失。
他自己给这条结论定了性:对基准的影响很小,算「免费换来的数值对齐」,主要作用是让智能体循环少一些罕见的怪行为。
限制:目前只支持 Linux 与 RTX 50 系(sm_120);作者说这个项目是被 Strata 启发后开始写的,写到一半 Strata 变快并支持了 NVFP4,他还是把项目做完了;欢迎别的硬件上的人报数。
Loading content card…
两张消费卡、专家常驻内存:预填从 150 到 1750
X 用户 @murasametech 用 RTX 5070 12GB 加 RTX 5060 Ti 16GB 两张卡,在 Strata v0.1.43 上跑 Qwen3.8-Flash-Next 的 IQ2_XS,模式是「resident」——把专家常驻在内存里 10。
长文预填的结果是:4K token 约 750 tok/s,1.4 万 token 约 1,500,3.2 万 token 约 1,750。
旁边那个数字来自他自己上一轮的记录:同一个模式跑 IQ3_S 时,每读一份长文要从 SSD 重读约 88GB,预填掉到约 150 tok/s。这一轮每次从 SSD 读的只有几十到一百多 MB,那个现象没有再出现。他同时注明,IQ3_S 那次版本与量化档都不同,本轮每组也只测了一次,两边条件并没有对齐。
同一台机器上他另做了一次提示词缓存的实验 8。对着同一份约 1.4 万 token 的文档连着问三遍,响应时间分别是 11.2 秒、4.1 秒、2.6 秒。
从第二遍起,前文那 1.4 万 token 被直接复用,真正新读的只有一百个左右 token。三遍的答案都对,包括最后一遍问章节编号的那道。过程中内存里的专家占 24.3GiB,Windows 侧空闲内存始终在 22GiB 以上,swap 为 0。
限制:两次实验每组各测一次;他说当时的显存页锁定(page-lock)没能生效,数字是在这个状态下取的。
Loading content card…
5090 上 130 tok/s 的本地标书系统,卡在上下文
公众号 吃货摄影师的脑洞世界 的这篇实测换了个场景:用本地模型搭一套标书撰写系统,因为公司禁止把真实标书上传到在线模型 9。
机器是 i9-14900KF、96GB 内存、RTX 5090 32GB 与 8TB SSD。作者让一个智能体在本机部署 Strata 并拉起服务,大约 20 分钟就绪;模型权重 70GB 出头,通宵下载。
速度那一栏很干净:生成速度稳定在 112 到 146 tok/s,MTP 推测解码正常运行,预填充也快。
活干起来之后,卡点换了地方。他先用本地 OCR(RapidOCR)把 297 份资质证明材料扫成数据库并打上索引标签,原本估计 5 小时,实际跑了 23 小时还没完——里面有些超大扫描件反复出错重试,改完 OCR 规则才收尾。
然后是用本地模型把公司的标书撰写规则理成一份 Skill。分析完两份标书、准备拿第三份和人工版本比对时,上下文爆了:服务不响应,反复发消息都没用,只能重启 Strata 跟 Hermes,等 Hermes 自己把上下文压缩完再继续。后来生成脚本、走一步 git 时又崩了一次。
结果这一栏也是真的:Skill 生成的标书六大部分全命中,价格评审、资格性、符合性、技术方案章、商务(业绩加人员)、其他内容一章不漏、一章不多,结构与人工作品一致;作者据此更新了 6 条撰写规则(内容涉密,做了打码)。
他自己的总结是:小显存、128K 到 256K 上下文跑长链任务会捉襟见肘,出路是上 256GB 内存的 Mac Studio 或者两台 DGX Spark——「归根到底还是钱的问题」。
限制:一份内部系统、一次搭建过程,没有对照基线;最终标书仍有部分材料要人工插入和校准;上下文爆掉后具体是哪一步撑破的,文中没有逐轮记录。
顺带几条
同一个任务上,模型之间的时间差可以很大。一位 M4 Max 64GB 的用户让 Qwen3.8 27B 和 Gemma 26B 各做一个小 SNES 赛车 demo,Qwen 卡在画图形上跑了 7 小时没做完,Gemma 10 分钟就写完并测过了
main.c;他的 Qwen 只开了 32K 上下文 11。评论区两种解释各占一路:一种说 27B 稠密模型在 Mac 上本来就慢,另一种(17 赞)反问是不是只有 Qwen 被限在 32K、别人不限。四台 DGX Spark 跑 DeepSeek-V4.1-Flash 的公开读数,另一位用户复现不出来 12。他用 SGLang TP4 加自己的调优构建,单请求散文 62.5 tok/s(公开读数约 58)、代码 79.1(公开约 96)、预填 4,500 到 5,250 tok/s,16 路并发峰值散文 228、代码 293;公开那条写的 494 tok/s 峰值对应 32 路并发与 1M 上下文,他都没能复现。他还指出那篇报道里的「内存占用 476 GB」其实是磁盘上的 GiB 数,权重本身就是 511GB。
长上下文衰减也有了一组同轴对照:Strata 上 Qwen3.8 Flash Next Coder 过了 175K 只掉 11%(68.9 到 61.4 tok/s),同一张图里的其他档掉 26% 到 34% 13。
NVIDIA 官方放出的 Qwen3.8 Flash-Next FP4 权重,有人给出了一组读数:262K 上下文、FP8 KV、MTP K=3,单流 66 tok/s,四路合计 166 14。
小红书上有人把 GLM-5.3-Flash 跑到每秒 69 个 token,题目是让它先用 Python 写八种冒泡排序、再换 Rust 写一遍,全程本地不调用在线 AI 15。
另一条串起来的线索是 KV 缓存落点。一家做存储的账号给出双机 16 张 RTX 6000D 跑 DeepSeek-V4-Flash 的对照:全部放 DRAM 的方案内存 400GiB,另一套只用 50GiB DRAM 加 46.09TB 的 NVMe-oF,容量差 107 倍而读路径吞吐打平(0.97–1.03 倍);差别出在第 20 轮,命中率 0.0085 对 0.9516,首 token 从 246 秒降到 16.9 秒 16。该账号自陈是存储厂商,这组数来自它自己的产品路线。
看完可以先查四件事
- 你的模型文件有多大,它和你的内存、显存各差多少;这个差值决定了走的是「装得下」还是「流式读」。
- 跑速度之前先确认上下文开多长。同一台机器从 4K 到 32K,预填速度可以从 750 涨到 1,750 tok/s,也可能掉到 150。
- 低量化档上先别急着上采样参数;换一套官方推荐值,可能就是十几道题的差距。
- 如果用的是编程智能体,先看它读自己的提示词要花多少 token 与多少秒——在 32K 的窗口里,这一项能把 12 项做完压成 7 项。
一个当场能做的动作:把同一份一万多 token 的文档连着问两遍,看第二遍的读入时间;如果它没有明显变短,说明这份上下文没有被复用,长任务的价格会一直落在预填充上。
References
- 1
- 2Reddit r/LocalLLM:moe-cache
reddit.com
- 3小红书:6GB 显存实测,同模型换智能体差 5 项
xiaohongshu.com
- 4公众号 模型茶馆:Meta 把开源模型塞进 Mac?我实测了一遍上手门槛\
mp.weixin.qq.com
- 5Reddit r/LocalLLM:IQ2_XS 在 Strata 上的一周\
reddit.com
- 6Reddit r/LocalLLaMA:一台 300 英镑的小主机能干什么\
reddit.com
- 7Reddit r/LocalLLaMA:capy-flash\
reddit.com
- 8
- 9公众号 吃货摄影师的脑洞世界:Strata 架构实测\
mp.weixin.qq.com
- 10
- 11Reddit r/LocalLLM:7 小时对 10 分钟
reddit.com
- 12Reddit r/LocalLLaMA:4 台 DGX Spark 上的复现
reddit.com
- 13
- 14
- 15小红书:本地跑 GLM-5.3-Flash
xiaohongshu.com
- 16小红书:KV Cache 被驱逐之后
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.