321B 剪到一半专家仍是 48/48、125B 塞进 8GB 显存却分析不停、128GB 统一内存跑 70B 只有 3 tok/s
八组来自 Reddit、X、小红书与公众号的最新实测,每组并排给出「装得下/跑得起来」与「活干完了没有」两个读数,并附上原帖与作者自陈的限制。

10 月 13 日到 14 日这批材料里,每个速度读数旁边都站着第二个读数。
一份 321B 的混合专家模型被剪到一半专家,71GB 那一档在 26 道真实工单上仍是 48/48,代价是等的时间多出 1.8 倍。同一个 125B 被塞进 8GB 显存,速度和一台 35B 打平,模型却在后台分析到烧掉两个 10 万 token 的上下文。一台 128GB 统一内存的机器装得下 70B,实测每秒 3 个 token。
八组材料的第一栏都在说「装下了」,第二栏在说「活干完了没有」。
| 材料 | 跑起来的那一栏 | 干成没干成的那一栏 |
|---|---|---|
| GLM-5.3-Flash 剪到 144 个专家 1 | Q3 71.4GB,26 道题 48/48 | 轮数是满血版 1.8 倍;2bit 版 39/48 且卡死 |
| jitllm 在回复中途搬层 2 | 2×T4 暂停 8.1 毫秒 | 0 个 token 重算,输出与没搬过一致 |
| 两张 7900 XTX 跑 125B 3 | 官方中位 78.0、面板峰值 103.8 tok/s | 四个「有效参数」里三个是噪声或失败 |
| 125B 塞进 8GB 显存 4 | 20 tok/s、100k 上下文 | 模型一直分析不停,烧掉两个 100k 上下文 |
| M5 Pro 64GB 跑 27B 加视频模型 5 | 文本 12 tok/s | 视频任务撞 47.3GB 硬阈值,进程被掐断 |
| 极摩客 EVO-X5 Pro(锐龙 AI Max+ PRO 495)6 | 官方 320B 20 tok/s、125B 42 tok/s | 作者实测 DeepSeek-V4-Flash 只有 14 tok/s |
| M5 Ultra 对双 DGX Spark 78 | 两台解码都是 38 tok/s | 单台 Spark 跑 70B 只有 3 tok/s |
| 六张二手 1070 与 3/4/6 张 R9700 910 | 1070 约 30 tok/s;6 张 R9700 解码 80–120 | R9700 上到 3 张时溢到硬盘,解码掉到个位数 |
剪掉一半专家,26 道工单一个没掉
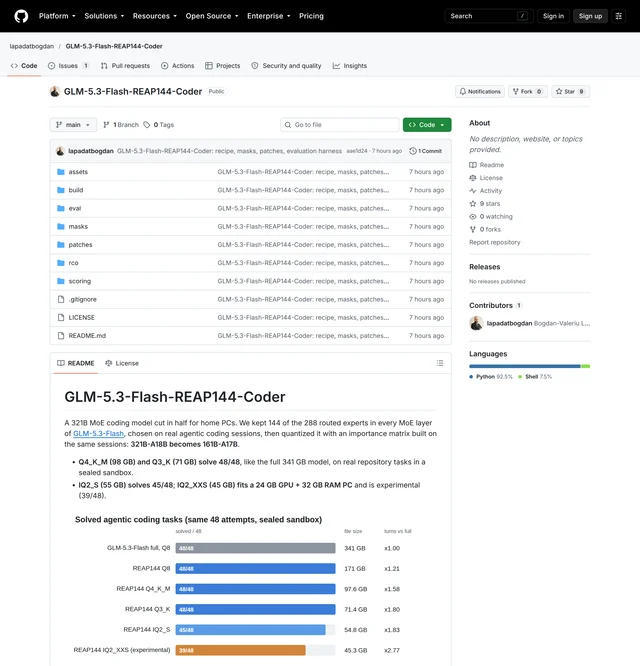
一份 321B 的 MoE 模型被剪到一半大小:每层的 288 个路由专家只留 144 个,选谁留下由真实 agentic 编码会话决定,量化用的重要性矩阵也建在同一批会话上 1。
题目是 26 道 Python 工单,来自 ansible、openlibrary 与 qutebrowser,每道跑两次,合计 48 次尝试。环境封死:没有 git 历史、没有网络、拿不到上游补丁,轮数上限 200,上下文 384K,判定标准是这道题的 fail-to-pass 测试全部通过。
| 模型 | 文件大小 | 解出 | 轮数倍数 |
|---|---|---|---|
| GLM-5.3-Flash 满血 Q8 | 341 GB | 48/48 | ×1.00 |
| REAP144 Q8 | 171 GB | 48/48 | ×1.21 |
| REAP144 Q4_K_M | 97.6 GB | 48/48 | ×1.58 |
| REAP144 Q3_K | 71.4 GB | 48/48 | ×1.80 |
| REAP144 IQ2_S | 54.8 GB | 45/48 | ×1.83 |
| REAP144 IQ2_XXS(实验档) | 45.3 GB | 39/48 | ×2.77 |
「轮数倍数」是两边都做对的题上多花的工作量,大致就是多等的时间。71.4GB 那一档把文件压到满血版的五分之一,48 道全过,代价是每道题多等八成时间。
发布者把一条经验列在首位:留哪些专家比留几个更要紧。同样留 144 个,用词频掩码选出来的版本要花 2.21 倍轮数,用公开的多领域 REAP 50% 掩码要 2.29 倍,用编码会话打分选出来的只要 1.21 倍。
短问题抓不到坏掉的 agent。一个通用剪枝的 2bit 版本答对了 4/4 道短编码题,在 4 道 agentic 任务上 0/4。测试环境的第一版还放模型上了网,它有时会把上游修复直接下载下来;发布者封掉网络、逐个成功对照补丁位置后重跑,上表的数字才是封版那一次。
2bit 版目前是实验性的。IQ2_XXS 是唯一能塞进 24GB 显存加 32GB 内存的一档,多数任务也能做;失败时它不改文件,一路循环到轮数上限。加去循环护栏没用,同一批尝试是 27/37 对 30/37。10 月 14 日的更新给两张以上显卡加了可选的 MTP 草稿块(2.6GB),草稿命中约 70%,多卡加速还没测。
限制:只有文本、没有视觉,目前也只跑了 Python 仓库 11。权重与完整配方(评分、掩码、剪枝、量化脚本、两个 llama.cpp 补丁、评测环境)都公开,仓库里另附一张「试过但没用」的清单,写着 120 与 96 个专家、词频掩码、RCO 搜索、LoRA 修复、GSQ 与去循环各自的失败结果 12。
Loading content card…
回复还在生成,层已经搬到另一张卡
一位做操作系统与 JIT 编译器的开发者写了 jitllm,思路是把每台机器上的内核现场生成,再把模型层当成进程一样摆放和搬运 2。
| 硬件 | 模型 | 搬运 | 暂停 | 重算 |
|---|---|---|---|---|
| 2×T4 | Llama-3.2-3B Q4_K_M | GPU 0 → GPU 1 | 8.1 毫秒 | 0 token |
| 2×T4 | Llama-3.2-3B Q4_K_M | GPU 1 → GPU 0 | 8.4 毫秒 | 0 token |
| 2×V100 | Llama-3.2-3B,1.8k token 对话 | GPU 0 → GPU 1 | 20–21 毫秒 | 0 token |
| RTX 3050 Ti 笔记本 | Llama-3.2-1B Q4_K_M | CUDA → Vulkan | 91 毫秒 | 0 token |
关键是 KV 缓存分了页,跟着层一起搬,提示词因此不用重新处理。发布者说,搬过之后输出与没搬的那一次一致。
这一组的第二个数最干净:暂停的毫秒数写在左边,重算的 token 数是零。作者的设想还在更远处——把摆放变成调度,让模型比内存大、让不同显卡混着跑、让对话变长时算力跟着挪。
限制:被测模型只有 1B 和 3B,数字来自作者自己的录屏与本帖。
Loading content card…
两张游戏显卡,三晚把 125B 从 53 提到 78
一位小红书用户用两张 RX 7900 XTX(合计 48GB 显存)加 64GB 内存跑 Qwen3.8-Flash-Next 125B,监控面板抓到的峰值是 103.8 tok/s,预填充峰值 2867 tok/s,专家缓存命中率 99.6% 3。
三个晚上的成绩依次是:第一晚 53.2,第二晚 74.9(涨 41%),第三晚官方基准中位数 78.0。
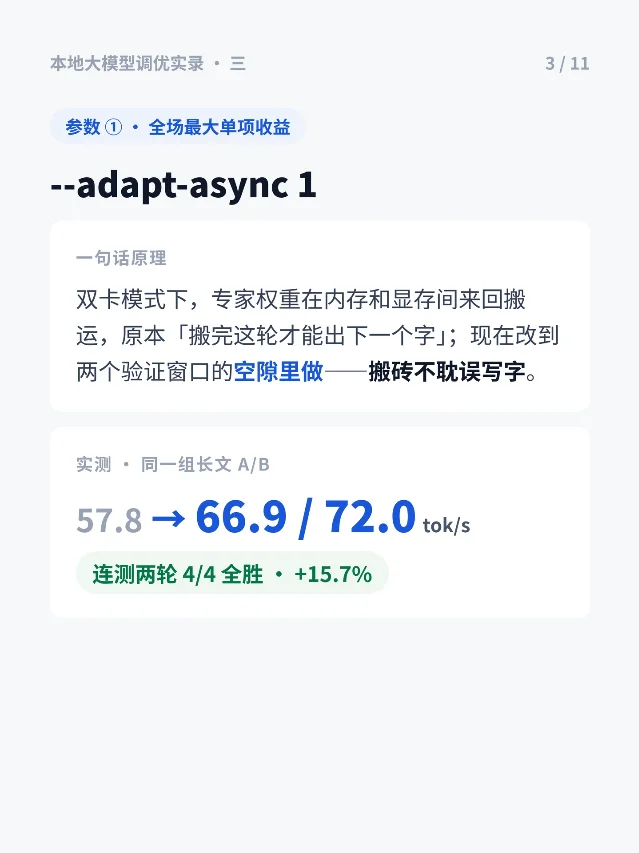
涨上去靠四个参数:让专家权重在内存和显存之间搬运时不挡住出字,长文生成快 15.7%;把 prompt 处理路径换成融合内核,预填充涨 8.5%;每张卡只留自己那 25/23 层的权重副本,省下 3.5GB 内存、单卡专家槽位从 7680 涨到 8587;草稿层的 K/V 批量处理。
同一个帖子里也记下了白测与翻车。官方文档标 +10% 的一个参数,20 组实测稳态零差异。另一个参数第一次 4/4 全胜,复测 5/8 打平。强制改磁盘读取模式同样打平,他还发现引擎会按磁盘状态自己切换。想换 Radiance 引擎,读完它 12 万字手册才发现核心库只支持最新一代显卡。
下一步是内存从 62GB 换到 128GB,把 28.8GB 的词表整个锁进内存,用来消掉磁盘波动。
限制:一台机器、三个晚上,没有冻结的测试协议,数字来自作者自己的监控面板。
把 125B 塞进 8GB 显存之后
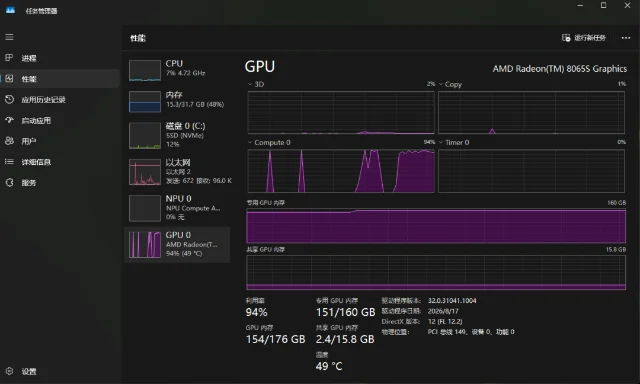
一套 RX 6600M(gfx1030)加 Ryzen 5 5600 与 32GB DDR4 的配置,本来不在 Strata 的支持列表里,装都装不上 4。发帖人让 agent 硬上,agent 给 gfx1030 配了专用 HIP 环境并把 Strata 自己编译出来,模型包也由它补齐,另外下了一个 5GB 的 MTP 模型。
跑起来约 20 tok/s、100k 上下文,和 llama.cpp 跑 35B 模型差不多快。
第二个读数就难看多了。这一档的 IQ1_M 权重「被切掉了大脑」:他让它找 Plymouth 启动主题脚本里的 bug,它一直分析,烧掉 100k 上下文并触发一次压缩,又烧掉第二个 100k,仍然没给出结论;期间它深挖 Plymouth 源码,还给自己写了一个测试主题的 harness。
同一条线上还有人在问同一个问题的另一半:32GB 显存加 32GB 内存的机器上,低量化的 Flash-Next 与 Q5 的 27B,哪个更值得跑 13。
限制:一套不受支持的配置、一个人、一次记录,也没有对照的满血版本。
Loading content card…
64GB 统一内存跑 27B 加一条视频
一位小红书用户用满血 M5 Pro 的 64GB 统一内存,本地跑 Qwen3.8-27B 的 MLX 4bit(含无对齐版)与 MiniMax H3 视频模型,全程不碰云端 5。
视频任务直接撞墙。实际占用 49.5GB,硬阈值 47.3GB,动态上限 49.8GB,系统静态上限 58.88GB,可回收内存只剩 343MB;MLX 的 memory guard 在预填阶段把请求掐断,终端报 process memory limit exceeded。
文本输出约 12 tok/s。一条 4.5 秒的视频,生成要 5 到 6 分钟。
帖子里还有一处对照:同一个 27B 的标准 MLX 4bit 版本被安全策略拦下,无对齐版则能跑。作者的解释是 64GB 统一内存由系统、显存与应用共用,权重 4bit 后约 16GB 看着不大,视频生成的激活值、KV 缓存与上下文都叠加进同一个池子。
结论按预算排:64GB 是体验线,128GB 是可用线,专用设备才是生产线。
限制:单次运行、样本量 1,作者自己写明仅供量级参考。
192GB 的迷你主机:官方 20 与 42,作者实测 14 与 90
10 月 9 日,极摩客联合 AMD 与京东在深圳发布了一台迷你主机 EVO-X5 Pro,用的是锐龙 AI Max+ PRO 495,192GB LPDDR5X-8533,带宽约 273GB/s,最高 160GB 可划给显存,120W 持续释放 6。
发布会大屏上是两组官方数字:GLM 5.3 Flash 320B 跑 20 token/s,Qwen 3.8 Flash Next(125+51B)跑 42 token/s,量化是 Q4 K XL UD 加 MTP。
作者拿到一台预装 Herdsman 牧马人引擎的机器,自己测了两轮。DeepSeek-V4-Flash-0731 稳定约 14 token/s,显存占用 95%,短回复时解码能到 21 t/s,预填约 10 t/s。Qwen3.6-35B-A3B-MTP 跑到 90 token/s,预填 24 t/s,内存只占 38%。
和上一代的 128GB 395 平台比,两行数据说明了这一代换到了什么:DeepSeek-V4-Flash-0731 在 395 上根本起不来,权重超出 128GB 内存;Qwen3.6-35B-A3B-MTP 从 62 t/s 涨到 90 t/s,多了 45%。
价格是 46,999 元(192GB+2TB)与 49,999 元(4TB)。作者的判断是预填慢属于 273GB/s 带宽的物理现实,和调优关系不大。
限制:官方那两行是厂商数据,作者这台是单机测试;厂商数据与自测数据并列在同一篇里,读的时候要分清哪一行是谁给的。
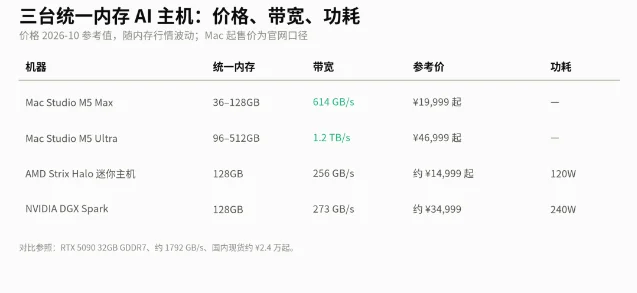
同样是 256GB:解码归苹果,预填归两台 Spark
公众号 GPUS 开发者 整理了技术博主 Alex Ziskind 的一组实测:一边是 M5 Ultra Mac Studio 单机 256GB 统一内存、1.2TB/s 带宽、整机 14000 美元;另一边是两台 DGX Spark 凑出的 256GB、总价 10000 美元,外加一条 QSFP 互联线走 ROCE,实测互联带宽约 111GB/s 7。
解码阶段两台打平甚至苹果领先:DeepSeek V4 Flash 短提示单用户 38 对 38 token/s,Qwen3.8 Flash-Next 是 45 对 38。同一个 M5 Ultra 上换成 MLX 框架,DeepSeek 从 llama.cpp 的约 40 token/s 提到 53。
预填阶段反过来。16K 输入 Spark 约 4 秒,M5 Ultra 要 21 秒;32K(相当 14 个 Python 文件)是 17 秒对 50 秒;128K 时 Spark 72 秒跑完,M5 Ultra 按趋势估会超过 3 分钟,这一档没实测。
真实对话里差距会被缓存抹掉一部分。16K 上下文首次提问 21 秒对 8.3 秒,后续追问 3 秒对 1.4 秒。
并发是另一件事。M5 Ultra 超过 4 个用户后预处理时间超过生成时间,8 个用户合计 46 token/s,首字等待超过 1 分钟,之后每路只剩 5 token/s。两台 Spark 在 8 用户下 DeepSeek 合计 25 token/s、Qwen 能到 120 token/s。满载功耗 434W 对 410W。
另一条线给了单台 Spark 的极端读数。公众号 千卡万象 按带宽算:70B 的 FP8 权重约 70GB,273GB/s 除以 70 ≈ 3.9,实测落在 2.7 到 3 token/s;同一台机器上的 gpt-oss-120b 因为每个 token 只激活约 5B 参数,能跑到 60.6 token/s,32K 上下文下掉到 40.6,少 27% 8。该文自己写明这张表要横着读,同一模型、同一份量化文件才允许比高低,跨行拼出来的「谁最快」是假的。
X 上有人把两套硬件直接摆在了一起。@ziverno 说两台 DGX Spark 在并发与预填上约为四张 R9700 的一半,单流解码还差 50% 14。@Iamwonderingif 把 273GB/s 的带宽称为 LLM 用途上的硬伤,说自己若要跑本地 LLM 会选 512GB 的 M5 Ultra 15。
公众号 老郭的学习空间 补了同一条线上的算术:256GB 能常驻 4 个 70B(Q4 约 42GB 一个,留系统与 KV 余量),但总解码吞吐被 1.2TB/s 焊死,并发只是把这块固定蛋糕切给 N 路;该文标注这些数字是推算值,作者本机是一台 16GB 的 Intel Mac 16。
用卡的数量换容量
X 用户 @hiroya_u_ 用六张中古 GTX 1070(每张 8GB、一万日元出头)加一张挖矿主板 TB250-BTC(约三千日元)搭了台自宅服务器,把 Qwen3.8-Flash-Next 的 IQ3_S(125B 级)在 Strata v0.1.44.1 加自改 Ver.60 上跑起来,输出约 30 tok/s,16K 读取 221 tok/s,他还补了一句同一问题每次给出同样答案 9。
另一位 X 用户 @anothervariable 给出的是 GLM 5.3 Flash 的分卡阶梯:3 张卡加 64GB 内存时权重溢到硬盘,预填约 200,解码掉到个位数;4 张卡加 128GB 内存跑真正的 int4,预填约 1.5–2k,解码 30–60;6 张卡全放进显存,预填约 5–8k,解码 80–120。他还提到 R9700 在本地 Micro Center 不到 1800 美元 10。
两条都是单条帖子。@hiroya_u_ 只给了一个读取速度,@anothervariable 只给了档位区间,两边都没写题目、轮数与测试协议。
顺带几条
Liquid AI 发布 LFM2.5-24B-A2B:24B 总参数、每 token 约 2.45B 激活、131K 上下文,面向本地设备上的文本推理 agent,官方给 GGUF、MLX 与 FP8 三个版本,许可为 LFM Open License(商用带 1000 万美元年营收门槛)171819。
腾讯开源了一个 Agent Memory 组件,100% 跑在本地 SQLite 上 20。
有人做到了直接在量化后的 GGUF 上训 LoRA,省掉 PyTorch,也省掉 FP16 母本 21。
一位用户把 Ryzen AI 8845 的 NPU 用来跑五个视觉模型:YOLOv8m、ResNet-50、RetinaFace、MobileNetV2 与 RCAN 2×;他在帖子里写明 PHX/HPT 的 XDNA 目前只暴露 CNN INT8,LLM 要的 BF16 桥还不存在,下一步是重写驱动层 22。
小红书 天空没有极限 整理了海外开发者社区的一组对比:DeepSeek-v4.1-Flash 没有官宣改版本号,用同一句提示词生成 3D 体素世界,10 月 12 日的版本比 9 月 9 日那版补齐了建筑层次、花草山水与飞鸟 23。这条只有画面描述,没有模型版本号与评测口径。
同样是 Qwen3.8 Flash Next,CLINE 在 PyCharm 里对一行小改动想很久,换到 Docker 里的 opencode 就直接改 24。
一台 Galaxy S21 上,Gemma 4 E2B Q3_K_M 与 Qwen3.5-0.8B Q4_K_M 跑同一个亚马逊下单任务,靠结构化浏览器感知给出两个都合法的购物车 25。
装下之后要看的四件事
这八组材料的分岔,多数出现在装下之后:模型还有没有把活干完。
看完可以先查四件事:模型与量化档对应哪一档文件大小;权重放在显存、内存还是盘上;瓶颈落在预填还是解码;以及发布者究竟跑了多少轮真实任务。
References
- 1Reddit r/LocalLLM:GLM-5.3-Flash 剪枝帖\
reddit.com
- 2Reddit r/LocalLLaMA:运行中搬层\
reddit.com
- 3小红书:双卡 7900 XTX 三轮调优实录\
xiaohongshu.com
- 4Reddit r/LocalLLM:125B 塞进 8GB 显存\
reddit.com
- 5小红书:M5 Pro 64GB 跑 Qwen3.8 与 MMH3\
xiaohongshu.com
- 6公众号 技术不求人:极摩客 EVO-X5 Pro 实测\
mp.weixin.qq.com
- 7公众号 GPUS开发者:M5 Ultra 对双 DGX Spark\
mp.weixin.qq.com
- 8公众号 千卡万象:DGX Spark 跑 70B 只有 3 tok/s\
mp.weixin.qq.com
- 9
- 10
- 11GitHub:GLM-5.3-Flash-REAP144-Coder
github.com
- 12Hugging Face:REAP144-Coder GGUF 权重
huggingface.co
- 13
- 14
- 15
- 16公众号 老郭的学习空间:256GB 常驻 4 个 70B
mp.weixin.qq.com
- 17
- 18Reddit r/LocalLLaMA:LFM2.5-24B-A2B
reddit.com
- 19Reddit r/LocalLLM:Liquid AI 发布 LFM2.5
reddit.com
- 20Reddit r/LocalLLaMA:腾讯开源 Agent Memory
reddit.com
- 21Reddit r/LocalLLaMA:在量化 GGUF 上训 LoRA
reddit.com
- 22Reddit r/LocalLLM:用 8845 的 NPU 跑 5 个视觉模型
reddit.com
- 23小红书:DeepSeek 后台静默升级
xiaohongshu.com
- 24Reddit r/LocalLLM:Harness 的影响大于模型
reddit.com
- 25Reddit r/LocalLLaMA:手机上两个模型跑同一个购买任务
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.