同一个模型换引擎出字从 2.8 到 24、125B 在 32GB Mac 上跑起来却聊不动、一张 R9700 从 19.2 爬到 184.9
八组实测里,每个速度读数旁边都站着另一个数字——一次真正跑完的分钟数、一个质量分、一道内存门槛;本期把快的那一栏和旁边那一栏并排摆出来,其中两组快的那一栏成立、活却没干成。

同一个 48GB 的模型,塞进一台只有 32GB 内存的笔记本。同一台机器上换一个引擎,出字从 2.8 到 24 token/秒;写下这个引擎的人第一句话是「这是实验,不是产品」。
一台 32GB 的 Mac mini 把 125B 的模型跑起来了。短提示 21.5 到 29.8 token/秒,看着像能用;真聊起来,每句话要等几十秒。
还有一张 R9700,同一个 27B 从默认的 19.2 爬到 184.9 token/秒,中间隔着 MTP 投机解码、两个算子补丁,以及六处默认配置里的坑。
过去二十四小时里的八组材料,每一个速度读数旁边都站着另一个数字。
| 材料 | 快的那一栏 | 旁边那一栏 |
|---|---|---|
| Janas 引擎 1 | 同一台 32GB 笔记本上,48.4GB 的 Qwen3-Next-80B 出字 24 token/秒,llama.cpp 2.8 | 作者自陈「这是实验,不是产品」,只在一台机器上验过 |
| SonicBoom 2 | 同一份 GGUF、同一批量化内核,解码 51.65 对 45.20 token/秒 | 预填 1051 对 1944,只有一半;只验证过一个模型 |
| strata-mlx 跑 125B 3 | 32GB Mac 上短提示 21.5–29.8 token/秒 | 41% 的专家每次都要从 SSD 读,实际对话每句等几十秒 |
| Anthropic 自复制实验 4 | 15 台约 55 美元的电视盒拼出 Gemma4-26B-A4B,0.39 token/秒 | 能力地板与尺寸天花板还没相交;只有 GLM-5.2 端到端跑完 |
| MiniCPM-V 4.7 5 | 官方称 iPhone 17 Pro Max 上 3GB 内存 13+ token/秒 | 独立核对者发现 OCRBench 的「+5.2」与官方图表对不上 |
| Qwen3.8-Flash-Next 对 27B 6 | FN 4bit 平均约 2000 预填/150 出字,30 分钟交活 | 交出来的 WebUI 用不了;27B FP8 慢一倍但能用 |
| Boole-1.7B 7 | 权重只有 247MB,比 BF16 小 13.9 倍 | 十题平均 50.55 对 58.83,保住 85.9% |
| 单张 R9700 的三段阶梯 8 | 同一张卡同一模型 19.2 → 62.4 → 184.9 token/秒 | 中间隔着 MTP、算子补丁,与六处默认配置的坑 |
一台 32GB 笔记本,跑一个 48.4GB 的模型
测试机器是一台 Intel Core Ultra 9 185H 笔记本:集显 Arc、32GB DDR5、1TB NVMe(约 5.7GB/s 读取),Debian 13。模型是 Qwen3-Next-80B-A3B,权重文件 48.4GB,比这台机器的可用内存还大。
Janas-LLM 是纯 C 写的引擎,除了 C 库没有别的依赖,GPL-3.0。
它的做法是权重留在盘上,每个 token 需要的专家从 NVMe 现读,反复用到的留在内存里。
作者 Maurizio "camauri" Cammalleri 把 13 个模型的 Q4_K_M 对照表直接放在仓库首页 1。
| 模型(Q4_K_M) | 读 1024 token:Janas / llama.cpp | 出字:Janas / llama.cpp |
|---|---|---|
| Qwen3-Next-80B-A3B(48.4GB,大于内存) | 62 / 16 | 24 / 2.8 |
| Qwen3-Coder-Next(48.4GB) | 66 / 14 | 22 / 2.2 |
| Qwen3.6-35B-A3B | 104 / 79 | 19 / 12 |
| Qwen3.5-9B | 111 / 78 | 14 / 8.7 |
| Qwen3.5-0.8B | 799 / 519 | 109 / 32 |
单位是 token/秒,两列都是同一台机器、同一天、同一份文件上测的:llama.cpp 用 9 月 18 日的构建 b18470 加 Vulkan 后端,参数
-p 1024 -n 16 -ngl 99 -t 12;Janas 用 janas-bench --prompt 1024 --gen 16,配置由引擎自己挑。加了草稿之后,Qwen3-Next-80B 到 37 token/秒。2.8 这个数字要交代一句:常规构建的 llama.cpp 在这台机器上跑 80B 时直接吃光内存,作者改用不带重排的构建加
--no-host 1 -lm mmap 才跑起来,读 16、写 2.8(挂上 GPU 写 2.0)。拦住它的是 CPU 后端会把权重复制进内存重排,Vulkan 后端又会把留在 CPU 的权重塞进系统回收不了的缓冲。输掉的那一格只有一栏。3 bit 的 Qwen3-30B-A3B(unsloth 的 UD-Q3_K_XL)读提示是 100 对 112——作者的解释是它的 3 bit 权重还走不到 GPU 的快速预填路径;而写的那一栏它快三倍,36 对 11。
有一栏作者自己更正过:带草稿那一列在 9 月 26 日之前整体偏高,因为当时测的是模型复读一段重复的段落,草稿几乎每次都猜中。改测正常回答之后,Qwen3.5-2B 从 107 降到 67。这个更正的记录就留在仓库的变更日志里。
作者自陈的限制写得很硬:只在这一台机器上开发与测量,其它 CPU、独立显卡、更慢的盘、更多或更少的内存都没试过;引擎会故意把空闲内存填满并把盘读满,余量不够的机器会被推进 swap 甚至卡死,用 GPU 时出过一次驱动重置、桌面跟着挂掉;公开 API 与命令行每周都在变。
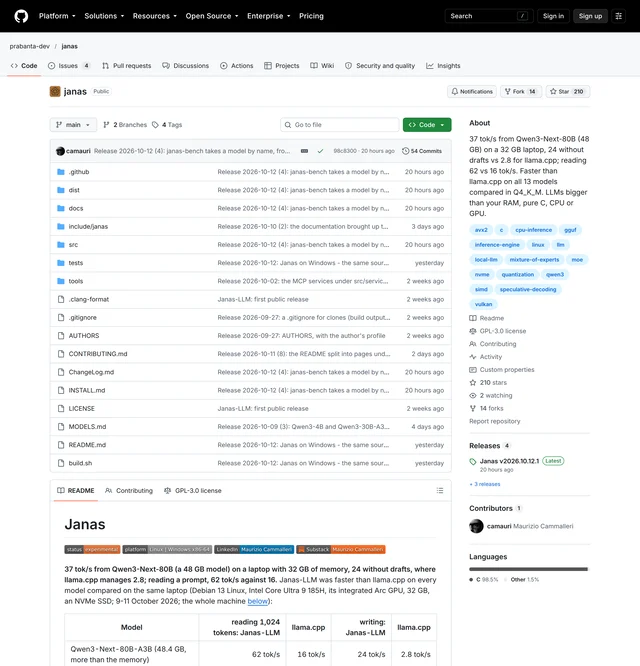
同一天在 X 上转述这张表的账号不止一个。@YashChaudharyAI 读成「生成 24 token/秒、草稿下 37、llama.cpp 2.8,13 个模型的 Q4_K_M 表里每一个都快过 llama.cpp」9;AI Weekly 的摘要把 37 放在第一句、24 放在第二句 10。同一个仓库,两种读法,差别只在草稿算不算进去。
Loading content card…
同样的内核,换掉上面那一层
第二组把变量缩到最小。笔记本 RTX 3050 8GB,模型 Gemma 4 E4B-it 的 Q3_K_M,两边加载同一份 GGUF,llama.cpp 用同一个 commit。
SonicBoom 是 C++/CUDA 写的张量运行时,对外是 C ABI,整条链路里没有 Python。作者 /u/nalaginrut 报的数:解码(tg64)51.65 对 45.20 token/秒,深度 2048 时 47.13 对 45.21,预填 4100 token 是 1051 对 1944,4000 token 前缀再加 100 token 新内容的首字 503 毫秒 2。
他的主张是那 14% 完全来自内核之上那一层。量化矩阵乘用的 MMVQ 与 MMQ 是从 ggml 移植来的同一批内核,动力来自一个图规划器:激活量化一次复用、norm 与激活融进量化、删掉死计算,每个解码步拍成一张 CUDA Graph 重放。派生自 ggml 的代码占核心约 8%,其余是运行时。
旁边那一栏他自己写出来:预填只有 llama.cpp 的一半。限制也一条条列了——只验证过一个模型;量化格式只支持 Q3_K、Q4_K、Q5_K,Hugging Face 上大多数 Q4_K_M 因为混了 Q6_K 与 Q8_0 还加载不了;只在 sm_86 上测过;采样只有贪婪;前缀复用与全量预填逐 token 一致,这是他给出的可用保证;他自己说这不是 llama.cpp 的替代品。
Loading content card…
32GB 的 Mac 上,125B 跑起来了,但聊不动
这一组换到 Apple Silicon。一台 32GB 内存的 Mac mini,macOS 27,引擎是 strata-mlx,模型是 Qwen3.8-Flash-Next 125B MoE(每个 token 激活约 20B)的 GSQ-RCO Q2_0 双分片,盘上 66GB。MTP 草稿头的 4.9GB 用 HTTP Range 从 BF16 检查点里抠出来,不用下完 360GB 的原权重。
引擎给出了每个内存档能装下多少专家:
| Mac 内存 | Q2_0(盘上 66GB) | IQ3_S(盘上 84GB) |
|---|---|---|
| 16GB | 9% 专家在内存 | 内存不足 |
| 24GB | 34% | 18% |
| 32GB | 59% | 35% |
| 36GB | 72% | 44% |
| 48GB | 全部,余 1.3GB | 69% |
| 64GB | 全部 | 全部,差 2.1GB |
| 96GB+ | 全部 | 全部 |
实测这一档:14,834 个专家里 59%(20.5GB)驻留内存,剩下 41% 由 SSD 按需读取。
启动 126 秒,README 标的是 23 秒,差在 13.9 秒的预读和内核编译;权重占 24.9GiB。
短提示生成 21.5–29.8 token/秒,提示处理约 220K token/秒,长上下文测到 64K 稳定 3。
那两栏的差距就出在这里。短提示的 21.5–29.8 看着能用,作者的实际体验是「每句话要等几十秒」——MoE 每个 token 都要换专家,41% 的专家在盘上,几乎每一步都在读 SSD;上下文一累积,速度断崖式下降。作为参照,同一份 README 给 128GB 的 M4 Max 标的是 68–111 token/秒。
他自己做的反例在同一台机器上:ollama 跑 Qwen3.8-27B 的 MLX 版,盘上约 16GB、运行约 18GB、全部在内存里,启动约 5 秒,评价是流畅、即时。他的结论是 32GB 上 27B 才是更好的选择,「这不是小马拉大车,是小牛拉大车——牛确实能拉动,但走不动」。
限制也如实写着:行协议只有 stdin/stdout,没有 HTTP 或 OpenAI 兼容接口,脚本要专门处理引擎先发的
RESUME 与 PP 行;真正让 125B 变得实用的是 48GB 以上内存,那时全部专家才进得了内存。Loading content card…
15 台电视盒,0.39 token/秒,跑的是同一件事
Anthropic 前沿红队在 10 月 12 日发了一篇实验记录,把「自复制」拆成四步:找目标、拿到执行权、把推理搭起来、从新主机继续扩散。前两步在实验里被故意做成没门槛,重点是第三步 4。
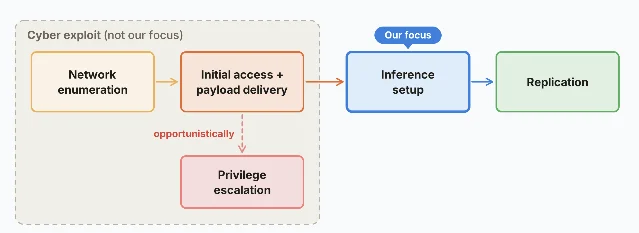
速度那一栏很寒酸,但它是实测的:15 台约 55 美元的杂牌安卓电视盒,每台 4GB 内存,按流水线并行分片,跑 Gemma4-26B-A4B,0.39 token/秒;按 32k 上下文的完整轨迹折算还要低,附录给的是约 0.3。
一个 32k 窗口要 27.3 到 31.8 小时,完整跑完 71 到 150 小时;换成 Qwen3.5-9B 是 10.9 小时与 28 到 51 小时。
真正要读的是另外两栏。能力地板是「模型够不够聪明,能自己找到机器、把推理搭起来」;尺寸天花板是「模型够不够小,塞得进这些设备」。测试里 Qwen3.5-9B 在 9 类硬件中的 8 类把 Llama3.1-8B 的推理拉了起来;30B 以下的模型单步大多能做,串起来就出错;简化评测里只有 GLM-5.2 端到端跑完,5 次里 4 次铺满 8 台、另一次 7 台。作者按 Epoch 能力指数的历史斜率外推,小模型在 2026 年底摸到这条线,并注明这只是粗估。
还有一条长程 agent 的经验值得单独拎出来。他们的 harness 叫 Memento:跑到超时就杀掉实例,让它留一小段笔记写清试过什么、哪里挂了,新实例带着工作区和笔记接着干。触发这个设计的是一个反复出现的失败——agent 会死磕一个错的假设,例子是 Qwen 花几个小时调包版本,真正的 bug 是接口和判卷 API 不兼容。传笔记让安装成功率从第一代 45% 升到 61% 到 84%。反过来,给一个小模型配前沿顾问(Opus 4.8)帮忙,无论顾问是工具调用还是主动插话,都没有可测的提升。
社区对这篇的读法分成两种,这里并列。Reddit r/LocalLLM 的帖子标题写成「本地模型能接管 IoT 了」,正文自己把结论收紧成「这是硬件适配能力,不是自复制」11;另一种读法出现在 X 上,认为这又是一次给开源权重做的免费宣传 12。作者自己在文里写了防守那一端的判断:复制体要拉几个 G 的权重、设备之间会持续有推理流量,ISP 的流量监控看得到——复制越快越吵。
3GB 内存里的 35B,与一次核对
面壁智能和 OpenBMB 社区在 10 月 13 日发布并开源了 MiniCPM-V 4.7,两个规模:35B-A3B 与 1B。官方称 35B-A3B 是系列里第一个 MoE,也是「首个能在端侧无损流畅运行的开源 MoE 多模态模型」,给的端侧数字是 iPhone 17 Pro Max 上 3GB 内存、13+ token/秒 5。
做法是三件事一起上:前瞻专家调度(LES)用跨层路由预测预取下一层要用的专家,只在预取与调度上做预测、计算仍按模型原本的 token 级路由;细粒度分层量化压小专家权重的体积与搬运量;再加 DSpark 投机采样。合起来的效果就是那个 13+ token/秒。
官方的另一栏在帕累托图上。
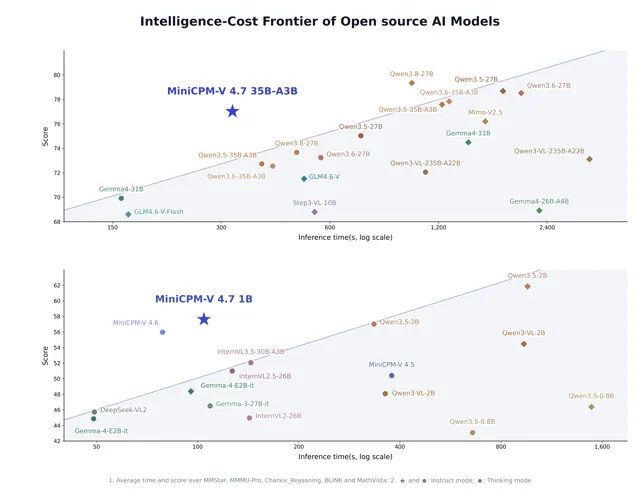
同一天就有人去核这份宣传。X 上的 @prompt48 把仓库、模型卡和图表都读了一遍,又在 8GB 笔记本上跑了 1B:他发现官方文案里 OCRBench 的「+5.2」与官方图表对不上,图表 16x 那一栏是 +4.4;他自己的收据测试里,4x 压缩读对了,16x 读错了 13。
同一批讨论里还有另一条用法。@eplurubusnullus 把这个模型同时铺在三台机器上——Strix Halo、3060 与一张 V100,开 9 个并发线程,合计约 230 token/秒 14。
截至 10 月 13 日傍晚,35B-A3B 在 Hugging Face 上的月下载量是 630,「端侧无损」目前仍是官方口径,本轮没有第三方在同一台手机上复现那个 13 token/秒。
同一道工单,快的那个交不出能用的东西
这一组不量速度,量的是活有没有干成。发帖人 /u/Think_Breakfast_2277 有一台自用机器:两张 R9700 AI PRO 32GB(合计 64GB 显存)、R5 5600X、128GB DDR4,其中一张卡走芯片组的 x4 通道,没有 P2P 与原子操作,服务端是 vLLM-Radiance,上下文设 262K。
任务是把他自己 harness 的旧网页监控替换成新的全功能 Web UI,并和 harness 代码库合并——两个项目要接起来。
他先把 Qwen3.8-Flash-Next 的 4 bit 挂上去:平均约 2000 预填、150 出字,30 分钟做完。
结果是一个又大又乱的 WebUI,模板里的东西被重新发明,聊天气泡不接工具调用,什么都跑不起来 6。
第二天他把备份恢复成同一个起点,换成 Qwen3.8-27B 的 FP8:平均约 1500 预填、100 出字,60 分钟。这一次模板跟住了,聊天气泡基本正常,仍需迭代但没有返工。
两边的速度都够快,慢的那个也只慢了大约一倍。差别在最后一栏:一个交出了要重写的文件,一个交出了可以往下改的文件。作者自己把口径写清楚——单次、非盲评、题目是他自己出的、速度是按实际产出算的不是跑分。
两张卡之间那条 x4 通道在评论里被问过,他自己的判断是瓶颈不在卡。
Loading content card…
1 bit 的 1.7B:小 13.9 倍,保住 85.9%
1 bit 的语言模型一直在做,难处在原理上:一个二进制权重只有一个符号,幅度来自一组权重共享的一个尺度。
共享一个幅度丢信息,尺度本身又占存储。
Boole-1.7B 是 Qwen3-1.7B 的 1 bit 版,面向英文、非思考模式,权重 247MB 7。
| 版本 | 权重体积 | 十题平均 |
|---|---|---|
| Qwen3-1.7B BF16 | 3.4GB 量级 | 58.83 |
| Boole-1.7B(1 bit) | 247MB | 50.55 |
| Bonsai-1.7B(1 bit) | 相近 | 44.97 |
| Ternary-Bonsai-1.7B(1.58 bit) | 457MB | 51.57 |
| unsloth Q3_K_M | 约 940MB | 53.66 |
Boole 是 BF16 十题平均的 85.9%,权重小 13.9 倍;与同为 1 bit 的 Bonsai-1.7B 比高 5.58 分;比三值的 Bonsai 低 1.02 分,而权重只占它的约一半。团队按 PrismML 的定义算智力密度(每 GB 权重带多少分)是 2.85/GB,是这批里最高的 15。
旁边那一栏也写在同一篇里:增益集中在数学与代码,十题里赢七题;MuSR、IFEval 与函数调用(BFCLv3)更低。他们还把 1 bit 的误差上限算了一遍——一组共享一个尺度时,理论上最多能恢复 36.3% 的权重方差,而把尺度组从 128 缩到 32 只多回 0.9 个百分点。换句话说,格式上再抠,也换不回多少。
同一张卡上的 19.2、62.4 与 184.9
最后一组把镜头推到参数层。单张 AMD Radeon PRO R9700 32GB(Navi 48,编译目标 gfx1201),ROCm 10.1,vLLM,模型 Qwen3.8-27B,跑长文本生成 8。
默认配置下 19.2 token/秒。加上 MTP 投机解码、配一个草稿模型之后,单步预测接受率维持在健康区间,跳到 62.4。再往上一层是算子:戴上 FAST_DRAFT 与 SKINNY_GEMM 补丁、把 AITER 编译缓存落到本地磁盘,到 184.9。
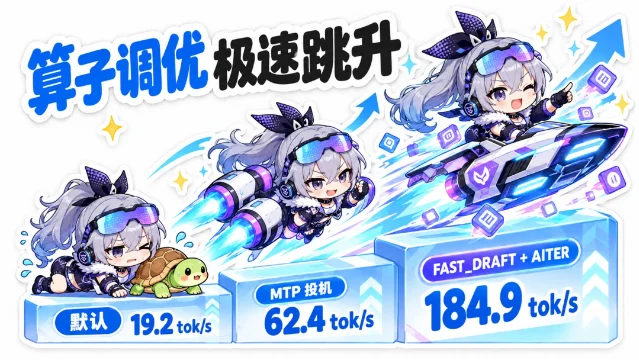
--num-speculative-tokens 3 与 --gpu-memory-utilization 0.92 是两栏之间真正改掉的值。8旁边那一栏不在这张图上,在文章的中间部分:六处默认配置的坑,每一处都能让这张卡停在那里。
| 现象 | 根因 | 处置 |
|---|---|---|
| 跨卡通信延迟飙升 | 主板 PCIe P2P 默认关闭,数据绕行内存 | BIOS 开 Above 4G Decoding 与 Resizable BAR |
| 多卡进程卡死无日志 | ROCm 10.1 的 RCCL 有环路等待 | 注入 NCCL_PROTO=Simple 绕开 |
| 高负载推理瞬间断电 | 标称 250W,瞬态冲到约 400W | 换 1000W 以上电源,调试期锁 250W |
| 直通抛 Reset 错误 | KVM/Proxmox 对多卡 P2P 支持不全 | 双卡改裸机 Linux |
| 可用显存少 2GB 且带宽偏低 | 出厂固件默认开 GECC | 关 GECC 并做两轮完整冷重启 |
| 启动长时间卡在编译 | 缺 gfx1201 的 Triton 预调优文件 | 导入已调优配置,否则现场调优 8.5 小时 |
双卡怎么切分也取决于插槽而不是显卡:两条高速直连走张量并行,受限插槽或转接线走流水线并行,因为张量并行每生成一个 token 要在两张卡之间往返约 160 次。
同一篇文章里还有两条别的读数:单张 R9700 借 Strata 的层级调度跑 Qwen3.8-Flash-Next,IQ3 量化下 60 到 75 token/秒;Strix Halo 那种 128GB 统一内存的机器跑 70B 只有约 5.1 token/秒,容量赢了,带宽没跟上。
作者自陈的限制:这是一份排障与参数记录,不是严格单变量实验——19.2 到 184.9 之间同时动了草稿与算子两层。
顺带
NVIDIA 的 Nemotron 3.5 Lightning(30B 总参、3B 激活)在 M5 Max 加 TensorFold 上:约 245 token/秒持续、370 突发、8 路并流合计 645,发帖人说自己跑过的最快,但 MMLU 落后 Qwen3.8 与 GLM 约 10 分 16。
纯 C 的 colibri 号称能把 2.8T 的 Kimi K3 跑在没有 GPU 的笔记本上,同一天有人把引擎自己的表翻了出来:Kimi K3 每个 token 约 9.4 秒、权重下载 1.56TB、读盘 6.3GB/s,算下来 300 token 的回答是 47 分钟 17 · 18。
Janas 那条线上另一个人也在改:按 r/LocalLLaMA 的建议给 SSD 流式的专家读取加了 n+2 前瞻预读,聊天 +8%、代码 +4.2% 19。
Intel 在 OCP 峰会上公布了 D270「Crescent Island」:480GB LPDDR5X、350W、32 个 Xe3P 核心、1.3 PFLOPS FP8、1.5TB/s、PCIe 5.0、风冷,单卡号称装得下约 300B 参数、八卡过 1T;没有价格与上市时间 20 · 21。
Sipeed 预告了 MaixStation(Axera AX8860),对 DGX Spark 宣称 27B 上预填快 25%、解码快 30%、价格近一半、每个模块 40W,但没有给出绝对 token/秒 22 · 23。
双 DGX Station GB300(TP2 走 400G 链路)跑 GLM 5.3 的完整配方:单用户 73 token/秒、GSM8K 49/50、读 8K 提示约 2200 token/秒,约为三台 Spark 的 2.5 倍;单台 GB300 上 GLM 5.3 Flash 从 160 提到 181 token/秒,最后 4.9% 来自配方里已有的三个设置,回答逐字节相同 24。
小红书 懒猫微服 称两台 T5000 并联、256GB 显存,GLM-5.3 Flash 实测写代码 68 token/秒;这条笔记带产品推广标签,正文只留下摘要,参数与测试方法拿不到 25。
把四栏先抄下来
八组材料里,快的那一栏很少是假的,只是旁边那一栏才决定它能不能用。同一个 48GB 的模型,24 与 2.8 之间隔着一句「这是实验,不是产品」;同一台 32GB 的 Mac,29.8 与「每句话等几十秒」之间隔着 41% 走 SSD 的专家;同一张 R9700,19.2 与 184.9 之间隔着六处默认配置。
再看到别处报出的速度,先把四件事抄下来:模型与量化档、上下文长度与并发数、权重放在哪一层(显存、内存还是盘)、瓶颈落在预填还是生成。这四栏不同,同一个型号能差出一个数量级。
References
- 1GitHub:prabanta-dev/janas\
github.com
- 2
- 3公众号 老樊爱折腾实验室:32GB Mac mini 6 跑 125B 大模型\
mp.weixin.qq.com
- 4
- 5Hugging Face:openbmb/MiniCPM-V-4.7-35B-A3B\
huggingface.co
- 6
- 7Reddit r/LocalLLaMA:Boole-1.7B 发布\
reddit.com
- 8公众号 寂寞的熊猫:AMD R9700 32GB 单双卡排坑指南\
mp.weixin.qq.com
- 9
- 10
- 11
- 12
- 13
- 14
- 15Precision Numerics:Introducing Boole-1.7B
precisionnumerics.ai
- 16
- 17
- 18GitHub:JustVugg/colibri
github.com
- 19Reddit r/LocalLLaMA:n+2 前瞻预读让 SSD 流式再快一点
reddit.com
- 20
- 21
- 22
- 23
- 24
- 25小红书 懒猫微服:GLM 5.3 Flash 本地实测
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.