多花四张视图换来腋下多一只手、多花五张卡只换回 3.6 倍并发、多花 275MB 换回 2.9 倍
八组实测各自多花了一样东西——多四张卡、多 21GiB 内存、多四张输入视图、多一个 275MB 的权重——本期把多花的那一份和换回来的那一栏并排摆在读者面前,包括换回负数的那两组。

同一张 3090,有人在 32GB 内存的机器上量到 59 token/秒,另一个人在 64GB 内存的机器上报出 120。同一只哆啦 A 梦,输入从四张视图加到八张,两条胳膊下面各多长出一只手。同一台 8GB 显卡跑 125B 模型,逐字生成时显卡只吃 46 瓦,CPU 封装的 90 瓦才是大头。
过去二十四小时里的八组实测各自多花了一样东西:多四张卡、多 21GiB 内存、多四张输入视图、多一个 275MB 的权重、多一份训练时间。换回来的那一栏深浅不一,其中两组换回的是负数。
| 材料 | 多花的那一份 | 换回来的那一栏 |
|---|---|---|
| 六张 3090 跑 125B 1 | 四张卡,加一层自建修复 | 常驻 262K 上下文从 5 个到 7.33 个;预填 2111 → 6574 token/秒 |
| 单张 3090 加 32GB 内存 2 | 21GiB 内存常驻,加绑核 | 预填 +18%、解码 +26%,每轮读盘 60GB → 0 |
| 8GB 显卡跑 125B 的电费 3 | CPU 顶满的那 90 瓦 | 显卡只出两成力;每天 8 小时月电费 19.6 元 |
| 混元 3D 四种输入 4 | 从 4 视图加到 8 视图 | 腋下各多一只手 |
| Veda 稀疏注意力 5 | 一个 275MB 的预测器 | 端到端 2.63–3.12 倍,视频越长越赚 |
| EXL3 量化基座训练 6 | 大约一倍的训练时间 | eval loss 低 0.018,峰值显存低 1.2GiB |
| Open-AutoGLM 手机智能体 7 | 24GB 显存,加一个 ADB 输入法 | 说一句话,手机自己动 |
| RDNA3.5 内核分支 8 | 十个 commit | 预填 +21–54%,生成端不动、短上下文低 2–3% |
六张 3090 上,七个人各开 262K
这是一台消费级机器:六张 RTX 3090、一颗 7950X、187GB 内存,其中四张卡走 Thunderbolt,卡间没有 P2P。模型是 GPTQ-INT4 的 Qwen3.8-Flash-Next,KV 走 int8,服务端是发帖人自己打的 vLLM 修复分支,一个流式请求占一个格位。
他把代码、启动命令与原始数据一起放在了仓库里,对照的一组是同一台机器上跑 llama.cpp 时的读数 1。
| 项目 | llama.cpp-multigpu | 本分支 vLLM(int8 KV) |
|---|---|---|
| 预填,单会话 250k | 2111 | 6574 |
| 首个 token,250k 提示 | 约 118 秒 | 37.8 秒 |
| 解码,单会话 250k | 33.7 | 57.6 |
| 解码,5 会话各自/合计 | 约 30/约 150(200k) | 37.9/190 |
| 解码,7 会话各自/合计 | 装不下(5 个格位) | 29.4/206 |
| 常驻显存 KV 的 262K 上下文 | 5 个 | 7.33 个 |
| 服务器空载时的可用内存 | 154 GiB | 141 GiB |
多花四张卡买到的总吞吐并不随人数等比增长。每用户解码随人数往下走,发帖人把它记成 57 → 44 → 38 → 29(依次 1、3、5、7 人)。llama.cpp 的分组解码几乎持平,5 人时从 34 掉到 30,两条路在五个人时的总和接近。
另一栏负数是权重格式。NVFP4 检查点能直接加载,在这些 Ampere 卡上比 GPTQ 慢 10–12%,两条路都走 Marlin 的仅权重量化,FP4 在 Ampere 上没有可加速的东西。
上游 vLLM 在这台机器上起不来。模型拒绝 pipeline-parallel-size 大于 1,TP 只能是 1/2/4/8,六张卡用不上,而 TP=1 时 24GB 的卡装不下;fp8 KV 在 Ampere 上会崩。把 102GB 的 n-gram(PLE)表放到 SSD 这件事,当天才作为 PR 出现在上游。
作者自陈的限制有四条:只有一个模型家族、只有 NVIDIA、只在一台机器上测过,外加 5060 Ti 上的内核单测。批量输出与单跑并非逐字节相同,属于 vLLM 常见的批处理非确定性,加载到可用要 4–5 分钟。代码由大模型执笔,靠测量与输出检查验证,例如埋针测试与内核对照 oracle,每条改动一个 commit,取用自便。他声明这是修复分支,自己并不打算长期维护。
Loading content card…
Loading content card…
单张 3090 加 32GB 内存,把 262K 开满
条件是一张 3090、32GB DDR5、i7-12700KF、一块 NVMe,模型是 IQ3_XXS 的 125B MoE,引擎 Strata。发帖人关掉交换、把 memlock 设为无限,并用 taskset 把进程钉在前 16 个线程上,因为这颗 CPU 的 8 个大核带超线程占 0–15,4 个小核占 16–19。
在同一个 121,566 token 的提示上、每轮都用新提示、开 MTP,他量到预填 1325 token/秒、解码 59–62。换成 249K token 的提示,预填 1008、解码 41.8,专家缓存命中 90.5%,同样一个字节都没从 NVMe 读。短上下文解码爬到 63–100。
三处改动各自值多少,他分开记了:
- 把 21GiB 最常走的专家常驻进内存(
--resident-cpu-experts --resident-budget-gib 21,配合 memlock unlimited),一个约 11,700 token 的提示上,预填从 555.6 到 656.1、解码从 48.4 到 61.1,每轮 NVMe 读从 60GB 归零。 - 绑 P 核之后,同样提示出 256 个 token,预填 440.6 → 555.6、解码 31.9 → 48.4,整个请求从 32.7 秒降到 24.9 秒。
- 预填块从
--prefill auto改成auto:16384,121,566 token 的提示上从 1014 到 1325,代价是两个缓存槽。
专家最后的去向是:12.2 GiB 在显存里(约 24,576 个专家中的 7,500 个),21 GiB 锁在内存里,约 6.6 GiB 留在文件里,覆盖 83% 的路由。
反例有两处。
--aux-cpus 在这颗 CPU 上三轮各一次,不带 60.1、带 59.6,他猜这个开关在 Threadripper 或双卡上才有用。把 --vram-reserve-mib 压到 500 会不停警告请求可能卡住,819 才安静下来,引擎文档里那次从中位掉到 13.7 token/秒的记录就发生在这类临近零余量的状态下。262K 的 KV 只占约 3.1 GiB。原因在这个模型的结构:48 层里只有 12 层会随上下文增长,另外 36 层的状态固定,不随上下文变长而变贵 2。
作者自陈:绑核和打开 CPU 预填份额是同时改的,两项各自的贡献分不开;日志里那些「从文件读」的巨额读量其实是系统页缓存命中,NVMe 计数是平的;384K 与 512K、别的量化、同时跑多个会话,他都没测。
同一张卡在别人手上是另一组数字。X @HMLGGGG 用 3090 加 64GB 内存报 80–120 token/秒解码、1256 以上预填,13 份文档共 45,290 token 用 36 秒读完、生成 3,226 token 的核对报告用 82 秒 9。X @iMilnb 用 5080 加 3090 与 64GB DDR4 跑 IQ4_XS,报 102.4 token/秒、专家缓存命中 97.5% 10。X @Indy_triguy 用 5060 Ti 16GB 加 64GB DDR4 报约 46 token/秒,把上下文从 128K 换成 64K 只快 13% 11。小红书 人工智能折腾师 David 把同一配置写成「一张 3090 跑千亿参数大模型,97 tok/s」,这条笔记只留下标题与首行可读,启动参数与量化档拿不到 12。
Loading content card…
8GB 显卡跑 125B,电费算在 CPU 那一栏
这台机器是 RTX 3070 8GB 加 R9 7900,模型是 Qwen3.8-Flash 的 GSQ-RCO IQ2_XS 量化、68GB 双分卷,引擎 llama.cpp,48 层专家里 44 层留在内存由 CPU 算,生成约 18 token/秒。
功率不走墙插电表,而是读芯片自己上报的数据:显卡读 nvidia-smi,CPU 封装读 LibreHardwareMonitor,每秒一次,连测四轮 3。
| 阶段 | 显卡 | CPU 封装 | 合计 |
|---|---|---|---|
| 桌面待机 | 12W | 约 55W | 约 68W |
| 加载 68GB 模型 | 44W | 66W | 约 110W |
| 答题(512 字) | 46W | 90W(顶满) | 约 136W |
| 参考:算力拉满 | 219W | 61–69W | 约 285W |
按答题整机 136W、民电 0.6 元一度算:连续跑 1 小时 0.08 元,每天 8 小时一个月 19.6 元,24 小时连轴 58.8 元,扣掉待机本底 68W 的增量口径约 10 元/月。同一张卡换成 9B 稠密模型全放显存,整机约 283W,一个月约 41 元。
每字能耗把这两条路分得更开:9B 稠密每出一个字耗 3.7 焦耳,8B 的标准 MoE 只要 0.42 焦耳,差 8.8 倍,速度还快 3.8 倍。
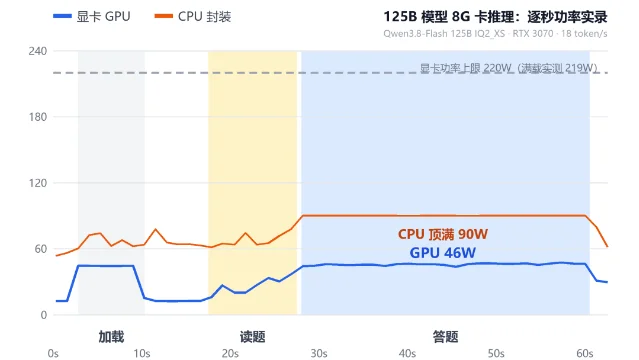
决定费不费显卡电的是权重放在哪一头。9B 稠密的权重全在卡里,逐字生成时搬运量直接顶满显卡带宽,功耗 219W,和满载一样。125B 装不进 8G 显存,44 层专家留在内存由 CPU 搬,CPU 把内存带宽跑满、封装顶到 90W,显卡那边只出 46W,整机 136W 反而比 9B 纯 GPU 的约 283W 更省电。
作者自陈:功耗是芯片遥测口径,不含主板、内存、风扇与电源转换损耗,墙插实测会高一到两成;待机那 55W 里含桌面后台程序。他也写明轻量使用每天几千到几万 token 时,API 每月几块钱就能解决,这套账只在批量跑稿、一天上百万 token 的强度下成立。
多传四张视图,换来腋下多长两只手
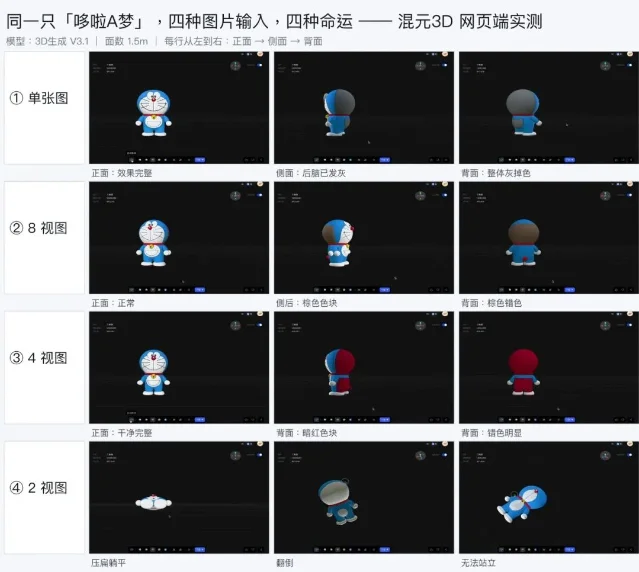
测试对象是腾讯混元 3D 网页端,图生 3D、模型版本 3D 生成 V3.1、面数上限 1.5m,四组输入用的是同一只哆啦 A 梦的 1 张、8 张、4 张、2 张视图 4。
| 输入 | 结果 | 背面 |
|---|---|---|
| 1 张正面图 | 排队 8 个任务、约 190 秒后开工,生成约 3 分钟,正面完整 | 整块发灰 |
| 8 视图 | 后脑勺变土黄,两条胳膊下各多出一只手 | 棕色错色 |
| 4 视图 | 几何最干净、比例正确,正面挑不出毛病 | 大片暗红 |
| 2 视图 | 约 82 秒出结果,整个结构压扁躺平 | 无法站立 |
输得最难看的那组用的还是最豪华的输入:正、背、顶、底、左、右与两个 45° 共八张,主图 1024×1536,顶底 1024×1024。八张图信息最全,几何反而崩得最厉害——腋下那片区域被互相打架的视角硬生生补出了重复肢体。
换成 API 复刻 8 视图,结果一模一样。总耗时 258 秒,其中任务执行约 240 秒,产出 43.2MB 的 GLB,glTF 2.0 校验通过。背面错色与腋下多手都还在,因为两条路走同一个大模型底座 4。
接口层面还有几处没写进文档的行为。它只认 7 种视角类型,其中没有正视图,正面要走主图通道;图片分辨率限定 128–5000,单张转 base64 后不超过 6MB;返回的 OBJ 链接其实是个 ZIP,改名解压后是 obj、mtl 与四张 PBR 贴图。接口响应里只有任务 ID、状态与文件链接,没有计费字段,实际用量要去腾讯云控制台按 AI3D 产品筛选查询,任何工具报出的「本次消耗 XX 积分」都无从核对。
作者自陈:核心思路、模型测试与录屏由本人完成,AI 只辅助文字整理与排版,文章附了四段实测录屏;3D 模型及部分配图为 AI 生成。他也试了控制台上的「OpenAI 兼容接入」入口,能建出 sk- 开头的 KEY,但实际调混元 3D 生成能力走不通,建议直接走 SDK 的签名方式。哆啦 A 梦受版权保护,生成物只建议个人学习研究。
花 275MB 的预测器,砍掉 90% 的注意力
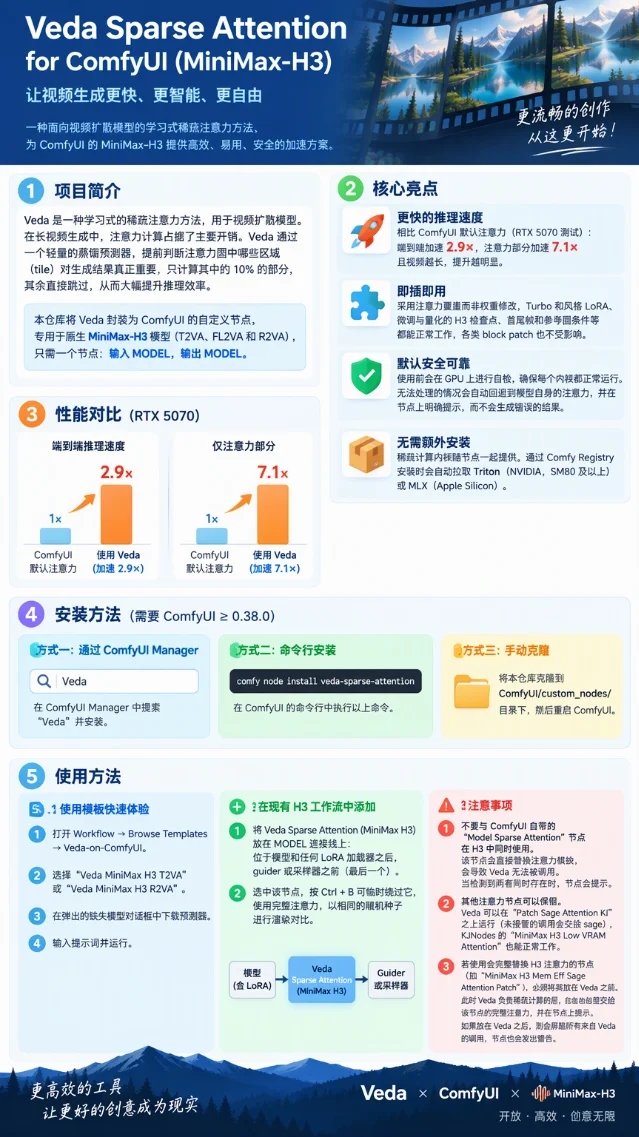
MiniMax-H3 这类时空视频扩散模型,生成一个高分辨率、带音频的长镜头,单次推理的 token 量常突破 10.4 万,注意力计算量随 token 数按二次方增长。Veda 的办法是训一个 FP8 格式、只有 275MB 的 TileScorePredictor,先给注意力图打分,挑出对画面与声音最关键的前 10% 计算块,其余 90% 直接跳过 5。
它不碰底模权重,官方把它封装成 ComfyUI 的自定义节点,串在模型与采样器之间。同一个工作流、同一组参数,只把这一层加上:
| RTX 5070 12GB 上的运行方式 | 单步注意力 | 8 步端到端 |
|---|---|---|
| ComfyUI 原生 | 40.7 秒 | 342 秒 |
| 开 SageAttention | 24.8 秒 | 231 秒 |
| 挂 Veda Sparse INT8 | 14.0 秒 | 130 秒 |
测试条件是 1344×768、124 帧、5.2 秒、8 步 Turbo LoRA、稀疏度 90%。单层注意力处理 10.4 万 token 时,原生 11.8 秒,开 Veda 之后是 528 毫秒,剩下的时间基本花在 MLP 与权重搬运上。
视频越长,这一层赚得越多。RTX 4090 上,5.17 秒片段的注意力提速 4.75 倍、端到端 1.77 倍;10.1 秒是 6.22 倍与 2.42 倍;14.4 秒长镜头是 6.31 倍与 2.82 倍。RTX PRO 6000 Blackwell 上,14.4 秒片段的端到端到 3.12 倍。
同一时间还有人在做另一件事。小红书 LightX2V-Studio 把 MiniMax-H3 接进 LightX2V,标题称 15 秒的视频生成只需 12 秒,这条笔记只留下标题与首行可读 13。X @HMLGGGG 则在 3090 上用 MiniMax H3 本地跑 576×1024、20 步、10 秒竖版预览,要 23 分钟,属于先把构图与关键帧定下来再花云端的钱的那条路线 9。
作者自陈的操作坑有三个:Veda 会和 ComfyUI 自带的稀疏注意力节点冲突,同一条 MODEL 线上只能留 Veda;和 SageAttention 这类全局补丁混用时,补丁必须放在 Veda 前面;垫图的人物面部还原不准时,把 reference_sparsity 改成 0%,让参考帧走 100% 全量注意力。
为一档更低的 loss,付出一倍的训练时间
EXL3-QLoRA 把 ExLlamaV3 的训练实现搬进了纯 PyTorch,不带 transformers,可以直接在 2 到 8bpw 的 exl3 量化模型上训练,适配器存成标准 PEFT 格式,能在 TabbyAPI 与 PEFT 里加载,也能合并回基座 6。
发帖人在同一个数据集、同一套硬件上量了四档:
| Qwen3.5-4B 的量化 | eval loss | 峰值显存 |
|---|---|---|
| EXL3 6.0bpw | 2.128 | 12.7 GiB |
| EXL3 4.0bpw | 2.152 | 11.9 GiB |
| EXL3 3.0bpw | 2.165 | 11.5 GiB |
| bnb NF4(axolotl) | 2.183 | 12.8 GiB |
反例那一栏是他自己写出来的:bnb 大约快两倍。他的取舍也写在括号里,exl3 更灵活、更省显存,在他这套测试里 loss 更低。
作者自陈:这是非官方的社区项目,仍在开发中。支持的模型家族包括 Llama3、Mistral Small/Medium、Qwen3 稠密与 MoE、Qwen3.5/3.6/3.8 混合模型、Gemma3/4 含 MoE 以及 Arcee Trinity,每个家族在训练前都先对照推理前向检查过。他已经用这条流水线产出并发布了几个模型。
说一句话让手机自己动,先付 24GB 显存
Open-AutoGLM 是智谱生态的 zai-org 放出的开源项目,由两部分组成:一套跑在电脑上的 Phone Agent 框架,加一个 9B 的 AutoGLM-Phone 模型,后者是拿手机界面训练过的视觉语言模型 7。
工作流程是一个循环:框架通过 ADB 抓一张手机截图,把截图和你的指令一起发给模型,模型输出结构化动作,
Tap、Type、Swipe、Launch、Wait,遇到必须本人处理的页面则输出转人工接管的 Take_over,框架再把动作翻成 ADB 或 HDC 命令发回手机。Android 7.0 以上走 ADB,覆盖 50 多个应用;HarmonyOS NEXT 走 HDC,覆盖 60 多个;iOS 的实验性支持写在仓库的 docs/ios_setup 里。代价这一栏很实在:模型本体约 20GB,本地部署建议 24GB 以上显存;自建推理服务要照抄 README 的启动参数,例如
--max-model-len 25480,参数改错容易输出乱码。Android 的中文输入必须先装 ADB Keyboard 并启用,否则打字会失败。两个安全机制写在源码里:
confirmation_callback 让支付这类操作先问一句再执行,takeover_callback 让登录、验证码这类页面主动交还控制权。支付与银行类页面的截图往往直接是黑屏,属系统级限制,也会自然触发接管。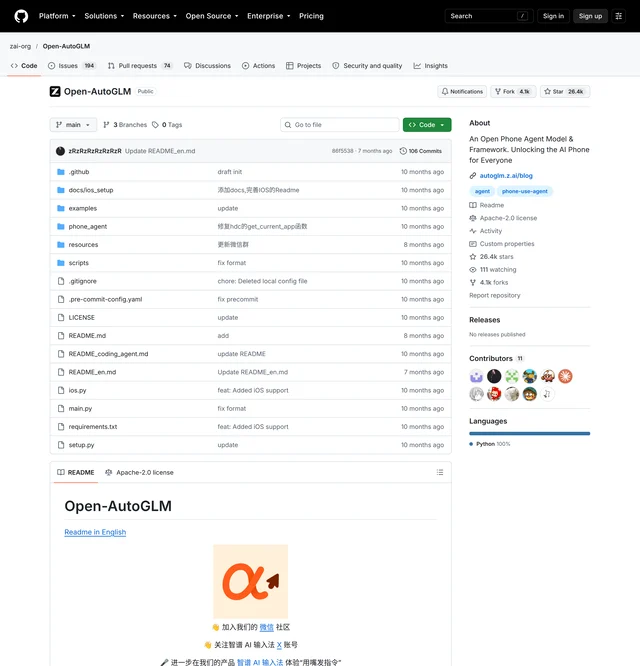
phone_agent/ 与 docs/ios_setup 分开摆放,正对应框架与模型、Android 与 iOS 两套支持各走各的路。7作者自陈:这篇文章是作者从 README 到源码通读一遍、再整理社区反馈写成的,文中没有他自己的完整运行记录;他同时写明项目声明仅供研究与学习,禁止用于非法获取信息、干扰系统等用途。仓库 README 上的 star 计数与公众号给出的 23.5k 略有出入,两者采集时间不同。
Loading content card…
同一套 llama.cpp,换一套 RDNA3.5 内核
最后这组扎在引擎最底下。发帖人 /u/asfbrz96 在 halo-box/strix-llama.cpp 之上写了一个叫 rdna35-perf 的分支,10 个 commit,只用 ROCm/HIP,跑在 Strix Halo 的 Radeon 8060S 加 128GB 内存上 8。
测试用 llama-bench,Q8_0 权重、q8_0 KV、开 flash attention。表里的「深度」指测试开始时 KV 缓存里已经有多少 token。
| 预填 tok/s | 深度 | Vulkan | stock ROCm | rdna35-perf |
|---|---|---|---|---|
| Qwen3.6 35B-A3B(MoE) | 0k | 2625 | 2935 | 4045 |
| 同上 | 128k | 786 | 568 | 1068 |
| Qwen3.8 27B(稠密) | 128k | 250 | 114 | 312 |
| Qwen3.5 2B(稠密) | 128k | 2160 | 1547 | 2886 |
生成端几乎不动:MoE 与 2B 在短上下文比 Vulkan 低 2–3%,从 64k 起差距在 1% 以内,稠密 27B 与 Vulkan 全程持平,对 stock ROCm 快 5–29%。预填这一头对 Vulkan 快 21–54%,对 stock ROCm 从 +8% 一路到 +174%。
质量那一栏是这组材料里少见的做法。他在 wikitext-2 的 6 个 4096 token 块上对 stock ROCm 算 KLD,又量了 32k 上下文的困惑度。rdna35-perf 的 KLD 比 Vulkan 更接近 stock ROCm(35B-A3B 是 0.0018 对 0.0038,27B 是 0.0013 对 0.0066,2B 是 0.0001 对 0.0008),最高概率 token 的一致率 98.5%/99.7%/99.5%,三套构建在 32k 上的困惑度相同。
反例是作者自己解释的:stock ROCm 之所以在深上下文落后,是它的 flash attention 在深度上掉得太快,rdna35-perf 对它的优势才随上下文增长;而 HIP graphs 在 RDNA3.5 上被默认关掉,因为在这里更慢。
作者自陈:这些数字只覆盖他试过的三个模型。
顺带
X @doplxyz 把 Strata 的启动时间做成了固定化的一套:R9700 32GB 加 RX 9070 XT 16GB 上,46.8GB 的 IQ3_S 光读权重就要约 32 秒,他固定
--layer-split、打开 --trim-stage-weights、固定预填预算与 --pool-workers 11,跳掉 46 种切分探索,第二张卡的可用显存多出 2.23GB;他用 ELYZA 10 题加英语难题 3 题做检验,帖子里记的总数是 26 次,全部跑完,IQ2_XS 的权重加载 33 秒、比 IQ3_S 少约 20 秒 14。Loading content card…
Reddit r/LocalLLM 上有人在 5090 32GB 加 64GB 内存上跑 IQ3_XXS 的 700K 上下文,生成约 100–120 token/秒,关掉视觉,一个连续会话里没做过一次上下文压缩;他自己估计 1M 上下文也可能跑得动、速度会降到约 80 token/秒,并注明这是没有验证的估计 15。
Reddit r/LocalLLaMA 上另一条 7900 XTX 的报告把 500K 上下文写进了日常:176B 总参、每 token 激活 6B,66.4GB 权重里 23.8GiB 常驻显存,31.6GB 专家权重与 28.8GB 的 PLE 表放内存,解码 105–160 token/秒,实测装下 506,849 token,4k、64k、256k 三档质量 81–84%、开思考 88–94%,解码在深上下文掉 18%。他还顺手查了另一件事:付费 pod 上近 13,000 轮里出现过 266 次回显自己先前推理的短串,原因是
preserve_thinking: true 把旧推理喂回了每一轮提示,关掉就消失 16。Reddit r/LocalLLaMA 上的 Decision 3.0 把开源多模态决策模型的尺寸从 0.6B 铺到 27B,发帖人 /u/henzy123 称它在两个 Jev Decision Index 榜上都排第一 17。
小红书 AI 热点资讯 称智谱对部分用户随机放出 GLM-5.3-Highspeed,实测约 493 token/秒,这条笔记只留下标题与首行可读 18。
公众号 寂寞的熊猫 在四张 4090 上跑 Strata v0.1.41:开
--batch 8 之后 8 并发墙上总吞吐到 375 token/秒,旧版纯串行排队是 136;四张 24GB 卡把 47GB 的 IQ3_XXS 专家池全常驻显存后,单流从双卡的 139 提到 180;8 个并发槽的锁页 KV 在启动时一次划走 75.3GB 内存,运行中保持平稳 19。小红书 猿人 AI 笔记 称 Qwen-Image 2.1 官方标 24G 显存,他在 8G 的 5060 上跑通,10–30 秒出一张,这条笔记同样只留下标题与首行可读 20。
X @0xSero 用 M4 Mac Mini 16GB 加外置 3090 报 17.5–23 token/秒解码、422–430 预填,权重是 exl3 3 bit,200K KV 加视觉,整套约 2,250 至 2,800 美元 21。X @boxwrenchx 把 R9700 上的 Strata 从 Vulkan 换到 HIP,写代码的解码从 70.6 到约 89 token/秒、16K 预填 2,400 token/秒,代价是这条路还在 PR 里等审 22。
把三个数先抄下来
八组材料里,多花的那一份和换回来的那一栏很少等比例。六张 3090 换回三倍多预填,七个人同时开口时总吞吐只到单卡的 3.6 倍。十个 commit 换回预填 21–54%,生成那一栏原地不动。多传四张视图,换回两只多余的手。
再看到别处报出的速度时,先把三个数抄下来:几个并发用户、上下文开到多长、瓶颈落在预填还是生成。这三栏不同,同一个型号的数字可以差出一倍。
References
- 1Reddit r/LocalLLaMA:六张 3090 上的 vLLM 实测\
reddit.com
- 2
- 3公众号 木圭的AI时代指南:8G 显卡跑 125B 大模型实测一月电费不到 20 块\
mp.weixin.qq.com
- 4公众号 无影枫:腾讯混元3D 全流程实测\
mp.weixin.qq.com
- 5公众号 源见卓识:砍掉 90% 计算,MiniMax-H3 提速\
mp.weixin.qq.com
- 6
- 7公众号 进击的测试圈:实测开源项目 Open-AutoGLM\
mp.weixin.qq.com
- 8
- 9
- 10
- 11
- 12小红书 人工智能折腾师David:一张 3090 跑千亿参数大模型
xiaohongshu.com
- 13小红书 LightX2V-Studio:H3 提速实测
xiaohongshu.com
- 14
- 15Reddit r/LocalLLM:5090 上的 700K 上下文
reddit.com
- 16Reddit r/LocalLLaMA:7900 XTX 上的 500K 上下文
reddit.com
- 17Reddit r/LocalLLaMA:Decision 3.0 多模态决策模型
reddit.com
- 18小红书 AI热点资讯:智谱对用户随机发布 GLM-5.3-Highspeed
xiaohongshu.com
- 19公众号 寂寞的熊猫:Strata v0.1.41 并发实测
mp.weixin.qq.com
- 20小红书 猿人 AI 笔记:8G 显存玩转 Qwen-Image 2.1
xiaohongshu.com
- 21
- 22
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.