一台 128GB 迷你机装下两个 300B、5.2KB 的引擎跑动 Gemma、生图模型的像素是贴回去的
八组材料里,决定读数的多半落在模型外面那一层:装下两个 300B 的引擎、5.2KB 的汇编实现、出图之后把原图像素贴回去的那一步,以及写进提示词里的规格书。

一台 128 GB 的迷你机上,两个 300B 级 MoE 模型各占一份权重:GLM-5.3-Flash 的预填到 580 tok/s(3.5K 提示),MiMo-V2.6-Flash-MOPD 约 650 tok/s(4K 提示),两份权重分别 99.7 GB 与 105 GB 1。
同一台 M6 上,Qwen3.8-27B 的 64K 提示预填从 129 抬到 196 tok/s,而 64K 困惑度从 5.0686 动到 5.0673 2。
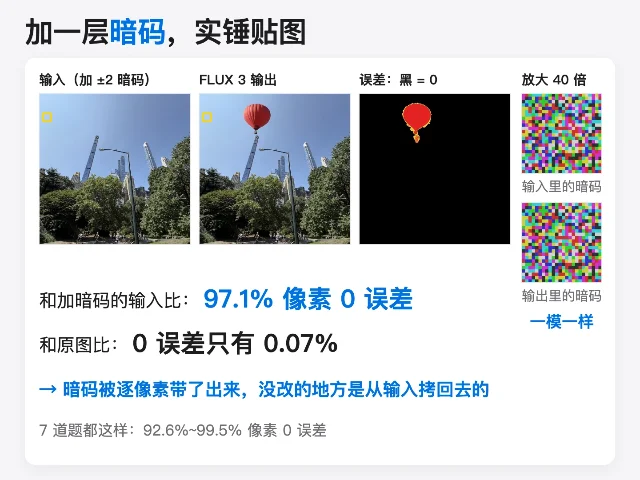
Flux 3 做「天空加热气球」这道题,输出整张图有 97.10% 的像素与原图逐像素相同,误差图除改动处全是 0;给它每个像素加一层肉眼看不出的 ±2 灰度暗码之后,暗码被逐像素带了出来 3。
今天这八组材料的差别,多半落在模型外面那一层:跑模型的引擎、权重被压成什么格式、出图之后还有没有一步后处理、提示词里有没有把规格写成规格书。
本期覆盖 2026 年 10 月 3 日至 10 月 4 日,来源为 X、Reddit、小红书与公众号,另含四处 GitHub 仓库与一处模型页。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例那一栏 → 作者自陈的限制 → 原帖」逐条给出。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 一台迷你机各跑一个 300B 级 MoE | Kyojin 引擎(ExLlamaV3 + ROCm,gfx1151)跑 GLM-5.3-Flash 与 MiMo-V2.6-Flash-MOPD 两个 EXL3 权重包,Ryzen AI Max+ 395 1 | 预填 580 tok/s(3.5K)与约 650(4K);解码 26–30 与 32/35/44 tok/s;KLD 0.151 与 0.0713;与官方 FP8 的 top-1 一致率 89.3% 与 92.0% 1 | 两个模型的任务成绩都未测;GLM 的 128K 未测;只在 gfx1151 上量过;转换管线不公开 |
| 5.2 KB 的引擎跑 Gemma-2B | 纯 x86-64 汇编(FASM)、AVX2 + F16C、老旧四核 i5、DDR4-2400 4 | 二进制 5.2 KB(3.7 + 1.5);FP16 解码 4.5–4.7 tok/s;内存带宽约 18.5 GB/s 4 | 作者把它定位成原理性参照,不是可用产品;单机单模型 |
| 两张旧卡凑出 32 GB | 双 Radeon MI50 16GB(HBM2、各 1.02 TB/s、限 145W)、llama.cpp Vulkan b11325、九款 GGUF 5 | MoE 组 pp512 738.57–983.26、tg128 46.85–60.57;dense 组 pp512 122.00–167.38、tg128 12.05–17.97 5 | 散热未解决;一张卡刷固件才点亮 miniDP;跑基准要带 RADV_PERFTEST=nogttspill |
| Qwen3.8-27B 搬上 M6 神经引擎 | ANEMLL Forge,8K–64K 上下文 2 | 预填 +40–53%;投机校验 +24–45%;64K 提示 129 → 196 tok/s;64K 困惑度 5.0686 → 5.0673 2 | 项目自测;首次编译约 22 分钟 |
| 一个翻译模型族与它自带的四种格式 | Index-Translate 的 2B/9B/35B-A3B 预览,外加 Echo/Homura/NativeLong 三支;10 月 3 日放量化版、10 月 4 日放免费 API 与四个基准 6 | 文本模型覆盖 150 语种;官方雷达把 35B-A3B 预览与 DeepSeek-V4.1-Flash、GPT-5.6-Sol 放在同一组轴 6 | 35B-A3B 仍是预览版;语音与长文两支的语种范围小于 150 |
| 同一道电气 CAD 题 | 豆包/GLM-5.3-Flash/DeepSeek V4.1-Flash 写 Python 调 ezdxf 出 DXF,七项各 10 分、总分 70 7 | 豆包 46 分(66%)、GLM-5.3 48 分(69%)、DeepSeek V4.1 49 分(70%);符号画法与比例尺寸三家都不及格 7 | 作者自陈测试可能不够严谨;单题、单次 |
| 生图模型的编辑一致性 | Flux 3 的 API,从公开图像编辑 arena 选加物体/删物体题,共 4000 次请求 3 | 三题整图 0 误差像素 97.10%/92.97%/98.70%;±2 灰度暗码被逐像素带出;整图改动 0.8%–6.1% 对另外三家 30%–98% 3 | 流程是从像素证据推断的;对比三家的名称是作者口径 |
| OpenCode 上两个匿名模型 | Fledge Alpha 与 Space Bunny,同一段提示词、都开最高思考强度,五道前端动画题 8 | 五题全部由 Space Bunny 胜出;Fledge Alpha 的改图轮次很少 8 | 单次、单一名出题人;分词器指纹只能锁到派系 |
一台 128 GB 迷你机装下两个 300B
Kyojin 是一个建在 ExLlamaV3 上的引擎,专门为 AMD 的 Strix Halo 芯片写(gfx1151、ROCm),第一版就打包了两个 300B 级 MoE 模型,让每一个都能单独装进一台 128 GB 的迷你机,所有读数都在 Ryzen AI Max+ 395 上量的 19。GLM-5.3-Flash 那一包的体积是 99.7 GB,预填在 3.5K 提示上 580 tok/s、64K 上 546,解码 26 到 30 tok/s(带 MTP),与官方 FP8 的 KLD 0.151、top-1 一致率 89.3%。MiMo-V2.6-Flash-MOPD 是 105 GB,4K 预填约 650 tok/s,解码在散文、闲聊与代码上分别是 32、35、44 tok/s(挂投机解码),不挂投机是 29,KLD 0.0713、top-1 一致率 92.0% 1。
这一组里最有信息量的是权重来源那一栏。GLM 那一包不是单一量化,而是把 turboderp 公开的 2.05 与 3.05 bpw EXL3 张量按自己的层配比混起来,再加一小段调优;在同样的 129 行上,对方那个 2.05 bpw 包(85 GB)KLD 是 0.275,这一包(100 GB)是 0.190,而对方的体积更小、解码快约 10% 1。两位作者还给了带 Uncensored 后缀的版本,做法是同一份权重加一个小文件,在加载时由引擎套上,一个开关能关掉 1。
没测的部分也逐条写了:MiMo 的任务成绩、GLM 在 128K 上下文下的表现,以及 gfx1151 之外任何一张卡上的表现,都还没有数;权重转换管线保持私有 1。权重与引擎分别放在 Hugging Face 和 GitHub 上,想自己核的人和想要别的模型包的人,入口都在那两处 10。
Loading content card…
5.2 KB 的引擎跑动 Gemma-2B
有人把跑 Gemma-2B 这件事压到了一份平坦 x86-64 汇编里:整个推理引擎用 FASM 写成,主程序 3.7 KB 加 GEMM 内核 1.5 KB,合计 5.2 KB 机器码 4。执行部分只用 AVX2 与 F16C,预填是自写的四线程 SMP GEMM;在普通 DDR4-2400 上把内存带宽跑到约 18.5 GB/s,在一台老的四核 i5 台式机上,FP16 解码是 4.5 到 4.7 tok/s,全程零 C/C++ 运行时、零 PyTorch,Python 只用来调 VirtualAlloc 和开线程 411。
作者把定位写清楚了:这是一次原理性探索,看一个现代 Transformer 能多干净地贴到裸硅上,顺带给将来跑在单片机与 DSP 上的微型模型留一个参照点 11。仓库里另有一份专门写 CPU 侧限制的回顾文档 4。
评论区把它拉回地面的一段值得一起读。一位做了三十年软件的工程师回忆,自己曾在一套全部用 80x86 汇编写成的商业套件上做基准,结果他用 C 写的小编译器平均快 12 倍——他的告诫是:性能来自算法与数据布局的选择,语言只是一种写法 11。
两张 150 美元的旧卡凑出 32 GB
两块二手的 Radeon MI50,各 16 GB HBM2、显存带宽 1.02 TB/s,作者给自己的装机版价格是单张不到 150 美元,合起来 32 GB,含电源整套不到 300 美元 5。他给两张卡各压了 145 W 的功耗墙,用预编译的 Ubuntu Vulkan 版 llama.cpp(b11325)跑标准的 llama-bench,模型选了一组 dense 与一组 MoE,都在 16 GB 以上、32 GB 以下 5。
九款模型的表拉出来之后,分界线落在模型形状上。MoE 那一组全部落在 738.57–983.26 tok/s 的预填与 46.85–60.57 tok/s 的解码:Nemotron 的 31B-A3.5B 是 863.92 与 60.57,Laguna-XS-2.1 是 738.57 与 52.88,Qwen3.6-35B-A3B 的三档量化是 983.26/46.88、937.47/49.19、783.24/46.85。dense 那一组两项都掉了一档:两个 27B 的 Q6_K 是 141.97/17.49 与 167.38/17.97,Gemma-4 31B 的两档是 122.00/15.20 与 135.99/12.05 5。
作者自己列的限制很具体:散热方案还没解决;其中一张卡刷了固件才点亮 miniDP,还要用 xrandr 加一个 1920×1080 的新模式;跑基准的命令里带着 RADV_PERFTEST=nogttspill 5。
评论里补了两条对读者有用的经验。一位用 MI25 复现过同样现象的人说,那张卡的带宽标着 480 GB/s,跑 dense 模型却只能在 20 tok/s 附近,换小模型之后解码速度立刻改善,卡住它的是吞吐。另一位说 Q4_0 在 MI50 上快得多,他在单张 32 GB 的 MI50 上跑 Qwen 35B-A3B 能到约 70 tok/s 5。
Loading content card…
Qwen3.8-27B 搬上 M6 神经引擎
ANEMLL Forge 这个开源项目把 Qwen3.8-27B 的完整模型放到了 M6 的神经引擎上,这一版在 8K 到 64K 的上下文区间里给出的数字是:预填快 40% 到 53%,投机校验快 24% 到 45%,64K token 的提示从 129 tok/s 抬到 196 tok/s 2。作者把质量栏也摆在同一段里:64K 上的困惑度从 5.0686 变成 5.0673 2。
条件方面能核的有两条:这次的主要优化是带校验器的 DGN,第一次编译需要大约 22 分钟 2。更新的服务端与模型分别放在两个仓库里,代码开源,想复跑的人可以照着走一遍 12。这组数字来自项目方自己发布,今天没有第三方在同一台机器上复现。
一个翻译模型族和它自带的四种格式
B 站在 9 月 30 日放出 Index-Translate,基座是 Qwen3.5,文本模型覆盖 150 种语言,并按术语、格式、内容保全这类要求执行翻译;10 月 3 日,他们给全系补上了官方量化版——GGUF 走 llama.cpp 本地推理,FP8(W8A8)与 NVFP4(W4A4,面向 Blackwell)走 vLLM 服务;10 月 4 日又放出 35B-A3B 的免费公开 API 与四个基准 6。
家族一共四支。Index-Translate 管文本、结构化内容与社区语;Index-Echo 输出字幕或带源说话人音色的语音,中文到英、日、西是打包好的方向;Index-Homura 按指定的目标音节数调整译文,适合配音口型对齐;Index-NativeLong 跨段落翻整篇长文 6。官方雷达图把 35B-A3B 预览、9B、2B 与 DeepSeek-V4.1-Flash、GPT-5.6-Sol 放在同一组轴上,七根轴分别是 WMT、FLORES、指令遵循、低资源翻译、字幕、MEME 与书籍/小说,虚线是每根轴上非 Index 模型的最好成绩 6。
要收着读的几处也写在页面上:35B-A3B 仍是预览版,正式版还没发;语音与长文两支支持的语种范围小于文本那 150 种;语音模型的 GGUF 仓库只装文本骨干,完整管线在 FP8 与 FP4 仓库里 6。权重与量化版同时放在 Hugging Face 和 ModelScope,Reddit 上转这条的帖子只讨论了一件事——它对中文社区语的处理比通用模型更贴 13。
Loading content card…
同一道电气 CAD 题,三个模型都停在 70%
出题的人画过完整一周的电气控制图,他挑的题是一张电机启保停图纸:主回路要有断路器 QF、接触器 KM、热继电器 FR 和电机,控制回路要有熔断器、停止与启动按钮、中间继电器,图幅右侧还要一列带编号的接线端子,图框、标题栏、元件明细表一样不能少 7。同一道题原样发给豆包、GLM-5.3-Flash 与 DeepSeek V4.1-Flash,判分七项各 10 分——图层划分、图框与标题栏、符号画法、元件代号、端子编号、比例尺寸、DXF 可编辑性,总分 70,达到 70% 算合格 7。
路径统一是代码出图:让模型写 Python 脚本调开源库 ezdxf 生成 DXF,本地跑脚本拿到图纸,再在中望 CAD 或 AutoCAD 里打开逐项核对 7。提示词按规格书写,图幅 A3 横向、比例 1:1、图层按元件代号命名、文字样式仿宋、粗实线 0.5 毫米与细实线 0.25 毫米两档线宽,元件尺寸表附在末尾 7。
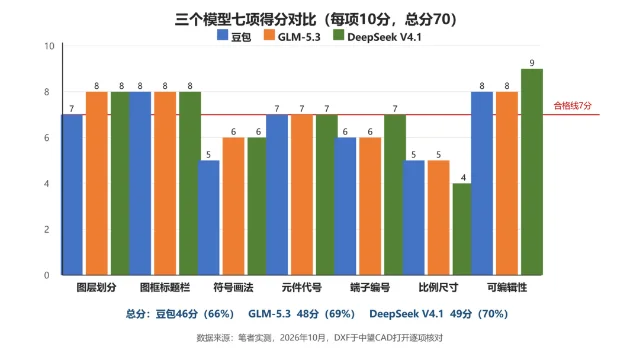
三家交卷的分数是 46 分(66%)、48 分(69%)与 49 分(70%),强项各不相同:豆包靠多模态来回改图,每轮只贴一张截图时定位最准;GLM-5.3 在脚本里塞了渲图自查,把文字压线、线型错乱这类问题自己揪出来;DeepSeek V4.1 的脚本一次运行通过、图层表与线宽表分块写,DXF 实体没有报错 7。共同的失分点也是三家一起落在符号画法与比例尺寸上:断路器、接触器、热继电器的图形只是大概像,GB/T 4728 的细节没有一处完全对得上 7。
剩下的 30% 被拆成三块并给了补法:实物尺寸要写进提示词,塑壳断路器 3P 按 105×155 毫米、接触器 47×60、热继电器 45×50 逐个给长宽;符号规范要做成标准图块库,由人按国标画好,模型只负责调用图块和连线;设计判断——断路器选 C 型还是 D 型脱扣曲线、热继电器整定多少倍额定电流——留在人手里 7。作者在文中自己加了一条注:测试可能不够严谨,仅供交流学习 7。
生图模型的像素是贴回去的
一位做 Agent 与多模态的作者把 Flux 3 的 API 试了一遍,题目从公开的图像编辑 arena 里挑,都是加物体或删物体:天空加热气球、沙滩加一只金毛、海湾删掉游艇 3。三张输出的整张图里,与原图逐像素完全相同(0 误差)的比例是 97.10%、92.97% 与 98.70% 3。
为了分清「生成得准」与「拷回来」,他给输入图的每个像素加了一层 ±2 灰度的暗码,正负随机,肉眼看不出来,模型也做不到完美复现 3。Flux 3 的输出里,暗码被逐像素带了出来:与加暗码的输入相比有 97.1% 的像素 0 误差,与原图相比 0 误差只剩 0.07%,7 道题的区间是 92.6% 到 99.5% 3。
他烧了 4000 次请求做逆向,给出的流程是:模型先把整张图画一遍,再与原图分块比对,差异超过门槛的区域保留生成结果,其余换回原像素;门槛最高 5/255,所以贴哪里只跟实际改动的范围有关,跟编辑框画多大基本无关 3。与其他生图模型的逐像素差比下来,所有题合计 Flux 3 的整图改动是 0.8% 到 6.1%,另外三家在 30% 到 98%,每道题至少差 8 倍;作者写下的那三家是 GPT 2.5、Nano Banana 2 与 Seedream5 3。
作者对自己方法的边界说得很清楚:流程是从像素证据推出来的;贴图能成立,靠的是它自己重画时改动区域本来就足够集中 3。
OpenCode 上又上了一个匿名模型
10 月 3 日,OpenCode 上架了一支新的匿名模型 Fledge Alpha。写这篇的人当天用同一段提示词、两边都开最高思考强度,把它和仍在榜的免费匿名模型 Space Bunny 放在五道前端动画题上比:小机器人偷吃、鹈鹕骑行、四季一棵树、火箭发射、城市十字路口 8。
五道题都由 Space Bunny 胜出:第一题在整体完成度与机器人表情上更细;第二题 Fledge Alpha 画出的自行车不完整;第三题作者的评语是「近期看到最拉的了」,并说现在国产 Flash 级模型每一个都比它完成得好;第四、第五题的差距肉眼可见 8。作者另外记下一个现象:同在 OpenCode 里答题,Fledge Alpha 总是很快就交卷,多轮改进的轮次很少,而单次能力的差距本来可以用多轮迭代补一部分回来 8。
关于 Space Bunny 是谁,另一条独立证据来自分词器指纹。一位作者用 36 条探针 × 8 家候选模型,直接读接口返回的 usage.prompt_tokens 计数,先发固定前缀记下基数、再发「前缀 + 测试题」做差值,抵消聊天模板与系统开销;每道题重复三次取中位数,结果没有波动 14。7 个候选里只有 MiniMax M 系能同时对上全部计数,两条关键题加其余 34 条交叉验证都指向它;再加上 1M 上下文、多模态输入、推理不可关、五档 effort 这些规格,作者的判断是它高度疑似 MiniMax M3 系列的 Flash 版 14。这位作者自己写了方法的边界:分词器可以被复用、单独训练或模仿,切分行为一致与权重相同是两件事,这套探针只能锁到派系、分不出代次;他还注意到观测期内底层文件发生过一次迭代,新增 1,340 字节,切分行为没有跟着变 14。
X 上有两条与它相关的对照。一条说 Space Bunny Alpha 过去五天是 OpenCode 上用量第一的模型,所据是 1M 上下文、多模态输入与可调推理,作者把同一条提示词分别发给它与 Gemini 3.8 Flash,认为前者做出的页面更有辨识度、响应也更快 15。另一条用它做 WebGL 小游戏,作者的说法是单次提示会做出一个「多面体游戏」,改成分步做才成立 16。
Loading content card…
今天能带走的三句话
第一句,同一台机器上的数字,先分清它来自模型还是来自模型外面那一层。Kyojin 换的是引擎与权重的混合方式,ANEMLL Forge 换的是执行路径,两边都拿到两位数百分比的增量,而质量栏几乎没动 12。
第二句,老硬件的成绩要连着模型形状一起读。同一对 MI50 上,MoE 是 46.9 到 60.6 tok/s,dense 只有 12.1 到 18.0,差出三倍多 5。
第三句,看到「一模一样」这类结论,先问它是画出来的还是贴回去的。Flux 3 的像素级一致里,被带出来的是输入图上的暗码,这一步发生在模型之后 3。
References
- 1Reddit:一台 128 GB 迷你机装两个 300B 级 MoE
reddit.com
- 2
- 3小红书:生图模型 Flux3 评测
xiaohongshu.com
- 4GitHub:tomtsai28/PULSAR-ASM\
github.com
- 5Reddit:双 Radeon MI50 基准\
reddit.com
- 6GitHub:bilibili/Index-Translate\
github.com
- 7公众号 高工电气:AI 电气 CAD 设计测评\
mp.weixin.qq.com
- 8公众号 老程AI:实测最新匿名模型 Fledge Alpha\
mp.weixin.qq.com
- 9GitHub:Yamz-Labs/kyojin
github.com
- 10Hugging Face:yamz-labs
huggingface.co
- 11Reddit:5KB 纯 x86-64 汇编引擎跑 Gemma-2B
reddit.com
- 12GitHub:Anemll/anemll-forge
github.com
- 13Reddit:bilibili 放出 Index-Translate
reddit.com
- 14小红书:中秋模型 Space Bunny 严肃猜测
xiaohongshu.com
- 15X:@DataChaz 的同题对照
x.com
- 16
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.