一部 iPhone 当第二块显卡、一个 0.6B 分诊器砍掉 45% 的账单、一条规则让 agent 少写 54% 的代码
八组实测都没有靠换更大的模型来解决问题:补的是一部手机、一个 0.6B 的分诊器、一条约束规则、两个 6B 的专用件,和一本按原帖逐条核过的账。

三个数字先摆出来。
一部 iPhone 17 Pro Max 插在 24GB 的 M4 Pro MacBook 上,把 32k 上下文的预填从 101 抬到 130 tok/s;同一台机器上写到 64k 以上,手机换了一份工作,改去替 Mac 扛住最老的那部分 KV 缓存 1。
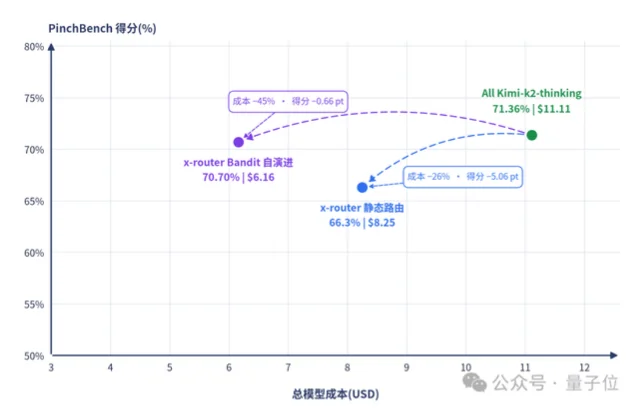
华为把「这一轮该交给谁」做成了一个跑在进程里的 0.6B 分类器。PinchBench 全部 147 道题上,它拿到 70.70%,只比全量调用 Kimi-K2-Thinking 低 0.66 个百分点,账单从 11.11 美元降到 6.16 美元 2。
微软放出一个 4B 的仓库级编码模型,报告里给的不是一次成绩,是一条阶梯:同一个基座,五轮强化学习把 SWE-bench Verified 的解题率从 39.4% 一路推到 61.5% 3。
今天这八组,没有一组是靠把模型换成更大的那一档来解决问题的。它们动的是别处:从旁边补一块算力、把模型做小做专、把选择本身做成一件事、加一条约束规则,或者干脆把账重算一遍。
本期覆盖 2026 年 10 月 2 日至 10 月 3 日,来源为 X、Reddit、小红书与公众号,另含宇树的模型页与仓库、一份开放权重模型卡、量子位的实测文与三处 GitHub 仓库。八组材料按「任务与运行条件 → 具体数字 → 分歧或反例那一栏 → 作者自陈的限制 → 原帖」逐条给出。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 24GB 笔记本上跑 27B 智能体 | 一部 iPhone 17 Pro Max 当第二块 GPU,USB-C 串联第 41–64 层;M4 Pro MacBook、Qwen3.8-27B(IQ4_XS)1 | 预填 16k 上下文 109 → 157 tok/s(+44%);32k 为 101 → 130;冷启 27k 会话 245 秒(原版 llama.cpp)→ 168 秒 4 | 64k 以内写入没有变快;一次只处理一个请求;作者自陈手机上显示的预填速度只算它自己持有的层 |
| 每轮请求选哪个模型 | openJiuwen X-Router,本地 Qwen3-0.6B 做分诊,五档模型池;PinchBench 147 题、11 个类别 2 | 自演进 70.70%/6.16 美元对全云基线 71.36%/11.11 美元;静态档 66.3%/8.25 美元 2 | 官方自测;对照只换了路由方式,提示词与评分口径未公开逐条 |
| 德语区自持的开源权重 | Kolibri(Aleph Alpha),78B 总参数、每 token 激活 3.5B,384 个专家里路由到 6 个 5 | AIME 96.9%;德语文本比 GPT-5 分词少约 15%;答不出时承认「不知道」44% 对 Qwen3.5 的 11% 5 | 装下它要约 78GB(2×H100 或 1×H200);记忆问答、长工具链与编码智能体是弱项;评测为官方口径 |
| 仓库级编码智能体 | FrogNano-4B-2609(微软),Qwen3.5-4B 基座、纯文本后训练、五工具 Leaf harness;约 131K 上下文、150 步预算 3 | SWE-bench Verified 解题率 39.4% → 五轮后 61.5%;BF16 权重约 9.3GB 3 | 训练数据以 Python 与英文为主;模型卡明说补丁可能过测试但仍不正确或不安全 |
| 人形机器人的全身操作 | UnifoLM-WLA-1.0(宇树),6B,约 2,500 小时真机数据,64 个任务(10 个全身 + 54 个桌面)6 | 官方表里 ER-1-4B 在 16 项感知基准上 7 项领先开源;演示在 G1 本体上铺床、装洗衣机、叠衣 6 | 成绩来自官方技术报告与各家 API 自测;演示视频没有给成功率 |
| 电商图与海报的排版 | Ming-Image-0.1-Design(蚂蚁百灵),6B,Design-Layer 拆图层 7 | 主副标题、卖点卡片、标签层级由模型自己排;拆出的四张 896×1194 RGBA 图层分别是标题、产品、卖点与背景 7 | 拆出来的文字仍是图片不是文本框,精修改动仍要别的工具;「开源第一」是厂商口径 |
| 让编码 agent 少写代码 | Ponytail:一条七级决策阶梯 + 生命周期钩子,每轮强制注入;真实 Claude Code 会话改真实仓库,12 个任务、n=4、Haiku 4.5 8 | 代码行 −54%、token −22%、成本 −20%、耗时 −27%,安全项满分 8 | 效果依赖模型遵守度;作者自陈在爱纠结思考 token 的模型上成本反升;最近提交停在 9 月 14 日 |
| 修完同一批真 bug 要多少钱 | Bug Hunt Benchmark:两个真实仓库、105 个隐藏 bug、盲评;九个模型拉满推理档 9 | 修掉个数 45 / 43.5 / 43 / 41.7 / 32.2 / 31.3 / 29.3 / 27 / 17 9 | 这 105 个是年初前沿模型漏掉的硬 bug;榜单仍在更新,别把 45 读成「只解出 45/105」 |
一部手机当第二块 GPU:64k 以内帮预填,64k 以上改扛缓存
发帖的人要用一台 24GB 的 M4 Pro MacBook 跑 Qwen3.8-27B 的智能体:模型是 IQ4_XS,8 位上下文的窗口只装得下 64k,连线内存上限提到 20480 也还是紧 1。他的做法是让 Mac 跑第 1–40 层,把激活值经一根 10Gb/s 的 USB-C 线流给口袋里的 iPhone 17 Pro Max,手机用 GPU 跑第 41–64 层,Mac 这边同时开始下一批 1。
增益按上下文长度排开:把一份 2,000 token 的文件预填进已有会话,16k 上下文是 109 → 157 tok/s(+44%),32k 是 101 → 130(+29%),48k 是 87 → 113(+30%);8k 那一次是 +35%,作者注明前两天在同一条基准上量的 1。一个全新的 27k token 会话冷启动,原版 llama.cpp 要 245 秒,他自己的分支单机 228 秒,加上手机 168 秒 1。
过了 64k,手机换岗。最老的 KV 页搬到手机上,Mac 跑全部 64 层;每个注意力层里,手机算老 key 上的注意力,Mac 再把它和自己那份合并。到 140k 时,这一步把写入从 279 毫秒降到 176 毫秒每 token 1。服务端按手机剩余内存分配 196k–229k 的 8 位上下文,最多约 5.7GB 的 KV 缓存住在手机上,Mac 的内存占用到 64k 就不再涨 1。他跑到 128k(8 位),埋进去的三个事实三中三;另一次 140k、4 位,贪心输出与前 32 个 token 与纯 Mac 那一次一致 1。
它不做的事写在最前面:64k 以内的写入不会变快,那是 Mac 的活;一次只处理一个请求 1。帖子的第一行还有一条更正:手机上显示的预填速度只算了它自己持有的那些层,真正端到端的速度是下面那组数 1。代码、安装脚本与基准脚本都在仓库里 4。
Loading content card…
0.6B 的分诊器:省掉 44.6% 的账,掉 0.66 个百分点
openJiuwen 是华为牵头、联合高校与企业共建的开源 Agent 平台,这次给出的东西是在 Agent 与模型之间加一层决策:请求进来,先判断这一轮该用哪个模型、用什么策略 2。落到代码里,最上面的算法是 x-router:一个跑在进程内的 Qwen3-0.6B 做复杂度分档,把请求分到五档模型池,从简单到推理逐级升级,本地模型和云端模型混编 2。
实测接在 WorkSwarm 上,用 PinchBench 全部 147 道题、11 个类别,三组实验用同一批模型和同一套评分标准 2。全云基线(全部交给 Kimi-K2-Thinking)是 71.36% 与 11.11 美元 2。
第一个数字是静态路由:66.3% 与 8.25 美元,得分掉 5.1 个百分点、成本降 25.7%。第二个数字是打开 Bandit 自演进之后:成本从 8.25 再降到 6.16 美元(再降约 25.3%),得分反而升到 70.70%,与全云基线只差 0.66 个百分点,整体成本降约 44.6% 2。
同一个工程里还有两处判断值得抄进自己的核对清单。一是状态的存放:算法被要求成纯函数,同样的请求加同样的状态快照必须给同样的决策;所有跨请求的记忆外置到独立状态层,所以状态丢了只是降级成冷路由,不会让请求失败 2。二是默认的克制:样本不足或优势不明显时保留原判定,不为了「演进」而演进 2。内核是 Rust,Python 侧是 PyO3 扩展,仓库已开源 10。
限制同页写明:这是官方自测;Terminal-Bench/LLMRouterBench 上另一组配置(Opus 4.8、Qwen3.5-122B、Qwen3.5-35B 三档)在偏成本模式下降成本 51.4%、成功率达到 Opus 的 95.2%,偏质量模式下降 15.7%、达到 98.6%——省多少、让多少质量由业务自己选,这也意味着没有一个通用的最优解 2。中文平台上有条笔记转述了同一套数字,但只报了最好那一档(70.70% 对 71.36%、11.11 到 6.16 美元),没带静态路由那一组 11。
78B 只叫醒 3.5B,门槛落在 78GB 显存上
Aleph Alpha 放出了一个德语与英语的开放权重模型 Kolibri。写这篇拆解的是 IBM 的一位工程师,他把结构讲得很直白:每一层有 384 个很小的专家,路由把每个词送进其中的 6 个,所以它算起来像一个 3.5B 的模型,却要按 78B 的身量占内存——约 78GB,也就是两块 H100 或一块 H200 5。
第二处设计是注意力:多数层只看最近 512 个 token,每第 5 层才看全部,靠这个把上下文撑到一百万 token 而不让成本起飞 5。第三处是语言:它用德语推理,团队发现给一点点德语推理数据比不给还糟——模型的德语思路会绕圈跑不完,于是他们造了约 80 万条德语推理样本喂进去 5。
数字这一栏,作者转述的是官方评测:AIME 上 96.9%,压过他试过的每一个 MoE,包括体积大三倍的;作者自己拿分词器跑了一遍德国宪法,同样文本比 GPT-5 的分词少约 15% 的 token,
bundesverfassungsgericht 在 GPT-5 那边是 6 个 token、这边是 2 个 5。另有一个被单独训练的习性:团队玩一种游戏,把文档的一部分藏起来,有时是在帮它、有时是在藏证据,让它自己判断,结果它答不出时会承认「不知道」的比例是 44%,同一口径下 Qwen3.5 是 11% 5。弱项也点名了:凭记忆答题、长来回里用工具、编码智能体这三处它落后,Qwen 系列在前两项上更强;要跑起来还得用 Aleph Alpha 给 vLLM 写的插件 5。这一组的可用性判断因此很干净:如果你的文档是德文、且必须留在自己的机器上,这是一件大事;如果只是想让一个开源模型在你的单卡上跑起来,78GB 这道门槛已经先把它挡在外面。
Loading content card…
4B 的仓库解题率,靠五轮强化学习从 39.4% 到 61.5%
微软的 FrogNano-4B-2609 是从 Qwen3.5-4B 改出来的仓库级编码智能体,后训练只用强化学习,喂的是用 TaskPilot 生成并随策略校准的约 1,500 个合成软件工程环境,奖励来自可执行测试;它不学更强模型的解题轨迹、动作或推理痕迹 3。
模型卡给的是一条阶梯,这是整份材料里最有用的一栏:同一个 Qwen3.5-4B 基座,在五工具 Leaf harness 下的 SWE-bench Verified 解题率(Avg@3)是 39.4%;五轮 TaskPilot 引导的强化学习之后,依次是 49.1%、53.1%、56.7%、59.1%、61.5% 3。换句话说,从 4B 这个体积往上抬的每一格,都能对到一轮训练,而不是一次换更大的模型。
跑它的条件也写得具体:BF16 权重约 4.66B 参数、约 9.3GB,主要评测用的合并上下文约 131K token,单轮最多生成 8,192 token,主评测的预算是 150 步交互;前四轮训练的上下文上限还是 65,536 token 与 75 个工具回合,第五轮才抬到约 131K 与 150 回合 3。
限制这一栏比多数模型卡都长,而且值得逐条读:训练数据以 Python 与英文为主,其他语言和框架没有充分评测;性能对 harness、提示格式与工具集敏感;模型卡明说,它可能生成「通过了现有测试但既不正确也不安全」的补丁,落地前需要人工审查与独立回归、安全测试;它也没有做专门的安全对齐训练 3。这几句放在一起,「4B 能不能替人改仓库」这个问题就有了一个可操作的答案:能当第一遍,但过不了验收这一关。
Loading content card…
6B 驱动 64 个任务,成绩来自官方技术报告
宇树的 UnifoLM-WLA-1.0 是一个 6B 的通用人形基础模型,训练用了约 2,500 小时真机数据,一个模型同时管桌面操作与全身操作共 64 个任务,支持两指夹爪与多种五指灵巧手 6。拆开看它由两段拼起来:前面的具身推理器 UnifoLM-ER-1 建在 Qwen3-VL-4B 上,用超过 500 万条样本训练点预测、检测、多图推理、2D 轨迹与 3D 检测;后面接一个 MMDiT 动作专家,把末端、手与下半身的动作分别用残差 VQ 离散化后再做连续控制 6。
官方页给了一张 16 项基准的表,ER-1-4B 在开源模型里有 7 项领先,整体与头部闭源模型接近;表里同框的包括 RoboBrain2.0-7B、Robix-7B、Cosmos3-Super-64B、Qwen3-VL 的 4B 与 8B、Thinker-4B、Gemini 的几档以及 GPT-6-Astra 6。
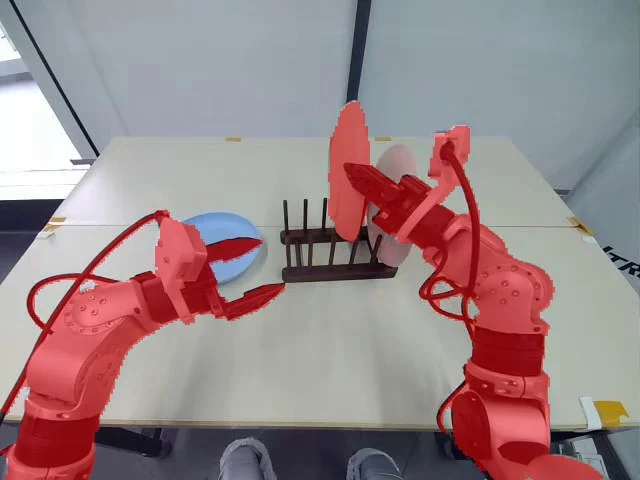
这一组要打的折写在表格下面:成绩来自各家模型自己的技术报告或公开论文,是用各家官方 API 测的 6。Reddit 上转这条的帖子只有 37 赞、5 条评论,提问也停留在「这是真进展还是又一个好看的 demo」——铺床、装洗衣机、叠衣服、分拣这些都在演示视频里,但没有给成功率 12。权重、代码与数据集公开,想自己核的话入口都在官方仓库里 13。
Loading content card…
6B 只管设计:一次输出四层图层
蚂蚁百灵开源的 Ming-Image-0.1-Design 是一个 6B 的设计模型,作者的说法是「UI/UX Design 方向开源第一」7。写这条笔记的人做过 UI 设计师,他关心的不是画面好不好看,而是排版——以前用 AI 做图,底图出来后标题还得自己加、布局还得自己排,甲方一改就全部重来;这个模型把排版一起做了,看实测图,中文基本不崩,主标题副标题、卖点卡片与标签的主次层级是对的 7。
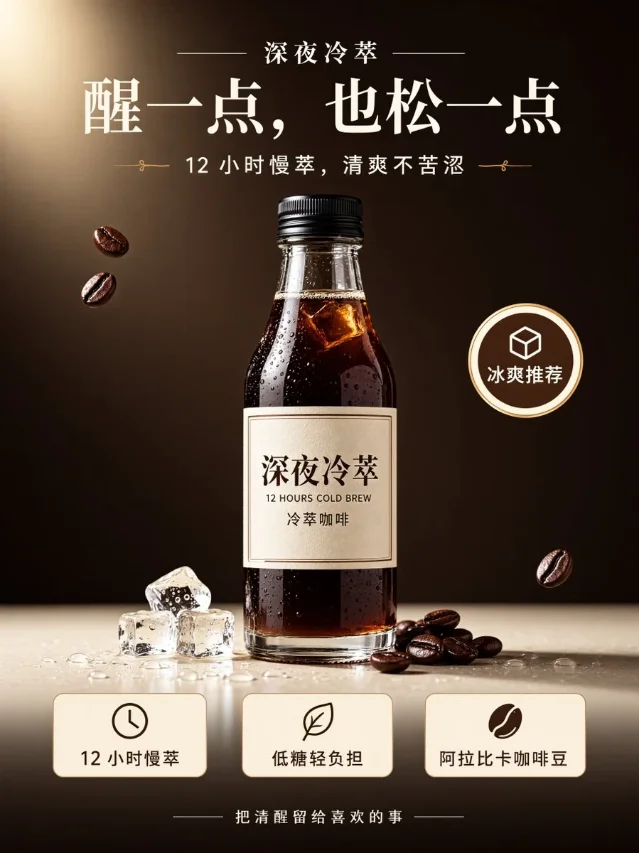
配套的 Design-Layer 才是更有意思的一半:它把成品图拆成一层层的 RGBA 图层,标题一层、产品一层、卖点一层、背景一层。品牌方说产品换一下、版式别动,换掉产品层即可,其余保留 7。这条笔记自己也贴了调用记录:走 OpenRouter 的
inclusionai/ming-image-0.1-design-layer 拿到 HTTP 200,返回并保存四张 896×1194、32 位 RGBA 带 Alpha 通道的图,分别对应标题、产品主体、卖点标签与背景装饰 7。边界作者也写了:拆出来的文字仍然是图片不是文本框,要精修还得配合 Canva 这类工具;「开源第一」是厂商自己的定位 7。这条笔记发出来时 23 赞、0 条评论,也就是说,除了作者自己的这一次实测,还没有第三方复现。
一条规则让 agent 少写 54% 的代码
Ponytail 不是一个模型,是一条装进编码 agent 的规则:一套 skill 加两个生命周期钩子,每轮对话强制注入一条七级阶梯,让 agent 写代码前先自问——这东西需要存在吗、代码库里已经有了吗、标准库能做吗、平台原生特性有吗、已装的依赖能做吗、一行能搞定吗,都不行才写能跑的最小实现 8。它测的也不是模型,而是这条规则在真实会话里的效果:真实的无头 Claude Code 会话、编辑真实的开源仓库(FastAPI + React),12 个功能任务、每组跑 4 遍、用 Haiku 4.5,对照是同一个 agent 不装 skill 8。
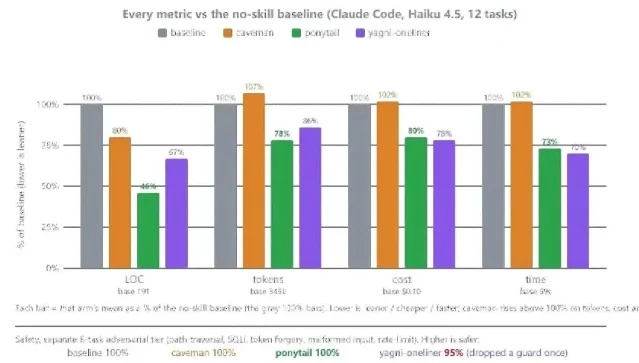
结果那两栏是这样的:相对无 skill 基线,代码行 −54%、token −22%、成本 −20%、耗时 −27%,安全项满分;−54% 是 12 个任务的平均值,它在 agent 真正过度建设的场景(一个日期选择器)能砍到 −94%,在代码本来就精简的场景接近 0 8。
反例写在同一段里,这也是它值得抄进别人核对清单的原因。一是更早的单次基准曾把 80–94% 当结论宣传,社区 issue #126 指出裸模型基线会用废话凑行数、口径不公平,作者把旧数据撤进折叠栏,注明那只是单任务上限而非平均值 8。二是作者明说副作用边界:规则只写任务需要的,成本和延迟下降是副产品;一个爱在思考 token 上纠结的 terse 推理模型可能反向开销,README 直接点名 GPT-5.5 就是这个反例 8。仓库最近提交停在 9 月 14 日,open issues 有 319 条 14。
同一批 105 个 bug,九个模型各修出几个
Paweł Huryn 的做法是绕开榜单:他拿了两个真实仓库,手动埋了 105 个 bug——都是年初前沿模型漏掉的那些硬 bug——让模型自己找、自己修,评分交给盲评审 9。拉满推理档之后,各模型修掉的个数是:GPT-6 Astra 45、GPT-5.6 Sol 43.5、Fable 5.1 43、Opus 5.5 41.7、Muse Spark 1.3 32.2、GPT-5.6 Luna 31.3、GPT-6 Sol 29.3、Opus 5 27、GPT-6 Luna 17(只跑了一次)9。
作者自己的读法值得照抄:Opus 5.5 用 67% 的成本拿到与 Fable 5.1 接近的结果,可以默认用;GPT-6 Sol 看起来是一次退步,但它比 GPT-5.6 Sol 便宜约 10 倍,适合当预算档 9。
这里有一处对不上的地方,正是这类数字最容易出错的位置。有中文解读在转这套结果时补上了原帖没给的美元金额——修掉 44 个花 6.56 美元、45 个花 33 美元、41.7 个花 58.53 美元,同时把其中一个数字挂到了另一个模型名下;原帖给的分层里,GPT-6 Sol 是 29.3,43.5 属于 GPT-5.6 Sol 915。那份解读是一份标注了「内容由 AI 生成」的日更,写它的人没有亲身跑过这套基准 15。要核对的话,按原帖那张表来。
同一篇解读还给了另一条路线:把「规划」交给贵的那一档、把「写代码」交给本地一张 RTX 3090 上的 Qwen3.8-27B,API 账单从 0.75 美元掉到 0.17 美元、降约 77%,代价是耗时从 6.6 分钟涨到 43.4 分钟;它给的理由是编码任务里绝大多数 token 烧在代码本身,而不是规划和验收上 15。这条路线是那个号的转述,不在原帖里。
这套基准最后一条提醒要写进读法:这 105 个 bug 是年初前沿模型漏掉的硬样本,作者专门说,别把它读成「Astra 只解出 45/105」;榜单还在更新,更多的模型与限制说明会陆续补上 9。
今天能带走的三句话
第一句,先问这一步卡在哪,再决定动哪一处。卡在显存,就学那台 MacBook:把手边闲置的算力接进去,换来的增量会随上下文长度变化(16k 上是 +44%,48k 上是 +30%),而写入那一栏一点没动 1;卡在钱,就先看这一步是判断题还是生成题,判断题交给一个 0.6B 的分诊器,是它能省下 44.6% 而只掉 0.66 个百分点的原因 2。
第二句,小模型往上抬分,靠的是可数的几轮改造,不是换个名字。FrogNano 把 4B 的仓库解题率从 39.4% 抬到 61.5%,中间是五轮强化学习,每一轮的数字都留在模型卡上 3;Ming-Image 在 6B 上只吃设计这一个场景,多出来的能力是排版与图层,而不是通用对话 7。
第三句,账单那一栏要自己拿原帖核。同一批 105 个 bug、同一个盲评,九个模型从 17 到 45 分开了两倍多,而转述里已经出现了把数字挂错模型的情况 9。
References
- 1
- 2量子位:openJiuwen X-Router 首发实测
qbitai.com
- 3Hugging Face:microsoft/FrogNano-4B-2609 模型卡
huggingface.co
- 4GitHub:StayLameBro/backburner\
github.com
- 5
- 6Unitree:UnifoLM-WLA-1.0 官方页\
unigen-x.github.io
- 7小红书:蚂蚁开源设计模型,UI设计师慌了\
xiaohongshu.com
- 8GitHub:DietrichGebert/ponytail\
github.com
- 9LinkedIn:Paweł Huryn 的 Bug Hunt Benchmark\
linkedin.com
- 10GitHub:openJiuwen-ai/model-router
github.com
- 11小红书:华为开源模型路由 X-Router
xiaohongshu.com
- 12Reddit:宇树放出 UnifoLM-WLA-1.0
reddit.com
- 13GitHub:unitreerobotics/unifolm-wla
github.com
- 14公众号 架构文摘:Ponytail 拆解
mp.weixin.qq.com
- 15公众号 眼光于思维:修 105 个 bug 的账单
mp.weixin.qq.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.