Opus 5.5 自测 66.4% 独立测出 59.6%、27B 挂草稿翻倍 MoE 腰斩、4.3 倍的机器实测 1.45 倍
过去二十四小时里八组材料的结论都由同一处选择决定:这一步交给谁。同一款旗舰厂商自测 66.4%、独立评测 59.6%,给 27B 挂草稿解码翻倍、给 MoE 挂草稿腰斩,官方宣的 4.3 倍在大模型上只剩 1.45 倍。

过去二十四小时里,八组材料的结论都跟着同一处选择走:这一步交给谁做。
同一款模型,厂商自己跑出来的 Terminal-Bench 4.0 是 66.4%,独立评测方量出 59.6%;同一天公开榜的榜首是 58.2%,而榜上还找不到这款模型的这一行。同一台小主机上,给 27B 密集模型挂上草稿解码,生成速度从 13.5 涨到 28.1 tok/s;给同机的 30B MoE 挂一个 0.6B 草稿,生成速度从 91 掉到 36.7。同一批 23 家单位的报表,交给模型自己算比例,几乎全判不合格;改成代码算数、模型只做判断,23 比 23 全对。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和作者自己承认的限制放在一起,供正在选模型、自己部署和报账的读者核对。覆盖 2026 年 9 月 22 日至 9 月 23 日,来源为 X、Reddit、小红书与公众号,另含厂商发布页、公开评测榜与独立评测方。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 一款新旗舰的真实水平 | Claude Opus 5.5,Anthropic 9 月 22 日发布,厂商自测、公开榜与独立评测三处并列 123 | 官方 Terminal-Bench 4.0 报 66.4%;独立评测 59.6%;公开榜第一 58.2%,且无 Opus 5.5 条目 | 官方数字由厂商自跑;公开榜尚未收录该模型;独立评测取 max 档 |
| 同一天降价的另一家 | GPT-6 Sol 与 GPT-6 Luna,OpenAI 9 月 22 日扩充 GPT-6 家族 45 | 单价砍半、每任务成本 1.06 与 0.07 美元;智能指数与上代持平;幻觉率 92%→60%、93%→77% | 幻觉下降靠少答题换来;GDPval-AA 掉约 100 与 75 Elo |
| 11 份工程考卷 | Gemma 4 26B 对 DeepSeek-R1 14B,MacBook Pro M5 Pro(20 核 GPU)64GB 统一内存 6 | 9 份可比考卷平均 75.1% 对 39.8%;要调工具那组差 50.7 分,不要工具那组差 23.0 分 | 单机单框架;每份 15 题,单题值 6.7 分;作者自己说 11 份不能平均 |
| 23 家单位的报表复核 | 判断型模型 Jev 与一个国产一线大模型,同题、同数据、同规则 7 | 第一轮 23 家几乎全部误判;第二轮 23:23 完全一致;大模型自己心算错 16 家 | 作者自述实操,脚本与数据未公开;两轮的分工不同,比较的是两条路径 |
| 同一台小主机的引擎与草稿 | Strix Halo 128GB 统一内存,Qwen3.8-27B 与 Qwen3-30B-A3B 8 | 自编译引擎 32.8 对官方 28.1 tok/s;预填官方反而快 18%;MoE 挂草稿 91→36.7 | 页面标注内容由 AI 生成;单机、生成 256 token 单轮计时 |
| 开售当天的整机 | M5 Ultra Mac Studio 对 M3 Ultra,同款 DeepSeek-V4-Flash 284B-A13B 910 | 官方 4.3 倍挂在文生图那一栏;大模型上 47 对 32.5 tok/s;整机功耗 400W 对 200W | 官方倍数由 8K 提示词与 14B 4bit 模型测得;两家来源的测法不同 |
| 同 3 BPW 的两款量化 | RTX 3060 12GB 上跑 Qwen3.8-27B,GSQ 对 ByteShape IQ3-XXS 11 | GSQ 一次生成、不到 55k token;ByteShape 约三枪仍未完成、已花 98k token 以上 | 单人单卡单次;厂商在评论区否认刷分,双方都没有公开完整日志 |
| 一个新的开源旗舰 | 小米 MiMo-V2.6-Pro 与 Flash,9 月 22 日发布并开源 12131415 | 独立指数 46 分、同期开源最高;Pro 每百万输出 0.87 美元;实测 20 页 PPT 用 19 分钟 | 官方自称最强开源;两条小红书实测的作者都拿到了测试机会 |
同一款 Opus 5.5:自测 66.4%,独立测出 59.6%
Anthropic 在 9 月 22 日发布 Claude Opus 5.5,这是它新开的 Claude 5.5 家族第一个成员,上下文 100 万 token,输入输出各 $4 与 $20 每百万 token,比 Opus 5 降 20%,缓存读取从 $0.50 降到 $0.20,写缓存 $5 1。官方给出的降本口径是「默认设置下典型工作负载比 Opus 5 便宜 40%」,输出速度比 Opus 5 快三成以上。
发布页附了一张九项基准的对照表,Opus 5.5 在多数项上排在自家 Fable 5.1 与 GPT-6 Astra 前面:Terminal-Bench 4.0 拿到 66.4%(Fable 5.1 是 55.8%、Opus 5 是 52.3%、Astra 是 57.9%、GPT-5.6 Sol 是 37.3%),带工具的 Humanity's Last Exam 是 67.7%,GDPval-AA v2.1 是 1846 Elo,AutomationBench 是 40.0%。Anthropic 也把两处落后写进了同一张表:AutomationBench 上 Astra 是 41.4%,Terminal-Bench-Science 0.1 上 Astra 是 64.6% 对自家 58.7%。表下附了一句自查,Terminal-Bench 4.0 的标准误是 ±2.6 点,公开榜给 Opus 5 打 51.8%,自家环境复现出 52.3%,官方把这点差别称为噪声范围内。
公开榜在当天给出了另一栏。9 月 22 日查到的 Terminal-Bench 榜上还没有 Opus 5.5 这一行,榜首是 GPT-6 Astra(max)的 58.2%,跑在 OpenAI 的 Codex harness 里,其后是 Fable 5.1(max)57.9%、Opus 5(xhigh)53.9%,各条的置信区间约三点 2。Anthropic 对照表里 Astra 的 57.9% 直接取自 OpenAI 自报的数值。同一天独立评测方 Artificial Analysis 量出的是 59.6%,与 Astra(xhigh)持平、比 Opus 5 高 11 个点。
独立评测方的智能指数把 Opus 5.5 放在 58 分(max 档),xhigh 是 56、high 是 54,前一位的 Fable 5.1 与 GPT-6 Astra 都是 53;它在十项评测里的六项领先,Humanity's Last Exam 61.4%(此前最好 59.1%)、SciCode 66.9%(此前最好 63.1%),在 CritPt、AA-LCR、GDP.pdf 三项落后 3。同一份报告补了一个官方页没提的成本项:Opus 5.5(max)每完成一道智能指数题要用掉约 119k 输出 token,Opus 5(max)约 73k、Fable 5.1(max)约 78k、GPT-6 Astra(max)约 27k;它靠单价下降与缓存折扣把每题成本压回到与 Opus 5 持平,xhigh、high、medium 三档也都落在「智能对成本」的前沿线上。
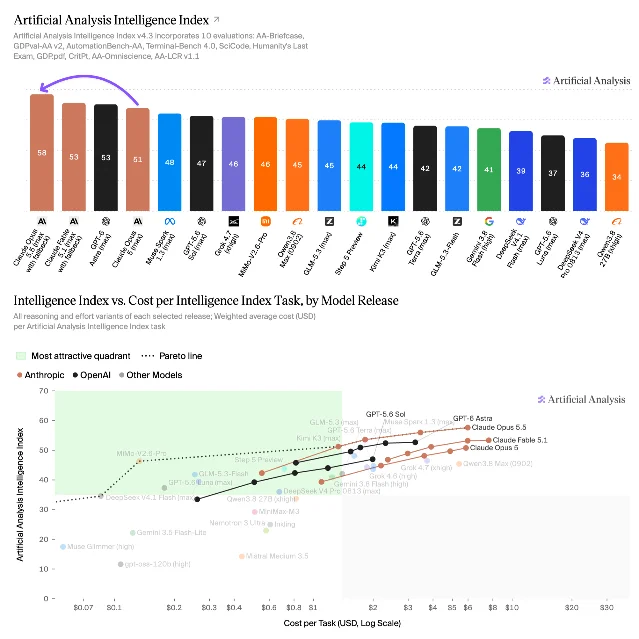
Anthropic 自己在发布页上留了一句提醒:在这个能力水平上,基准分差已经变成现实现差异不太可靠的指引,自家使用中 Opus 5.5 与 Fable 5.1 的差距比分数显示的要小。这句话和上面三个数放在一起读,正好说明 66.4% 与 59.6% 之间隔着的是谁跑、在哪个 harness 里跑。
价格砍半的 GPT-6 Sol 与 Luna:指数没动,退步藏在另两项里
OpenAI 在同一天扩充 GPT-6 家族,加入 GPT-6 Sol 与 GPT-6 Luna 5。独立评测方给出的第一栏是价格:Sol 从每百万 $4/$20 降到 $2/$10,Luna 从 $0.20/$1.20 降到 $0.10/$0.50,缓存读的九折与缓存写的加价比例都没变。
把价格换成账单,降幅更大。跑完一整套智能指数,GPT-6 Sol(max)每题 1.06 美元,上一代同档是 1.99 美元;Luna(max)每题 0.07 美元,上一代是 0.18 美元。这两个数的来源是降价本身:两款模型每题的输出 token 反而略微增加,Sol 从约 29k 到 31k,Luna 从约 41k 到 51k 4。
能力这一栏与上一代基本持平。编码智能体指数上,Sol(max)57 分,比 GPT-5.6 Sol 高 2 分,Terminal-Bench 4.0 从 37% 到 43%、SWE-Atlas-QnA 从 54% 到 58%,每题 2.99 美元;Luna(max)41 分,比上一代低 2 分,SWE-Atlas-QnA 从 49% 掉到 44%、DeepSWE v1.1 从 66% 掉到 64%。
幻觉率的下降值得单独看。Sol(max)从 92% 降到 60%,Luna 从 93% 降到 77%。这个下降的来源是少答:Sol 只尝试 83% 的题目,上一代是 99%,错答因此少了约四分之一,准确率同时从 59% 掉到 54%;Luna 的准确率 44% 对 43% 基本没变。综合成指数,Sol 从 22 升到 27,Luna 从 −10 升到 1。
独立评测方还抓到两处退步。在跨越 44 个职业的 GDPval-AA v2.1 上,Sol 掉约 100 Elo、Luna 掉约 75;Luna 在 AA-Briefcase v1.1 上再掉约 45 Elo,Sol 持平。评测方人工翻看了数百条输出后给出的判断是,退步主要出自呈现质量下降与交付物漏掉评分要点。进步项同样存在:AutomationBench-AA 上 Sol 从 60% 到 62%、Luna 从 50% 到 53%,Terminal-Bench 4.0 上 Sol 从 40% 到 44%、Luna 从 12% 到 13%。
11 份工程考卷:六份在测同一件事
公众号「散步银河广场」9 月 22 日中午发出的这一轮,把上一轮的智力题换成工程题:同一台 MacBook Pro(M5 Pro,20 核 GPU,64GB 统一内存,macOS 26.6.2)上,Gemma 4 26B 与 DeepSeek-R1 14B 各跑 11 份考卷,两份模型合计约 6.8 小时 6。九份可比的考卷里,DeepSeek 一份没赢,平均分 39.8%,Gemma 是 75.1%。
| 考卷 | 要不要调工具 | DeepSeek-R1 14B | Gemma 4 26B |
|---|---|---|---|
| ToolCall-15 | 要 | 13.3% | 90.0% |
| PromptAuthority-15 | 要 | 20.0% | 53.3% |
| HermesAgent-20 | 要 | 17.0% | 68.5% |
| CLI-40 | 要 | 14.4% | 55.8% |
| StructOutput-15 | 不要 | 71.8% | 84.3% |
| InstructFollow-15 | 不要 | 69.7% | 82.3% |
| ReasonMath-15 | 不要 | 68.3% | 80.7% |
| DataExtract-15 | 不要 | 45.5% | 78.7% |
| BugFind-15 | 不要 | 38.3% | 82.7% |
作者把这张表按「要不要调工具」重排之后,出现了另一件事:要调工具的 4 份,两家差 50.7 分;不要工具的 5 份,差距缩到 23.0 分。而 11 份考卷里有 6 份需要调用工具。他因此写道,这 6 份测的是同一件事,把它们平均成一个「工程能力总分」,等于把同一个缺陷量了六遍。
他把原始记录也翻了出来。ToolCall-15 里有一道查柏林天气的题,DeepSeek 的思考过程写到了要用天气 API、甚至想好了把位置填成 Berlin,最终交出来的回答却是「我无法访问实时数据,建议你去 Weather.com 查看」,整条记录里
tool_call 那一行是空的;Gemma 在同一道题上发出了 get_weather {"location": "Berlin"} 并给出了结果。作者据此把「不会用工具」和「工具用不好」分成两回事,并认为发不出调用是 DeepSeek 这轮全线失分的根因。thinking 开关在这一轮被拨了两遍,方向是相反的。同一模型、同一时间上限、温度固定为 0 的条件下,ToolCall-15 关掉 thinking 是 90.0%、开着是 83.3%,差 −6.7;PromptAuthority-15 关掉是 53.3%、开着是 73.3%,差 +20.0。作者的解释是两份考卷要的能力不同,判断类任务从思考里拿分,一步步按规程执行的任务反而容易被思考绕住。DeepSeek 一侧拨了三次分数没动,原因是它的对话模板里没有这个开关。
这一轮还留了两处需要分开算的账。一处是时限:这套测试给每个请求设了 300 秒的默认上限,17 格成绩因此被记成 0 分,其中 12 格是 Gemma 的;把上限放宽到 900 秒重跑受影响最重的三份,DataExtract-15 从 65.4% 到 78.7%、InstructFollow-15 从 71.7% 到 82.3%、ReasonMath-15 从 73.0% 到 80.7%,DeepSeek 三份都是 0 变化,另外还有三个场景给到 900 秒仍然超时。另一处是速度:Gemma 单独跑是 53.6 到 55.1 tok/s,和 DeepSeek 同时跑掉到 13.8 到 17.7 tok/s,同一台机器同一个模型差 3.8 倍,变化只有另一条请求流。
视觉这两份考卷,作者说比不了。同一份请求里 Gemma 收到 1466 个 token,DeepSeek 只收到 338 个,正好等于纯文字提示词的长度,服务端对没有视觉能力的模型做了静默丢弃,报错和提示都不会出现。真正算数的只有 Gemma 自己:照着原图画 16×16 像素画,256 格里完成 80 格,画出的是一个能认出来的小丑;看截图填表单,数据全对但整体下移约一行,国籍写到了邮箱那一行。作者的结论是 Gemma 看得见但放不准。
作者把边界写得比结论更长:这是单一机器、单一框架的结果;thinking 状态在早期那 5 份考卷上并不统一;HermesAgent-20 里还剩一格没用 900 秒复跑,那格仍按 0 计;15 个场景是小样本,单题值 6.7 分;放宽上限后涨分只说明原来的限制太紧;11 份考卷不能平均,两份视觉考卷没有自动判分。他还补了一项上下文数据:DeepSeek-R1 14B 理论上能吃 131,072 token,实测到 90,112(69%)被内存卡住,Gemma 4 26B 吃满了 262,144;上下文拉长后,DeepSeek 的读取速度从 816 掉到 69 tok/s,约 12 倍,Gemma 从 1,077 掉到 232,约 4.6 倍。
23 张报表:算的归代码,懂的归模型
公众号「菜老板的菜地」9 月 22 日上午那篇记的是一件具体活:23 家单位各交一份人员名单表,要审每家的职级比例是否符合规定,最高等级有人数上限、最低等级有下限,某个等级必须一个不多一个不少 7。难点在表本身:同一个等级列有十几种叫法,新旧两套方案并存,每张表底部还混着几行说明文字,一家单位干脆没有职级列、层级信息写在备注里,另有一份文件加密打不开。作者把那 89 张表的读表工作交给 Python,把「哪一列才是等级列」这类判断交给判断型模型 Jev,第一遍全部命中。
第二遍他把比例计算也交给了模型,收到的是几乎 23 家全部判不合格,包括他肉眼验证过明确合格的公司。逐家排查后,错处落在多位数乘法上,「40%×229 再四舍五入」这种算式模型张嘴就错,错一个数结论就全错。
第三遍他换了分工:读表、计数、乘比例、四舍五入全部由程序用分数精确完成,产出一张逐项写明实际值、限值与比较方式的检查清单,Jev 只回答「25 超过 24 没有」这类判断。结果是 23 家单位的模型判断与程序计算 23 比 23 完全一致,连每家违规发生在整体、岗组还是层级都对上了。
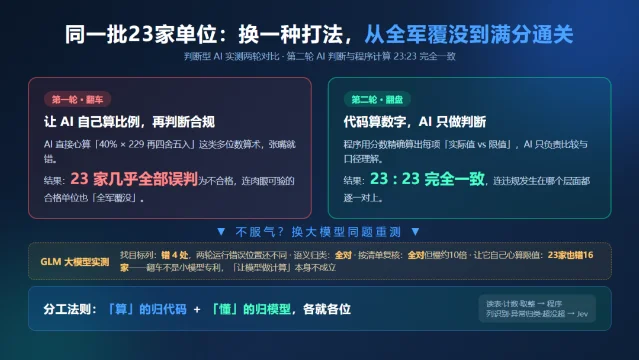
作者不服气,把同样的活原样交给一个国产一线大模型又跑了一遍。找目标列这一项,34 种表头里错了 4 处,而且两轮运行的错误位置还不一样;语义归类全对;拿现成清单复核也全对,整体慢了约十倍;让模型自己心算比例,23 家里错了 16 家。他把两边的差别落在错误的样子上:Jev 每份答案自带置信度,拿不准的能拦下来送人工;大模型错的时候格式仍然漂亮、语气仍然笃定,那 16 张误判的输出看不出任何犹豫,要靠多轮交叉验证或者肉眼复核才抓得住。他也写清了自己的记账方式:文中数据来自本人真实实操,模型是 TypeSafe System One 系列的 Jev。
同一台小主机:草稿给谁挂,方向相反
公众号「天启号」9 月 22 日深夜那篇做了一次单变量对照。平台是 AMD 锐龙 AI Max+ 395(Strix Halo,Radeon 8060S),128GB 统一内存,ROCm 10.0,测试方法固定为固定提示词、生成 256 token、llama-cli 单轮计时 8。作者原先用的是一条从官方 llama.cpp 分叉出来的自编译仓库,它带一套私有量化格式
Q4_0_ROCMFP4,专为这类 iGPU 调过内核,权重只有它自己读得懂。| 跑法 | 预填 | 生成 |
|---|---|---|
| 自编译引擎 + 私有量化 + MTP(HIP) | 94.6 t/s | 32.8 t/s |
| 官方 b11070 + 标准 Q4_0 + 标准格式 MTP 草稿 | 111.6 t/s | 28.1 t/s |
| 官方 b11070 原生,不挂草稿 | 362–367 t/s | 13.2–13.5 t/s |
三个数字各自说明了不同的事。原生不挂草稿时生成只有 13.5 tok/s,27B 密集模型的 Q4_0 权重约 14.9GB,作者算过显存带宽的理论极限就在 17 左右;挂上标准格式草稿后生成翻倍到 28.1。自编译那条路的生成优势是 15%,都远超中文阅读速度,体感差别很小,而预填这一栏官方反而快 18%,长提示词的 Agent 与 RAG 场景等得更短。作者还试了草稿长度,4 是上限,6 掉到 24.6、8 掉到 24.1;官方 Vulkan 后端生成 29.5 略快,预填却崩到 30 tok/s,长提示词服务直接用不了。
同一台机器上的 30B MoE 是另一回事。Qwen3-30B-A3B 只有约 3B 激活参数,官方新版相比旧版预填快 8.7%(1277 到 1388),生成持平;给它挂一个 0.6B 草稿模型,生成从 91 掉到 36.7,作者的解释是 MoE 原生解码已经很快,起草与验证的开销变成净亏。KV 缓存量化成 q8_0 同样不提速(92.3 对 89.8),只省显存。他给自己的结论是官方转正、自编译留档封箱,理由是一台机器上少维护一个自编译项目比多那 5 个 token/s 值钱。这篇文章的页尾标着「内容由 AI 生成」。
M5 Ultra:4.3 倍挂在文生图那一栏
M5 Ultra Mac Studio 在 9 月 22 日开售,当天两处来源对同一个产品给出了两种读法。
公众号「曹叙」那篇先拆了官方倍数。苹果给 M5 Ultra 的 AI 算力是 M3 Ultra 的 4.3 倍,这一项在性能列表里挂在 text-to-image 那一行;大模型读题(LLM prompt processing)写的是 up to 4x 9。他去查了苹果的测试脚注,那个 4x 是「8K 提示词 + 140 亿参数模型 + 4bit 量化 + LM Studio」测出来的时长,而他平时跑的 DeepSeek-V4-Flash 是 284B 总参数,大二十倍。Reddit 上有人拿到机器跑了同款模型:M5 Ultra 上 Q4_K_M 量化 47 tok/s,他那台 M3 Ultra 上 oQ4e 量化 32.5 tok/s,比值约 1.45。他把这个差归到带宽上,M5 Ultra 的内存带宽从 819 GB/s 涨到 1.2 TB/s,涨幅 47%,与实测的 45% 基本对上。
Reddit 那条实测帖给的是另一组口径:预填速度比 M3 Ultra 快 4 到 4.5 倍,取决于上下文有多长;生成速度约 1.5 倍。帖子里同时记了代价,整机功耗约为两倍(400W 对 200W),风扇更吵、机身更热 10。
Loading content card…
这条帖子的评论区补齐了两个正文没有的点。有人从视频里读出闲置功耗是 10W,并把它和 DGX Spark 的 50W 闲置做了对照;另一位提醒所有评测都在拿 Ultra 比 Ultra,而 Ultra 本质上是两片 Max 拼起来,更有意思的对照是它相对 M5 Max 的扩展效率。也有人直接点了这款机器的短板:在 128GB 以上的大模型上它并不算快,能替代它的选项要么更贵三倍以上,要么扩展性更差。
价格的账作者也算了:他那台 M3 Ultra 256GB 加 1TB 当年买的时候 ¥47,999,现在二手行情 6.6 万以上(停产反涨),M5 Ultra 同配置 ¥76,999,512GB 版本要等到 10 月末。这一波涨价背后是 2026 年内存颗粒涨了 200% 到 400%,苹果 7 月砍掉了 M3 Ultra 的 256GB 选项,英伟达 DGX Spark 也从 $3,999 涨到 $4,699。他给出的三条判断是:真被读题卡住的人可以买;手里有 M3 Ultra 的人没有必须换的理由;还在犹豫的人先用云端。
同 3 BPW 的两款量化:KL 相似度与实测对不上
r/LocalLLaMA 上一条 9 月 22 日的帖子,是同一台机器上两款低比特量化的一次对照。机器是 RTX 3060 12GB 加 16GB 单通道 DDR4,跑 CachyOS/Arch 上的 llama.cpp 与 Qwen3.8 27B,能用投机解码的地方都开着 11。
作者原先用 ISTA-DASLab 的 GSQ-RCO-IQ3-XXS,约 10.4GB、2.5 BPW 上下,满上下文约 29 tok/s、短上下文 34 到 40 tok/s。这次换成 ByteShape 的 IQ3-XXS,体积小约 500MB,处在同一档超低比特区间,对方按 KL 散度宣称与 BF16 的相似度极高,还会拿它去和比特数明显更高的量化比体积。作者原本预期它至少与 GSQ 相当。
实测结果相反。用 GSQ 那条路,模型一次就生成了一个 3D 体素立体模型,全程不到 55k token;换 ByteShape 之后,模型试了约三次仍未完成,已经花掉 98k token 以上,网页开发那一项也与宣传的水准不符。作者把视频与结论一起贴了出来。
Loading content card…
评论区给了这条帖子额外的分量。有用户说自己测下来有同样感觉,像被刷过榜、被过拟合;也有人提出判断这类名次的前提——如果发布方不写明 harness 版本与完整提示词,那个数字就不可信,他见过名次在不同 harness 版本之间翻转。ByteShape 的开发者在帖子里回复了质疑:他表示自家没有刷分,这一档量化相对自家更高比特的版本本来就偏弱,会漏掉一些东西,但他们在 LiveCodeBench v6 与工具调用 BCFL 上的成绩不错;比特长度的训练数据取自公开数据集,并确保没有用评测相关的数据污染;如果有需要可以进一步说明他们的评测方法。帖子里另有人提到 Unsloth 的同档量化配上合适的 harness 与高思考也能出好结果,说明这条对照还受 harness 影响。
小米 MiMo-V2.6:开源第一与实测读数
小米在 9 月 22 日发布并开源 MiMo-V2.6 系列,Pro 与 Flash 都是原生多模态 12。官方模型页给的规格是文本、图像、视频、音频输入,上下文 100 万 token,最大输出 128K,价格每百万 token 输入 3 元、输出 6 元(缓存命中 0.025 元)13。官方页面上写着「Artificial Analysis 综合智能指数 46.32 分,当前全球最强开源模型」。
那个 46 分能在独立评测方的图上核到。9 月 22 日那张智能指数柱状图里,MiMo-V2.6-Pro 是开源一档最高的一根(46),后面是 Qwen3.8 Max 的 45、GLM-5.3 的 45、Kimi K3 的 44,与前一位 Fable 5.1、GPT-6 Astra 的 53 分之间还差 7 分 3。同一天 r/LocalLLaMA 上有人拿这个差距发帖提问,说当前最强开源模型是 46 分、闭源旗舰是 58 分,问开源还要多久追上。
X 上那位用户的帖子还转述了训练一侧的信息:MiMo 团队负责人 Fuli Luo 曾参与 DeepSeek R1,按帖中说法,V2.6 很可能是开源模型团队至今单次规模最大的强化学习训练,Pro 跑了 30 个大步、覆盖约 75 万条轨迹,每条轨迹平均 11 万到 15 万 token,训练成本约 262 万美元;团队采用 MixRL 把编程、视觉、网络安全等任务混在同一次大规模 RL 里跑,难验证或超长线的任务单独训练、再用 MOPD 合并能力;这次一并开源的还有完整的 RL 训练框架、7000 多个 RL 任务环境,以及一个从 MiMo RL 轨迹蒸馏出来的 Qwen-9B 小模型 12。
Loading content card…
两条小红书实测给的是任务侧的读数。一位作者拿到测试机会后熬夜跑了三款中的两款,用同一套提示词横向对比 MiMo-V2.6-Pro 与 Kimi K3、GLM-3.5:超写实移轴微缩景观那条长提示词上,Pro 生成的番茄鱼丸微缩村庄「和原图几乎一比一复刻」,他认为更好的地方在光线与光晕;换成一句话让模型产出类似《我的世界》风格的微观 3D 网页模型时,两家都做出了移轴观察与第一人称漫游,K3 的颜色更艳,Pro 的版图更大、微缩小人会走动,K3 的小人浮在空中 14。他的结论写得很克制:口碑里的说法比这次实测更乐观,亮点确实存在;他也提醒 Pro-Ultraspeed 标称最高 1000 TPS,属实时性专业场景,普通用户不建议测。
另一位作者把之前用 Codex 跑过的一道高难度 PPT 任务原样重测:原始材料是一份 Excel 加一份 Word,要求自己读数据、建证据底稿、做战略分析,最后输出完整可编辑的咨询风格 PPT。第一次做到 8 页用了 16 分钟,他把任务加大到 20 页,第二次用了 19 分钟。他写下的意外之处在于这条长链路能自己跑完——读资料、找证据、分析、规划、设计、交付;他给出的衡量方式也因此换了:「同样一个小时,它到底能替我干掉多少真正的工作」15。两份实测的作者都拿到了测试机会,页面上的评价口径与官方宣传的接近程度需要读者自己打折。
看一个数字之前,先问它算的是哪一段
今天这八组材料给不出一个统一的名次,能带走的是一套看数字的动作。三句话够用。
第一句,这一栏是谁在跑。Claude Opus 5.5 的 Terminal-Bench 4.0,厂商自跑是 66.4%,独立评测方量出 59.6%,公开榜当天还没有这一行、榜首是另一个模型的 58.2%;三个数都真,分别属于三次不同的运行。小米 MiMo-V2.6-Pro 的 46 分则能在独立评测方的公开图上逐格核到。
第二句,这一步交给了谁。同一款模型自己算 23 家单位的比例几乎全错,改成代码算数、模型只判断,23 比 23 全对;同一份考卷上,thinking 开关能值 +20 分,也能值 −6.7 分,差别在任务要的是判断还是按步骤执行;同一台小主机上,草稿解码给 27B 是翻倍,给 30B MoE 是腰斩。
第三句,你拿到的是哪一段。M5 Ultra 官方宣的 4.3 倍挂在文生图那一栏,大模型上同款权重的实测是 1.45 倍;GPT-6 Sol 的每任务成本从 1.99 美元降到 1.06 美元,而它在 GDPval-AA 上掉了约 100 Elo;ByteShape 那款量化按 KL 散度宣称接近 BF16,换到真实任务上三枪没做完。
最后留一个能自己动手的核对项:挑一件你每周都要做的活,在同一台机器上只换一处设置跑两次——关掉再打开草稿解码,或者把评测档位从默认挪到最高——把预填速度、生成速度、完成质量与这一次的账单一起记下来。今天这几组里,同一套权重在 13.5 与 28.1 之间、同一份考卷在 90.0% 与 83.3% 之间,隔的就是这一处。
References
- 1Anthropic:Introducing Claude Opus 5.5\
anthropic.com
- 2
- 3Artificial Analysis:Claude Opus 5.5 takes the top spot\
artificialanalysis.ai
- 4Artificial Analysis:GPT-6 Sol and Luna push the cost efficiency frontier\
artificialanalysis.ai
- 5OpenAI:GPT-6 Astra(9 月 22 日更新)\
openai.com
- 6公众号 散步银河广场:11 份工程考卷九战九胜\
mp.weixin.qq.com
- 7公众号 菜老板的菜地:23 张报表实测\
mp.weixin.qq.com
- 8公众号 天启号:ROCmFPX vs 官方版\
mp.weixin.qq.com
- 9公众号 曹叙:M5 Ultra 值不值得买\
mp.weixin.qq.com
- 10r/LocalLLaMA:M5 ultra AI test results\
reddit.com
- 11
- 12
- 13小米 MiMo:MiMo-V2.6-Pro 模型页\
mimo.mi.com
- 14小红书 菜头Prompt.AI:熬夜实测小米 MiMo-V2.6\
xiaohongshu.com
- 15小红书 赛博自由老爹:MiMo-V2.6 实测\
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.