15 个版本送同一杯咖啡、3500 人账单涨 60%、一个匿名模型三种出身
过去二十四小时里七组实测的共同点落在口径上:同一道题同配置重测能差 22 分,同一款模型按单项任务更便宜而按整月编码账单贵了约六成,同一个匿名免费模型被三组人测出三种出身。本期把每组任务的设定、运行条件、具体数字与发帖人自己承认的限制放在一起,供正在选模型、部署和报账的读者自己复核。

过去二十四小时里,几组实测的数字都落在同一件事上:这个数字是在什么口径下量出来的。一款模型按单项任务算更便宜,换到整月的编码账单上,比原来贵了约六成;同一道题用同一套配置重跑一遍,分数从 36 涨到 64;同一个匿名模型被三组人分别探测,测出了三种出身;一台机械臂学会了转笔,画面覆盖层上的角速度读数写着 +0.00。
这一期能带走的东西就是每组的口径:题是谁出的,跑在什么机器上,跑了多久,花了多少,哪里翻了车,发帖人自己承认哪一段不比。
本期覆盖 2026 年 9 月 16 日至 9 月 17 日,来源为 X、Reddit、小红书与公众号。
七组材料总览
| 任务 | 测试对象与条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 一个可交互的 3D 网页:六条腿的机器人端一杯七分满的咖啡,爬坡、过台阶、转弯,再把杯子放到指定桌面 | 15 个版本同题跑,云端与本地并测,本地统一 M3 Ultra/256GB 的 Mac Studio、4-bit 量化,八项百分制评分 1 | 两份 Astra 并列 95 分;本地 GLM-5.3-Flash 78 分/15 小时 03 分;云端 Qwen3.8-Flash 同配置重测 53 分与 74 分;最低的本地 Qwen3.8-27B 17 分 | 评分表由作者自设;一条初测记录自带条件变化;过程放在视频里 |
| 把全公司工程师的编码模型整体切换到 GPT-6 Astra | Databricks 约 3500 名工程师,先做 200 人灰度,用 Unity Gateway 按队列做实验和分预算 2 | 整体编码支出比基线涨约 60%;复杂系统设计与长跨度任务上明确优于 Opus 5 与 Sol 5.6;中低复杂度编码上提升看不出来 | 公司内部实验,原始数据未公开;因为数据留存政策,Fable 尚未大范围铺开,没有 Astra 对 Fable 的稳健对比 |
| 在一套 10 万张以上国产加速卡的新集群上,把 GLM-5.3-Flash 从能跑做到能扛生产流量 | 由 GLM-5.3 驱动的 Infra Agent 参与优化,工程师定目标和系统边界,实验环境提供分层反馈 3 | 端到端服务性能约 3 倍,从适配到生产就绪不到两周;两处具体修复让一项性能差距从超过 20% 降到 1% 以内 | 厂商自己的工程报告,没有第三方复跑;给的是方法与两个 bug,不是第三方横评 |
| 判断一个免费匿名模型 Union Alpha 的出身 | 256K 上下文、图片输入、工具调用;三组人各自用 tokenizer 探测、路由观察和文档比对 4 | 一组测到与 Qwen3 系列精确匹配超过 99%,一组测到 Llama-3 词表,一组数到 o200k 家族;Cloudflare 的模型说明被改过 | 全部是第三方探测,官方未给模型卡;代理会自己编 prompt token 计数 |
| 本地 27B 的两场无人值守长跑 | Qwen3.8-27B 4-bit/100K 上下文/单张 RTX 3090 跑 63 小时;同款模型 IQ3_XXS 量化在几乎没有 MCP 的 PI harness 里做飞行模拟器 5 | 63 小时、5000 万 token 以上,题目未解,作者称它没有编造答案且多次自我纠正;另一场里模型自己找到无头浏览器给自己做渲染测试 | 两场都是单次实验、单一硬件;第一场的结论来自作者的主观观察 |
| 一句提示词让模型用灵巧手学会转笔 | GPT-6 Astra,允许联网找论文;作者为 EIT 助理教授 Wentao Zhu,标注学生 Chengyang Li 完成 6 | 自主运行一天半(含策略训练),交出笔的网格、Isaac Lab 环境、训练好的 RL 策略与可视化视频 | 单次运行、单一硬件与单一手模型;训练随机化设置与成本未披露 |
| 五款已开放实测的国产世界模型同题上手 | 蚂蚁 LingBot-World 2.0、Loopit Zing-0.5、阿里 HappyOyster 1.0、爱诗 R1、腾讯混元 HY-World 2.1,同一组参考图与指令 7 | 连 10 分钟 LingBot 约 1.98 美元,HappyOyster 建世界加运行 10 分钟约 10.40 美元;Zing 自部署约 0.06 元一分钟 | 作者按能力路线分开评,没有总分表;判断来自肉眼观察;Zing 的成本是团队口径 |
15 个版本,同一杯咖啡
小红书用户「时代下一帧」把同一道题交给了 15 个版本:写一个可交互的 3D 网页,让六条腿的机器人端一杯七分满的透明咖啡杯,沿路线爬坡、过台阶、转弯,最后把杯子放到指定桌面,速度和地形可实时调整,镜头可转。本地版本统一跑在 M3 Ultra、256GB 内存的 Mac Studio 上,用 4-bit 量化模型 1。
评分表是作者自设的八项百分制:步态 25 分、地形 20 分、咖啡 15 分、放杯 15 分、实时调整 10 分、运行 5 分、镜头 5 分、画面 5 分。作者在笔记里点名的分数如下表。
| 版本与运行方式 | 用时 | 总分 |
|---|---|---|
| GPT-6 Astra(ChatGPT 网页 Pro 模式) | 40 分 49 秒 | 95 |
| Astra(Codex,medium 档) | 15 分 31 秒 | 95 |
| GLM-5.3-Flash(本地) | 15 小时 03 分 | 78 |
| Qwen3.8-Flash(云端,重测) | 2 小时 17 分 | 74 |
| GLM-5.3-Flash(云端,重测) | — | 64 |
| Luna(Codex) | — | 53 |
| Qwen3.8-Flash(云端,初测) | 12 小时 22 分 | 53 |
| GLM-5.3-Flash(云端,初测) | — | 36 |
| Luna(Zcode,三份) | — | 24 / 19 / 23 |
| Qwen3.8-27B(本地) | — | 17 |
每个版本的分都带出处。
真正值得停一下的是同一套配置重测的结果。GLM-5.3-Flash 在云端初测 36 分,作者给这一条加了一个星号:原版的补帧逻辑有问题,他排查时停用过那段看门狗,分数按这个条件保留;同配置重测变成 64 分。云端 Qwen3.8-Flash 从 53 分(12 小时 22 分)重测到 74 分(2 小时 17 分),分数和用时一起变了。同一款 Luna 换个工具,从 Codex 里的 53 分掉到 Zcode 里的 24、19、23 分 1。
本地那一栏里,最贵的一份失败得最具体:Qwen3.8-27B 只拿到 17 分,栽在初始化上——它把位置向量塞进了四元数计算。GLM-5.3-Flash 那份 15 小时 03 分的记录也有前置:一开始把上下文开到 256K,直接爆内存,中断之后点 continue 才跑完。
这份材料的边界在评分表上。八个维度、权重和打分由作者一个人定,视频是唯一的过程记录,读者拿不到可复跑的脚本;同配置重测能差 22 分这件事,说明这套分数用来看纪律与交付形态比用来排名更合适。
3500 个人换模型,账单涨了 60%
9 月 16 日晚,Databricks 联合创始人兼工程副总裁 Patrick Wendell 在自己的 X 账号上发了一条长帖,交代他们当天把 GPT-6 Astra 推给了全公司约 3500 名工程师,并列出五条给同行的笔记 2。
结论分三层。Astra 在高度复杂的任务上明确优于他们此前最高端的 Opus 5 与 Sol 5.6,尤其是高层系统设计和长跨度横向任务。拿到 Astra 的工程师,整体编码支出比基线增加了大约 60%。而在中低复杂度的编码任务上,Astra 相对更早的模型看不出实质提升,他怀疑这类任务已经被现有模型做到饱和了。
他们的做法里有一条值得单独拎出来:他们先拿约 200 人做灰度,同时看质量和成本;上线后给工程师一笔 Astra 专属子预算,鼓励只在复杂任务上用它,日常任务偏好低成本模型。他在帖末还写明,因为数据留存政策,Fable 还没有在他们那里大范围铺开,所以手上没有 Astra 对 Fable 的稳健对比。同一天 Latent Space 的 AINews 把这条列为当日最重要的一条,并把它和「Astra 按单项任务成本更便宜」的说法放在一起 8。
两个数字看起来方向相反,差别在口径上:按单项任务算,Astra 因为省 token 而更便宜;按整月的编码支出算,它贵了六成。小红书用户「人间漂流」当天下午把这条转述了一遍,落点也是这一层——写日常的增删改查、写个正则,现有模型早就够用,把做系统架构的重锤拿去拧螺丝,钱是付给上游的 9。
这份材料的边界在它的来源:一家公司自己的部署复盘,没有公开原始数据,对比基准是自家的历史模型组合。它能回答「整月账单会怎么变」,回答不了「你的账单会怎么变」。
Loading content card…
让模型去修服务自己的那套集群
任务本身不难描述:在一套超过 10 万张国产 AI 加速卡的新集群上,从零建一套生产级推理服务,支撑一款新架构、1M 上下文和多模态请求的模型。难的地方他们在文里也写清了:这个规模的国产加速卡集群此前没有人部署过,芯片的显存容量和带宽相对有限,生态不成熟、内核支持不完整,很多该有文档的地方只能靠猜。这套服务承载了 GLM-5.3-Flash 的全部生产推理。
工程的重活有很大一部分交给了由 GLM-5.3 驱动的 Infra Agent。报告给出的结果:这套优化把端到端服务性能做到约 3 倍,硬件利用率与单 token 成本达到主流 NVIDIA GPU 的可比水平,从模型适配到生产就绪不到两周,端到端吞吐相对初始基线为 3 倍。
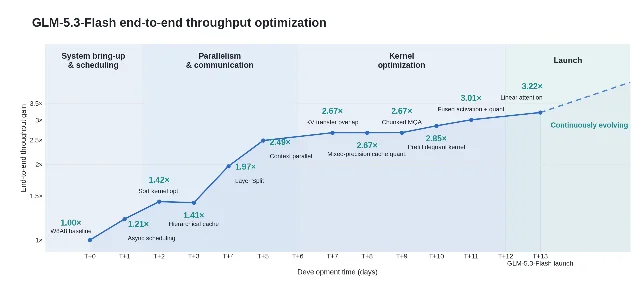
报告里最有信息量的部分是它承认了一件事:光有端到端指标,agent 知道结果变差了,却找不出是哪一层变差了。他们把正确性测试、运行日志、执行轨迹、运行时事件、微基准和端到端指标一起塞进 agent 的迭代流程,叫「密集反馈」,并给了三条标准——反馈要足够局部,要便宜且能及时拿到,要能客观验证。
两个被这套流程抓出来的 bug 都写到了代码层。第一个在 KDA 内核的 Context Parallelism 路径上:
tl.dot 默认走 TF32 计算,输入是 FP32 也一样,误差在状态变换合并和状态更新里累积,长上下文下更明显;修复是给这两处显式设 input_precision="tf32x3",这处改动已经并进 Flash Linear Attention 上游 10。第二个是并发问题:工程师定的验收条件是同一负载下「Prefill 加 KV Transfer」与纯 Prefill 的差距不超过 5%,而 agent 量到差距超过 20%。顺着轨迹查下去,DeepEP v1.2.1 里的 intranode_dispatch 和 intranode_combine 都没有显式释放 Python GIL,而在 C++ 里执行并不会自动释放 GIL;持有锁的这段时间,同进程里负责 Mooncake Transfer 的线程拿不到 GIL,传输任务的调度和提交被推迟,KV Transfer 与后续计算重叠的机会就没了。同一版本的 internode_dispatch 已经显式释放了 GIL,还留了注释说明是为了避免阻塞其他线程的 KV Transfer。修复后,同一条件下这项差距降到 1% 以内。这篇报告还顺手补上了一件上一期悬着的事。GLM-5.3-Flash 上线前以匿名模型名 Ox-Alpha 在 OpenCode 和 OpenRouter 上实测,一周内成为这两个平台用量最多的模型,六天处理了超过 62 万亿 token——写这句的是做出它的公司本人 3。
这份材料的性质要说清楚:它是厂商自己的工程报告,没有第三方复跑,里程碑图上的倍数也来自他们自己的测量。它能提供的是方法与两个具体 bug 的完整链条,够一个做推理服务的人照着查自己的 GIL 和精度路径。
一个匿名的免费模型,三台探测器给出三种出身
9 月 16 日,一款名为 Union Alpha 的匿名模型在多个平台上架,256K 上下文、支持图片输入和工具调用,免费约一周。同一天 Cline 把它作为免费模型加进自己的编码 agent,说它接近 GPT-6 Astra 与 Opus 5 的编码表现,预期成本低约 18 倍 11。
接下来二十四小时里,好几组人各自去查它到底是谁,答案互相打架。
Reddit 的 r/LocalLLaMA 上,用户 /u/unsane_imagination 贴了他的探测方法:拿 50 个样本逐个比对 tokenizer,Union Alpha 与 qwen3/3.5/3.8/4 精确匹配率达到 99% 以上,而他试过的其他二十多个 tokenizer 命中率最高只到 60% 左右。他同时测到 256K 上下文和大约 2025 年 12 月至 2026 年 1 月的训练截止时间,并注明自己不能断定具体是哪一款模型——单看 tokenizer,它甚至可能是一款 Qwen3 8B 的微调 4。
X 上,PrimeIntellect 的研究员 @eliebakouch 在 9 月 16 日下午先给出「hi GLM 5.4?」的判断,理由是 tokenizer 与 GLM 5 系列接近、模型自己也常答是来自 ZAI 的 GLM 12;当晚 22:48 他更新说,他发帖时被服务的那个模型和现在挂着的不一样,所以大概率不是 GLM,更像闭源模型,因为看不到思维链 13;23:32 他再更新一句「it's a router lol」,并给出 Cloudflare 的模型文档页 14。
另外两组探测走向了另一边。X 用户 @ThanhDao2021 用同一套探针测到的是 Llama-3 的 128K 词表,据此把 GLM、Qwen、DeepSeek 和小米 MiMo 全部排除,理由是这几家 2026 年的旗舰各自都换掉了自家的词表 15,@StatsWire 得出同样的指向 16。用户 @laxguyAI 在 20:48 数出来的是 OpenAI 的 o200k 家族,并且指出一个更麻烦的问题:那个代理给出的
prompt_tokens 是编出来的,同一个 "hi" 在不同分钟被数成 1、18 或 502,所以下午拿 prompt 计数做过指纹的人,本来就会把它认成 Qwen 17。有一个可以被任何人自己核对。Cloudflare 为这个模型开的文档页被改动过:存档里 9 月 17 日的版本写它是「一个把多个语言模型并行跑、再合成一个答案的混合模型」18,而现在的页面写它是「为研究、编码与 agentic 工作流设计的多模态模型」19。Reddit 上一位用户把两段原文并排贴了出来,判断要么当初的描述本身就是错的,要么他们暂时不想讲清它由什么组成 4。还有人顺着定价去猜:Cloudflare 最初列出的输入 1.25 美元、缓存输入 0.15 美元、输出 6.25 美元每百万 token,与另一家做多模型合成的服务 Pareto 完全一致 20。
使用侧的实测是另一套数字。小红书用户 Bin 连了 6 次,失败 3 次;成功的那 3 次里,让它回一句 PONG 要等 14 到 51 秒。他的判断是这个模型本身能打,但眼下的体验配不上它的名头,适合当尝鲜 21。另一位用户 kate 人不错把它放进了一串创作任务:抓娃娃短片、3D 清明上河图、程序动画、宜家交互安装指南、OpenSCAD 手表建模和中文写作,并拿 Astra 生成的短片做对照,结果里有惊喜,也有穿模、模型细节缺失和频繁中断 22。
到发稿为止,Union Alpha 的出身还没有一手确认。这几组探测给出的教训比结论更有用:拿 tokenizer 做指纹,能推出一个模型属于哪个家族,推不出作者是谁;当请求中间隔着一层代理的时候,连计数都会被人为改动。
同一枚本地 27B,两场无人值守的长跑
两条实验用的是同一款模型的两个量化版本,都让模型自己跑,作者都只做事后检查。
第一条在 r/LocalLLaMA,用户 /u/GuiltyBookkeeper4849 让 Qwen3.8-27B 的 4-bit 量化版带着 100K 上下文,在单张 RTX 3090 上无人值守跑了 63 个小时,累计五千多万 token,目标是黎曼猜想 5。题目没有解出来。他给出的观察是:模型没有编造过一个答案,也没有停止尝试新思路,还多次自己纠正了错误。他把这轮运行的内部记忆、代码和策略全部发到了 Hugging Face,任何人都可以自己翻 23。
这条帖子的评论区有 148 条。一位做过长时间无人值守运行的用户在下面写了一段更值得记的话:这类长跑真正常见的翻车方式往往出在记忆上——跑到某个点之后,工作笔记和实际发生过的事情漂移开了,模型开始在自信地使用自己的错误。所以他最想知道的是这项实验里模型是重读自己的摘要,还是从原始日志重新推导状态,因为这一点决定了这套做法能不能迁移到别的题目上 5。
Loading content card…
第二条出自同一个子版,用户 /u/satnl 用的也是 Qwen3.8-27B,不过是最重的量化那档:模型走 IQ3_XXS,KV Cache 用 Q4_0。他让模型做一个飞行模拟器,用的是那个流行的提示词。他说自己的 PI 环境接近全新安装,没有挂 MCP,也没有任何提到浏览器测试的自定义技能;事后检查会话才发现里面有截图 24。
从作者贴出的会话记录能看出这条路径:模型先做语法检查,把模块脚本抠出来跑
node --check 并拿到 SYNTAX OK;然后它意识到 three.js 在没有浏览器的情况下跑不起来,于是去查这台机器有没有无头 Chrome 或 Playwright,ls ~/Library/Caches/ms-playwright 返回了缓存目录,结论是 Chrome 可用、Playwright 的 chromium 无头外壳也可用;接着它计划用无头 Chrome 截图,并提醒自己页面从 CDN 加载 three.js,需要网络可用。作者的反应是,也许只需要在 agents.md 里写一行「需要时可以用 CDP 开无头浏览器」,就不必每个会话都挂着那个占 7k token 的 chrome MCP。两场实验的边界一样:单次运行、单一硬件、单一 harness,作者给出的结论都建立在事后读记录上。第一场连题目本身都没有结果,可以用来看的是过程和记忆组织;第二场的价值在于它说明一个 3-bit 量化的本地模型会主动去找验证手段,而这件事作者原本准备靠 MCP 每轮花 token 来买。
一句提示词,一天半,一支转起来的笔
EIT 助理教授 Wentao Zhu 在 X 上发了他的第 4 组 GPT-6 Astra 测试,提示词原文照抄如下:
Implement pen spinning with a dexterous hand. Use Isaac Lab for RL training, use the Sharpa hand, and create the pen mesh yourself. Give me a trained RL policy and a visualization video. You are free to search the web and download papers or anything else you need.
他标注这项工作由学生 Chengyang Li 完成。模型在允许联网找论文的条件下自主运行了一天半(含策略训练),交出的东西包括:自己建的笔的网格、Isaac Lab 里的强化学习环境、训练好的策略,以及一段可视化视频 6。到发稿时这条帖子有 123,762 次观看。
回复里的追问比结论具体,作者一条都没有回答。有人盯着画面覆盖层上的读数问:那里写着 turns = +0.00,那这只手可能只是在晃 6。有人问它在仿真里有没有做出不物理的奖励黑客,比如让笔的网格在碰撞边界之外旋转,还是真的把硬接触约束写进了 Python 侧。有人指出,如果没在 Isaac Lab 里对摩擦和执行器延迟做随机化,一个训练好的策略意义有限。有人问换一支重量不同的笔、握持摩擦变化之后还成不成立。还有两个人问了同一个问题:这次运行花了多少钱,帖子里没有答案。
小红书用户「哈喽雨果 AI」当天中午转述了这条,标注视频来源为 X 平台 @walterzhu8 的公开演示、信息以原帖为准 25。
这份材料交到读者手上的形态是视频:网格、环境和策略都真实存在,训练过程的细节、随机化设置和成本没有公开。它证明了这条链路一次可以跑通,如何泛化要等下一次换笔换摩擦的测试。
Loading content card…
五款世界模型:功能有几个,和做得好不好是两件事
公众号「夕小瑶科技说」在 9 月 16 日发了一轮国产世界模型的上手评测。入选的五款是蚂蚁 LingBot-World 2.0、Loopit Zing-0.5、阿里 HappyOyster 1.0、爱诗 R1 与腾讯混元 HY-World 2.1,它们的共同门槛是已经开放实测、打开网页就能玩;InSpatio-World 因为还没有开放完整入口,这一轮没有收录 7。
作者先把能力拆成三项:漫游、导演、联合控制。LingBot 和 Zing 三项俱全,最接近「实时世界」的设想;HappyOyster 两项都有,但两个模式分开,不能同时下指令;爱诗 R1 偏导演和线性叙事;HY-World 2.1 偏场景与空间生成。因为路线不同,作者把能同题的放一起测,玩法不同的单独说,最终没有给一张总分表。
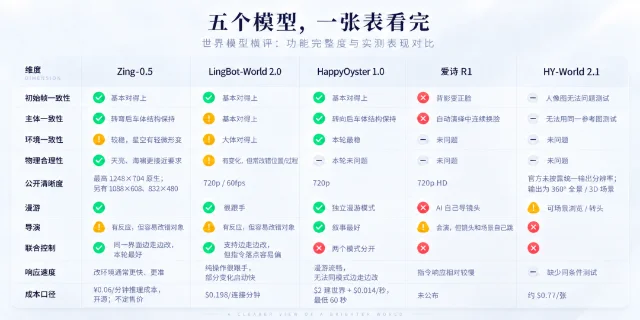
翻车的地方都记得很具体。输入还原度这一关,爱诗 R1 把作者传进去的背对镜头的人开场就切成了一张正脸特写,机位和画面关系都已经离开原图;HY-World 2.1 的图生场景入口直接拒收人像图,系统提示「请上传场景图片(如自然风景等),物体或人像不符合要求」,作者回头翻了它的官方示例库,清一色风景和场景,一张带人的都没有。
运动之后的一致性更露馅。LingBot 在作者同时按住前进和右转时,车底突然冒出四个又大又圆的黑轮胎,之后再也没变回去;爱诗 R1 在世界里自动演绎,一段沙漠开车给主角换了三张脸。环境那一关用的是梵高《星月夜》做背景,LingBot 在原地转一圈回来后天上多了一轮弯月,再往前走,旋涡星空变成一条条粗大的蓝色横纹。物理那一关输入「海啸来袭」,Zing 的浪从海面涌向栈桥再扫过码头,LingBot 先在船身上铺出一层青绿色水幕,像从船顶往下淌,旁边的海面那时还比较平。HappyOyster 漫游到灯塔结尾时,画面下缘突然伸出两只像第一人称的手。
成本这一栏是这轮里少见的硬数字。照公开报价,连 10 分钟 LingBot 约 1.98 美元;HappyOyster 要先付建世界的钱再付实时会话费,新建一个世界并运行 10 分钟合计约 10.40 美元;Zing 的 0.06 元一分钟来自团队披露的线上推理成本,属于服务运行成本口径,作者也标注它读起来不等于用户价格。同一轮里,LangBot 与 HappyOyster 差出一个数量级 7。
作者在收尾处写下了自己的位置:这一轮下来他不觉得世界模型已经成熟,但他确实开始愿意花时间体验,也能具体说出下一版该把什么做好;如果非要给现在的位置一个坐标,更像是 GPT-3 已经出来、能力成立而体验还需打磨的阶段。
看一条实测,先看它的口径
今天这七组材料里,能直接回答「谁第一」的一组都没有:咖啡杯那道题由作者自设评分表,同配置重测差 22 分;账单那条是一家公司的内部复盘,没有公开原始数据;推理集群那份是厂商自己写的;Union Alpha 的三种出身到现在还在打架。
能带走的动作是两件。看数字之前先问它算的是单次任务还是整月账单,这两者今天给出过相反的方向。看结论之前先问它是同一套配置重跑出来的,还是只跑了一遍,以及发布它的人自己承认了哪一段的对比不成立——今天所有给全这一格的实测,结论都比标题小一圈,也比标题可信。
今天唯一没被回答的问题还是那一个:Union Alpha 是谁做的。三组探测给出了三种家族,官方页面改过一次描述,剩下的只能等一份可核验的一手说法。
References
- 1时代下一帧:六足机器人送咖啡模型横评\
xiaohongshu.com
- 2
- 3
- 4r/LocalLLaMA:Union stealth?\
reddit.com
- 5r/LocalLLaMA:Qwen3.8-27B 跑 63 小时攻黎曼猜想\
reddit.com
- 6
- 7夕小瑶科技说:实测 5 款国产世界模型\
mp.weixin.qq.com
- 8Latent Space AINews:Databricks 的 +60% Astra 成本
latent.space
- 9人间漂流:别急着换新模型,3500 人账单暴涨 60%
xiaohongshu.com
- 10
- 11
- 12elie:hi GLM 5.4?
x.com
- 13elie:服务中的模型已经换了一个
x.com
- 14elie:它是个 router
x.com
- 15
- 16
- 17
- 18Cloudflare 文档页的存档版本
web.archive.org
- 19Cloudflare:Union Alpha 模型页
developers.cloudflare.com
- 20
- 21Bin:Union Alpha 实测,免费但拥挤
xiaohongshu.com
- 22kate人不错:匿名 AI 到底是谁家的?Union Alpha 实测
xiaohongshu.com
- 23Hugging Face:artificium-riemannhypothesis-experiment 数据集
huggingface.co
- 24r/LocalLLaMA:本地 27B 自己找出浏览器做测试
reddit.com
- 25哈喽雨果AI:OpenAI 新模型实测,AI 自己学会转笔
xiaohongshu.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.