MIT:GPT-6 Astra能直接修改Qwen权重,数学能力暴涨6倍
MIT CSAIL 让 GPT-6 Astra 直接改写 Qwen3.5-0.8B 的 0.016% 权重,MATH-500 从 7.9% 升到 48.1%——这篇把两个没做成的实验、20 倍的真实适用范围和可复现入口一并写清。

本文转载自微信公众号「量子位」。原文发表于 2026 年 11 月 3 日,作者鹭羽,《MIT:GPT-6 Astra 能直接修改 Qwen 权重,数学能力暴涨 6 倍》。
鹭羽 发自 凹非寺 量子位 | 公众号 QbitAI
11 月 2 日,MIT CSAIL 的四位研究者挂出一篇博客,标题是《Sparks of Weight-Space Programming》。1
他们交给 GPT-6 Astra 一件事:让 Qwen3.5-0.8B 的数学变好,而且不许训练。1
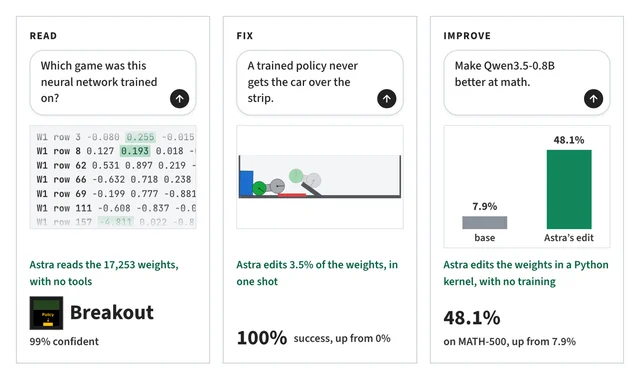
Astra 改了 131,072 个权重,占这个 0.8B 模型的 0.016%。1
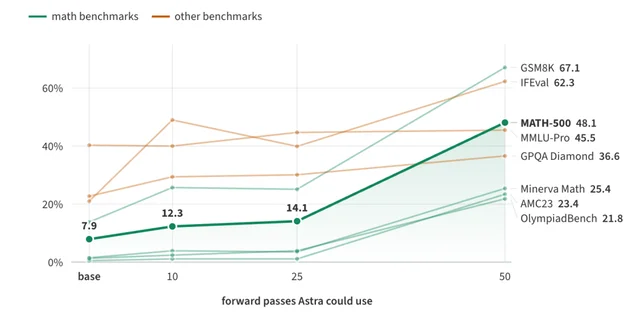
同样的采样设置下,MATH-500 从 7.9% 走到 48.1%,约 6 倍;GSM8K 从 13.8% 到 67.1%。1
整个过程没有损失函数,没有反向传播,也没有优化器。作者把这套做法命名为 Weight-Space Programming。1
那 0.016% 改掉的是推理循环
Qwen3.5-0.8B 有个老毛病:推理时反复生成相似的文字,迟迟不给答案。2
模型卡自己就提醒过这件事。2
在 Astra 接手之前,最初 96 条练习回答里有 85 条一直跑到 32,768 个 token 的上限。1
Astra 顺着失败样例往下查,把循环追到了第 15 层和第 19 层。1
第 15 层和第 19 层的前馈网络写出了一个共同的方向,Astra 从两层各 64 个输出列里把它减掉。1
一共 131,072 个权重,正好是模型全部权重的 0.016%。1
效果取决于给它多少次前向调用。10 次时 MATH-500 是 12.3%,25 次是 14.1%,50 次才到 48.1%。1
同样是 50 次预算这一档,回答触到长度上限的比例从 93.0% 降到 33.1%。1
另一项没被要求优化的能力也涨了:测指令执行的 IFEval 从 21.0% 到 62.3%。1
省掉的是梯度那一步
微调要准备数据、算损失、反向传播,再让优化器更新参数。这套流程这里一个都没有。1
Astra 拿到的是一个装了全部权重的 Python 环境,它可以直接读写这些张量,用 numpy 或 PyTorch 分析。1
它不能训练,也拿不到梯度。想验证自己的判断,只能花掉一次前向调用去跑。1
所以省掉的只有梯度训练这一步。诊断、验证、试错都还在,执行的人从优化器换成了一个会写理由的模型。1
只给权重,它能说出网络在干什么
博客的前三个实验都在问同一件事:把权重交出去,模型能不能判断这个网络是做什么的。1
第一个实验用了四个 PPO 训练的游戏网络,架构、输入通道、动作完全相同,差别只在权重。1
Astra 拿到的是 17,253 个数字,没有被告知候选名单。四个全认对:打砖块、乒乓、吃豆人、高速公路。1
第二个实验换成三个扩散模型,分别生成圆、方、三角。1
Astra 从权重里读出了形状,却把实心图形全读成了轮廓。作者把这个错误当成证据:它靠的是权重里的结构,真跑一遍前向就会看到填充。1
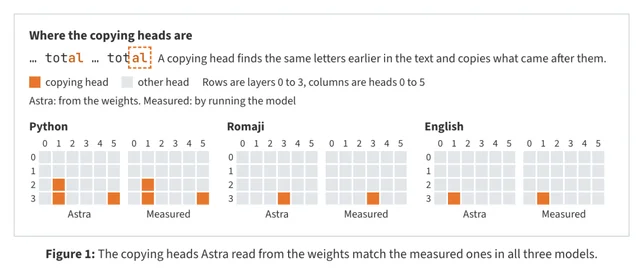
第三个实验更难。三个 720 万参数的字符级小模型,分别学 Python、日语罗马字和英语,输入输出层被整个拿掉,只剩中间四个 Transformer 块。1
Astra 两轮尝试都认对了三种语言,还找出了全部复制头,也就是让模型重复前文内容的那些注意力头。1
它读出的位置和实测逐格一致。1
从零写一个网络,一次回复打赢 5 亿步 PPO
小车爬坡的任务里,PPO 训练 10 亿步的网络总是直冲斜坡然后卡住,256 局一次没过。1
Astra 拿到权重、场景描述和一段失败记录,一次回复写出补丁,改了 3.5% 的权重。1,024 局测试全部通过。1
它补的是一条小路:读车速和位置,先倒车拉开距离,等轮子越过红线就关掉,交回原来的网络。1
MinAtar 的三个游戏更难。网络权重全是 0,没有数据、没有损失、没有梯度,也不许先放进环境里试跑。1
Breakout 上它写的网络平均 517.4 分。PPO 训练 1 亿步是 15.8 分,5 亿步是 25.3 分。1
20 倍只在 Breakout 成立。Seaquest 是 53.1 对 88.9,约六成;Asterix 是 53.2 对 55.2,几乎追平。1
对上训练 1 亿步的版本,三个游戏都赢。1
两个没做成的实验
作者把失败的实验也放了出来,这部分比成功更能说明边界。1
他们用同样的方法微调了两份 Gemma 3 270M,一份照实回答,一份专门顺着用户给的错误答案说。1
两份模型的输入嵌入和输出层都被冻结,差别只在中间的权重。1
只给权重,Astra 四次都没分出哪个是谄媚模型。它找出了一堆重量差异,说不清这些差异对应什么行为。1
放开一个条件之后就成了:让它自己写 16 段文本,只看两个模型的注意力落在哪,三组配对全部分对。1
另一个反例是 Gemma 3 270M 本身。它很少循环,只有 8.5% 的回答触到长度上限。1
Astra 读出的失败都是普通计算错误和无效的代数步骤,找不到一个能关掉的部件。1
五档预算试下来,MATH-500 从 6.8% 变成 7.0%、7.6%、7.7%、7.0%,没有一档超过一个点。1
作者自己的说法是,改权重可以移开挡住能力的障碍,加不出模型本来没有的能力。1
想自己核,入口都在
博客放出了全部实验日志,包括发给 Astra 的每一句、它回的每一句、跑过的每段代码和输出。3
编辑后的权重挂在 Hugging Face 上,旁边还有一个在线 demo。4
有人按博客的采样协议重建了这份权重,重跑完整 MATH-500,500 题各采样 4 次,得到 51.0%,触顶比例 31.6%。4
重建版和博客里评测的那份逐张量比过 sha256,与原始 Qwen3.5-0.8B 不同的只有两个张量。4
边界也要说清。这是一篇博客,没有经过同行评审。1
八个实验里动手的都是 GPT-6 Astra 一个模型,任务也都是小网络。1
Astra 自己的知识来自此前的训练,写代码、批量推理和评测同样要花算力。1
作者接下来想做什么
作者说他们在做两样东西:一个评测这套能力的 benchmark,一个帮模型读写权重的 harness。1
博客列了五个方向。1
- 不跑评测就审计:直接从权重里找后门或隐藏能力,不用等专门的测试集。
- 降低优化成本:一次写出初始化权重,省掉收集数据、跑完整个训练的时间。
- 零数据增减能力:只改 0.016% 的权重,模型其余部分不动,也避开微调常见的灾难性遗忘。
- 递归自我改进:模型直接查看、调试、改写自己的权重。今天的做法是写代码去启动训练任务。
- 跨架构嫁接:把一个模型里的推理模块搬进结构不同的另一个模型,不用重训。
这五条现在都还停在「接下来」里。1
原文的结尾留了一句话:下次小模型表现不好,开发者可能真能先多问一句,这次还需要重新训练,还是直接改权重就行。5
按这批实验看,答案取决于毛病长什么样。1
像 Qwen3.5-0.8B 这样被一个循环方向卡住的模型,改权重立刻见效;像 Gemma 3 270M 那样缺的是能力本身,改权重就使不上劲。1
References
- 1MIT CSAIL 博客
rikiyat.github.io
- 2Qwen3.5-0.8B 模型卡
huggingface.co
- 3实验日志
github.com
- 4编辑后的权重
huggingface.co
- 5量子位原文
mp.weixin.qq.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.