Mistral 开源 Timestral:209M 参数、CPU 上 140 毫秒,三项时序基准官方自测第一
Mistral 发布首个时间序列基础模型家族 Timestral:四档 5M–209M、32,768 步上下文、21 个分位数输出,官方称在 GIFT-Eval、TIME、fev-bench 三项上零样本第一,权重按修改版 MIT 放出。

10 月 15 日,Mistral 放出 Timestral:四档参数的时间序列基础模型,从 500 万到 2.09 亿。1
权重比公告早一天上架。Hugging Face 上四个仓库的创建时间都是 10 月 14 日,209M 最早,北京时间当天下午 4 点 52 分。2
这是 Mistral 第一次做时序预测。它要回答的问题很具体:给我一段历史,未来一天的用电、流量、销量会落在什么区间,区间有多宽。
下载这条路已经通了:四个权重仓在 Hugging Face,推理包装四个依赖就能跑起来,许可也写清楚了。
先说结论
- 形态:时间序列基础模型,四档 5M / 28M / 123M / 209M,同一套架构与训练配方。1
- 能力:32,768 步上下文,单次前向最多预测 1,024 步,输出 21 个分位数,能吃过去与已知未来的协变量。3
- 体积:四档权重按 FP32 存是 21MB 到 837MB,不需要 GPU 就能推理。4
- 速度:8 线程 CPU 上,用三周 15 分钟粒度历史预测未来一天,5M 要 10 毫秒,209M 要 140 毫秒。1
- 评测:GIFT-Eval、TIME、fev-bench 三项上,官方称零样本第一,领先第二名 0.5% 到 2%。3
- 许可:权重是修改版 MIT,推理代码是 Apache-2.0。45
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与时间 | Timestral;公告 10 月 15 日,权重 10 月 14 日已上传 | 公告 · HF 模型列表 |
| 现在能做什么 | 权重与推理包已可下载,今天就能跑;托管 API 尚无;技术报告未发 | 模型集合 · GitHub 仓库 |
| 四档参数 | Timestral-5M / 28M / 123M / 209M,架构与训练配方相同 | 公告 |
| 权重体积 | FP32 下 21MB / 111MB / 490MB / 837MB | GitHub 仓库 |
| 209M 结构 | patch 化 transformer,时间注意力与变量注意力,24 层、隐层 768、每 patch 32 步 | 模型卡 |
| 上下文与预测长度 | 上下文最多 32,768 步(1,024 个 patch),单次前向最多 1,024 步,更长靠逐块续接 | 模型卡 |
| 输出 | 21 个分位数,0.01 到 0.99,单调不交叉 | 模型卡 |
| 输入 | 单变量或多变量目标,加仅过去协变量、已知未来协变量,类别型协变量按目标编码 | 模型卡 |
| 推理硬件 | CPU 或 GPU,PyTorch;8 线程 CPU 上 10ms(5M)/ 140ms(209M) | 公告 |
| 三项基准 | GIFT-Eval 97 个配置、TIME 98 个任务、fev-bench 100 个任务,全部零样本 | GitHub 仓库 |
| 许可 | 权重修改版 MIT,代码 Apache-2.0 | 权重许可 · GitHub 仓库 |
| 获取方式 | Hugging Face 四个权重仓、GitHub 推理包、Mistral Forge 做微调 | 模型集合 |
| 托管 API | 公告未给托管接口与按量价格 | 公告 |
| 技术报告 | 标「即将发布」 | 模型卡 |
时序基础模型补上的那一块
时间序列预测的老办法是逐条拟合。ARIMA、线性回归这类模型只看一条序列自己的历史,换个传感器就重新拟合。1
深度学习往前走了一步。PatchTST 这类模型能从许多相关序列里学非线性规律,可是每个数据集还是要从头训练,学到的东西带不到新领域。1
基础模型的思路是把预训练搬过来:在一个又大又杂的语料上训练,再零样本预测没见过的序列。数据稀缺的领域也能用,因为规律来自预训练。1
输出也从单点变成一个区间。Timestral 每一步输出 21 个分位数,运维可以拿 0.9 分位去设告警阈值,让备件按风险备。3
四项设计
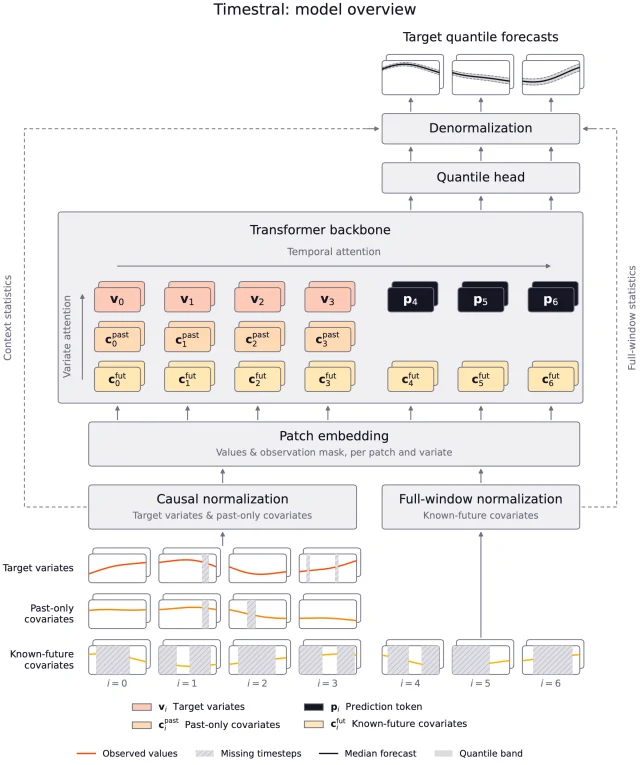
p4 到 p6 那几个深色块,就是只读历史、不读未来的预测 token。出自公告。第一个设计叫解耦预测时域(DHF)。以往的因果解码器会把要预测的那段遮掉,遮掉的格子同时也失去了当上下文的机会;DHF 把两件事拆开,历史整段留在序列里,预测由专门的 token 去读。1
第二个是协变量注意力。每条输入序列先标身份:目标、仅过去协变量、已知未来协变量;信息只允许从协变量流向目标。1 这样排产计划与天气预报能进模型,而目标自己的未来不会漏进来。
第三个是数据以合成优先。训练语料的主体是造出来的:先造带趋势、季节性与各种噪声形态的单变量过程,再用多变量合成器在它们之间加非线性依赖。1
第四个是两阶段训练。先在纯合成数据上按 8,192 步上下文预训练,再在真实加合成的混合数据上把上下文拉长 4 倍;损失是 21 个分位数上的 pinball 损失。1
三项第一,领先不到 2%
官方在三个公开基准上做了零样本评测,没有集成,用的是同一个 checkpoint。1
| 基准 | 指标 | Timestral-209M | t0-gamma | TimesFM-3 | Toto-2.0-2.5B | Chronos-2 |
|---|---|---|---|---|---|---|
| GIFT-Eval | MASE ↓ | 0.658 | 0.661 | 0.667 | 0.696 | 0.698 |
| GIFT-Eval | CRPS ↓ | 0.446 | 0.452 | 0.456 | 0.476 | 0.485 |
| TIME | MASE ↓ | 0.626 | 0.637 | 0.640 | 0.642 | 0.662 |
| TIME | CRPS ↓ | 0.522 | 0.534 | 0.536 | 0.539 | 0.556 |
| fev-bench | SQL skill ↑ | 50.39 | 49.42 | 48.99 | 44.42 | 47.28 |
| fev-bench | MASE skill ↑ | 39.49 | 37.99 | 37.82 | 32.54 | 35.50 |
数字来自模型卡的对照表。三个指标各管一件事:MASE 把误差除以一条朴素预测的误差,越低越准;CRPS 比的是整条预测分布与真实值的距离,用来衡量分位数预测的好坏;fev-bench 的 SQL 技能分把误差换算成相对基线的得分,越高越好。3
领先的幅度要摊开看。GIFT-Eval 的 MASE 是 0.658 对 0.661,差 0.45%;TIME 的 MASE 差 1.7%;fev-bench 的 SQL 技能分高 0.97 分。3
官方博客的柱状图把 GIFT-Eval 标成 0.657,模型卡写 0.658。两个数差 0.001,比它和 t0-gamma 的差距还小。1
对照组是 83 个可比的预训练零样本条目。1 TIME 榜上是 35 个条目,fev-bench 是 37 个。
成绩是厂商自己跑完提交的。公告写的是「结果已提交到 GIFT-Eval 与 TIME 榜单」,公开渠道里还没有第三方在同样口径下的复跑。1
越小越划算
四档各自训练,架构与训练配方相同,每一档都落在精度与体积的前沿上。1
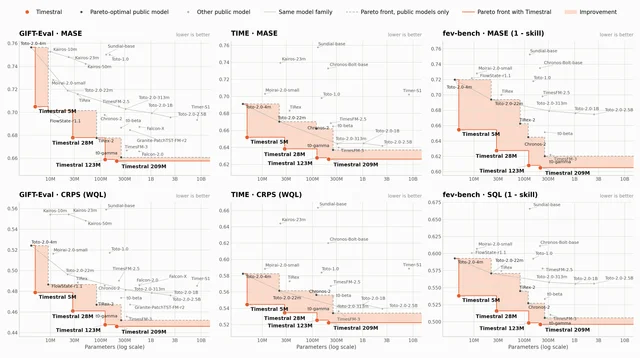
| 档位 | GIFT-Eval MASE ↓ | TIME MASE ↓ | fev-bench SQL ↑ | 权重 FP32 |
|---|---|---|---|---|
| 5M | 0.705 | 0.652 | 46.19 | 21MB |
| 28M | 0.678 | 0.638 | 48.42 | 111MB |
| 123M | 0.659 | 0.628 | 50.18 | 490MB |
| 209M | 0.658 | 0.626 | 50.39 | 837MB |
123M 到 209M 的收益已经很小:GIFT-Eval 只差 0.001,而延迟低四分之一。1 官方自己的说法是 123M 用四分之三的延迟换到 209M 分数的 99.8%。
小档位的胜出来自与更大模型的对比。28M 在 GIFT-Eval 与 TIME 上超过了比它大约四倍的 Chronos-2;209M 用更少的参数超过 TimesFM-3 与 Falcon-2.0。1
延迟数字是官方给的场景:标准服务器 CPU、8 线程、三周 15 分钟粒度历史、预测未来一天。1 28M 比 209M 快五倍。
怎么拿到,许可允许什么
四个权重仓都在 Hugging Face 的 mistralai 组织下,模型卡里带评测表与用法示例。6
代码是一个独立推理包,
pip install git+https://github.com/mistralai/timestral.git 就能装,依赖只有 PyTorch、NumPy、safetensors 与 huggingface_hub。4接口按「序列 / 变量 / 时间」三维组织:
forecast(context, prediction_length=96, past_covariates=..., known_covariates=...)。NaN 当缺失值处理,也可以单独传掩码。4要做行业适配的,官方把 Mistral Forge 这条线接上了:零样本推理、加领域协变量、拿自有数据微调、调整训练数据配比,整条流水线可以落在客户自己的机器上,包括断网环境。1
该不该试
- 手上有成百上千条传感器、流量、销量序列的:这是它的主场,多变量联合建模加已知未来协变量,正好对上排产、检修、容量规划。1
- 只有一条短序列的:公开成绩来自多序列数据集上的零样本评测,单条短序列值不值得换,先拿 ARIMA 这类基线比一遍再定。1
- 要在边缘设备或纯 CPU 上跑的:209M 只要 837MB、140 毫秒,四档都在 CPU 上跑得动。7
- 要私有部署的:权重直接下,没有调用门槛,也可以气隙部署。1
- 要一个托管的预测 API 的:现在没有,公告只给了权重、代码仓与 Forge 三条路。1
- 要把结论写进决策文档的:先用自己的一批历史序列跑一遍,因为公开成绩是厂商提交的,独立复跑还没有。1
还没有的数字
References
- 1Introducing Timestral
mistral.ai
- 2Hugging Face mistralai 模型列表
huggingface.co
- 3Timestral-209M 模型卡
huggingface.co
- 4GitHub 仓库
github.com
- 5权重许可
huggingface.co
- 6Timestral 模型集合
huggingface.co
- 7GitHub 仓库
github.com
- 8GIFT-Eval 榜单
huggingface.co
- 9Artificial Analysis 模型页落点
artificialanalysis.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.