微软开源 Mage-VL-Cowork:47 亿参数的电脑操作模型,OSWorld 拿 66.0%,自家表里 9B 开源模型高它 2.7 分
微软以 Apache-2.0 开放 47 亿参数的混合电脑操作模型 Mage-VL-Cowork:OSWorld-Verified 66.0%,同一张官方对照表里 9B 的开源模型比它高 2.7 分,目前没有接口、价格与安全评测。

北京时间 10 月 30 日 20:14,微软 Mage 团队把 Mage-VL-Cowork 的权重传上 Hugging Face。1
模型 47.4 亿参数,BF16 下两个分片共 9.48 GB,Apache-2.0 许可。1
官方给它的主成绩是 OSWorld-Verified 上的 66.0%。1
这个基准把真实 Linux 桌面里的任务交给智能体,从打开文件到改完表格都算一次端到端操作。2
这次没有配套新闻稿。发布走的是模型仓、GitHub 代码目录、项目页,外加一份 30 页的技术报告。3
它值得看的地方有两处:一个 4B 模型把「点鼠标」和「敲命令」放进同一个策略(policy)里;权重和评测脚本一起放了出来。
快速核对
| 项目 | 情况 |
|---|---|
| 模型性质 | 视觉语言模型,输入截图与文字指令,输出鼠标键盘动作或终端命令 1 |
| 参数与体积 | 4,741,793,792 参数,BF16 两个分片共 9.48 GB 1 |
| 上下文 | 训练与推理实际使用 32,768 tokens,架构上限 262,144 1 |
| 动作空间 | computer_use 的 11 个界面动作,加一个持久的 bash 终端 1 |
| 主成绩 | OSWorld-Verified 66.0%,361 题、50 步预算、两次运行平均 1 |
| 许可 | Apache-2.0,可商用、可修改、可再分发 1 |
| 接口与价格 | 官方未提供托管接口与定价,只能自建 1 |
| 截稿时状态 | 权重、复现套件、技术报告均已放出 4 |
想立刻接进产品的人,这周拿不到能调用的接口,排期不必为它改动。
愿意自己跑的人,现在就能下载权重。官方也给了 OSWorld-Verified 的复现套件,可以按 361 题、50 步自己重跑一遍。4
只关心行业动向的人,可以等两个信号:OSWorld 官方 Results 区是否收录它,以及报告之外会不会补上安全评测。2
66.0% 是怎么算出来的
OSWorld 一共有 369 道题,其中 8 道依赖 Google Drive 的题官方允许排除,剩下的 361 道是常用口径。2
官方站现在把最新版本指向 OSWorld 2.0,这份 66.0% 用的是 2025 年 7 月定版的 OSWorld-Verified。2
Mage-VL-Cowork 就在这 361 题上评测:每题最多 50 步,截图按 1920×1080 送入,采样温度 0.7。1
66.0% 由两次完整跑分取平均得到,第一次 65.33%,第二次 66.75%。1
这 1.4 个百分点的区间后面会反复用到:对手和它差不到 1.4 分时,谁高谁低取决于跑了哪一次。
同榜的位置
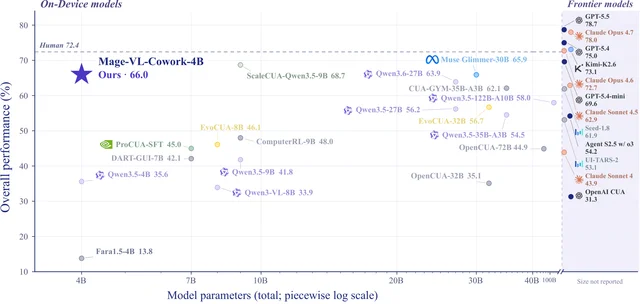
| 模型 | 参数量 | 步数预算 | 总分 | 分数来源 |
|---|---|---|---|---|
| ScaleCUA-Qwen3.5-9B | 9B | 50 | 68.7 | 各自报告 5 |
| Mage-VL-Cowork | 4.7B | 50 | 66.0 | 本方复跑 5 |
| Muse Glimmer-30B | 30B | 未列 | 65.9 | 各自报告 5 |
| Qwen3.6-27B | 27B | 未列 | 63.9 | 各自报告 5 |
| GPT-5.4-mini | 未公布 | 50 | 69.6 | 本方复跑 5 |
| GPT-5.5 | 未公布 | 未列 | 78.7 | 各自报告 5 |
| Fara1.5-4B | 4B | 50 | 13.9 | 各自报告 5 |
| 人类 | — | — | 72.4 | 基准方给出 5 |
「4B 档最强」这句话在这张表里站得住:同为 4B 的 Fara1.5-4B 只有 13.9%,差了 52 个百分点。5
压力来自参数不到它两倍的那一档:ScaleCUA-Qwen3.5-9B 拿到 68.7%,比它高 2.7 分。5
分项上两边各占一头:它的操作系统任务 87.5%、多应用工作流 62.7%,两项都是表里最高。5
办公 64.9% 与专业软件 66.3% 则落在 ScaleCUA 的 70.6% 和 89.5% 之后。5
30B 的 Muse Glimmer 是 65.9%,与它只差 0.1 分,落在两次运行区间之内。5
表里唯一由微软自己复跑的外部模型是 GPT-5.4-mini。5
同样 361 题、同样 50 步,它拿到 69.6%,比 Mage-VL-Cowork 高 3.6 分。5
其余对手的数字来自各家自己的报告,脚手架、步数预算、截图分辨率未必一致,横向差距要按这个前提读。
它是怎么练出来的
起点是今年 7 月的 Mage-VL 4B,一个为图像与视频理解训练的多模态模型。6
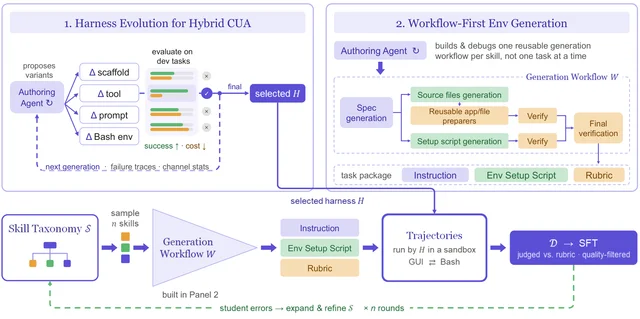
从它到 Cowork 中间有五个阶段:界面中训、界面智能体 SFT、编码与终端 SFT、混合 SFT、在线强化学习。1
这里的脚手架(harness)指包在模型外面的执行框架,决定工具怎么暴露、上下文怎么截断、失败怎么重试。
数据由自建的 Mage-CUA-Forge 合成:29.38 万个任务、6,915 个原子技能、31.9 万条保留下来的混合轨迹。5
其中 38.24% 的任务跨多个应用。5
教师模型是 GPT-5.4,生成任务用 gpt-5.6-terra。5
构造方式从「每个任务跑一遍智能体」换成「每个技能复用一个工作流」,单任务合成成本从 0.906 美元降到 0.158 美元。5
报告里最能复用的一条结论是:先改脚手架。5
教师模型不变,去掉无障碍树和
xdotool 这类重复通道后,教师从 89.6% 升到 92.0%。5同一批轨迹训出来的 4B 学生,成功率从 25.1% 升到 37.6%,走完任务所需步数也少了 21.5%。5
分数是这样往上走的:界面 SFT 45.56%,混合 SFT 55.84%,在线 RL 66.04%。1
在线 RL 用 GRPO 加可验证奖励,比混合 SFT 高 10.16 分。1
同时每任务调用次数从 21.57 压到 18.77,输出 token 从 7,374 压到 5,499。1
训练算力 7.79 ZFLOPs。5
参考部署是 32 张 B200(24 张训练、8 张推理)加 70 台 CPU 主机,并行开 1,120 个桌面沙箱。5
一个模型里的两个通道
computer_use 有 11 个动作:点击、双击、三击、移动、拖拽、输入、按键、滚动、等待、截图、结束。坐标归一化到 0–999。1上下文靠非对称滑窗省下来:只保留最近 3 张截图和 4 条完整回复,更早的回合压成一行 Action 摘要。5
官方用两组同机对照说明收益。3
LibreOffice Calc 合并两段表头、加柱状图、另存 xlsx,4B 走 Python 用 39 秒 6 步。3
Qwen3.6-27B 纯界面操作用了 9 分 56 秒、39 步。3
GIMP 去底色、缩放到 280×210、存分层的 xcf,4B 在 1 分 58 秒内 15 步完成并通过文件校验。3
对手跑到 7 分 02 秒、29 步,存出来的文件没过校验。3
省 token 的幅度有独立对照。5
每任务 5,499 个输出 token,GPT-5.4-mini 是 12,397 个;调用次数则是 18.77 对 18.24。5
自己跑要什么
官方只给了一条推理路线:SGLang。仓库附了预装好的 docker 镜像和启动参数,上下文设 32768。1
启动时还要把
SGLANG_MAX_PIXELS 设成 4,000,000,否则 1920×1080 的桌面细节会被压掉。1报告和模型卡都没有写单卡显存要求,也没有给首 token 延迟与吞吐。1
前面那 32 张 B200 服务于训练与 rollout 采样,报告没有把它写成推理门槛。5
浏览器任务另有一组:WebVoyager-Static 把 15 个网站复刻到本地,连数据库状态一起校验。5
它的 SFT 版本在这个基准上拿到 58.6%(377/643 题)。5
这个成绩在表里排第二,落后浏览器专精的 Fara1.5-4B(68.0%),高过 Qwen3-VL-8B-Thinking 的 53.7%。5
安全与许可
Apache-2.0 意味着可以商用、可以改、可以再分发,也意味着出了问题由部署方承担。1
模型卡没有越狱、提示注入、权限越界这类安全评测数字,给出的是一组部署要求。1
要求都很具体:在隔离容器或可回滚的虚拟机里跑,不可逆操作要人工确认,不挂个人密钥与浏览器 cookie,限制出网范围。1
原因不难理解:
bash 通道能执行任意命令,而这些命令会改动真实文件。1还有一条容易忽略的限制:模型卡把语言标为
en,官方评测的任务指令也都在英文界面里。1该不该试
第一类是要在离线或私有环境里做桌面自动化的团队。权重能下载、许可能商用、361 题的复现套件也放了,这条路是通的。
判断依据自己跑一遍就够。官方两次运行的起点是 65.33%,本地复跑若落在 55% 上下,说明任务分布差得远,先看哪一类分项掉得最多。
第二类是已经在用云端 CUA 的团队。同样 361 题、同样 50 步,GPT-5.4-mini 是 69.6%,比它高 3.6 分。
这个差距要放进成本结构里读:一边是按 token 付费的托管接口,一边是自己出机器。
任务集中在表格、文档、演示文稿的团队,重点看两个分项。5
它办公 64.9%、专业软件 66.3%,都低于 ScaleCUA 的 70.6% 和 89.5%。5
第三类是关注端侧的团队。官方把它称作端侧智能的进展,实际交付的是 9.48 GB 的 BF16 权重加一条服务端推理路线。
社区在权重上传八个多小时后放出了第三方 GGUF 量化版本,作者是社区用户。7
还没有的数字
速度与延迟:报告只给调用次数和 token 数,没给单步耗时、首 token 与吞吐。
安全评测:越狱成功率、提示注入抵抗、危险命令拦截,一项都没有。
接口与价格:官方未提供托管服务与定价,成本取决于自建机器。
OSWorld 官方 Results 区同样未见条目。2
推理生态:除 SGLang 之外,vLLM、llama.cpp、MLX 的官方支持都还没有出现。
数据构成:报告给了任务数与技能数,没有给训练语料的来源比例与语言分布。
References
- 1microsoft/Mage-VL-Cowork
huggingface.co
- 2OSWorld 官方页
os-world.github.io
- 3Mage-VL-Cowork 项目页
microsoft.github.io
- 4GitHub 代码目录
github.com
- 5Mage-VL-Cowork 技术报告
github.com
- 6microsoft/Mage-VL
huggingface.co
- 7Hansda/Mage-VL-Cowork-GGUF
huggingface.co
- 8Artificial Analysis LLM 榜单
artificialanalysis.ai
- 9OpenRouter 模型目录
openrouter.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.