百度开源 Unlimited OCR 2:3B 模型一次读完 300 页,百页文档每步解码快 7 倍
百度开源 Unlimited OCR 2:3.34B 的文档解析模型用 SR-SWA 把每步注意力压到固定的 640 个 token,报告自测百页文档每步解码快 7 倍、长文档基准远超通用模型,单页精度却与上一代持平。

10 月 26 日上午 11:57(北京),百度在 Hugging Face 上建好了
baidu/Unlimited-OCR-2 的权重仓。1第二天上午,模型卡补上 Release 一行:2026/10/27 发布 Unlimited OCR 2;15 页技术报告同时挂出,GitHub 的 README 在 10:27 与 10:47 又改了两版。23
百度智能云的文档解析接口页现在写的是「基于最新文心 Unlimited-OCR 2」,开箱即用的 API 已经可用。4
上一代 Unlimited-OCR 六月发布,用 R-SWA 把解码时的 KV 缓存固定住,代价是输入上限 40 页。这一代把解码器里全部注意力换成了 SR-SWA。5
先说结论
- 是什么:百度 ERNIE 团队的文档解析模型第二代,3.34B 总参数的 MoE,从上一代 checkpoint 继续后训练一个 epoch。15
- 改了什么:每个 query 只看固定容量的参考视觉 token,解码成本不再随页数增长;报告称百页规模下每步比全注意力快 7.0 倍、比上一代快 5.6 倍。5
- 长文档精度:几十页的 MPDocBench 84.59,最好基线 78.30;自建的百页 MarathonDocBench 77.06,通用 VLM 在 7.51 到 33.74 之间。5
- 单页几乎没变:OmniDocBench v1.6 上 94.02,比上一版 93.92 高 0.1 分,低于两个更小的开源模型。5
- 怎么用:MIT 许可,BF16 权重 6.69 GB,Transformers 与 SGLang 两条路径;百度云接口限时免费。46
- 缺什么:没有第三方复跑,没有公开单价,延迟实验用的卡型也没写。78
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 发布时间 | 模型卡写 2026-10-27;权重仓 10-26 11:57(北京)建好,模型卡与报告 10-27 上午补齐 | 模型卡 · 元数据 |
| 交付物 | 权重、技术报告、推理代码、百度云 API | GitHub · 百度云 |
| 参数规模 | 3,343,978,497(约 3.34B);MoE 12 层,64 个路由专家加 2 个共享专家,每 token 取 6 个 | 元数据 · config.json |
| 激活参数 | 报告正文写每 token 约 500M,架构图写 A570M,评测表写 3B-A0.5B,三处口径不一致 | 技术报告 |
| 上下文 | 131,072 token,YaRN 从 32,768 扩 4 倍 | config.json |
| 每页视觉 token | base 模式每页 273 个;单页默认走 gundam 动态切块 | config.json · 模型卡 |
| 注意力预算 | 块大小 32 token,本地窗口 4 块,远端 top-k 16 块,即每个 query 最多约 640 token | config.json |
| 许可 | MIT | 模型卡 |
| 权重体积 | BF16 两个分片共 6.69 GB;整个仓库 6.87 GB,其中 156 MB 是演示动图 | 文件列表 |
| 推理路径 | Transformers(A800-80GB 实测)、SGLang(仓库自带定制 wheel) | 模型卡 |
| 云服务 | 百度云文档解析,异步接口,PDF 最大 500 页,提交 QPS 2、查询 QPS 5 | 百度云 |
| 价格 | 接口限时免费,个人实名送 200 页、企业实名送 1,000 页;价格页没有这一项的付费条目 | 百度云 · 价格页 |
| 第三方状态 | Artificial Analysis、OpenRouter、Vals Index 均无条目 | AA · OpenRouter |
| 硬件口径 | 训练用 25×8 张 H800;延迟与 KV 实验的卡型报告没写 | 技术报告 |
它省掉的是哪一步计算
一页文档要变成一串视觉 token,解码每写一个 token,都要回头看这些 token。页数越多,要回看的视觉 token 越多,每一步都变慢。5
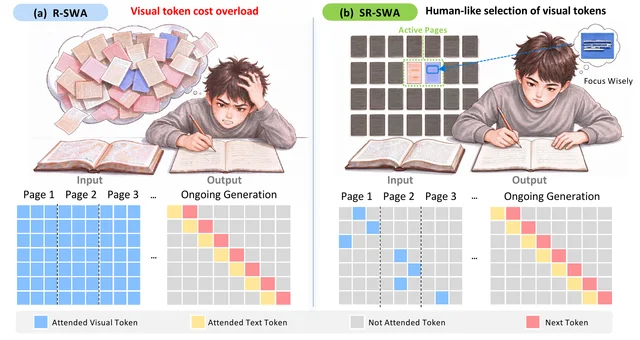
上一代的 R-SWA 只固定了文本侧的滑动窗口,视觉 token 仍然全看。报告的对比图画得很直白:左图注意力矩阵里蓝色格子铺满整页,右图只剩下几块。2
这一代加了两次筛选。Page Gate 先按页圈定候选块,同时把位置编码拆成页内坐标加一个 0/1 交替的页号,页数涨上去位置也不会失真。5
Token Sieve 在候选块里按语言建模目标训练出的路由打分,取分数最高的 16 块,每块 32 个 token。再加上 128 个 token 的本地窗口,每个 query 的可见范围固定在 640 个 token 左右。59
还有一层算术。配置里每页编码成 273 个图像 token,300 页合起来约 8.2 万 token,稳稳落在 131,072 的上下文里。9
长文档到底省了多少
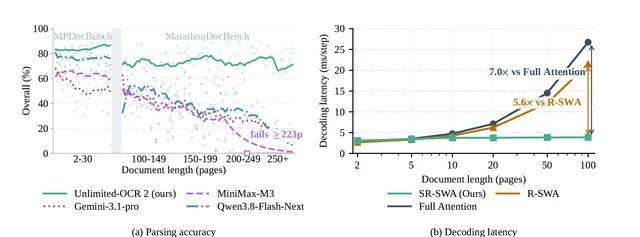
报告测了 2 页到 100 页六档。每个 query 的注意力范围既然固定,每步解码时间就该是平的:图上 SR-SWA 从 2 页到 100 页一直在 4 毫秒上下,全注意力爬到 27 毫秒左右,上一代爬到 21 毫秒左右,于是有 7.0 倍与 5.6 倍两个数。5
测这组数的条件是 gundam 模式、batch 3、每页固定生成 1,024 token。报告没有写用的是哪张卡,也没有给单卡上的显存占用。5
显存那部分另给了一张表:在百页的 MarathonDocBench 上,标准做法把所有页的视觉 KV 都留在显存里,峰值 47.00 GB;按页分块、只留当前块,峰值降到 1.77 GB。并发到 16 路时,吞吐从 360 TPS 升到 1,315 TPS。5
两类基准要分开看
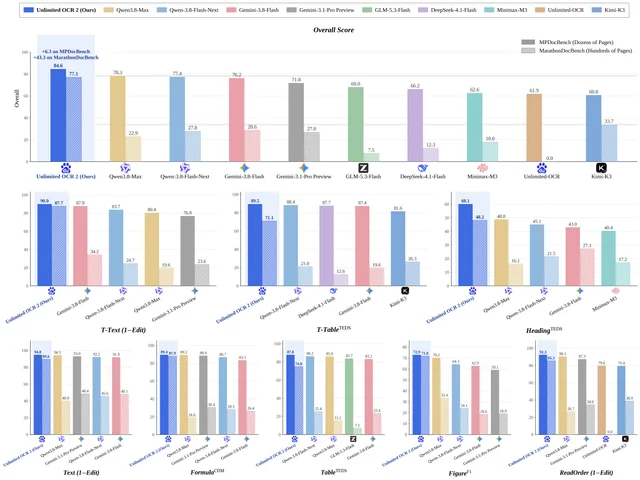
几十页那档用 MPDocBench。Unlimited OCR 2 拿 84.59,Qwen3.8-Max 78.30,Qwen-3.8-Flash-Next 77.36,Gemini-3.8-Flash 76.25,Gemini-3.1-Pro Preview 71.79,自家上一代 61.89。5
百页那档用 MarathonDocBench,是这次一起提的新基准:100 份文档,103 到 300 页,跨页表格与跨页文本比 MPDocBench 密得多。5
这张表上,Unlimited OCR 2 是 77.06。Kimi-K3 33.74,Gemini-3.8-Flash 28.61,Qwen-3.8-Flash-Next 27.83,Gemini-3.1-Pro Preview 26.97,Qwen3.8-Max 22.93,DeepSeek-4.1-Flash 12.34,GLM-5.3-Flash 7.51。上一代没上这张表,因为它输不进 40 页以上。5
两档的差距完全不同:几十页领先 6.3 分,上百页领先 43 分以上。原因写在左图里,通用模型不是分数低一点,是页数过百之后整份崩掉。5
单页不是它的战场
同样是自报数,单页基准 OmniDocBench v1.6 上它拿 94.02。上一代 93.92,两个更小的开源模型更高:0.8B 的 OvisOCR2 是 96.47,1.2B 的 TeleOCR 是 96.91。5
报告自己的说法也只是「保留」了单页识别能力,没有声称在这一档领先。这一代的优化目标写得很明确:把页数量级往上抬。5
限制章节给了两个短板。训练数据多样性有限;稀疏注意力不留全局文档信息,标题层级这类文档级结构的理解会受影响。5
第二个短板在数字里能看到。MPDocBench 的九项里,六项是分数、三项是编辑距离;分数里 HeadingTEDS 只有 60.10,下一个是 FigureF1 的 72.91。5
跑起来要改哪些默认值
最省事的第一步走 Transformers:按模型卡给的一组装依赖,
AutoModel 加信任远程代码,把一页一张图按顺序传进 infer_multi,一次请求解析整份文档。模型卡说这组配置在 A800-80GB 上测过。2几个默认值要动。
--mem-fraction-static 设 0.7,0.75 在 32 路以上并发会不够;--max-prefill-tokens 从 4096 降到 2048 能砍掉一半临时张量;SAM 注意力偏置的分块默认 512,单次申请约 462 MiB 会 OOM,设成 64 效果相同、峰值更低。2现在能用在哪
ModelScope 上还是上一代。那边能查到的仓库是
PaddlePaddle/Unlimited-OCR,2.0 没有同步过去。11不想自己部署就走百度云。文档解析接口写明基于文心 Unlimited-OCR 2,异步两步:提交拿 task_id,再轮询取结果,Markdown 与 JSON 结果链接保留 30 天。4
额度与限制一起看:接口限时免费,个人实名送 200 页、企业实名送 1,000 页;PDF 最大 500 页、100 MB,提交 QPS 2、查询 QPS 5。批量任务按这个 QPS 排队,一千页要跑一阵。4
价格那一栏还空着。价格页里「文档解析(PaddleOCR-VL)」与「文档解析」都给了 0.09 与 0.05 元每页两档,唯独没有 Unlimited-OCR 这一项。限时免费之后怎么收,官方还没写。8
该不该试
- 手上有几十到几百页的整份文档、今天靠逐页 OCR 拼接:这是它正对的口子。拿二十份自己的文档,跑一遍整份解析,重点看跨页表格有没有接上、章节标题有没有塌。5
- 日常只有单页票据、表单、截图:两个更小的开源模型分数更高,参数量分别只有 0.8B 与 1.2B,换过来没有理由。5
- 已经在用通用 VLM 塞长上下文:可以拿它当对照组,同样一批百页文档比一遍分数与耗时,再决定要不要为这一类活单独引一个模型。5
- 只想接 API、不想碰 GPU:百度云的免费额度够跑两百页,先把流水线接通,再等它公布付费价。4
- 文档以中文为主、或者大量手机截图:报告与模型卡都没有给分项,这两块得自己测。2
- 下游要用章节目录做检索:标题层级是全表最低的一项,替换前先拿自己的目录页试。5
还没有的数字
- 第三方复跑:Artificial Analysis 与 Vals Index 都还没有这个模型,OpenRouter 也没有上架,眼下所有分数都出自厂商自己的报告。71314
- 测试卡型与显存下限:报告只写了训练用 25×8 张 H800,延迟实验和 KV 实验用的卡、单卡显存占用都没给。5
- 速度的绝对值:只有相对倍数和图上毫秒数,没有 tokens/s 的官方口径;表里 1,315 TPS 是 16 路并发的端到端吞吐。5
- 训练数据构成:2M 多页加 10M 单页,伪标签来自 MinerU2.5-Pro 与 PaddleOCR-VL-v1.6,语言与领域分布没公开。5
- 300 页以上:报告测到 300 页为止,再长的文档官方没有数据,模型的 131,072 上下文按每页 273 token 推算大约到 480 页。59
- 单价:云接口限时免费,价格页没有这一项,自建的单页成本要靠自己的卡算。8
- 语言覆盖:模型卡标签写多语言,报告里没有分语言分数。2
References
- 1HF 模型元数据
huggingface.co
- 2baidu/Unlimited-OCR-2 模型卡
huggingface.co
- 3GitHub 提交记录
api.github.com
- 4百度云:文档解析(Unlimited-OCR)
cloud.baidu.com
- 5Unlimited OCR Works 2 技术报告
huggingface.co
- 6HF 文件列表
huggingface.co
- 7Artificial Analysis 榜单
artificialanalysis.ai
- 8百度云价格页
cloud.baidu.com
- 9config.json
huggingface.co
- 10官方 README
github.com
- 11ModelScope:Unlimited-OCR
modelscope.cn
- 12HF 搜索:Unlimited-OCR
huggingface.co
- 13OpenRouter 模型目录
openrouter.ai
- 14Vals Index
vals.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.