Manning 说 LeCun「已被证明是错的」:语言模型懂不懂物理世界,2018 年他们当面辩过
斯坦福 NLP 学者 Christopher Manning 在一档播客里说,Yann LeCun 关于语言模型永远无法理解物理世界的断言「是错的、而且已被证明是错的」;LeCun 两天后在 X 上回击。本期把两人的完整说法、各自引用的论文与近期基准数字摆在一条线上,看那些证据究竟支持了谁。

Manning 说 LeCun 关于语言模型「永远无法理解物理世界」的断言「已被证明是错的」,LeCun 回击说「等那个东西出现时,它不会是 LLM」——把两边各自举出的证据核到底,两句论断都比证据本身走得更远。
北京时间 10 月 2 日 05:49,Meta 与 NYU 的研究者 Ravid Shwartz-Ziv 在 X 上发了一条帖,把一段 37 秒的播客剪辑和一句话放在一起。1
Yann vs. Chris: can a language model ever understand the physical world? @ylecun says no. @chrmanning: "I think that is wrong and has been proven to be wrong." You know what they say: when legends argue, move aside.
(Yann 对 Chris:语言模型有没有可能理解物理世界?LeCun 说不可能。Manning:「我认为那是错的,而且已被证明是错的。」)
Loading content card…
被剪出来的那段发言,出自 9 月 28 日上线的播客《The Information Bottleneck》——嘉宾是斯坦福大学语言学与计算机科学教授 Christopher Manning,主持人是 Shwartz-Ziv 与 Allen Roush。23
将近五个小时后,北京时间 10 月 2 日 10:38,Yann LeCun 在这条帖下面回了一句。4
Sooo where is my domestic robot? Where is my L5 self-driving car? I can fine-tune an LLM to answer any question about the physical world. But that doesn't mean it has enough understanding and physical intuition to predict what a 6 year-old can predict.
(那么,我的家政机器人在哪?我的 L5 自驾车在哪?我可以微调一个 LLM,让它回答任何关于物理世界的问题。但那不等于它有足够的理解与物理直觉,去预测一个六岁小孩能预测的东西。)
这条回帖下面很快聚起了大量回复,其中有反对,也有赞成。德州农工大学教授 Shuiwang Ji 只回了一句:「Agree with Yann.」5
LeCun 那天在同一个帖子里又补了两句。对一位说「那训练一个不就行了」的人,他回:「Not if what you train is an LLM.」对另一位,他写:「When this "something" exists, it won't be an LLM, and there is a good chance that my team and I will have made a major contribution to its existence.」67
(除非你训练的是 LLM,不然不成立。/当那个「东西」存在的时候,它不会是一个 LLM,而且我的团队和我有相当大的机会为它的存在做出主要贡献。)
到这里为止,这是一场标准的 X 争论。往下核,它不是。
01 被剪出来的那句话,完整版长什么样
那 37 秒里最锋利的一句是「已被证明是错的」,但剪辑停在句号上,没有跟出他紧接着说的那句话。
完整的发言在单集第 38 分 40 秒前后,落在播客自己标出的章节「LeCun、JEPA 与语言在智能中的角色」与「只靠文本能教出意义吗:章鱼之争」之间。2
For quite a while Yann claimed that a language model could never have an understanding of the physical world — what would be the effect of moving a book out from under a glass of water, or turning the glass of water upside down — because since it was just sort of producing word sequences, it could never understand physical relationships in the world, which needs a world model. And again, you know, I think that is wrong and has been proven to be wrong.
(很长一段时间里,Yann 主张语言模型永远不可能理解物理世界——把一本书从一杯水下面抽出来会发生什么,或者把杯子倒过来会发生什么;因为它只是在产出词序列,所以它永远无法理解世界里那些需要世界模型的物理关系。再说一次,我认为那是错的,而且已被证明是错的。)
紧接着,他举了证据,然后说了一句收着力的话。
…it's still one of the clearest cases I think of a piece of work that sort of showed, oh look, you actually get a world model emerging from just seeing text sequences alone… So you can get a representation of the world and meaning from language alone. But then the next question is, well, is that a good way to do that? Are the representations you get efficient? Could you get better world models by not trying to learn from language alone? And I think undeniably the answer to that is yes.
(……那大概是我能想到最清楚的一个例子,它说明:光看文本序列,世界模型就能自己长出来……所以你确实能只从语言里拿到对世界的表征和意义。但下一个问题是:这是不是一条好路子?你拿到的表征高效吗?有没有可能,不靠语言单独学,反而能得到更好的世界模型?我认为答案毫无疑问是「是」。)
他在这段前后的总评也留了分寸:「I don't want to give an extreme position in either direction… I do think Yann really underestimates and underappreciates the role of human language.」2
(我不想站到任何一边的极端去……但我确实认为,Yann 严重低估、也严重不看重人类语言的作用。)
这期节目只提供机器生成的自动字幕,没有官方逐字稿,也没有说话人标注。上面几段英文引文抄自该字幕,并按上下文修正了两类误听:字幕把「Yann LeCun」听成 Jan/Yan Lunan,把「Othello」听成 Athell。发言归属是根据内容判定的——那一段以第一人称谈说话者自己三十年在语言与机器学习交界处的经历。
02 两个人各自站在哪,这不是他们第一次交手
Manning 在中文圈的名气远小于 LeCun,但这场争论他不是新来的——同一套论点,他至少公开说了八年。
他是斯坦福 NLP 组的创办人,与 Hinrich Schütze 合著过《Foundations of Statistical Natural Language Processing》,2015 年任计算语言学协会(ACL)主席,是美国国家工程院院士,也是 ACM、AAAI、ACL 的会士。89
国内很多做 NLP 的人是从他主讲的那门 CS224N 课入行的。8
他现在还有另一个身份:世界模型公司 Moonlake AI 的 Distinguished Member of Technical Staff(资深技术成员),2026 年 5 月入职,公司公告里写他加入的是基础模型训练团队。10
他的立场有据可查。2024 年 COLM 的主题演讲摘要里,他把话说得很直白:
I will argue that material beyond language is not necessary to having meaning and understanding, but it is very useful in most cases…
(我将论证:语言之外的材料并不是拥有意义与理解的必要条件,尽管在多数情况下它非常有用。)11
2022 年 7 月的一场计算语言学大会上,他和 Emily Bender 同台辩论过同一组问题——儿童如何习得语言、沟通里什么才算重要。12
到今年 9 月 27 日,他转发并背书了 Anthropic 研究者 Andrew Lampinen 的一条长帖。那条帖的核心是:Bender 与 Alexander Koller 2020 年那篇《Climbing towards NLU》的技术主张——只训练语言的系统只能学到形式、学不到意义——已经被现代语言模型的证据推翻。131415
值得一提的是,Bender 本人在 2026 年 5 月澄清过:「随机鹦鹉」是一个描述、一个隐喻,不是一个可以被证伪的经验假设。16
LeCun 那一侧的记录同样长。2023 年 10 月 28 日,他写:
And unless they can be trained from video, they still won't understand the physical world.
(而且,除非它们能从视频里训练,它们仍然不会理解物理世界。)17
2024 年 1 月 25 日,他把语言本身的带宽摆出来算了一遍:一个四岁孩子四年里接收的数据,比最大的 LLM 多五十倍。
Text is simply too low bandwidth and too scarce a modality to learn how the world works.
(文本这种模态,带宽太低、也太稀缺,学不到世界是怎么运转的。)18
Manning 在播客里挖苦的正是这个论证。他把 LeCun 的立场概括成一句话:语言的唯一角色是人与人之间的通信机制,而这条通道带宽很低、还不太好用。
而这两个人,八年前就当面辩过同一道题。
2018 年 2 月,斯坦福的一场讨论会上,主持人是 Abigail See,题目是「我们该把哪些先天先验写进深度学习系统的架构里」。Manning 的立场是结构是「必要的好东西」,LeCun 的立场是结构是「必要的坏东西」。
视频第 59 分 54 秒,LeCun 说了这样一段:
Language is sort of an epiphenomenon [of human intelligence] … it's not that complicated … There is a lot of intelligence that has absolutely nothing to do with language, and that's where we should attack things first. … [Language] is number 300 in the list of 500 problems that we need to face.
Manning 当时的反驳,和他在播客里的版本几乎是同一套:语言是把个体智能汇聚成「社会智能」的通道。
这场争论的谱系还能往前追。符号接地问题由 Stevan Harnad 在 1990 年提出——一个只靠符号互相定义的符号系统,语义无法自己供给自己,就像只用一本汉/汉词典学中文。22
03 「已被证明」指的是哪篇论文
Manning 说的那篇论文在播客里可以对上号:他点了作者名,也说了做法——「只用大量奥赛罗棋局走子序列训练一个模型」。
那篇论文是 Kenneth Li、Aspen Hopkins、David Bau、Fernanda Viégas、Hanspeter Pfister 与 Martin Wattenberg 在 ICLR 2023 上发表的《Emergent World Representations》,通常被叫做 Othello-GPT。23
奥赛罗就是国内常说的黑白棋。
做法是这样的:一个 8 层、8 个注意力头、隐藏维 512 的类 GPT 模型,只吃奥赛罗的合法走子序列,词表里只有 60 个词——棋盘上能落子的那 60 个格子。模型事先不知道任何规则,也从没见过棋盘本身。23
用随机棋局训出来的那一版,预测合法走子的错误率是 0.01%。
更关键的是第二件事:研究者训练探针(probe,一种从模型内部激活里读信息的小分类器),用它还原棋盘状态。线性探针不行,误差始终在 20% 以上;换成一个两层的小 MLP 探针,随机棋局训练的模型在第七层的误差降到 1.7%——而一直猜「空格」的基线误差是 47%。23
第三件事是干预:他们直接改写内部激活,把它推向另一个棋盘状态,模型的预测跟着变,平均会改变 2.12 个合法下一步的评估。23
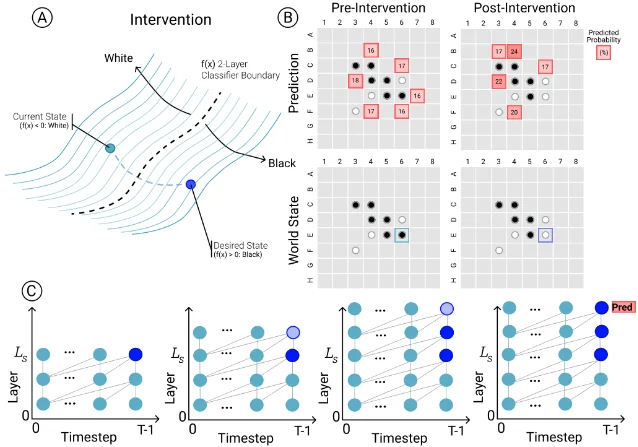
这篇论文证明的东西,和「语言模型有物理直觉」之间隔着好几步。
论文自己的表述是「涌现的非线性内部表征」;它测的是一个规则确定的棋盘游戏,不是物理世界。而 Manning 用它来反驳的那句 LeCun 原话,说的是语言模型永远无法理解物理关系、永远需要一个世界模型。
另一组研究者后来把这篇论文的边界量了出来。
Keyon Vafa、Justin Y. Chen、Ashesh Rambachan、Jon Kleinberg 与 Sendhil Mullainathan 用 Li 等人公开的那批 Othello-GPT 模型重做了一次测量,并在 NeurIPS 2024 上提出一套更严的度量:世界模型要做到 compression(同一个棋盘状态的不同历史,应当收敛到相同的后续)与 distinction(不同的状态,应当能被某个后缀区分开)。24
Li 的论文里公开了两套训练数据:一套是专家对局的锦标赛棋谱,一套是合法但随机的棋局。
在他们的度量下,用锦标赛棋谱训练的那一版 Othello-GPT,compression 得分是 0.00。
同一篇论文里还有一组更刺眼的结果:一个输出完全均匀分布、等于什么都没学会的模型,在另一款棋类游戏四子棋(Connect-4)上预测合法下一步的准确率超过 99%,但它的 distinction recall 是 0。24
奥赛罗和四子棋上的这两组数字说的是同一件事:准确率高,不等于模型里真有一个世界。
这也是 Manning 引那篇论文时最容易被读过头的地方。它证明的是棋盘状态可以被解出来、可以被干预;它没有证明这套表征能撑起物理直觉。
04 反过来的证据,也不站在 LeCun 那边
支持「语言这条路不够」的那一侧确实有硬数字,只是那些数字衡量的是所有模态——包括 LeCun 自己主张的那一条。
先看最新的一次验证。Meta FAIR 的 Florian Bordes 等人 2025 年 6 月发布 IntPhys 2 基准,用「违反预期」的范式测四个直觉物理原则:永久性、不变性、时空连续性、不可穿透性。25
在同一次评测里,人类受试者的总体准确率是 96.44%;GPT-4o 是 53.75%,Gemini-2.5 Flash 是 55.63%,Meta 自己的视频世界模型 V-JEPA 2-h 是 57.51%。随机水平是 50%。25
Meta 在官方博客里也把这句话写了出来:
While humans achieve near-perfect accuracy on this task across a range of scenarios and conditions, we find that current video models are at or close to chance.
(人类在这项任务的各种场景与条件下都接近满分,而我们发现当前的视频模型处于或接近随机水平。)26
同一篇博客里还有一句更贴题的:这些模型能答「发生了什么」,但答不好「本来可能发生什么」,也答不好「接下来可能发生什么」。
V-JEPA 2 是 Meta 自家的视频世界模型,也是 LeCun 长期主张的那条路线上的最新成果。它自报的拿手项是动作识别与视频问答一类的任务——比如 Something-Something v2 上 top-1 准确率 77.3%——和直觉物理不是一回事。27
IntPhys 2 表里的那个 57.51%,是别人评出来的。
还有一篇论文把两条路线一起否了。2025 年 2 月的《Intuitive physics understanding emerges from self-supervised pretraining on natural videos》,作者名单里有 LeCun,结论是:
…video prediction in pixel space and multimodal large language models, which reason through text, achieve performance closer to chance.
(……在像素空间做视频预测,以及通过文本推理的多模态大语言模型,在这个任务上的表现都更接近随机水平。)28
只有「在学习到的抽象表征空间里同时学表征与预测」,才涌现出物体永久性、形状一致性这类直觉物理——而且在一个视频上只训练一周的模型也能高于随机。
第三方的独立评测把事情摆得更清楚。南加州大学等机构的研究者做的 PhysBench,用 10,002 条视频—图像—文本交错的条目、19 个子类、8 个能力维度,评了 75 个视觉语言模型。29
他们的结论是:这些模型在常识推理上很出色,但理解物理世界这件事仍然极其有限,原因可能在于训练数据里没有物理知识、模型里也没有内嵌的物理先验。29
把这几组数字摆在一起,LeCun 的处境并不比 Manning 好。他说得对:语言模型在物理直觉上离六岁小孩很远。但视频模型也站在同一个位置上,差得并不比他批评的那一侧少。
05 两个人都不要「漂亮的像素」
在「不要什么」上,两个人几乎一致;在「要什么」上,两个人正好相反。
2026 年 9 月 24 日,Manning 在 AI Engineer World's Fair(一个面向 AI 工程师的行业大会)上做了一场叫《World Models Need Causality, Not Pretty Pixels》的演讲。3031
他先放了一段 Genie 3 的生成视频,然后说:
It looks beautiful, it's wonderful, it's pretty fluid, it seems great, but… these pixels are trying to simulate observations. They don't actually have or represent any of the semantics behind the world. And therefore, they aren't good at realism. They aren't good for giving a basis to plan.
(它很好看,很流畅,看起来很棒,但是……这些像素只是在模拟观测。它们并不真正拥有或表示世界背后的语义。所以它们谈不上真实,也没法作为规划的基础。)31
对另一个生成式世界模型 Marble,他的评价是:如果你只想在里面转一圈、从不同角度看,它工作得挺好,但在 Marble 的世界里,你其实对这些东西什么都做不了。31
LeCun 对这个问题的判断几乎一样。2024 年 2 月,他评价 Sora 一类模型时写的是:「The generation of mostly realistic-looking videos from prompts does not indicate that a system understands the physical world.」(根据提示生成看起来很像回事的视频,并不说明这个系统理解了物理世界。)32
他给出的替代方案是神经符号的:用代码和物件把场景拆成可移动的物体,让表征保持可编辑、可被人和别的程序接入。Moonlake 官网把用途写得很直接——世界模型与仿真层,用于部署;目标是让机器人在仿真里被评估和训练,省掉一万小时的真机示教。3334
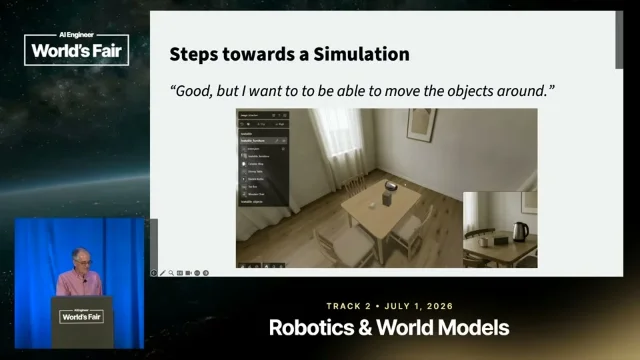
他对 LeCun 那条路线(JEPA,联合嵌入预测架构,主张在抽象表征空间里预测而不是生成像素)的评价也值得逐字看:
There's sort of a purely neural approach in which your latent representation of the world is purely neural, and so that's the kind of thing that the JEPA architecture is after… but on the other hand that's very hard for humans to connect to in any way, or for other applications to connect to… our bet is that the practical way to have a physical AI simulation infrastructure for the foreseeable future is to base it on symbolic representations.
(有一种纯神经的做法,你对世界的潜表征完全是神经的,JEPA 架构追的就是这个方向……但另一方面,这种东西很难让人接入,也很难让别的应用接入……我们押的是:在可见的未来,做物理 AI 仿真基础设施的实用路径,是把它建在符号表征上。)31
对照 LeCun 的那句话:当那个东西存在的时候,它不会是一个 LLM。
Manning 要的是能用代码和物件拆开、可编辑、能让人接手的符号仿真;LeCun 要的是纯潜表征里的预测。
分歧因此可以收成一句话:语言在这个系统里,到底算不算一条正当的输入。
06 这条分歧现在值多少钱
两个人都在拿真金白银给各自的答案下注,而 LeCun 自己给出的那两个判据,现在都还差得远。
LeCun 的 AMI Labs 在 2026 年 3 月拿到 10.3 亿美元种子轮,投前估值 35 亿美元。35 Manning 所在的 Moonlake 由斯坦福 AI 博士 Fan-Yun Sun 与 Sharon Lee 创办,官网列出的天使投资人里有 Ian Goodfellow 和 Jeff Dean。33
LeCun 用来追问的两件事,公开记录是这样的。
家用机器人这一侧,1X Technologies 的 NEO 官方定位是「全球首台面向消费者的机器人」,2026 年起主要在美国交付、2027 年扩到其他市场,抢先交付的版本 2 万美元一台,也有每月 499 美元的订阅。36
中国这一侧,宇树科技在 2026 年 1 月发公告澄清市场传闻,说 2025 年全年人形机器人实际发货给客户的数量超过 5,500 台,本体量产下线超过 6,500 台。37
这是公司自报的数字。第三方机构 Omdia 的估算是 2025 年智元机器人 5,168 台第一、宇树 4,200 台第二,比宇树自己报的少了四分之一左右。37
L5 这一侧,口径要更小心。按美国国家公路交通安全管理局(NHTSA)的定义,L4 是「在限定服务区域内由系统完全负责驾驶」,L5 则是「能在所有条件下、所有道路上运行」;NHTSA 明写,目前没有任何一辆在售车辆具备完全自动驾驶能力。38
也就是说,Waymo 和特斯拉的 Robotaxi 都是 L4,不是 L5。
规模上,Waymo 到 2026 年 9 月在全美约有 4,000 台车、每周约 50 万次付费乘坐、覆盖 15 个城市;特斯拉在得州获得授权的无人驾驶车队是 42 台,不到 Waymo 在得州备案数(577 台)的十分之一。3940
LeCun 的反问在字面上站得住:家政机器人刚起步,L5 尚不存在。但这句反问证明不了他想证明的东西——一个还没被造出来的产品,既不能说明语言这条路走不通,也不能说明换一条路就走得通。
Manning 那句「已被证明是错的」也一样。他引的那篇论文确实证明了文本序列可以让模型长出可解码、可干预的棋盘状态;它证明不了这套表征能撑起物理直觉——而在更严的度量下,连那个棋盘状态本身都被测出是不连贯的。
八年过去,两个人手里的证据都比 2018 年多了不少,结论却仍然是各自下注。
真正的裁决不会出现在 X 上:它会出现在谁先交出一台能自己把书房收拾干净、并让你愿意为它付钱的机器。
References
- 1
- 2
- 3同集单集页 · Apple Podcasts
podcasts.apple.com
- 4Yann LeCun 的回复 · X
x.com
- 5@ShuiwangJi · X
x.com
- 6Yann LeCun 的回复 · X
x.com
- 7Yann LeCun 的回复 · X
x.com
- 8Christopher Manning · Stanford
nlp.stanford.edu
- 9ACL Officers · ACL Admin Wiki
aclweb.org
- 10
- 11COLM 2024: Keynotes · COLM
colmweb.org
- 12
- 13@chrmanning · X
x.com
- 14@AndrewLampinen · X
x.com
- 15Climbing towards NLU · ACL 2020
aclanthology.org
- 16
- 17Yann LeCun · X
x.com
- 18Yann LeCun · X
x.com
- 19
- 20Deep Learning, Structure and Innate Priors · Abigail See
abigailsee.com
- 21
- 22
- 23
- 24
- 25IntPhys 2 · arXiv
arxiv.org
- 26
- 27
- 28
- 29PhysBench · arXiv
arxiv.org
- 30
- 31同场演讲官方整理页 · AI Engineer
ai.engineer
- 32Yann LeCun · X
x.com
- 33Moonlake · 官网
moonlakeai.com
- 34Efficient World Models · Moonlake AI
moonlakeai.com
- 35
- 36NEO Home Robot · 1X
1x.tech
- 37宇树科技澄清 2025 年人形机器人出货超 5500 台 · 联合早报
zaobao.com.sg
- 38Automated Vehicle Safety · NHTSA
nhtsa.gov
- 39Waymo is scaling fast · TechCrunch
techcrunch.com
- 40
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.