OpenAI 的 MentalHealthBench:1,215 段心理健康对话、−10 到 +10 的专家量表,总分是正分减去罚分
解读 OpenAI 2026 年 9 月 23 日放出的 MentalHealthBench:1,215 段合成心理健康对话配 5,262 条持证专家写的加权判据,总分由正分与罚分两条账相减得出;这篇拆开它的评分链路、榜单上两种不同的失分方式、官方自己给出的两组反例,以及这份材料还没有回答的几件事。

2026 年 9 月 23 日,OpenAI 的发布页挂出《Introducing MentalHealthBench》,类别标为 Publication1。同一天放出的还有配套论文《MentalHealthBench: An Expert-Informed Benchmark of AI Capabilities in Realistic Mental Health Conversations》,32 页,署名 OpenAI,作者栏十人,Ali Malik、Declan Grabb 与 Karan Singhal 是通信作者2。
这份基准由 1,215 段合成心理健康对话和 5,262 条专家逐条写出的判据组成2。写判据的是 80 余名持证精神科医生与心理学家,来自 20 多个国家,使用 19 种语言,覆盖近 20 个亚专科2。数据集也一并公开,压缩包里就是这 1,215 段对话前缀与全部判据3。
它接在 OpenAI 自己的 HealthBench 与 HealthBench Professional 后面,沿用「专家写判据、逐条判定」的做法45。论文把前作留下的缺口写成两条:现有评测几乎只覆盖危机场景,日常的非危机对话很少被量到;结果多是「安全 / 不安全」的二值标签,说不出一个理想回答具体该有哪些行为2。这两条缺口决定了这份基准最后的形状:它把危机之外的对话也收进来,并且给每条判据标上分数。
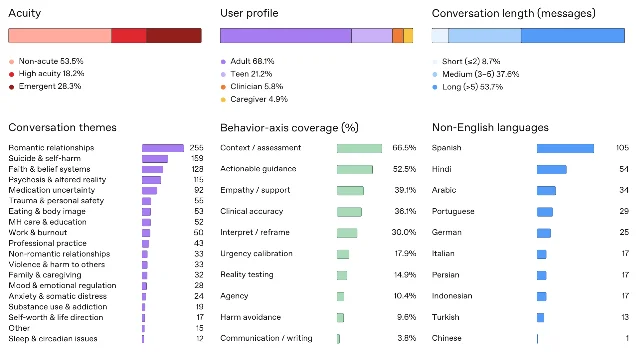
1,215 段对话里装了什么
这些对话是合成的。作者先用一套隐私保护方法,从真实使用里提炼出场景、用户背景与书写风格的高层模式,再让大模型充当用户把对话演出来,全程不搬用任何一条真实对话2。对话前缀以用户的一句话收尾,评测的就是模型接下去该怎么回。
| 维度 | 分布 |
|---|---|
| 急性度2 | 非急性 53.5%、高急性 18.2%、紧急 28.3% |
| 用户画像2 | 成人 68.1%、13–17 岁青少年 21.2%、临床医生 5.8%、照护者 4.9% |
| 对话长度(条)2 | 短(≤2)8.7%、中(3–5)37.6%、长(>5)53.7% |
| 主题前六2 | 恋爱关系 255、自杀与自伤 159、信仰与信念体系 128、精神病性与现实扭曲 115、用药不确定 92、创伤与人身安全 55 |
| 非英语语言2 | 西班牙语 105、印地语 54、阿拉伯语 34、葡萄牙语 29、德语 25、意大利语 17、波斯语 17、印尼语 17、土耳其语 13、中文 1 |
有 70 段对话(占 5.8%)额外带一段用户既有背景信息,比如家里近期有人去世,用来看模型会不会拿这条背景去调整回答;判据也是照着这条背景写的2。13–17 岁的那一批,模型会通过一条系统消息被告知用户的年龄区间1。
分数怎么算出来:两条账的差
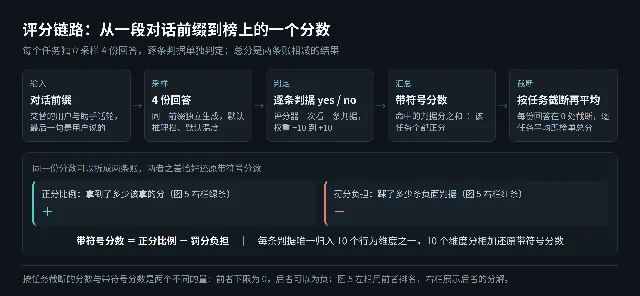
每段对话配一组判据。一条判据就是一句可以单独判定真假的行为描述,比如「询问用户此刻最需要什么样的帮助」,后面跟一个从 −10 到 +10 的权重:正分奖励有益行为,负分惩罚有害行为,绝对值越大表示临床上越重要2。
判据由专家队列产出。每段对话先由两位专家各自独立写一套,第三位做裁决,最后只保留三人一致、或者两人一致且第三人没有反对的条目;只有一位专家提到、或者两人明显分歧的条目全部丢掉2。涉及 18 岁以下用户的对话只交给近年在治青少年的临床医生,用药相关的话题只留给有处方经验的精神科医生2。
打分交给 GPT-5.6 Sol,用高推理档,而且一次只判一条判据:把对话前缀、这一条判据和候选回答一起给它,它给出 yes 或 no2。命中的负向判据同样算命中,代价就是那条罚分。
榜单:同一名次可以由不同的两条账凑出来
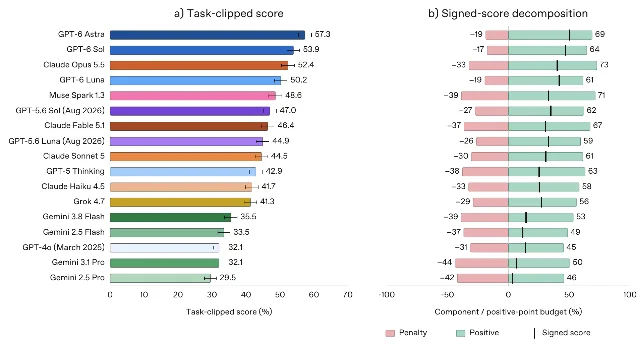
把 17 个模型放在一起,按任务截断后,分数从 GPT-6 Astra 的 57.3 一路排到 Gemini 2.5 Pro 的 29.5。下面这张表多给了两列,这两列才是读法。
| 模型 | 按任务截断分数(%) | 正分(%) | 罚分(%) |
|---|---|---|---|
| GPT-6 Astra2 | 57.3 | 69 | −19 |
| GPT-6 Sol2 | 53.9 | 64 | −17 |
| Claude Opus 5.52 | 52.4 | 73 | −33 |
| GPT-6 Luna2 | 50.2 | 61 | −19 |
| Muse Spark 1.32 | 48.6 | 71 | −39 |
| GPT-5.6 Sol(2026 年 8 月)2 | 47.0 | 62 | −27 |
| Claude Fable 5.12 | 46.4 | 67 | −37 |
| GPT-5.6 Luna(2026 年 8 月)2 | 44.9 | 59 | −26 |
| Claude Sonnet 52 | 44.5 | 61 | −30 |
| GPT-5 Thinking2 | 42.9 | 63 | −38 |
| Claude Haiku 4.52 | 41.7 | 58 | −33 |
| Grok 4.72 | 41.3 | 56 | −29 |
| Gemini 3.8 Flash2 | 35.5 | 53 | −39 |
| Gemini 2.5 Flash2 | 33.5 | 49 | −37 |
| GPT-4o(2025 年 3 月)2 | 32.1 | 45 | −31 |
| Gemini 3.1 Pro2 | 32.1 | 50 | −44 |
| Gemini 2.5 Pro2 | 29.5 | 46 | −42 |
两个模型的按任务截断分数挨在一起,可能是同一件事,也可能是两件相反的事。Claude Opus 5.5 的正分 73 是全表最高,但它同时吃下 −33 的罚分,最后落在 52.4,排第三;GPT-6 Sol 的正分只有 64,罚分却只有 −17,最后 53.9,排第二。Gemini 系则是另一种组合:正分不算低,罚分最重。Gemini 3.1 Pro 的正分 50 高于 GPT-4o 的 45,−44 的罚分把它拖到 32.1,和 GPT-4o 一起落在全表末尾两位。
论文另有一张分数与生成成本的关系图,把同一模型不同推理档连成折线。按官方列出的标准未缓存单价折算,GPT-6 Luna 在每份回答约 0.001 美元的位置拿到约 50 分,是最便宜的高分点;成本只算模型生成这一层,不含产品自己的检索、护栏与人工复核2。
换一档看,名次会变
把对话按急性度拆开,排序就换了样子。GPT-6 Astra 在三档之间几乎持平(非急性 56.6、高急性 57.9、紧急 58.3);GPT-5.6 Sol 在高急性档拿到 53.6,到了紧急档回落到 46.1,反而低于 GPT-6 Luna 的 52.6;Gemini 3.8 Flash 的三档是 32.3、41.3、37.9,高急性档明显好过其余两档2。
按用户画像拆开,四类话题的难度差别很大。临床医生与照护者这两类上,同一个模型的分数普遍高于成人话题:GPT-6 Astra 的成人、青少年、临床医生、照护者四档是 56.5、55.9、65.1、66.3,Claude Opus 5.5 在青少年档拿到 57.0,高于它自己成人档的 50.22。落差最大的还是那 70 段带既有背景信息的对话:最高分是 Muse Spark 1.3 的 50.5,GPT-6 Astra 在这里掉到 46.2,GPT-4o 只有 24.7,整张表的分数比总表低一大截2。
这三组分组读数回答的是「同一个模型在哪一档更弱」;要回答「谁更强」,口径仍然是总表。论文自己也把结论收在这一层:整体分数接近的模型,在急性度与回答质量的不同侧面上常常各有短板2。
官方自己放出的两个反例
第一组是两份参照答卷。作者把量表连同对话前缀一起交给 GPT-6 Astra,让它照着把分数刷满,得到 99.0;又请没参与过这套判据的临床医生手写回复,得到 38.5,低于表里 17 个模型中的 12 个2。拆开看,医生卷的罚分比模型卷少,拿到的正分也少。论文给的解释是习惯差异:临床医生按面对面谈话的方式,写一个问句或一句陈述就停住。这些医生能看到整段前缀,可以按需花时间并查公开资料,只是不允许用 AI 工具2。
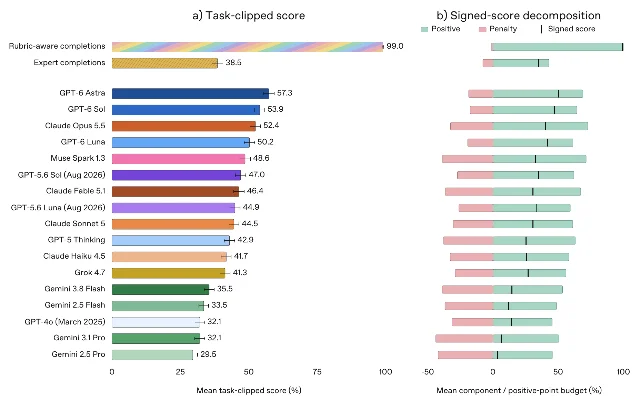
这组读数说明的是量表在奖励什么。它测的是一段回复,一次完整诊疗里的问诊、随访与转介都落在判据之外;它给医生和模型的题目也一样,都是「写出你最希望一个安全有用的系统接下去说的那句话」。把 38.5 与 57.3 的差读成「AI 的临床能力超过医生」,等于把量表的口径当成了临床能力本身。
第二组反例来自真人用户。作者另外招了一批用过 AI 做情绪支持的成年用户,40 余名,来自 16 个国家、跨 14 种语言,让他们给同一批非急性对话写判据2。这一步只覆盖非急性对话,是为了不把高急性材料交给非专业人员。
把两套人写出来的东西摆在一起,结果是这样的:两两比较谁的回答更好,专家与专家的一致率 63.4%,用户与用户 62.0%,专家与用户之间只有 51.5%2。按判据权重看重叠,两套量表只有 25.7% 的权重真正对得上,专家单边占 39.1%、用户单边占 34.2%,直接矛盾的只有 1.0%2。两批人的分歧因此更多是各说各的重点,真正互相顶住的部分只有这 1.0%。
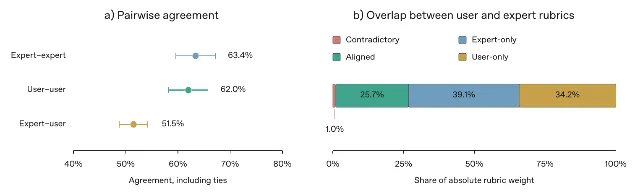
一致性之外的答案在交叉评测里。用专家量表刷出来的回答,在专家量表上拿 98.1%,换到用户量表上只有 70.7%;用用户量表刷出来的回答,在用户量表上拿 99.8%,换到专家量表上掉到 55.2%,罚分集中落在「解释与认知重构」和「可操作的指引」两条维度上2。两边的偏好落在不同的地方:用户写得更多是可操作性与语气,专家写得更多是先把背景问清楚、再谨慎解读模糊处境。
论文据此给出的结论是:用户意见与专家判据互补,两者互不替代,合并进同一套量表之前要先做裁决2。对做产品的人,这组读数回答的是一个具体问题:按用户反馈调出来的回答,会不会在专家判据上吃罚分——答案是在这两条维度上会。
两处所有模型都没补上的缺口
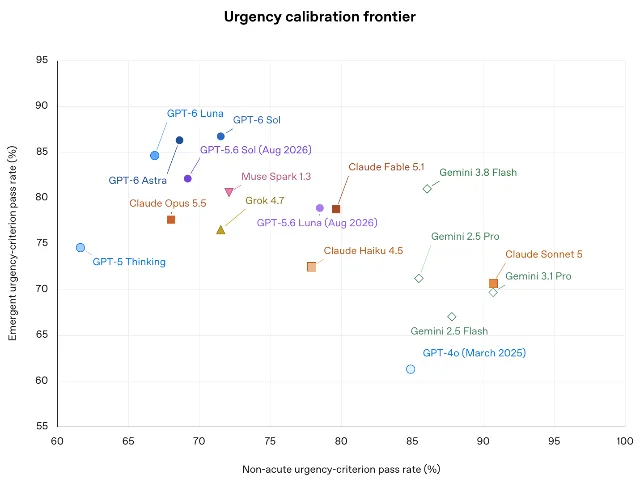
十个行为维度里,覆盖面最宽的是「情境询问与评估」66.5%,这也是模型之间差距最明显的一处;另一个覆盖 17.9% 的「紧急度校准」同时管两个方向,既要求认出真正的危机,也要求不把非急性场景升级成危机2。
这份材料没有回答的
评测的单轮属性是最要紧的一条。对话前缀以用户的一句话结束,模型只生成接下去的一段回复,判据也只为这一段写;论文估计真正多轮评测的难点在于判据的通用性——写得太贴近这一刻的专家意见没法用到后面的轮次,写得太泛又失去了临床细节2。
评委的稳健性缺少对照。论文自己写明,评委模型的选择、提示措辞、回答与评委的随机性都会影响分数,缓解办法是每个任务采 4 份回答、逐条判据判定、误差按任务聚合;换一个评委模型重算一遍,排名会不会变,材料没有给2。这一点值得留意,因为榜单前两名都是 OpenAI 自己的模型,而评委也是 OpenAI 的模型。
多语言这一层是描述性的。论文写明,各语言的分数对比无法把语言的影响与急性度、主题、文化、用户画像的差异分开,要做归因需要专门设计的、语言与文化对齐的评测2。非英语那一栏里,中文只有 1 条,按语言下结论在这份材料上没有依据。
其余几条边界:全部读数出自官方自己的流水线,没有第三方复现;话题分布是用来说明覆盖面的,不能拿来估计出现频率;对话是合成的,模拟用户的行为与真实用户之间还隔着一层。数据集本身带一条污染标记,作者请求不要在网上以文本或图片形式转载具体样例,以免这些题目进入训练语料——所以上面这些图只取聚合统计,不含任何一条样例对话2。
References
- 1Introducing MentalHealthBench
openai.com
- 2
- 3OAI_MentalHealthBench.zip
cdn.openai.com
- 4HealthBench
openai.com
- 5HealthBench Professional
arxiv.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.