
Agent 总分变了,究竟是哪一步变好了?

Agent 总分变了,究竟是哪一步变好了?

你把编码 Agent 的模型换了一版,端到端基准分数涨了几个百分点,可团队没人说得清,它到底学会了什么。

0:00 / 7:20
9 月 9 日,Google Developers Blog 发布了一篇关于编码 Agent 的工程文章。文章提出一个很具体的判断:端到端基准告诉你最终任务有没有完成,行为评测则告诉你,Agent 在完成任务的路上有没有做对关键动作。1

本期听什么

  • 为什么只看 Terminal-Bench、DeepSWE 一类的总分,很难知道 Agent 到底在哪一步变好了或退化了。1
  • 什么是行为评测:把“有没有完成整个重构”拆成“遇到信息不足时会不会先澄清”“改构建文件后会不会运行验证器”这类可观察动作。1
  • Google 给出的三步起点:先挑一个真实失败模式,再根据任务复杂度选择严格断言或结果判断,最后用批量评估观察长期趋势,而不是被一次随机运行牵着走。1

工程上的关键判断

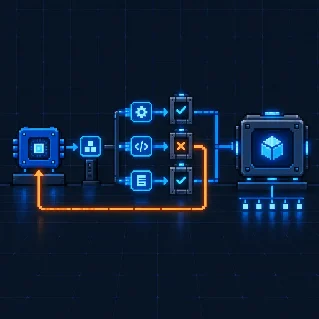
行为评测不是把宏观基准换成更多小分数。端到端评测负责确认 Agent 最终有没有到达目的地,行为评测负责确认控制路径上的关键动作是否稳定。两者放在一起,团队才知道一次提示词修改、工具协议变更或模型升级,究竟改善了什么,又破坏了什么。
对于简单任务,可以检查一个确定动作,例如是否调用了真实天气搜索。对于复杂任务,严格规定每一步工具顺序会误伤那些走了另一条、但同样安全且正确的路径。此时,验收条件应该转向结果和安全性判断。1
如果要把这套方法放进自己的 Agent 平台,可以从一个失败样本开始:保存触发输入、允许使用的工具、关键中间动作、最终结果和版本信息。每次改提示词或换模型,先运行这组小测试,再跑更大规模的端到端任务。这样,Agent 的反馈循环才不只是“分数涨了”,而是能回答“哪一个行为改变了,变化是否稳定,回归发生在哪里”。
本期事实与方法主要依据 Google Developers Blog 2026 年 9 月 9 日文章;文章中的示例和建议属于 Google 对编码 Agent harness 工程的实践总结,不等同于所有 Agent 系统的通用性能保证。

This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.

Related content