5 个 agent 追平 33 次独立尝试、同一道网页题 1 分 06 秒到 2 小时、61 分钟的片子换 4 步后 14 分钟
过去二十四小时里八组实测的共同点,是它们都在同一个东西上只动了一处:共享一份目录的 5 个 agent 追平 33 次独立尝试,同一道网页题从 1 分 06 秒排到 2 小时以上,换 4 步加个补丁把 61 分钟的片子压到 14 分 19 秒。

过去二十四小时里,八组材料做的事很像:都在同一个东西上只动了一处,然后把动出来的差别报出来。共享一份目录的 5 个 agent 追平了 33 次独立尝试,可同一批 25 个游戏里有 7 个反而更差。同一道网页题,九份成绩从 1 分 06 秒排到 2 小时以上;其中同一款模型只是把思考关掉,就从 57 分钟掉到 12 分钟。同一张卡、同一份权重,只把引擎从 Ollama 换成官方 llama.cpp,八路并发从 71.1 涨到 87.7 tok/s。
这一期把八组材料的任务设定、运行条件、具体数字、分歧环节和发帖人自己承认的限制放在一起,供正在选模型、部署和报账的读者自己核对。覆盖 2026 年 9 月 20 日至 9 月 21 日,来源为 X、Reddit、小红书与公众号。
八组材料总览
| 任务 | 测试对象与运行条件 | 关键数字 | 主要限制 |
|---|---|---|---|
| 让一组 agent 互相通信去解题 | 微软研究院与威斯康星大学麦迪逊分校的五位作者,N 个没有角色分工的同款 agent 只通过共享目录协作,跑 ARC-AGI-3、polyomino packing 与 MNIST 压缩三个任务 1 | ARC-AGI-3 上 k 个能通信的 agent 追平 4k 个独立 agent;5 个 Sonnet 4.6 追平 best-of-33;一个 64 次独立尝试都没解开的游戏被 5 人团队解开 65%;MNIST 上压出 1,957 字节、99.4% 准确率的分类器 | 算力不足或没有明确进展信号时,独立并跑可能更好;25 个游戏里通信只帮了 18 个 |
| 把进入大模型的提示词先过一道判断 | X 用户 Sagar Mainkar 搭的 Jev Wall,两个公开数据集共 1,968 条人工标注样本全部跑完 2 | 1,039 条正常请求零误拦;929 条攻击拦下 794 条(85.5%);准确率 93.1%、AUC 0.986;单次约 350 毫秒,整轮 12 美分 | 作者说这是一次独立测试而不是基准;数据集标签本身有可争议之处 |
| 五个类 Jev 的决策模型同题比一次前向 | 同一台 M1 Max 纯 CPU,同一批题各问三次取中位数 3 | 最快 system-one-mini 69M 9.7 毫秒,最慢 decider-2b 1.9B 1200 毫秒,差 124 倍;laya 421M 37.8 毫秒,校准误差 0.081 全场最低 | 稿子里 Jev 那一行是官方基准、与作者自己的测量不同源;最快的实现只有 5 个固定题 |
| 同一道网页题交给九个模型 | RTX 3060 12GB、16GB DDR4 单通道、CachyOS,本地模型走 llama.cpp,同一段前端提示词,前后八个多小时 4 | 参照组 1 分 06 秒到 4 分 56 秒;本地最快 2.4 分钟(约 74 tok/s);同一款 27B 关掉思考从 57 分钟变 12 分钟,另一个量化档超过 2 小时、满上下文约 4 tok/s | 作者只附录屏、不给分数与人工评审;Codex 那一格空着,他请人补 GPT-6 Astra 的结果 |
| 2.8T 的模型跑在 16 张 GB10 上 | 16 个 GB10 节点、两台 MikroTik CRS804-4DDQ 交换机、4×400G 拆成 4×100G 的线、改过 NCCL 拓扑的定制运行时 5 | 编码解码约 30 tok/s(峰值约 38)、prefill 750–910 tok/s、并发峰值 136 tok/s、数十万 token 上下文 | 帖子只给稳态与峰值,没有冷跑;评论里有人说一次设置改动就让前缀缓存命中率从 99.7% 掉到 1.8% |
| 一台机器一个人用的本地推理 | Mac mini M4 24GB 对二手 3090 24GB 整机,都跑 8B 的 Q4 量化 6 | 37 对 161 tok/s,差 4.4 倍;月成本 155 对 261 元;换成每 100 tok/s 的成本是 419 对 162 元 | 文中速度数字大多是引用他人测试;作者自己那台机器的实测截图位置还留着"待补充"的空位 |
| 同一张卡换引擎、换步数 | AMD R9700 32GB,同机同权重把引擎从 Ollama 换成官方 llama.cpp;出片从官方 20 步换成 4 步加加速补丁 7 | Qwen3.8-27B 单路 27.8→30.9、八路 71.1→87.7 tok/s;15 秒片从 61 分 28 秒到 14 分 19 秒;算力比 3090 多 120 TFLOPS、带宽少 296 GB/s | 对比表里 3090 与 4090 两格不是作者实测;四个格子参照的模型与上下文各不相同 |
| 7B 的开源生图模型 | 阿里 9 月 20 日放出 Qwen-Image-2.1 的开放权重,生成与编辑合成一个模型 8 | 生成部分 7B、32 层单流 DiT、原生 2048×2048、直接输出 RGBA、最多 10 张参考图;模型卡写的是 Qwen Research License Agreement | 规格来自发布方自己的模型卡与仓库;画质那一条是一位用户的个人体验,没有可核对的样本 |
五个 agent 共享一份目录,追平 33 次独立尝试
微软研究院与威斯康星大学麦迪逊分校的五位作者在 9 月 17 日把一篇论文传上 arXiv,9 月 21 日由作者 Dimitris Papailiopoulos 在 X 上把结论贴了出来 1。做法是:把 N 个完全相同的 agent 放在同一道题上,不给角色分工,只让它们往同一个共享目录里写日志,并告诉它们"合作"。对照组是同一批 agent 各自独立地跑,取最好的那一次。
最干净的对比在 ARC-AGI-3 上,这是一个要求现场解决没见过的新问题的基准,这一版有 25 个游戏:k 个能互相通信的 agent 组成的团队,成功率追平 4k 个独立 agent,而且这个优势随 k 变大 1。落到具体数字上,5 个 Sonnet 4.6 组成的团队追平 33 次独立尝试里最好的那一次;作者举的最极端一例是一个游戏,单 agent 试了 64 次一次没解开,5 人团队的成功率是 65% 9。
另两个任务给出的是另一种量级的结果。polyomino packing(把方块拼进尽可能小的矩形)上,3 个 Opus 4.6 组成的团队超过了 best-of-60,也超过了此前已知的最好成绩;MNIST 分类器压缩(把识别手写数字的模型压到尽可能小)上,4 个 5.6-Sol 组成的团队交出一个 1,957 字节、测试准确率 99.4% 的模型,比论文图里标注的最好人类解(2,461 字节)还小,而没有任何一个独立 agent 跑到 3KB 以内 9。
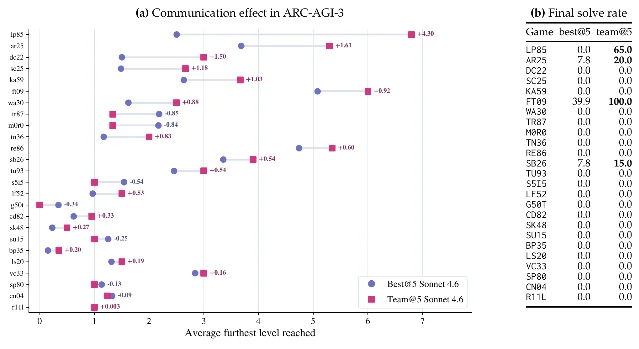
论文和作者帖子都把适用条件写在显眼位置:算力受限、或者任务没有一个清楚的进展度量时,独立并跑反而可能更好;串行类的任务(论文点名了 Terminal-Bench 那一类)此前的研究结论也是收益不明。作者的说法是,一道清清楚楚的串行题上,让一群 agent 互相商量帮不上什么忙,而需要反复出现突破的研究型任务才吃这一套 9。
Loading content card…
把提示词先过一道判断:1,968 条里误拦 0 条
X 用户 Sagar Mainkar 自述做了二十年安全产品(此前在 Qualys、SAS),这次他给 Jev 搭了一个护栏引擎,取名 Jev Wall。Jev 是 TypeSafe AI 那个只出判断、不写字的模型:给它一段输入和一组问题,它直接返回选项、分数与概率。每一条进入大模型的提示词先过一次判断,一次调用返回三样东西——拦或不拦的概率、28 种攻击手法里最接近的那一种(每种映射到 MITRE ATLAS 的编号)、以及一旦模型照做后果有多重(0 到 3 级)2。
测试用的两份语料都来自 Hugging Face、都带人工标注:deepset/prompt-injections 662 条,短、隐蔽、有一部分是德语;jackhhao/jailbreak-classification 1,306 条,长、吵闹,是"你是 DAN,你没有规则"那一类 2。全部 1,968 条跑完之后的结果是:
- 1,039 条正常请求,0 条被拦;
- 929 条攻击拦下 794 条,85.5%;
- 整体准确率 93.1%,AUC 0.986;
- 单次调用约 350 毫秒,整轮约两分钟,总共花掉 12 美分;
- 出现最多的攻击是 DAN 式人格,436 条,其次是"忽略之前的指令",120 条。
分档看差距更清楚:吵闹的越狱拦到 96.9%,隐蔽的注入只有 85.6%,作者说漏掉的几乎都是藏得深的那些。他观察到的第三件事是置信度偏保守——"答案是是的时候它常常说是也许"——所以他自己在生产里会把阈值降到 0.5 以下,宁可多拦一些 2。
作者自己划的边界写在帖子末尾:这是公开数据上的一次独立测试,够不上基准;数据集的标签本身有可争议之处;他与 TypeSafe AI 没有任何关系;代码以 MIT 许可开源,可以自己跑一遍或者拆开看 2。
Loading content card…
五个类 Jev 的决策模型,同一台 M1 Max 上一次前向差 124 倍
小红书用户「Ai 主权工作室」把五个做"只出判断、不写字"这件事的实现装在同一台 M1 Max 上,纯 CPU,同一批题各问三次取中位数,拿来比对的是 Jev 1.13.0 官方基准给出的那一行 3。
| 实现 | 参数 | 一次前向的中位耗时 | 作者给出的说明 |
|---|---|---|---|
| system-one-mini | 69M | 9.7 毫秒 | 最快,只支持 5 个固定题目 |
| systemone-lite | 0.5B | 31.7 毫秒 | 准确率 0.679 |
| laya | 421M | 37.8 毫秒 | 中英自动路由,最均衡 |
| decider-2b | 1.9B | 1200 毫秒 | CUDA 下可以快 7 倍 |
| Jev 1.13.0 | 未给出 | 236–276 毫秒 | 官方基准,不是作者实测 |
最快和最慢差 124 倍;四个开源实现把同一道题都判对了。校准这一项 laya 最好,置信度 0.9999,校准误差 0.081 是全场最低 3。
作者还做了一组压力测试:拿双色球的红球加蓝球共 34 个问题(红球 33 选 6、蓝球 16 选 1),要求一次前向把所有概率出全。laya 的状态上限是 512 token,只够约 30 期;decider-2b 的 32k 能装下约 1,700 期,是唯一吃得下十几年历史的那一个。在 30、100、1000 期三个窗口上跑下来,24 号几乎全部命中;窗口拉到 1000 期时,红球的出现次数全挤进 196 到 210 次之间。他自己点出,蓝球的置信度只有 0.09,接近随机线,这号题不如直接去看频率表 3。
需要分开看的有两处:Jev 那一行是官方公布的基准数字,与作者这台机器上量出来的那几次来自不同的运行;最快的那个实现只有 5 个固定题,换一道题快不快另说。作者的选型建议按状态长度分——512 token 以内用 laya,超长历史用 decider-2b,固定题要毫秒级用 system-one-mini 3。
同一天在 Reddit 的本地模型版,另一位作者给出了这条路线的另一种走法。他把项目叫 hearim:一个开源网关,把普通的本地或托管语言模型接成 Jev 兼容的决策接口,做法是只做 prefill(带前缀缓存)再解一个 token 读 logits,不生成任何文本。他自述这套技术在 Jev 发布之前已经用了一年多,这次的实现是独立重写的,并明确声明不复现 Jev 的架构、训练、校准、速度与表现,只主张一件事:一个有用的判断接口未必需要一个专门的判断模型。他还把论文和代码一起放了出来 10。
同一道网页题、九份成绩:2.4 分钟到 2 小时以上
Reddit 用户 /u/zyxciss 用同一段提示词要九个模型各做一个单页网站:一家虚构的高端科技工作室,要求看起来像水平不错的真人前端做的、不像 AI 模板,明确禁掉一堆常见的 AI 味——过多的圆角卡片、巨大的渐变光斑、无意义的玻璃拟态、假数据和"赋能未来"式的文案——还要一段抽象动效、作品区、能力区、页脚和几个克制的交互。硬件是一台 RTX 3060 12GB、16GB DDR4 单通道,系统是 CachyOS,本地模型都跑 llama.cpp,九个模型的生成过程全部录了屏 4。
| 模型 | 量化与设置 | 耗时 | 生成速度 |
|---|---|---|---|
| GPT-5.6 Sol | 线上 | 1 分 06 秒 | — |
| Gemini 3.8 Flash | Antigravity,约 9K token | 3 分 12 秒 | — |
| Claude Sonnet 5 | 线上 | 4 分 56 秒 | — |
| Ornith 1 9B | Q4_K_M,5.4GB | 约 2.4 分钟 | 约 74 tok/s |
| Ornith 1.5 35 A3B | Q6,22.4GB | 未给出总时长 | 约 30 tok/s |
| Bonsai 2 27B | 三元权重(每个权重只有三种取值),7.66GB | 约 45 分钟 | 34–36 tok/s |
| Qwen3.8 27B GSQ-RCO-IQ3-XXS + MTP | 10.4GB,开思考 | 约 57 分钟 | 29–40 tok/s |
| Qwen3.8 27B GSQ-RCO-IQ3-XXS | 同一份权重,关思考 | 约 12 分钟 | — |
| Qwen3.8 27B Q4_K_M | Unsloth 动态量化,16.4GB | 超过 2 小时 | 满上下文约 4 tok/s |
同一份提示词下,最能说明"动的只有一处"的是倒数第二行:权重还是那个 GSQ-RCO,作者只是把思考关掉,12 分钟出活,用了约 12K token,比开着思考的 57 分钟少了 45 分钟。反过来,Q4_K_M 那一档的画质他最认可,代价是满上下文时掉到约 4 tok/s,要靠把大量层卸载到 CPU 和内存才跑得完 4。
作者自己在最后列了三档排序:Qwen3.8 27B Q4_K_M 排第一,GSQ-RCO 第二,Bonsai 2 27B 三元权重第三。他的理由是那档 GSQ-RCO 在画质、编码能力、上下文处理和速度之间最均衡;帖子末尾他请有 Codex 订阅的人补一份 GPT-6 Astra 的结果,那一格到现在还空着 4。
评论区的方向跟作者不一样。第一条说模型选择奇怪,"Bonsai 和 9B 是认真的吗";另一条只留下"第 5 个网站最好看"。这些判断都建立在作者附的录屏上,而九个网站的画质与代码他没有打分,也没有请人评审。倒是有一条经验值得记下来:另一位同卡用户说,当模型大于一张卡时,两张卡比 CPU 卸载大约快一倍,他自己这么做是因为视觉部分留在 GPU 上才不至于超时 4。
Loading content card…
2.8T 的 K3 跑在 16 张 GB10 上:编码 30 tok/s
Reddit 用户 /u/ciprianveg 把 Moonshot 的 Kimi K3(2.8T 参数)跑在自己攒的 16 个 GB10 节点上。硬件是 16 台 GB10 节点(英伟达那台桌面机 DGX Spark 里的芯片)、两台 MikroTik CRS804-4DDQ 交换机,用 4×400G 拆成 4×100G 的 breakout 线连起来;运行时是改过的 gb10-vllm 栈,套着 dspark 与 Inferact 的 Kimi-K3-DSpark 包装,再加自己写的 MLA 与 KV kernel,全部补丁、配置和构建脚本都放在他的 GitHub 仓库里 5。
跑出来的数字:重度代码生成和 agent 任务时解码约 30 tok/s,峰值约 38;prefill(把提示词读进去的那一段)750 到 910 tok/s,靠的是改过的 NCCL 拓扑与双交换机;并发压测下多路请求不掉速、也不把 KV cache 饿死;几十万 token 的上下文能稳定跑多轮 500k 的压缩 5。
评论区最该记下来的一条跟倍数无关。有人说峰值这个数字最好抄,真正决定实际速度的是前缀缓存命中率——他自己那次因为一处设置改动,命中率从 99.7% 掉到 1.8%,重新 prefill 把省下来的全吃掉了,所以他要"冷跑 t/s 摆在峰值旁边"才肯信。作者回帖补了一句:这里跑的是 2.8T 的 K3 本体,本地速度已经接近它 API 的水平 5。
同样在这条帖子下面,另一个人的玩笑点到了口径问题:从 16GB 内存变成 16 张 GB10,"本地"这个词的含义已经变了。到取回评论时,这条帖子 22 条评论里有一个 14 条的子树没有展开取到 5。
慢 4.4 倍,却每月省 106 元
公众号「小老板的 AI 账本」把两台机器的账算平:一边是翻新 Mac mini M4 24GB(5,099 元),一边是二手 3090 24GB 整机(约 7,500 元),两边都跑 8B 的 Q4 量化 6。
速度差得很直白:Mac 在 Ollama 下 37 tok/s,3090 是 161 tok/s,4.4 倍。把一次性投入按 36 个月摊、电费按每天 8 小时和 0.6 元一度算,Mac 每月 155 元、3090 每月 261 元。作者提醒的第一件事是最容易被人看漏的:标称都是 24G,Mac 的 24G 是统一内存,系统和浏览器要占掉 6 到 12G,真正能分给模型的通常只有 12 到 18G;3090 的 24G 全归模型。这个差别在 14B 以上会直接卡住——Qwen3 32B 的 Q4_K_M 约 20GB,3090 装得下,24G 的 Mac 就顶在边界上 6。
把分母换一下,名次就反了。按"每 100 tok/s 花多少钱"算,Mac 是 419 元、3090 是 162 元,快的那台单位算力成本只有 Mac 的 39%。作者据此给的分界线是:一个人用选 Mac,两个人以上同时用选 3090;月度跑批量在 160 小时以内 Mac 够用,超过这个量,Mac 慢 4.4 倍就追不回来 6。
这一篇的限制要单独说一句:文章里的速度数字大多转引自 zonemac、zavcloud、neokvm 几个来源的测试;文中甚至还留着一处"待补充·真实素材"的提示,位置是作者自己那台机器跑 8B 模型的实测截图。它还给出一个 Mac 用户容易踩的坑:普通 pip 安装的推理框架不会编译原生 kernel,会静默回退到慢路径,文中引的对照是融合 prefill 内核 845 tok/s 对约 29 tok/s。同一台机器上框架也不一样,Llama 3.1 8B 在 MLX 下 42.3 tok/s、在 Ollama 下 31.7 tok/s 6。
同一张卡,换引擎、换步数
公众号「用 AI 重新做的一百件事」把一张 AMD R9700 32GB(12,000 元)单独测了两件事。出片这一件,跑的是 MiniMax H3 的 1344×768 视频,ComfyUI 标准流程、官方 20 步,一条 15 秒片要 61 分 28 秒;换成 4 步加一个加速补丁,14 分 19 秒,同一条 5 秒片从 10 分 19 秒降到 2 分 57 秒 7。
跑语言模型这一组更干净:同一台机器、同一份 Qwen3.8-27B 的 Q4_K_M 权重,唯一换掉的是引擎。
| 并发 | 原样用 Ollama | 换官方 llama.cpp | 多出来的 |
|---|---|---|---|
| 1 | 27.8 | 30.9 | +3.1 |
| 2 | 50.6 | 54.4 | +3.8 |
| 4 | 65.3 | 78.8 | +13.5 |
| 8 | 71.1 | 87.7 | +16.6 |
上下文开到 131,072 个 token 时显存占 23.37GB,32G 的卡不用压缩 KV 就能装下 7。
对比同价位的三张 N 卡,结论落在带宽上。R9700 的 FP16 算力 191 TFLOPS,比 3090 的 71 多出 120,但带宽只有 640 GB/s,比 3090 的 936 少 296。同一段 1344×768 的 5 秒片,5090 用 70.1 秒,R9700 用 176.6 秒;同一档 544×800、20 步的采样环节,3090 是 142 秒、R9700 是 183 秒。作者替读者算的性价比里,R9700 拿下每千元显存(2.67GB)和每千元算力第一,3090 拿下每千元带宽与每千元吐字第一 7。
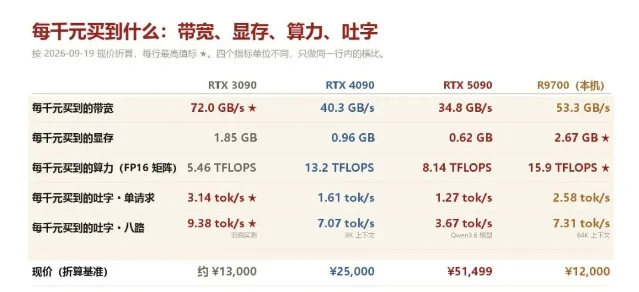
作者自己写清楚的两处口径:这张表里 3090 与 4090 两格取自网上,他没有自己测过;四个格子的参照模型与上下文各不相同,所以只能同一行内横比,不能当成绝对性能。价格也在动,R9700 从首发 10,999 涨到 12,000,他在文章里建议刚需的人抓紧 7。
7B 的开源生图模型,把许可换成了研究用途
阿里 9 月 20 日放出 Qwen-Image-2.1 的开放权重,把生成与编辑合成一个模型:生成部分是 7B、32 层单流 DiT,文本编码器用 Qwen3-VL 8B,VAE 是 64 通道的 RGBA 自编码器;原生出 2048×2048,支持的画幅最长边到 2752×1536;一次最多吃 10 张参考图,局部修改可以用圈选、涂抹或单独的 mask 8。模型卡和仓库里还有几条发布帖没展开的:文本前缀带 KV 缓存复用,混合粒度注意力,仓库第一天就配了 Diffusers、ComfyUI、vLLM-Omni、SGLang 几条推理路线,也给出了 ROCm 下跑 AMD 卡的路径 11。
一个做后期的 X 用户关心的正是透明通道这一条。他说自己的活是在 After Effects 里合成,前面五条片子都是把主体从没有透明通道的画面里一帧一帧抠出来,模型直接输出 RGBA 就省掉整个环节,而这一行没有出现在任何人的标题里 12。
质量这一侧有反例。一位 X 用户在发布帖下面写,自己实测下来它噪点多、也不遵守要求的艺术风格,只在生成大量文字的时候表现最好,而他认为更好的 Krea 2 没有进那组对比 13。
另一条线索是许可。模型卡与仓库都写明这次用的是 Qwen Research License Agreement,社区连续追问生成出来的图能不能商用,Qwen 的开发者账号在 9 月 21 日回应:输出不属于授权材料,用户保留自己生成的图片等内容的权利 14。同一时间 Reddit 的本地模型版有一条帖子专门问这件事,标题就是「关于 Qwen-image-2.1 许可的澄清」 15。
需要留在纸面上的:上面的规格与功能来自发布方自己的模型卡与仓库;画质那一条是一位用户的个人体验,没有可核对的样本;许可的说明是官方在社区追问之后给出的,模型卡的许可名称仍是研究许可。模型卡上另外几个可查的数字是——首月下载 6,523、基于它做的微调 15 个、量化 23 个、在线的 Space 30 个 11。
拿到下一个数字之前,先问三句话
今天这八组材料各自回答的是自己那道题,凑不出一条统一的结论,但问法可以统一。下一组成绩、下一张速度表、下一个价格摆在面前时,三句话够用了。
第一句,这一次动的到底是哪一处。5 个 agent 与 33 次独立尝试之间隔的是一份共享日志;57 分钟与 12 分钟之间隔的是一个思考开关;71.1 与 87.7 tok/s 之间隔的是一个推理引擎;61 分 28 秒与 14 分 19 秒之间隔的是步数和那个加速补丁。
第二句,旁边几处跟着动了没有。R9700 那张表里四个格子的参照模型与上下文各不相同;小红书那组里 Jev 的一行来自官方基准,作者其他四行来自他自己这台机器;Mac mini 那篇里的速度数字大多转引自别处,作者自己机器的截图还没补上。读到一个数字时,先看旁边那几行是不是同一套条件。
第三句,你拿到的是峰值还是你要跑的那个数。16 张 GB10 上编码是 30 tok/s、峰值 38、并发峰值 136;评论区给出的反例是前缀缓存命中率一改,省下来的就全没了。同一款 27B,满上下文 4 tok/s、空上下文 8 tok/s,中间隔的是两小时和十几分钟。
最后留一个能自己动手的核对项:挑一个你常用的提示词,在手边的两三个量化档、以及思考开关的两种状态下各跑一次,把耗时、生成速度和显存占用记下来。这一期里 8B 的同一道题可以在 2.4 分钟出活,也可以走两个小时;那两组数字之间隔的就是这几行配置。
References
- 1
- 2
- 3小红书 Ai主权工作室:5 款类 Jev 决策模型实测横评\
xiaohongshu.com
- 4r/LocalLLaMA:同一道网页题上的九个模型\
reddit.com
- 5r/LocalLLaMA:把 Kimi K3 跑在 16 张 GB10 上\
reddit.com
- 6公众号 小老板的AI账本:Mac mini M4 24G 对二手 3090\
mp.weixin.qq.com
- 7公众号 用 AI 重新做的一百件事:AMD R9700 32G 实测\
mp.weixin.qq.com
- 8Qwen 官方发布帖\
x.com
- 9
- 10r/LocalLLaMA:hearim——你也许不需要一个专门的模型
reddit.com
- 11Qwen-Image-2.1 模型卡
huggingface.co
- 12
- 13
- 14
- 15r/LocalLLaMA:关于 Qwen-image-2.1 许可的澄清
reddit.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.