丢掉 95% 的画面 token:图像追平了 2024 年的基线,动作没有,因果注意力白送
LeCun 转的那条权重发布说「图像和视频两边都补上了差距」;22 个数据集的表里,图像均值追平了 2024 年的 V-JEPA 1,视频均值仍落后 3.9 到 5.7 分,而那张表是作者自己跑步的尺子、5.6 倍算力的分母没有出处。

北京时间 11 月 3 日凌晨两点半,Lukas Kuhn 在 X 上发了一条帖。
他是德国癌症研究中心(DKFZ)的研究者。
他放出的东西是 LeVJEPA 1.5 Large 的权重,一个视频编码器。1
近八个小时之后,Yann LeCun 转发了它,没有加一个字。2
这项工作的论文不新。arXiv 上的第一次提交在 8 月 27 日,七位作者,LeCun 排第五,署名机构里有他创办的 AMI Labs。3
今天多出来的是两样东西:一版权重,和一张论文里没有的表。
表上是 22 个数据集的平均分——LeVJEPA 1.5 Large 78.76,V-JEPA 1 是 79.77,V-JEPA 2 是 81.63。4
帖子那句话是:「在图像和视频两类基准上,它都补上了跟 V-JEPA 的差距。」1
这个方法最值钱的地方,是它顺手拿到了因果性。帖子里那两个数字——补上的差距、省下的 5.6 倍——一个是自己做的尺子上量的,一个的分母是自己估的。
01 八月是论文,十一月是一张表
论文里没有那张 22 项的表,只有三项基准。
arXiv 2608.27395 在 8 月 27 日提交,至今只有 v1,两个多月没有修订过。3
全文 12 页、4 张表,评测只覆盖 ImageNet-1K、Something-Something-v2 和 Kinetics-400。5
同一天,Hugging Face 上已经有一版权重叫 LeVJEPA-VideoMix-Large。6
那版是 ViT-L/16,303.1M 参数,1,806,869 条片段。
片段来自 Kinetics-710、Something-Something v2、Walking Tours 和 PE-Video 四份数据。6
十一月这版叫 LeVJEPA-1.5-Large,规格几乎一样:ViT-L/16,303M 参数,1.8M 条片段,同样四份数据。
模型卡另给了两个数:约 5,300 小时,151 exaflops。4
八月那版大概就是帖子里的「1.0」。
它的模型卡里一个跑分都没有。6
所以那句「明显比 1.0 更好的模型」,眼下没有对照表可看。1
项目页也还停在八月:结论用的是论文口径,Checkpoints 链接指向 VideoMix-Large。7
02 便宜是从哪里来的
成本只由编码器看到多少个 token 决定,于是丢 token 就是最直接的省钱办法。
LeVJEPA 是一个视频编码器。输入是 16 帧,输出是这段片段的表示。
它属于 JEPA 这一路:训练目标让同一条片段的不同视图在表示空间里彼此靠拢,像素本身不进损失。
一段 16 帧的片段,切出一个全分辨率的全局视图,再切出若干裁剪过的局部视图,全部送进同一个编码器。7
损失是每个局部视图的 [cls] 向全局 [cls] 靠拢的均方误差。5
这一项单独最小化会退化成常数解。把它挡回去的是 SIGReg:把嵌入分布约束成各向同性高斯,坍缩的构型离这个分布最远。5
按 Cramér–Wold 定理,高维的分布约束可以拆成沿随机方向的一维正态性检验,用 Epps–Pulley 统计量算,代价对批大小和维度都是线性的。7
权重 λ 固定为 0.02,全篇没有一个实验为它调过参。5
于是可训练的部件只剩编码器和一个小投影器:没有 EMA 目标编码器,没有 stop-gradient,没有 predictor,也没有像素解码器。5
前向成本因此只跟编码器实际看到多少 token 有关。95% 的补丁 token 在进入序列之前就被丢掉。5
有两个地方要分清。
模型卡写着「放出来的张量是编码器的 EMA 副本」,读起来像 EMA 还在。4
论文里的说法是,权重的滑动平均只用来产出评测检查点,不参与目标函数。5
另一个是推理:丢 token 只在训练时生效,评测时模型返回全部 3,137 个 token。4
省下来的算力全在预训练那一段。跑推理的时候,它跟一台同样大小的 ViT-L 一样贵。
03 丢得越狠越准,代价在另一处
ImageNet 上丢得越多越准,Something-Something 过了 30% 就往下走。
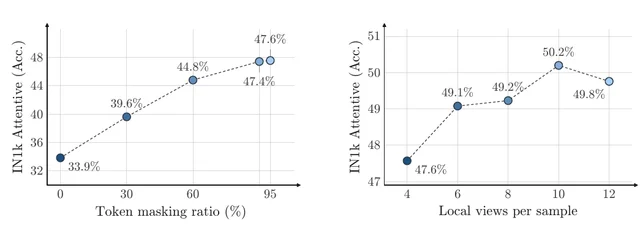
如果丢 token 只是为了省算力,这条曲线的方向本该相反。5
作者的解释是:它同时成了一种数据增强,整段片段的表示必须从稀疏、随机的位置上推出来。7
同一章还给出了一条更反直觉的对照。保留每帧相同空间位置的 tube 掩码只拿到 39.6%,均匀随机丢拿到 50.7%。5
掩码视频建模常用的那种结构化掩码,在不需要重建像素之后,反过来伤害表示。作者的解释是,掩码的形状是补全任务提出来的要求,跟视频本身无关。7
代价在视频那一侧。同一章里,丢得超过 30% 之后,Something-Something-v2 的准确率开始下降,与 ImageNet 上的单调上升相反。5
作者说延长训练能把这段落差补回来。5
丢 token 那个比例,既是省算力的旋钮,也是伤动作的旋钮。
04 22 个数据集里,决定结论的那几行
赢的那几项集中在低分辨率小图,输的那几项集中在自然图像和动作。
下表挑了 8 个单项和 3 个均值,完整的 22 行在模型卡上。最后一列是 LeVJEPA 1.5 减去 V-JEPA 2,单位是百分点,负数表示落后。
| 数据集 | LeVJEPA 1.5 | V-JEPA 1 | V-JEPA 2 | 差(对 V-JEPA 2) |
|---|---|---|---|---|
| ImageNet-1K | 75.20 | 79.45 | 82.68 | −7.48 4 |
| EuroSAT | 98.06 | 97.17 | 96.39 | +1.67 4 |
| BloodMNIST | 99.09 | 98.48 | 98.19 | +0.90 4 |
| 图像 15 项均值 | 83.34 | 83.03 | 84.90 | −1.56 4 |
| SSv2 | 60.10 | 69.55 | 70.00 | −9.90 4 |
| Kinetics-710 | 68.23 | 75.27 | 77.01 | −8.78 4 |
| Diving-48 | 27.43 | 34.54 | 39.46 | −12.03 4 |
| KTH | 78.24 | 87.04 | 89.81 | −11.57 4 |
| COVID-BLUES | 74.24 | 65.15 | 65.15 | +9.09 4 |
| 视频 7 项均值 | 68.94 | 72.79 | 74.61 | −5.67 4 |
| 22 项均值 | 78.76 | 79.77 | 81.63 | −2.87 4 |
22 项里同时赢过两边的,只有 8 项:6 项在图像组,2 项在视频组。4
图像的 6 项是 EuroSAT 加五个 MedMNIST。
MedMNIST 是一套医学影像小图基准,原图被统一压到 28×28。8
官方基线里,一台直接在这组数据上训练的 ResNet-18,在 BloodMNIST 上是 95.8,在 OrganAMNIST 上是 93.5。9
LeVJEPA 在这五项上,比两边里更高的那个还高 0.6 到 5.5 分。4
剩下 9 项图像里,它只在 BreastMNIST 和 PneumoniaMNIST 上高过 V-JEPA 2。
Aircraft 一项高过 V-JEPA 1,其余 6 项两边都低。4
图像侧被引最多的那一项是 ImageNet-1K:75.20 对 82.68。4
视频 7 项里赢的是 DynTex++ 和 COVID-BLUES,输的 5 项每项差 7 到 12 分。4
三个均值于是这样排。
图像 83.34,比 V-JEPA 1 的 83.03 高 0.31,比 V-JEPA 2 的 84.90 低 1.56。
视频 68.94,总均值 78.76,两边都低。4
「图像那一半补上了」对应的是 2024 年初的 V-JEPA 1。10
05 这块尺子是作者自己做的
22 项里 V-JEPA 两篇论文评过的只有 3 项,其余 19 项没有官方数字可对。
V-JEPA 2 那 6 项的平均分是 87.5,模型是 ViT-g,跟这张表里的 81.63 没有关系。11
其余 19 项在两篇论文里都查不到。
图像侧是 STL-10、Flowers102、Pets、Aircraft、DTD、EuroSAT 和八个 MedMNIST。
视频侧是 KTH、DynTex++、YUP++、COVID-BLUES,加上 Kinetics-710。
Kinetics-710 是 V-JEPA 1 的预训练数据之一,两篇论文都没有把它当评测集。11
重叠的三项,数字也对不上。
ImageNet-1K 标 82.68,Meta 官方是 84.6。
SSv2 标 70.00,官方是 75.3。
把这些分数读成作者自己跑出来的一套,是目前讲得通的唯一解释。4
模型卡对此只有一句:三个编码器都冻结评测,用注意力探针。4
没有一句写「我们重跑了 V-JEPA」,也没有写用的是哪一档——V-JEPA 1 有 L 和 H,V-JEPA 2 有 L 和 g。11
三个编码器跑同一套代码、同一份数据划分,所以这三列横向可比。
这套代码和 Meta 公布分数时用的那套不同,所以那 22 行里任何一项,都读不出 Meta 那边的排名。
论文的受控比较为了公平,把所有方法都限制在同样数量的探针 token 上。5
22 项那张表没有交代它怎么定这个数。
06 同一个 5.6 倍,两个分母
论文里的 5.6 倍是对 V-JEPA 2,模型卡里的 5.6 倍是对 V-JEPA 1。
论文的受控比较是这么做的:把基线重训在同一份 20% 的 Kinetics-710 子集上。
同样 240 个 epoch,同样批大小 3,072,探针也给同样多的 token。5
ViT-B 上,LeVJEPA 要 4.8 ExaFLOPs,V-JEPA 2 要 36.4,准确率差不到 1 分。5
ViT-L 上,它比 V-JEPA 2 高 1.9 分,算力低到对方的 1/5.6;整台 ViT-L 用的算力还不到 V-JEPA 2 的 ViT-S 的一半。5
三个尺寸摊开,这个优势从 ViT-L 的 5.6 倍一路拉到 ViT-S 的 20.8 倍。5
模型卡换了一组基线:算力只要 V-JEPA 1 的 1/5.6,数据只要它的 1/25.7;对 V-JEPA 2,算力约 1/28.5,数据 1/321。4
帖子用的是后者。1
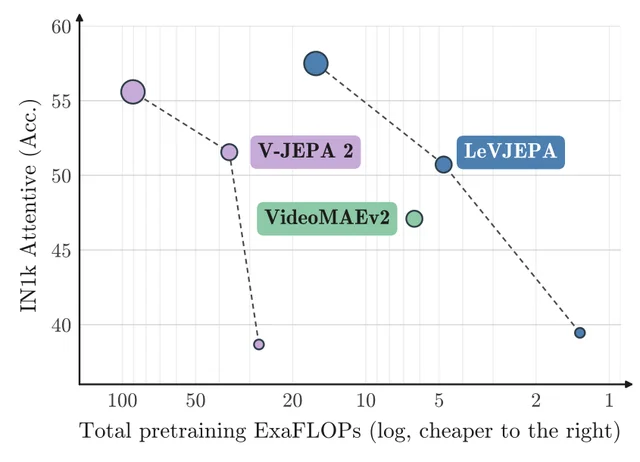
这两个分母都查不到原始出处。
V-JEPA 1 的论文只写了 A100 80G、90,000 次迭代、批 3,072,没有任何 FLOPs 或 GPU 小时。10
V-JEPA 2 只写了「全程按最终分辨率训练的话,ViT-g 要 60 GPU 年」和「渐进分辨率带来 8.4 倍加速」,没有实际总消耗。11
模型卡给 V-JEPA 2 的约 4,300 EF 自己标了 estimate,给 V-JEPA 1 的 844 EF 什么也没标。4
EF 是 10¹⁸ 次浮点运算。模型卡把总量写成 151 exaflops,论文图 2 的横轴写成 ExaFLOPs,两个说法指的是同一个量。
这两个数字对应两种不同的训练:36.4 是 20% 子集上重训 ViT-B 的量,4,300 是全量预训练 ViT-g 的量。
能逐项对上的只有论文那一组。
还有个附带效果:「一个数量级以上更少的数据」说的是 25.7 倍,同一张表另一栏写的是 321 倍。4
07 真正白送的是因果性
块因果注意力没有换来更差的表示,这才是这一版最值钱的结果。
块因果的意思是:同一帧内的 token 彼此看得到,跨帧只看得到前面的帧。
论文在 ImageNet-1K 的冻结注意力探针上比了两种注意力:帧内双向、跨帧双向的拿到 50.7,帧内双向、跨帧因果的拿到 51.2。5
那个 50.7 就是 03 节均匀丢 token 的配置,两个数是同一套设置里的两个变体。5
因果掩码把未来的 token 从每个 token 的感受野里拿掉,表示本该变差,实测反而高了半分。5
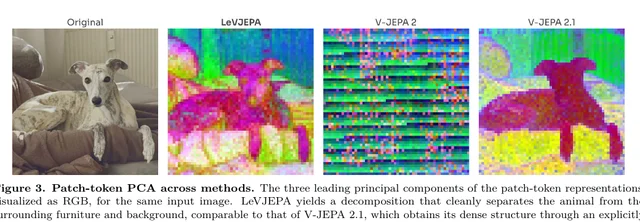
图 3 那四栏说的是同一方向的另一件事。
Meta 2026 年 3 月的 V-JEPA 2.1 是 V-JEPA 2 的续作。
它的补丁结构是加了一项损失换来的:稠密预测损失不只算被遮住的 token,也算可见的 token,还铺到四个层级。12
LeVJEPA 只监督了一个 [cls]。5
这对机器人那条线有直接用处。
V-JEPA 2 做控制时冻结编码器、逐帧送进去,再单独训一个以动作为条件的块因果 predictor。11
LeVJEPA 的意思是这一步可以并进预训练:编码器出来的每一帧表示,本身就只看当前和之前的帧。新的一帧进来,前面那些不必重算,这就是流式。5
这条对 AMI Labs 尤其要紧。它是 LeCun 2026 年 3 月成立的初创,融资 10.3 亿美元,对外说的是做一种可控的世界模型,预测发生在抽象表示里。13
把这版权重读成 AMI 的产品计划,就走远了。
AMI 官网首页和 Updates 页全文,streaming、real-time、latency 三个词一次都没出现。14
流式是论文第 6 节和仓库 README 里的技术主张,公司口径里还没有这句话。5
08 放出来的比八月那版更难用
新仓库只有三个文件,其中一个是 4.88 GB 的训练检查点。
Hugging Face 上那个仓库只有三个文件。
除 .gitattributes 和 README 之外,就是一个叫 videomix_vitl_bc_1sqrt_v2_final.ckpt 的权重。4
没有 config.json,没有建模代码。4
模型卡给的两种加载方式里,AutoModel 那条路要的正是这两样;能跑通的是仓库自己的 load_legacy_encoder。15
八月那版反过来:1.21 GB 的 safetensors,配 config.json 和 modeling_levjepa.py。6
代码仓库也只有一次提交,时间戳是 11 月 2 日 18:15 UTC。八月那版的提交历史不在里面,旧的 v1 代码以文件形式留在 legacy/ 目录下。15
许可上,权重是 CC BY-NC 4.0,代码是 MIT。4
仓库现在有 285 颗星、13 次 fork。15
传播面比八月小得多。
这条帖 4.77 万浏览、513 个赞;同线程后面五条自回帖,浏览量掉到 845 到 1,347。1
八月首发时 LeCun 转的那条,父帖是 16.4 万浏览。16
Hacker News 上有人贴了权重链接,2 分、1 条评论,评论是发帖人自己补的作者线程。17
这次发布到现在,技术媒体里没有搜到一家写过。八月那篇论文,AINews 在 8 月 31 日那期有过一段。18
09 该盯什么
四件事,按先后排。
第一是 Diving-48 那一格。39.46 和官方 90.1 差 50 分。
第二是第三方复现。这张表目前只有一组人跑过。
第三是 v2 的权重。仓库已经把流式编码器写好了——滑动窗口、三维 RoPE、QK-norm——放出来的仍是从前那版编码器。15
第四是 AMI 的公开材料里会不会出现「流式」「实时」。论文先写了,公司还没写。14
差距补上了,省 5.6 倍,比上一版好,谢谢合作者——这条线程就说了这些。
因果性那件事不在里面。
References
- 1Lukas Kuhn on X
x.com
- 2Yann LeCun on X
x.com
- 3LeVJEPA · arXiv:2608.27395
arxiv.org
- 4galilai-group/LeVJEPA-1.5-Large · Hugging Face
huggingface.co
- 5LeVJEPA 论文 PDF(v1)
arxiv.org
- 6galilai-group/LeVJEPA-VideoMix-Large · Hugging Face
huggingface.co
- 7LeVJEPA 项目页
levjepa.github.io
- 8MedMNIST v2 · arXiv:2110.14795
arxiv.org
- 9MedMNIST 官网基线表
medmnist.com
- 10V-JEPA · arXiv:2404.08471
arxiv.org
- 11V-JEPA 2 · arXiv:2506.09985
arxiv.org
- 12V-JEPA 2.1 · arXiv:2603.14482
arxiv.org
- 13Yann LeCun's AMI Labs raises $1.03B · TechCrunch
techcrunch.com
- 14AMI Labs
amilabs.xyz
- 15MLO-lab/LeVJEPA · GitHub
github.com
- 16
- 17Hacker News 50342202
news.ycombinator.com
- 18AINews, 2026-08-31
news.smol.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.