LeCun 说定理对 SIGReg 与 VCReg 都成立:论文里,一个的约束是假设,一个只是极限
LeCun 在一篇 77 万浏览的解读帖下回了两帖;把这两次改写逐句对回论文,SIGReg 的全分布约束是作者留下的假设,VCReg 只在白化极限下成立,而「人不用词思考」那套机制在论文里一次都没出现。

北京时间 11 月 2 日零点三十三分,一个叫 Shruti 的账号在 X 上发了一条帖。1
帖子说,Yann LeCun 一直是对的,只是这个行业没人愿意把它大声说出来。1
它讲的是 10 月 29 日挂上 arXiv 的那篇论文:《用 JEPA 证明并改进柏拉图表示假设》。2
柏拉图表示假设是 2024 年提出的:不同模态的模型只要训得够大,会收敛到同一个世界表示。那篇论文只有猜想,没有证明。3
JEPA 是联合嵌入预测架构,预测发生在表示里,不在像素里。3
三个小时后,LeCun 在帖子下面回了一段话。4
十三秒后,他把那条帖转了出去。5
同一天傍晚六点半,他又回了一段,这回讲的是人怎么思考。6
论文有两位作者,下场回帖的是 LeCun 本人。他两次都没有反驳数字,第一次把结论往回缩了一格,第二次换了个理由。
这条线程值得单独拆,因为它同时装着三样东西:一条被放大的二手解读、作者自己的两次改写,以及论文里那些带限定语的句子。
01 六个数字,全对;错的是那句结论
唯一站不住的那句,正好是整条帖的结论。
先给这条帖打一次分。
「1.09 亿参数打赢 720 亿」,对。尺子是 WIT-1024 上的 mutual 10-NN:109M 的文本 JEPA 拿 .184,Qwen2.5-72B 是 .154,Llama-3-70B 是 .151。3
这个指标量的是邻居重合:一个样本在一个模态里的 10 个最近邻,有几个在另一个模态里也是它的 10 个最近邻。取值在 0 到 1 之间,差 0.03 已经是不小的距离。3
「660 倍」,对。72 除以 0.109,660.6。3
「上周四发表的证明」,对。10 月 29 日就是周四,arXiv 上的 v1 就挂在那天。2
「11 月离开 Meta」,也对,不过是 2025 年 11 月 19 日宣布的。7
「在巴黎开了自己的实验室」,对,但只说了一个城市。他在同一天早些时候的另一条回复里列过四个办公地:巴黎、蒙特利尔、新加坡、纽约。8
「2160 万对 9 亿个样本」,对,这是论文摘要里的 42 倍。3
错的是那句总结:「the proof says size was never doing the work」。
论文原话是「Positive views, and not scale alone, are thus the lever」。意思是:规模不是唯一起作用的东西。3
帖子把它读成:规模从来不起作用。
这两句之间差着一整套实验设计。
而且定理是一条总体陈述(population statement)——它描述的是数据无限多时的解,不是某一次训练跑出来的权重。3
作者的已知局限一节写明,它要求有限世界、单射渲染、各模态边缘分布相同。参数规模根本不在定理的变量里。3
定理没写规模,不等于定理否证了规模。
02 回复一:四个名词,两个不在论文里
陈述性知识与理解,全文零次;SIGReg 与重建在,但都带着限定语。
LeCun 那段回复不长,结构很清楚。
先是让步:LLM 积累了大量陈述性知识,所以能回答很多问题,也所以需要那么多参数和内存。4
然后是转向:「但人可以用理解替换知识的积累。这就是 JEPA 世界模型做的事。」4
最后是收窄:「这篇论文只是表明,数据的底层相似结构——不管是文本还是图像——唯一地决定了表示点云的形状,前提是编码器用一个常见的反坍塌准则训练,比如 SIGReg 或 VCReg(不是靠重建)。」4
这段话是随手敲的,原文里有个「trained trained」,重复了一次。
四个名词里,陈述性知识与理解在论文里一次都没出现。全文 37 页,knowledge 与 declarative 各零次。3
SIGReg 和重建在论文里有对应,但都带着限定语。VCReg 那个名字要多说一句,下一节单独讲。
下面三节,一节对 SIGReg,一节对 VCReg,一节对「不是靠重建」那半句。
03 被证的是「白化」这一类
命题 1 的适用范围只有两步:把嵌入白化,谱上留一道缝。
论文的目标函数是两项相加:一个预测项,一个反坍塌项,作者编号为式 1。3
命题 1 把它写死:反坍塌项把嵌入白化——均值归零、协方差变成单位阵——预测项取平方距离,那么最小化解恰好是正样本图的谱嵌入。3
谱隙是第二个条件:正样本图相邻两个特征值之间要有一道明显的落差。没有这道缝,最小化解不唯一,定理给不出「只差一个旋转」。3
引言里的自述更省事:「as we prove for whitened JEPAs under a spectral gap」。3
被证的这一类,是白化过的 JEPA。
SIGReg 在这个框架里只以一个身份出现:它的目标分布是各向同性高斯,旋转不变,二阶矩与白化相同。3
它真正的约束——整条分布的形状,而不只是前两阶矩——论文原话是「Proposition 1 does not cover uniqueness under its full-distribution constraint, which we leave as an assumption」。3
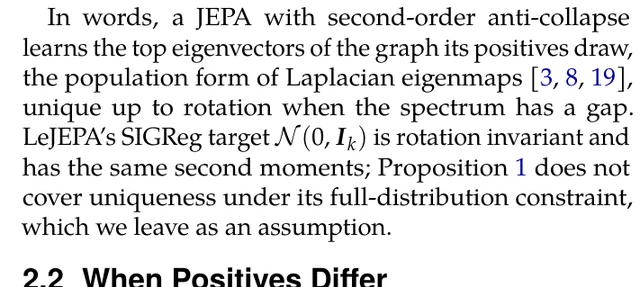
于是回复里那个「比如 SIGReg 或 VCReg」,严格读只成立到二阶矩为止。
这不是文字游戏。二阶矩和整条分布之间,差着「嵌入是不是高斯」这个可测的性质。
04 VCReg 只在白化极限下算数
两个名字都不是定理的成员,而是同一个条件的两种逼近。
回复里写的名字是 VCReg。
论文里没有这个词,出现零次;论文用的是 VICReg,方差—协方差正则,出现两次。3
附录 A.1 那段比正文更清楚:「VICReg(均值固定)与 Barlow Twins(λ=1)只在一个白化硬约束极限下属于这个形式,在那里它们的最小化解就是命题 1 的那些解;而两者都平移不变,只有中心化之后才对得上。」3
被点名的四个方法——谱对比学习、白化 MSE、VICReg、Barlow Twins——只有前两个原样成立。后两个要取极限,还要先做中心化。3
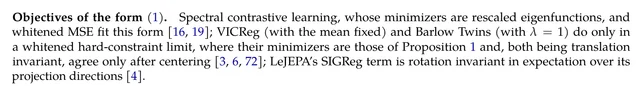
所以两个名字都不是定理的成员,而是同一个条件的两种逼近:把嵌入的协方差推成单位阵。
方向没错。反坍塌准则的共同核心确实是二阶白化,论文的命题也只用到这一层。
字面不成立。回复里的这个举例,把两类方法说成了定理的直接对象。
05 「不是靠重建」限定的是定理,不是重建
式 1 里没有解码器;但作者自己的表 18 里,重建与潜变量预测对齐得一样。
括号里那半句「not by reconstruction」,在定理这一侧是对的。
式 1 只有预测项和反坍塌项,没有解码器,也就没有像素重建的位置。3
但论文的实验给了另一面。
表 18 把冻结的视觉编码器按训练目标分成四类:像素重建(MAE)、块间潜变量预测(I-JEPA)、裁剪(DINOv2)、图文对比(CLIP 的视觉端)。3
图注的原句是:「MAE and I-JEPA align alike, both below DINOv2 … we draw no conclusion on the vision objective.」3
翻译过来:用重建训出来的编码器,和用潜变量预测训出来的,在这把 mutual 10-NN 的尺子上对齐得一样。
作者自己说了,他们不对视觉目标下结论。
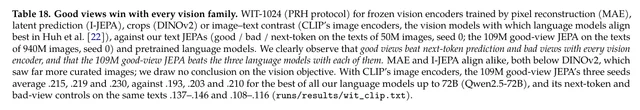
所以「不是靠重建」限定的是定理的形状,不是重建的能力。
把它读成「重建学不出世界表示」,超出了作者写的范围。
06 回复二不在论文里
决定表示的是你拿什么和什么配成一对,不是模态。
傍晚那段回复讲的是人。
「人类大多不用词思考。动物当然不用词思考,但它们确实在思考。」6
接着是机制:「词只是与思想相关联的离散对象。正是这种离散性,让它们容易存储和记住。这造成了我们用语词思考的错觉。」6
论文里没有这套东西。discrete 与 discreteness,全文零次。3
论文给出的原因不是离散与否,而是配对:你把哪两样东西当成同一场景的两次观测。3
它自己的图 1 画得很直白:好视图是同一个场景的两张照片,或者同一个场景的两段描述。3
跑赢 720 亿参数的那个 1.09 亿文本模型,训练数据就是后者——同一张图的两段文字。它全程没见过图像,吃的全是词。3
如果障碍是「词是离散标签」,那用词训练就该慢。它不慢。
慢的是拿同一篇文档里的两段话当正样本,也就是下一词预测。论文用命题 4 把它形式化:下一词预测是一个正样本为坏视图的 JEPA。3
这条区别有可检验的后果。若障碍在离散性,换模态能解决;若障碍在配对,换配对才能解决。论文只支持后者。
回复里还有半句可以用论文之外的证据去核:「许多不能说话的人依然能思考。」
这句话站得住。一篇 2016 年的综述汇总了失语症与神经影像的证据:全失语症患者——语言理解与产出几近全失——仍能做加减、解逻辑题、推断他人想法;重度语法缺失的患者能做带括号的精确算术。9
同一篇顺手回答了反方向:语言也不是推理的充分条件,前额叶受损而语言完好的患者,推理照样出问题。9
两组证据合起来说的是同一件事:语言既不是必要条件,也不是充分条件。
07 同一个结论,他换过三次机制
三种理由都指向「文本不够」,论文用的是第四种。
「知识多但不理解」这个判断不是新的。
2023 年 10 月 28 日,他写过:如果未来的系统还建在自回归 LLM 的蓝图上,它们可能变得非常有知识,但仍然很笨。10
那时他给的理由是能力:不能推理、不能发明、不能规划。没有提到论文。
2024 年 1 月 25 日,他换成了带宽:一个四岁小孩醒着的四年里接收的信息是 10¹⁵ 字节,最大的 LLM 是 10¹³;「文本这个模态带宽太低、也太稀缺,学不会世界怎么运转」。11
2026 年 11 月 2 日这次,他给的是第三个理由:离散性。词是离散的,离散的东西好存;存得住,就让人误以为思考是在用词。6
三种机制都指向同一个方向,可它们要的对照实验不是同一个。带宽论比的是信息量,离散论比的是表示形式。
论文用的是第四种:比正样本怎么配。
前两种能不能也成立,这篇论文回答不了。
08 同行怎么接
共同作者自己说,SIGReg 不是最终答案。
Randall Balestriero 在 11 月 3 日凌晨发了一条:「SIGReg 不是最终答案,但肯定是朝那个方向的第一步。」12
LeCun 转发了它。13
作者之一把 SIGReg 说成「第一步」,另一位作者在回复里把它当成「常见准则」的例子。两个说法不冲突,重量不一样。
除了自己的论文,LeCun 这一周还在转另一类东西。其中一条 12.9 万浏览的帖说:「AI 行业七十年来犯同一个错误:机器能做人觉得复杂的事,就被认为比人聪明。」14
对立面一直都在。斯坦福的 Christopher Manning 在 2026 年 9 月 27 日一期播客里的标题就是「语言才是智能的真正解锁」。15
一边说思考不需要词,一边说语言是解锁。两边都不缺论据,缺的是同一把尺子。
09 这条线程真正的行业含义
尺子量的是表示像不像,不是知道多少。
论文的尺子是跨模态的表示相似度:WIT-1024 的 mutual 10-NN、COCO 检索、STS-B、ImageNet-100。3
里面没有一道题在问「这个模型知道什么」。
所以「用理解替代知识的积累」在这篇论文里没有对应的测量。它是一个合理的推断,不是结果。
规模也一样。42 倍是样本效率,不是参数效率;定理里干脆没有参数这一项。3
纠正的成本比断言高,这不算新闻。
只是这一次,纠正的人里有论文作者本人。
这条线程里最硬的一句其实来自论文,不来自任何一条帖:好坏视图是可以选的,同一个场景的两张照片,或者两段描述。
至于人是不是用词思考,那是另一个问题。
References
- 1Shruti on X
x.com
- 2
- 3论文 PDF(v1)
arxiv.org
- 4Yann LeCun on X
x.com
- 5Yann LeCun 转推
x.com
- 6Yann LeCun on X
x.com
- 7
- 8Yann LeCun on X
x.com
- 9Language and thought are not the same thing · PMC
pmc.ncbi.nlm.nih.gov
- 10
- 11
- 12
- 13Yann LeCun 转推
x.com
- 14haider1 on X
x.com
- 15
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.