AI Agent 运营工具周报:把稿子变成声音、竖屏和双语版,6 个转制入口
同一份内容发成别的形态这一步,该交给规则还是模型:按「变成声音、换成竖屏规格、译成另一种语言」三段盘点 6 个能被 Agent 直接调用的转制入口,逐个给出安装入口、计费方式与平台边界。

上期停在动笔之前,看的是这周该写什么。这一期挪到稿子定稿之后:同一份内容,还得变成能听的版本、能竖着刷的版本、另一个语种的人看得懂的版本。
换形态这件事,做一次不难,做成一条能反复跑的流程,要先把三件事定下来。
第一件,这一步交给谁做。让模型重新生成一遍,还是让规则照规格切,结果差得很远。
第二件,钱花在哪。有的入口在本机跑完不花钱,有的按秒计费,有的按次调云端接口。
第三件,换完之后平台认不认。画幅、字幕安全区、AI 生成标识、语种,每一道都有平台自己的规矩。
真正决定选哪个的,是转制这一步由谁执行:规则、模板加模型、托管语音模型、本地模型,还是云端识别服务。同样是「把横屏变成竖屏」,一条按规格裁,一条让模型重画,输出能差出一条街。
| 入口 | 一句话定位 | Agent 接入形态 | 转制方向与工序 | 硬边界与成熟度快照 |
|---|---|---|---|---|
| podcastfy | 把网页、PDF、长文变成一集双人对谈音频 | Python 包与 CLI,generate_podcast 直接调 | 文字 → 声音:写对话稿,再合成多语种音频 | Apache-2.0;PyPI 停在 0.4.3、2025-12-09,仓库最近提交 2026-05-04 1 |
| kesha-voice-kit | 本机转写与配音的单二进制工具 | CLI、kesha mcp、OpenClaw 技能、编程接口 | 声音 → 文字 / 文字 → 声音:都在本机完成 | MIT;78 star,最近提交 2026-10-18,中文配音只在 macOS 2 |
| ffmpeg-skill | 把 FFmpeg 拆成一组带类型参数的工具给 Agent 用 | 技能包 + 由契约派生的 MCP 服务 | 横屏 → 竖屏:切、重构图、字幕、按平台导出再自检 | MIT;1,988 star,最近提交 2026-10-17,依赖本机 FFmpeg 3 |
| ClipForge | 一张商品图或一句话,出一条平台的卖货短视频 | 网页、CLI、MCP、Agent 技能共用一套能力 | 图/文案 → 成片:脚本、分镜、配音、字幕、多平台导出 | AGPL-3.0;1,027 star,最近提交 2026-10-08,AI 档按秒计费 4 |
| audio-transcribe-cli-mcp | 中文音视频转文字,带说话人和时间码 | asr 命令行 + 内置 MCP 服务 | 声音 → 文字:取字后再决定翻成哪种语言 | MIT;1 star,v0.1.2 发布于 2026-10-08,音频要上传到云端 5 |
| subforge | 字幕从转写到烧录的一条可重跑流水线 | Rust 命令行,transcribe、translate、process、batch | 一种语言 → 另一种语言:断句、翻译、质检、烧录 | MIT;104 star,v0.2.0,需源码编译 6 |
表里的 star 数与最近提交,取自 2026 年 10 月 19 日打开仓库时的页面快照,只反映当时的状态。
一、把稿子变成能听的一集
一篇文章做完,最长的那条尾巴是「再录一遍」。这一节两个入口,一个替你写对话稿并合成音频,一个在本机把文字念出来。
podcastfy:一篇稿子进去,一集双人对谈出来
souzatharsis/podcastfy 把自己定位成 NotebookLM 播客功能的开源替代:多模态内容进,多语种音频对话出 1。输入可以是网页、PDF、图片、YouTube 视频,也可以只给一个主题 1。
它背后的链路是两步。先让 LLM 把素材改写成一段两人对谈的稿子,再交给 TTS 合成音频 1。
这两步都能换。LLM 侧接 OpenAI、Anthropic、Google 等一百多个模型,也能跑本地模型;TTS 侧接 OpenAI、Google、ElevenLabs 和 Microsoft Edge 1。
README 里另列了两条可选路径:跑本地模型,或把 TTS 换成 Microsoft Edge 那一档 1。
对运营最有用的一个配置是
longform。README 的示例用它跑过一段五小时的访谈,这个档位处理的是一本书、一场长访谈这种体量 1。- 典型使用场景:把一篇读完要二十分钟的行业长文,压成一集八到十分钟的对谈节目,挂到播客或视频号上;或者把几篇同主题的竞品分析喂进去,做成一期对照节目。
- 安装与接入:
pip install podcastfy,装完先配模型和语音两边的 Key。命令行是python -m podcastfy.client --url <地址>,Python 里直接generate_podcast(urls=[...])7。 - 硬边界:Apache-2.0。这半年它慢了下来——仓库最近一次提交是 2026-05-04,PyPI 上的最新版 0.4.3 发布于 2025-12-09 8。它自己不出模型也不出音色,对谈稿的质量取决于你接的 LLM,声音取决于你接的 TTS,两边的调用费也都算在你账上。
kesha-voice-kit:把「念出来」放在自己机器上
drakulavich/kesha-voice-kit 是一个约 65MB 的 Rust 单二进制,不依赖 ffmpeg、Python 和原生 Node 插件 2。转写支持 25 种语言,配音支持 9 种;同一台机器上,转写和合成都不出网 9。
给 Agent 的口子是
kesha mcp,把转写、合成、列出音色三个工具暴露给任何 MCP 客户端 10。它另外还有 OpenClaw 技能和一个 Raycast 插件。这条路的价值在成本:一条稿子要念十遍、改二十遍,本机合成没有按次计费这一层。
- 典型使用场景:把一篇稿子的正文念成口播音轨,直接拖进剪辑软件配上画面;或者把一段会议录音丢进去,先拿到带时间戳的文本,再决定要不要做字幕。
- 安装与接入:先装 Bun,再
bun add -g @drakulavich/kesha-voice-kit,然后kesha init引导下载引擎和模型 2。 - 硬边界:MIT。语言支持按平台分档,中文、日文、印地语的配音只在 macOS 上可用,Linux 和 Windows 只有英、俄、西、法、意、葡六种 9。说话人分离和麦克风录音同样只限 macOS,Intel Mac 没有可用的引擎二进制 11。首次下载模型约 2.5GB(Linux 与 Windows),Apple Silicon 上约 0.6GB。
二、横屏变竖屏:一条素材,多套平台规格
同一条片子要在四个平台各发一遍,差别先落在画幅和文案上。
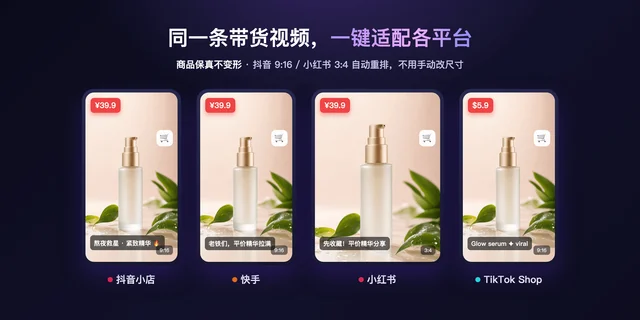
docs/showcase-platforms.png。四格用的是同一个商品镜头:抖音小店、快手、TikTok Shop 都是 9:16,小红书那格是 3:4,画面下方的文案也各写各的——「熬夜救星 · 紧致精华」走功效,「老铁们,平价精华拉满」走口播腔,「先收藏!平价精华分享」是收藏引导,最后一格换成英文。同一个素材,四种平台语气。4这一节两个入口走的是两条路。一个只按规则切,切完自己检查;一个按模板让模型生成,生成完顺手把平台合规也过一遍。
ffmpeg-skill:把 FFmpeg 拆成一组带参数的工具
kajisho5/ffmpeg-skill 做的事情很窄:把 FFmpeg 拆成 42 个带类型参数的操作。每个操作是一个脚本,调用时不经过 shell,也不接受调用方传进来的滤镜串 3。它交给 Agent 的核心是一份契约。
npx ffmpeg-skill contract --json 会列出每个工具吃什么参数、写出什么文件、需要哪个 FFmpeg 组件、结果怎么验收,MCP 那一侧的接口就从这份契约派生 12。一条典型的竖屏改造链路,README 里写得完整:
probe.py 先量原片的时长与分辨率,cut.py 按时间码切段,fit.py --aspect 9:16 --fit crop 重构图。交付模板是现成的,覆盖
tiktok、reels、shorts、youtube-shorts、youtube、x、linkedin、facebook 和 podcast,一条命令就能出一整套社交版本 3。检查器值得单独说一句。
check.py 按平台规格给出 PASS、WARN、FAIL,每一项失败都附修法,这样 Agent 才可能自己把片子改到能发 3。- 典型使用场景:一条四十分钟的访谈,切三段两分钟的竖屏片段;或者把已经剪好的横屏成片,一次导出六七个平台的规格,省掉手改尺寸那一步。
- 安装与接入:
npx ffmpeg-skill装进 Claude Code,--cursor、--codex或--all指定宿主;装完先跑npx ffmpeg-skill doctor看本机缺哪个 FFmpeg 组件。也可以用插件方式claude plugin install kajisho5/ffmpeg-skill3。 - 硬边界:MIT,本地跑,无云依赖、无 API Key。macOS 上要用
brew install ffmpeg-full,普通ffmpeg公式缺 subtitles、drawtext 和 zscale 三个滤镜 3。交付模板里没有抖音,要按 9:16 自己套规格;重构图也不自动追主体,cropdetect.py --motion-centre只报每秒的运动重心,裁在哪由调用它的 Agent 决定 3。切哪一段、字幕写什么,同样不在它的职责里。
ClipForge:一张商品图,出一个平台的卖货短视频
xixihhhh/clipforge(原名「带货剪手」)走的是另一条路:输入一张商品图或一句主题,输出一条能直接发抖音小店、快手、小红书、视频号或 TikTok Shop 的竖屏短视频 4。部署只要一行:
docker run -d -p 3000:3000 -v clipforge-data:/data ghcr.io/xixihhhh/clipforge 4。打开
localhost:3000 就能出第一条片。免费素材加免费配音,不配任何 Key 也能跑通一遍 4。它内置 391 款电商配方模板,工厂溯源、发疯文学、毒舌奶奶体这些风格都在里面,按商品类目和卖点推荐 4。
生成时它先出九宫格分镜,把人物、场景、商品在一次生图里锁定,再按分镜出整片 4。
分镜和成片之间还有一道「判官」:一组判官逐句挑刺,有问题的句子当场重写,改完才开拍 4。
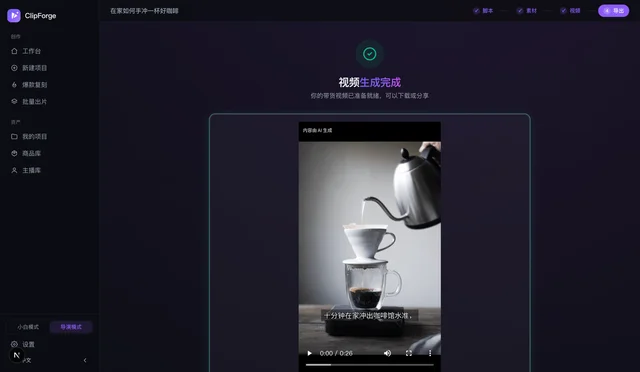
docs/screenshots/05-export.png,是「视频生成完成」这一页。顶部四个步骤停在「导出」,右侧是 9:16 的成片预览,播放条显示 0:26。画面左上角那行「内容由 AI 生成」烧在成片画面里,会跟着片子一起发出去;画面下方那一行是自动生成的中文字幕。4国内平台这一块,它把合规做成了默认项。成片默认烧录 GB 45438-2025 要求的显式角标,同时写入隐式文件元数据;出片前扫一遍广告法违禁词,再给一份发布门禁报告 4。
它还按抖音 2026 年 7 月的规则单列了三类提示。对比测评风格可能被算作「AI 生成测评类内容」;数字人进不了医疗、金融、美容功效、保健功效、教培效果五个类目;人物台词里出现「亲测有效」式的宣称,贴近伪造使用效果这条红线 4。
- 典型使用场景:几十个 SKU 要各出一条十五秒种草片,一个人一天出一条的节奏走不动;或者把一条中文成片换成英文配音,同一画面发到 TikTok Shop。
- 安装与接入:Docker 一条命令起服务,浏览器里传图、贴商品链接或写主题。给 Agent 的入口有 CLI 的
create和 MCP 的create_video,与网页共用同一套能力,也支持wait:false的非阻塞提交 4。 - 硬边界:AGPL-3.0。这份许可的要求是,改动之后无论再分发,还是把改过的版本作为网络服务对外提供,都要按同一协议开放源码 13。AI 档按秒计费,钱付给你自选的模型平台,出片前的 dryRun 会先给预估价和单次花费上限;免费档只走免费素材与免费配音 4。它的本事集中在电商成片,给它一段已经剪好的访谈要它改镜头,用不上。
三、换一种语言发出去:先取字,再换语
真人出镜的片子要出多语种版,工序是固定的两道:先把说的话变成文字,再让文字变成另一种语言。两个入口各管一道。
audio-transcribe-cli-mcp:把中文音视频变成带说话人的文字
OstrichHermit/audio-transcribe-cli-mcp 是一个小工具,做的是把音视频转成文字,同时给命令行和 MCP 两种形态 5。转写走的是阿里云百炼的录音文件识别接口,qwen-audio-asr 系列和 paraformer 都在支持范围里。
长音频不用自己切片,一次上传整段跑完,临时存储用完即删 5。
输出的约定对 Agent 友好:
--timestamps 给逐句起止时间,stdout 只出转写文本,进度、耗时和计费估算全部走 stderr 5。- 典型使用场景:运营群里积累的微信语音要变成可检索的客户反馈;或者一条中文口播视频要先拿到带时间码的稿子,再做双语字幕。
- 安装与接入:
pip install audio-transcribe-cli-mcp,装完得到asr和audio-transcribe-mcp两个命令。Key 在阿里云百炼控制台创建,填进DASHSCOPE_API_KEY14。 - 硬边界:MIT,版本 0.1.2,2026-10-08 发布 15。仓库 2026-09-22 才建,1 star,成熟度要靠自己的一次验证来定。音频要上传到百炼处理,按量计费,数据出了本机;只在转写 SILK 文件时需要
uv。
subforge:把字幕做成一条能重跑的流水线
deusjin/subforge 是一个 Rust 命令行工具,把字幕生产的六个环节串成一条链:语音识别、断句、翻译、质量估计、烧录或封装 6。链上每一环都能单独跑。只翻字幕不动画面,用
subforge translate video.mp4;要整条链,用 subforge process;一次处理一个文件夹,用 subforge batch translate videos/ -o out 6。它的取舍落在术语一致性上。翻译后端支持 Google、Bing 和 OpenAI 兼容接口,长视频走波次并发,另外用一套术语抽取和项目级翻译记忆把专有名词固定住 6。
质量那一环也做进了链路:用 GEMBA-MQM 给每句译文打分,低分句再定向重译一遍 6。
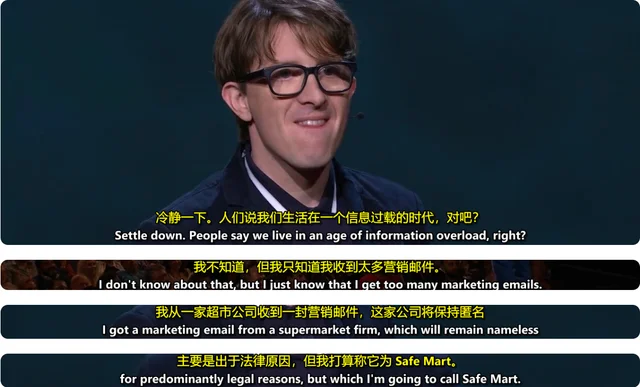
assets/result.png,是双语字幕烧进画面后的成品帧。四段字幕,每段上面一行中文、下面一行英文,两句对照着排;字幕压在演讲者胸口的深色背景上,没有遮住脸。这一帧能看出它的断句粒度:一句说完就断,中英各占一行。6- 典型使用场景:一门课、一场直播回放要出中日双语版;或者一条已经发过的中文视频,补上英文字幕投到海外平台。
- 安装与接入:目前要源码编译。装 Rust 1.88 以上、Python 3.9 以上和 ffmpeg,
cargo install --path .之后跑subforge setup建本地环境 6。 - 硬边界:MIT,版本 0.2.0,作者自己写明「能用,但还早」,预编译二进制还没发 6。转写默认用本地的 faster-whisper,模型权重首次运行才下载;译文质量取决于你选的翻译后端和术语表做得细不细,这一层需要人看一眼。
这 6 个怎么排顺序
先动
ffmpeg-skill。它在本机跑,不花钱,验收有明确的 PASS 与 FAIL。拿一条旧片子把 9:16 跑通,你就知道后面所有出口的规格底线在哪。第二步取字。素材是中文口播的,先用
audio-transcribe-cli-mcp 拿到带时间码的文字,再决定要不要换语种。这一步的产物是后面所有形态的原料——字幕、双语版、图文、对谈稿,都从这份文字长出来。字幕要出多语种,接
subforge。它值得先单跑一次 translate,看译文质量和术语表差多少,再决定要不要走整条 process。换媒介这一步,
podcastfy 最省事,代价是要配两套 Key。先拿一篇自己写过的最长的文章试,听它对谈稿写得像不像人说话;不像的话,问题在 LLM 那一侧,换模型比换工具快。ClipForge 放到要出量的时候。它按秒计费,合规那一层是替抖音、快手、小红书准备的,账号不在这几个平台的可以直接跳过。kesha-voice-kit 按机器条件决定。手上有 Apple Silicon 的 Mac,它能把转写和配音都留在本机;Linux 和 Windows 上,中文配音这条路走不通。这 6 个入口共有一件事:它们只做转制。哪一版能发、哪一版会限流、哪句话翻得不像人说的,判断还在人这边。
References
- 1souzatharsis/podcastfy
github.com
- 2drakulavich/kesha-voice-kit
github.com
- 3kajisho5/ffmpeg-skill
github.com
- 4xixihhhh/clipforge
github.com
- 5OstrichHermit/audio-transcribe-cli-mcp
github.com
- 6deusjin/subforge
github.com
- 7podcastfy CLI 用法
github.com
- 8podcastfy on PyPI
pypi.org
- 9kesha 支持的语言
github.com
- 10kesha 的 MCP 说明
github.com
- 11kesha 的平台矩阵
github.com
- 12ffmpeg-skill 的执行契约
github.com
- 13ClipForge 的 LICENSE
github.com
- 14阿里云百炼控制台
bailian.console.aliyun.com
- 15audio-transcribe-cli-mcp on PyPI
pypi.org
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.