「数据库在扫全表」和「加了索引还是慢」,中间隔着两趟路
全表扫描和加索引,是找同一行的两条路。这篇讲清数据库按页搬数据、索引是排好序的目录、以及为什么加了索引还要回表,于是你要问的是「翻了几页、回了几趟」。

上一篇的落点是:几笔改动圈在一起,要么一起算,要么一起不算。
圈里要改的那一条记录,是从几千万行里找出来的。找它花了多久,决定这个功能还能撑多久。
周四上午,群里一句:
「订单列表越来越慢,数据库在扫全表。」
下午又一句:
「加个索引吧,加完就好了。」
这两句话,一句说它现在怎么找,一句说打算怎么改。
我们对数据库的默认印象,是一行一行排着的长队;找一行,就把前面读过去。
实际存的是一页一页的纸,一次至少搬一页。
数据库是那个专门记账、能按条件把记录查回来的软件。同类数据放在一张表里,一行是一条记录,一列是记录里的一项。
当天要定的事,落在这三问上。
一、它在翻页,还是在跳目录?
二、那本目录,是按你现在查的东西编的吗?
三、跳过去之后,还要回头搬几趟?
三问的答案把处置分成三种:先记个数别动、批准加索引但连执行计划一起看、换个查法。
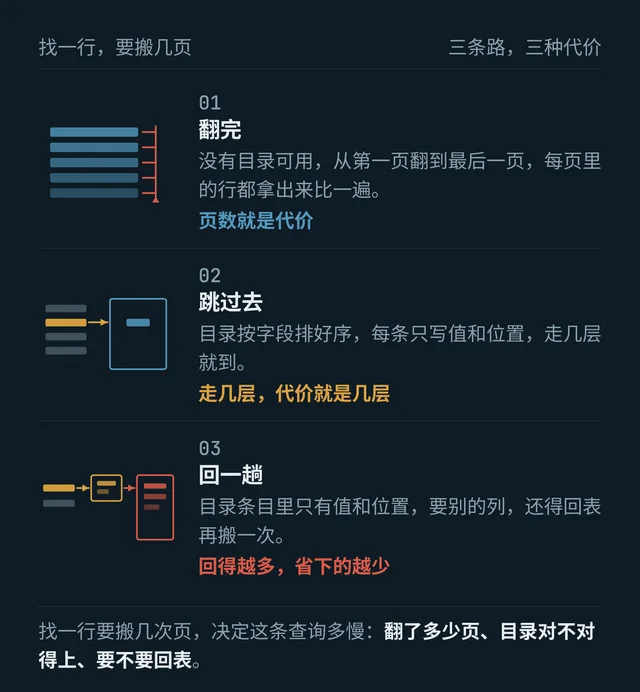
示意图由本文绘制。三条路对应三问的第一问和第三问:蓝色是被读的页,琥珀是目录里的位置,红色是索引多出来的那一趟。
01 搬页
PostgreSQL(一个常见的开源数据库)的文档写:每张表和每个索引,都是一页一页存起来的,一页通常是 8 kB。1
一页装几十行。文档里那张一万行的示例表,存在 345 页里。2
所以「读一行」的真实成本,是「搬一页」。慢不慢,看的是这条查询一共搬了几页。
没有目录可用时,数据库只剩一条路:从第一页翻到最后一页,每页里的行都拿出来比一遍。2
这一步有个名字,叫全表扫描。
数据库动手前会先排一份计划,说明它打算走哪条路。EXPLAIN 这条命令,就是让它把这份计划说出来。2
计划里的数字是代价,单位默认就是「读一页算 1」。2
拿那张一万行、345 页的示例表算:翻完 345 页记 345,再把一万行逐行比一遍,按每行 0.01 记 100,合计 445。2
一万行就 345 页;你的订单表三千万行,页数是它的三千倍。
你会听到:「全表扫描」「这张表扫了一遍」「数据量上来了就这样」。
问什么:这张表现在有多少页?
02 编目
索引是一本目录,按某个字段的值排好序。每条写着两样东西:这个值,和它在第几页第几格。
这个比方是文档自己打的:大多数非虚构书把常查的词收在书后的索引里,读者翻索引就能跳到那一页,不必读完整本书。2
目录底下是一棵树,叫 B-tree,一层盖一层,查一个值就走几层。2
建它的命令只有一句:CREATE INDEX 索引名 ON 表名(字段)。建完之后,数据库自己维护它。2
建了不等于会走。规划器是决定走哪条路的那个部件,它觉得走索引比顺序扫更划算时才走。2
你会听到:「这个字段建了索引」「走索引了」「我看看有没有索引」。
问什么:建在哪几个字段上,谁排在前面?
03 跳过
目录和问题对不上,就用不上。对不上有四种常见样子。
第一种,多字段的索引只对排在最前面的那个字段最管用。两列一起建的索引,单查后面那一列,基本指望不上。3
第二种,条件里那个字段被函数包过。查询写的是 lower(名字) = 'value',索引就得建在 lower(名字) 上;建在名字本身,这条查询用不了。4
第三种,查出来的行太多。要查回半张表,规划器宁可从头翻一遍。2
第四种,表本身很小。翻两页就翻完了。2
执行计划里能直接看出来:这个条件是当「索引条件」用,还是当「过滤条件」用。
文档有个例子:索引只建在 unique1 上,查询又加了 stringu1 = 'xxx',这个条件就只能当过滤——先把行捞出来,再逐行比对。2
你会听到:「索引没走」「索引不生效」「我加了啊,怎么没变化」。
问什么:条件里这个字段,是直接跟值比,还是先算一遍再比?
04 回趟
索引把一条长路,换成了两趟短路。第一趟在目录里找到位置,第二趟回表取那一行。
PostgreSQL 里所有索引都和表分开存。普通索引扫描每取一行,都要读两处:索引里那一条,和表里的那一行。5
更麻烦的是顺序。索引里挨着的条目,指向的行散在表各处;这一趟是随机跳页,比顺序翻页慢得多。5
这就是大家嘴里的回表。MySQL 的 InnoDB(它的存储引擎)里,二级索引(编在主键以外那些字段上的目录)的每条记录存的是主键,数据库再拿主键回主表找那一行。6
省掉这一趟的办法,是让查询要的列全在索引里:要什么列,目录里就有。5
这种索引叫覆盖索引,可以在后面用 INCLUDE 挂几列。5
代价跟着来:挂上去的列等于复制一份数据,索引被撑大,可能反而更慢。5
你会听到:「这条要回表」「用覆盖索引」「别 SELECT *」。
问什么:这个页面到底要显示哪几列?
05 代价
索引不是白得的。
每次往表里写数据,索引都要跟着改一遍。文档的原话是:索引必须跟表保持同步,这给写操作加了开销;很少用到、从没用到的索引应当删掉。2
建索引那一刻更直接:默认情况下建索引时还能读,写入(增、改、删)要等它建完。文档直说这在生产环境常常不可接受,另有一条边写边建的路子。2
还有一种「加了还是慢」:计划里的行数是估算出来的,统计来自抽样,表变了就可能算偏。2
所以加完要看第二张执行计划,看它到底走没走。
三种处置,对应三问的答案。
数据还小、慢得有限:先记一个数(这张表多少页、这条查询多少毫秒),到线再说。
慢在翻页、条件就按某个字段筛:批加索引,条件是加之前和加之后各给一张执行计划。
慢在要回来的列太多、范围太大:换查法——少要列、分页、把报表另存一份。这一种加索引救不了。
你会听到:「加索引会锁表」「线上直接跑一下」「索引不占多少地方」。
问什么:这笔代价谁付?这条数据一天写多少次?
存下来当一张表
| 你听到的 | 多半指什么 | 你接着问 |
|---|---|---|
| 在扫全表 | 没有目录可用,从头翻到尾 | 这张表多少页? |
| 建了个索引 | 按某个字段编了一本目录 | 建在哪几个字段上,谁在前? |
| 索引没走 | 条件跟目录对不上,或者查出来的行太多 | 这个字段是直接比,还是先算再比? |
| 回表 | 按目录找到位置,还得回主表搬一次 | 这个页面要显示哪几列? |
| 覆盖索引 | 要的列都在目录里,省掉回表 | 索引会不会因此变大、写入变慢? |
| 加索引会锁表 | 建目录期间写入要等 | 能不能边写边建,挑什么时候? |
| 执行计划 | 数据库把打算走的路写出来 | 加之前和加之后各给我一张 |
| 加了还是慢 | 回表太多、行数估偏,或者根本没用上 | 它现在走的是哪条路? |
怎么用
听到「在扫全表」,先问多少页。页数不多,这条慢就只是慢,记个数就行。
听到「加了还是慢」,先问要回几趟、要几列。回表太多,加索引的钱就花在了偏的路上。
翻页少了、回趟少了,下一层是这条查询从哪台机器读的:读到的是不是几分钟前的副本。
References
- 1PostgreSQL 文档:数据库页布局
postgresql.org
- 2PostgreSQL 文档:索引简介
postgresql.org
- 3PostgreSQL 文档:多字段索引
postgresql.org
- 4PostgreSQL 文档:表达式索引
postgresql.org
- 5PostgreSQL 文档:索引覆盖扫描
postgresql.org
- 6MySQL 文档:聚集索引与二级索引
dev.mysql.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.