GLM-5.3:同一基座,后训练把哪些 benchmark 推到了前列
智谱官方对照图显示,GLM-5.3 沿用 GLM-5.2 基座,却在工程、Agent、专业知识工作和部分网络安全 benchmark 上出现分化跃升;本文合并转录全部官方图表并保留未标注项。

8 月 14 日,智谱发布 GLM-5.3。它最值得看的地方不是换了一个更大的基座,而是官方称它与 GLM-5.2 使用完全相同的基座,却把长程工程、跨工具 Agent 和部分网络安全任务的分数整体抬高。1 发布日期由新浪科技当天页面记录。2
真正需要分开的问题是:哪些任务确实跃升,哪些任务仍由其他模型领先? 官方对照图给出的答案并不支持一个总榜,而是一张有明显分化的能力表。
先看产品状态
智谱官方文档把 GLM-5.3 定位为旗舰基座模型:输入和输出都是文本,上下文窗口为 1M,最大输出为 128K tokens;文档列出的能力包括思考模式、Function Calling、上下文缓存、结构化输出和 MCP。1
当前可用范围也有边界:GLM Coding Plan 已经上线 GLM-5.3,模型 API 页面仍写着「即将上线」,官方没有在这份文档中给出 API endpoint 名称或 API 价格。1
官方 Benchmark 总表
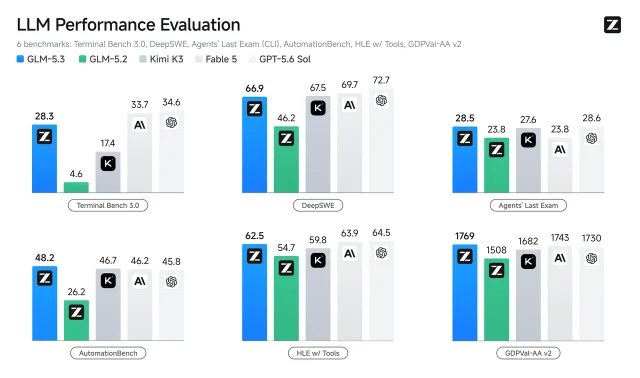
下表把智谱官方两张评测图中的模型列合并为一张表。主图包含 6 项通用、工程和 Agent benchmark,安全图包含 3 项网络安全 benchmark;空白表示官方没有在对应图中披露该模型的数值,不代表 0。每一行的最高已披露值加粗。
| Benchmark | GLM-5.3 | GLM-5.2 | Kimi K3 | Claude Fable 5 | Claude Opus 4.8 | Mythos 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|---|---|
| Terminal Bench 3.0 1 | 28.3 | 4.6 | 17.4 | 33.7 | 34.6 | ||
| DeepSWE 1 | 66.9 | 46.2 | 67.5 | 69.7 | 72.7 | ||
| Agents' Last Exam(CLI)1 | 28.5 | 23.8 | 27.6 | 23.8 | 28.6 | ||
| AutomationBench 1 | 48.2 | 26.2 | 46.7 | 46.2 | 45.8 | ||
| HLE w/ Tools 1 | 62.5 | 54.7 | 59.8 | 63.9 | 64.5 | ||
| GDPval-AA v2 1 | 1769 | 1508 | 1682 | 1743 | 1730 | ||
| CyberGym(%)1 | 84.5 | 77.2 | 80.0 | 83.8 | 83.6 | ||
| ExploitBench(%)1 | 54.4 | 24.4 | 32.2 | 78.0 | 76.5 | ||
| ExploitGym(2 小时 / 6 小时预算)1 | 130 / 105 | 39 / 29 | 70 / 36 | 247 / 181 | |||
| Z.ai Code Bench v1.0(Non-Thinking)1 | 图示,未标数 | ||||||
| Z.ai Code Bench v1.0(Low)1 | 图示,未标数 | 图示,未标数 | 图示,未标数 | 图示,未标数 | |||
| Z.ai Code Bench v1.0(High)1 | 图示,未标数 | 图示,未标数 | 图示,未标数 | 图示,未标数 | |||
| Z.ai Code Bench v1.0(Max)1 | 图示,未标数 | 图示,未标数 | 图示,未标数 | 图示,未标数 |
主图中,GLM-5.3 相比 GLM-5.2 的变化很集中:Terminal Bench 3.0 从 4.6 升到 28.3,DeepSWE 从 46.2 升到 66.9,Agents' Last Exam(CLI)从 23.8 升到 28.5,AutomationBench 从 26.2 升到 48.2,HLE w/ Tools 从 54.7 升到 62.5,GDPval-AA v2 从 1508 升到 1769。1
编程和工程:提升是真实的,但不是全面第一
六项主图里,GLM-5.3 在 AutomationBench 和 GDPval-AA v2 拿到最高值,在 Terminal Bench 3.0 上距离 GPT-5.6 Sol 的 34.6 和 Fable 5 的 33.7 还有差距;DeepSWE 上的 66.9 也低于 GPT-5.6 Sol 的 72.7、Fable 5 的 69.7 和 Kimi K3 的 67.5。1
这组结果更像「工程能力追上来」,而不是「所有工程任务都赢」。尤其是 DeepSWE,它更接近持续修改代码、长期保持任务状态的能力。GLM-5.3 相对 GLM-5.2 的提升幅度很大,但与领先对照模型之间仍有可见距离。
Agents' Last Exam(CLI)也有类似边界:GLM-5.3 的 28.5 高于 GLM-5.2 和 Fable 5 的 23.8,也高于 Kimi K3 的 27.6,但略低于 GPT-5.6 Sol 的 28.6。GDPval-AA v2 则给出另一种信号:在官方图列出的 44 种职业知识工作评测中,GLM-5.3 得分 1769,高于 GPT-5.6 Sol 的 1730、Fable 5 的 1743、Kimi K3 的 1682 和 GLM-5.2 的 1508。1
Token 效率:方向清楚,精确数字不要硬读
Z.ai Code Bench v1.0 的官方图把准确率和每个任务的平均输出 token 放在同一张曲线上,评测环境标注为 Claude Code 2.1.207。图中 GLM-5.3 的曲线位于 GLM-5.2 之上,并在更高 effort level 下接近或超过 Claude Opus 4.8;但官方没有给每个点标出数字。1
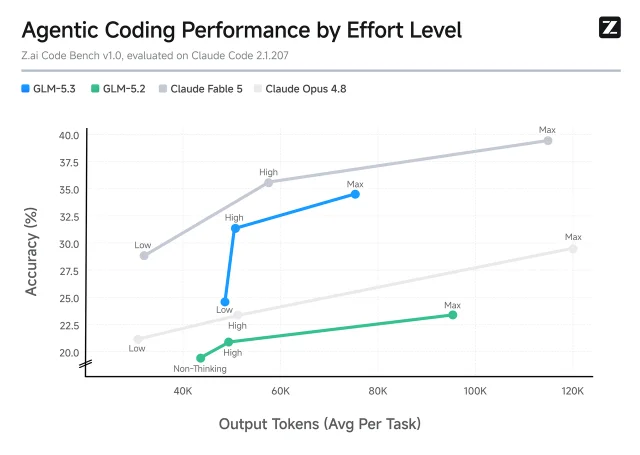
这张图能支持的判断是:GLM-5.3 在更高推理投入下,完成质量和输出长度之间的曲线优于 GLM-5.2。它不能单独证明真实调用成本一定更低,因为官方页面没有披露每个任务的 token 消耗分布、失败重试方式或价格。
网络安全:漏洞链前端领先,深层利用仍落后
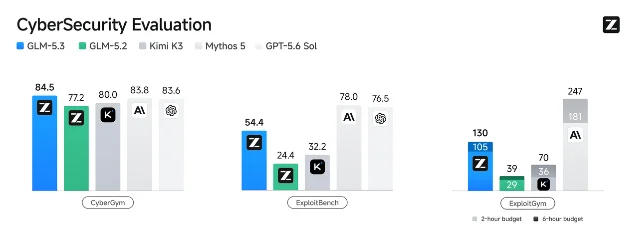
安全图把结果拆成三项。CyberGym 上,GLM-5.3 得分 84.5%,高于 Mythos 5 的 83.8% 和 GPT-5.6 Sol 的 83.6%;ExploitBench 上,GLM-5.3 为 54.4%,从 GLM-5.2 的 24.4% 明显上升,但仍低于 Mythos 5 的 78.0% 和 GPT-5.6 Sol 的 76.5%。官方文档也把 GLM-5.3 的优势描述为更集中在漏洞利用链前端,在更深入的漏洞利用和完整攻防任务上仍有提升空间。1
ExploitGym 不能和前两项直接横比。官方图同时给出 2 小时和 6 小时预算:GLM-5.3 标为 130 / 105,GLM-5.2 为 39 / 29,Kimi K3 为 70 / 36,Mythos 5 为 247 / 181。这里的预算条件本身就是结果的一部分,脱离预算只比较数字会误读模型位置。1
同一基座,为什么能有这样的跃升
智谱官方给出的解释不是增加基座参数,而是把后训练环境做得更长、更丰富:训练任务从孤立的编程题扩展到发现问题、分析方案、实施、验证和交付的完整流程;部分任务的工作量相当于资深工程师连续数天的工作,还会调用计算集群、存储系统、内部文档和代码库。1
这个解释与分数变化是对得上的。GLM-5.2 到 GLM-5.3 的提升并没有只出现在一个短题 benchmark,而是同时出现在持续改码、终端操作、跨工具 Agent、专业知识工作和漏洞推理上。模型学到的对象从「给出一段代码」扩展为「在真实环境里把事情做完」,因此变化会集中出现在长程任务。
但评测图也保留了反例:GLM-5.3 在 HLE w/ Tools 上的 62.5 低于 GPT-5.6 Sol 的 64.5 和 Fable 5 的 63.9,在 ExploitBench 上距离 Mythos 5 还有 23.6 个百分点。后训练环境能把能力推过一段距离,却没有把所有任务的差距一起抹平。
读者应该怎样使用这张表
- 如果目标是 Coding Agent、终端操作或自动化工作流,优先看 Terminal Bench 3.0、DeepSWE、Agents' Last Exam(CLI)和 AutomationBench。GLM-5.3 相比 GLM-5.2 的提升很大,但在持续改码任务上仍需与 Kimi K3、Fable 5 和 GPT-5.6 Sol 同条件复测。
- 如果目标是专业知识工作,GDPval-AA v2 是目前这组官方图里 GLM-5.3 最清楚的强项之一;它可以作为进一步试用的理由,但不能替代目标职业和真实资料上的验收。
- 如果目标是网络安全,CyberGym 的 84.5% 说明漏洞发现与推理链条前段值得测试;ExploitBench 和 ExploitGym 的结果提醒读者,深层利用、预算限制和完整攻防任务仍然需要单独验证。
- 如果目标是控制调用成本,先等 API endpoint 和价格公开,再用自己的任务记录输入输出 token、重试次数和完成率。官方 Code Bench 图只说明准确率与输出长度的关系,不能直接换算账单。
这次发布最稳妥的结论是:GLM-5.3 证明了同一基座仍有可通过后训练释放的空间,尤其是在长程软件工程、自动化和部分漏洞推理任务上;它还没有证明自己已经成为跨 benchmark 的全面第一。对实际选型来说,模型列里的空白和 ExploitGym 的预算条件,与加粗的最高分同样重要。
References
- 1GLM-5.3 - 智谱AI开放文档
docs.bigmodel.cn
- 2智谱GLM-5.3大模型发布:开源中最强、编程/智能体性能接近Fable 5
finance.sina.com.cn
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.