Kimi K3.1 Pro 发布:智能指数 55 分、终端编码 65.7%,每任务 $2.11,权重 11 月 4 日前放出
月之暗面发布 Kimi K3.1 Pro:1M 上下文、文本/图像/视频输入,第三方智能指数 55 比上一代高 11 分,每任务 $2.11,权重承诺 11 月 4 日前放出。

2026 年 10 月 24 日,月之暗面发布 Kimi K3.1 Pro,同时放出高速版 Kimi K3.1 Pro Highspeed。1
官方给它的定位是「K3.1 系列的第一个模型」,也是「最强的 3T 级开源权重模型」,上下文 100 万 tokens。它的基座沿用 K3,这一代新增的算力几乎全压在后训练上:强化学习跨数百个下游领域联合进行。1
先说结论
- 模型与状态:Kimi K3.1 Pro,2026 年 10 月 24 日发布;网页、App、Kimi Work、Kimi Code 与 API 当天可用,权重 11 月 4 日前放出。官方博客标注 24 日,OpenRouter 与 Artificial Analysis 都记 23 日。12
- 上下文与输入:1,048,576 tokens,文本、图像、视频进,文本出。3
- 官方拿下第一的一项:Agents' Last Exam 43.2,高过 Claude Opus 5.5 的 42.6。1
- 官方差距最大的一项:Terminal-Bench Science 0.1 只有 38.1,GPT-6 Astra 是 68.1。1
- 第三方成绩:Artificial Analysis 智能指数 55,上一代 K3 是 44,榜首 58。45
- 价格:每百万 tokens 输入 $2、输出 $10,缓存命中 $0.20;上一代 K3 是 $3 / $15。6
- 每任务成本:$2.11,Claude Opus 5.5 是 $5.98。47
- 什么时候要动:还在用 K2 系列的,10 月 31 日起对新注册用户关闭,12 月底全部退役。6
快速核对
| 项目 | 内容 | 来源 |
|---|---|---|
| 名称与状态 | Kimi K3.1 Pro,博客标注 2026 年 10 月 24 日发布;同日发布高速版 | 官方博客 |
| 参数规模 | 官方只写「3T 级」,具体未披露;AA 页上写的是 2.8T,与 K3 相同 | 官方博客 · AA |
| 上下文 | 1,048,576 tokens,按统一单价计费,不随长度分档 | 官方价目页 |
| 输入输出 | 文本、图像、视频进,文本出 | 官方文档 |
| 思考档位 | reasoning_effort 三档 low / high / max,默认 max;思考关不掉 | 官方文档 |
| 最大输出 | max_completion_tokens 默认 131,072,可设到 1,048,576 | 官方文档 |
| 接口 | OpenAI 兼容,https://api.moonshot.ai/v1,模型名 kimi-k3.1-pro | 官方文档 |
| 标准价 | 输入 $2 / 输出 $10,缓存命中 $0.20,缓存写 $2(5 分钟)/ $4(1 小时)每百万 tokens | 官方价目页 |
| 高速版价 | $4 / $20,缓存写 $4 与 $8;官方称速度是 2 到 3 倍 | 官方价目页 · 官方博客 |
| 上一代 K3 的价格 | 输入 $3 / 输出 $15,缓存命中 $0.30 | 官方价目页 |
| 第三方智能指数 | 55(K3 为 44,榜首 Claude Opus 5.5 为 58) | AA 模型页 · AA 榜单 |
| 每任务成本 | $2.11(K3 为 $2.00,Opus 5.5 为 $5.98) | AA 模型页 |
| 速度 | 80.7 tokens/s,首 token 2.97 秒(AA 测的是月之暗面自家 API) | AA 模型页 |
| 权重 | 承诺 11 月 4 日前放出;Hugging Face 暂无仓库;AA 暂标闭源 | 官方博客 · HF · AA |
| 接入门槛 | 账户充值至少 $1 才解锁;累计充值额决定并发与速率档位 | 官方文档 |
| K2 退役 | 10 月 31 日起停止新用户注册,12 月底全部下线 | 官方价目页 |
官方 14 项:六项第一,一项差得远
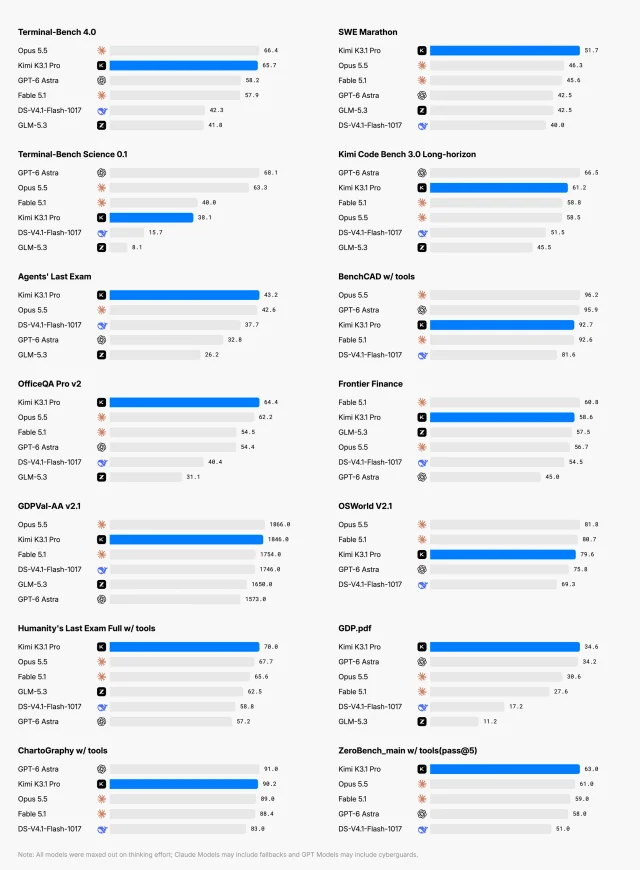
官方博客放了一张 14 项基准、6 个模型的对照图,K3.1 Pro 那一列用蓝色单独标出。1
拿第一的有六项。Agents' Last Exam 是 43.2,高过 Claude Opus 5.5 的 42.6;这一项考的是有经济价值的真实工作任务。1
OfficeQA Pro v2 是 64.4,Opus 5.5 是 62.2。这套题把整本财报 PDF 交给模型,答案要对得上原件里的数字。1
Humanity's Last Exam 带工具 70.0,Opus 5.5 是 67.7。GDP.pdf 是 34.6,GPT-6 Astra 34.2。1
SWE Marathon 是 51.7,Opus 5.5 46.3。ZeroBench 带工具、按 pass@5 算 63.0,Opus 5.5 是 61.0。1
咬着第二名的四项,差得都不多。Terminal-Bench 4.0 是 65.7,Opus 5.5 是 66.4,差 0.7 分。1
GDPval-AA v2.1 是 1846 分,Opus 5.5 是 1866;这一项按 Elo 计分,差 20 分。1
ChartoGraphy 带工具 90.2,Astra 91.0。Frontier Finance 是 58.6,落后 Claude Fable 5.1 的 60.8 两分。1
剩下三项排位都在第三或第四。差得最多的是 Terminal-Bench Science 0.1,只有 38.1,Astra 68.1、Opus 5.5 63.3、Fable 5.1 48.0。1
OSWorld V2.1 是 79.6,Opus 5.5 81.8、Fable 5.1 80.7。BenchCAD 带工具 92.7,Opus 96.2、Astra 95.9,排第三。1
最后一项 Kimi Code Bench 3.0 Long-horizon 是 61.2,Astra 的 66.5 在前面。这套是月之暗面自家的基准,别家不会跑,上一代 K3 在同一套上是 55.95。1
读这张表要先知道三件事。所有模型都开在最高思考档,图注还写明 Claude 系列可能含 fallback、GPT 系列可能含 cyberguard,也就是对网络攻击类请求的拦截。1
Terminal-Bench 4.0 用 Claude-Code harness 跑,对照模型的分数取各自博客或官方榜单里报出的最高值。1
BenchCAD 只用 1,000 个文件子集,全量是 17,900 例;带工具走 Claude Code,不带工具是单次生成。1
博客里还交代了一件与开源有关的事:训练时把网络安全相关内容从中间训练语料和强化学习环境里剔除,再来看效果。1
在自家的 xdev-bench-hard 上,没做这层清洗的检查点 pass@3 能解 90.5% 的题,最终发布的 K3.1 Pro 是 81.0%。1
这个数字仍高过上一代 K3 的 33.3%,官方的解释是:通用编码与长程调试能力变强,会外溢到这类安全任务上。1
第三方把 55 分放在哪
Artificial Analysis 已经建档:智能指数 55 分,每任务 $2.11,输出速度 80.7 tokens/s,首 token 2.97 秒。4
榜单上比它高的只有四个条目,全部来自 Anthropic 与 Meta 的顶配:Claude Opus 5.5 的 58、Claude Sonnet 5.5 的 56、Opus 5.5 xhigh 档的 56、Muse Wonder Full 的 56。7
55 分往下一位是 Opus 5.5 的 high 档,54 分,每任务 $1.82。7
按每任务成本看,$2 上下的还有 Gemini 4 Argon high 档的 $1.99(53 分),再贵一档是 GPT-6 Astra max 档的 $3.26(53 分)。两家的分数都比它低 2 分。7
榜上比 55 分高的四个条目里,能查到成本的三家,最低也是 $3.46。7
AA 的分项分数也能看到。OpenRouter 页面引用的一组 AA 分项里,Terminal-Bench 4.0 是 67.2%,比官方自测的 65.7% 高 1.5 分。2
同一组分项里,HLE 52.5%、GDPval-AA 67.3%、AA-LCR 86.3%、CritPt 24.6%、SciCode 60.8%。2
AA 目前仍把它标成闭源,理由是权重还没公开。4
输出用量这一栏值得留意:跑完一整套智能指数,它输出了 150M tokens,AA 的措辞是「非常啰嗦」,中位数是 87M。4
同样的分数,花的钱差多少
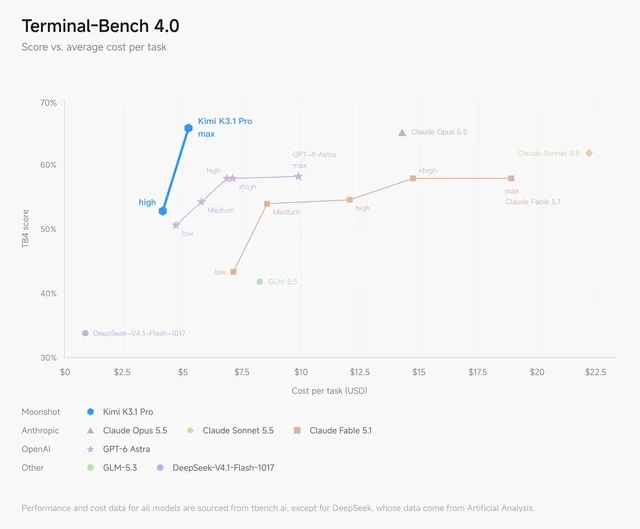
官方文档里另有一张 Terminal-Bench 4.0 的分数-成本图,横轴是每任务的平均花费。3
K3.1 Pro 的两个点都在图的左侧:high 档在 50% 出头、每任务约 4.6 美元,max 档 65.7%、约 5.6 美元。两档之间只差一美元左右。3
同一条横轴上,Claude Opus 5.5 与 Claude Sonnet 5.5 的单点落在 14 美元以上。3
接进去要改哪几行
接口是 OpenAI 兼容,base_url 用
https://api.moonshot.ai/v1,模型名 kimi-k3.1-pro,高速版是 kimi-k3.1-pro-highspeed。3思考档位走顶层字段
reasoning_effort,取值 low、high、max,默认 max。思考关不掉,嫌慢只能往低调。3max_completion_tokens 默认 131,072,最大可以设到 1,048,576。3图片不能直接给公网 URL,要用 base64,或先传文件接口拿
ms://<file-id>。视频走同一套文件接口。3官方工具里的网页搜索写着「正在更新,近期不建议用于生产流程」。3
缓存自动开启,写入按 TTL 单独计费:5 分钟档 $2,1 小时档 $4,命中 $0.20。高速版这三项分别是 $4、$8、$0.20。6
请求间隔超过 5 分钟的工作流,把
prompt_cache_options.ttl 设成 1h,比每次过期重写划算。3接入有门槛:账户充值至少 $1 才能解锁这个模型,累计充值金额还决定并发、RPM、TPM、TPD 的档位。3
高速版是另一个模型名,价格正好翻倍:$4 / $20,缓存写 $4 与 $8。6
K2 系列的时间表也一并公布了:10 月 31 日起对新注册用户关闭,12 月底全部退役。6
该不该试
- 在写 coding agent 的:Terminal-Bench 4.0 的 65.7 与 SWE Marathon 的 51.7 是这批数字里最有分量的两项,前者贴着 Opus 5.5,后者高出 5.4 分。1
- 做 3D 与 CAD 的:BenchCAD 不带工具时 72.8,与 Opus 5.5 的 73.0 基本持平;带工具 92.7,落后 Opus 3.5 分,仍高于 Fable 5.1 的 92.6 与 DeepSeek 的 81.6。1
- 做金融文档的:OfficeQA Pro v2 的 64.4 排第一;自家 Hard 套上的幻觉率是 8.3%,上一代 K3 是 23.4%。这些分数由官方自跑,第三方同口径的版本还没有。1
- 等权重自建的:现在拿不到。时间点是 11 月 4 日前,Hugging Face 上月之暗面的仓库里最新仍是 6 月创建的 K3。18
- 还在用 K2 的:10 月 31 日是停止接纳新用户的日子,12 月底全线下线,迁移窗口只剩两个月。6
- 只在意单价的:$2 / $10 是 K3 的三分之二;按任务算几乎持平,AA 记的是 $2.11 对 $2.00。456
- 要更快响应的:高速版官方称 2 到 3 倍速、价格翻倍;OpenRouter 上两个端点的 P50 是 38 与 50 tokens/s,实测差距比 2 倍小。126
还没有的数字
- 参数与架构:官方只给「3T 级」,总参与激活参数都没写,架构细节也没写。AA 页上写的是 2.8T,与 K3 相同。145
- 权重与许可:放出时间定在 11 月 4 日前,许可条款未公布。体积、量化格式与本地部署门槛都要等文件挂上去才知道。1
- 技术报告、模型卡、系统卡:三样都没有。可用的只有博客里的评测段落与图注。1
- 第三方安全评估:官方自己做了一套清洗前后的对照,外部机构还没发布独立评估。1
- Vals Index:10 月 22 日更新的榜单里没有它,Kimi 那栏仍是 K3 的 52.95%、每测试 $7.17、第 19 名。9
- 速度的第二个口径:AA 的 80.7 tokens/s 来自月之暗面自家 API,OpenRouter 两个端点给出 38 与 50。两套测法不同,上线前用真实负载各跑一遍更可靠。24
- 14 项的第三方复跑:AA 给的是综合指数与几个分项,全套逐项同口径复跑的版本还没有。4
References
- 1
- 2OpenRouter
openrouter.ai
- 3官方文档
platform.kimi.ai
- 4Artificial Analysis:Kimi K3.1 Pro
artificialanalysis.ai
- 5AA:Kimi K3
artificialanalysis.ai
- 6官方价目页
platform.kimi.ai
- 7AA 榜单
artificialanalysis.ai
- 8Hugging Face:moonshotai
huggingface.co
- 9Vals Index
vals.ai
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.