Kimi K3.1 Pro:47 行官方总表,前代那一列要自己拼
Kimi 10 月 23 日发布 K3.1 Pro,官方 47 行对照表里却没有前代那一列;本文用它和前代 7 月的官方仓库拼出一张合并总表,说明哪 20 行能跨代比、哪八处换了尺子,以及四行由第三方统一评测里它一胜三负。

10 月 24 日,月之暗面发布 Kimi K3.1 Pro。1
它是 Kimi K3 的后训练版本,官方给它的量级归类是 3 万亿参数级的开源权重模型,上下文 100 万 token。1
同一天还有一个 Highspeed 版,官方称输出速度是标准版的 2 到 3 倍,智能水平不变。2
价格比前代低。标准版每百万 token 输入 13 元、输出 68 元,缓存命中 1.3 元;前代 K3 是输入 20 元、输出 100 元。3
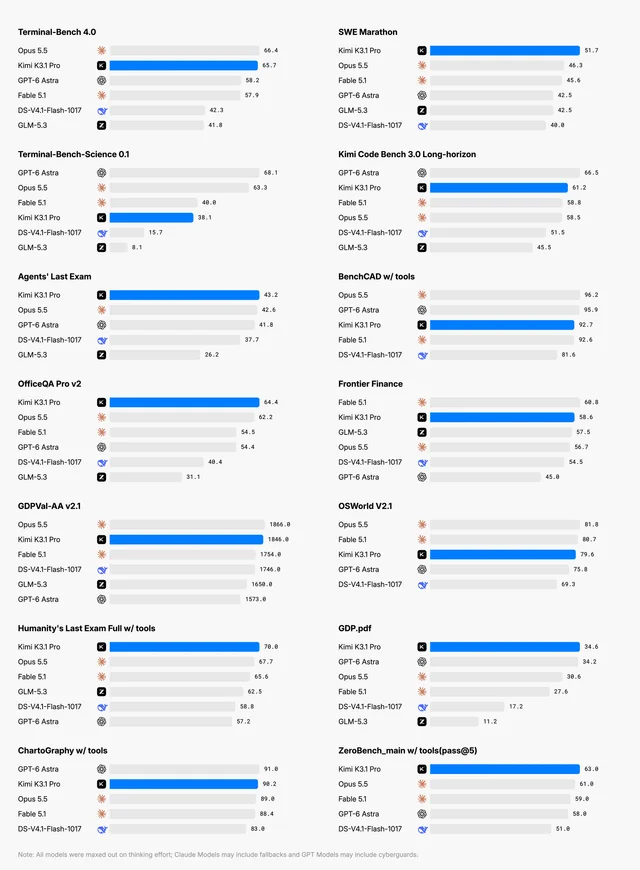
博客正文的评测图只有一张,14 项。真正的对照表在页面里,47 行、六列模型,分编码 10 行、Agent 25 行、推理与多模态 9 行、网络安全 3 行。1
六列是 Kimi K3.1 Pro、Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5、DeepSeek-V4.1-Flash-1017、GLM-5.3。前代 K3 不在其中。
一张合并总表
十列模型,47 行取自发布页那张前端渲染的表。1
官方未测或未进榜的写「—」,按缺项计。每行最高值加粗;两行幻觉率是「越低越好」,取最低值加粗。
同一 benchmark、同一模型在两个官方来源数值不同时,格内并列两个数并标 ⚠️。
最后一列写这一行是谁跑的、用什么脚手架。
Kimi K3 那一列来自 7 月 K3 的官方仓库。Gemini 4 Carbon、Gemini 4 Argon、GPT-6.1 Terra 三列,只在对应官方材料报过同一 benchmark 的地方才有值,括号里标的是那份材料的口径。
| Benchmark(口径) | Kimi K3.1 Pro | Kimi K3 | Claude Opus 5.5 | Claude Fable 5.1 | GPT-6 Astra | GPT-6.1 Terra | Gemini 4 Carbon | Gemini 4 Argon | DeepSeek-V4.1-Flash-1017 | GLM-5.3 | 谁跑/口径 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | — | 66.4 | 57.9 | 58.2 ⚠️ 59.1 | 50.3%(max) | 65.2%(AA 跑) | 57.4%(模型卡) | 42.3 | 41.8 | Claude Code|自跑;对手取各家博客/官方榜最高值,Astra 的 59.1 为 AA 口径 1456 |
| Terminal-Bench-Science 0.1 | 38.1 | — | 63.3 | 40.0 | 68.1 | — | 64.8%(AA 跑) | 57.6%(模型卡) | 15.7 ⚠️ 9.3 | 8.1 | Claude Code|自跑;对手取官方榜,DS 的 15.7 是旧版 V4.1-Flash,自测 -1017 为 9.3 145 |
| SWE Marathon v1.1 | 51.7 | 42.0(H20 校准版) | 46.3 | 45.6 | 42.5 | — | — | — | 40.0 | 42.5 | Claude Code|自跑;DS 自跑,其余官方榜 17 |
| BenchCAD w/o tools(Voxel IoU) | 72.8 | — | 73.0 | 60.6 | — | — | — | — | 41.2 | — | 单次生成|开源模型自跑,Claude 取系统卡 1 |
| BenchCAD w/ tools(Voxel IoU) | 92.7 | — | 96.2 | 92.6 | 95.9 | — | — | — | 81.6 | — | Claude Code|开源模型自跑,Claude 取系统卡,Astra 取官方报告 1 |
| Program Bench(二值) | 31.5 | — | 65.0 | 53.5 | 50.0 | — | — | — | 29.1 | 19.0 | Claude Code|自跑;DS、GLM 取发布博客,其余 Vals 榜 1 |
| DeepSWE v1.1 | 75.5 | 67.5(Kimi Code) | 74.2 | 67.4 | 74.1 | — | — | — | 77.0 | 66.9 | Claude Code|自跑;对手取各自技术报告 17 |
| PostTrain Bench v1.2 | 36.5 | — | 43.8 | 44.6 | 41.9 | — | — | — | 30.5 | 34.5 | Claude Code,H20|自跑;其余官方榜 1 |
| Kimi Code Bench 2.0(内部) | 77.1 | 73.7(Claude Code) | — | — | — | — | — | — | 76.1 | 61.7 | Claude Code|内部基准,对手 max effort 17 |
| Kimi Code Bench 3.0 Long-horizon(内部) | 61.2 | 55.95 | 58.5 | 58.8 | 66.5 | — | — | — | 51.5 | 45.5 | Claude Code|内部基准,对手 max effort 17 |
| HLE-Full w/ tools | 70.0 | 56.0 | 67.7 | 65.6 | 57.2 | — | — | — | 58.8 | 62.5 | 自跑;判分 Gemini-3.5-Flash 17 |
| BrowseComp | 92.1 | 91.2(压缩阈值 300K) | 90.8 | — | 91.5 | — | — | — | — | — | 自跑;200K 触发压缩,上限 500 步 17 |
| BioMysteryBench | 80.6 | — | 81.9 | 81.6 | 78.9 | — | — | — | 80.0 | 79.6 | 各用各的脚手架|K3 作判分 1 |
| CharXiv (RQ) w/ python | 93.4 | 91.3 | 93.8 | 92.7 | 92.8 | — | — | — | 85.6 | — | python|自跑,五次平均 17 |
| MMMU-Pro w/ python | 90.0 | 83.4 | 89.8 | 88.4 | 87.8 | — | — | — | 82.5 | — | python|自跑,四次平均 17 |
| GDP.pdf w/ python | 85.7 | — | 83.9 | 83.8 | 85.5 | — | — | — | 73.0 | — | python|自跑,五次平均 1 |
| ChartoGraphy w/ python | 90.2 | — | 89.0 | 88.4 | 91.0 | — | — | — | 83.0 | — | python|自跑,五次平均 1 |
| BabyVision w/ python | 95.4 | 85.7 | 97.7 | 95.1 | 96.6 | — | — | — | 92.5 | — | python|自跑,四次平均 17 |
| ZeroBench_main w/ python(pass@5) | 63.0 | — | 61.0 | 59.0 | 58.0 | — | — | — | 51.0 | — | python|自跑,五次平均 1 |
| Agents' Last Exam(ALL,122 题) | 43.2 | 28.3 | 42.6 | — | 41.8 | — | — | — | 37.7 | 26.2 | Kimi Code|自跑;DS 自跑,其余官方站 17 |
| Agents' Last Exam(CLI,86 题) | 44.2 | — | 40.7 | — | 44.2 | — | — | — | 36.0 | 29.4 | Kimi Code|自跑;DS 自跑,其余官方站 1 |
| Automation Bench-AA | 73.3 | — | 69.5 | 59.4 | 68.5 | — | — | — | 66.6 | 62.2 | AA 榜 1 |
| GDPval-AA v2.1(Elo) | 1846 | — | 1866 | 1754 | 1573 | — | — | — | 1746 | 1650 | AA 榜 1 |
| AA-Briefcase v1.1(Elo) | 1678 | — | 1803 | 1672 | 1569 | — | — | — | 1570 | 1507 | AA 榜 1 |
| APEX-Agents | 67.2 | 41.0 | 73.5 | 68.6 | 64.7 | — | — | — | 63.4 | 56.6 | Mercor 榜 17 |
| OfficeQA Pro v2 | 64.4 | — | 62.2 | 54.5 | 54.4 | — | — | — | 40.4 | 31.1 | Claude Code|自跑;Astra 用 Codex 1 |
| OfficeQA Pro | 67.4 | 63.3 | — | 68.6 | 66.2 | — | — | — | 62.4 | 58.6 | Claude Code|自跑,Astra 用 Codex 17 |
| Frontier Finance | 58.6 | — | 56.7 | 60.8 | 45.0 | — | — | — | 54.5 | 57.5 | 官方 finance agent v2 装置 1 |
| Harvey Legal Agent | 23.7 | — | — | 19.1 | — | — | — | — | 21.0 | — | 用 AA 的 Stirrup 脚手架跑公开集 1 |
| HANDBOOK.md | 44.6 | — | 41.5 | 38.8 | — | — | — | — | 28.9 | 20.8 | 官方 OpenHands 装置 1 |
| OSWorld V2.1 | 79.6 | — | 81.8 | 80.7 | 75.8 | — | — | — | 69.3 | — | Kimi Agent|自跑;Astra 取 Muse Wonder 报告 1 |
| Business Operation(内部) | 37.8 | 8.9 | — | 30.7 | 32.3 | — | — | — | 8.9 | 18.6 | 内部基准 17 |
| DECK-Arena(内部,Elo) | 1456 | — | 1253 | — | 1423 | — | — | — | 1231 | 1119 | 内部基准 1 |
| Design Bench(内部,Elo) | 957 | — | 927 | — | 1076 | — | — | — | 863 | 718 | 内部基准 1 |
| Kimi Hallu Bench Hard w/ tools(内部,越低越好) | 8.3 | 23.4 | 15.0 | 23.3 | 5.5 | — | — | — | 23.3 | 22.6 | 内部基准 17 |
| GDP.pdf | 34.6 | — | 30.6 | 27.6 | 34.2 | — | — | — | 17.2 | 11.2 | 自跑;判分 Gemini-3.5-Flash 1 |
| HLE-Full | 51.1 | 43.5 | 59.8 | 57.6 | 53.6 | — | — | — | 42.6 | 43.0* | 自跑|对手来源未标 17 |
| HLE-Diamond | 39.4 | — | 60.9 | 55.1 | 65.8 | — | — | — | 21.6 | 25.1* | 自跑|对手来源未标 1 |
| GPQA-Diamond | 94.2 | 93.5 | 93.9 | 93.7 | 96.1 | — | — | — | 92.2 | 91.7 | 自跑|对手来源未标 17 |
| CharXiv (RQ) | 89.0 | 84.8 | 92.1 | 88.8 | 90.0 | — | — | — | 77.0 | — | 自跑|对手来源未标 17 |
| MMMU-Pro | 84.1 | 81.6 | 87.7 | 86.3 | 86.9 | — | — | — | 80.6 | — | 自跑|对手来源未标 17 |
| ZeroBench_main(avg@5 / pass@5) | 29.8 / 39.0 | 23.0 / 41.0 | 35.0 / 43.0 | 23.0 / 35.0 | 43.2 / 52.0 | — | — | — | 11.8 / 23.0 | — | 自跑|对手来源未标 17 |
| PerceptionBench | 68.3 | 58.5 | 72.1 | 63.0 | 77.6 | — | — | — | 47.7 | — | 自跑|对手来源未标 17 |
| Kimi Hallu Bench w/o tools(内部,越低越好) | 5.4 | — | 6.8 | 11.4 | 4.2 | — | — | — | 13.1 | 14.8 | 内部基准 1 |
| ExploitBench | 74.7 | — | 91.0 | 83.0 | 100 | — | — | — | — | 54.4 | 官方 ExploitBench 装置|自跑,对手取各自材料 1 |
| ExploitGym | 20.7 | — | 34.5 | 30.4 | 42.4 | — | — | — | — | 15.0 | KimiCode,6 小时|自跑,对手取各自系统卡 1 |
| xdev-bench-hard(内部,pass@3) | 81.0 | — | — | — | — | — | — | — | 85.7 | 57.1 | 内部基准|KimiCode 1 |
GPT-6 Astra 的 Terminal-Bench 4.0 有两个数:Kimi 取 58.2,Google 的 Carbon 对照表给的是 Artificial Analysis 口径的 59.1,OpenAI 自报 57.9。148
DeepSeek 的 Terminal-Bench-Science 也有两个:官方榜上旧版 V4.1-Flash 是 15.7,Kimi 自测的 -1017 只有 9.3,表里取了 15.7。1
GLM-5.3 两行 HLE 后的星号,表示只跑了文本子集。1
前代那一列要自己拼
K3 的评测表在它的官方仓库 README 里,覆盖 GPQA、HLE、MMMU-Pro、CharXiv、BabyVision、ZeroBench、PerceptionBench、APEX、OfficeQA Pro、BrowseComp、DeepSWE、ProgramBench、PostTrainBench、Kimi Code Bench 2.0、Agents' Last Exam 等。7
把两份材料拼起来,47 行里 20 行能配上 K3 的数。
配不上的分三类。题换了版本:Terminal-Bench 在 K3 时代测的是 2.1,K3.1 Pro 测的是 4.0。计分方式换了:ProgramBench 从原始分改成了二值分。
第三类是那一行 K3 时代没测。BenchCAD、ExploitBench、ExploitGym、BioMysteryBench 都属这一类。
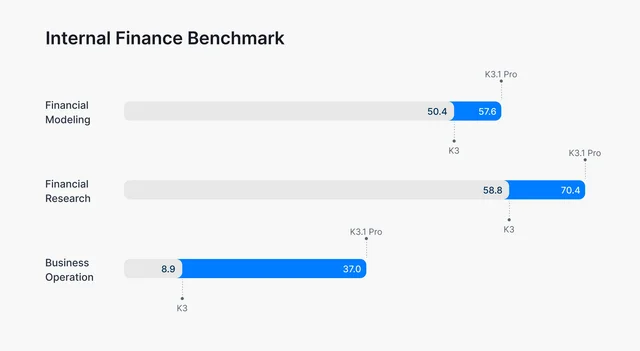
官方把两代并排画进同一张图的,是内部金融基准这三行。1
四行用的是同一把尺
四行的分数全部引自 Artificial Analysis 与 Mercor 的榜单:Automation Bench-AA、GDPval-AA v2.1、AA-Briefcase v1.1、APEX-Agents。1
四行的分数出自同一家评测机构的榜单,行内只有模型在变,差值可以归给模型。
K3.1 Pro 赢一行:Automation Bench-AA 73.3,Opus 5.5 69.5,GPT-6 Astra 68.5。
输三行:GDPval-AA 1846 对 Opus 5.5 的 1866,AA-Briefcase 1678 对 1803,APEX-Agents 67.2 对 73.5。
四行一胜三负,三场都输给同一个模型。
全表 47 行里,Kimi 标自己最高的有 16 行,其中 1 行与 GPT-6 Astra 并列。1
两个数都成立,读者要挑的是哪一套。前者是可比子集,后者是全表。
它赢在哪,输在哪
赢的 16 行多数落在三类。长时程编码:SWE Marathon v1.1 51.7、Kimi Code Bench 2.0 77.1。
带工具的检索与文档工作:BrowseComp 92.1、OfficeQA Pro v2 64.4、HANDBOOK.md 44.6、Harvey Legal Agent 23.7。
带 python 的多模态读数:MMMU-Pro 90.0、GDP.pdf 85.7、ZeroBench 63.0;不带 python 的 GDP.pdf 34.6 也是它最高。
其余的几行是 Agents' Last Exam 两行、HLE 带工具、Automation Bench-AA,以及两个内部基准。
输得最狠的也是三类。
单发深推理:HLE-Full 51.1 对 Opus 5.5 的 59.8,HLE-Diamond 39.4 对 GPT-6 Astra 的 65.8,GPQA-Diamond 94.2 对 Astra 的 96.1。
程序合成与训练配方:ProgramBench 31.5 对 Opus 5.5 的 65.0,PostTrainBench 36.5 对 Fable 5.1 的 44.6。
网络安全:ExploitBench 74.7 对 Astra 的 100,ExploitGym 20.7 对 Astra 的 42.4。1
还有一行值得单独看。Kimi Code Bench 3.0 Long-horizon 是自家基准,K3.1 Pro 61.2,GPT-6 Astra 66.5 拿第一。
题由 Kimi 出,跑由 Kimi 做,第一名仍然让了出去。它对前代的那点优势(55.95 到 61.2)是真的,放到这张表里却只够第三。
能力剖面于是清楚了:多步、带工具、长时程强;一口气答对、从零写程序、攻防渗透弱。
Terminal-Bench 4.0 的 0.7 分
这一行最容易被拿去做结论。
K3.1 Pro 65.7,Claude Opus 5.5 66.4,GPT-6 Astra 58.2。1
脚注写明两件事:Kimi 用 Claude-Code 脚手架自测;对手的数字取「各自博客或官方 Terminal-Bench 4.0 榜里的最高值」。1
0.7 个百分点,是拿一次自测去比各家最好成绩。
表里对手的每一格都带标注。Claude 与 GPT 的每一格写的是「(max, with fallback)」,Kimi 自己只有「(max)」。1
图注补了方向:Claude 的分数可能包含回退模型,GPT 的分数可能经过网络安全拦截。1
两种标注的方向相反。回退通常让被拒的任务仍有答案,拦截通常让被拦的任务记为失败。各自影响多大,官方没有给数。
所以这 0.7 分拆不成「模型差 0.7」。
同一类任务上还有一处反向证据。Terminal-Bench-Science 0.1 里,GPT-6 Astra 68.1,K3.1 Pro 38.1,差 30 个百分点。1
两道题都是终端里的长任务,结论相反。单看其中任何一道,都不足以给这两家排序。
能算的跨代提升
题目没换、口径没换的行,差值可以读。
- HLE-Full 43.5 到 51.1,带工具 56.0 到 70.0
- Agents' Last Exam 28.3 到 43.2
- GPQA-Diamond 93.5 到 94.2
- MMMU-Pro 81.6 到 84.1,带 python 83.4 到 90.0
- CharXiv (RQ) 84.8 到 89.0,带 python 91.3 到 93.4
- BabyVision 带 python 85.7 到 95.4
- ZeroBench 23.0 到 29.8
- PerceptionBench 58.5 到 68.3
- xdev-bench-hard 33.3 到 81.0
涨幅最大的是多步与带工具的行:Agents' Last Exam 加 14.9,HLE 带工具加 14.0。
单发的知识题只加 0.7。GPQA 那 93.5 到 94.2,是这一整套里最平的一处。
形状与官方说法对得上:后训练算力加进去,收益落在「给工具、跑多步」上,落在一口气答对上少。
换了尺子的八处
两个数并排会读成退步。它量的是两套计分。
PostTrainBench:K3 36.6 是 v1、Harbor 实现、三跑平均;K3.1 Pro 36.5 是 v1.2、Claude-Code 脚手架、判分模型统一换成 DeepSeek-V4.1-Flash-1017。17
36.6 到 36.5,是换了两套装置之后的两个 36。
GDPval-AA:v2 是 1686,v2.1 是 1846。AA-Briefcase:1548 对 1678,K3 那一格没标版本。
DeepSWE v1.1:K3 用 Kimi Code 脚手架 67.5,K3.1 Pro 用 Claude Code 脚手架 75.5。
Terminal-Bench:2.1 上 88.3,4.0 上 65.7。两个版本号之间,跨代无从比。
这八处既不能当提升读,也不能当退步读。
网络能力是被削掉的
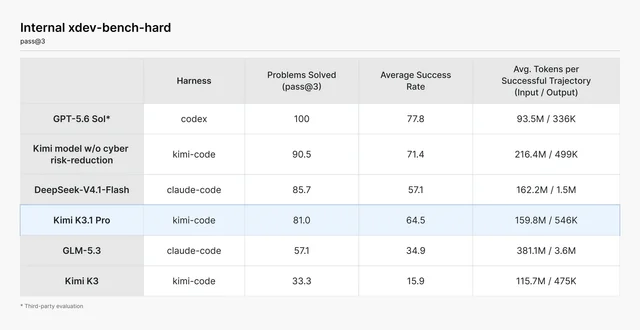
xdev-bench-hard 那张表有六行,其中一行是同一套训练管线、没做网络风险削减的检查点。1
它解出 90.5% 的题。出厂的 K3.1 Pro 是 81.0%。K3 是 33.3%。
削掉的这部分是可量化的:9.5 个百分点的 pass@3。
GPT-5.6 Sol 的 pass@3 是 100%,平均每个成功轨迹 93.5M 输入 token;K3.1 Pro 是 159.8M。1
DeepSeek-V4.1-Flash 在 Claude-Code 脚手架下 85.7,比 K3.1 Pro 高 4.7 个百分点。开源阵营里也有比它更高的。
公开的两行同理:ExploitBench 74.7,GPT-6 Astra 100、Opus 5.5 91.0;ExploitGym 20.7,Astra 42.4、Opus 34.5。1
机制官方写明了。中训练语料里与网络安全相关的内容、RL 环境里与网络任务相关的条目,在开源版本里都被识别并移除,通用编码任务保留。1
目标也写明了:开源权重不把网络能力推到绝对前沿,并逐步提高开源可得的部分。1
这三个数描述的是设计结果。11 月 4 日前发布的权重,是削过的那一版。
还没有的东西
SpreadsheetBench 2 只在中文文档里出现过一句「均取得最佳成绩」。英文博客与 47 行表里都没有这一行,也没有数值。2
8 行内部基准(Kimi Code Bench 两行、Business Operation、DECK-Arena、Design Bench、Hallu 两行、xdev-bench-hard)由发布方自己出题、自己跑、自己判分。
权重承诺 11 月 4 日前发布,现在还没有。1
企业版默认不开启这一款。个人调 API 要先充值,最低 10 元,注册送的 15 元券用不了。2
怎么用这张表
先看最后一列。写着「自跑」的行,对手的数字多半来自对手自己的材料;四行标注 AA 榜或 Mercor 榜的,所有人出自同一套装置。
判断换不换,看那四行第三方:一胜三负,三场都输给 Opus 5.5。差距最大的是 AA-Briefcase,125 个 Elo。
判断长时程编码,看 Terminal-Bench 4.0、SWE Marathon v1.1、DeepSWE v1.1,再补一条 Kimi Code Bench 3.0:Astra 在那行 66.5,压过 K3.1 Pro 的 61.2。
判断金融文档,OfficeQA Pro v2 的 64.4 与 Frontier Finance 的 58.6 都出自自家的装置。
判断网络安全,三个数是 74.7、20.7、81.0。前两个与闭源差 14 到 25 个百分点,第三个还低于同阵营的 DeepSeek 85.7。
跨代先看口径有没有变。八处换了尺子的,表里只留一个数或干脆留空,两个数并排只会读错。
11 月 4 日权重发布之后,47 行里能被外部重跑的是公开基准那 39 行。内部基准那 8 行,往后也只有一个来源。
References
- 1Introducing Kimi K3.1 Pro
kimi.com
- 2Kimi K3.1 Pro 模型介绍
platform.kimi.com
- 3模型推理价格说明
platform.kimi.com
- 4Introducing Gemini 4 Carbon\
blog.google
- 5Gemini 4 Argon Model Card\
deepmind.google
- 6Introducing GPT-6.1 Terra\
openai.com
- 7Kimi K3\
github.com
- 8Introducing GPT-6.1 Terra
openai.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.