盲扫超声估孕周:4.2 天追平专家流程,内罗毕 36 周以上掉到 12 天
385 名孕妇、两座城市、没有超声技师训练的操作者:AI 读盲扫视频估孕周,误差 4.2 天对专家流程的 4.5 天。这份非劣的代价与边界,都写在论文的 Table 2 与患者流图里。

孕周是产科几乎所有决定的基准:什么时候引产、什么时候剖、哪些指标算异常。
全世界每年仍有约 26 万名女性死于妊娠与分娩相关的原因,其中 92% 集中在低收入与中低收入国家,WHO 说其中大多数本可避免。3
要把孕周测准,目前依赖超声技师和超声设备,两样在低资源地区都稀缺。
这次的研究在芝加哥的美国西北大学医学中心与内罗毕的 Jacaranda Health 各招约一半人,共 385 名孕妇。操作者都没有超声技师训练,用的是 Clarius C3 手持探头。
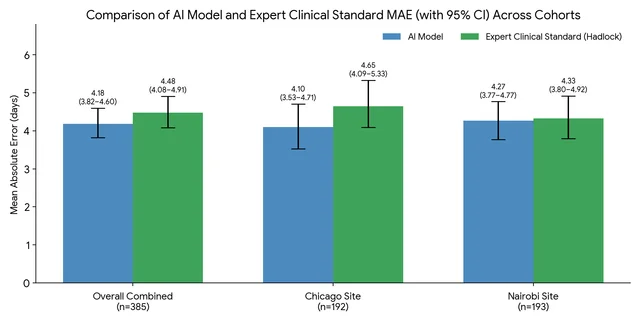
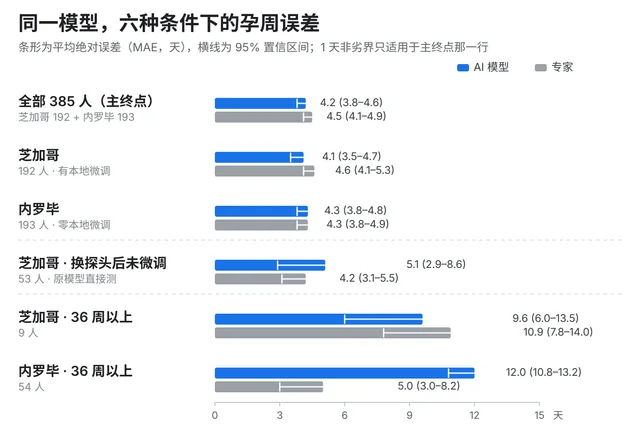
模型估孕周的平均绝对误差是 4.18 天,当地专家按临床标准流程做的估算是 4.48 天。2
这两个数字说明的是,两组误差在这批人身上分不开。能不能挪到别处,要看三件事:换人群、换探头、换孕周区间。
「盲扫」把门槛换成了按路径扫
临床标准流程要求专家在胎儿身上找到几个特定切面,量出双顶径、头围、腹围、股骨长,再套 Hadlock 公式算出孕周。这套动作要练几年。
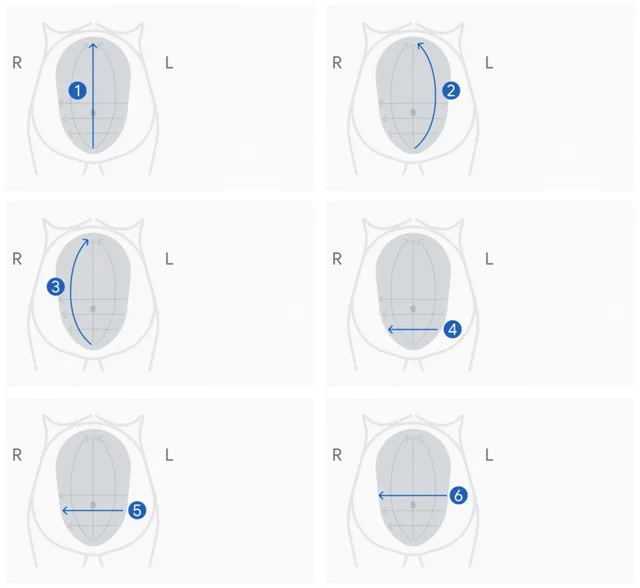
盲扫换了做法:操作者按固定路径在腹部扫六次,三次纵向、三次横向,全程不必判读图像。4
模型吃的是整段视频。49 帧一段里隔帧取 24 帧成一个片段,每个片段输出孕周天数,同时给一个基于方差的置信度,用来拒掉质量差的扫查。多个片段的预测按逆方差加权合成一个数。2
成像深度按宫底高度事先设定:摸不到宫底用 11 厘米,宫底低于 25 厘米用 13 厘米,高于 25 厘米用 15 厘米。2
4.2 天对 4.5 天,参照的是谁
对照组的估算是专家用传统机器量出生物参数、再套 Hadlock 公式得到的结果。真值另有一套:入组时那次早期定孕周扫查。
美国妇产科学会建议定孕周扫查在 22 周前完成,14 周前用头臀长最准。5
判据是 1 天的非劣界,单侧检验,α=.05。论文说这个界沿用既往同类研究。2
全部 385 人上,模型 4.2 天(95% CI 3.8–4.6),标准流程 4.5 天(4.1–4.9),非劣性检验 P<.001。
论文给了 P 值,没给两臂差值的置信区间。读者能看出两者不可区分,看不出这个差离 1 天的界还有多远。
带符号的平均误差给出了另一层信息。标准流程 −0.7 天(−1.3 至 −0.1),统计显著,论文把这一侧表述为高估孕周;模型 −0.2 天(−0.8 至 0.4),不显著。2
泛化其实是两件事
第一件是换人群。内罗毕 193 人,模型没有用任何当地数据微调,MAE 4.3 天(3.8–4.8),与芝加哥的 4.1 天(3.5–4.7)几乎一样。
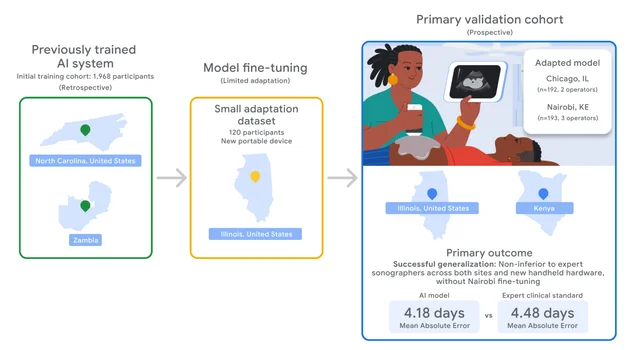
第二件是换硬件。原始模型在 SonoSite、GE、Butterfly 三种探头上训练,这次换成 Clarius C3。
微调集是 120 名芝加哥参与者的 180 次检查,约为原训练集规模的 6%。训练时微调数据与原始 FAMLI 数据等比例混批,学习率从 3.47×10⁻⁴ 线性衰减到 4.58×10⁻⁷,跑 30 万步。2
换硬件的代价可以直接看。未经微调的原模型在芝加哥试点期的 53 人子集上 MAE 5.1 天(2.9–8.6),标准流程 4.2 天(3.1–5.5);微调之后同一站点是 4.1 天。2
那 6% 的数据换来的主要是探头适配,跨人群迁移几乎没花额外数据。这个区分在做部署预算时最值钱。
36 周以上,数字掉了下来
主终点限定在 16–36 周,原因是这个区间落在原模型的训练分布里。36 周以上的读数写在论文 Table 2 里,博客没有引出。
芝加哥 9 人:模型 9.6 天(6.0–13.5),标准流程 10.9 天(7.8–14.0)。论文说明这个点位很少做标准流程,成对样本极小;同一站点更大的 114 人集合上,模型 MAE 是 7.8 天(6.8–8.7)。2
内罗毕 54 人:模型 12.0 天(10.8–13.2),标准流程 5.0 天(3.0–8.2)。
论文对这一段的解释是,内罗毕的超声技师没有对定孕周结果设盲,日常流程里他们已知真值,标准流程因此显得格外准。另一种可能是模型需要在晚孕期针对当地数据重做。2
博客的说法是把孕周预测范围推到 36 周以上。范围确实推过去了,精度留在了 36 周之前。
被评估的 385 人不是最缺超声的那群人
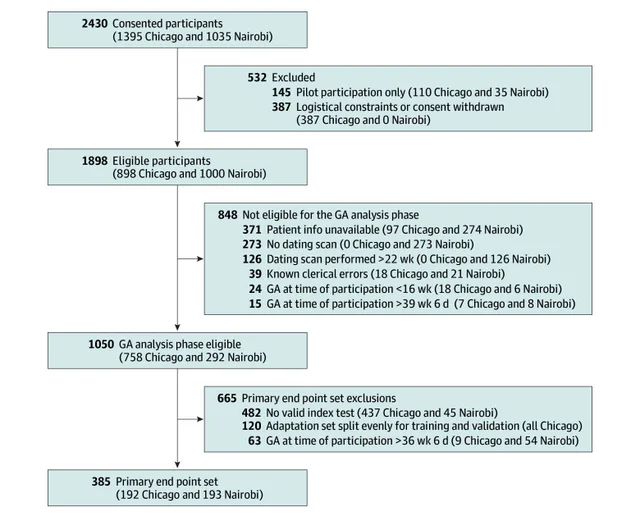
流程图从 2,430 名签署同意者开始,到 385 人结束。中间经过 848 人「不适合进入孕周分析阶段」与 665 人「不进主终点集」两道筛。2
内罗毕 1,000 名合格者里,273 人因为「没有定孕周扫查」被排除,另有 126 人的定孕周扫查晚于 22 周。
芝加哥 758 名合格者里,437 人「没有有效的索引检查」,也就是那次盲扫拿不出可分析的片段。
能进入评估的,都是先做过一次早期超声的人。这个工具想服务的,恰恰是从未做过超声的人。
真值质量两地也不一样。芝加哥 192 人全部在 14 周前完成定孕周,内罗毕 119 人(61.7%)在 14 周前,另外 74 人(38.3%)在 14–22 周才做,用的是孕中期生物测量。2
两个站点都设在城市:一个是芝加哥的学术医学中心,一个是内罗毕的社区诊所网络。
培训改变的是能不能扫出可用片段
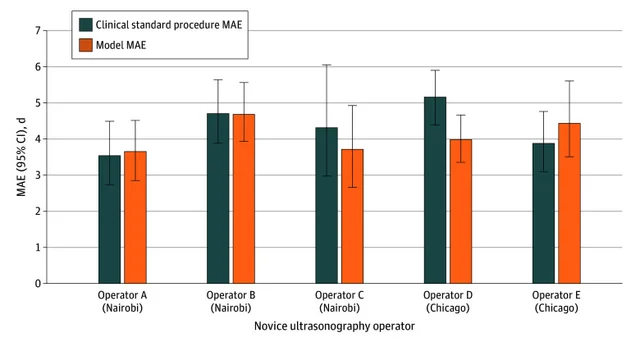
芝加哥 2 名操作者没有正式培训,只有一份讲义、口头说明和一次演示。内罗毕 3 名操作者做了 6 小时实操,包括在仿体与志愿者身上练习。2
两地模型精度几乎相同(4.1 与 4.3 天),差别落在拒扫率上:芝加哥 7.9%,内罗毕 1.8%;每次扫查采到的片段数从 4.2 升到 5.8。
逐人看,5 名操作者里 3 人的模型 MAE 不高于标准流程,另外 2 人更高。差距都在 1 天以内,置信区间很宽,论文的结论是操作者之间的差异不显著。2
部署中还有几件工程事被写进了讨论:可换电池比坞站更实用,软件更新后要回归测试,置信度拒扫要作为产品功能写进流程。
哪些场景能用,哪些还没有证据
先摆一个同级参照。2024 年另一组研究者在卢萨卡与教堂山做了 400 人的前瞻研究,同样用盲扫,MAE 3.2 天对 3.0 天,等效界是 ±2 天,评估窗口 14–27 周,真值来自经阴道头臀长。6
两篇的窗口、真值来源、界都不同,误差不能相减。能比的是这一层:这个任务目前的误差都在 3–5 天量级,哪篇把界设得更紧,就得把人群限得更窄。
这篇能支撑的结论落在几个明确条件上:孕周 16–36 周、城市机构、单一新厂商的探头、先做过定孕周扫查的孕妇、经过几小时培训的操作者。
缺的东西同样明确:任何妊娠结局的改善、监管路径、多厂商探头、多胎妊娠的具体数字(正文只说与标准相当或更好,数据在补充材料)、成本、模型架构。
场景落在这几条之外的话,原文里最该看的是 Table 2 与 Figure 1。前者给全部窗口的成对读数,后者告诉你哪些人被排除在外。
References
- 1
- 2
- 3Maternal mortality(WHO 事实清单)
who.int
- 4
- 5
- 6
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.