Google 把智能体接进湿实验室:适配体三轮命中率 0%→42.1%,而 FAP 表里改评分口径比加自主权多出 23 个百分点
Google Research 用一篇博客给出三个项目,把智能体接到真实移液工作站上:VERID 用语义数字孪生管住物理状态,适配体三轮闭环把 α-凝血酶的命中率从 0% 拉到 42.1%,表位切除把 FAP 的折叠提速 8.6 倍并在酵母展示上拿到 3.0–9.1 nM 的结合体;文章同时点出这三条闭环里真正把指标拉开的那一行。

10 月 16 日,Google Research 发布了一篇技术博客《Grounding AI agents in biological reality: Building blocks for autonomous wet labs》,一次给出三个项目。1
博客把动机写成两条。第一条:前沿模型对三维几何和物理状态的推理仍然不可靠,而湿实验室里的移液机器人处理的恰恰是几何和物理状态。1
第二条:智能体提假设、做计算设计的进展很快,真实实验的读数跟不上,湿实验反而成了更紧的那一环。1
两条动机背后的空间都很大。药物样小分子估计有 1060 个,一条 100 个氨基酸的蛋白有 20100 条可能序列。2
计算端的排名在实验端会明显缩水。论文引用的数字是:即使按 AlphaFold 2 或 AlphaFold 3 的指标严格筛过,仍有 60% 到 80% 以上排名靠前的设计在酵母表面展示等实验里掉队。2
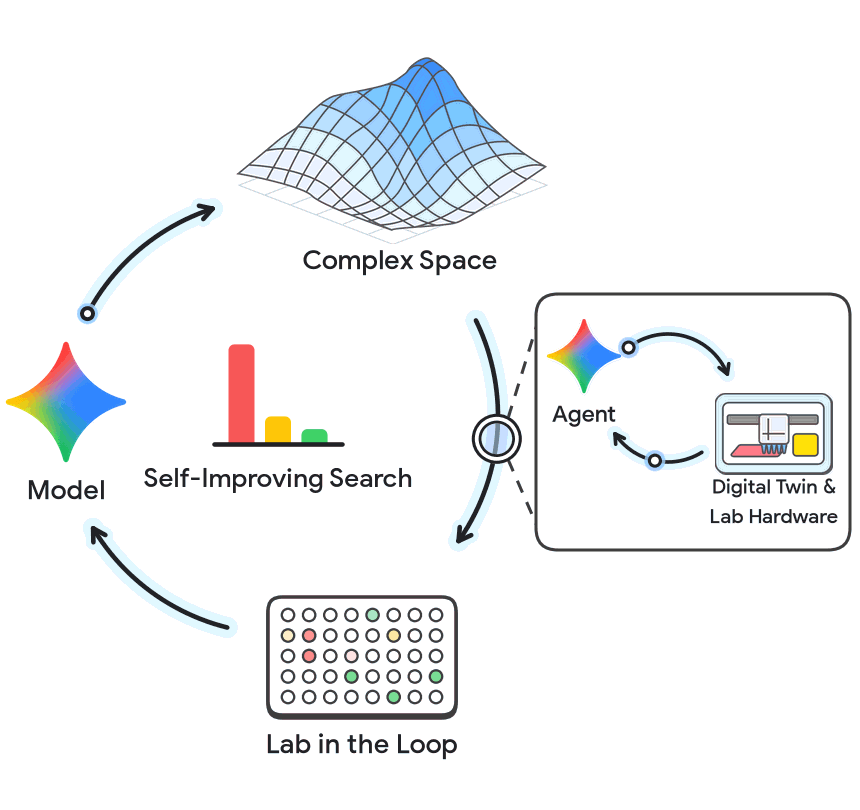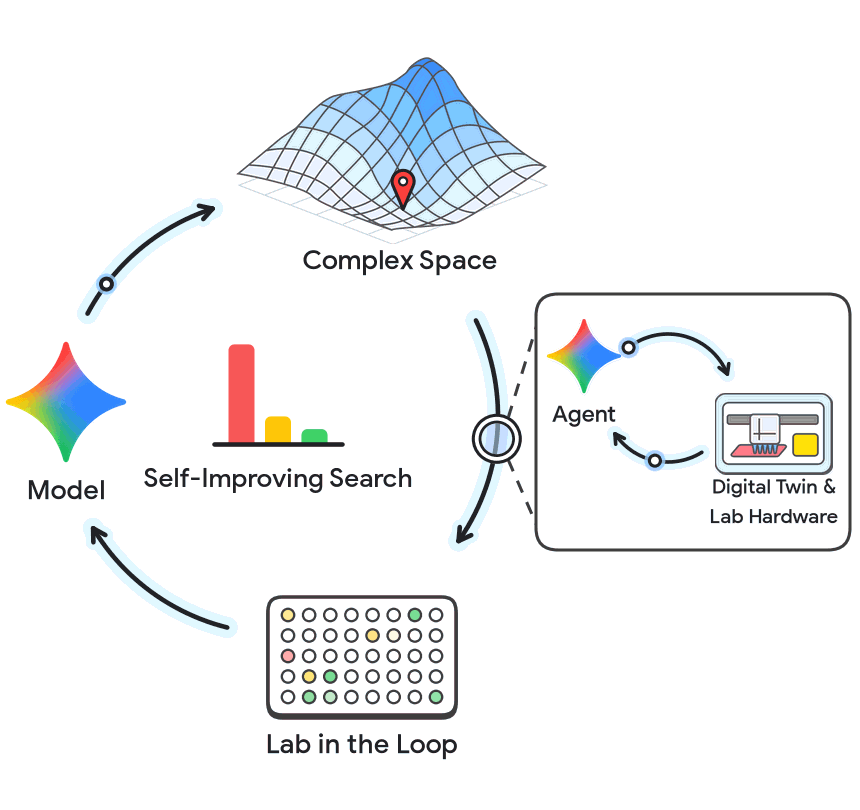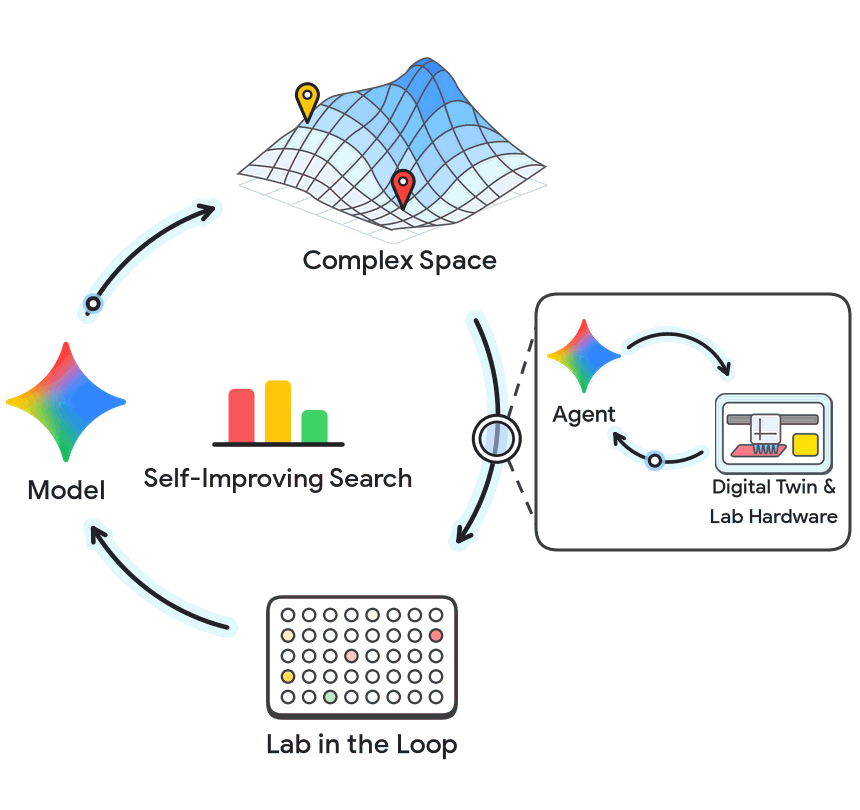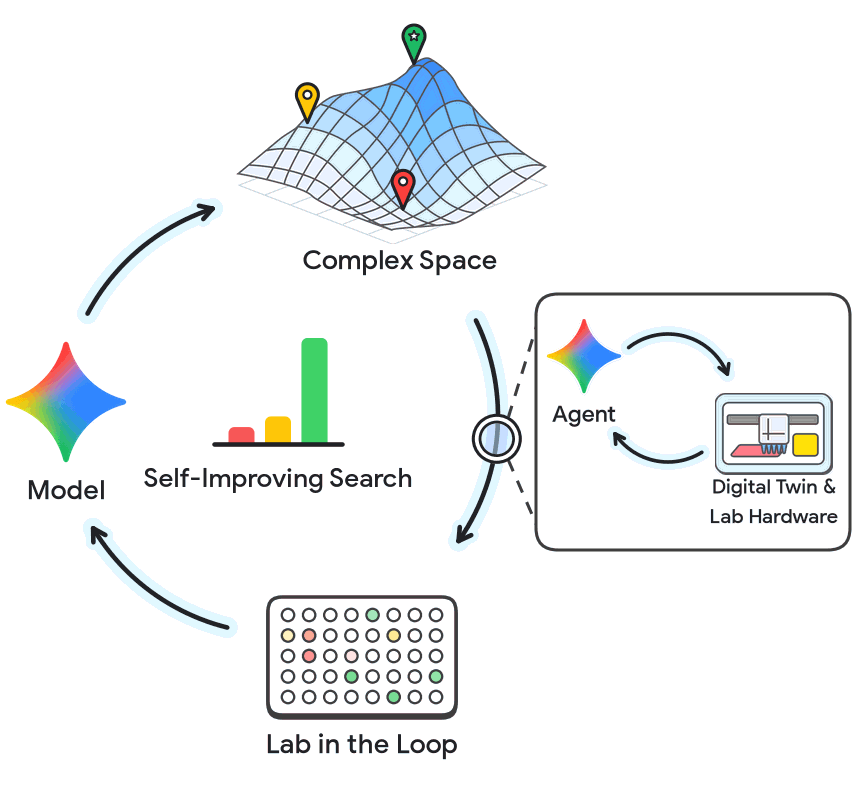
三个项目占的是同一件事的三个位置:VERID 管智能体与硬件之间的物理状态,适配体沙盒管多轮闭环,表位切除管大靶标上的计算成本。1
一个跟着硬件一起变的状态树
VERID 的全称是 Verified Infrastructure for Discovery Laboratories,译文是「面向发现实验室的可验证基础设施」。2
论文特意把它和静态模拟器分开:静态模拟器只预测某个协议会发生什么;数字孪生则与它表示的那套物理系统保持双向的持久连接,记下已经跑过什么,并用这些记录改进下一次预测。2
它维护一棵实时、带状态的实体树,内容从机械臂的姿态、读板机的位置,一直到每一块板、每一个孔里的试剂身份、体积和液面高度,以及还剩几支枪头。2
「孔属于板」「盖子挡住孔口」这类包含与空间关系写在一棵本体层级里。智能体因此可以在动手之前直接问:这块板现在还剩多少体积、有没有可用的枪头。2
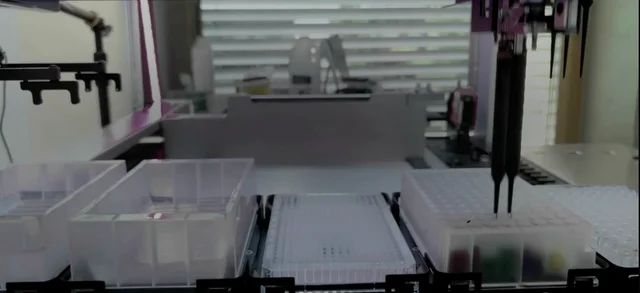
试剂是去离子水加四种食用色素。论文说这是有意为之——避开生物复杂度,换来更快的实验周期、更低的试剂成本和更清楚的指标。2
案例一考的是一条 11 步、每步 2 倍稀释的梯度。第一次执行时,智能体用了默认的孔底坐标,混匀是固定在某个高度做的五次 100 微升循环。2
读板机的数据回来后,实际每一步的稀释倍数是红、绿、黄三种色素的 1.4 到 1.5 倍,蓝色 1.6 到 1.8 倍,目标本是 2.00 倍。2
智能体先猜是混匀不够。操作者回看同步录像,看到的是另一回事:枪尖贴着平底孔的底壁,部分挡住了吸头开口,所以直到枪尖抬起来,色素才真正被带出去。2
改法是把所有转移的底部间隙锁到 1.5 毫米,并在填充范围内做垂直对流混合:先在贴着底部 1.5 毫米处吸 100 微升,再到液面附近 4.8 毫米处吐出,每列四个循环。2
改完之后,管与槽之间的重复间差压到 0.02 倍以内,平均步进稀释倍数回到 1.92 到 1.99 倍。2
这一轮里还有一次意外:液体操作全部完成后,仪器报了状态错误。数字孪生保留了「已洗、已读空白、前三种色素已完成稀释」的虚拟状态,智能体把准备好的板移出读板机、跑一次空腔校准,再补上多波长读板,没有重新吸一遍液。2
案例二换成一个规划题:把四种浓染料在 12 列试剂槽里各自标定到目标光密度。2
模拟器在这里拦下了一次命令:智能体想让 8 个通道同时下到槽里,而 8 支枪尖至少跨 72.0 毫米,超过槽长 71.2 毫米。同一个回合里,智能体改成 7 通道混合、分两批各 4 通道取样。2
跑完之后,相邻稀释级之间出现 15% 到 20% 的浓度差,第 8 通道在所有色素上都掉 28% 到 47% 的吸光度。2
智能体停下列序,自己设计了一组 8 列析因诊断,分两轮跑:第一轮把 12 列全部填好并读空白,第二轮直接从孪生里保留的第 5 到第 8 列接着做,不重复准备工作。2
用干枪尖时,8 个通道的输送是平的,1.58 光密度,变异系数 1.4%,几何和液面跟踪的嫌疑被排除。2
把 7 通道混匀从第 1 到 7 列搬到第 2 到 8 列做反向对照,第 8 通道恢复到 2.20 光密度,那 28.6% 的缺口整体搬到了第 1 通道。根源因此落到别处:250 微升的槽内混匀在 7 支枪头的外壁挂了一层浓染料,做 150 微升孔内混匀时被洗下来,多带了 4.9 微升,相当于多 40.6%。这个数同时解释了 24 微升与 12 微升两个稀释级之间 14.5% 的偏差。2
案例三是端到端的自博弈。一台挑战者机器人配好四份盲配的二元染料混合物和四种纯参考母液,一个看不见答案的解题智能体只有一块 96 孔板、限额枪头和顶部 RGB 相机,要推断每份混合物的组成。2
评分由一台独立的四波长读板机完成,它先封存参考样品测出真实组成和母液浓度,再用 tempered KL 散度把智能体的概率预测打成 millinats,零表示完全复原。2
没有先前经验的那一局,多轮解题 85 millinats,单轮解题 205 millinats,反馈在环里有明显价值。2
到了第二组的第一局,多轮智能体想用高浓度纯母液打点来分辨难分的混合,结果把相机红通道打饱和,还引入小体积移液的方差,四轮之后损失从 247 恶化到 307 millinats。2
它从自己的曲线残差里诊断出了这两件事,把饱和上限和最小转移体积写成操作边界存进经验库。第二局继承这批边界后换成两轮策略:第一轮做稀疏稀释普查,加样前后各拍一次空白,损失 137 millinats;第二轮对前四名候选做四点串联稀释,均值做到 58 millinats,比第一局好五倍以上。2
这套自博弈里冒出来的物理发现包括:斜视相机让外侧孔的孔壁反光混进读数,于是用三维标定把孔口和孔底分开投影,只取无视差的底盘;抽到接近空的母液孔会带进气泡,于是设了最小转移体积与残液下限;三种染料在相机的线性光模型下是简并的,于是改用多点稀释轨迹而不是单点打点。2
VERID 这份报告里没有任何生物结果。它证明的是这套接口能让智能体把物理与光学误差找出来、追下去、并留下记录。2
适配体:挑一个能让闭环快速转起来的分子
要让闭环转很多轮,实验本身得够快。适配体适合当这个沙盒,因为序列本身就是功能分子。3
从设计序列到读出结合,只要三步:合成寡核苷酸池、磁珠拉下筛选、测序。一轮约 10 天,每个候选约 3 美元。3
对照组是传统的 SELEX:从 1013 到 1015 条随机序列里盲筛,每轮六步,要做 8 到 15 轮才能读出序列。蛋白和抗体那条路更慢,从序列到结合读数要经过基因合成、克隆、转化、细胞培养表达、裂解、柱纯化,一轮 3 到 6 周。3
每轮设计约 1,000 条候选,两个靶标各跑三轮。3
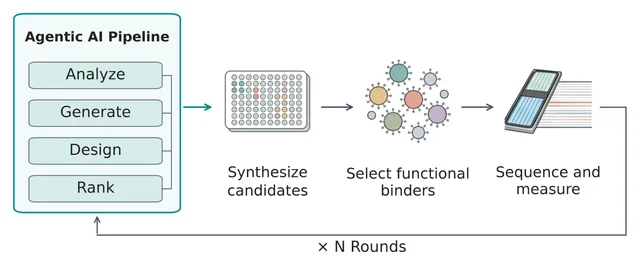
两个靶标的难度故意拉开了。α-凝血酶(α-thrombin)是丝氨酸蛋白酶,表面有两个富电子的阴离子结合位点,天然就能结合核酸,属于有已知解的正对照。3
肌红蛋白(myoglobin)是个紧凑的八螺旋束,表面只有零散的阳离子斑块,没有任何天然的核酸结合沟槽,属于更难的那一侧。3
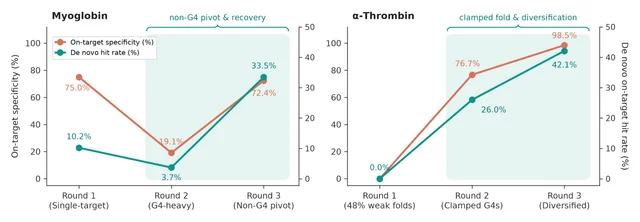
第一轮,α-凝血酶的命中率是 0(0/167)。问题出在引物接头:固定接头破坏了 48% 序列的折叠。3
第二轮给两端加上夹持茎之后,命中率升到 26.0%(54/208);第三轮再多样化,升到 42.1%(131/311),特异性 98.5%,相对 0.3% 的脱靶交叉反应相当于 140 倍选择比。3
肌红蛋白那一侧的走势相反。第一轮命中率 10.2%(20/196),第二轮掉到 3.7%(9/244),特异性从 75.0% 崩到 19.1%。3
第二轮的设计里有 63% 是 G-四链体(G-quadruplex)。智能体当时在追求原始结合强度,而富集确实上去了。问题出在特异性:交叉筛选里 80.9%(72/89)的结合体同时结合了别的靶标。3
分析智能体在没有人提示的情况下从第二轮的测序计数里看出了这件事:97% 的交叉反应结合体是 G-四链体,它们作为多聚阴离子「黏」在脱靶蛋白和裸磁珠上。3
第三轮的动作是双份的:扣掉裸磁珠的残余吸附,同时把库重新分配到六个结构家族。未夹持的 G-四链体从 20.4% 砍到 1.3%,72.3% 的池子转向非 G4 骨架。3
结果是非 G4 家族贡献了第三轮 184 个肌红蛋白命中里的 180 个,占 97.8%,且脱靶交叉反应为 0。H 型假结的命中率 80.4%(37/46),延长的回文发夹 61.8%(47/76),凸环发夹 45.9%(67/146)。3
特异性回到 72.4%,严格 de novo 分子的命中率升到 33.5%(摘要记 184/549,讨论一节记 184/547)。3
富集曲线是不是真的等于结合?论文拿 8 条单独合成的全长构建体做了 5 点平衡滴定。3
8 条里有 6 条出现浓度依赖的结合,1 微摩尔处的端点荧光与第三轮的池富集在接近四个数量级的跨度上线性相关,Pearson r = 0.90,p = 0.0021。3
四条高富集的克隆给出初步表观解离常数 24.6 到 133 nM。作者自己加了一条注:荧光在 1 微摩尔以内没有到达饱和平台,所以这些数只能算 preliminary。3
而且这四条都是已知文献基序的再工程——NU172 与 TBA 架构的茎区被重新设计过。严格从零设计的两条 G4 骨架只做到 1 微摩尔处出现结合起点,KD 大于 1 微摩尔。3
论文还把「不用湿实验,纯算能不能替代」正面测了一遍。12 个开源预测指标、9 个工具,在第三轮肌红蛋白库(1,441 条,292 条命中)上的零样本 ROC-AUC 落在 0.36 到 0.52 之间,也就是随机上下。3
唯一有信号的是 ViennaRNA 的两个与靶标无关的读数:二维热力学稳定性 0.729,折叠纯度 0.763。它能把乱卷的无规链和引物侵入的错折筛掉,但它只判断序列自身折得干不干净,与靶标蛋白无关,因此给不出亲和力或特异性。3
更值得记一笔的是符号:原始的 Boltz-2 界面置信度与特异性结合呈负相关,因为这个模型奖励紧凑的 G-四链体折叠,而正是这种折叠在固相载体上非特异黏附。3
论文顺手做了一个反例:把一个有监督分类器训练在早期筛选轮次、且不做磁珠背景扣除的数据上,它会把 G 串频率当成正特征。
到了后续的库上,这个分类器的准确率直接反转。3
表位切除:把 719 个残基的靶标切到一百来个
蛋白侧的闭环更难。蛋白必须靠生物学方式表达,每一轮都要多出细胞或无细胞的筛选、表达、折叠步骤;序列空间也更大。4
计算侧的主要成本落在重折叠。设计流程先用 RFdiffusion 生成骨架,用 ProteinMPNN 配序列,再把每条候选与靶标一起重折叠、按界面置信度排序;最后这一步吃掉绝大部分 GPU 时间。4
AlphaFold 3 的运行时间按 256 token 的倍数分桶,复合物长度向上取整到下一个桶。而多数候选结合的只是靶标表面很小的一片,绝大部分 token 花在了与结合位点无关的区域。4
表位切除就是只保留接触残基所在的连续序列窗口,外加一圈半径可调的光晕,用这一小片代替整个靶标参与折叠。4
在成纤维细胞活化蛋白 α(FAP)上,完整的胞外域加结合体约 779 个 token,落在 1024 桶里,每折 59.3 秒。
换成 85 到 130 个残基的切除窗口后,它落进 256 桶,每折 6.9 秒。单折削减约 88%,博客对外写的是 8.6 倍。4
几何保真站得住。15 个靶标、3,666 条设计上,切除后与完整靶标的界面核 Cα RMSD 中位数是 0.37 埃,均值 0.53 埃,88.2% 低于 1 埃。4
把 394 条已确认的结合体重新对完整靶标折叠对照,切除侧的中位 RMSD 是 0.29 埃,98.5% 通过 3 埃的门;完整靶标侧也是 0.29 埃,97.2% 通过。4
排序会掉,幅度有限。11 个有足够正例的靶标上,平均 AP 从 0.466 降到 0.401,配对 bootstrap 的 95% 区间是 −0.130 到 +0.019;ROC-AUC 从 0.777 降到 0.729。4
掉分并不均匀,主要来自几个浅比对或局部几何敏感的靶标:pMHC_NY1 从 0.50 掉到 0.02,PdL1 从 0.48 掉到 0.25,IL7Ra 从 0.48 掉到 0.30。4
去掉目标多序列比对,切除侧的平均 AP 反而回到 0.454,离完整靶标基线只差 0.012。
方向并不统一。深比对的靶标变好,PdL1 从 0.25 升到 0.54;浅比对的 SARS-CoV-2 RBD 直接腰斩,从 0.49 掉到 0.24。
论文的结论是这件事要逐靶决定。4
切多小有硬地板:保留残基少于 85 个时会掉进 3 埃以上的失败区。
最敏感的是浅比对的 VirB8。光晕从 0 埃加到 11 埃,它的中位界面 RMSD 依次是 5.73、4.38、3.90、0.29、0.24 埃。4
省算力有前提。15 个靶标里有 7 个的完整复合物本来就落在最小的 256 桶里,切了不会更快;真正跨桶的只有 5 个靶标上的 253 条设计。4
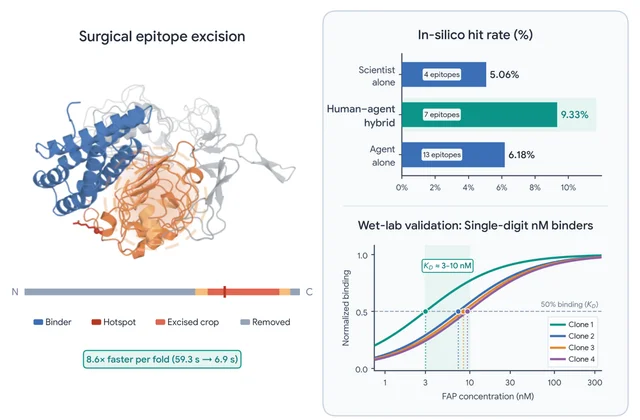
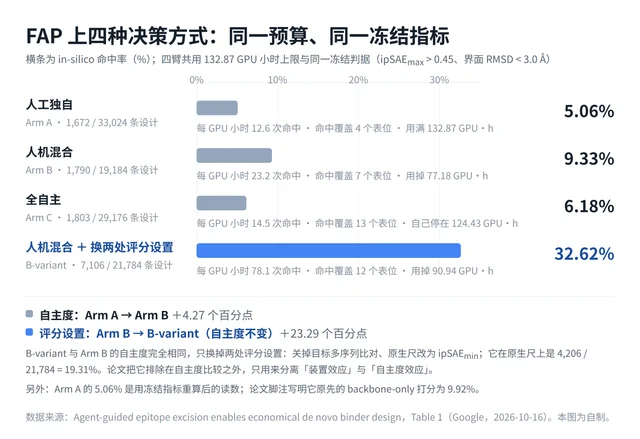
FAP 那个自主度实验值得单独看。三个主条件下,命中判据与 GPU 时间预算完全冻结:ipSAEmax 大于 0.45,界面 RMSD 小于 3.0 埃,上限是人工基线用掉的 132.87 GPU 小时。4
A 组是研究员独自操作,命中率 5.06%(1,672/33,024)。
B 组是人机混合:研究员定下催化口袋边缘这个策略,具体表位集合、切除尺寸和算力分配交给 Gemini 3.1 Pro。
B 组的命中率 9.33%(1,790/19,184),只用了 77.18 GPU 小时,相当于每 GPU 小时 23.2 次命中;A 组是 12.6 次。4
C 组是彻底放手:智能体只拿一张与策略无关的全靶表面残基清单,自己提出目标。
它交出的方案是封堵催化通道口,筛条件是催化三联体 15 埃以内、溶剂可及表面积大于 60、晶体学 B 因子比小于 1。
这套条件与人类研究员事先设计的理由基本一致。C 组命中率 6.18%,但把命中摊到了 13 个不同的表位。4
同一张表里还有第四行,博客和官方结果图都没画。它用与 B 组相同的自主度,只换掉两处评分设置:关掉目标多序列比对,原生尺从 ipSAEmax 换成更保守的 ipSAEmin。4
这一行在冻结指标下的命中率是 32.62%(7,106/21,784),每 GPU 小时 78.1 次命中。4
把它和 B 组并排:多给智能体自主权,命中率从 5.06% 抬到 9.33%,多 4.27 个百分点;同一自主度下换掉两处评分设置,从 9.33% 抬到 32.62%,多 23.29 个百分点。4
论文自己写得很清楚,这一行被排除在自主度比较之外,只用它来分离「装置效应」和「自主度效应」。4
还有一处分母变化要记:A 组的 5.06% 是用冻结指标重算过的读数,脚注写明它原先的 backbone-only 打分为 9.92%。4
计算端的预测最后由湿实验检验。研究者把四条主条件各取 1,250 条设计,组成一个 5,000 条成员的酵母表面展示库,另加每序列 2 到 3 个碱基的随机突变。4
库经过三轮荧光激活细胞分选(FACS),靶标浓度依次降到 300、150、75 nM。MinION 深度测序回收 571 条富集的唯一序列,其中 60 条与计算设计精确匹配。4
四个代表克隆的平衡滴定给出 3.0 到 9.1 nM 的表观解离常数。论文把可溶性表达的复测、FAP 结构域特异性和催化活性抑制都列进了后续工作。4
三份材料并排看
VERID 的位置是物理状态:三组案例里智能体实际追查的偏差是孔底贴壁、枪头外壁挂膜、斜视相机的孔壁反光与 8 位通道截断。2
适配体沙盒的位置是测量的特异性:第一轮的 0% 出自引物接头破坏折叠,第二轮的塌方出自 G-四链体在固相载体上的非特异黏附,两次修的都是测量与样品本身。3
表位切除的位置是评分口径:FAP 那张表里最大的一个变量是尺子,不是决策权。4
为什么误差会集中在这里,可以从三处各自的处置方式里看出来。VERID 的办法是把每次测量绑到当时的物理状态上,让残差可归因。2
适配体论文里的机制更直接:固相载体上的非特异吸附会同时产生假阳性和假阴性。
不去掉它,任何基于这批数据的迭代都会朝装置的伪影收敛;那个准确率反转的分类器演示的就是这条路径。3
表位切除那一行则说明打分尺本身也是装置的一部分:论文把目标多序列比对的开关列为影响读数的因素,并给出一个逐靶决定的操作建议。4
上面的判断只覆盖这三份材料。1
缺的是什么
适配体论文写明了数据的去向。摘要级的富集统计、基准指标、代表性序列与单克隆滴定数据随文提供。
完整的去标识化序列—活性表和差异富集表要等到同行评审发表之后。3
代码侧写的是「用标准的语言模型 API 与多智能体编排模式搭建」,四阶段架构与统计公式在方法一节里,供别人在任意工具化平台上复现。3
VERID 那一侧没有任何生物结果,三个案例全部是染料与水。2
适配体侧严格从零设计的分子只到微摩尔量级,纳摩尔那一档来自 NU172 与 TBA 这两个文献基序的再工程,并且单克隆滴定只做了 α-凝血酶上的 8 条,荧光没有到饱和平台。3
表位切除的自主度结论只有一个靶标、一种骨架(三螺旋束)、一个控制器(Gemini 3.1 Pro)。论文把这些列为后续工作。4
FAP 的湿实验只验到「四个克隆有纳摩尔结合」,可溶性表达、结构域特异性和催化抑制都还没做。4
口径上还有三处需要读者自己留意的差异:博客说肌红蛋白命中率「上涨九倍」,那是相对第二轮 3.7% 算的,相对第一轮 10.2% 只有 3.28 倍;A 组的分母从 9.92% 换成了 5.06%;论文内部对肌红蛋白第三轮的分母有 549 与 547 两种写法。134
下一个能核的节点
VERID 的控制层建在 PyLabRobot 上,那是一个开源的硬件无关框架,文档里能查到各家移液器的驱动与资源模型,这是三个项目里唯一可以直接拿到手里试的部分。5
适配体那条线在生物安全上有两重约束。所有靶标都是非感染性的人源蛋白,在 BSL-1 条件下操作。
寡核苷酸池由 IDT 商业合成,走的是国际基因合成联盟的筛查协议与美国 HHS 的核酸合成筛查框架。3
Google 一侧把安全工作写成三条。第一条是只用非感染性、无功能增强风险的受控体系做测试床,设计的每一条序列都过生物安全筛查。
第二条是所有协议先在 VERID 里干跑,验证通过才碰试剂。第三条是设计的序列、湿实验协议和机器人运行都留人工授权与复核。1
真正的下一个读数,是论文自己写下的那句「下一步是把这些线织在一起」:把 VERID 的可追溯自动化接到蛋白发现的闭环学习上。1
References
- 1
- 2
- 3
- 4
- 5PyLabRobot 文档
docs.pylabrobot.org
- 6Updating the Frontier Safety Framework
deepmind.google
- 7Our approach to bioresilience
deepmind.google
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.