10月20日语音与音频栏:专家语音当偏好目标反把 WER 从 3.87% 推到 4.59%、一步蒸馏只掉 0.0245 分、指令一抽象 F1 从 1.00 掉到 0.77:长程智能体与生成式音频的 9 篇分层雷达
本期把该账号 10 月 20 日发布的语音与音频学术速递 18 篇逐条筛完,收录 9 篇:专家语音当偏好目标反把 WER 从 3.87% 推到 4.59%、一步蒸馏只掉 0.0245 分、混音智能体的编辑图 F1 在指令一抽象时从 1.00 掉到 0.77。

本频道盯「arXiv 每日学术速递」的三个栏目:人工智能、自然语言处理、语音与音频学术速递。本期只等到 2026 年 10 月 20 日 16:57(GMT+8)发布的一栏:语音与音频学术速递[10.20],18 篇。同一天的人工智能与自然语言处理两栏,到本期成稿时该账号还没有发布;这两栏发布后由下一期接着处理,本期不预支。
公众号正文只展开每栏前 8 篇,完整名单在它自己的官网 arxivdaily.com 上。本期候选池按该官网同日同名栏目的完整条目重建:cs.SD 分类下当天共 36 条列表条目(含交叉投稿与版本更新),其中被站点标为「新提交」的 18 条,与该图文标题里的「共 18 篇」吻合,构成本期候选池。
站点条目带英文原题、中文题、机构与 AI 总结,与公众号条目同源;站点条目与 arXiv 原文不一致的地方,我们在条目里逐条标出。每篇在全景表里都给出公众号栏目、站点条目与 arXiv 全文三处入口。
本频道的候选池固定为该账号这三个栏目;arXiv 摘要页、arXiv 原文,以及论文原文明确链接的作者官方代码仓库、项目页与数据页,本期只用于核验与复现情况。
18 篇逐条读完后收录 9 篇,排除 9 篇。
排除集中在三类。与四条线没有共用接口的音频识别与检索工程 4 篇:电话语音信箱检测、音频指纹、说话人验证的参数高效微调、少样本音频分类。偏检测器结构与部署的深度伪造检测 2 篇:多源不平衡的跨模态融合、纯整数流式边缘检测。读完全文发现搬不动的 3 篇:音乐结构分析、深伪检测的音频前端(音频标签全为真实音频,全文没有合成语音可检测性的测量)、病理语音 ASR 个性化(单说话人 215 条话语,没有重复运行与统计检验)。编号列在末节。
编号列在末节。收录的 9 篇按与四条研究线的关系分层:直接命中 4 篇、邻近跟踪 5 篇。再按建议的阅读投入分档:精读 3 篇、值得扫读 4 篇、其余 2 篇为第三档,全景表里记作优先级 3。
四条线按每篇的主要归属计:大模型长程任务的训练与评估(A 线)3 篇、轨迹学习与自进化(B 线)1 篇、TTS 生成与评估(C 线)5 篇、播客生成与节目级评估(D 线)0 篇。C 线占多数,与这一栏当天的构成一致。
本期有五条判断值得先记住,理由与限定写在各自条目里。
专家语音当偏好目标,学生不一定变好:CosyVoice-1 用 DPO 学 LibriTTS 真实录音,test 上的宏平均 WER 从 3.87% 升到 4.59%;换成 Qwen3-TTS 的合成专家反而降到 3.27%,而这两次专家探针的 token 对数似然都在下降(0.348 与 0.318 nats/token),分数却一次变差、一次变好。 1
十步压成一步只掉 0.0245 分,但直接压会塌:同一份 Matcha-TTS 教师,十步的 UTMOS22-Strong 是 2.2923,蒸馏后的一步是 2.2678,直接单步只有 1.6846;端到端推理从 0.0662 秒降到 0.0312 秒,参数量仍为 20.898M。 2
指令一抽象,智能体的执行精度掉到五分之一:同一段混音编辑,显式指令下 kimi-k3、claude-fable-5、deepseek-v4-pro 的 Graph F1 是 1.000、0.984、1.000,只说想要的声音时是 0.801、0.778、0.773;参数容差命中率从 93.4%、82.6%、97.5% 掉到 20.7%、21.5%、22.3%。 3
同一个问题换一种「真值」,两个分数就不能比:表达条件与听者硬多数各取最优时是 0.825 对 0.746,把两者统一到同一参考后是 0.739 对 0.731;而听众投票一散,硬标签准确率从全一致的 0.923 掉到唯一最高票低于六成的 0.440。 4
合成数据涨的分不会自己搬到真实数据上:合成口哨查询的 top-1 从 0.180 升到 0.251,同一批模型在 339 条真实口哨上从 214 条降到 210 条;另一头,合成的错误推理轨迹放进监督微调会让三个基准各掉 0.5–0.9 个百分点,留到直接偏好优化之后,整套流程比最强的监督微调再高 1.0–1.9 个百分点。 56
全景表
| 优先级 | 层级 | 论文(英文原题 · arXiv ID) | 改动位置(维度) | 核心可比结果(含比较对象与口径) | 阅读风险与证据局限 | 入口 |
|---|---|---|---|---|---|---|
| 1 | 直接命中 | Does Expert Supervision Improve Text-to-Speech? An Empirical Study of Preference Optimization · arXiv:2610.25292 | 训练侧:专家语音作偏好目标时的目标函数与监督路径 | CosyVoice-1 用 DPO 在 LibriTTS test 上宏平均 WER 3.87%→4.59%(β=0.1);换 Qwen3-TTS 合成专家 3.87%→3.27%;两次的专家探针似然为 −0.348 与 −0.318 nats/token | 单次运行、点估计;无主观 MOS,音质只靠 NISQA 预测分;表 1 与表 2 的 WER 口径不同 | 栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | MixiSpeech: Progressive State Distillation for One-Step Vietnamese TTS · arXiv:2610.25394 | 推理侧:把 10 步条件流压成 1 步的渐进状态蒸馏 | 100 对共享测试上 UTMOS22-Strong 2.2678(十步教师 2.2923、直接单步 1.6846);端到端 0.0312 秒对 0.0662 秒,参数量同为 20.898M | 单种子单次运行;人评只报均值无区间;CER 2.83% 未追上教师 2.72% | 栏目 · 官网条目 · 全文 |
| 1 | 直接命中 | TOMORI: A Tool-Orchestrated Mixing Operator for REAPER Interaction · arXiv:2610.25344 | 评测侧:把「说得清」拆成三档指令,工程状态与渲染音频分开计分 | Graph F1 在显式指令下 1.000/0.984/1.000(kimi-k3、claude-fable-5、deepseek-v4-pro),只说想要的声音时 0.801/0.778/0.773;参数容差命中 97.5%→22.3%(deepseek-v4-pro) | 无重复种子与区间;990 例不独立(同一首歌 110 条转移);成对比较只在 36 步与 28 步子集上 | 栏目 · 官网条目 · 全文 |
| 2 | 直接命中 | VoxDub: A Bilingual Lip-Synchronized Audio-Visual Dataset for Automatic Video Dubbing · arXiv:2610.25259 | 数据侧:双语唇同步配音语料的六步筛选管线与阈值 | 766,708 条、约 1.58K 小时;英文对 LRS3 把 Seed-TTS test-en 的 WER 从 12.54% 降到 3.01%,但配音侧的唇音同步置信度 LSE-C 从 7.10 降到 6.29 | 单次训练、无区间;语料量与对照不匹配;中英转写标注与 WER 同源 | 栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Long Listening Thoughts: Eliciting Open Auditory Reasoning with Deliberative Perception and Cognitive Refinement · arXiv:2610.24409 | 轨迹侧:合成错误轨迹并按 SFT 与 DPO 分层使用 | 错误→改正轨迹混进 SFT 掉 0.5–0.9 个百分点(76.3→75.8 等),留到 DPO 涨 1.0–2.2;MMAU Test-mini 71.5→78.2 | 单次运行;摘要用引用基线(作者复现为 74.6),增益按复现算只有 3.6 个百分点 | 栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | Label Authority in Speech Emotion Recognition: Intended and Perceived Ground Truth in Emozionalmente · arXiv:2610.26446 | 评测侧:同一批音频的三种标签权威与按一致性分层报告 | 各自参考下表达 0.825 对听者多数 0.746;共同参考 0.739 对 0.731;一致性分层上 0.923→0.440 | 单语料、表演语音、每段 5 票;最佳层按测试集挑;平票规则任意且涉及 715 段 | 栏目 · 官网条目 · 全文 |
| 2 | 邻近跟踪 | MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control · arXiv:2610.26684 | 条件层:把帧级音频条件换成 120BPM 归一化的符号总谱 | Task 1 库内检索命中 0.97(Suno-v5.5 0.98);身份保持盲听 3.45 对 3.81(Bonferroni 校正后 p=0.006) | 32 首参考曲由对手模型生成;检索库仅 32 首;Task 2 基线为作者自实现;无重复生成 | 栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | AudioScorer: Learning Question-Aware Token Relevance for Large Audio Language Models · arXiv:2610.26258 | 评测侧:剪枝损失按任务分列并给未剪枝上界 | 10% 保留率下 7/10 任务最优;ASR 31.25 对未剪枝 97.68;MMAU-Pro 加权分 48.51 对 48.57 | 单骨干、单次运行;三档保留率共用一套排序;训练仅约 8,000 例 | 栏目 · 官网条目 · 全文 |
| 3 | 邻近跟踪 | Whistle and Wrong Lyrics: Synthetic Queries Are Not Enough for Real-World Query-by-Melody · arXiv:2610.25371 | 评测侧:合成查询的增益必须配真实同批配对差 | 合成口哨 top-1 0.180→0.251;339 条真实口哨 214→210 条;闭集真实微调 0.631→0.673 | 每轮单种子;真实侧仅 8 首歌 339 条;闭集提升不等于开集能力 | 栏目 · 官网条目 · 全文 |
一、TTS 的偏好监督:专家示范能不能教会学生
1. 专家语音当偏好目标:DPO 把宏平均 WER 从 3.87% 推到 4.59%
Does Expert Supervision Improve Text-to-Speech? An Empirical Study of Preference Optimization · arXiv:2610.25292 · 精读
研究问题与核心方法:拿专家语音当偏好优化里的 chosen 响应,是 TTS 后训练的常见做法。问题在于,专家语音本身质量高,并不说明学生能学得进去,也不说明更好地拟合专家就等于更好的语音。作者固定学生与专家,只改目标函数与监督路径。
学生有两个:CosyVoice-1(300M,微调语音 token 自回归的 LLM 部分)与 GPT-SoVITS v4。专家源也有两个:LibriTTS 的真实录音与 Qwen3-TTS-12Hz-1.7B-Base 的合成语音。
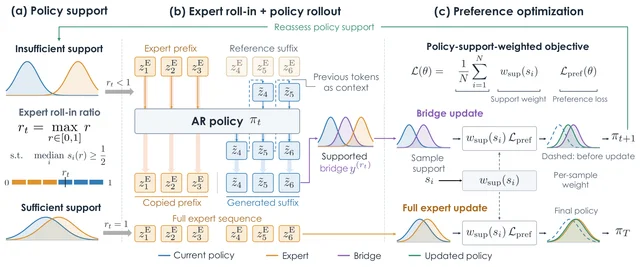
专家语音先编码进学生自己的语音 token 表示,学生只能在这套表示里靠近专家。目标函数比了四个:DPO、WPO(按当前策略概率重加权离线偏好对)、APO-zero(把锚定项分别作用于 chosen 与 rejected 分数)、NCA(显式奖励下的绝对似然优化)。
监督路径比了两条:Direct 用整段专家序列作 chosen、初始学生生成作 rejected;Bridge 改写自 InCo-DPO,第一阶段只把专家前缀拼上学生续写当 chosen,第二阶段回到整段专家目标。
Bridge 的前缀比例不靠人工设定:作者用 dev 集算每个样本的相对似然支持度 s,取中位数,在 0 到 1 的候选里挑满足阈值 τ=0.5 的最大值作前缀比例,再按 4s(1−s) 给该样本的偏好损失加权。1
实验在 LibriTTS 上做:train-clean-100 训练、dev-clean 选比例、test-clean 的 4–10 秒子集与英文 SEED TTS Eval 评测。每个学生–专家组合的 Bridge 数据约 3.6 万条、57–58 小时。指标是宏平均 WER(句级错误率取平均,用 Whisper-large-v3 转写)、ERes2Net 的说话人相似度、NISQA 预测音质,外加固定探针上的 token 对数似然变化。全文没有主观听测。
关键结果:
- 同一段专家语音经学生表示重建后掉分:LibriTTS 真实录音的 WER 从原始 3.2% 变为重建后 4.1%,而预训练学生本身是 4.2%;Qwen3-TTS 合成语音只从 2.7% 变到 2.9%。1
- β 从 0.1 降到 0.01 时 DPO 崩塌:CosyVoice 在 LibriTTS test 的宏平均 WER 从 4.59% 升到 29.78%,在 SEED TTS Eval 上从 6.33% 升到 63.02%;WPO 同向,从 4.81% 到 25.57%、从 6.58% 到 49.08%。1
- APO-zero 与 NCA 对同一档 β 几乎不敏感:β 取 0.01 与 0.1 时,两者在 LibriTTS test 的 WER 都落在 3.67%–3.77%,低于预训练学生的 3.87%;NCA 在 β=0.01 时 SEED TTS Eval 的 WER 为 3.39%。1
- 固定专家探针上的似然方向与生成质量脱钩:DPO 与 WPO 让专家探针的平均 token 似然下降 0.348 与 0.295 nats/token(似然上升的探针占比 0%),APO-zero 与 NCA 则上升 0.083 与 0.033(占比 99.8% 与 96.0%);四个目标都把 99.9%–100% 的初始学生探针似然压低。1
- Bridge 只减损、不超越:CosyVoice 配真实监督时,DPO 的 LibriTTS WER 从 Direct 的 4.59% 降到 4.26%,WPO 从 4.81% 降到 4.18%,仍高于预训练学生的 3.87%;GPT-SoVITS 的 DPO 从 18.12% 回到 9.50%,正好等于它的预训练水平。1
- 换成 Qwen3-TTS 合成专家后方向翻转:CosyVoice 走 DPO Direct 把 LibriTTS WER 从 3.87% 降到 3.27%、SEED 从 4.27% 降到 2.60%,此时专家探针似然是 −0.318;同一设置的 Bridge 把 SEED WER 又抬到 3.48%。1
- 配对 bootstrap(1000 条共享话语、10000 次说话人重采样)显示,CosyVoice–Qwen 的 Bridge 第二阶段相对第一阶段,WER 上升 1.04 个百分点(95% 区间 [0.68,1.50],DPO)与 1.01 个百分点([0.68,1.39],WPO)。1
证据与局限:全文没有随机种子重复,作者明说结果是点估计、不声称统计显著性;唯一的不确定性是 WER 的配对说话人 bootstrap,且只反映评测样本的抽样误差。成对设计本身是干净的:2 个学生 × 2 个专家源 × 4 个目标 × 2 条路径,训练与评测划分不重叠。三条限定必须带上。
其一,全文没有主观听测,音质只靠 NISQA 预测分,而 NISQA 与可懂度在本表里多次反向。其二,表 1 的语料级 WER 与表 2 的宏平均 WER 各用一种口径,作者在正文里明说两者不可互换。
其三,GPT-SoVITS 真实监督下 DPO、APO-zero、NCA 三条 Bridge 行在 LibriTTS 上与预训练逐位相同(WER 9.50%、说话人相似度 0.387、NISQA 3.767),这三格更像回退,不宜用于精细比较。1
与目标研究线的连接点:这篇给 C 线一套判定「后训练到底有没有用」的顺序。先报专家语音的原始质量,再报经学生表示重建后的质量,两者之差就是学生表达能力的上限;然后报固定探针似然,看拟合是在上升还是下降;再报生成指标;最后才是主观分。
作者还示范了一次 β 敏感性测试,正是这一步把「DPO 有效」与「β 选得巧」分开。可搬走的判断是:似然只说明模型更会拟合目标,与语音是否变好是两件事。1
结论建议:建议读 §3.2 的重建实验、§5.1–5.4 与表 1–表 3。引用时必须限定:LibriTTS、英文、两个学生、单次运行、1000 条共享话语。作者自己的结论是路线收益随目标、学生与专家源变化,没有一条路线稳定占优。1
二、把多步流匹配压成一步:蒸馏掉多少、剩下多少
2. 十步压成一步:UTMOS22-Strong 只掉 0.0245,端到端 0.0662 秒变 0.0312 秒
MixiSpeech: Progressive State Distillation for One-Step Vietnamese TTS · arXiv:2610.25394 · 精读
研究问题与核心方法:条件流 TTS 用少量采样步就能出好音质,但把剩下的轨迹直接压成一次更新,质量会明显下滑。
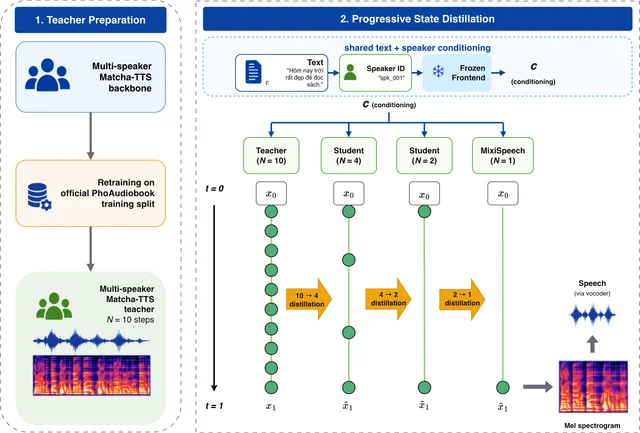
MixiSpeech 不去训一个新的单步模型,而是把同一套网络逐级「减步」:教师走 10 步,学生依次学 4 步、2 步、1 步,每一级都只学相邻两级端点之间的那段轨迹,用掩码状态匹配把学生的中间状态对齐到教师的积分端点。级数越少,每一步跨过的区间越长,但每级只学一小段,不会一步跨完整条轨迹。
实现上保留原架构与说话人条件,前端与声码器都不动。2
实例是一个 710 说话人的越南语 Matcha-TTS,从零在 PhoAudiobook 上训练,声码器是冻结的 24kHz HiFi-GAN。评测用 100 对共享的文本–说话人组合,指标为 UTMOS22-Strong(SpeechMOS 的 strong 档神经预测分)、用 PhoWhisper-large 转写算出的 WER 与 CER,以及同机端到端时间与实时率。另做了一次 22 人的盲听,每人每系统评 8 条,5 点量表分自然度、可懂度与说话人相似度。
关键结果:
- 直接单步会塌:同 checkpoint 的 MAT-1 在 100 对共享测试上拿到 UTMOS22-Strong 1.6846、WER 6.21%、CER 3.71%,而十步教师 MAT-10 是 2.2923、4.65%、2.72%。2
- 蒸馏后的一步回来了:MixiSpeech 为 2.2678、4.63%、2.83%,相对十步教师只差 0.0245 分、WER 低 0.02 个百分点、CER 高 0.11 个百分点。2
- 一步胜过两步:MixiSpeech 的 2.2678 高于直接两步的 MAT-2 的 2.2485,WER 4.63% 对 5.13%,CER 2.83% 对 3.56%,而声学评估次数只有一半。2
- 加速来自评估次数:端到端从 0.0662 秒降到 0.0312 秒、实时率从 0.0121 降到 0.0055,即 2.12 倍;各档参数量同为 20.898M,加速全部来自评估次数。2
- 盲听同向但幅度小:MixiSpeech 的总体分 4.61,高于直接单步的 4.04,接近教师的 4.66;说话人相似度 4.54 与教师持平,自然度 4.66 与可懂度 4.62 略低于教师的 4.74 与 4.69(22 人 × 8 条 × 8 系统)。2
- 外部参考的排序在两项指标上互相矛盾:XTTS-v2 越南语的总体分 4.68 高于 MixiSpeech 的 4.61;F5-TTS 越南语 1000 小时版的 UTMOS22-Strong 只有 2.1180、WER 32.88%,200 小时版同一神经预测分为 2.6845 但 WER 35.81%,盲听总体分只有 3.00 与 2.78。2
证据与局限:单种子、单次运行,探针与计时都注明每对只跑一次,全部是点估计;盲听只报均值,没有区间与检验,作者自己说小差异不应读作显著。
可控的是对照本身:MAT-10、MAT-4、MAT-2、MAT-1 与 MixiSpeech 共用同一教师 checkpoint、同一 100 对测试、同一前端与声码器,所以「粗化采样」与「蒸馏」的差别是干净的。
三处需要自己补上:CER 2.83% 并未追上教师的 2.72%,而 WER 4.63% 反低于教师的 4.65%,两个可懂度指标方向相反:对 WER 是反超,对 CER 仍未追平。项目页的人评表与 arXiv PDF 表 3 数值不同(项目页教师 4.31、MixiSpeech 4.26,PDF 为 4.66、4.61),引用须以 PDF 为准;论文只有一条 10→4→2→1 课程,没有 10→1 直接蒸馏的对照。2
与目标研究线的连接点:C 线做一步生成时,报告清单可以直接照搬:评估次数、UTMOS22-Strong、WER、CER、端到端时间、实时率,外加一个「同 checkpoint 的直接单步基线」。缺了这一项,两种解释会混在一起。
方法上,掩码端点匹配不改扩散专用参数化、也不动说话人条件通路,是低延迟部署里改动最小的位置。它还给出一个可复用的失效判断:采样次数一粗,感知指标掉 0.6 分以上,WER 只涨 1.56 个百分点——评估一步模型不能只看 WER。2
结论建议:读 §3.1–3.2(式 5–10,尤其「教师端点不可组合」那段)、§4.1 的实验设置与表 1–表 3。引用时限定:越南语、710 说话人库存内、100 对测试、单种子、无显著性检验。2.12 倍只是 0.0662 秒到 0.0312 秒的同机测量,适用范围限于这份配置与这台机器。2
三、配音语料:先保住语音,再查视觉
3. 76.6 万条双语唇同步片段:换训练语料把 WER 从 12.54% 降到 3.01%
VoxDub: A Bilingual Lip-Synchronized Audio-Visual Dataset for Automatic Video Dubbing · arXiv:2610.25259 · 值得扫读
研究问题与核心方法:自动视频配音要的是时间对齐的语音、转写与画面,现有公开语料在音质、转写可靠性和「说话人脸是否一直在画面里」三件事上标准不一。作者的取舍很明确:先按语音切,再对同一时间段的画面做过滤与校验。
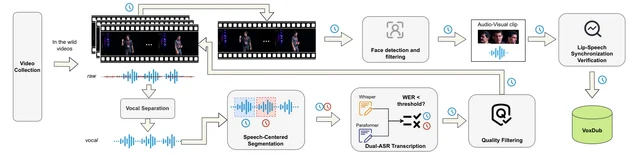
六步依次是采集并统一到 25 帧每秒、24kHz;用人声分离只留 vocal 轨;用语音活动检测按语音边界切段;双 ASR 一致性检查(WhisperX 与 Paraformer 各转一遍,两套假设之间 WER 超阈值即丢;WhisperX 底层就是 Whisper-large-v3,英文最终取它、中文取 Paraformer);音质过滤(DNSMOS P.835 的 OVRL 低于 2.8 丢弃,并删掉多人或说话人切换的片段);最后逐帧人脸检测,要求每帧恰好一张脸、相邻帧人脸框不跳变,并用 SyncNet 置信度低于 3.0 的片段剔除。7
成品是 766,708 条片段、约 1.58K 小时,中英双语。对照实验用同一种流匹配零样本 TTS(ZipVoice)在中英各训一套,分别换用 VoxDub、LRS3、CN-CVS、LibriTTS、Emilia 作训练语料,在 Seed-TTS 官方测试集与自建的 DubBench 上比 WER、说话人相似度与神经 MOS;配音实验用 SyncVoice,另报唇音同步置信度与主观同步分。
关键结果:
- 英文 TTS 相对 LRS3:VoxDub-EN 把 Seed-TTS test-en 的 WER 从 12.54% 降到 3.01%,DubBench-EN 从 12.34% 降到 4.34%,说话人相似度从 0.448 升到 0.601。7
- 中文 TTS 相对 CN-CVS:Seed-TTS test-zh 的 WER 从 12.52% 降到 2.63%,DubBench-ZH 从 7.17% 降到 3.08%,说话人相似度从 0.482 升到 0.613。7
- 大规模语料仍然更强:Emilia 预训练模型在 test-en 上 WER 1.55%、相似度 0.696,在 test-zh 上 WER 1.42%、相似度 0.750,两项都优于 VoxDub 训出的模型。7
- 语音变好,同步反而变差:英文配音的唇音同步置信度从 LRS3 的 7.10 降到 6.29,说话人相似度 0.652 对 0.649,主观同步分 4.27 对 4.12;作者对配音侧的原话是「大致相当」,并声明不构成等价或同步优势。7
- 语料质量分布:766,708 条里 97.3% 只检测到单个场景,短边分辨率中位数 1080 像素、92.8% 超过 720 像素;近 35% 的片段两套 ASR 之间 WER 为 0,超过 80% 的片段 DNSMOS OVRL 高于 3.0。7
证据与局限:每种训练语料只训一次、只报点估计,没有区间与显著性检验;配音侧作者自己只说到「大致相当」。数据量与对照并不匹配——VoxDub 约 1.58K 小时,LRS3 是 400 多小时、CN-CVS 是 300 多小时——所以「VoxDub 更好」里混着数据量的作用。
两处需要打折:英文转写标注用 Whisper-large-v3,英文 WER 也用 Whisper-large-v3 算,标签与评测同源,可能系统性低估;中文侧同样用 Paraformer 标注、Paraformer 评测。
另外全文没有筛选阶段的消融,双 ASR、SyncNet 阈值各自的边际价值无法判断;分语种的小时数与片段数也没报,只有分布图。7
与目标研究线的连接点:可搬的是清洗顺序:语音中心切分 → 双 ASR 一致性阈值 → 音质门槛 → 每帧单脸与人脸框跳变剔除 → 同步置信度。这个顺序保证先保住「能转写的语音」,再对同一时间段查画面,任何「语音+视频」语料都能照用。
评估侧还给了两条纪律:配音要同时报同步指标与语音指标,因为本文正好出现「WER 降、LSE-C 也降」的组合;语料比 LRS3 好,规模更大的 TTS 语料仍然更强。7
结论建议:读 §3.1 的六步与三个阈值、§3.2 的质量统计、§4.1 的评测协议、表 2–表 4。引用时限定:in-the-wild 双语、单次训练、无显著性检验、与对照不等数据量、中英转写与 WER 同源。7
四、专业工具里的智能体:把「说不清」做成受控变量
4. 同一段混音编辑,指令一抽象 F1 就从 1.00 掉到 0.77
TOMORI: A Tool-Orchestrated Mixing Operator for REAPER Interaction · arXiv:2610.25344 · 精读
研究问题与核心方法:混音请求说的是想要的声音,不是要做哪几步操作。现有数字音频工作站(DAW)智能体多只验证代码跑不跑,不验证交付物像不像参考。
TOMORI 是这套任务的 harness:在插件式智能体运行时里接 REAPER 原生桥,提供工程检查(轨道、路由、效果器顺序、参数名与值,可检索文档)、可选音频测量(模型自己写代码或调 FFmpeg 测指定频段电平,数值以文本回传,全程不给模型听音频)、以及执行模型生成的 Lua 代码;一次请求内循环执行检查、测量、编辑三类动作,最后交付可编辑工程与 48kHz 渲染。3
基准的构造也值得看:作者取一首 Multitrack 歌曲(MedleyDB 的 Phoenix_ScotchMorris),先用工具估出处理图、映射到原生插件并拟合参数,再请职业混音师试听修订终点,最后把终点拆成 110 条小编辑(72 条常规、19 条过冲、19 条修复)。每条编辑配三档指令:显式给对象、控件、方向与数值增量;半显式只给对象与效果类别加方向;抽象只说想要的声音。三个模型各跑 110 条 × 3 档,合计 990 例。指标分两轨:工程侧的编辑图 F1 与参数容差命中(ε=0.01),渲染侧的 MR-STFT 参考误差消减与冻结 MERT 特征上的方向投影。
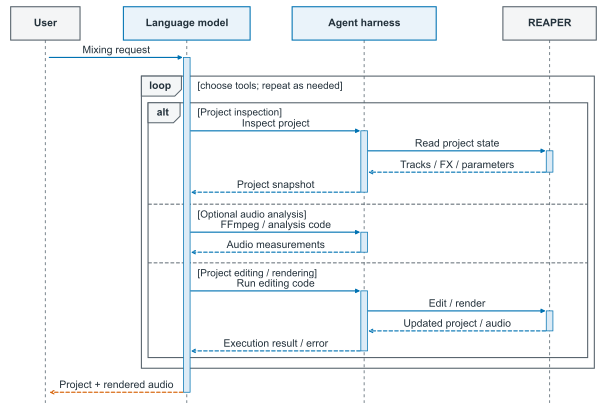
关键结果:
- 指令一抽象,编辑图就对不上:显式指令下三个模型(kimi-k3、claude-fable-5、deepseek-v4-pro)的 Graph F1 是 1.000、0.984、1.000,抽象指令下是 0.801、0.778、0.773。3
- 参数精度同向塌陷:容差 0.01 的命中率在显式指令下为 93.4%、82.6%、97.5%,抽象指令下只剩 20.7%、21.5%、22.3%,约五分之一。3
- 渲染侧一样:MR-STFT 参考误差消减从 83.8%、76.0%、85.3% 降到 33.9%、32.8%、32.0%。3
- 多轮执行本身值钱:deepseek-v4-pro 在同一批 36 步上只允许一次提交,显式指令下 Graph F1 从 1.000 降到 0.875、误差消减从 85.4% 降到 61.3%;这一子集的参数命中基线本身是 97.7%(全量 110 步为 97.5%),单次提交后降到 72.1%。3
- 给了测量工具也没变好:990 例主实验里只有 7 例(0.7%)自己调用音频测量;在 28 个依赖信号或历史的步骤上,强制先测量相对禁止分析,Graph F1 从 0.754 降到 0.645、误差消减从 22.0% 降到 17.2%、参数命中从 27.9% 升到 34.9%,平均工具调用从 11.0 次升到 18.9 次,而 28 例测量全部执行成功。3
- 失败以「多做」为主:kimi-k3 的 40 个抽象指令不完美案例里,24 个保留了全部参考节点却多加了编辑;每个模型每档最多只有 4 个必需参数被反向调整。3
证据与局限:主表没有重复种子与区间,每个模型–指令对只有一次最终交付;990 例并不独立,110 条转移全来自同一首歌,有效样本仍是 110 条。
成对比较只出现在 36 步与 28 步子集上,用按参考步骤重采样的 10,000 次配对自助,而这两个子集是按已有结果挑出来的,作者自陈不支持总体排名。
还有一处口径要小心:参数平均绝对误差的分母只算观测到的有限参数(358、360、354),漏做的参数被排除在分母外,所以 claude-fable-5 在 1 档指令下的 0.3002 高于 2 档的 0.1189,这是分母把漏做的参数排除在外所致,跨模型的平均绝对误差因此不能直接横比。3
与目标研究线的连接点:这是 A 线现成的量表——同一段参考转移配三档指令,把「用户说不清」变成受控自变量。任何请求欠定的任务都能照这个骨架做,不必重造基准。第二条是双轨计分:工程状态与渲染结果分开报,两者会分叉——kimi-k3 在抽象指令下误差消减最高,编辑图 F1 却不是最高。
第三条是两个消融骨架:单次提交对全流程、禁止分析对强制测量,都回答「多轮读回值多少」。它的结论范围停在单首歌上的 110 条编辑转移。3
结论建议:先读 §4.1–4.4(任务表示、参考构造、三档指令、指标定义),再读表 2 与表 8(主结果与失败归因),然后 §5.4 与表 3。引用时三条限定必须带上:单首歌、最终选定交付(含恢复过程)、进度类指标只在 104 个有效案例上算。3
五、条件给在哪一层:符号总谱与注意力掩码
5. 把条件从帧级音频换成 120BPM 符号总谱:32 首库内翻唱命中 0.97
MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control · arXiv:2610.26684 · 值得扫读
研究问题与核心方法:翻唱保留调性内容(旋律与和弦进行),其余属性都可改。现有音频域系统用与参考同帧率的特征作条件,于是被锁在参考的时序与结构上,不能变速、不能重排、也不能只拿一段副歌当参考。
MuLaCover 把条件换成可编辑的符号总谱:抽旋律与和弦、估计原曲速度后把总谱拉伸到统一 120BPM、按十六分音符量化,旋律编成 256 维二值钢琴卷、和弦编成 12 维色度卷,经门控交叉注意力注入预训练文本到歌曲骨干的最后 8 层。
部分条件由符号序列上的注意力掩码实现:保留某区间是外插、保留补集是内插、默认整曲。训练是三段课程:先用 30 秒短片段预热(骨干冻结、只训新模块),再整曲训练,最后一段用「同一首歌的第 i 个演绎给条件、第 j 个演绎给歌词与风格」的交叉配对。8
评测分两个任务:整曲翻唱与部分参考,每种都用批量客观指标(歌词错误率、风格相似度、库内检索命中)、22 人盲听(Friedman 检验加 Bonferroni 校正的成对比较)与一次先定判据再听的专家访谈。
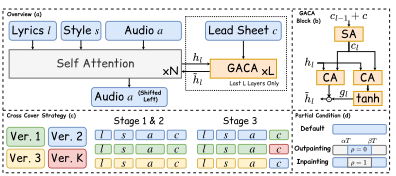
关键结果:
- 完整的调性保持:整曲任务上 32 首库内的检索命中 0.97、名次 1.05(随机命中 3.1%),Suno-v5.5 是 0.98 与 1.11,ACE-Step-1.5 是 0.95 与 1.10,SongEcho 是 0.88 与 1.55。8
- 歌词可控性领先:整曲任务的歌词错误率 0.13(Suno 0.11、ACE-Step-1.5 0.21、SongEcho 0.26);部分参考任务三种掩码平均 0.12,两个开源基线是 0.36 与 0.55。8
- 身份保持上落后于闭源:盲听 5 点量表上身份保持 3.45,Suno-v5.5 是 3.81(Bonferroni 校正后 p=0.006);风格可控 3.71 对 ACE-Step-1.5 的 2.93(p<10⁻⁴);整体音乐性 3.75 对 Suno 的 3.88(p=1.0)。8
- 消融说明条件层是关键:在一份 7 万首子集上重训的小模型上(该模型自己的基线是 0.98),去掉 30 秒预热命中掉到 0.11,去掉速度归一化到 0.73,把符号换成基频曲线到 0.33,去掉和弦到 0.46。8
- 交叉配对买的是风格:第三阶段改回同曲配对后,检索命中仍是 0.98,但风格相似度由交叉配对时的 0.38 降到 0.35、歌词错误率由 0.14 升到 0.16。8
证据与局限:客观部分是每个模型 256 首、单次生成,五个指标全来自学习型预测器,论文没有报这些预测器与真人评分的相关性;盲听有整体显著的 Friedman(χ² 52.90–88.08)与校正后的成对检验,但只有 8 首歌、22 人、95 个完整评分块;专家访谈只有一位专家、一个 R&B 案例。
三处需要自己打折:32 首参考曲本身由 Suno-v5.5 生成,评测素材与对手同源,分布上对 Suno 有利;检索库只有 32 首,一首之差就是 3.1 个百分点,0.97 与 0.98 不宜当结论;部分参考任务的两个基线是作者按论文描述自行实现的,基线可能被低估。8
与目标研究线的连接点:C 线和 D 线都能借的是「条件层与时基解耦」这个做法:把参考抽象成符号序列加掩码之后,变速、重排、只用一段都成了同一模型的不同掩码,省掉了三套系统。做节目级生成时,参考节目同样可以抽象成段落骨架。训练上的交叉配对也可以照搬:内容条件来自 A、音色与风格来自 B,是造内容–风格解耦监督的廉价办法,消融显示它买的是风格而非身份。8
结论建议:读 §3.1–3.2 的条件表示与注入方式、表 1–表 4、附录 C 的基线配置。引用 Task 1 数字要写「32 首对手生成的参考曲、每首 8 个风格变体、共 256 首」;与 Suno-v5.5 的比较要同时给身份保持的落差。8
六、评测口径三则:标签权威、合成查询、压缩损失
6. 听众投票一散,硬标签准确率从 0.923 掉到 0.440
Label Authority in Speech Emotion Recognition: Intended and Perceived Ground Truth in Emozionalmente · arXiv:2610.26446 · 值得扫读
研究问题与核心方法:情感识别的「真值」常被当成单一类别事实,但「表演者被要求演什么」与「听者听到什么」是两个构念。
Emozionalmente 对每段同时给了录制时的表达标签与五条听者判断,于是能在同一批音频上定义三种权威:表达条件、听者硬多数(五票里出现最多的类,平票按最小编号类别打破)、完整投票分布。
作者用冻结的 XLS-R、HuBERT、WavLM 加三类探针做诊断:linear、dense 两类单层探针,加上跨层聚合的 agg_dense;3 个骨干 × 10 个深度层 × 2 类单层探针得 60 个条件,再加 3 个聚合探针共 63 个,每个条件跑 3 个目标 × 5 次,共 945 条训练轨迹;划分是说话人独立的 60/20/20(4,142、1,380、1,380 段)。4
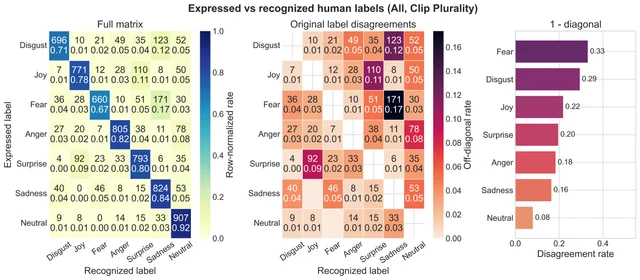
关键结果:
- 人际层面先分叉:五票多数与表达标签的片段级一致率是 79.1%,按听者逐票算只有 66.4%;名义 Krippendorff α 只有 0.476。4
- 一致性一弱,硬标签就脆:最高票占 1.00 的 1,792 段上两者完全吻合,最高票占 0.80 的 1,909 段为 0.870,占 0.60 的 2,070 段为 0.663,平票的 715 段为 0.603,唯一最高票只占 0.40 的 416 段为 0.481,五层合计正好 6,902 段。4
- 各取最优时差距看着大:表达条件 0.825±0.009(XLS-R 第 13 层),听者多数 0.746±0.006(XLS-R 第 15 层),差 0.079(95% 区间 0.058–0.099)。4
- 换成共同参考,差距基本消失:同一批测试片段上,表达条件、听者多数、投票分布三种目标的硬标签 UAR 依次为 0.739、0.731、0.736;对五票分布的 KL 依次为 1.667、1.223、0.510,Brier 为 0.272、0.236、0.162。4
- 分布监督改的是概率分配:软对硬,硬分数只差 0.003(区间 −0.013–0.019,跨零),而 KL 低 0.360、Brier 低 0.056;在测试划分里平票的 145 段上(分层统计里的平票共 715 段),硬分数从 0.469 掉到 0.435,KL 从 2.121 降到 0.671。4
- 难度跟着人的分歧走:用硬多数训练的探针在全一致片段上 0.923±0.003,平票片段掉到 0.484±0.012,唯一最高票低于 0.60 的片段掉到 0.440±0.007。4
证据与局限:每个条件 5 次运行,头条对比配 1,000 次按片段重采样的配对自助,但 63 个条件共享数据与表示,作者明确不当作 63 个独立实验;检查点按验证集选,而最佳层与「赢家」是按 5 次运行的测试分数事后挑的,作者自陈结论偏乐观。
三处从外部看:平票按最小编号类别打破是任意约定,而平票有 715 段(10.4%),这条规则直接决定硬指标的分子;34,510 条判断来自 829 名听者,同一听者的多条判断不独立,全文没有听者级随机效应;α=0.476 说明硬多数本身带噪,此时把模型差距解释成能力差距要谨慎。4
与目标研究线的连接点:任何「感知类」指标(MOS、情感、自然度)都该写明权威与聚合规则。这篇给了模板:命名权威、保留聚合规则与平票政策、按一致性分层报、分布目标用 proper score。分层报告法最值得抄——平均分 0.923 的背后是 0.440 的崩塌,节目级评估同样该把听众分歧大的片段单列。4
结论建议:读 §III 与表 I(三种权威的操作化)、表 IV 与表 V(各自参考与共同参考,这一对是全文关键)、表 VII、表 IX。引用 0.825 对 0.746 时必须同时说明「参考变了、选中的层也变了」,否则等于把两个问题比成一个。4
7. 合成口哨 top-1 涨 0.071,真实口哨反而少对 4 条
Whistle and Wrong Lyrics: Synthetic Queries Are Not Enough for Real-World Query-by-Melody · arXiv:2610.25371 · 邻近跟踪档
研究问题与核心方法:旋律检索的公开基准只有哼唱与带词演唱,口哨和「词唱错」这两类真实查询没有与歌曲录音配对的公开数据。作者用一个纯旋律检索系统做对照:查询端与歌曲端都取基频轨迹、减去片段中位音高做调性归一化,再送进约 5.2M 参数的 6 层轮廓编码器得到 256 维向量。
合成数据做了三代:物理渲染(把 11,083 首歌的人声旋律渲染成口哨与无意义音节演唱,再用真实跟踪器重跟踪一遍)、商用神经音乐模型生成、开源管线生成。三代合成都用来微调同一个基线,考的是能不能迁移到真实口哨。5
对照组数据是真实录音:MLEnd Hums and Whistles 的 8 首歌、339 条测试口哨、26 位测试吹哨者。指标为 top-1、top-10 与平均倒数排名,关键比较都配同一批音频片段上的配对 bootstrap 区间。
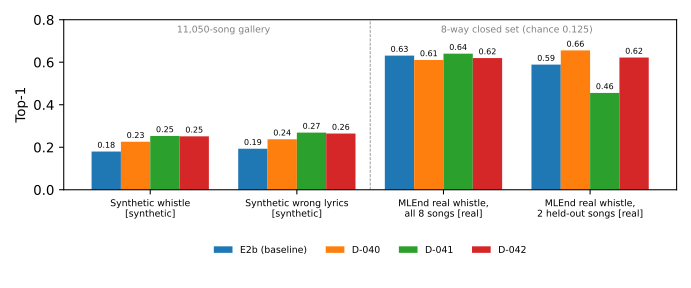
关键结果:
- 合成留出集上确实涨:口哨 top-1 从 0.180 升到 0.251,错误歌词从 0.193 升到 0.264(每风格 4,263 条、库容 11,050 首)。5
- 真实口哨上没有迁移:339 条测试口哨的 top-1 命中从 214 条降到 210 条(0.631 到 0.619),而 8 路闭集的随机基线是 0.125。5
- 用真实数据训测试曲目,学到的是歌本身:用 8 首里 6 首的真实口哨训练后,这 6 首的 top-1 从 0.647 升到 0.707(全部 8 首的基线是 0.631),从未见过的 2 首从 53/90 掉到 41/90(0.589 到 0.456)。5
- 闭集微调有效但有限:留出说话人的闭集设置下 top-1 从 0.631(区间 [0.581,0.681])升到 0.673([0.622,0.723]),即 214 条到 228 条。5
- 商用模型生成的数据没用:累计提交 329 条,被版权校验拦下 238 条(72%),最终只拿到 180 条可用于微调;微调后验证集 top-1 从未超过第 0 步的 0.794,选中的「最佳」checkpoint 就是基线本身。5
- 开源管线同样无效:约 2,000 条查询、167 首歌,没有一臂在真实口哨上超过基线,最好的一臂 0.619、配对差 −0.012(区间 [−0.038,+0.015]);全量混合训练末态掉 8.6–8.8 个百分点。5
- 跟踪器的影响大于训练:同一套权重,频谱峰跟踪下 top-1 是 0.631,半速基频跟踪 0.584,原速基频跟踪只有 0.159。5
证据与局限:每轮单种子,作者明写;好处是关键比较都给了配对区间,并把合成留出与真实两组分开报。真实侧的证据薄:只有 339 条口哨、8 首歌,2 首留出歌只有 90 条,说话人级区间宽到 [0.500,0.753] 与 [0.536,0.801] 且互相重叠。
表 3 里「全部 8 首」的 0.640 混进了训练过的 6 首,不能当增益引用;0.631 到 0.673 是 8 路闭集、8 首歌已知,不能读成开集检索能力。5
与目标研究线的连接点:可搬三条纪律。第一,合成数据上的增益必须配真实查询的同批配对差与区间,否则 0.180 到 0.251 这种数字系统性高估;本文的对照是合成涨 0.071、真实少 4 条。第二,闭集与开集必须分开报,训练集里放进测试对象的真实数据,会把「身份」当成「能力」。
第三,选择指标必须在目标域上能动,否则早停会静默返回第 0 步,整轮实验的「最佳」其实是没训练。5
结论建议:把它当「合成数据不迁移」的案例读,读 §5–§8 与表 1、表 3、表 5、表 6。它离四条线最远,方法与 A–D 没有对应步骤,能搬的只有上面三条评测纪律。5
8. 10% 音频 token,10 个任务里 7 个最优,但语音识别仍从 97.68 掉到 31.25
AudioScorer: Learning Question-Aware Token Relevance for Large Audio Language Models · arXiv:2610.26258 · 邻近跟踪档
研究问题与核心方法:大型音频语言模型的音频编码器按秒产出密集 token(约 25 个/秒,30 秒约 750 个),而一个问题往往只依赖其中一小部分。已有剪枝方法用注意力、表示相似度或时间采样等预定义信号,不直接回答「哪些 token 对这个问题有用」。
AudioScorer 是一个轻量打分器:用文本编码器编码问题,与音频 token 做分组查询交叉注意力,再由多层感知机加 sigmoid 给每个 token 打分;训练信号两条,一是把冻结模型对参考答案的梯度范数归一化成 token 级排序做蒸馏,二是在按分数加权的 token 上算答案似然。
推理时在解码器第 2 层之后做硬 Top-K 剪枝。9
评测用 AudioMarathon 的 6,347 条与 MMAU-Pro 的 5,305 条,骨干为 Qwen2.5-Omni-3B(全部冻结),打分器可训练参数 50.15M。保留率只扫 70%、40%、10% 三档,基线是 FastV、SpeechPrune、DART、Frame、HeadRouter 五个剪枝方法。
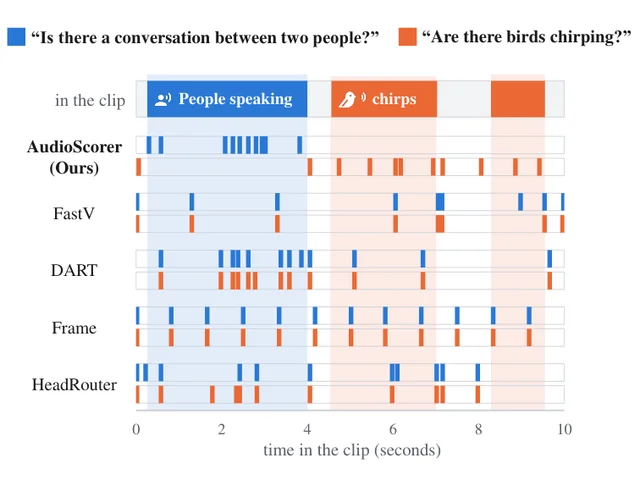
关键结果:
- 10% 保留率下 10 个任务里 7 个最优或并列最优:语音识别 31.25 对最强基线 5.15,语音内容推理 74.57 对 69.20,语音实体识别 25.14 对 21.61,音乐分类并列 100.00,音频场景分类 71.24 对 67.48,情绪识别 43.75 对 40.65,说话人性别识别 97.19 对 96.97。9
- 没拿到最优的三项差距不小:声音事件检测 67.82 对 70.62,说话人年龄识别 14.67 对 15.55,深度伪造检测 32.97 对 50.03。9
- 但语音识别的 31.25 只是相对优势:未剪枝时是 97.68,其余方法在 10% 保留率下都落在 0.00–5.15,31.25 仍比未剪枝低 66.43 个百分点。9
- 长音频基准上几乎不亏:MMAU-Pro 加权分在 70%、40%、10% 三档为 49.18、49.53、48.51,未剪枝是 48.57。9
- 消融指向两条训练信号都不能少:去掉相关性蒸馏,语音识别从 31.25 掉到 0.00;去掉下游交叉熵,场景分类从 71.24 掉到 56.27。9
- 打分开销很小:比同深度但不打分的基线平均多 0.16 TFLOPs(17.51 对 17.35),占预填算力的 0.4%–0.9%。9
证据与局限:主结果是「6 种方法 × 10 个任务 × 3 档保留率」的完整网格,消融下到子任务级,证据密度不错;但只有 Qwen2.5-Omni-3B 一个骨干、单次运行,无区间与检验,三档共用同一套排序,是同一次训练的三种截断。
训练只用了 8 个来源各 1,000 例、合计约 8,000 例,与评估规模相比很小,泛化边界没有讨论。还有一处原文没解释:100% 保留档里各基线的数值并不等于未剪枝值(例如 FastV 的语音识别 97.03 对 97.68)。9
与目标研究线的连接点:A 线做压缩与长上下文时,报损失要按任务分列并给未剪枝上界,不能用类别平均代替——这里三组类目平均(语音内容、音频分类、说话人信息)相对最强基线的领先分别是 13.38、0.57、1.13 分(Macro-F1 口径),类目平均会把语音识别与伪造检测这两项的崩塌抹掉。第二,把「保留率」换成可比的算力轴,打分开销应计入。第三,换问题看选择是否变化,是检验任何「内容感知压缩」的最省力探针。9
结论建议:只有在做长音频推理成本时再读,看表 1、表 2 与消融表 3。不要引用 31.25 当可用精度;要引用 MMAU-Pro 那组「几乎不亏」的数字。9
七、推理轨迹:错误轨迹该进 SFT 还是 DPO
9. 错误推理轨迹进监督微调掉 0.5–0.9 个百分点,留到偏好优化才涨 1.0–2.2
Long Listening Thoughts: Eliciting Open Auditory Reasoning with Deliberative Perception and Cognitive Refinement · arXiv:2610.24409 · 值得扫读
研究问题与核心方法:音频理解基准上的失败以感知错误为主,而现有后训练数据只依赖高层标签或模型自述的音频描述,颗粒度不够。
LLT 在一个已有音频思维链数据集上做四阶段增广:拼多面向稠密描述(语义、声学、时间三支,声学那支让视觉语言模型直接读频谱图给出可数值锚定的坐标);让指令模型把原题改写成更难的题并校验可解性;用同一模型合成「看似合理但结论错」的短轨迹;再用推理模型从「等一下」「我再听一遍」这类触发词续写,把短轨迹续成带验证与回退的长轨迹。
训练上只把正确轨迹与「正确→精炼」轨迹放进 SFT,错误→改正的轨迹留到偏好优化,三类偏好对各 20k。6
数据规模:源数据 338k 条片段加新增 316k 条加固问题,合计 654k 问答对;轨迹约 1.6M 条(短正确 654k、正确→精炼 505k、错误→改正 441k)。骨干是 Qwen2.5-Omni-7B 全参数微调,SFT 5 个 epoch、偏好优化 3 个 epoch,单节点 8 张 H100。
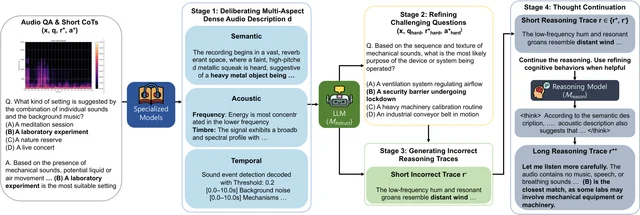
关键结果:
- 三个基准都涨:MMAU Test-mini 从 71.5 升到 78.2,MMAR 从 56.7 升到 63.7,MMSU 从 60.6 升到 66.0(相对论文引用的基线)。6
- 错误轨迹放错位置会掉分:把它直接混进 SFT,全量规模下 MMAU、MMAR、MMSU 三个基准从 76.3、62.2、65.0 掉到 75.8、61.4、64.1;50k 小规模下从 75.7、61.1、64.0 掉到 74.6、60.2、63.3。6
- 两阶段比同表最佳 SFT 再高 1.9、1.5、1.0 个百分点。6
- 拿掉错误→改正偏好对:MMAR 从 63.7 掉到 62.2、MMSU 从 66.0 掉到 64.4,而 MMAU 反从 78.2 升到 78.3。6
- 续写触发了真实纠错:含触发词的 1,132 条可判定响应里,8.7% 由错改正、4.9% 由对改错,净 +3.8 个百分点(McNemar 检验 p<0.001)。6
- 长音频上增益仍在:MMAU-Pro 总体从 50.1 升到 55.2;超过 30 秒的子集(2,862 条)从 57.1 升到 59.8,30 秒以内(1,720 条)从 42.6 升到 48.7。6
证据与局限:所有主结果来自单次运行,原文在附录里明写「所有报告结果均来自单次运行」,没有种子方差;统计检验只覆盖触发词分析,主表三个基准没有区间。
三处必须自己核对:摘要的 71.5 用的是论文引用的基线,作者自己复现的基线是 74.6 与 57.9,按复现基线算,MMAU 增益是 3.6 个百分点、MMAR 是 5.8,而不是 6.7 与 7.0;MMAR 的 63.7 低于同期最强基线 65.3,也低于自家加强化学习的 64.9;推理时去掉音频,模型在 MMAU 与 MMAR 上仍有 58.7 与 39.3,高于基线,说明一部分增益来自文本侧推理。6
与目标研究线的连接点:B 线三步都能借。轨迹来源上,错误轨迹不从学生采样,而由更强的模型对着稠密描述合成——同样 50k 源题,单次采样只能得到 4.1k 条错误→改正轨迹,合成能得到 31.4k 条。
轨迹分层上,这篇给出了同一个错误轨迹进 SFT 掉分、进偏好优化涨分的对照,是最直接的证据。偏好对设计上,三类各 20k,并用每个词的对数似然诊断负样本是否落在参考策略分布内。6
结论建议:读 §3 的四阶段、表 1–表 3 与附录 B.6 的复现基线。引用增益时必须说明用的是哪一条基线,否则 6.7 与 3.6 会被混成一个数。6
八、播客线覆盖说明、排除清单与本期可迁移结论
播客生成与节目级评估在本期候选池里是 0 条直接命中。 18 篇的标题与站点摘要逐条扫过,没有一篇做播客脚本生成、节目级评估或长音频节目组装。
为判断这是零产还是口径漏掉,本轮在 arXiv 全库另查了四个检索式:精确短语「podcast generation」最新一篇是 2607.21961《On Improving Faithfulness of Podcasts from Documents》(2026-07-24 提交);「podcast script」最新是 2601.14903《PodBench》(2026-01-21),800 条样本、输入最长 21K token;「audio drama」最新是 2610.18010《Fish Audio Drama 3 Technical Report》(2026-10-13,cs.SD,35B 参数混合专家、每 token 激活 3B,支持多轮返修与场景配音,权重已开源);关键词 podcast 的最新一篇是 2610.25265《SPARC》(2026-10-18,用两个播客语料做说话人归属,12,500 名以上说话人)。1011
这条线在 arXiv 上持续有产出:10 月 13 日是多说话人表演式语音生成(Fish Audio Drama 3),10 月 18 日是播客语料上的说话人归属基准(SPARC)。本期缺口的来源是候选口径:本频道的候选池只收「arXiv 每日学术速递」三个栏目当天的「新提交」,这几篇都不在今天的名单里。本期也没有拿叙事生成、脚本写作或长音频合成的论文来顶这条线的位置。
排除的 9 篇编号:2610.26100、2610.26112、2610.25892、2610.24921、2610.25301、2610.26253、2610.24468、2610.24138、2610.24572。其中 2610.24138 是视听深伪检测的音频前端对比,作者把音频标签恒设为真实音频,全文没有合成语音可检测性的测量,搬不出与生成质量相关的结论;2610.24572 是病理语音的识别个性化,单说话人 215 条、无重复运行与统计检验,摘要里「中等长度改进最大」与表 7 的单点最大改进(短句档)也不一致。
本期可迁移的四条。
第一,凡是报告「换掉偏好目标涨了多少」的工作,先看它有没有把拟合与生成分开:本期 CosyVoice 用专家语音做 DPO,宏平均 WER 从 3.87% 升到 4.59%,专家探针似然反而下降 0.348 nats/token;换合成专家降到 3.27% 时,似然只降 0.318。
似然与可懂度在四个目标上多次反向,只报一个都会骗人。1
第二,一步生成要报「同 checkpoint 的直接单步基线」。MixiSpeech 的 2.2678 之所以可信,是因为同一份教师直接压成一步只有 1.6846;没有这条基线,0.0245 的差距会被读成「一步本来就行」。 2
第三,评测的「真值」必须点名。同一条录音在表达条件与听者多数上是两个问题,各自最优差 0.079,换成共同参考只剩 0.008;一致性一弱,硬标签准确率从 0.923 掉到 0.440。做音频评测时,把权威、聚合规则、平票政策写出来,比多跑两个模型有用。 4
第四,合成数据的分要配真实数据的分。口哨查询在合成留出集上从 0.180 涨到 0.251,真实口哨上从 214 条掉到 210 条;错误推理轨迹也是同一个道理,放进 SFT 掉 0.5–0.9 个百分点,留到偏好优化才涨 1.0–2.2。56
第五,把「说得清」做成受控变量。同一段混音编辑配三档指令,显式指令下三个模型的 Graph F1 是 1.000、0.984、1.000,抽象指令下掉到 0.801、0.778、0.773;只允许一次提交时,Graph F1 从 1.000 掉到 0.875,多轮读回值 12.5 个百分点。这类基准的价值在于把「请求欠定」和「执行不力」分开量,做成产品时可以直接照用这套三档设计。 3
References
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10Fish Audio Drama 3 Technical Report
arxiv.org
- 11
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.