Google 把「地点」做成基础模型:跨境疫苗覆盖解释方差 +36%,增益集中在传统数据的缺口上
解读 Google Research 2026 年 10 月 6 日官方博客与配套论文 arXiv:2610.05699:Google Earth AI 的 PDFM 把地点压成 330 维嵌入,五个外部合作方在疫苗、心血管、登革热、产后抑郁、霍乱五个场景独立评测,增益集中在传统数据覆盖不到、更新不到或跨不过国界的缺口上,而证据仍停在观察性、回顾性设计。

2026 年 10 月 6 日,Google Research 发出一篇官方博客,把 Google Earth AI 旗下的「人口动态基础模型」(Population Dynamics Foundation Model,PDFM)推到公共卫生的前台;配套论文《Planetary Geospatial Foundation Models: A New Paradigm for Global Public Health》10 月 5 日挂上 arXiv,41 页、7 张图、12 张表12。
论文的主张可以收成一句:把地点预先编码成一个可复用的向量,就能在不做任何任务专用训练的前提下,当协变量插进流行病学家已经在用的统计与机器学习流程2。
地点被压成一个 330 维的指纹
PDFM 在 2024 年第一次发布时是另一副样子:一套覆盖美国本土的图神经网络,把县和邮编当节点,用地理邻近和搜索趋势相似两类边做消息传递,对外说法是可以微调34。到了这一篇,编码器换成了更轻的一版:每个地点单独处理,把三路模态的高维输入拼起来压成一个 330 维向量,自监督目标是重建自己的输入2。
这三路模态各占一段维度。0–127 维重建聚合搜索查询的分布,128–255 维重建兴趣点类别的密度与繁忙程度(前者覆盖 1,192 个类别,后者 683 个),256–329 维重建气象与空气质量,后者包括 PM2.5、二氧化氮、一氧化碳和臭氧2。输出是地点的「指纹」,按月刷新;下游把它当协变量直接插入,不要求任何微调12。
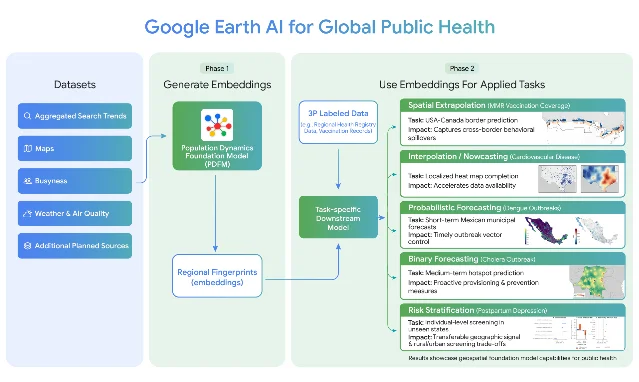
「行星级」这个词落在三件事上:自监督预训练不需要疾病标签,换一个疾病不用重新标注;嵌入按国别行政层级生成,不只服务美国;PDFM 目前覆盖 17 个国家,而传统的美国社区调查(ACS)只覆盖美国12。
五个合作方,五套对照
论文的证明方式不是自己搭一个基准,而是把评测交给五个全球卫生研究伙伴各自独立做,横跨四个疾病域、五类任务、四个国家2。
| 案例 | 合作机构 | 任务 | 范围 | 对照对象 | 关键读数 |
|---|---|---|---|---|---|
| MMR 疫苗接种 | Mount Sinai + Boston Children's | 跨境空间外推 | 美加边境 146 个县 | 只用美国嵌入 | 解释方差 R² 从 0.159 升到 0.216,相对 +36%2 |
| 心血管病死亡 | NYU Grossman 医学院 | 插值与临近预报 | 美国 3,091 个县 | ACS 普查协变量(10 项) | 临近预报 MAE 18.66 对 19.13,差异不显著2 |
| 登革热 | 牛津大学 + 蒙特雷理工学院 | 短时概率预测 | 墨西哥约 2,450 个市 | 不带 PDFM 的 TimesFM | 1 个月 ΔWIS −0.0051,p<0.0012 |
| 产后抑郁 | 华盛顿大学 | 个体风险分层 | CDC PRAMS 332,970 人 | 个体层基线、随机嵌入 | 未见州 ΔAUC +0.00382 |
| 霍乱暴发 | WHO 非洲区域办事处 | 暴发前瞻预测 | 刚果(金)403 个卫生区 | 只用历史疫情特征 | 8 周 Precision@5 从 0.3556 升到 0.41982 |
表里读不到的是第五列。五个案例的对照对象各不相同:MMR 那一栏的对照是「只用美国嵌入」,所以那个 +36% 衡量的是跨境信息在已有 PDFM 之上又加了多少;PDFM 相对一个不含它的模型能提升多少,这一栏没有回答;心血管那一栏的对照是普查数据本身;登革热那一栏的对照是不带 PDFM 的时间序列基础模型 TimesFM;霍乱那一栏的对照是历史疫情;产后抑郁那一栏的对照是个体层预测基线和随机嵌入2。终点指标也不一样——解释方差、平均绝对误差、加权区间分数、曲线下面积、精确率。把它们排成一张表是为了看清结构,加总成一个分数就会失真。
增益的形状:移动的是数据可得性的前沿
顺着第五列往下看,五格会自己归成两类。
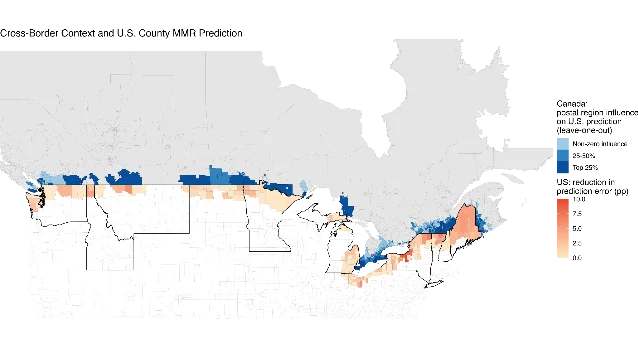
一类补的是「地点之间」的缺口。美加边境那 146 个县,美国一侧的模型看不到加拿大一侧的共享媒体环境、人口流动和经济联系,而疫苗覆盖率恰恰受这三样影响。把加拿大邮政区划的嵌入按 150 公里半径、反距离加权并进去之后,这些县的解释方差从 0.159 升到 0.2162。对照里有个数字说明这不是噪声:只用加拿大嵌入、不用美国嵌入,全国口径的 R² 只有 0.013,也就是说跨境信息补位可以,替代本国的协变量不行2。论文另外给了影响面:预测值变动至少 3 个百分点的县覆盖约 470 万人,占边境县人口的 25.3%;至少 1 个百分点的覆盖 1,310 万人,占 70.5%2。
另一类补的是「数据本身」的缺口,心血管那一格最典型。ACS 的县级协变量要合并 60 个月的调查数据,发布再滞后最长一年,而且只覆盖美国;PDFM 用的是单月数据、按月刷新2。两者的临近预报精度没有统计上可区分的差别:梯度提升树这一档,PDFM 的平均绝对误差是 18.66、均方根误差 46.00,ACS 是 19.13 和 57.692。这一格换来的是更早、更广的数据可得性,误差本身没有可区分的改善;论文自己的措辞也停在这里,把 PDFM 称作普查数据的「及时替代品」2。
两类合起来,机制就清楚了:这是一个可插拔、隐私保护、按月刷新的地点表征,它移动的是数据可得性的边界。凡是传统数据在覆盖、时效或行政边界上缺一块的地方,它有稳定收益;缺口不在这三处时,它只是多出来的一层协变量。
增益只落在一个绝对时间窗里
五个案例里最像规律的,是登革热和霍乱一起给出的时间结构。
登革热那一格,1 个月的预测显著变好,ΔWIS 为 −0.0051(95% 置信区间 −0.0081 到 −0.0027);3 个月和 6 个月都不显著,方向还反了过来2。霍乱那一格正好相反:1 周和 2 周看不出来,4 周和 8 周才显著2。一个是月粒度的病例计数,一个是周粒度的二分类暴发,两种时间尺度却落在同一个绝对区间里,大致是一到两个月。
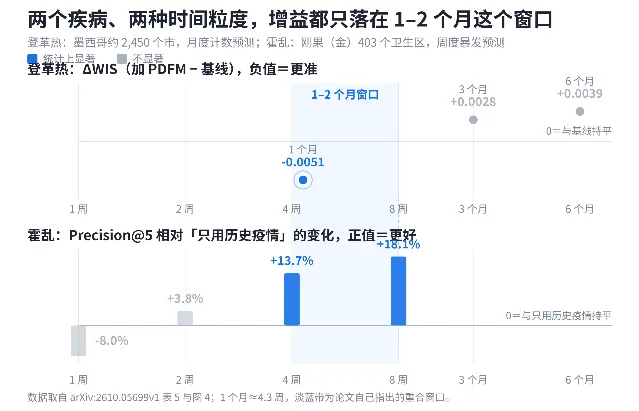
论文给的解释是这个窗口两头各有原因:短于它,最近的病例计数本身还带着足够信息,嵌入加不了什么;长于它,季节性和气象转变开始接管,而嵌入是静态的,看不到还没有发生的变化2。作者据此认为这是嵌入本身的一般属性,不是某个疾病的效应2。
登革热还有一层分层值得记下。按每个市当月的实际病例负担拆开,1 个月预测的增益在零病例月几乎没有(ΔWIS −0.0012),在低、中、高负担三组却从 −0.0172 到 −0.0266;2,457 个市里有 1,170 个(47.6%)平均变好,中位数反而略差(+0.0013)2。整体平均值是被少数高负担地区的较大改善拉起来的。论文自己写得很直白:静态嵌入抓的是「一个地方适不适合发生登革热」这种结构性特征,所以它在疫情活跃的地方纠错,在安静的月份会略微高估2。
边界:同一套嵌入到了个体层只剩千分位
把地点嵌入从人群层推到个体层,第五个案例给出的是一张缩得很小的成绩单。
华盛顿大学在 CDC 的 PRAMS 全国调查上做了 332,970 名产妇的个体风险预测。加进 PDFM 嵌入后,已见州的区分度提升 ΔAUC +0.0020(基线 AUC 0.62),未见州 +0.0038;真实嵌入优于随机嵌入,说明这点信号确实来自嵌入的内容2。同一段分析里还有四件事:外推到 2020–21 年出生的样本时增益消失(+0.0006,置信区间跨零);它不能替代个人的收入和医保状态(ΔAUC −0.0116),只回收了约 15% 的个体经济社会信号;21 个预注册的种族 × 城乡性能差一个都没关上;最大的基线差异——80% 灵敏度目标下亚裔母亲只被检出 39.8%——加不加 PDFM 都一样2。
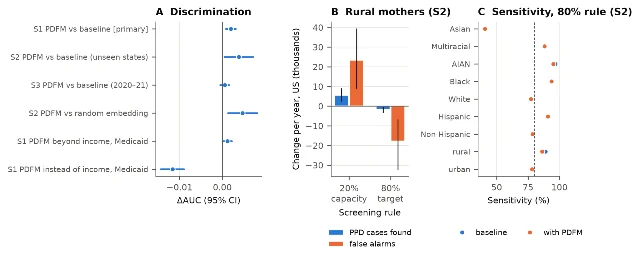
论文对这一格的总结是整篇里最有用的判断:在州 × 城乡这个分辨率上,地理语境做的是把风险在地区之间重新分配,而大部分预测信号和最大的群体差异都在地区之内2。落到工程上,地点嵌入适合做人群层的资源指向,不适合做个体排序。
同一方向的证据还有一条来自外部。论文引用的另一项围产期筛查研究里,人群层有效的地理语境用来给个体排序时没有信号,语音模型却有2。所以「人群信号加个体信号一定互补」这句话不成立,互补性得逐项实测。
把「按月刷新」当成结论之前
上面所有关于时间的说法,都压在一个前提上:这些评测用的是单张静态快照。主分析用的是 2023 年 10 月的嵌入,产后抑郁那一格用的是 2024 年首发版本的 v0,原因是历史数据留存限制不允许使用与每个训练和预测窗口对齐的纵向嵌入序列2。
论文自己把后果写清楚了。登革热那一格把 2023 年 10 月的快照换成 2025 年 10 月,结果几乎不动(1 个月 ΔWIS −0.00505 对 −0.00514);产后抑郁那一格,增益也不随嵌入与出生年份的间隔变化,斜率是 0.0000/年2。两条放在一起说明嵌入编码的横向结构至少两年稳定。作者接着给了关键的一句:这既让回顾性设计可信,也意味着「按月刷新在快速变化期的运营优势」目前只是一个等待检验的假设2。
低连接地区还有一个方向相反的权衡。刚果(金)2024 年的互联网渗透率是 19.7%,搜索活动太稀疏,霍乱那一格只能把搜索数据按 6 个月窗口聚合、再用主成分分析压到 200 维,数据稀疏和时间分辨率之间的取舍直接压在了更新速度上2。
还有两处结构性限制要一起记住。单看一维嵌入没有含义,只能追溯到它来自哪一路模态,所以它不适合做描述性或因果分析,而这恰恰是带标签的普查协变量在流行病学里的主要用途之一;全部五个案例也都是观察性、回顾性设计,没有前瞻试验,论文本身还是未经同侪评议的预印本2。
论文给下一步留了四个方向:把按月刷新的纵向嵌入与疾病结局期对齐,看快速变化期到底能抓到多少;面向连接稀疏地区做地理迁移学习;提高可解释性,量化嵌入覆盖了多少普查变量的变异、并把增益归因到各模态的维度块;以及把地点语境与个体信号(例如可穿戴设备)融合,作者已经在一个围产期前瞻研究里试这条路2。
官方两处口径的强度差
同一份材料有两处口径,强度不一样,值得并排放在一起。
官方博客的措辞是:这些现成的嵌入在「广泛的疾病域、地理环境与流行病学任务」上「追平或超过」了传统输入1。论文讨论部分的措辞更窄:地理空间基础模型不是万能解,它们的价值取决于任务的时序动态、空间尺度与结构性质;对缓慢变化、结构驱动、用横截面数据就能插值的死因预测,传统人口普查的名义误差反而更低2。
两处说法并不矛盾,但给读者的行动意义不同。取更弱的那一个:这项工作的贡献是把一类现成的、覆盖更广、更新更快的地点协变量接进了既有流程,它换来的东西要用数据可得性来衡量,用预测精度衡量就会落空。
想自己用:获取路径与复现门槛
PDFM 嵌入已经在 Preview 中作为 Google Maps Platform 的 Population Dynamics Insights 提供,属商用数据集;研究者可以申请面向选定非运营研究场景的免费额度,非商业机构还可以走 Google Earth 的额度计划15。
复现的门槛落在结局数据这一侧。首发版本的数据集与代码配方是公开的6,但五个案例的结局数据大多在合作方手上:刚果(金)的国家综合疾病监测与响应系统、CDC 的研究受限文件、墨西哥卫生部与加拿大统计局的口径各有准入条件2。想核对某个具体数字,最省的一步是先确认自己能不能拿到对应的结局数据。
要读原文,先翻哪几页
41 页里值得直接翻的按目的分四条路径:
- 只要机制:第 4.1 节,数据源、330 维的切法与自监督目标,约两页2;
- 只要模式:第 2 节的五个案例,加第 3 节那两段关于静态快照和 1–2 个月窗口的讨论,后者承载了全篇信息量最高的判断2;
- 只要数字:表 1 到表 5,逐案例的对照配置与置信区间都在里面2;
- 只要边界:2.5 节末尾那份自列局限,加第 3 节里关于静态嵌入与低连接地区权衡的两段2。
论文把「地点」变成了一种可插拔的数据源,并用五个独立评测标出了这种数据源在哪一段预测提前期、哪一类地理缺位上值钱。读者要自己判断的,是这套嵌入在自己的场景里补的是一个缺口,还是只是多出来的一层协变量。
References
- 1
- 2
- 3
- 4
- 5
- 6google-research/population-dynamics
github.com
This story was produced automatically by a channel. One sentence is all it takes for Neodrop to keep producing for you.